tracks
개발자를 위한 AI 엔지니어 보조
26
먼저 GPU가 제대로 인식되는지 확인하고 NVIDIA 드라이버와 CUDA 버전을 점검합니다.
nvidia-smi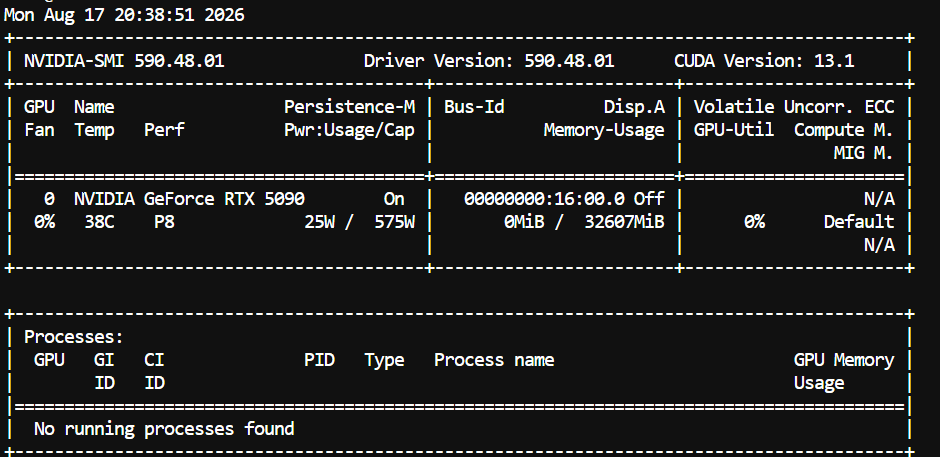
RTX 5090, 드라이버 버전, CUDA 버전, GPU 메모리, 현재 GPU 사용량이 표시되어야 합니다.
참고: 이 설정은 RTX 5090과 같은 NVIDIA Blackwell GPU에 특화되어 있습니다. 아래 빌드는 RTX 5090이 사용하는 컴퓨트 아키텍처인 SM120을 대상으로 합니다.
다음으로 CUDA 지원을 포함한 최신 llama.cpp를 다운로드하고 컴파일합니다.
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp

cmake -B build \
  -DGGML_CUDA=ON \
  -DCMAKE_CUDA_ARCHITECTURES=120

cmake --build build --config Release -j$(nproc)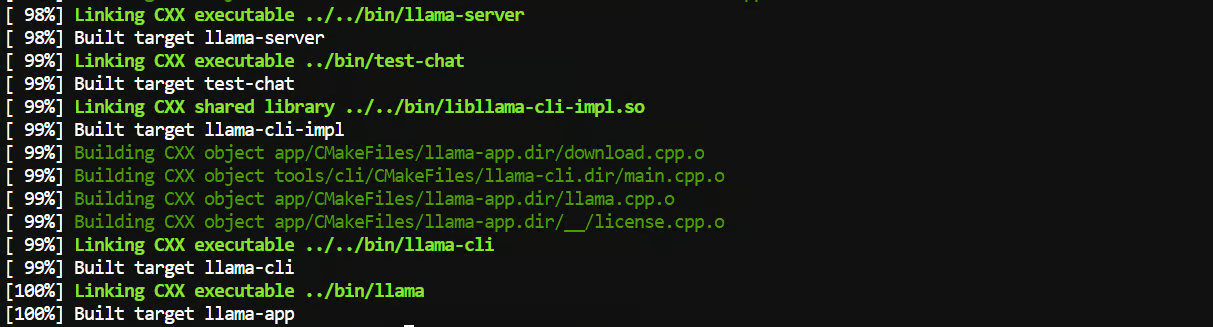
여기서 중요한 부분은 -DCMAKE_CUDA_ARCHITECTURES=120입니다. 이는 RTX 5090에 사용되는 Blackwell 아키텍처를 대상으로 llama.cpp를 빌드하라는 의미입니다.
빌드가 완료되면, 임의 폴더에서 실행할 수 있도록 llama-server를 전역으로 사용 가능하게 만듭니다:
sudo ln -sf "$(realpath ./build/bin/llama-server)" /usr/local/bin/llama-server이제 모든 것이 정상 동작하는지 확인합니다:
llama-server --version다음과 유사한 출력이 표시됩니다:
version: 0.1.1-dev (build 10479, commit 0021a77de)
built with GNU 13.3.0 for Linux x86_64
이제 끝입니다. RTX 5090과 Blackwell 네이티브 NVFP4를 활용할 수 있는 CUDA 활성화 llama.cpp 빌드를 준비했습니다.
이제 Qwen3.8-27B 모델을 다운로드합니다.
먼저 Hugging Face CLI를 설치합니다:
pip install -U huggingface_hub모델을 보관할 폴더를 만듭니다:
mkdir -p /workspace/models/qwen38그다음 NVFP4-MTP GGUF를 다운로드합니다:
hf download felippeburk/Qwen3.8-27B-NVFP4-MTP-GGUF \
  --local-dir /workspace/models/qwen38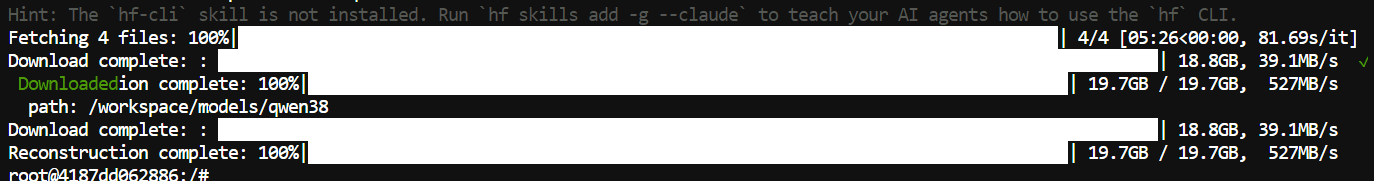
이 버전은 NVFP4를 사용하고 MTP 지원을 포함하고 있어, RTX 5090에서 속도 향상이 큰 이 설정에 적합합니다.
이제 재미있는 부분입니다. GPU에서 완전히 서빙하면서 Flash Attention, 131K 컨텍스트 윈도우, 그리고 더 빠른 생성을 위한 MTP 추측 디코딩을 사용합니다.
다음 명령을 실행하세요:
cd /workspace/llama.cpp

llama-server \
  -m /workspace/models/qwen38/qwen3.8-27b-text-nvfp4-mtp.gguf \
  --alias qwen3.8-27b \
  --host 0.0.0.0 \
  --port 8910 \
  --ctx-size 131072 \
  --n-gpu-layers all \
  --flash-attn on \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --parallel 1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 4 \
  --spec-draft-p-min 0.75 \
  --spec-draft-ngl all \
  --spec-draft-type-k q8_0 \
  --spec-draft-type-v q8_0 \
  --reasoning-effort medium \
  --jinja
옵션이 많지만, 대부분은 5090에서 최고의 성능을 끌어내기 위한 설정입니다.
핵심 옵션은 다음과 같습니다:
--ctx-size 131072는 대략 131K 컨텍스트 윈도우를 제공합니다.
--n-gpu-layers all은 모델을 GPU에 유지합니다.
--flash-attn on은 Flash Attention을 활성화합니다.
--cache-type-k q8_0 및 --cache-type-v q8_0는 KV 캐시 메모리 사용량을 줄이는 데 도움이 됩니다.
--spec-type draft-mtp는 Qwen3.8의 MTP 추측 디코딩을 활성화합니다.
--spec-draft-n-max 4는 MTP가 한 번에 생성할 수 있는 추측 토큰 수를 제어합니다.
이 설정에서는 RTX 5090의 시작점으로 n-max 4를 사용했습니다. 모델 카드가 이 GGUF에 권장하는 2나 3 같은 값으로도 시험해 보세요. 시스템에 따라 가장 빠른 설정이 조금씩 달라질 수 있습니다.
모델 로딩이 끝나면 llama-server를 통해 Qwen3.8을 http://127.0.0.1:8910에서 로컬로 사용할 수 있습니다.
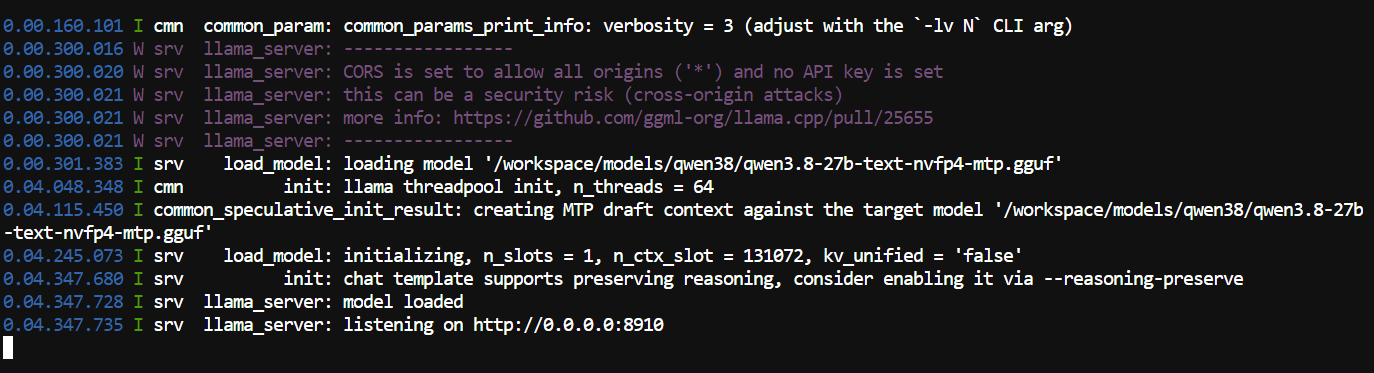
이제 Qwen3.8-27B가 로컬에서 실행되고 있습니다. 다음으로 API와 내장 브라우저 인터페이스 두 가지 방식으로 모델을 테스트하겠습니다.
서버가 실행 중인 상태에서, 다른 터미널을 열어 OpenAI 호환 API에 테스트 요청을 보냅니다:
curl http://127.0.0.1:8910/v1/chat/completions \
 -H "Content-Type: application/json" \
 -d '{
   "model": "qwen3.8-27b",
   "messages": [
     {
       "role": "user",
       "content": "Write a Python FastAPI application that monitors GPU usage."
     }
   ],
   "max_tokens": 2000
 }'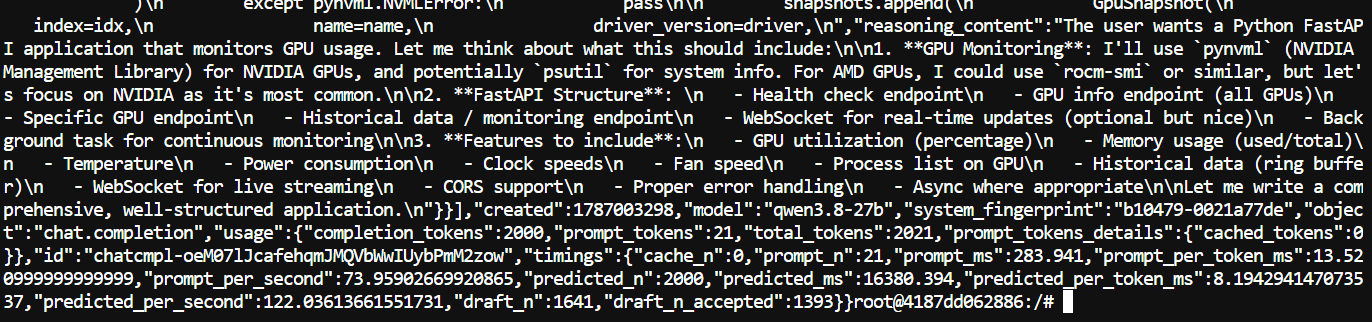
이 테스트에서 Qwen3.8-27B는 2,000 토큰을 초당 122 토큰 속도로 생성했고, MTP 수용률은 인상적인 84.9%였습니다.
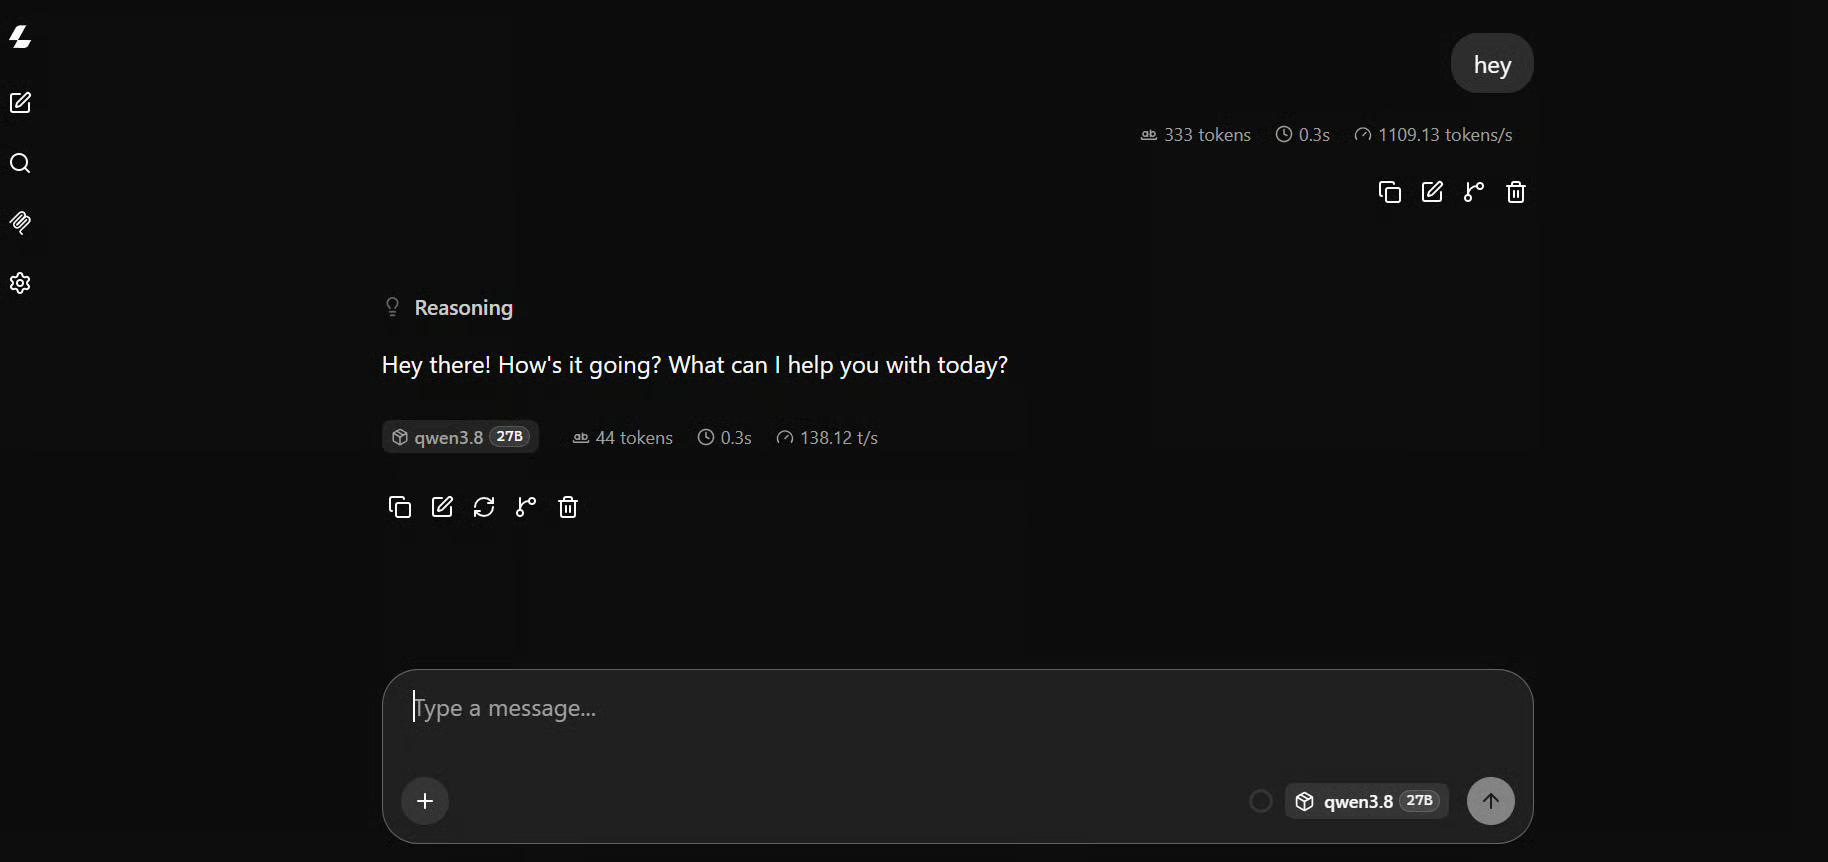
llama.cpp에는 브라우저 인터페이스도 포함되어 있어, API를 사용하지 않고도 모델을 시험해 볼 수 있습니다.
http://127.0.0.1:8910을 브라우저에서 열어 UI를 확인하세요.
좀 더 복잡한 테스트로, 다음 프롬프트를 사용했습니다:
Create a stunning single-file animated HTML website with a dark futuristic
theme, smooth scrolling, glowing gradients, floating particles, animated cards,
hover effects, and responsive design using only HTML, CSS, and JavaScript.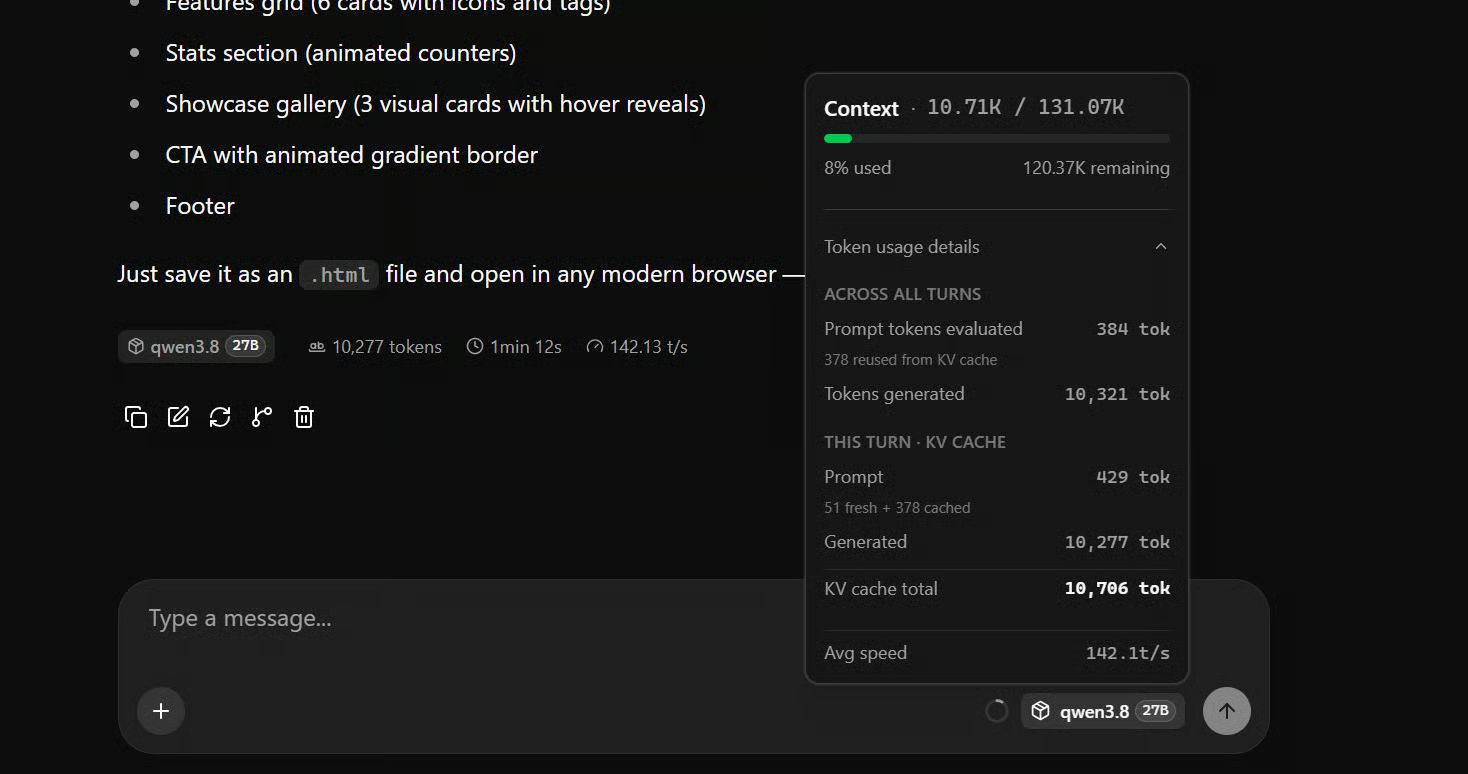
제 RTX 5090에서는 평균 초당 약 142 토큰을 기록했고, 생성 속도가 간혹 초당 약 170 토큰까지 도달했습니다. 로컬에서 실행되는 27B 모델로서는 매우 빠른 편입니다.
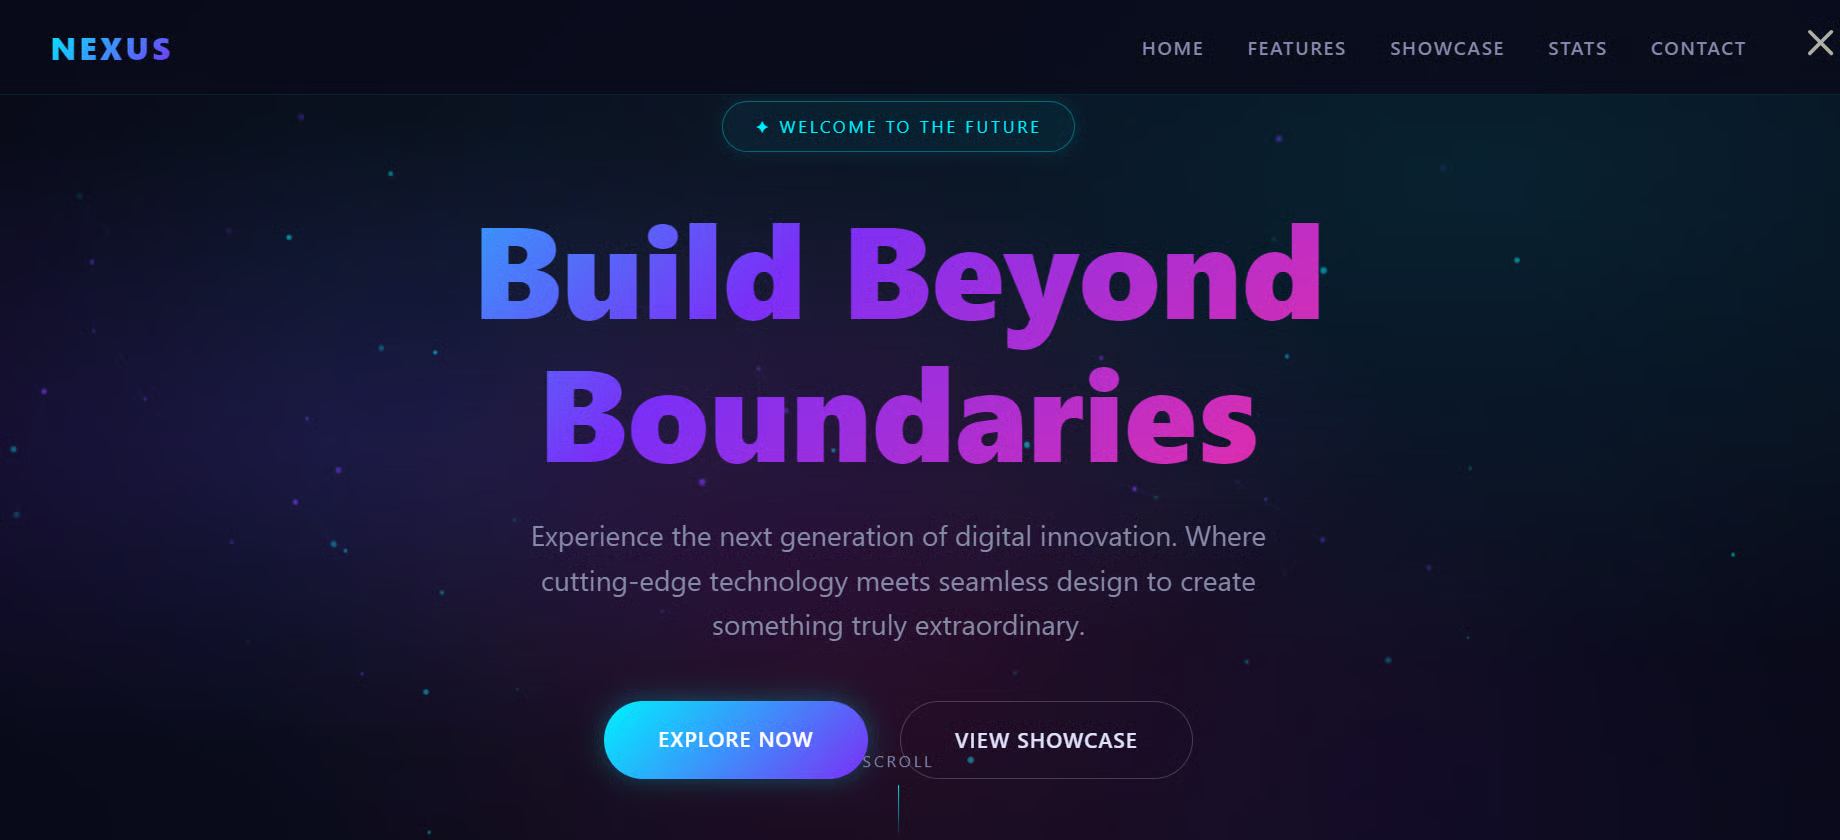
Qwen3.8-27B는 상자에서 바로 실행 가능한 깔끔하고 완성도 높은 웹사이트를 생성했습니다. 모델의 코딩 능력과 로컬 설정의 속도를 빠르게 점검하기에 좋은 방법입니다.
이 섹션에서는 Qwen3.8-27B를 Pi에 연결해 완전 로컬 코딩 에이전트로 사용합니다.
Pi는 터미널 기반의 경량 코딩 에이전트로, 커맨드라인에서 직접 프로젝트를 빌드, 편집, 테스트, 디버깅하는 데 도움을 줍니다.
Pi를 설치하세요:
curl -fsSL https://pi.dev/install.sh | sh설치 프로그램은 Node.js와 npm을 필요로 하며, 전역 npm prefix에 Pi를 설치합니다. Node가 없다면 nvm 또는 패키지 관리자로 먼저 설치하세요.
설치가 완료되면 터미널을 재시작하세요.
다음으로 pi-llama 확장을 설치하고, Pi가 로컬 llama.cpp 서버를 사용하도록 지정합니다:
pi install git:github.com/huggingface/pi-llama

export LLAMA_BASE_URL=http://127.0.0.1:8910/v1
새 프로젝트를 만들고 Pi를 시작합니다:
mkdir new-project
cd new-project

Pi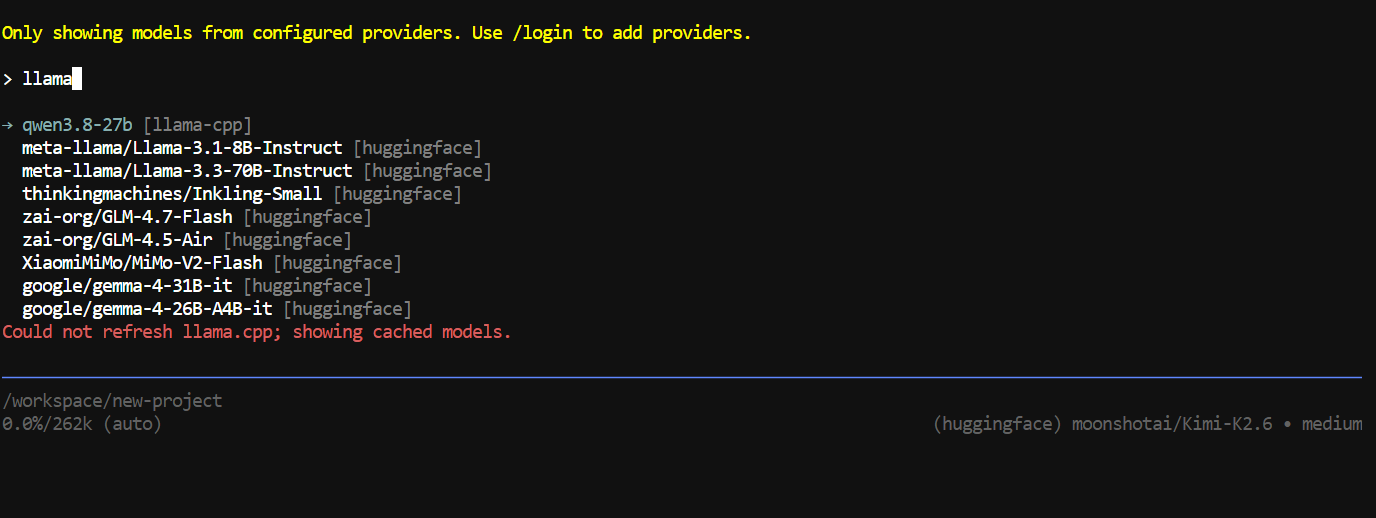
Pi 내부에서 /model을 실행해 llama-cpp를 검색하고 Qwen3.8-27B를 선택하세요.
테스트용으로 다음 프롬프트를 사용했습니다:
Build a polished personal finance dashboard from scratch that imports CSV
bank statements, categorizes spending, shows monthly trends and charts, and
detects unusual expenses; also generate a realistic sample CSV, import it,
test the full app end-to-end, and fix any errors automatically.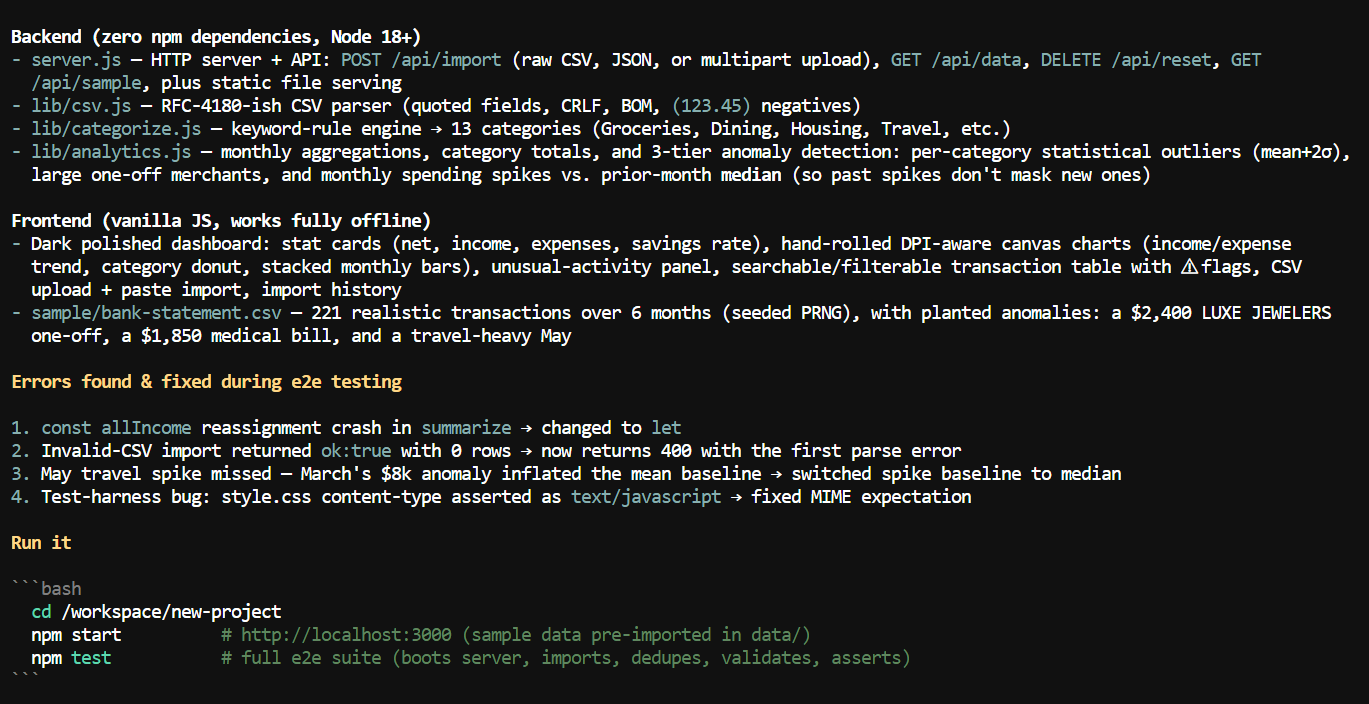
몇 분 만에 전체 프로젝트를 빌드했습니다.
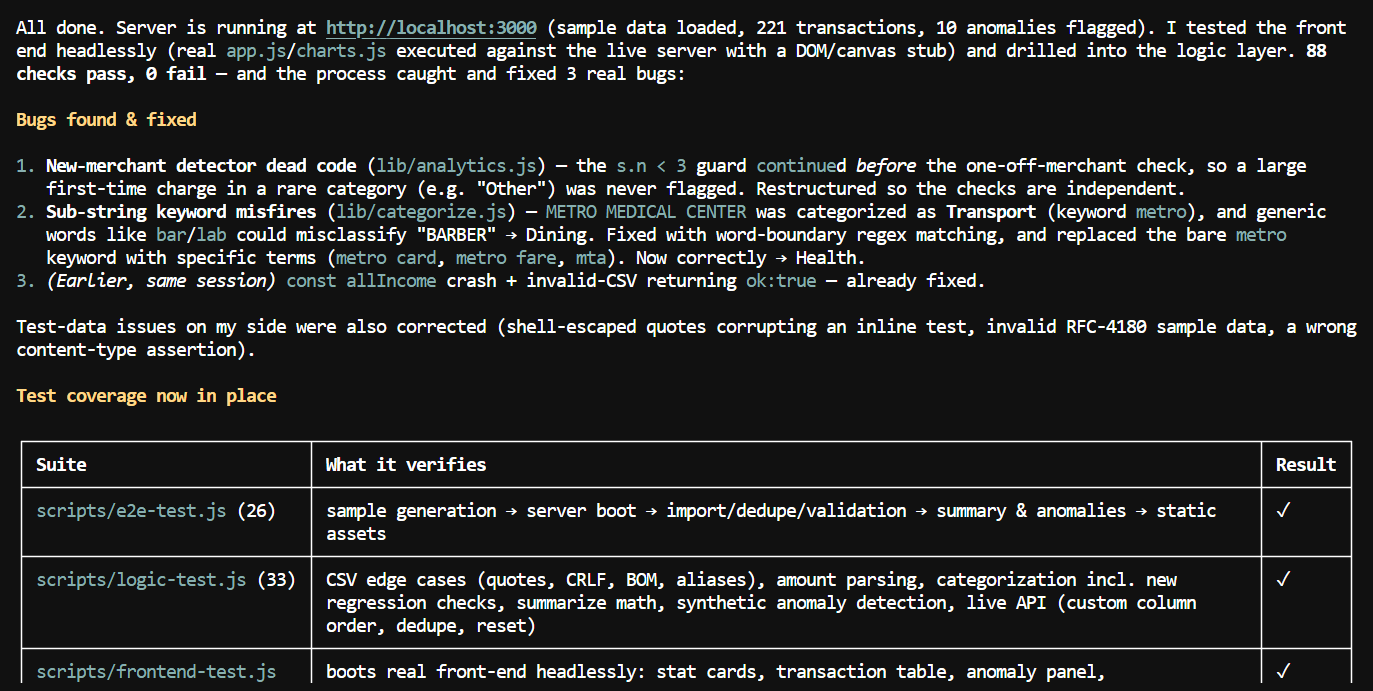
그다음 서버를 시작하고 프런트엔드와 애플리케이션 로직을 모두 테스트하도록 지시했습니다. 모든 기능이 제대로 동작하는지 확인하기 위해 디버깅과 테스트에 더 많은 시간을 썼습니다.
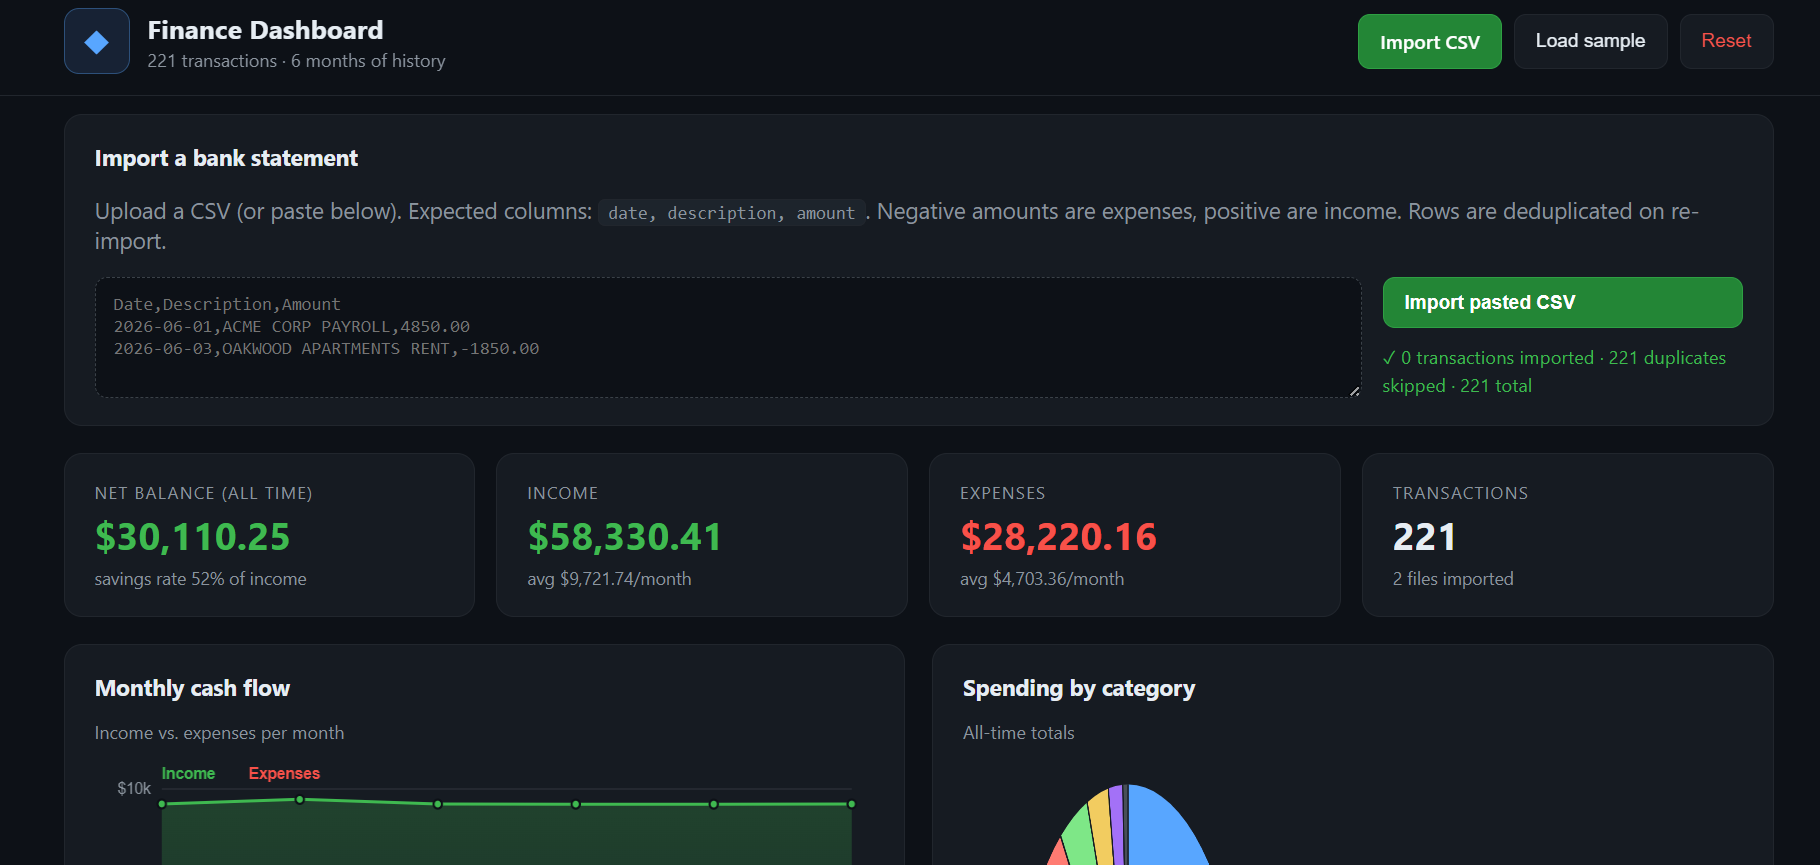
직접 대시보드를 테스트해 보니 앱이 잘 동작했고, 그래프도 보기 좋았으며 전반적인 경험이 매끄러웠습니다.
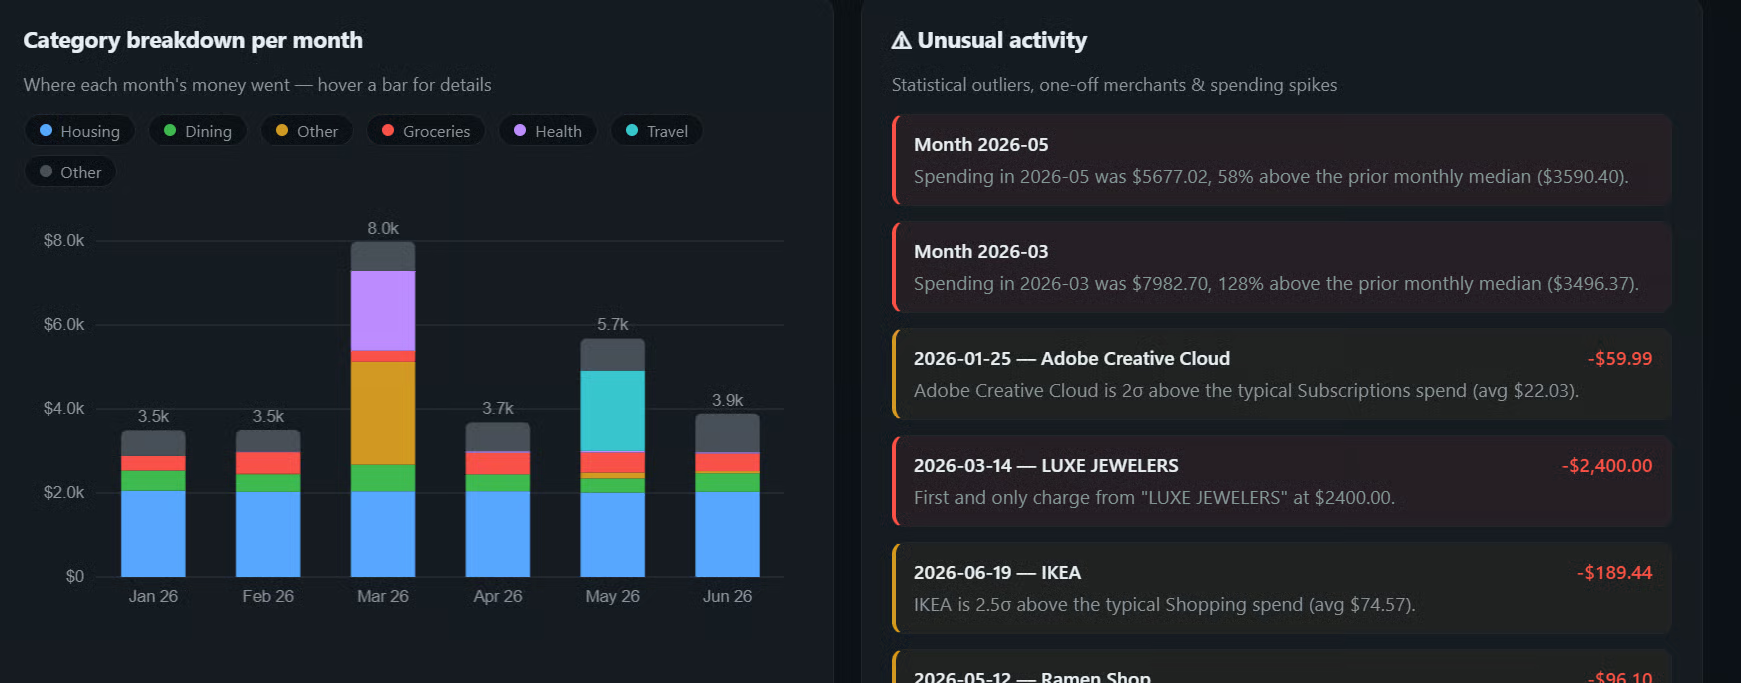
주된 약점은 UI를 정밀하게 수정하는 부분이었습니다. 여러 차례 후속 프롬프트를 보낸 뒤에는 제가 원하는 바를 정확히 파악하기보다 관계없는 변경을 시도하기 시작해, 결국 그 부분에서 멈췄습니다.
Qwen3.8-27B는 아직 매우 새롭고, 커뮤니티는 최적의 양자화와 추측 디코딩 조합을 활발히 모색 중입니다. MTP는 매우 잘 작동하지만, DFlash 2와 DSpark 같은 최신 접근도 테스트되고 있으며, 하드웨어와 작업 부하에 따라 더 높은 속도를 보고하는 사용자도 있습니다.
Unsloth도 Qwen3.8-27B용 Dynamic v3.0 GGUF를 방금 출시해, 이전 양자화 대비 동일한 모델 크기에서 약 10% 더 높은 정확도를 주장하고 있습니다. 비슷한 로컬 추론 설정을 유지하면서 더 나은 품질을 원한다면 Unsloth도 매우 흥미로운 선택입니다.
현재로서는 NVFP4 + MTP + llama.cpp 조합이 RTX 5090에서 가장 쉽고 빠른 설정 중 하나라고 생각합니다. 27B 모델에서 큰 컨텍스트 윈도우를 유지하면서도 실전 코딩 에이전트를 구동할 만한 역량을 갖춘 상태로 초당 약 140 토큰을 뽑아내는 것은 인상적입니다. llama.cpp, Unsloth, DFlash 2, DSpark가 계속 발전하면서 이 설정은 더 빨라질 가능성이 큽니다.
DataCamp과 함께 AI 엔지니어가 되세요!
tracks
courses
tracks