
Leerpad
Associate AI Engineer voor ontwikkelaars
26 uur
Eerst zorgen we dat de GPU goed wordt gedetecteerd en controleren we de NVIDIA-driver en CUDA-versie.
nvidia-smi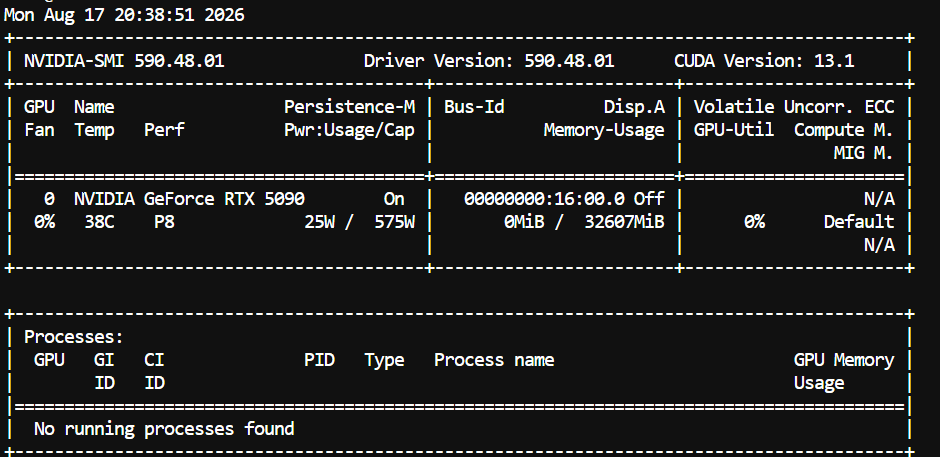
Je zou je RTX 5090, driverversie, CUDA-versie, GPU-geheugen en huidig GPU-gebruik moeten zien.
Let op: Deze setup is specifiek voor NVIDIA Blackwell-GPU's, zoals de RTX 5090. De build hieronder richt zich op SM120, de compute-architectuur die door de RTX 5090 wordt gebruikt.
Vervolgens downloaden en compileren we de nieuwste versie van llama.cpp met CUDA-ondersteuning.
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp

cmake -B build \
  -DGGML_CUDA=ON \
  -DCMAKE_CUDA_ARCHITECTURES=120

cmake --build build --config Release -j$(nproc)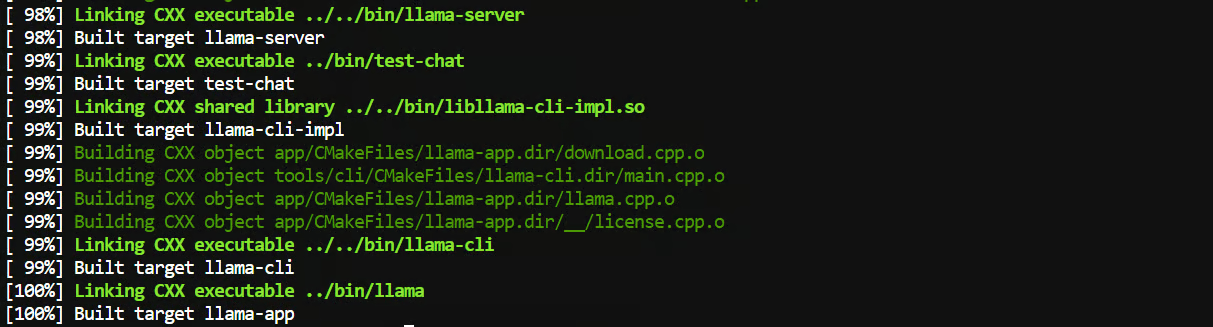
Het belangrijkste hier is -DCMAKE_CUDA_ARCHITECTURES=120. Dit vertelt llama.cpp om specifiek te bouwen voor de Blackwell-architectuur die de RTX 5090 gebruikt.
Als de build klaar is, maken we llama-server globaal beschikbaar zodat we het vanuit elke map kunnen draaien:
sudo ln -sf "$(realpath ./build/bin/llama-server)" /usr/local/bin/llama-serverControleer nu of alles werkt:
llama-server --versionJe zou een output moeten krijgen zoals:
version: 0.1.1-dev (build 10479, commit 0021a77de)
built with GNU 13.3.0 for Linux x86_64
Dat is het. We hebben nu een CUDA-enabled llama.cpp-build die gebruik kan maken van de RTX 5090 en de native Blackwell NVFP4-ondersteuning.
Nu downloaden we het Qwen3.8-27B-model.
Installeer eerst de Hugging Face CLI:
pip install -U huggingface_hubMaak een map waarin we het model bewaren:
mkdir -p /workspace/models/qwen38Download vervolgens de NVFP4-MTP GGUF:
hf download felippeburk/Qwen3.8-27B-NVFP4-MTP-GGUF \
  --local-dir /workspace/models/qwen38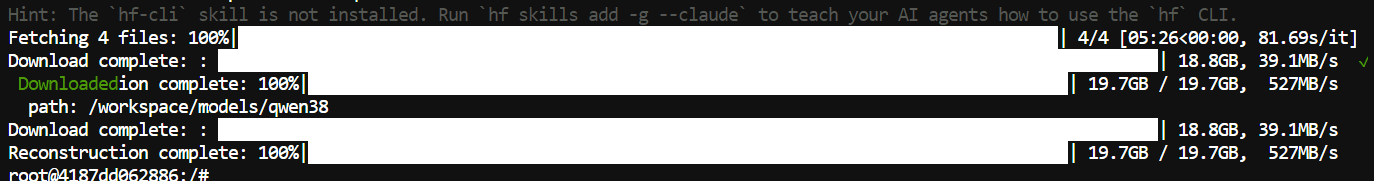
Dit is de versie die we voor deze setup willen, omdat deze NVFP4 gebruikt en MTP-ondersteuning bevat. Daar komt een groot deel van de snelheidswinst op de RTX 5090 vandaan.
Nu komt het leuke gedeelte. We serveren Qwen3.8-27B volledig op de GPU met Flash Attention, een 131K contextvenster en MTP-speculatieve decodering voor snellere generatie.
Draai:
cd /workspace/llama.cpp

llama-server \
  -m /workspace/models/qwen38/qwen3.8-27b-text-nvfp4-mtp.gguf \
  --alias qwen3.8-27b \
  --host 0.0.0.0 \
  --port 8910 \
  --ctx-size 131072 \
  --n-gpu-layers all \
  --flash-attn on \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --parallel 1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 4 \
  --spec-draft-p-min 0.75 \
  --spec-draft-ngl all \
  --spec-draft-type-k q8_0 \
  --spec-draft-type-v q8_0 \
  --reasoning-effort medium \
  --jinja
Er zijn hier veel opties, maar de meeste zijn er simpelweg om de beste prestaties uit de 5090 te halen.
De belangrijkste om te kennen:
--ctx-size 131072 geeft ons grofweg een contextvenster van 131K.
--n-gpu-layers all houdt het model op de GPU.
--flash-attn on schakelt Flash Attention in.
--cache-type-k q8_0 en --cache-type-v q8_0 helpen het KV-cachegeheugen te verminderen.
--spec-type draft-mtp schakelt Qwen3.8's MTP-speculatieve decodering in.
--spec-draft-n-max 4 bepaalt hoeveel speculatieve tokens MTP tegelijk kan genereren.
Voor deze setup gebruiken we n-max 4 als startpunt voor een RTX 5090. Je kunt later experimenteren met waarden zoals 2 (dat raadt de modelkaart aan voor deze GGUF) of 3, omdat de snelste instelling licht kan variëren per systeem.
Zodra llama-server klaar is met het laden van het model, is Qwen3.8 lokaal beschikbaar op http://127.0.0.1:8910.
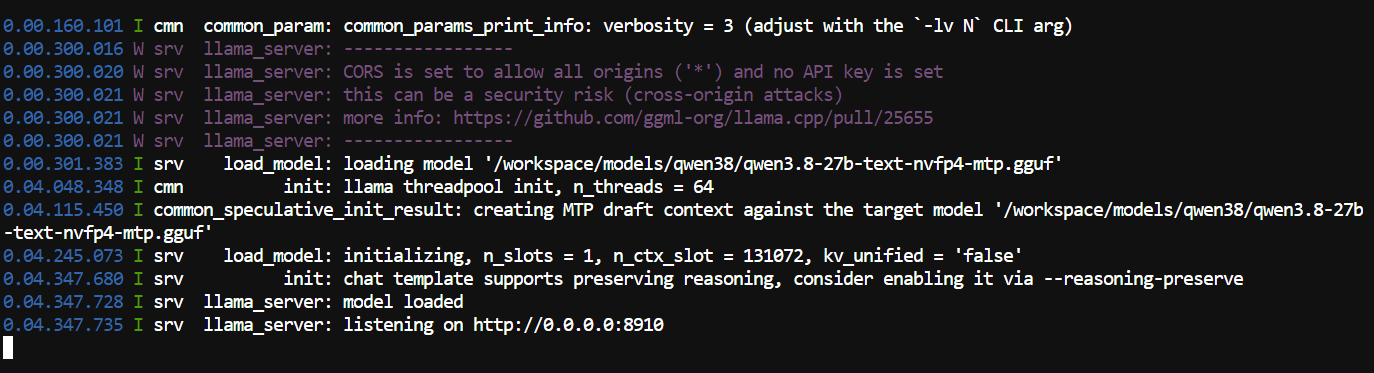
We hebben Qwen3.8-27B nu lokaal draaiend. Daarna testen we het model via zowel de API als de ingebouwde browserinterface.
Met de server draaiend, open je een andere terminal en stuur je een testrapport naar de OpenAI-compatibele API:
curl http://127.0.0.1:8910/v1/chat/completions \
 -H "Content-Type: application/json" \
 -d '{
   "model": "qwen3.8-27b",
   "messages": [
     {
       "role": "user",
       "content": "Write a Python FastAPI application that monitors GPU usage."
     }
   ],
   "max_tokens": 2000
 }'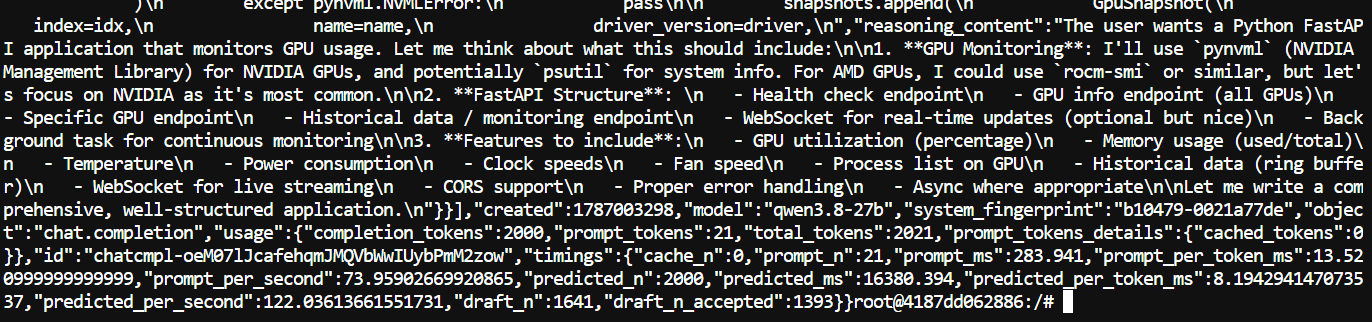
In deze test genereerde Qwen3.8-27B 2.000 tokens met 122 tokens/sec en een indrukwekkend MTP-acceptatiepercentage van 84,9%.
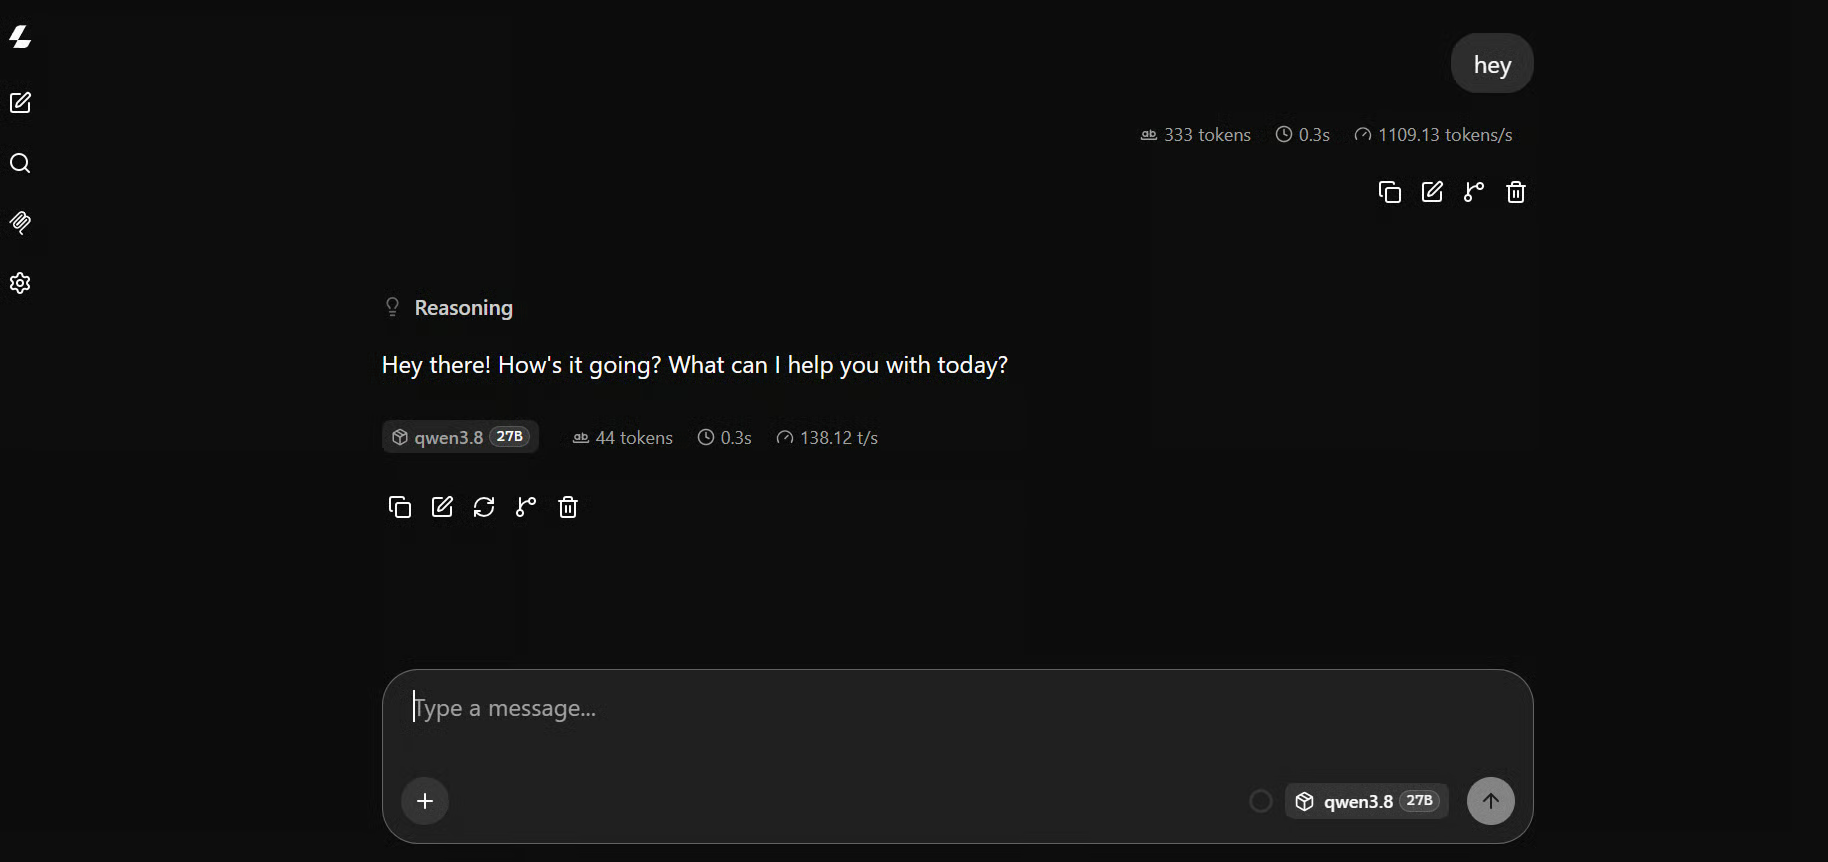
llama.cpp bevat ook een browserinterface, zodat je het model kunt testen zonder de API te gebruiken.
Open http://127.0.0.1:8910 in je browser om de UI te bekijken.
Voor een complexere test gebruikte ik deze prompt:
Create a stunning single-file animated HTML website with a dark futuristic
theme, smooth scrolling, glowing gradients, floating particles, animated cards,
hover effects, and responsive design using only HTML, CSS, and JavaScript.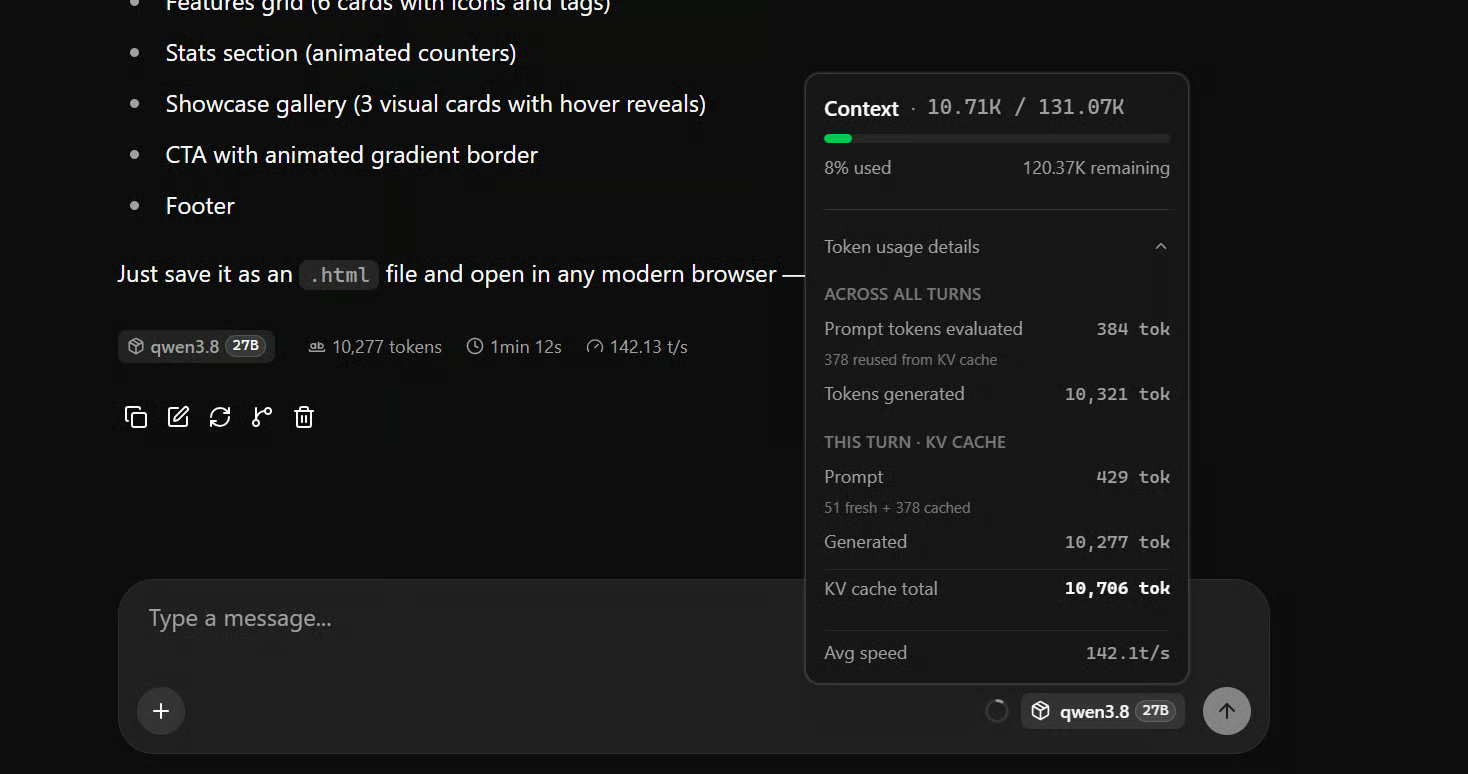
Op mijn RTX 5090 haalde ik gemiddeld zo'n 142 tokens per seconde, met uitschieters tot ongeveer 170 tokens per seconde. Dat is extreem snel voor een 27B-model dat lokaal draait.
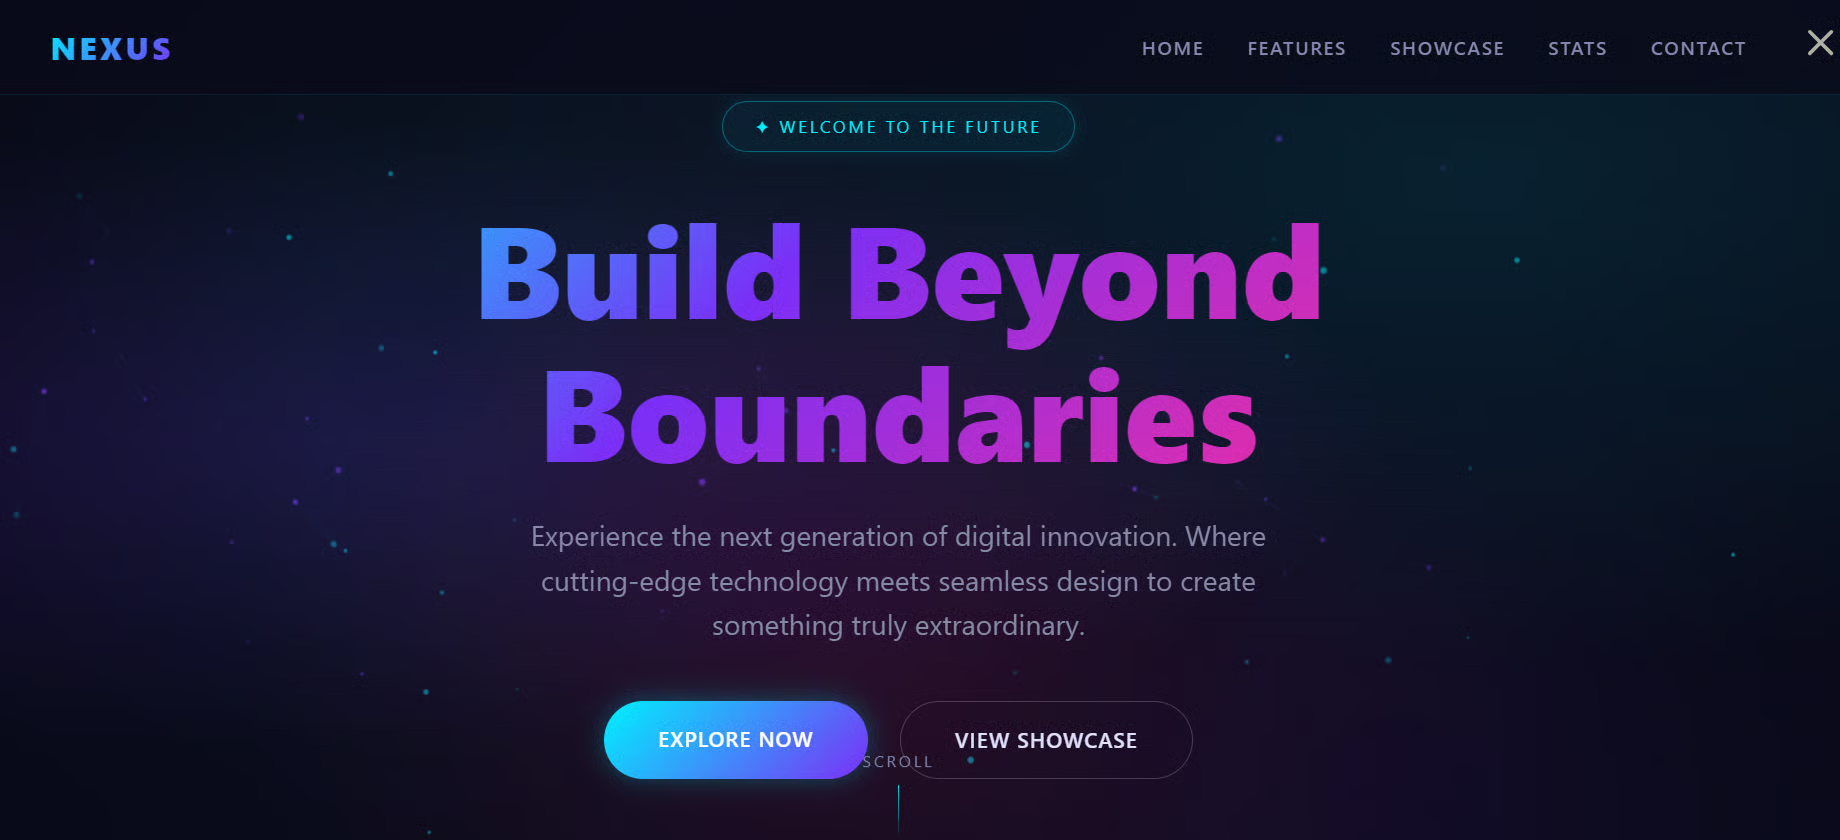
Qwen3.8-27B genereerde een gepolijste, volledig werkende website die meteen draaide. Dit is een goede manier om snel zowel het coderingsvermogen van het model als de snelheid van je lokale setup te testen.
In deze sectie koppelen we Qwen3.8-27B aan Pi en gebruiken we het als een volledig lokale coding agent.
Pi is een lichtgewicht, terminalgebaseerde coding agent die je kan helpen projecten te bouwen, bewerken, testen en debuggen rechtstreeks vanaf de command line.
Installeer Pi met:
curl -fsSL https://pi.dev/install.sh | shDe installer vereist Node.js en npm. Het installeert Pi in je globale npm-prefix. Als je nog geen Node hebt, installeer dat dan eerst met nvm of je pakketmanager.
Zodra de installatie klaar is, herstart je je terminal.
Installeer vervolgens de pi-llama-extensie en wijs Pi naar onze lokale llama.cpp-server:
pi install git:github.com/huggingface/pi-llama

export LLAMA_BASE_URL=http://127.0.0.1:8910/v1
Maak een nieuw project en start Pi:
mkdir new-project
cd new-project

Pi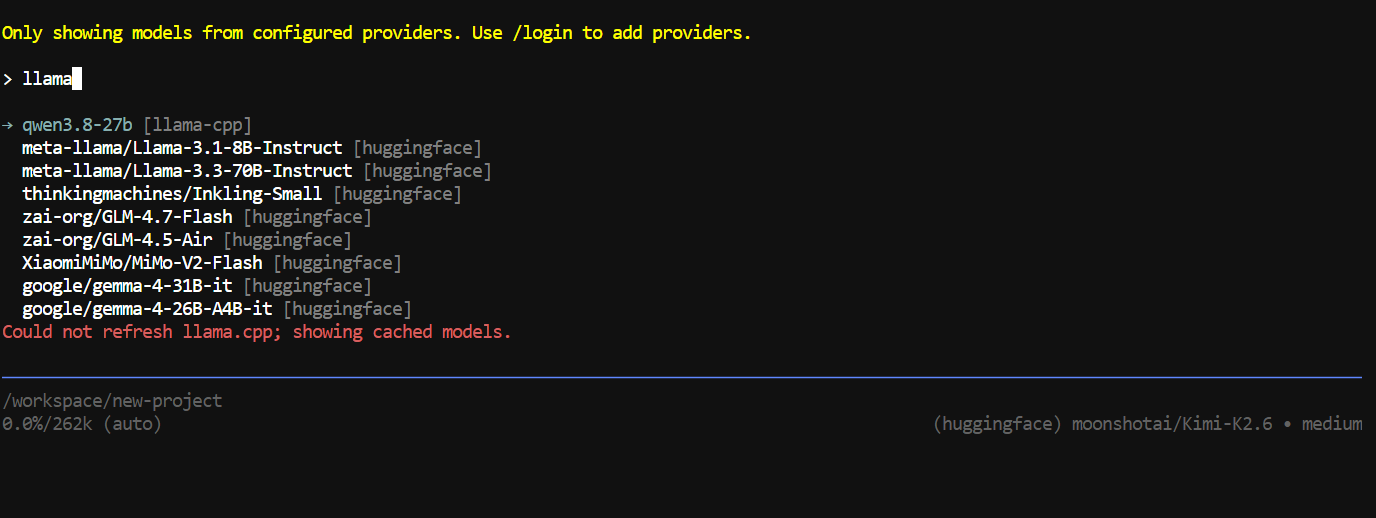
Binnen Pi voer je /model uit, zoek je naar llama-cpp en selecteer je Qwen3.8-27B.
Voor de test gaf ik deze prompt:
Build a polished personal finance dashboard from scratch that imports CSV
bank statements, categorizes spending, shows monthly trends and charts, and
detects unusual expenses; also generate a realistic sample CSV, import it,
test the full app end-to-end, and fix any errors automatically.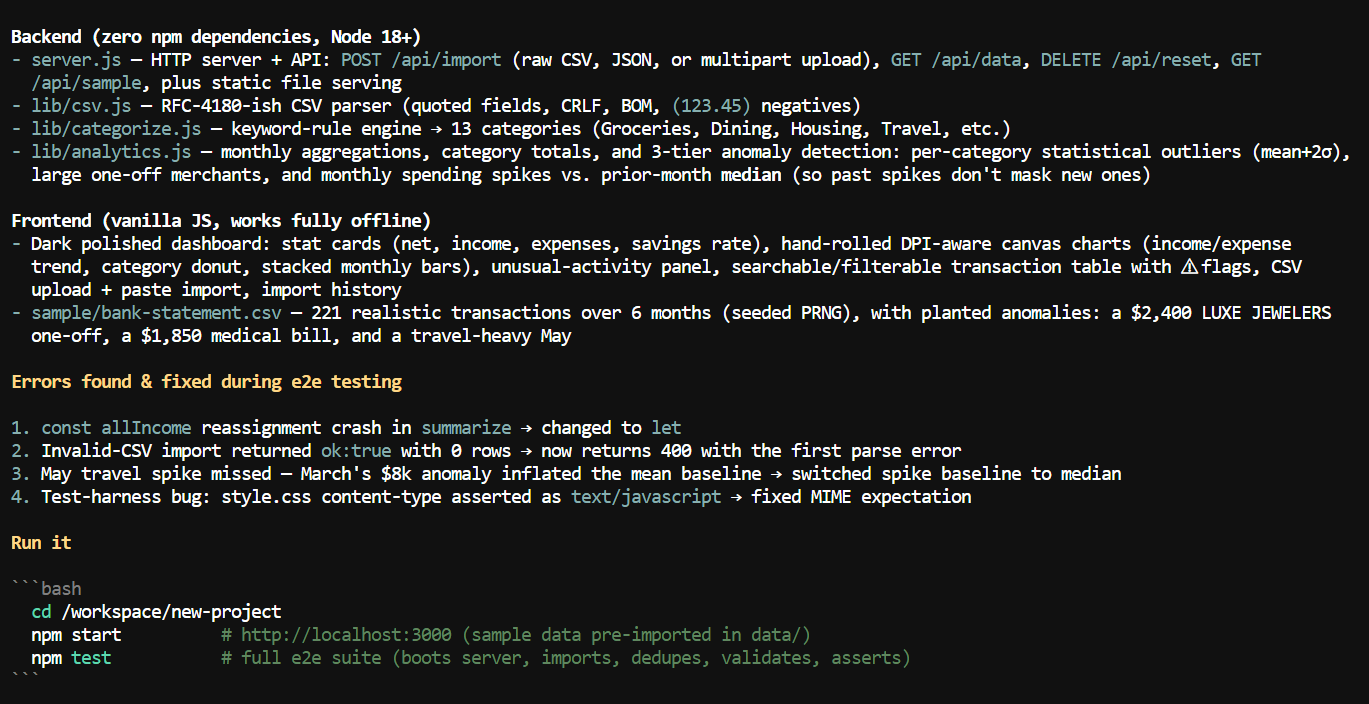
Het bouwde het hele project binnen een paar minuten.
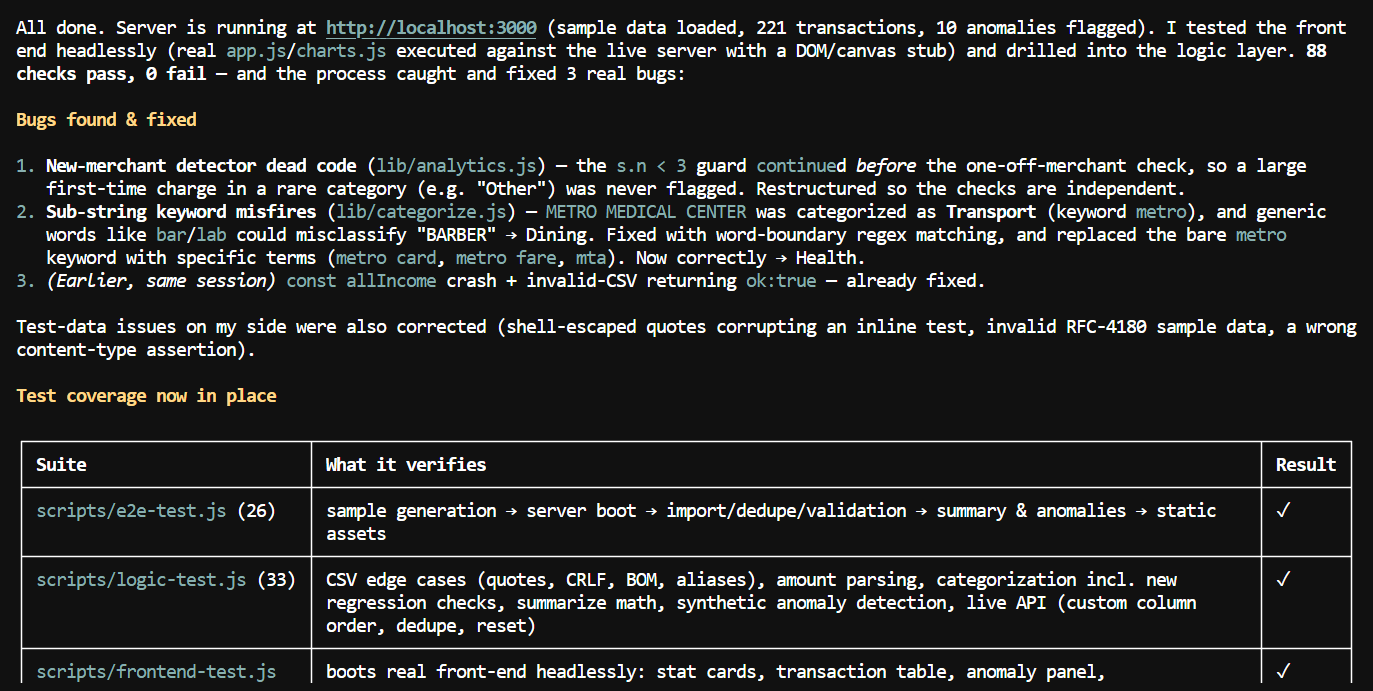
Daarna vroeg ik om de server te starten en zowel de frontend als de applicatielogica te testen. Het besteedde meer tijd aan debuggen en testen om te zorgen dat alles goed werkte.
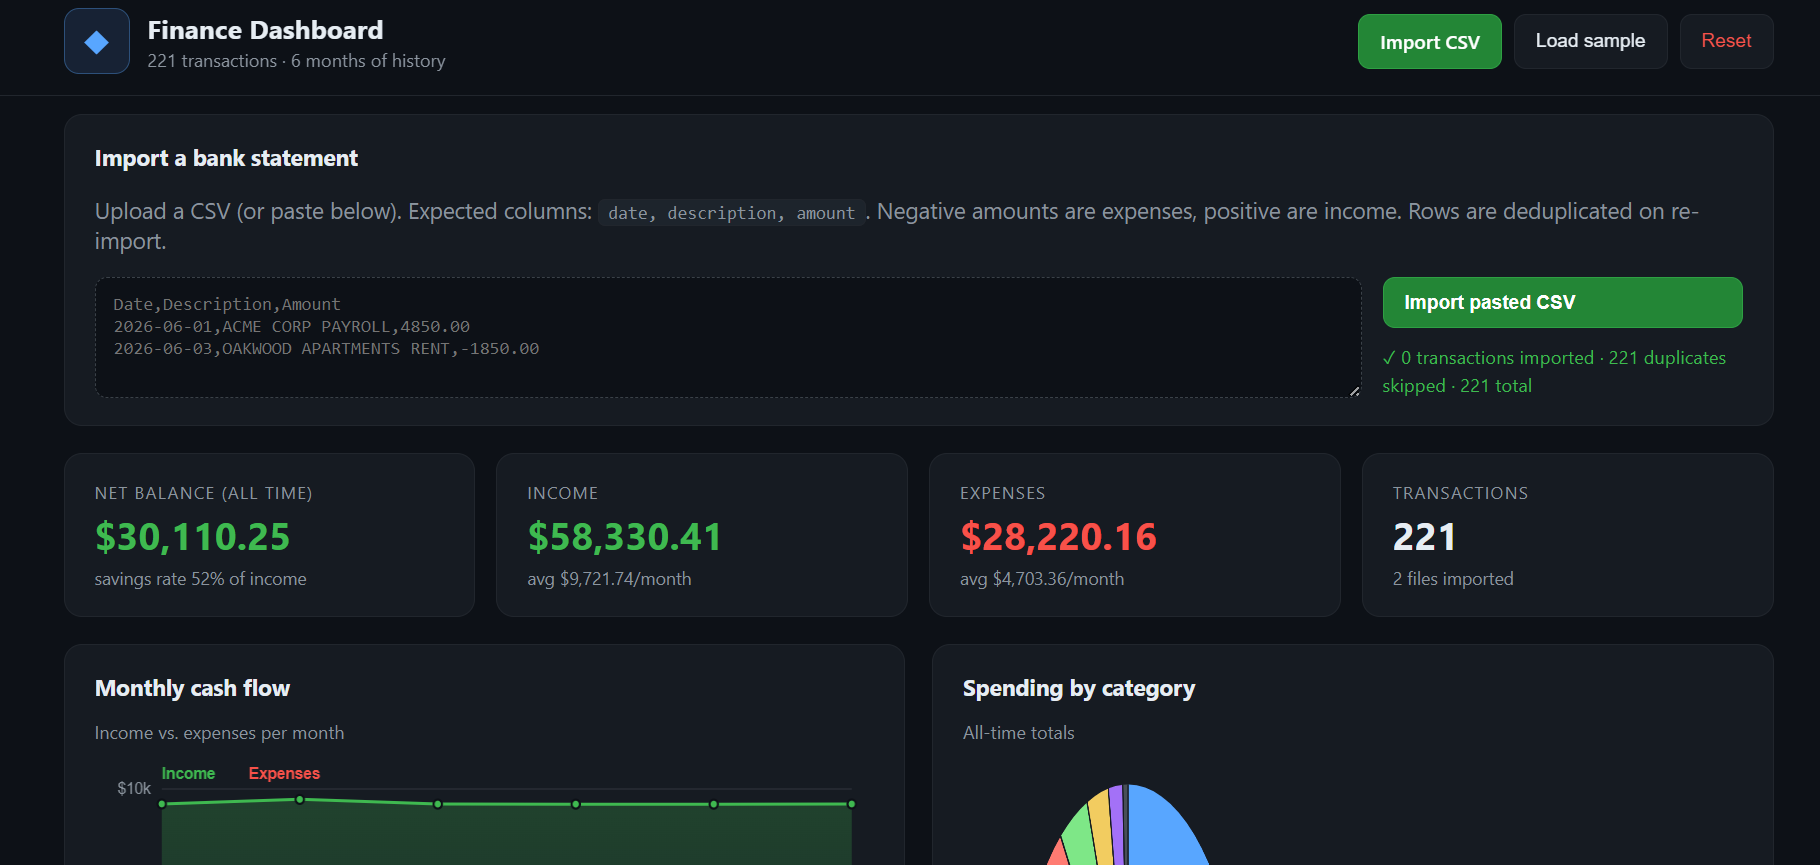
Toen ik het dashboard zelf testte, werkte de app goed, zagen de grafieken er top uit en was de algehele ervaring soepel.
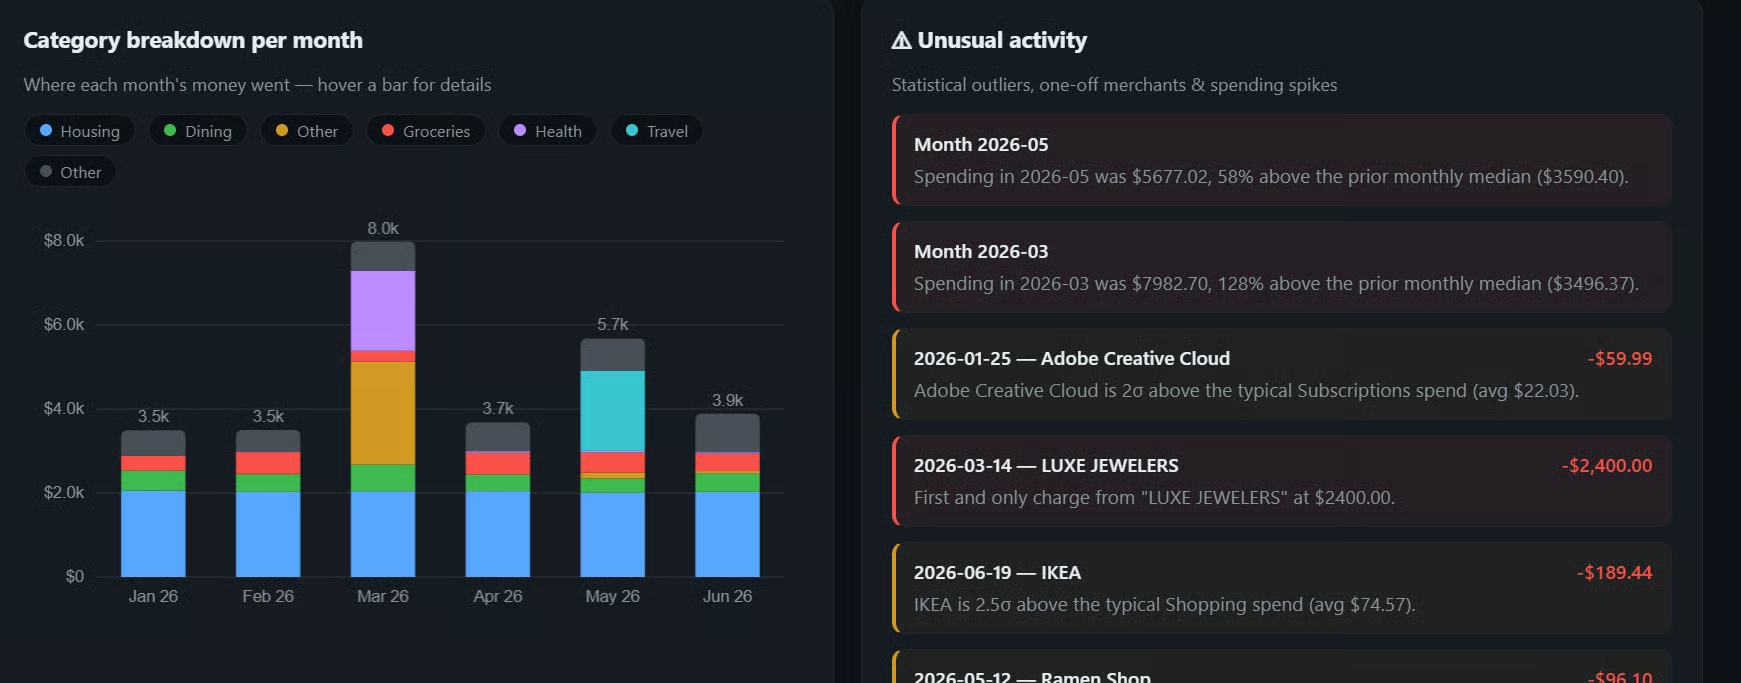
De grootste zwakte was het maken van precieze UI-wijzigingen. Na meerdere vervolgprompts begon het ongerelateerde wijzigingen te maken in plaats van precies te begrijpen wat ik wilde, dus daar ben ik uiteindelijk gestopt.
Qwen3.8-27B is nog erg nieuw en de community zoekt actief naar de beste combinatie van kwantisatie en speculatieve decodering. MTP werkt uitzonderlijk goed, maar nieuwere benaderingen zoals DFlash 2 en DSpark worden ook getest, waarbij sommige gebruikers nog hogere snelheden melden afhankelijk van hardware en workload.
Unsloth heeft ook net Dynamic v3.0 GGUF's voor Qwen3.8-27B uitgebracht, met de claim van zo'n 10% hogere nauwkeurigheid bij dezelfde modelgrootte vergeleken met eerdere quants. Dat maakt Unsloth een andere zeer interessante optie als je betere kwaliteit wilt terwijl je ruwweg dezelfde lokale inferentiesetup behoudt.
Voor nu vind ik NVFP4 + MTP + llama.cpp een van de makkelijkste en snelste setups voor een RTX 5090. Ongeveer 140 tokens per seconde halen met een 27B-model terwijl je toch een groot contextvenster hebt en genoeg vermogen om een echte coding agent te draaien, is indrukwekkend. De setup zal waarschijnlijk nog sneller worden naarmate llama.cpp, Unsloth, DFlash 2 en DSpark blijven verbeteren.
Word AI Engineer met DataCamp!
Leerpad
Cursus
Leerpad
blog
Adel Nehme
15 min

