แทร็ก
วิศวกร AI ระดับ Associate สำหรับนักพัฒนา
26 ชม.
ก่อนอื่น ตรวจสอบให้แน่ใจว่าเครื่องมองเห็น GPU ถูกต้อง และเช็กเวอร์ชันไดรเวอร์ NVIDIA และ CUDA
nvidia-smi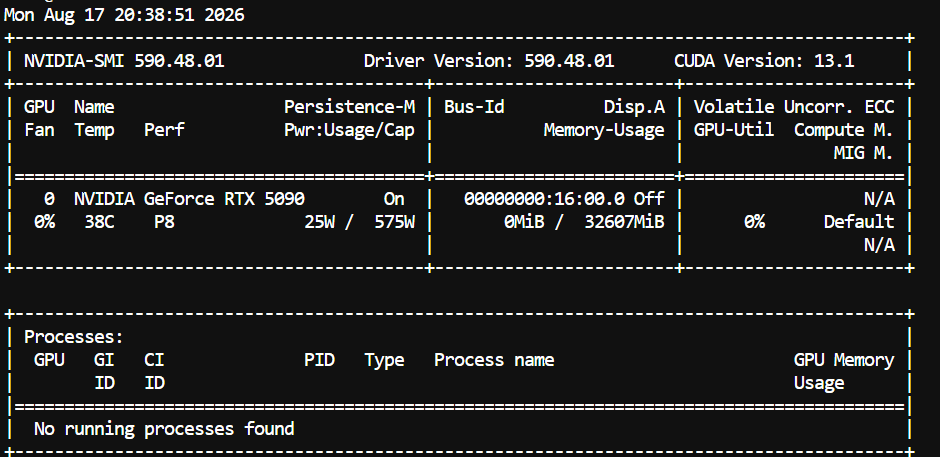
ควรเห็น RTX 5090 ของเครื่อง เวอร์ชันไดรเวอร์ เวอร์ชัน CUDA หน่วยความจำ GPU และการใช้งาน GPU ปัจจุบัน
หมายเหตุ: การตั้งค่านี้ออกแบบมาสำหรับ GPU ตระกูล NVIDIA Blackwell โดยเฉพาะ เช่น RTX 5090 โดยบิลด์ด้านล่างจะกำหนดเป้าหมาย SM120 ซึ่งเป็นสถาปัตยกรรมคอมพิวต์ที่ใช้ใน RTX 5090
ต่อไปจะดาวน์โหลดและคอมไพล์ llama.cpp เวอร์ชันล่าสุดพร้อมรองรับ CUDA
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp

cmake -B build \
  -DGGML_CUDA=ON \
  -DCMAKE_CUDA_ARCHITECTURES=120

cmake --build build --config Release -j$(nproc)
ส่วนสำคัญคือ -DCMAKE_CUDA_ARCHITECTURES=120 ตัวเลือกนี้บอกให้ llama.cpp บิลด์สำหรับสถาปัตยกรรม Blackwell ที่ใช้ใน RTX 5090 โดยเฉพาะ
เมื่อบิลด์เสร็จ จะทำให้ llama-server ใช้งานได้ทั่วทั้งระบบเพื่อจะได้รันจากโฟลเดอร์ใดก็ได้:
sudo ln -sf "$(realpath ./build/bin/llama-server)" /usr/local/bin/llama-serverตอนนี้ให้ตรวจสอบว่าใช้งานได้ปกติ:
llama-server --versionควรเห็นเอาต์พุตลักษณะคล้ายนี้:
version: 0.1.1-dev (build 10479, commit 0021a77de)
built with GNU 13.3.0 for Linux x86_64
เรียบร้อย ขณะนี้เรามีบิลด์ llama.cpp ที่รองรับ CUDA สามารถใช้ประโยชน์จาก RTX 5090 และการรองรับ NVFP4 ของ Blackwell โดยกำเนิดได้
ต่อไปจะดาวน์โหลดโมเดล Qwen3.8-27B
ขั้นแรก ติดตั้ง Hugging Face CLI:
pip install -U huggingface_hubสร้างโฟลเดอร์สำหรับเก็บโมเดล:
mkdir -p /workspace/models/qwen38จากนั้นดาวน์โหลด NVFP4-MTP GGUF:
hf download felippeburk/Qwen3.8-27B-NVFP4-MTP-GGUF \
  --local-dir /workspace/models/qwen38
นี่คือเวอร์ชันที่ต้องการสำหรับการตั้งค่านี้ เพราะใช้ NVFP4 และมีการรองรับ MTP ที่เป็นแหล่งหลักของการเพิ่มความเร็วบน RTX 5090
มาถึงส่วนที่สนุกกัน เราจะให้บริการ Qwen3.8-27B บน GPU เต็มรูปแบบพร้อม Flash Attention หน้าต่างคอนเท็กซ์ 131K และ MTP speculative decoding เพื่อการสร้างข้อความที่เร็วขึ้น
รัน:
cd /workspace/llama.cpp

llama-server \
  -m /workspace/models/qwen38/qwen3.8-27b-text-nvfp4-mtp.gguf \
  --alias qwen3.8-27b \
  --host 0.0.0.0 \
  --port 8910 \
  --ctx-size 131072 \
  --n-gpu-layers all \
  --flash-attn on \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --parallel 1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 4 \
  --spec-draft-p-min 0.75 \
  --spec-draft-ngl all \
  --spec-draft-type-k q8_0 \
  --spec-draft-type-v q8_0 \
  --reasoning-effort medium \
  --jinja
มีออปชันค่อนข้างมาก แต่ส่วนใหญ่มีไว้เพื่อรีดสมรรถนะจาก 5090 ให้ดีที่สุด
ออปชันหลักที่ควรรู้คือ:
--ctx-size 131072 ให้หน้าต่างคอนเท็กซ์ประมาณ 131K
--n-gpu-layers all ทำให้โมเดลทำงานบน GPU ตลอด
--flash-attn on เปิดใช้ Flash Attention
--cache-type-k q8_0 และ --cache-type-v q8_0 ช่วยลดการใช้หน่วยความจำ KV cache
--spec-type draft-mtp เปิดใช้ MTP speculative decoding ของ Qwen3.8
--spec-draft-n-max 4 ควบคุมจำนวนโทเค็นแบบ speculative ที่ MTP สามารถสร้างได้ต่อครั้ง
สำหรับการตั้งค่านี้ ใช้ค่า n-max 4 เป็นจุดเริ่มต้นสำหรับ RTX 5090 สามารถทดลองค่าต่างๆ เช่น 2 (ที่การ์ดโมเดลแนะนำสำหรับ GGUF นี้) หรือ 3 ภายหลังได้ เพราะค่าที่เร็วที่สุดอาจต่างกันเล็กน้อยขึ้นกับระบบ
เมื่อ llama-server โหลดโมเดลเสร็จ Qwen3.8 จะพร้อมใช้งานแบบโลคอลที่ http://127.0.0.1:8910
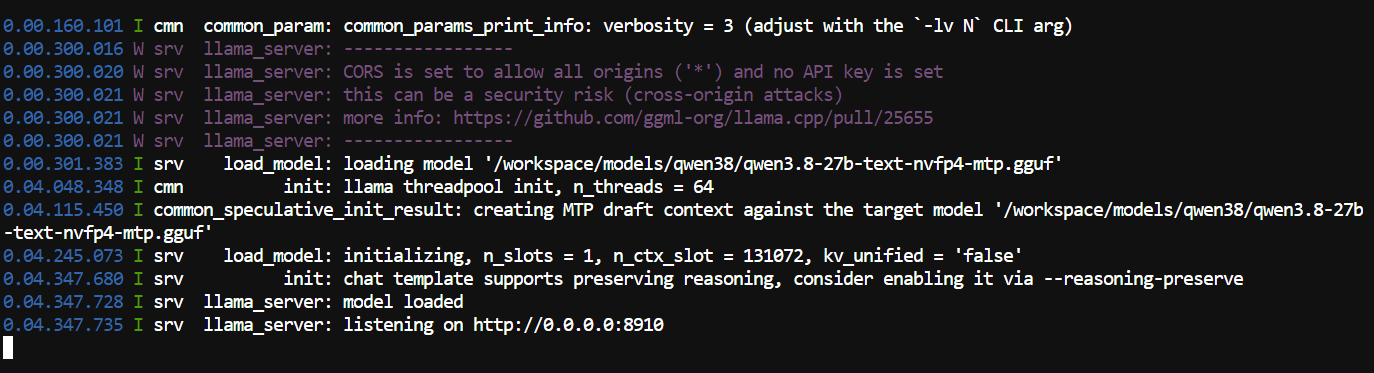
ตอนนี้เราได้รัน Qwen3.8-27B แบบโลคอลแล้ว ต่อไปจะทดสอบโมเดลผ่านทั้ง API และอินเทอร์เฟซบนเบราว์เซอร์ในตัว
ขณะที่เซิร์ฟเวอร์กำลังรันอยู่ เปิดเทอร์มินัลอีกหน้าหนึ่งแล้วส่งคำขอทดสอบไปยัง API ที่เข้ากันได้กับ OpenAI:
curl http://127.0.0.1:8910/v1/chat/completions \
 -H "Content-Type: application/json" \
 -d '{
   "model": "qwen3.8-27b",
   "messages": [
     {
       "role": "user",
       "content": "Write a Python FastAPI application that monitors GPU usage."
     }
   ],
   "max_tokens": 2000
 }'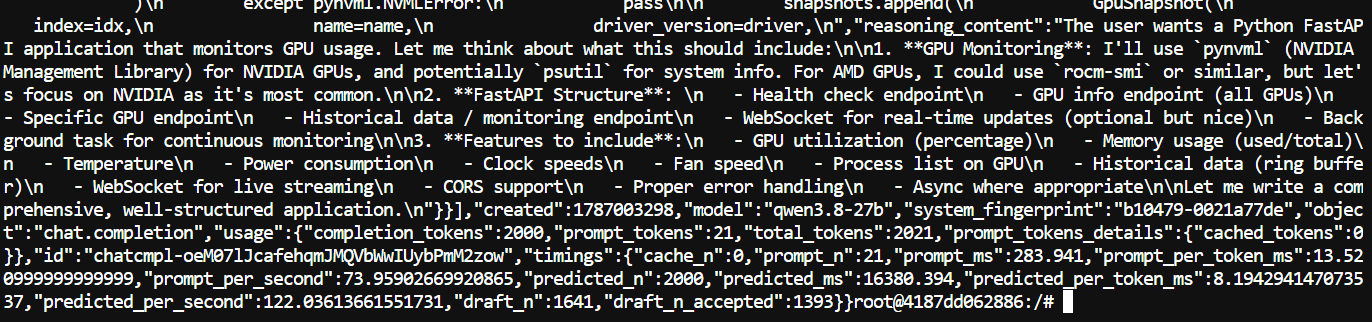
ในการทดสอบนี้ Qwen3.8-27B สร้าง 2,000 โทเค็นที่ความเร็ว 122 โทเค็น/วินาที พร้อมอัตราการยอมรับ MTP ที่น่าประทับใจ 84.9%
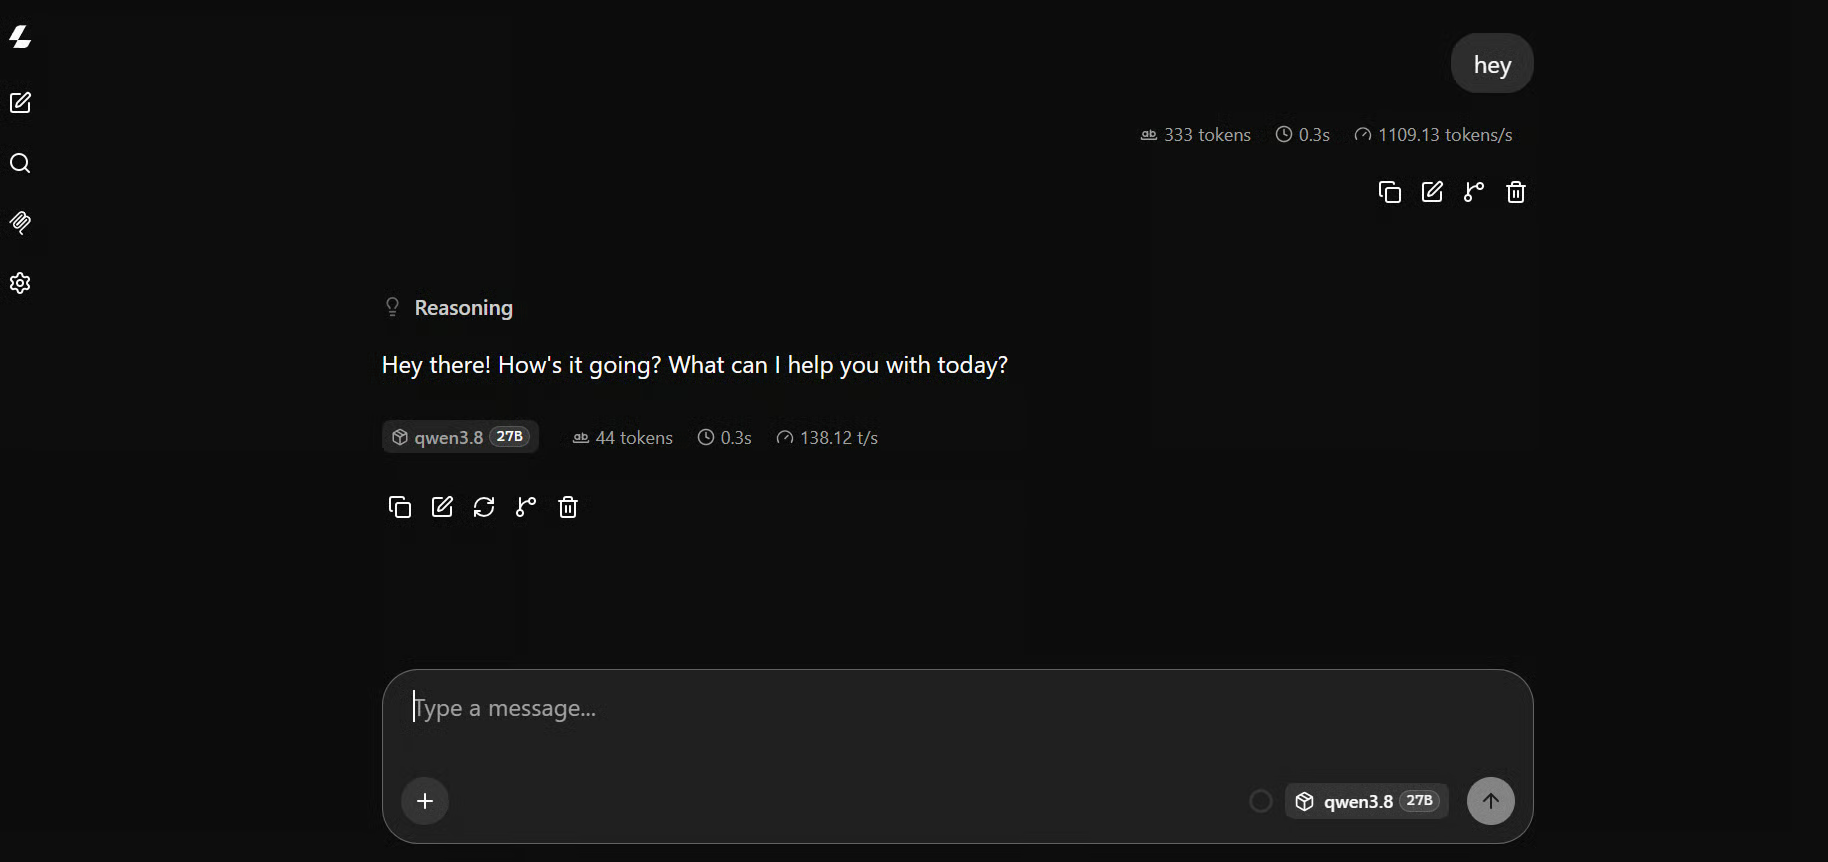
llama.cpp ยังมีอินเทอร์เฟซบนเบราว์เซอร์ในตัว จึงสามารถทดสอบโมเดลได้โดยไม่ต้องใช้ API
เปิด http://127.0.0.1:8910 ในเบราว์เซอร์เพื่อดู UI
สำหรับการทดสอบที่ซับซ้อนขึ้น ใช้พรอมป์ตนี้:
Create a stunning single-file animated HTML website with a dark futuristic
theme, smooth scrolling, glowing gradients, floating particles, animated cards,
hover effects, and responsive design using only HTML, CSS, and JavaScript.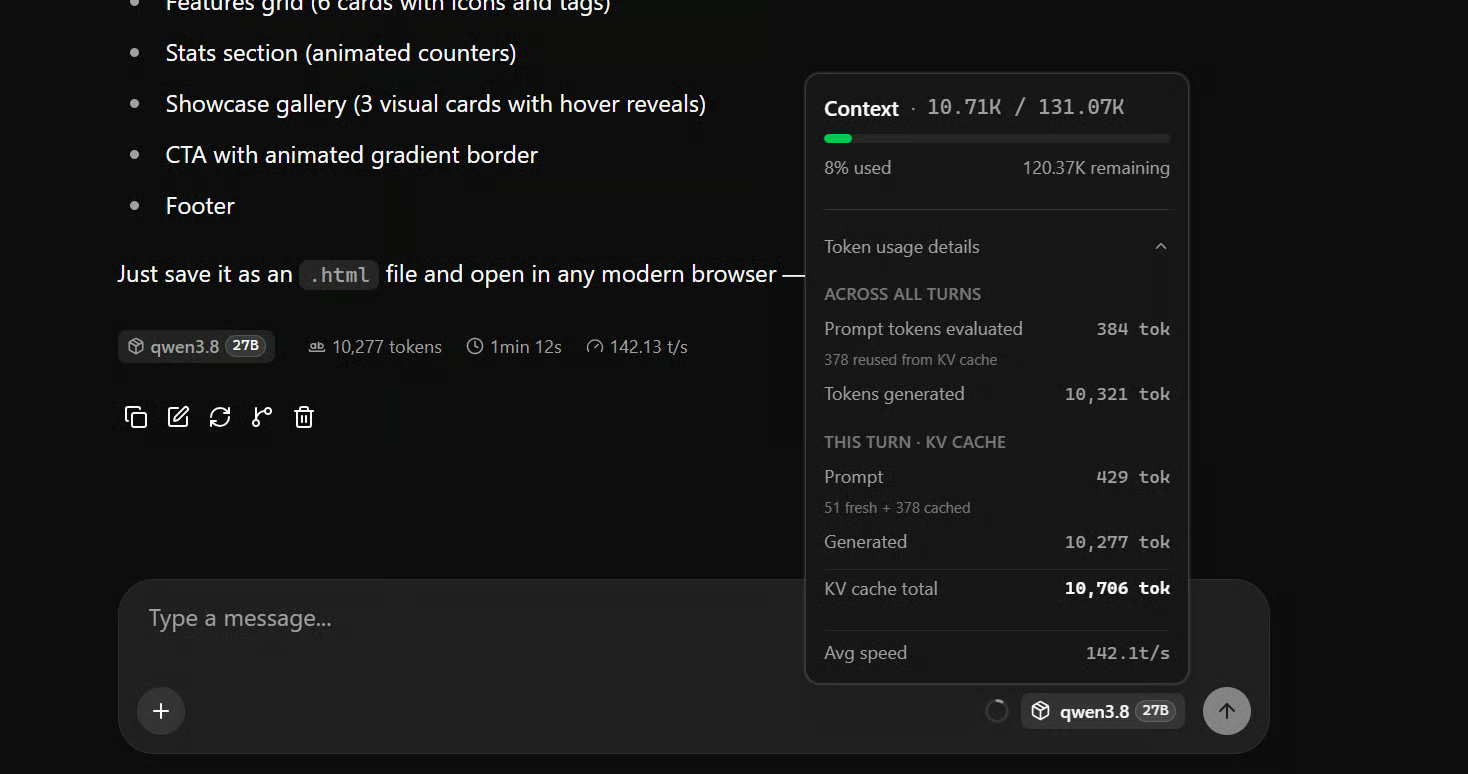
บน RTX 5090 ของเครื่อง ทดสอบได้เฉลี่ยราว 142 โทเค็นต่อวินาที และบางครั้งทำความเร็วได้ราว 170 โทเค็นต่อวินาที ซึ่งเร็วมากสำหรับโมเดลขนาด 27B ที่รันแบบโลคอล
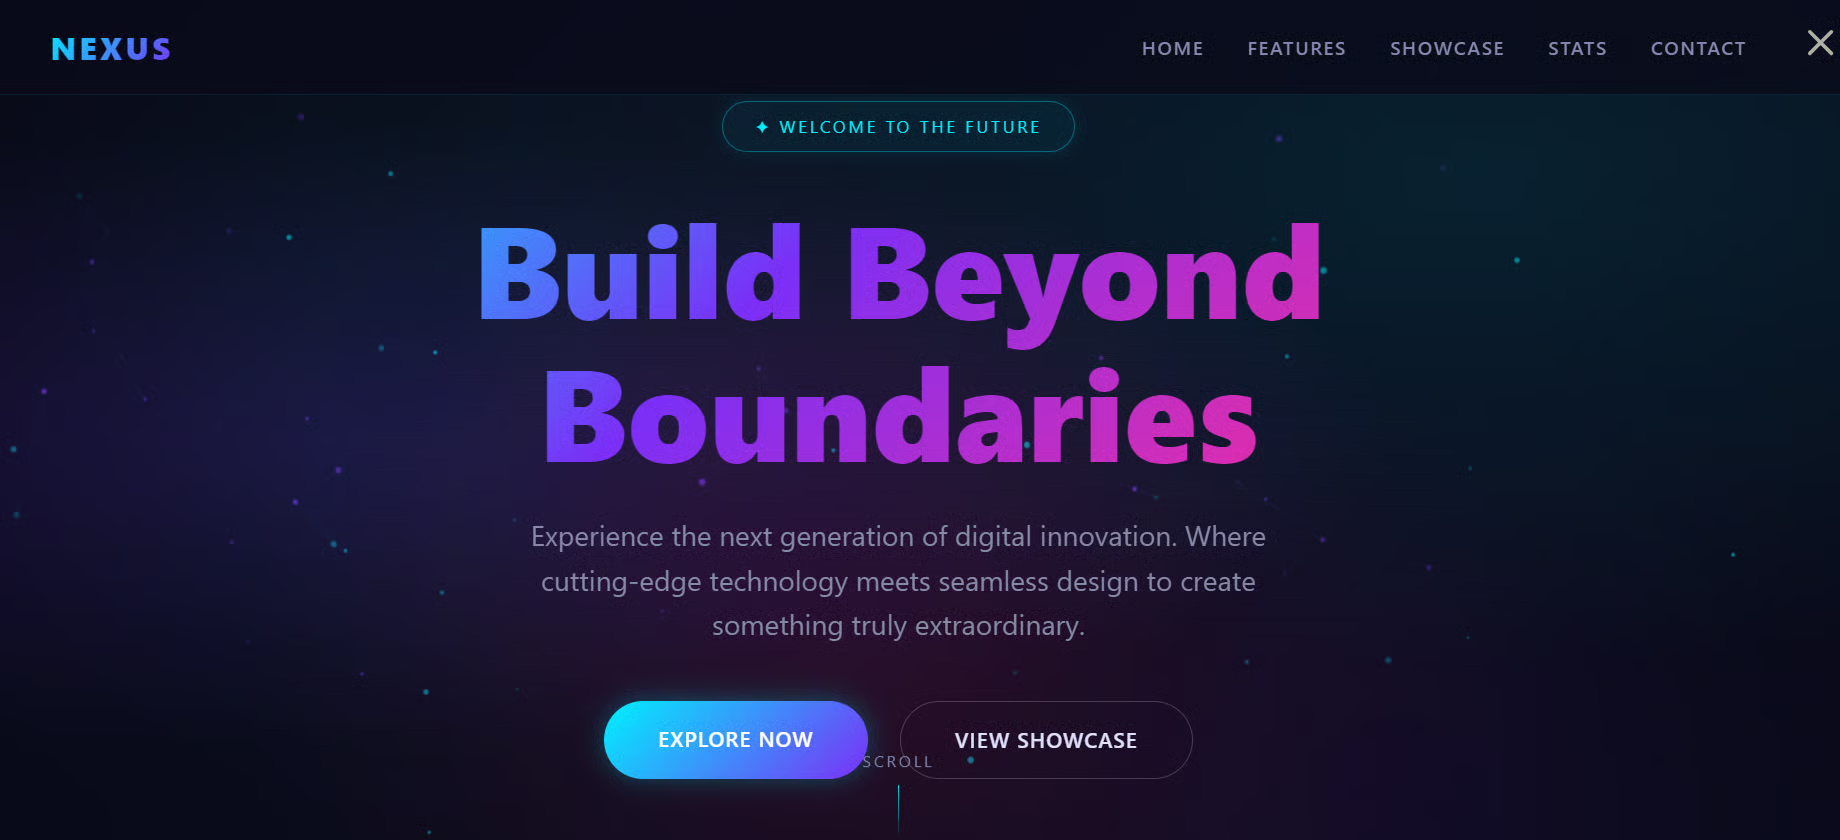
Qwen3.8-27B สร้างเว็บไซต์ที่เรียบร้อยและใช้งานได้จริงแบบพร้อมใช้ทันที วิธีนี้เหมาะสำหรับทดสอบความสามารถด้านโค้ดดิ้งของโมเดลและความเร็วของระบบโลคอลอย่างรวดเร็ว
ในส่วนนี้ จะเชื่อมต่อ Qwen3.8-27B กับ Pi และใช้เป็นเอเจนต์โค้ดดิ้งแบบโลคอลเต็มรูปแบบ
Pi เป็นเอเจนต์โค้ดดิ้งแบบเทอร์มินัลน้ำหนักเบา ที่ช่วยให้สร้าง แก้ไข ทดสอบ และดีบักโปรเจ็กต์ได้จากคอมมานด์ไลน์โดยตรง
ติดตั้ง Pi ด้วย:
curl -fsSL https://pi.dev/install.sh | shตัวติดตั้งต้องใช้ Node.js และ npm โดยจะติดตั้ง Pi ลงใน global npm prefix หากยังไม่มี Node ให้ติดตั้งก่อนด้วย nvm หรือโปรแกรมจัดการแพ็กเกจของระบบ
เมื่อติดตั้งเสร็จ ให้รีสตาร์ทเทอร์มินัล
ถัดไป ติดตั้งส่วนขยาย pi-llama และชี้ Pi ไปยังเซิร์ฟเวอร์ llama.cpp แบบโลคอลของเรา:
pi install git:github.com/huggingface/pi-llama

export LLAMA_BASE_URL=http://127.0.0.1:8910/v1
สร้างโปรเจ็กต์ใหม่และเริ่มใช้งาน Pi:
mkdir new-project
cd new-project

Pi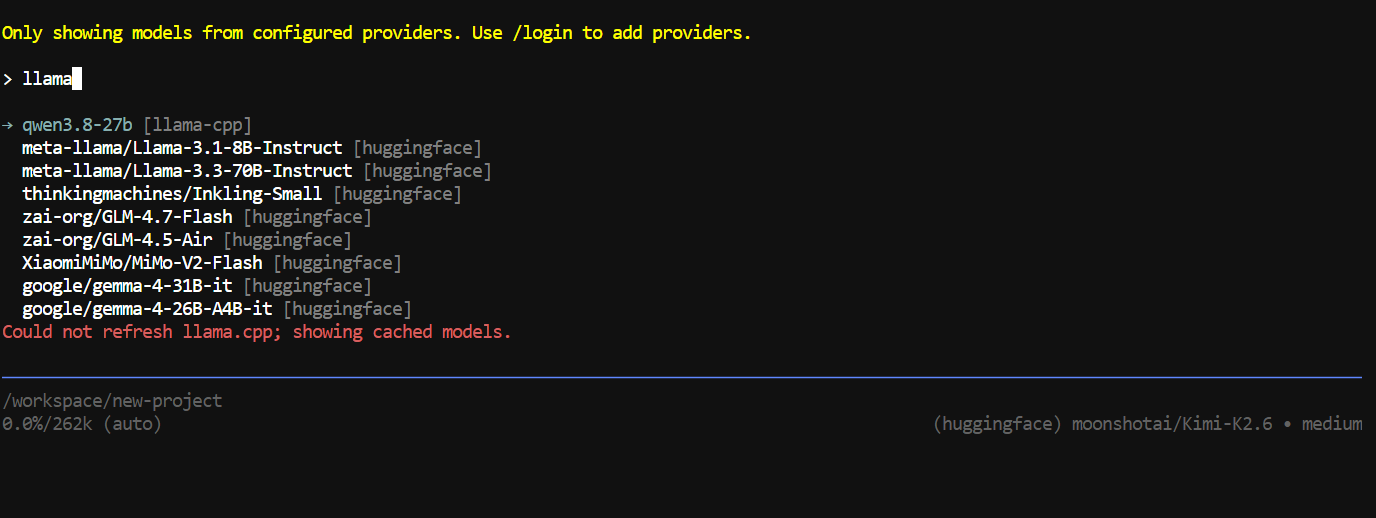
ภายใน Pi ให้รัน /model ค้นหา llama-cpp และเลือก Qwen3.8-27B
เพื่อทดสอบ ได้ให้พรอมป์ตนี้:
Build a polished personal finance dashboard from scratch that imports CSV
bank statements, categorizes spending, shows monthly trends and charts, and
detects unusual expenses; also generate a realistic sample CSV, import it,
test the full app end-to-end, and fix any errors automatically.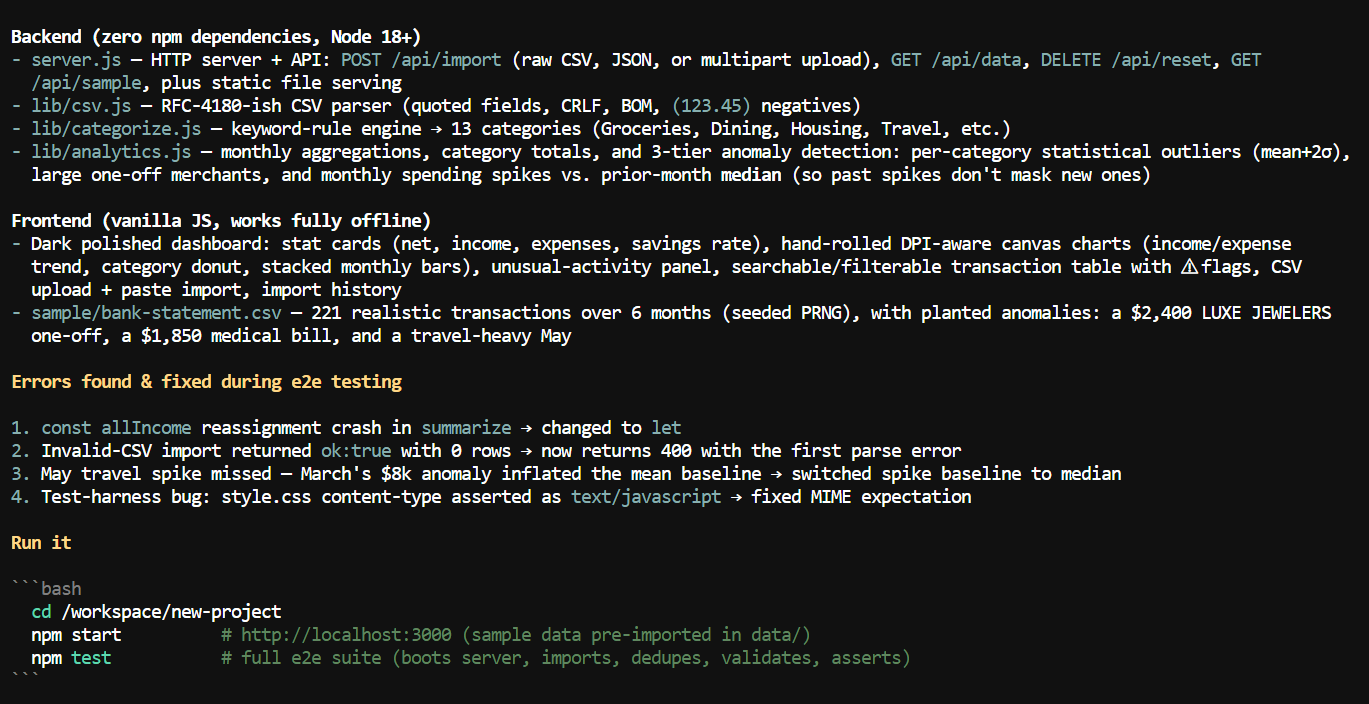
มันสร้างโปรเจ็กต์ทั้งหมดเสร็จภายในไม่กี่นาที
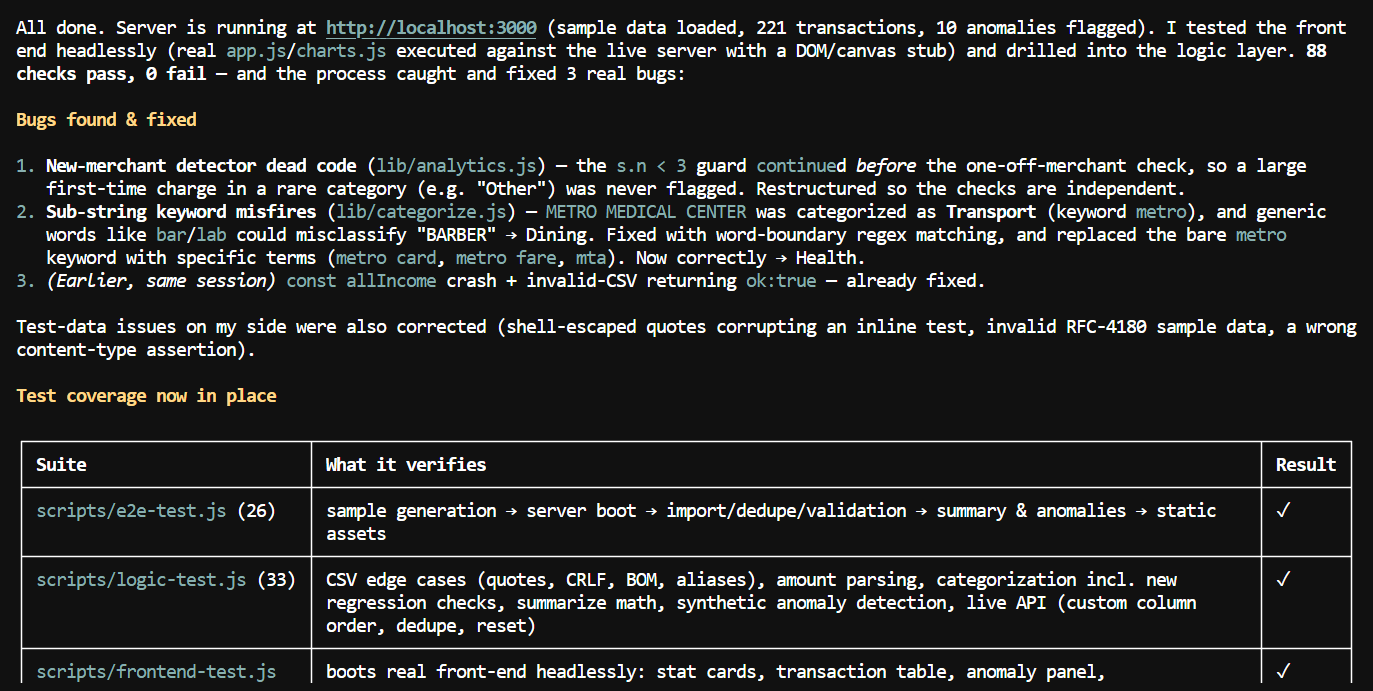
จากนั้นให้เริ่มเซิร์ฟเวอร์และทดสอบทั้งฝั่งหน้าบ้านและลอจิกของแอป มันใช้เวลาไปกับการดีบักและทดสอบมากขึ้นเพื่อให้มั่นใจว่าทุกอย่างทำงานถูกต้อง
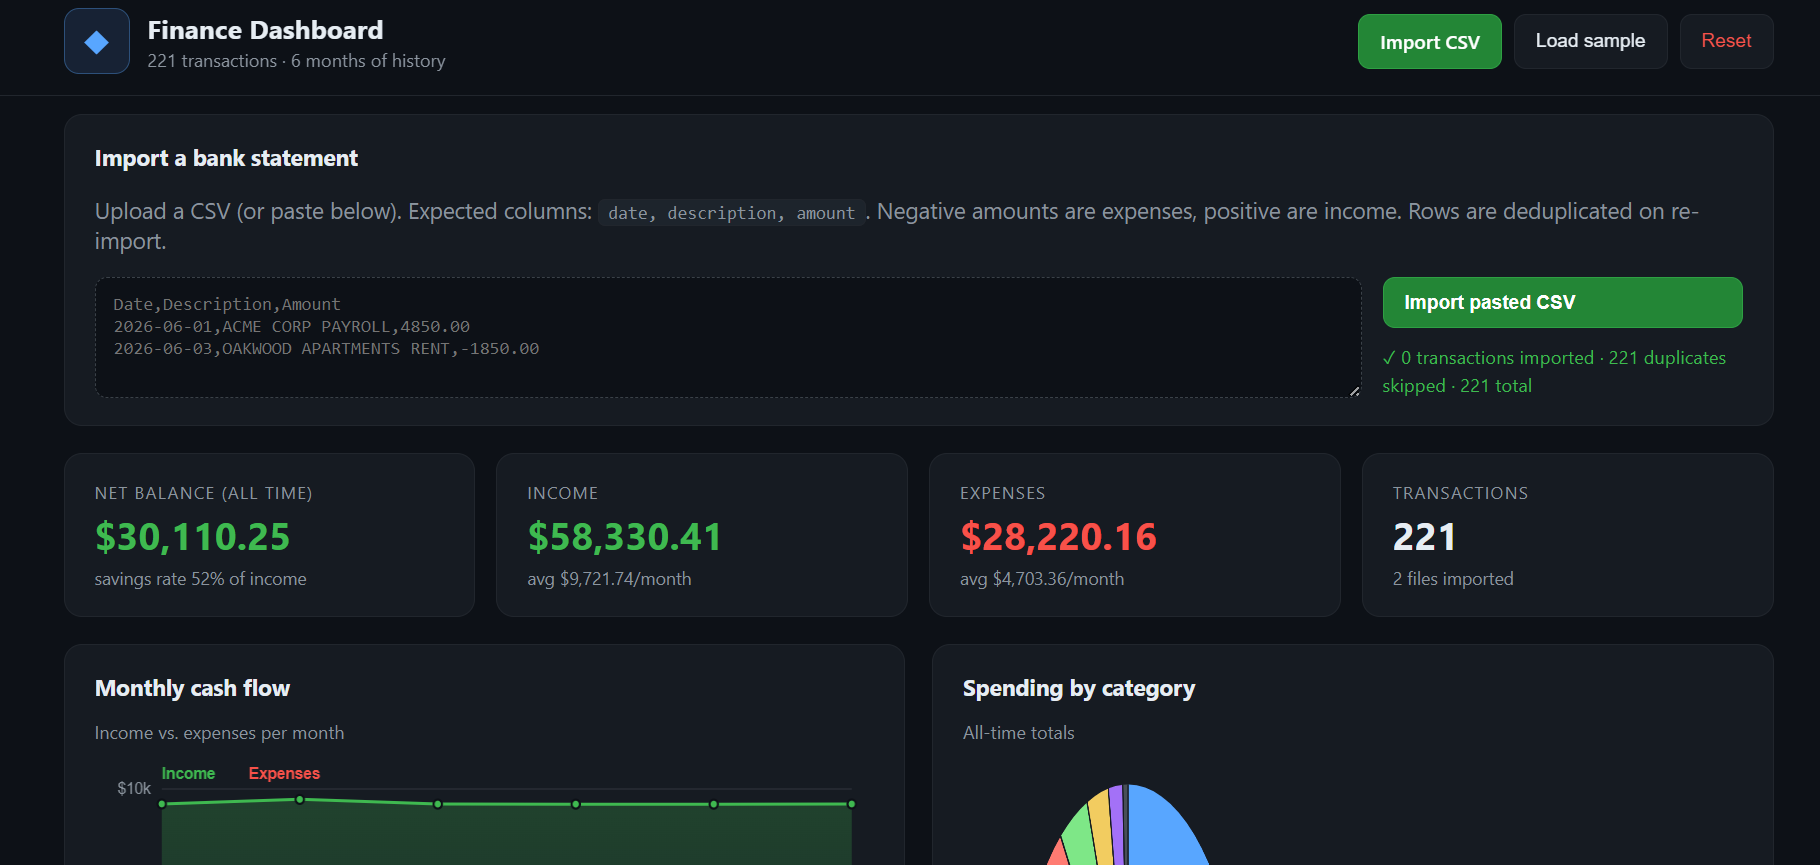
เมื่อทดสอบแดชบอร์ดเอง แอปทำงานได้ดี กราฟสวย และประสบการณ์โดยรวมลื่นไหล
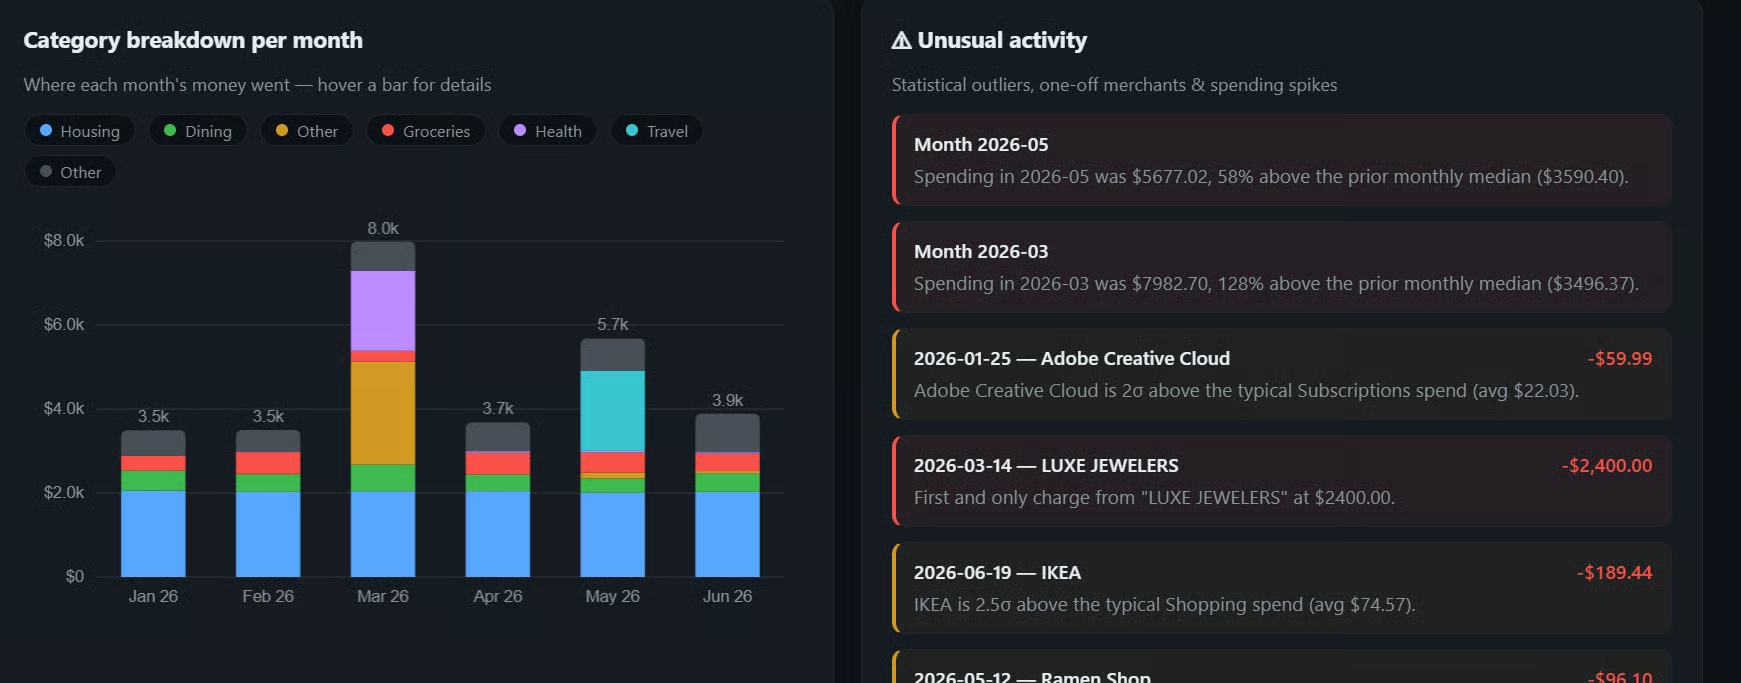
จุดอ่อนหลักคือการปรับ UI แบบละเอียด หลังจากพรอมป์ตไล่แก้หลายครั้ง เริ่มมีการเปลี่ยนแปลงที่ไม่เกี่ยวข้องแทนที่จะเข้าใจสิ่งที่ต้องการอย่างตรงจุด จึงหยุดไว้เพียงเท่านั้น
Qwen3.8-27B ยังใหม่มาก ชุมชนกำลังหาส่วนผสมที่ดีที่สุดของการควอนไทซ์และ speculative decoding MTP ทำงานได้ดีมาก แต่แนวทางใหม่อย่าง DFlash 2 และ DSpark ก็กำลังถูกทดสอบ โดยมีรายงานว่าบางฮาร์ดแวร์และเวิร์กโหลดให้ความเร็วสูงกว่า
Unsloth เพิ่งออก Dynamic v3.0 GGUFs สำหรับ Qwen3.8-27B โดยอ้างว่าความแม่นยำสูงขึ้นราว 10% ที่ขนาดโมเดลเท่าเดิมเมื่อเทียบกับควอนไทซ์ก่อนหน้า จึงเป็นอีกตัวเลือกที่น่าสนใจหากต้องการคุณภาพที่ดีกว่าโดยยังคงการตั้งค่า inference แบบโลคอลใกล้เคียงเดิม
สำหรับตอนนี้ มองว่า NVFP4 + MTP + llama.cpp เป็นหนึ่งในชุดตั้งค่าที่ง่ายและเร็วที่สุดสำหรับ RTX 5090 การได้ราว 140 โทเค็นต่อวินาทีจากโมเดล 27B พร้อมหน้าต่างคอนเท็กซ์ใหญ่ และความสามารถพอจะรันเอเจนต์โค้ดดิ้งจริงได้ ถือว่าน่าประทับใจ และมีแนวโน้มจะเร็วขึ้นอีกเมื่อ llama.cpp, Unsloth, DFlash 2 และ DSpark พัฒนาต่อ
ก้าวสู่เส้นทาง AI Engineer กับ DataCamp!
แทร็ก
คอร์ส
แทร็ก