Tracks
開発者向けアソシエイトAIエンジニア
26時間
まず、GPU が正しく検出されていることを確認し、NVIDIA ドライバと CUDA のバージョンを確認します。
nvidia-smi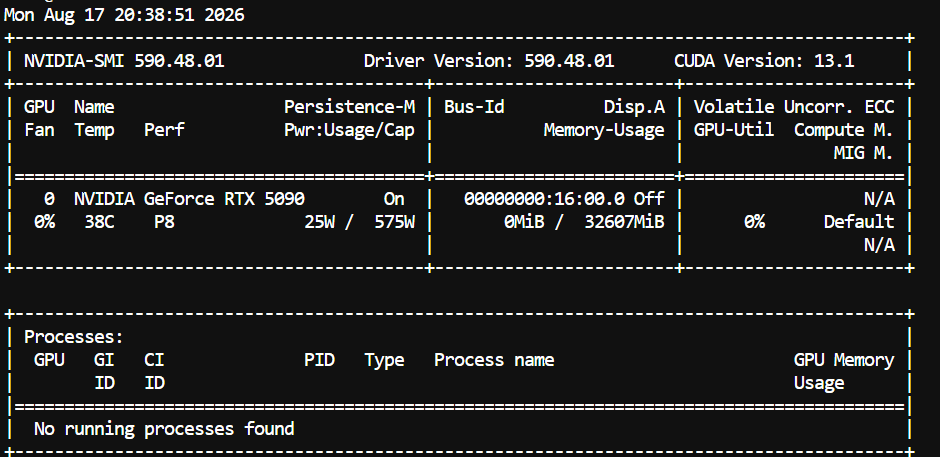
RTX 5090、ドライバのバージョン、CUDA バージョン、GPU メモリ、現在の GPU 使用状況が表示されるはずです。
注意: ここでのセットアップは RTX 5090 など NVIDIA Blackwell GPU 専用です。以下のビルドは RTX 5090 が用いる計算アーキテクチャである SM120 を対象にしています。
次に、CUDA 対応で最新の llama.cpp をダウンロード・コンパイルします。
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp

cmake -B build \
  -DGGML_CUDA=ON \
  -DCMAKE_CUDA_ARCHITECTURES=120

cmake --build build --config Release -j$(nproc)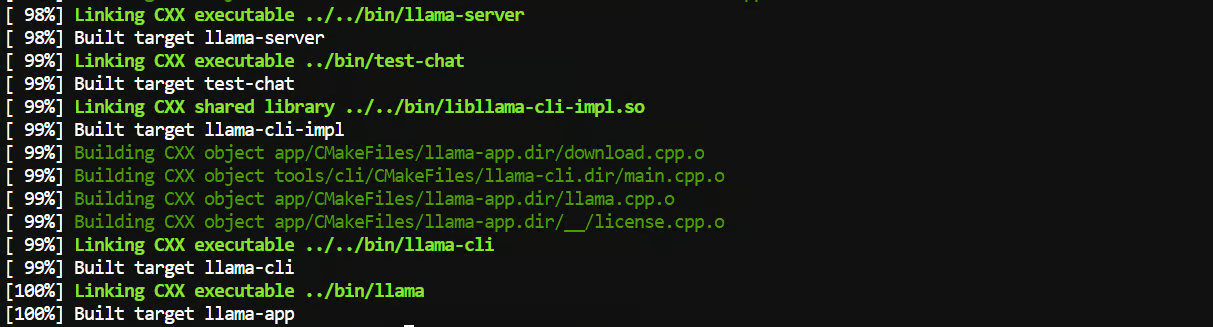
ここで重要なのは -DCMAKE_CUDA_ARCHITECTURES=120 です。これは RTX 5090 で使われている Blackwell アーキテクチャ向けに llama.cpp をビルドする指定です。
ビルドが完了したら、任意のフォルダから実行できるように llama-server をグローバルに使えるようにします:
sudo ln -sf "$(realpath ./build/bin/llama-server)" /usr/local/bin/llama-server動作確認を行います:
llama-server --version出力例:
version: 0.1.1-dev (build 10479, commit 0021a77de)
built with GNU 13.3.0 for Linux x86_64
以上で、RTX 5090 とその Blackwell ネイティブ NVFP4 を活用できる CUDA 対応の llama.cpp ビルドが用意できました。
続いて、Qwen3.8-27B モデルをダウンロードします。
まず Hugging Face CLI をインストールします:
pip install -U huggingface_hubモデルを保存するフォルダを作成します:
mkdir -p /workspace/models/qwen38次に NVFP4-MTP GGUF をダウンロードします:
hf download felippeburk/Qwen3.8-27B-NVFP4-MTP-GGUF \
  --local-dir /workspace/models/qwen38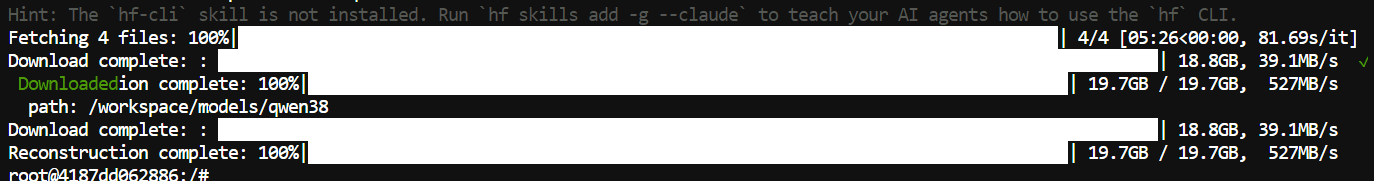
このバージョンは NVFP4 を用い、MTP をサポートしているため、本セットアップに最適です。RTX 5090 での高速化の多くはここから得られます。
ここからが本番です。Flash Attention、有効コンテキスト 131K のコンテキストウィンドウ、高速化のための MTP 推測デコードを使って、Qwen3.8-27B を完全に GPU 上で提供します。
次を実行します:
cd /workspace/llama.cpp

llama-server \
  -m /workspace/models/qwen38/qwen3.8-27b-text-nvfp4-mtp.gguf \
  --alias qwen3.8-27b \
  --host 0.0.0.0 \
  --port 8910 \
  --ctx-size 131072 \
  --n-gpu-layers all \
  --flash-attn on \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --parallel 1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 4 \
  --spec-draft-p-min 0.75 \
  --spec-draft-ngl all \
  --spec-draft-type-k q8_0 \
  --spec-draft-type-v q8_0 \
  --reasoning-effort medium \
  --jinja
オプションは多いですが、ほとんどは 5090 で最高の性能を引き出すためのものです。
主なポイントは次のとおりです:
--ctx-size 131072 はおよそ 131K のコンテキストウィンドウを指定します。
--n-gpu-layers all はモデルを GPU 上に維持します。
--flash-attn on は Flash Attention を有効にします。
--cache-type-k q8_0 と --cache-type-v q8_0 は KV キャッシュのメモリ使用量を抑えます。
--spec-type draft-mtp は Qwen3.8 の MTP 推測デコードを有効化します。
--spec-draft-n-max 4 は MTP が一度に生成する推測トークン数を制御します。
本セットアップでは RTX 5090 の初期値として n-max 4 を使っています。システムにより最速設定はわずかに変わるため、この GGUF のモデルカードが推奨する 2 や 3 なども試してみてください。
モデルの読み込みが完了すると、Qwen3.8 はローカルの http://127.0.0.1:8910 で利用可能になります。
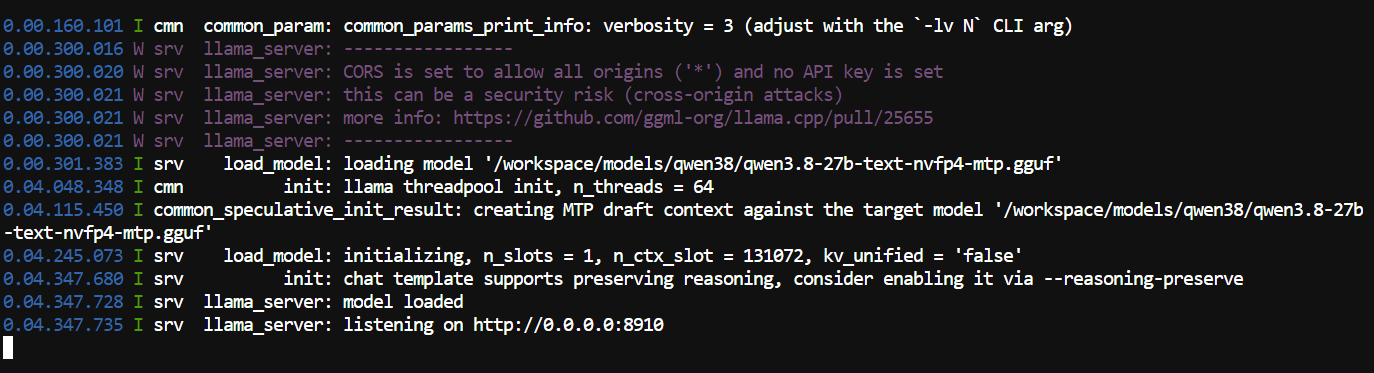
これで Qwen3.8-27B をローカル実行できました。次に、API と組み込みブラウザー UI の両方でモデルをテストします。
サーバーが起動している状態で、別のターミナルを開き、OpenAI 互換 API にテストリクエストを送ります:
curl http://127.0.0.1:8910/v1/chat/completions \
 -H "Content-Type: application/json" \
 -d '{
   "model": "qwen3.8-27b",
   "messages": [
     {
       "role": "user",
       "content": "Write a Python FastAPI application that monitors GPU usage."
     }
   ],
   "max_tokens": 2000
 }'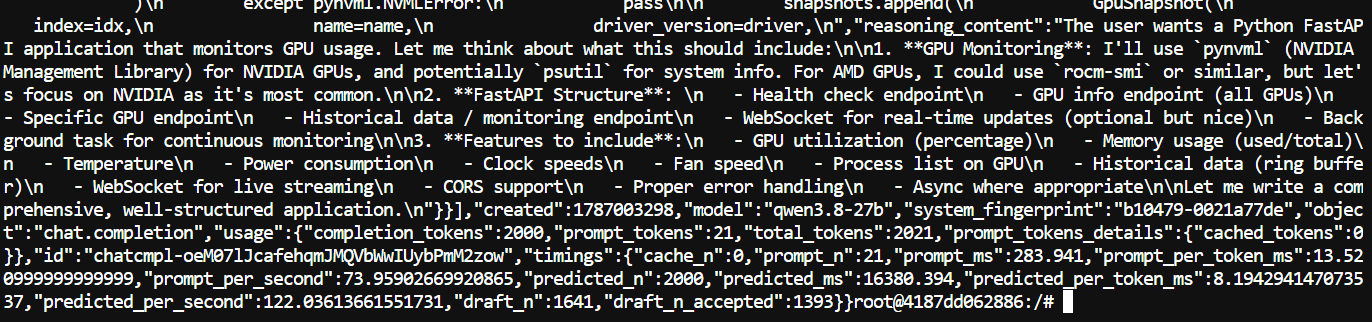
このテストでは、Qwen3.8-27B は 2,000 トークンを毎秒 122 トークンで生成し、MTP 受け入れ率は 84.9% と非常に良好でした。
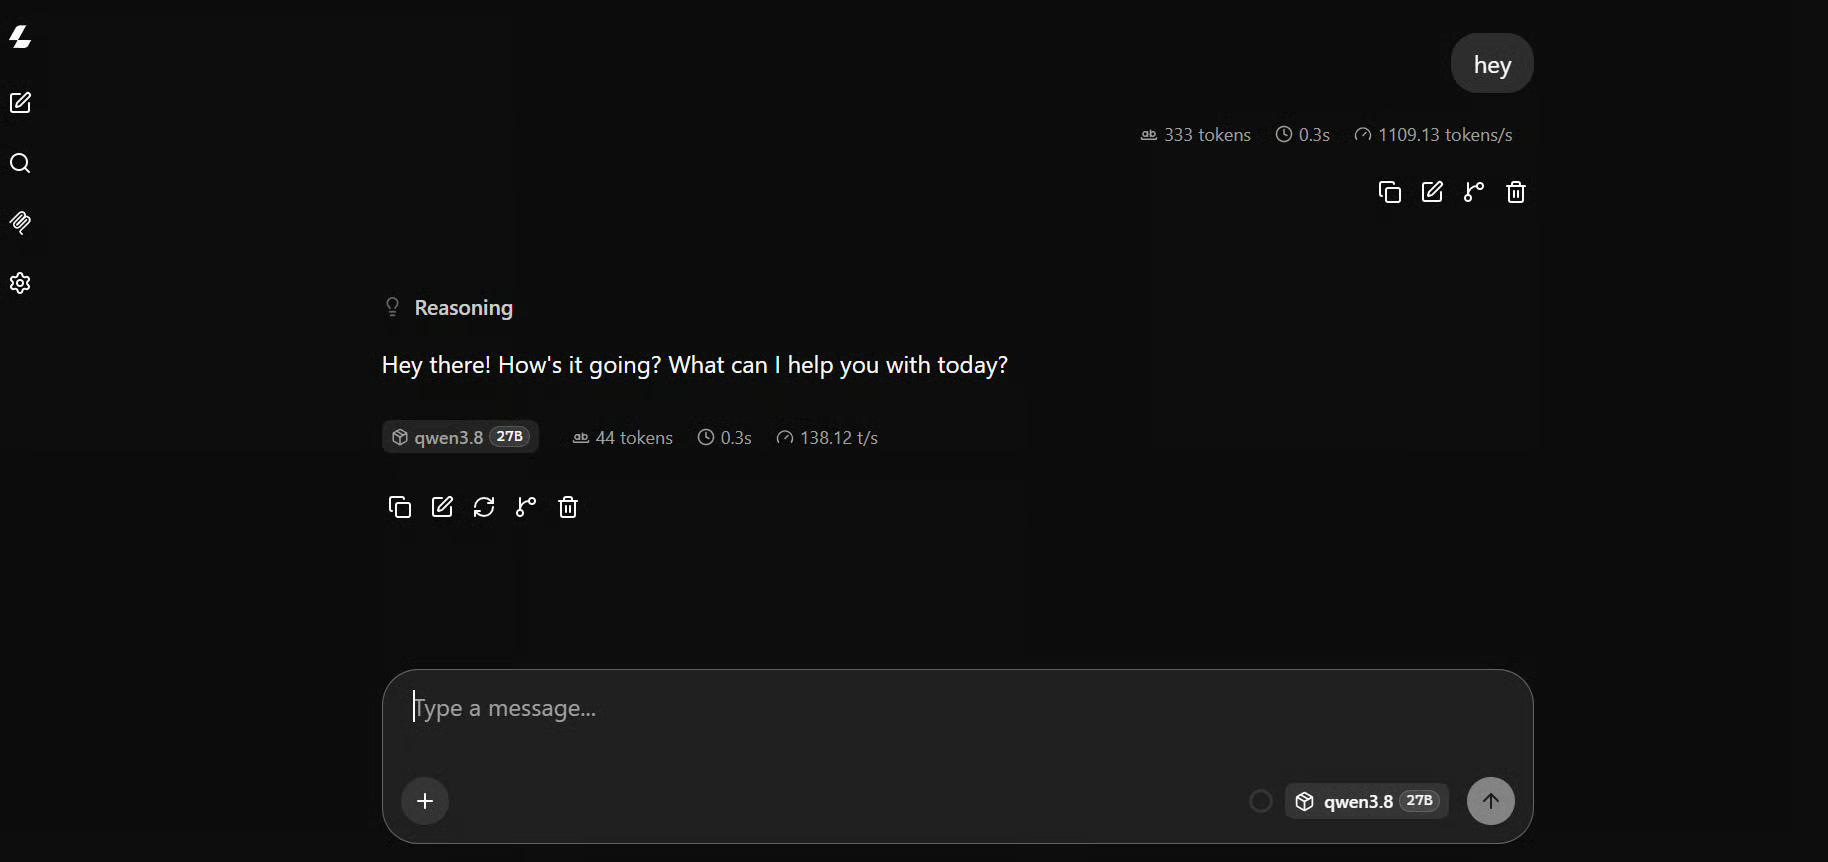
llama.cpp にはブラウザーインターフェースも含まれているため、API を使わずにモデルを試すこともできます。
http://127.0.0.1:8910 をブラウザーで開くと UI が表示されます。
より複雑なテストとして、次のプロンプトを使用しました:
Create a stunning single-file animated HTML website with a dark futuristic
theme, smooth scrolling, glowing gradients, floating particles, animated cards,
hover effects, and responsive design using only HTML, CSS, and JavaScript.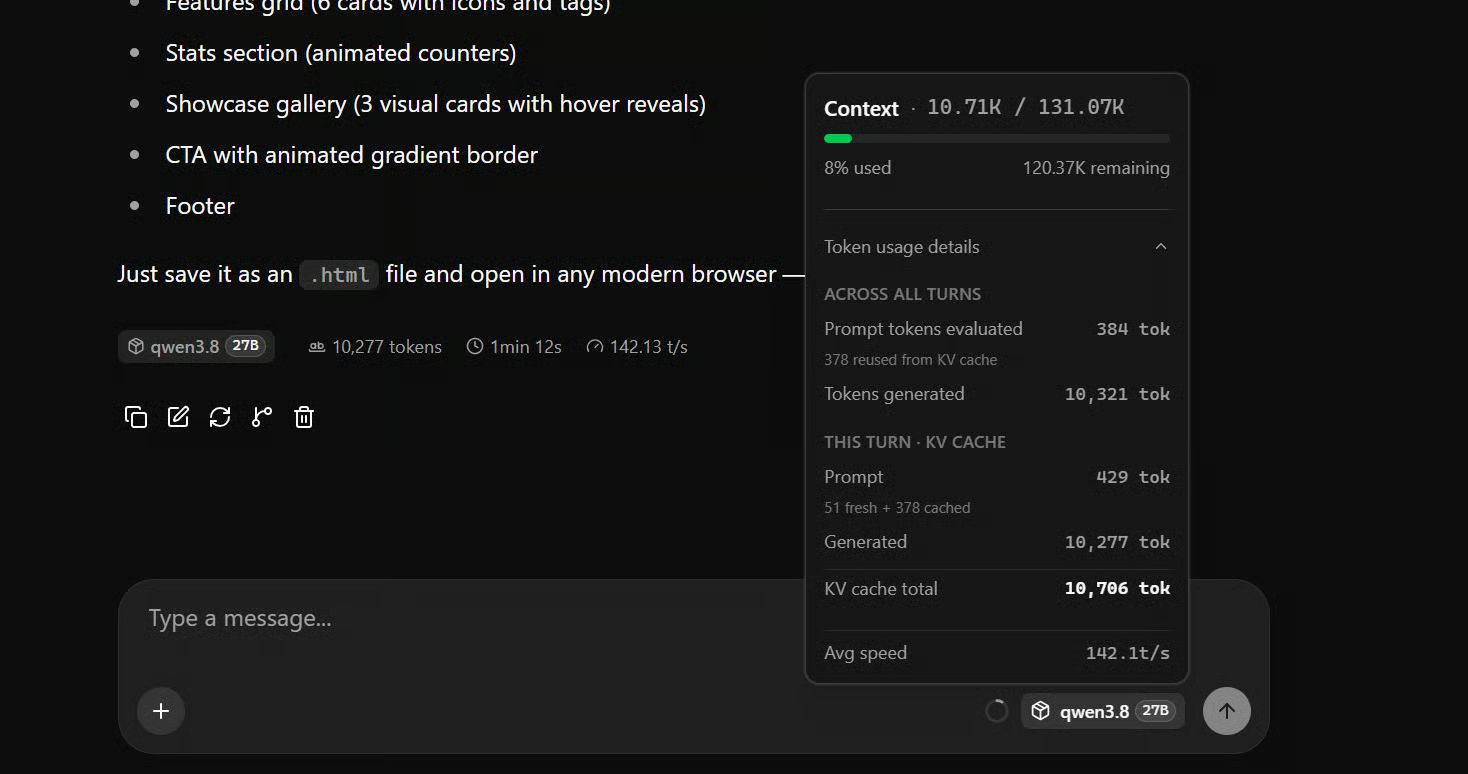
私の RTX 5090 では平均で毎秒約 142 トークン、状況によっては毎秒約 170 トークンに達することもあり、ローカルで動く 27B モデルとしては非常に高速でした。
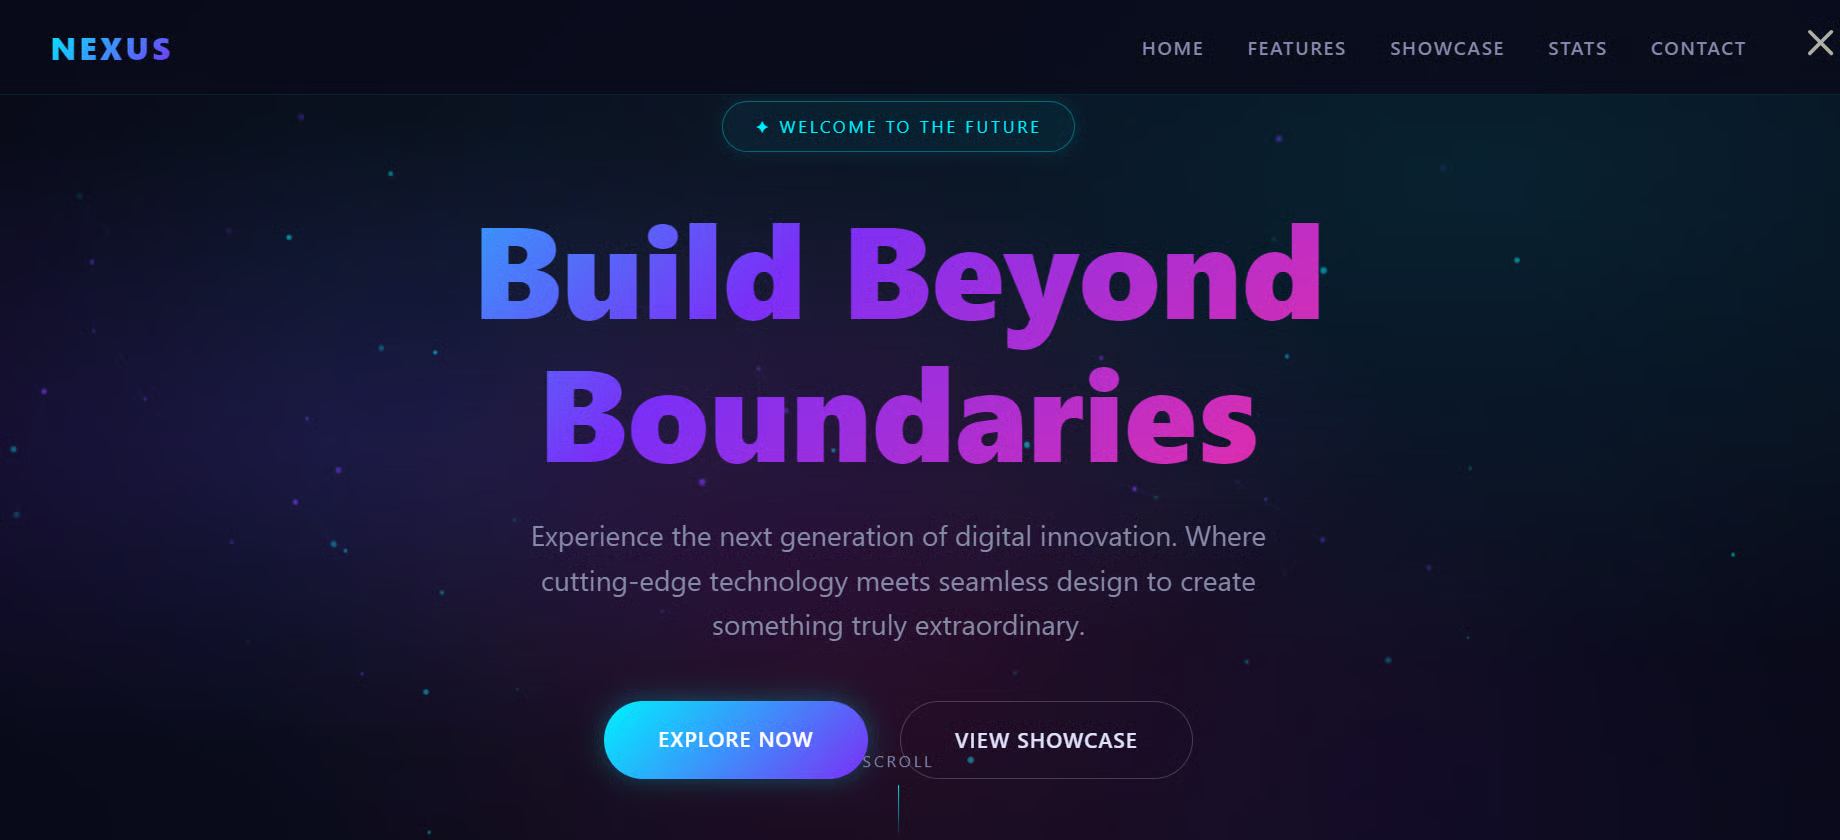
Qwen3.8-27B は、箱から出してすぐ動く洗練された完全動作のウェブサイトを生成しました。モデルのコーディング能力とローカル環境の速度を手早く確認するのに好適です。
このセクションでは、Qwen3.8-27B を Pi に接続し、完全ローカルのコーディングエージェントとして使用します。
Pi はターミナルベースの軽量コーディングエージェントで、コマンドラインから直接プロジェクトの構築・編集・テスト・デバッグを支援します。
Pi のインストール:
curl -fsSL https://pi.dev/install.sh | shインストーラーには Node.js と npm が必要です。Pi はグローバルな npm プレフィックスにインストールされます。Node が未導入の場合は、nvm かパッケージマネージャーで先にインストールしてください。
インストールが完了したら、ターミナルを再起動します。
次に、pi-llama 拡張をインストールし、Pi をローカルの llama.cpp サーバーに向けます:
pi install git:github.com/huggingface/pi-llama

export LLAMA_BASE_URL=http://127.0.0.1:8910/v1
新しいプロジェクトを作成して Pi を起動します:
mkdir new-project
cd new-project

Pi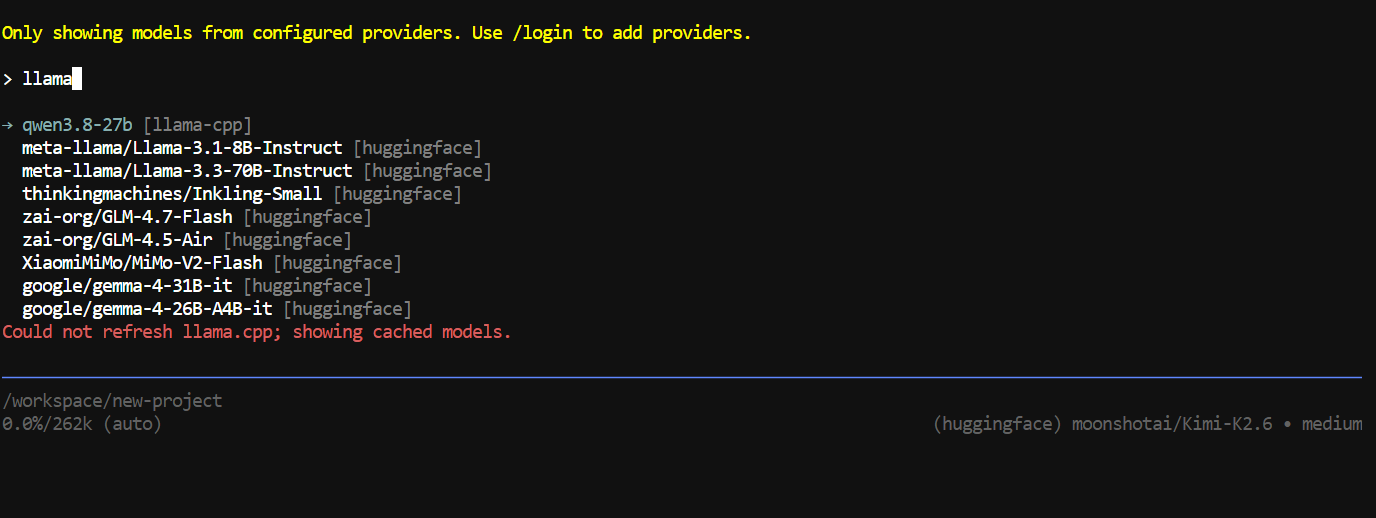
Pi の中で /model を実行し、llama-cpp を検索して Qwen3.8-27B を選択します。
テスト用に、次のプロンプトを与えました:
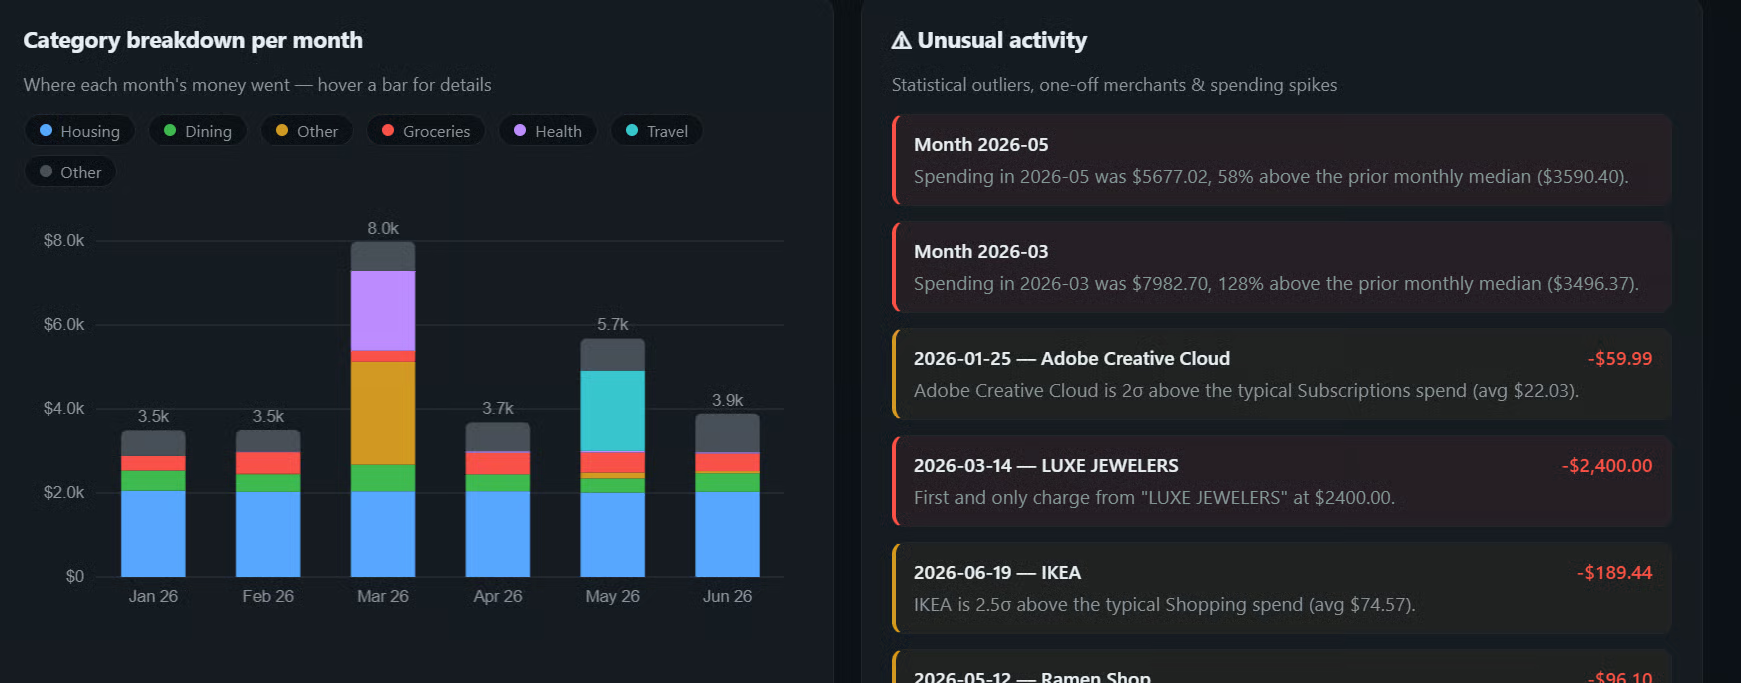
Build a polished personal finance dashboard from scratch that imports CSV
bank statements, categorizes spending, shows monthly trends and charts, and
detects unusual expenses; also generate a realistic sample CSV, import it,
test the full app end-to-end, and fix any errors automatically.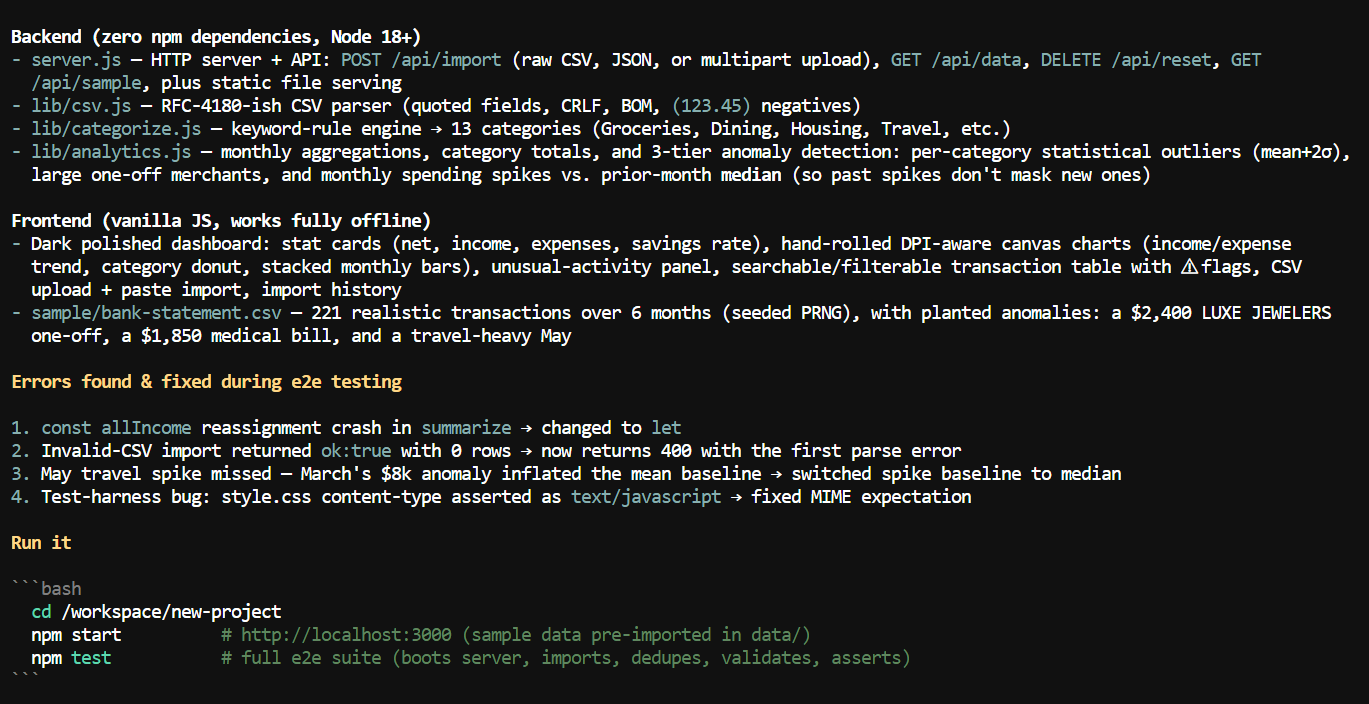
数分でプロジェクト全体を構築しました。
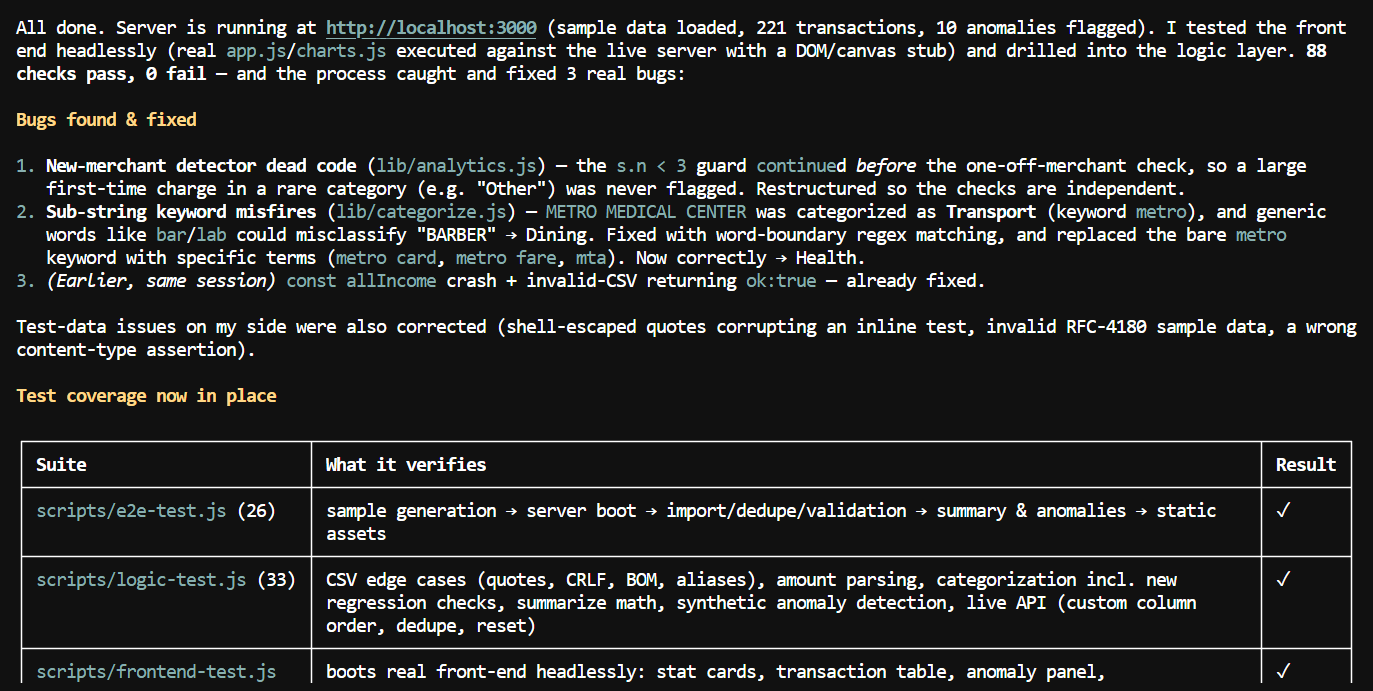
その後、サーバーを起動し、フロントエンドとアプリケーションロジックの両方をテストするよう指示しました。すべてが正しく動くよう、デバッグとテストにより時間をかけていました。
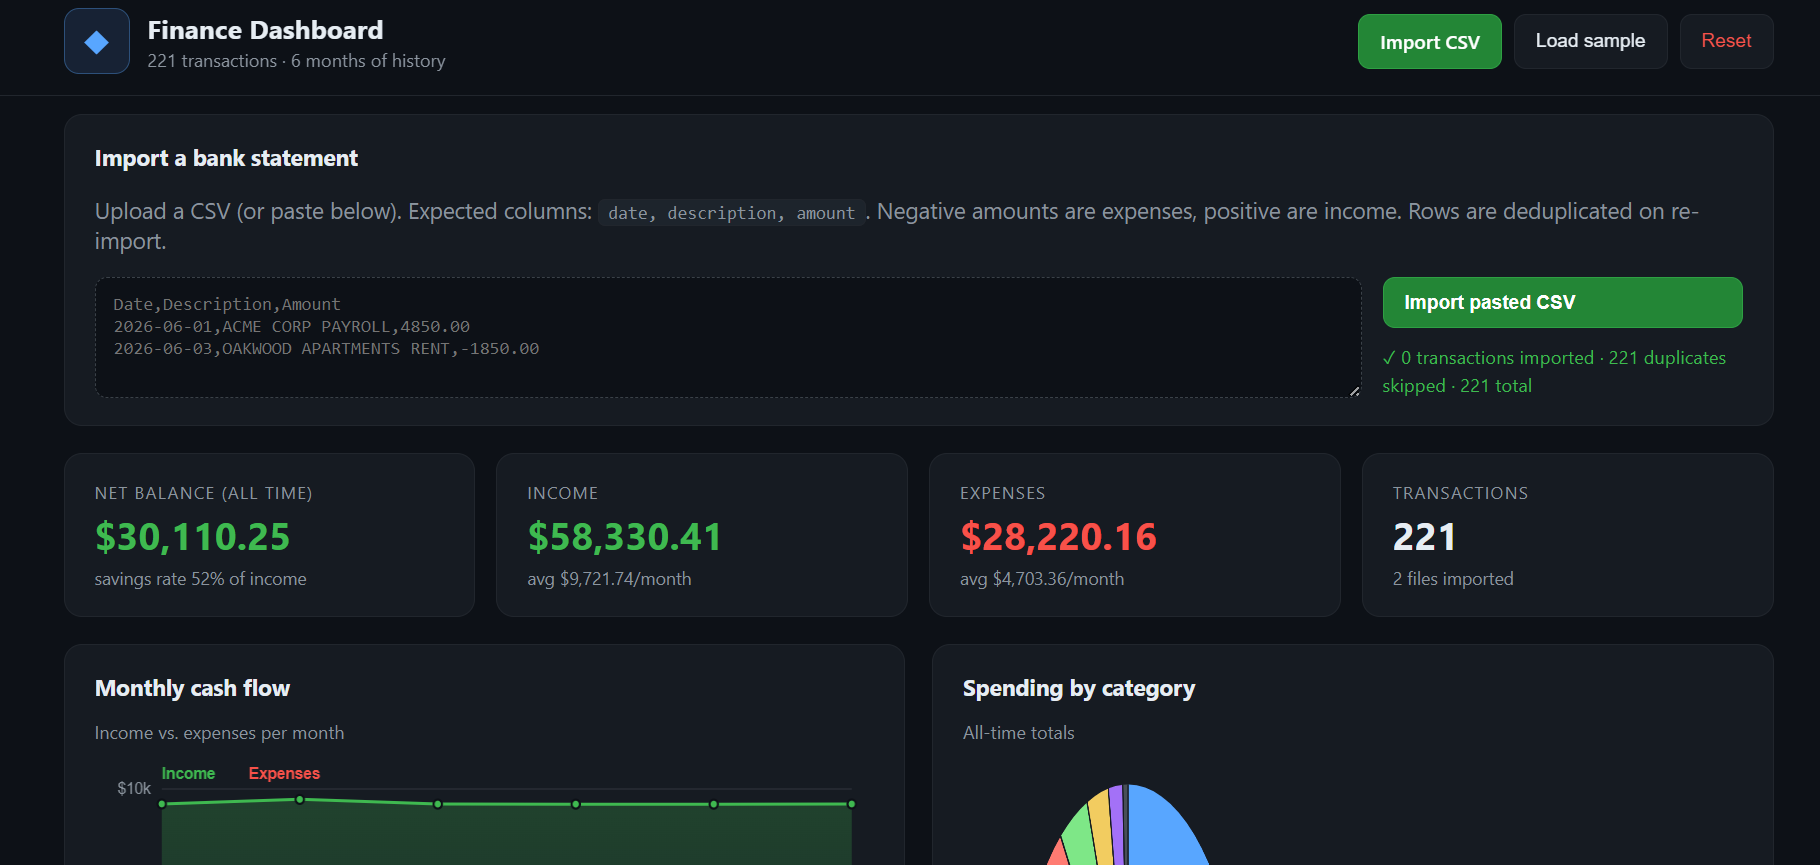
自分でもダッシュボードを試しましたが、アプリは良好に動作し、グラフも見やすく、全体としてスムーズでした。
唯一の弱点は、UI をピンポイントに調整する作業でした。いくつか追加入力を重ねると、こちらの意図を正確に理解する代わりに無関係な変更を始めてしまったため、その時点で打ち切りました。
Qwen3.8-27B はまだ非常に新しく、量子化と推測デコードの最適な組み合わせをコミュニティが積極的に模索している段階です。MTP は非常に良好に機能しますが、DFlash 2 や DSpark などの新手法も検証が進んでおり、ハードウェアやワークロードによってはさらに高速という報告もあります。
Unsloth からは Qwen3.8-27B 向け Dynamic v3.0 GGUF も公開されたばかりで、同一モデルサイズで前世代の量子化比で約 10% の精度向上をうたっています。ローカル推論の構成を大きく変えずに品質を高めたい場合、Unsloth も非常に有力な選択肢になります。
現時点では、NVFP4 + MTP + llama.cpp は RTX 5090 において、最も簡単かつ高速な構成の一つと考えます。27B モデルで約毎秒 140 トークンを達成しつつ、大きなコンテキストウィンドウと実用的なコーディングエージェント機能を両立できるのは驚異的です。llama.cpp、Unsloth、DFlash 2、DSpark の改良に伴い、今後さらに高速化が見込まれます。
DataCamp で AI エンジニアになろう!
Tracks
Courses
Tracks