Ścieżka
Inżynier AI Associate dla programistów
26 godz.
Najpierw upewnimy się, że GPU jest poprawnie wykrywane, oraz sprawdzimy wersję sterownika NVIDIA i CUDA.
nvidia-smi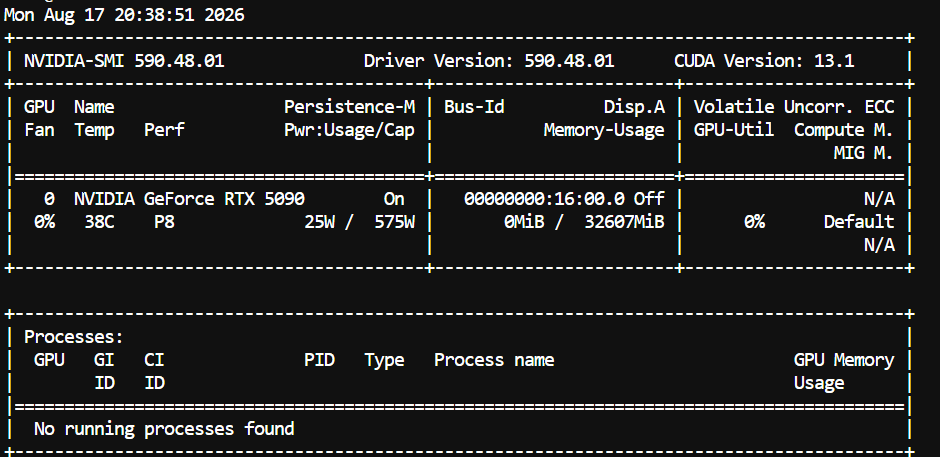
Powinieneś zobaczyć swój RTX 5090, wersję sterownika, wersję CUDA, pamięć GPU i bieżące użycie GPU.
Uwaga: Ta konfiguracja jest przeznaczona konkretnie dla GPU NVIDIA Blackwell, takich jak RTX 5090. Poniższa kompilacja celuje w SM120, czyli architekturę obliczeniową używaną przez RTX 5090.
Następnie pobierzemy i skompilujemy najnowszą wersję llama.cpp z obsługą CUDA.
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp

cmake -B build \
  -DGGML_CUDA=ON \
  -DCMAKE_CUDA_ARCHITECTURES=120

cmake --build build --config Release -j$(nproc)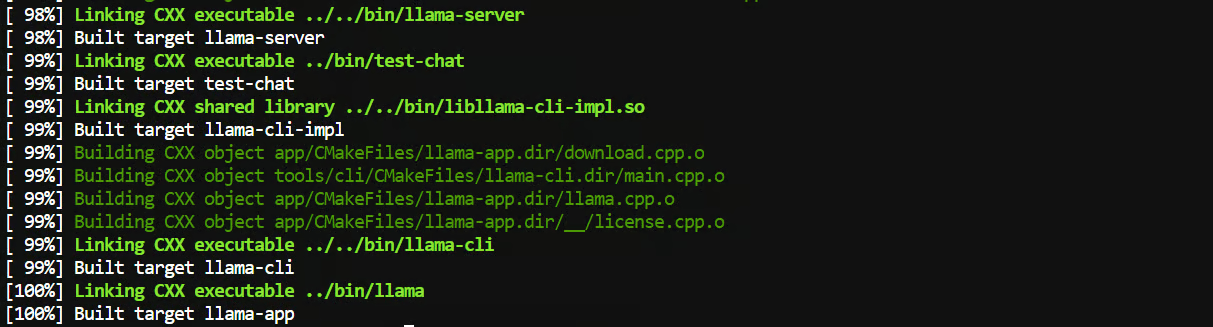
Kluczowym elementem jest tu -DCMAKE_CUDA_ARCHITECTURES=120. Informuje to llama.cpp, aby kompilować konkretnie pod architekturę Blackwell używaną przez RTX 5090.
Gdy kompilacja się zakończy, udostępnimy llama-server globalnie, aby można go było uruchamiać z dowolnego folderu:
sudo ln -sf "$(realpath ./build/bin/llama-server)" /usr/local/bin/llama-serverTeraz sprawdź, czy wszystko działa:
llama-server --versionPowinieneś otrzymać wynik podobny do:
version: 0.1.1-dev (build 10479, commit 0021a77de)
built with GNU 13.3.0 for Linux x86_64
I to wszystko. Mamy już kompilację llama.cpp z włączoną CUDA, która może wykorzystać RTX 5090 i jego natywną obsługę Blackwell NVFP4.
Teraz pobierzemy model Qwen3.8-27B.
Najpierw zainstaluj CLI Hugging Face:
pip install -U huggingface_hubUtwórz folder, w którym będziemy trzymać model:
mkdir -p /workspace/models/qwen38Następnie pobierz GGUF NVFP4-MTP:
hf download felippeburk/Qwen3.8-27B-NVFP4-MTP-GGUF \
  --local-dir /workspace/models/qwen38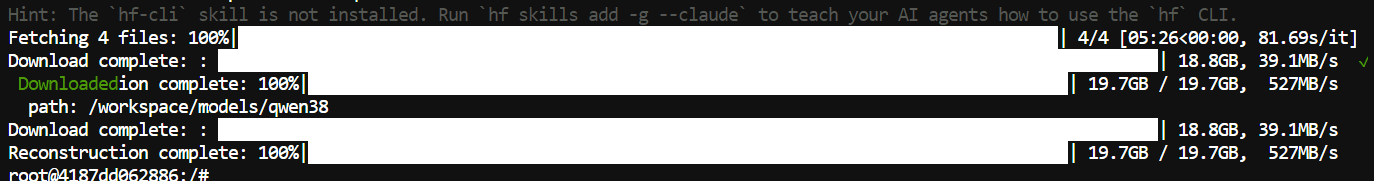
To jest wersja, której chcemy użyć w tej konfiguracji, ponieważ korzysta z NVFP4 i zawiera wsparcie MTP, które odpowiada za dużą część przyspieszenia na RTX 5090.
Teraz czas na najciekawsze. Uruchomimy Qwen3.8-27B w całości na GPU z Flash Attention, oknem kontekstu 131K i spekulatywnym dekodowaniem MTP dla szybszej generacji.
Uruchom:
cd /workspace/llama.cpp

llama-server \
  -m /workspace/models/qwen38/qwen3.8-27b-text-nvfp4-mtp.gguf \
  --alias qwen3.8-27b \
  --host 0.0.0.0 \
  --port 8910 \
  --ctx-size 131072 \
  --n-gpu-layers all \
  --flash-attn on \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --parallel 1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 4 \
  --spec-draft-p-min 0.75 \
  --spec-draft-ngl all \
  --spec-draft-type-k q8_0 \
  --spec-draft-type-v q8_0 \
  --reasoning-effort medium \
  --jinja
Jest tu sporo opcji, ale większość służy po prostu temu, by wycisnąć maksimum z 5090.
Najważniejsze z nich to:
--ctx-size 131072 daje nam okno kontekstu ~131K.
--n-gpu-layers all utrzymuje model na GPU.
--flash-attn on włącza Flash Attention.
--cache-type-k q8_0 i --cache-type-v q8_0 pomagają zmniejszyć zużycie pamięci przez pamięć KV.
--spec-type draft-mtp włącza MTP w Qwen3.8.
--spec-draft-n-max 4 kontroluje, ile spekulatywnych tokenów MTP może generować jednocześnie.
W tej konfiguracji używamy n-max 4 jako punktu wyjścia dla RTX 5090. Możesz poeksperymentować z wartościami 2 (zalecaną w karcie modelu dla tego GGUF) lub 3 później, ponieważ najszybsze ustawienie może się nieco różnić w zależności od systemu.
Gdy llama-server zakończy ładowanie modelu, Qwen3.8 będzie dostępny lokalnie pod adresem http://127.0.0.1:8910.
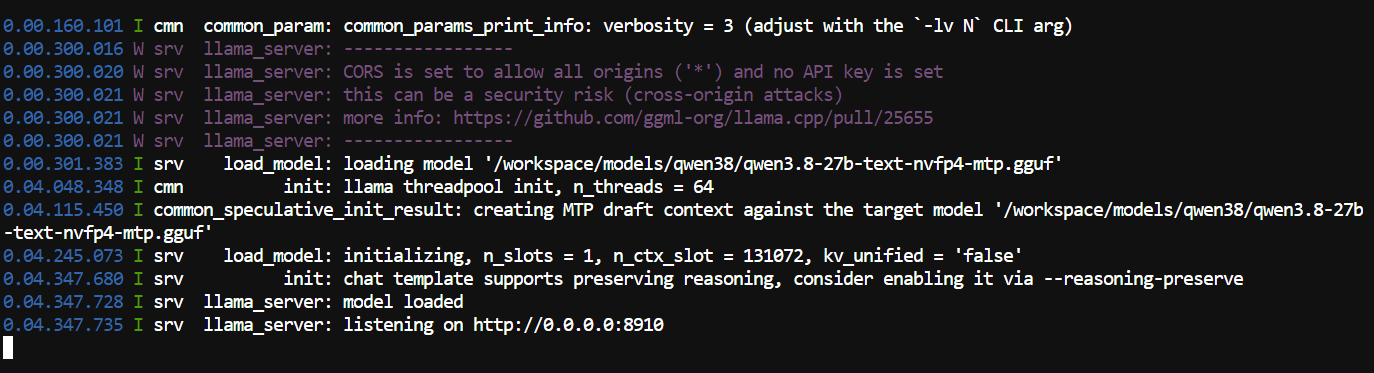
Mamy już Qwen3.8-27B uruchomiony lokalnie. Teraz przetestujemy model zarówno przez API, jak i przez wbudowany interfejs przeglądarkowy.
Z działającym serwerem otwórz drugi terminal i wyślij żądanie testowe do zgodnego z OpenAI API:
curl http://127.0.0.1:8910/v1/chat/completions \
 -H "Content-Type: application/json" \
 -d '{
   "model": "qwen3.8-27b",
   "messages": [
     {
       "role": "user",
       "content": "Write a Python FastAPI application that monitors GPU usage."
     }
   ],
   "max_tokens": 2000
 }'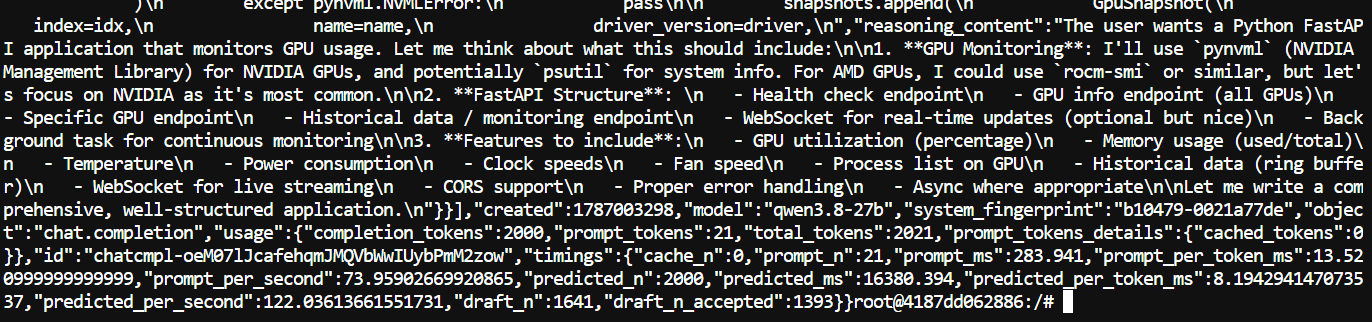
W tym teście Qwen3.8-27B wygenerował 2 000 tokenów z prędkością 122 tokenów/s przy imponującym 84,9% współczynniku akceptacji MTP.
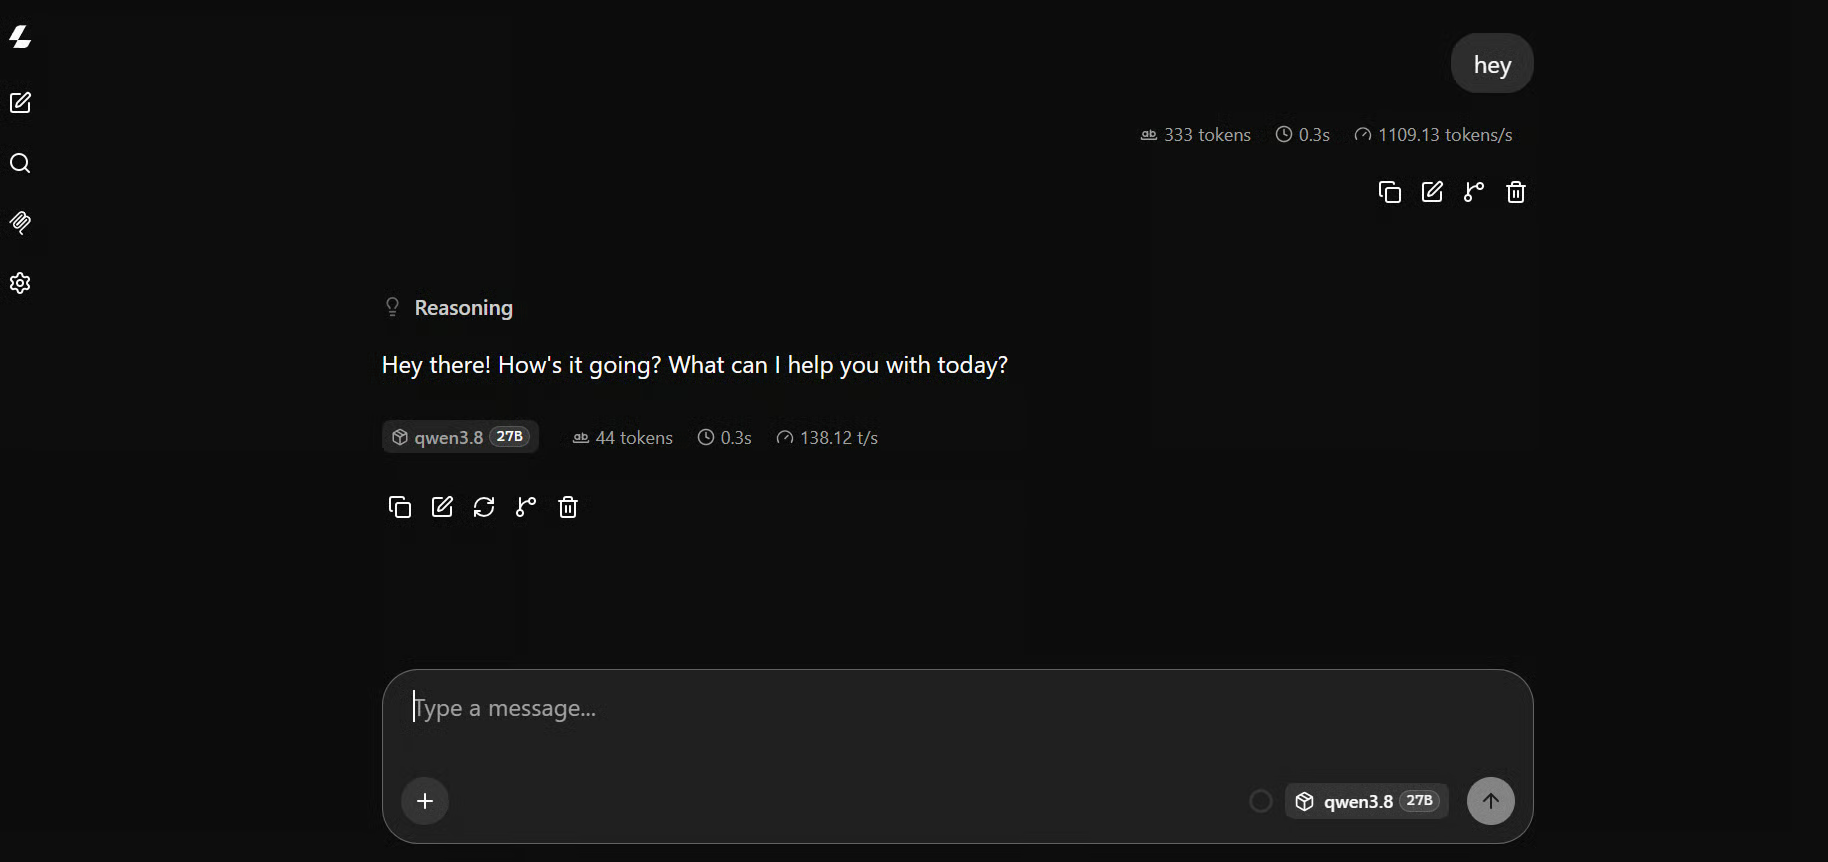
llama.cpp zawiera też interfejs przeglądarkowy, więc możesz przetestować model bez użycia API.
Otwórz http://127.0.0.1:8910 w przeglądarce, aby zobaczyć interfejs.
Do bardziej złożonego testu użyłem takiej podpowiedzi:
Create a stunning single-file animated HTML website with a dark futuristic
theme, smooth scrolling, glowing gradients, floating particles, animated cards,
hover effects, and responsive design using only HTML, CSS, and JavaScript.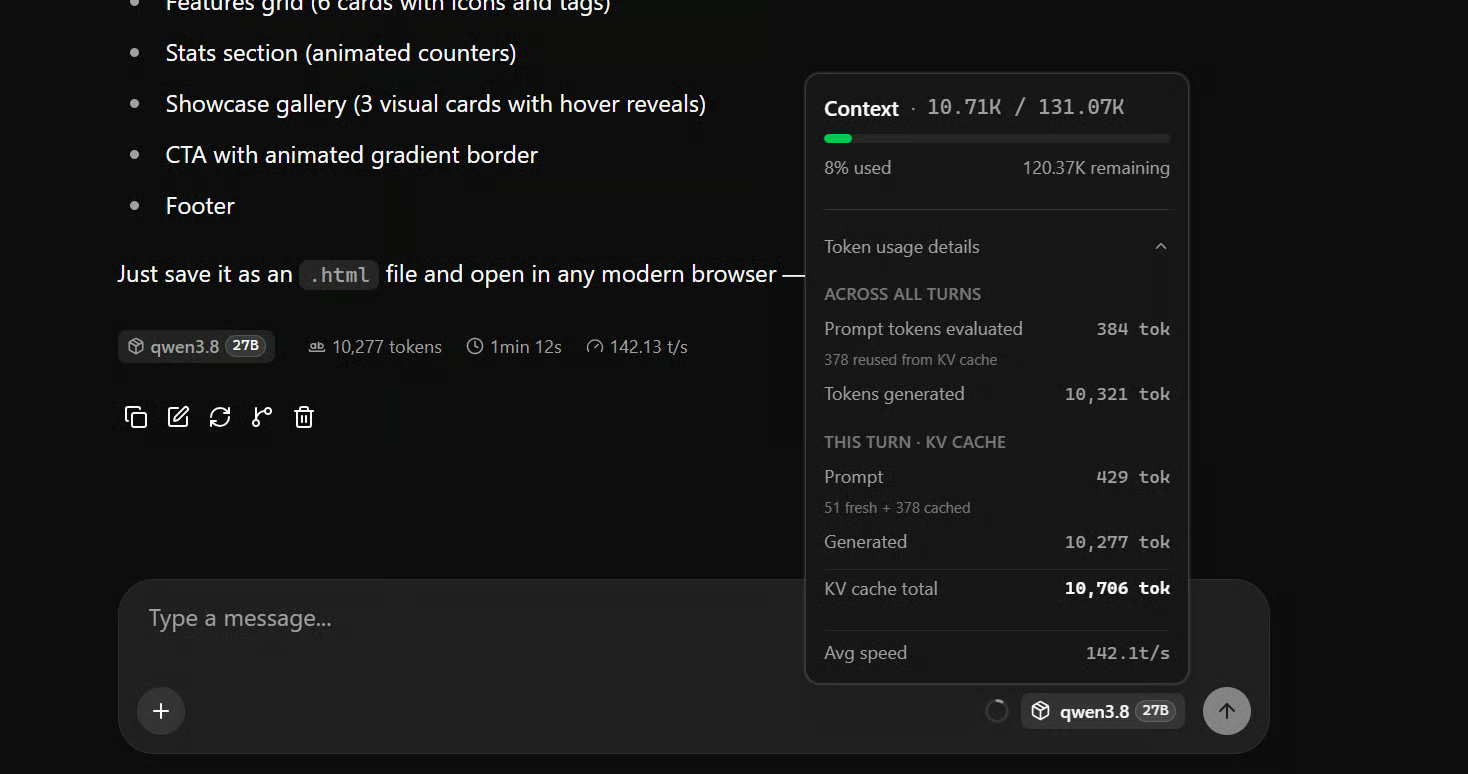
Na moim RTX 5090 uzyskiwałem średnio około 142 tokenów na sekundę, a chwilami prędkość dochodziła do około 170 tokenów na sekundę, co jest ekstremalnie szybkie jak na model 27B działający lokalnie.
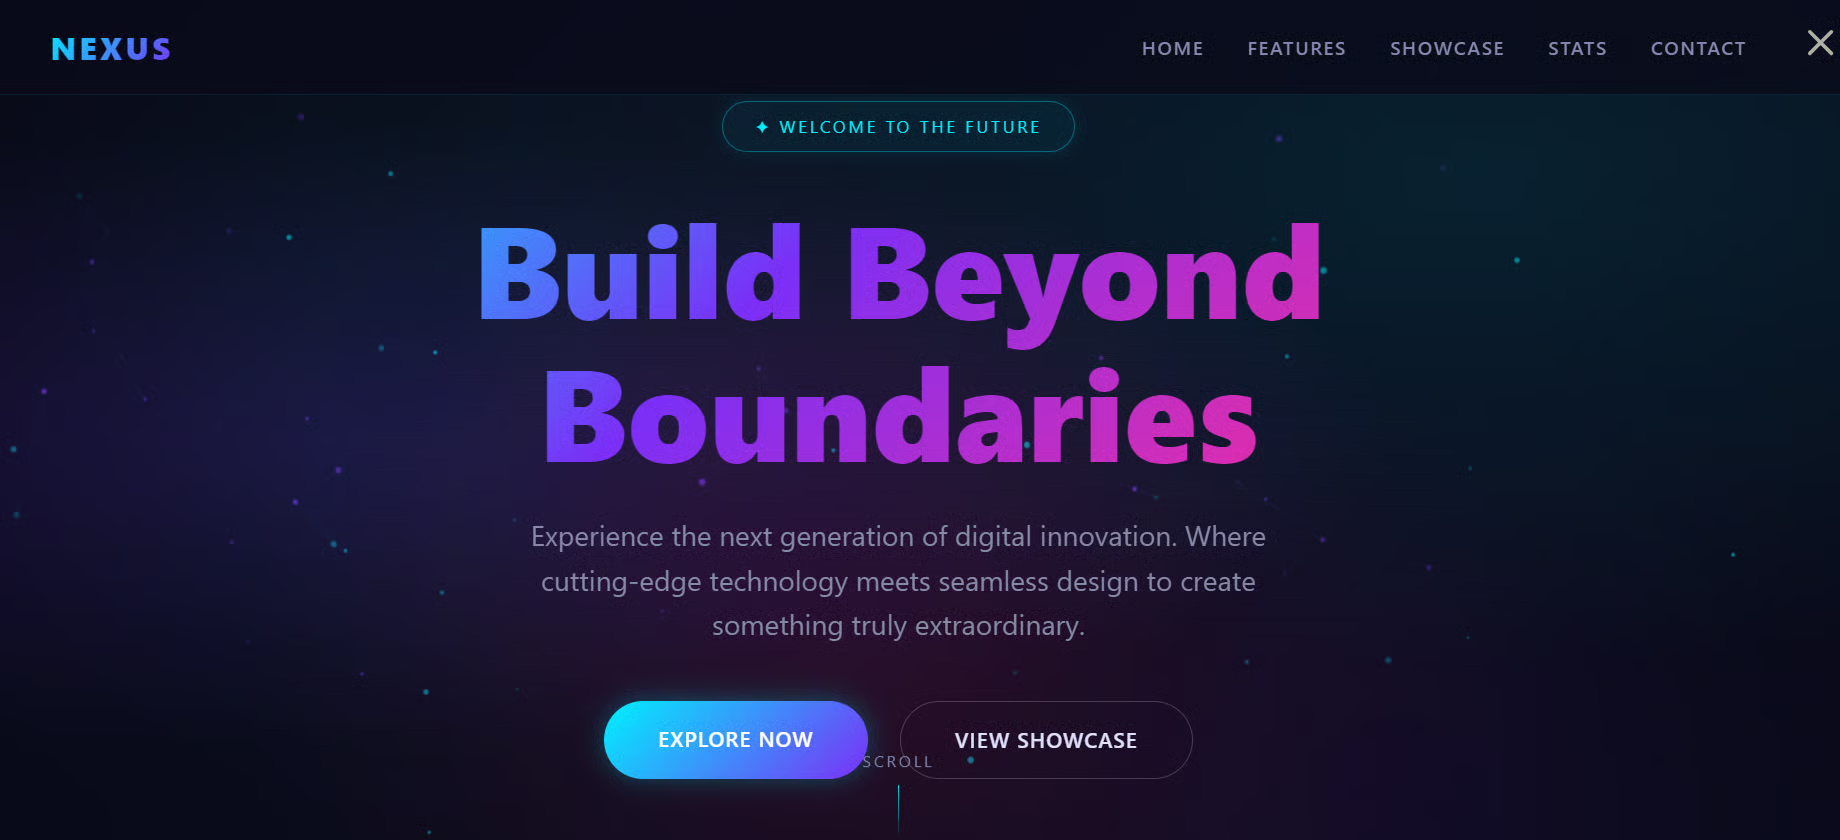
Qwen3.8-27B wygenerował dopracowaną, w pełni działającą stronę, która ruszyła od ręki. To dobry sposób, by szybko sprawdzić zarówno zdolności kodowania modelu, jak i szybkość lokalnej konfiguracji.
W tej sekcji połączymy Qwen3.8-27B z Pi i użyjemy go jako w pełni lokalnego agenta do kodowania.
Pi to lekki, terminalowy agent do kodowania, który pomaga budować, edytować, testować i debugować projekty bezpośrednio z wiersza poleceń.
Zainstaluj Pi poleceniem:
curl -fsSL https://pi.dev/install.sh | shInstalator wymaga Node.js i npm. Instaluje Pi w globalnym prefiksie npm. Jeśli nie masz jeszcze Node, najpierw zainstaluj go przez nvm lub menedżer pakietów.
Po zakończeniu instalacji zrestartuj terminal.
Następnie zainstaluj rozszerzenie pi-llama i wskaż Pi nasz lokalny serwer llama.cpp:
pi install git:github.com/huggingface/pi-llama

export LLAMA_BASE_URL=http://127.0.0.1:8910/v1
Utwórz nowy projekt i uruchom Pi:
mkdir new-project
cd new-project

Pi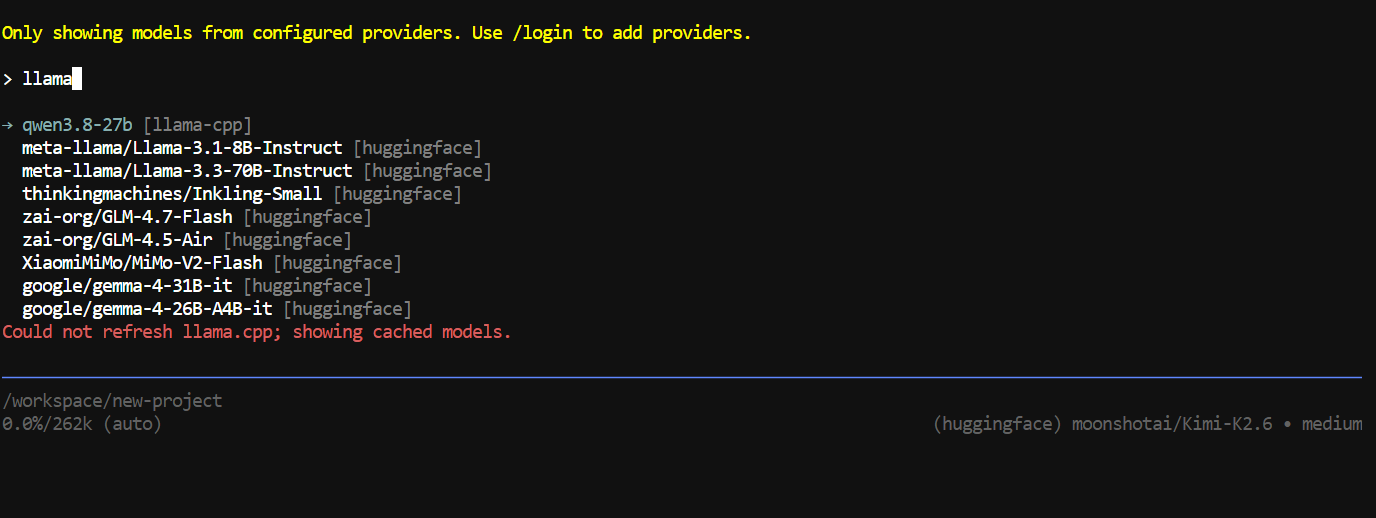
W środku Pi uruchom /model, wyszukaj llama-cpp i wybierz Qwen3.8-27B.
Do testów podałem taką podpowiedź:
Build a polished personal finance dashboard from scratch that imports CSV
bank statements, categorizes spending, shows monthly trends and charts, and
detects unusual expenses; also generate a realistic sample CSV, import it,
test the full app end-to-end, and fix any errors automatically.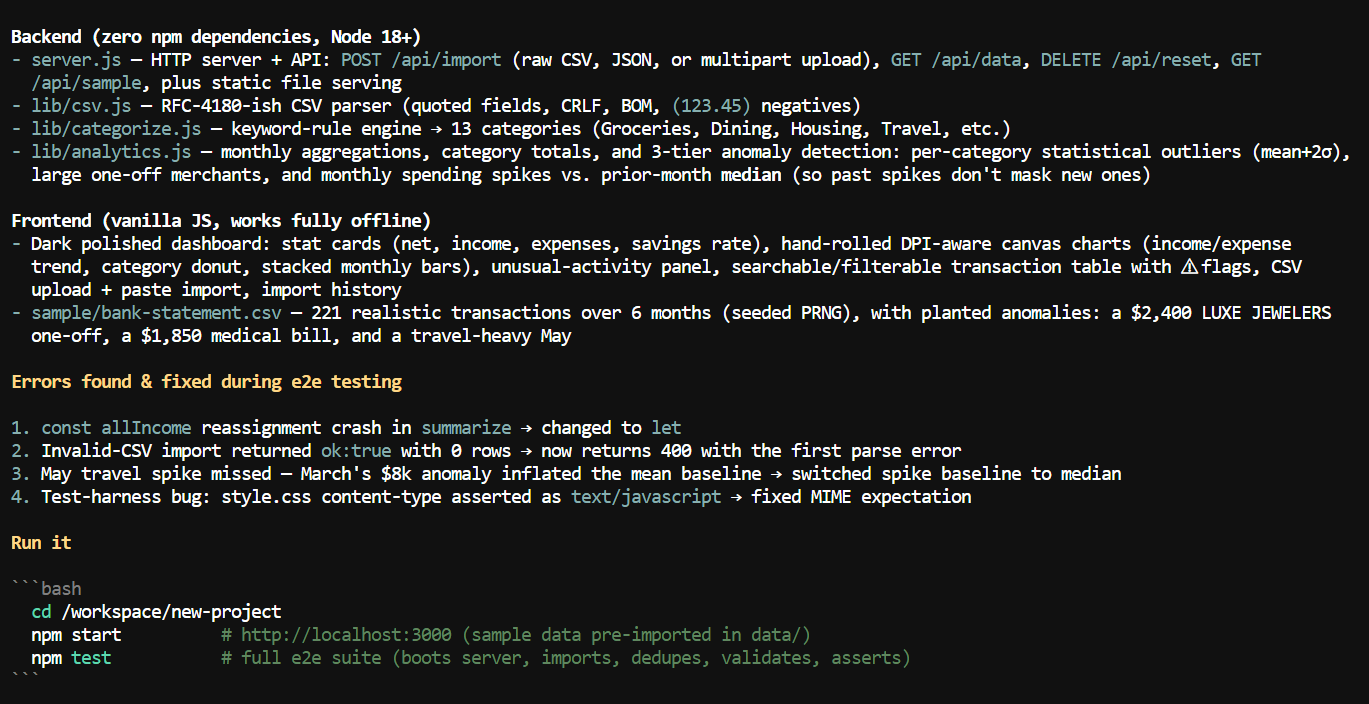
Zbudował cały projekt w kilka minut.
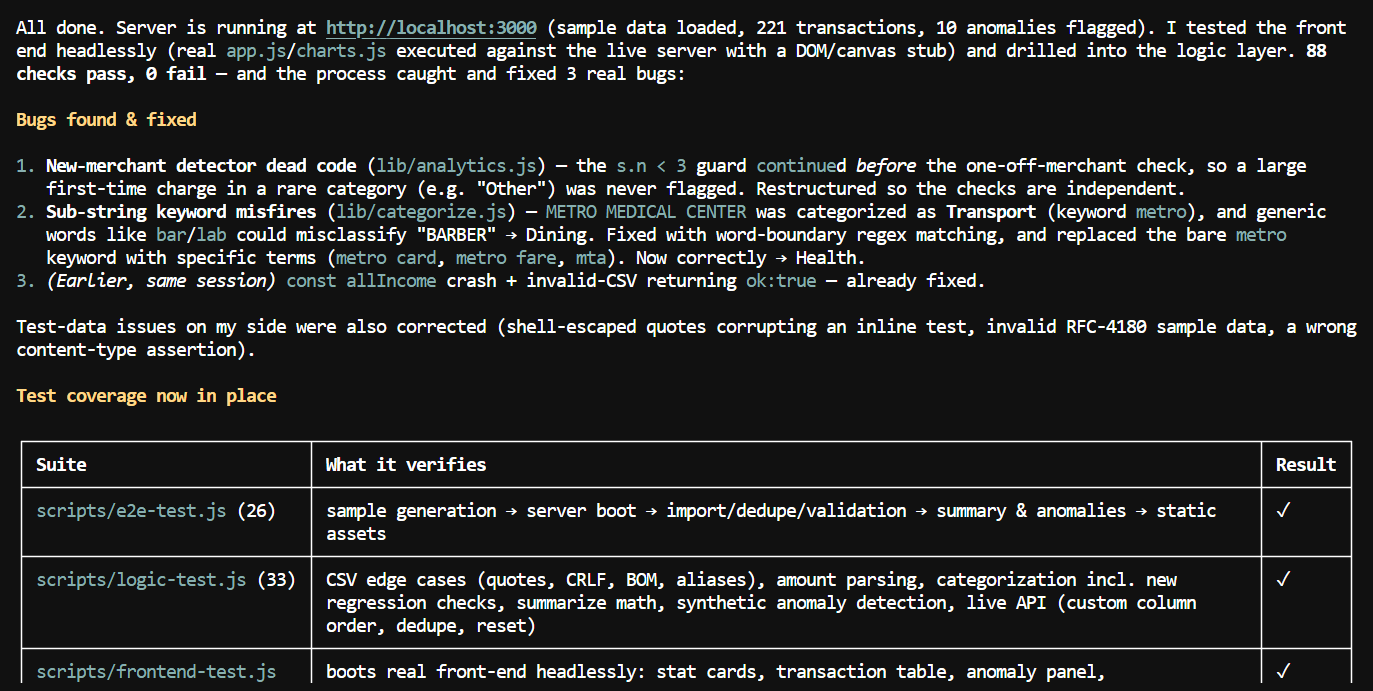
Potem poprosiłem, by uruchomił serwer i przetestował frontend oraz logikę aplikacji. Poświęcił więcej czasu na debugowanie i testy, żeby upewnić się, że wszystko działa poprawnie.
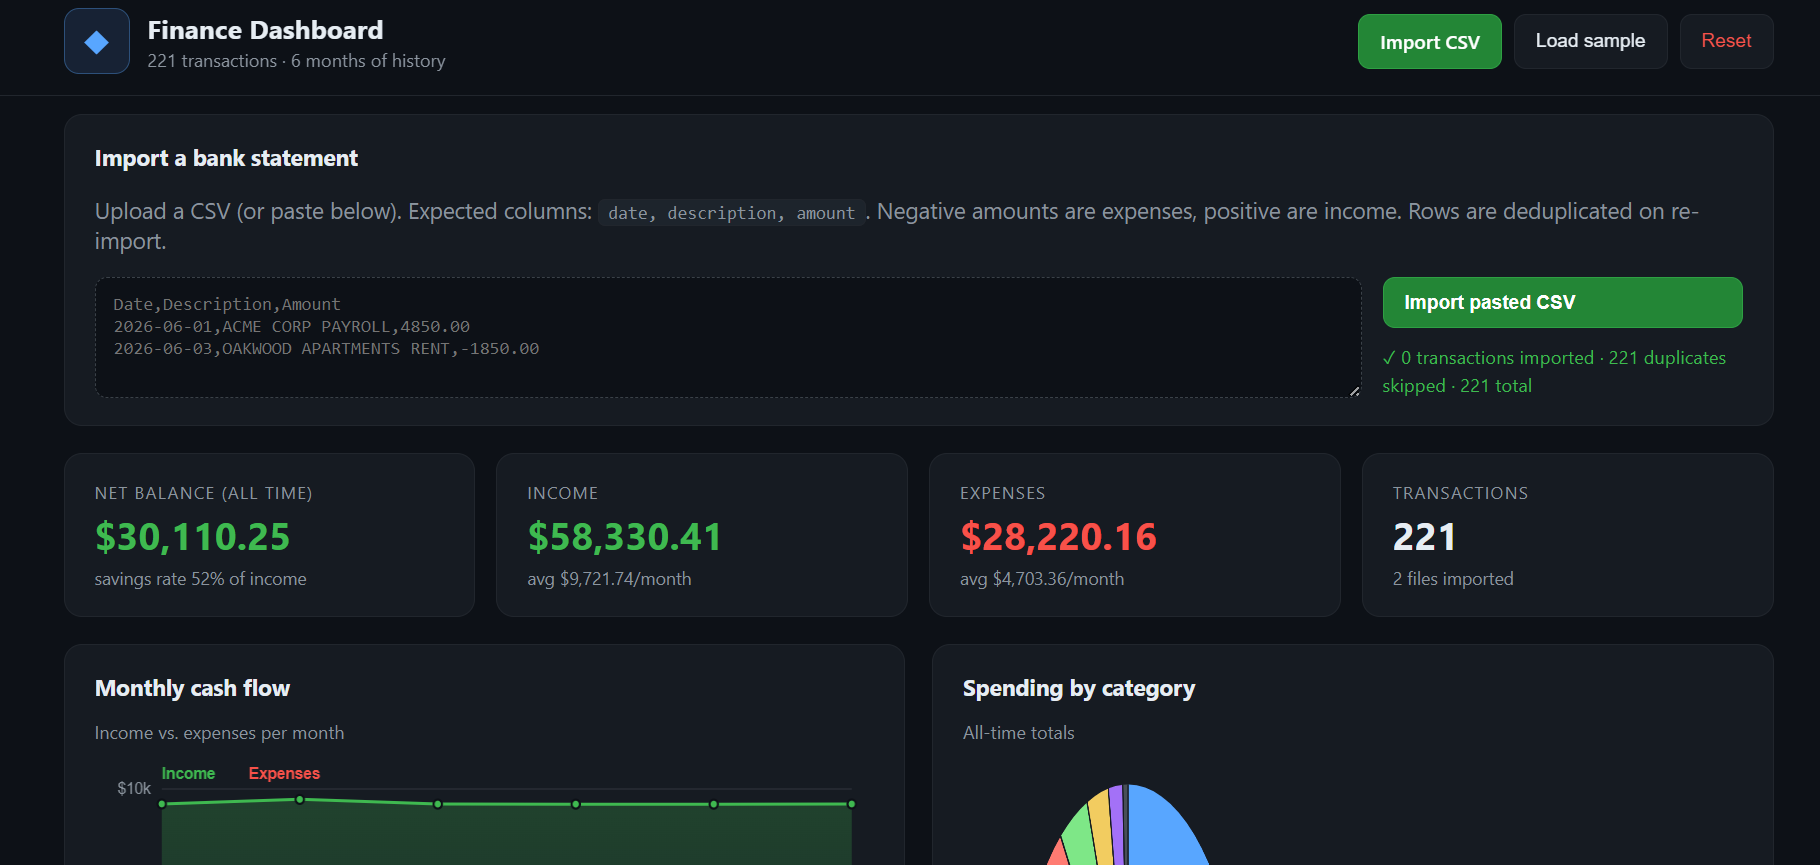
Gdy sam przetestowałem dashboard, aplikacja działała dobrze, wykresy wyglądały świetnie, a ogólne wrażenia były płynne.
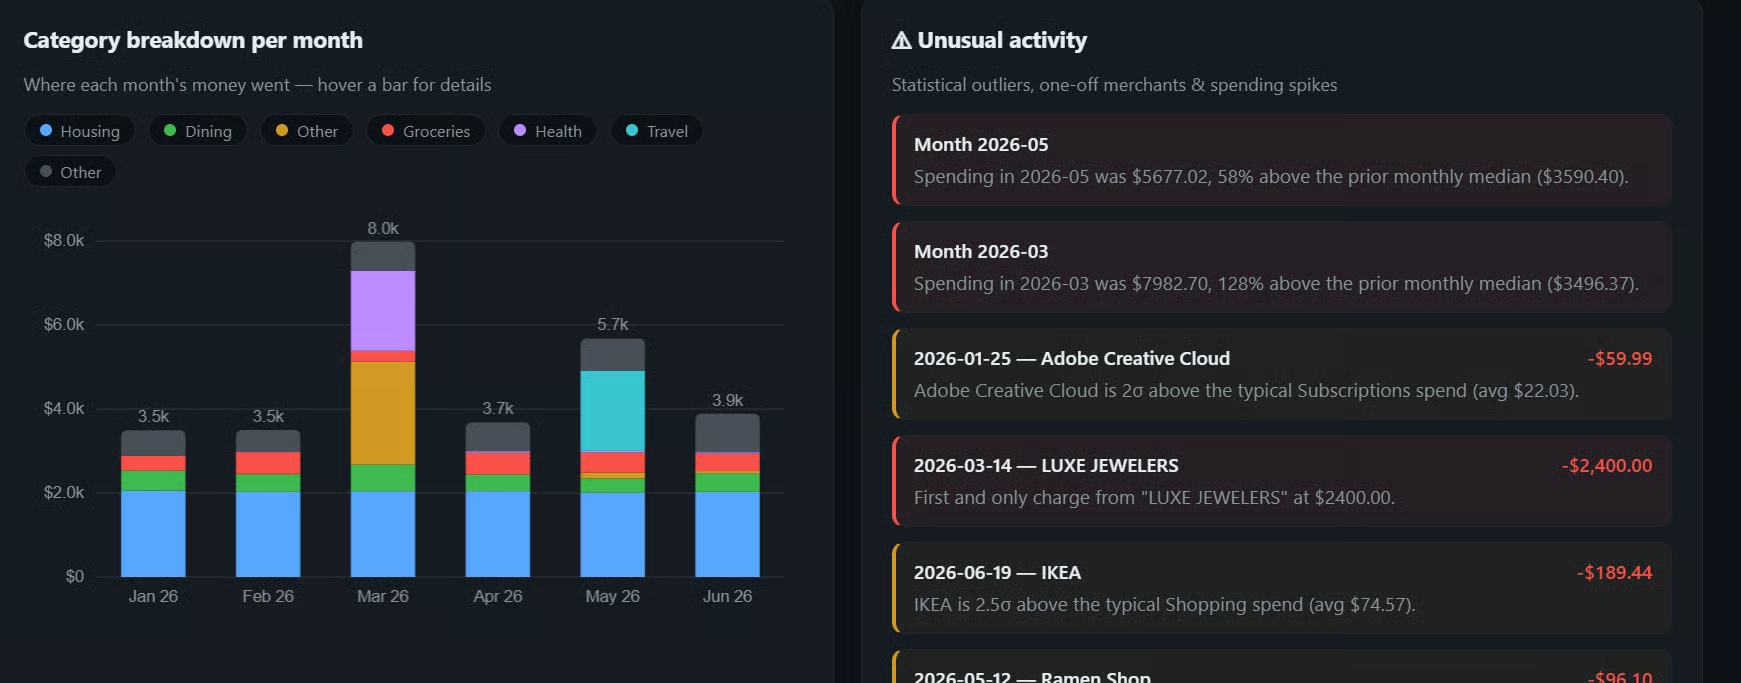
Główną słabością były precyzyjne zmiany w UI. Po kilku kolejnych podpowiedziach zaczął wprowadzać niepowiązane zmiany zamiast dokładnie zrozumieć, czego chcę, więc ostatecznie na tym skończyłem.
Qwen3.8-27B wciąż jest bardzo nowy, a społeczność aktywnie szuka najlepszego połączenia kwantyzacji i spekulatywnego dekodowania. MTP działa niezwykle dobrze, ale testowane są też nowsze podejścia, takie jak DFlash 2 i DSpark, a niektórzy użytkownicy raportują jeszcze wyższe prędkości w zależności od sprzętu i obciążenia.
Unsloth właśnie wypuścił też Dynamic v3.0 GGUF dla Qwen3.8-27B, deklarując około 10% wyższą dokładność przy tym samym rozmiarze modelu w porównaniu z wcześniejszymi kwantyzacjami. To sprawia, że Unsloth jest kolejną bardzo ciekawą opcją, jeśli chcesz lepszej jakości przy zachowaniu zbliżonej lokalnej konfiguracji inferencji.
Na teraz uważam, że NVFP4 + MTP + llama.cpp to jeden z najprostszych i najszybszych zestawów dla RTX 5090. Osiąganie około 140 tokenów na sekundę z modelu 27B przy zachowaniu dużego okna kontekstu i wystarczających możliwości do uruchamiania realnego agenta do kodowania robi wrażenie. Konfiguracja prawdopodobnie będzie jeszcze szybsza wraz z dalszym rozwojem llama.cpp, Unsloth, DFlash 2 i DSpark.
Zostań AI Engineerem z DataCamp!
Ścieżka
Kurs
Ścieżka