
Tracks
Kỹ sư Trợ lý Trí tuệ Nhân tạo (AI) cho Lập trình viên
26 giờ
Trước hết, chúng ta sẽ đảm bảo GPU được nhận diện đúng và kiểm tra phiên bản driver NVIDIA cùng CUDA.
nvidia-smi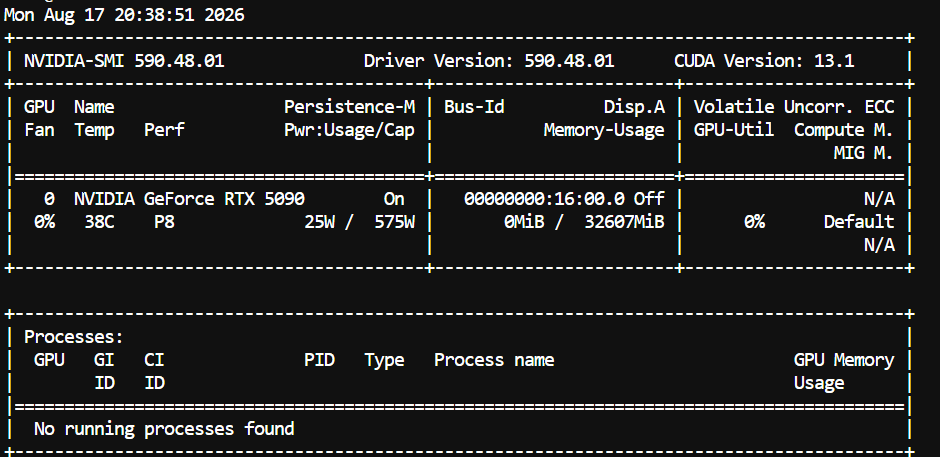
Bạn sẽ thấy RTX 5090 của mình, phiên bản driver, phiên bản CUDA, bộ nhớ GPU và mức sử dụng GPU hiện tại.
Lưu ý: Thiết lập này dành riêng cho GPU NVIDIA Blackwell, như RTX 5090. Bản dựng dưới đây nhắm tới SM120, tức kiến trúc tính toán dùng bởi RTX 5090.
Tiếp theo, chúng ta sẽ tải và biên dịch phiên bản mới nhất của llama.cpp với hỗ trợ CUDA.
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp

cmake -B build \
  -DGGML_CUDA=ON \
  -DCMAKE_CUDA_ARCHITECTURES=120

cmake --build build --config Release -j$(nproc)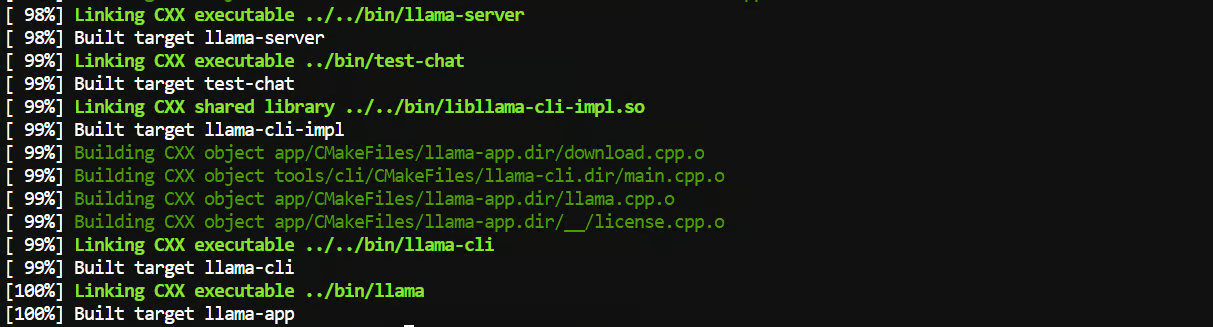
Phần quan trọng ở đây là -DCMAKE_CUDA_ARCHITECTURES=120. Cờ này yêu cầu llama.cpp biên dịch dành riêng cho kiến trúc Blackwell dùng bởi RTX 5090.
Khi biên dịch xong, chúng ta sẽ đưa llama-server vào phạm vi dùng chung để có thể chạy từ bất kỳ thư mục nào:
sudo ln -sf "$(realpath ./build/bin/llama-server)" /usr/local/bin/llama-serverBây giờ, kiểm tra mọi thứ hoạt động:
llama-server --versionBạn sẽ nhận được đầu ra tương tự như:
version: 0.1.1-dev (build 10479, commit 0021a77de)
built with GNU 13.3.0 for Linux x86_64
Vậy là xong. Chúng ta đã có một bản dựng llama.cpp bật CUDA có thể tận dụng RTX 5090 và hỗ trợ NVFP4 gốc của Blackwell.
Giờ chúng ta sẽ tải mô hình Qwen3.8-27B.
Trước tiên, cài đặt Hugging Face CLI:
pip install -U huggingface_hubTạo một thư mục để lưu mô hình:
mkdir -p /workspace/models/qwen38Sau đó tải GGUF NVFP4-MTP:
hf download felippeburk/Qwen3.8-27B-NVFP4-MTP-GGUF \
  --local-dir /workspace/models/qwen38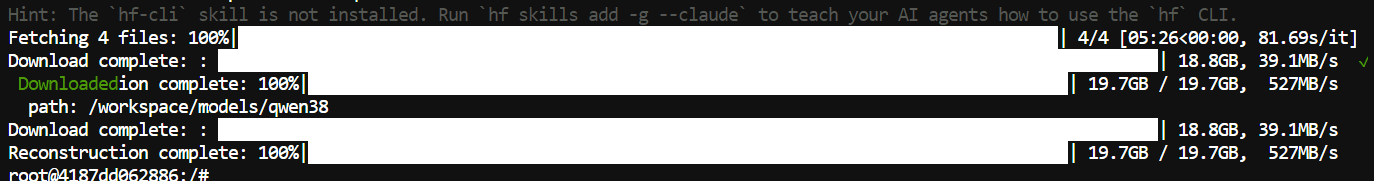
Đây là phiên bản chúng ta cần cho thiết lập này vì nó dùng NVFP4 và bao gồm hỗ trợ MTP, vốn là nơi mang lại nhiều cải thiện tốc độ trên RTX 5090.
Giờ đến phần thú vị. Chúng ta sẽ phục vụ Qwen3.8-27B hoàn toàn trên GPU với Flash Attention, cửa sổ ngữ cảnh 131K và suy đoán giải mã MTP để tạo sinh nhanh hơn.
Chạy:
cd /workspace/llama.cpp

llama-server \
  -m /workspace/models/qwen38/qwen3.8-27b-text-nvfp4-mtp.gguf \
  --alias qwen3.8-27b \
  --host 0.0.0.0 \
  --port 8910 \
  --ctx-size 131072 \
  --n-gpu-layers all \
  --flash-attn on \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --parallel 1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 4 \
  --spec-draft-p-min 0.75 \
  --spec-draft-ngl all \
  --spec-draft-type-k q8_0 \
  --spec-draft-type-v q8_0 \
  --reasoning-effort medium \
  --jinja
Có khá nhiều tùy chọn ở đây, nhưng phần lớn chỉ để tận dụng tối đa hiệu năng của 5090.
Những tùy chọn chính cần biết là:
--ctx-size 131072 cho chúng ta cửa sổ ngữ cảnh khoảng 131K.
--n-gpu-layers all giữ mô hình trên GPU.
--flash-attn on bật Flash Attention.
--cache-type-k q8_0 và --cache-type-v q8_0 giúp giảm bộ nhớ KV cache.
--spec-type draft-mtp bật suy đoán giải mã MTP của Qwen3.8.
--spec-draft-n-max 4 kiểm soát số token suy đoán MTP có thể tạo cùng lúc.
Với thiết lập này, chúng ta dùng n-max 4 làm điểm khởi đầu cho RTX 5090. Bạn có thể thử các giá trị như 2 (được thẻ mô hình khuyến nghị cho GGUF này) hoặc 3 sau đó, vì thiết lập nhanh nhất có thể hơi khác nhau tùy hệ thống của bạn.
Khi llama-server tải mô hình xong, Qwen3.8 sẽ có sẵn cục bộ tại http://127.0.0.1:8910.
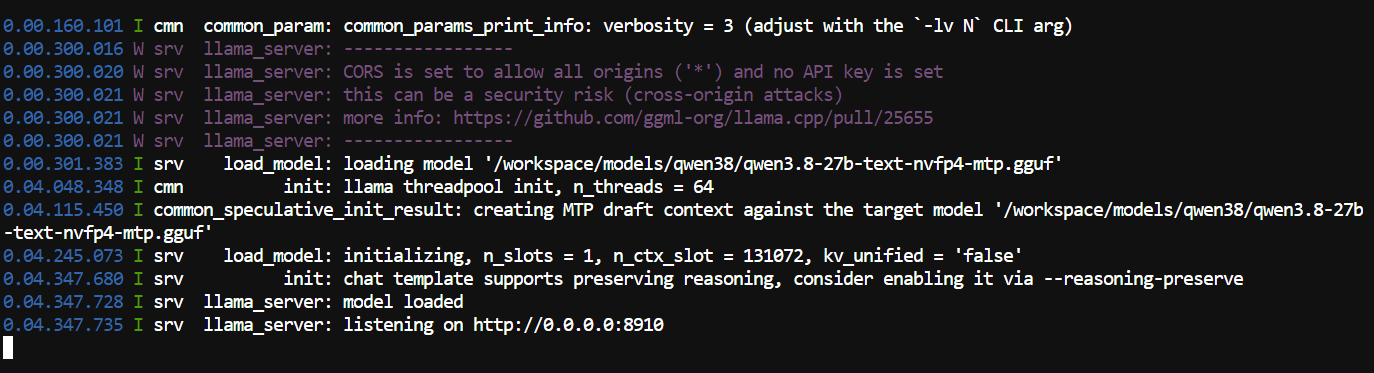
Giờ chúng ta đã chạy Qwen3.8-27B cục bộ. Tiếp theo, chúng ta sẽ kiểm thử mô hình qua cả API và giao diện trình duyệt tích hợp.
Khi máy chủ đang chạy, mở một terminal khác và gửi yêu cầu thử nghiệm tới API tương thích OpenAI:
curl http://127.0.0.1:8910/v1/chat/completions \
 -H "Content-Type: application/json" \
 -d '{
   "model": "qwen3.8-27b",
   "messages": [
     {
       "role": "user",
       "content": "Write a Python FastAPI application that monitors GPU usage."
     }
   ],
   "max_tokens": 2000
 }'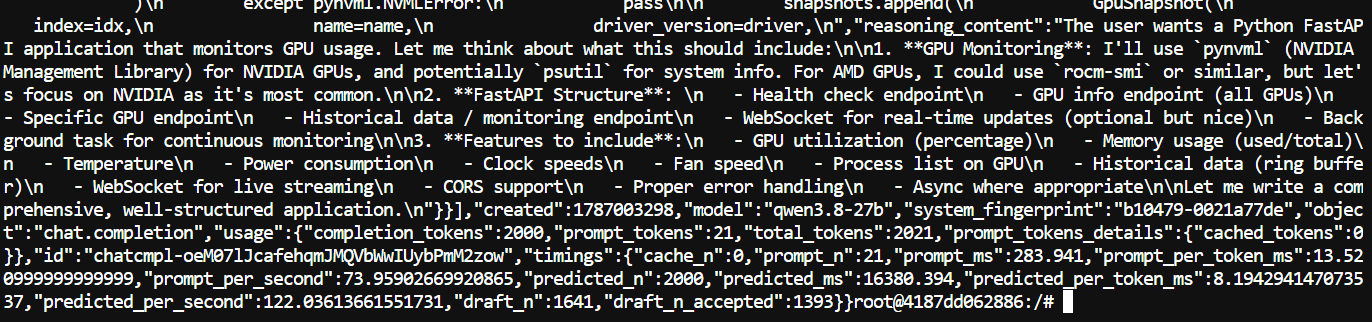
Trong bài test này, Qwen3.8-27B tạo 2.000 token ở tốc độ 122 token/giây với tỷ lệ chấp nhận MTP ấn tượng 84,9%.
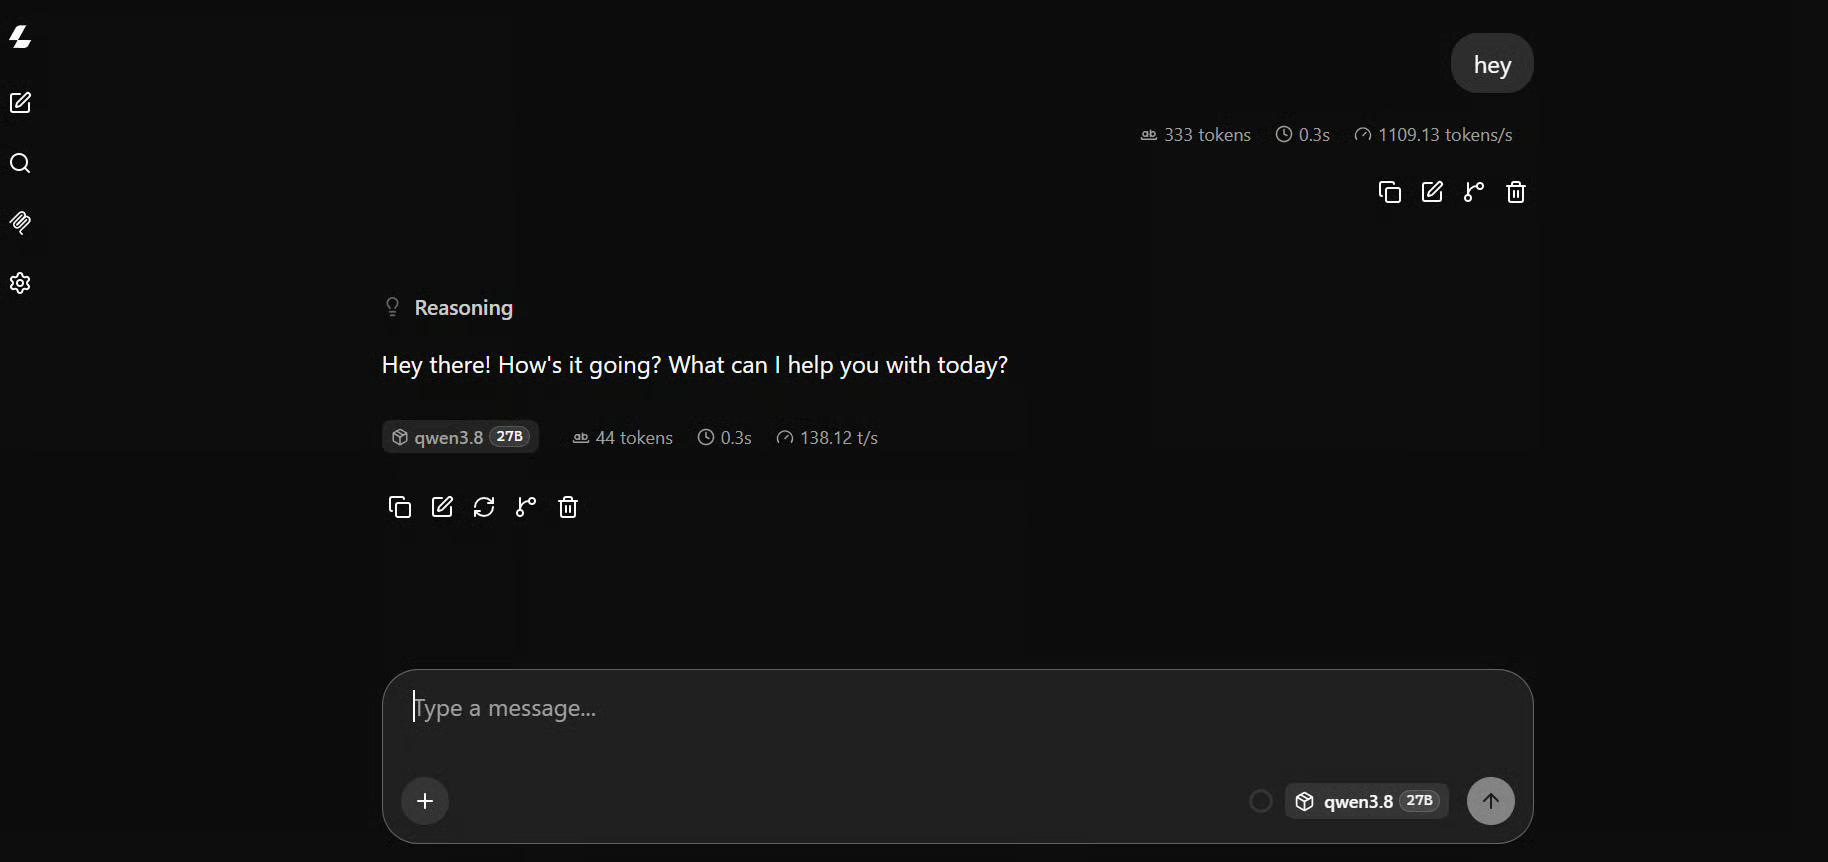
llama.cpp cũng bao gồm giao diện trình duyệt, vì vậy bạn có thể thử mô hình mà không cần dùng API.
Mở http://127.0.0.1:8910 trong trình duyệt để xem giao diện.
Cho một bài test phức tạp hơn, tôi dùng prompt này:
Create a stunning single-file animated HTML website with a dark futuristic
theme, smooth scrolling, glowing gradients, floating particles, animated cards,
hover effects, and responsive design using only HTML, CSS, and JavaScript.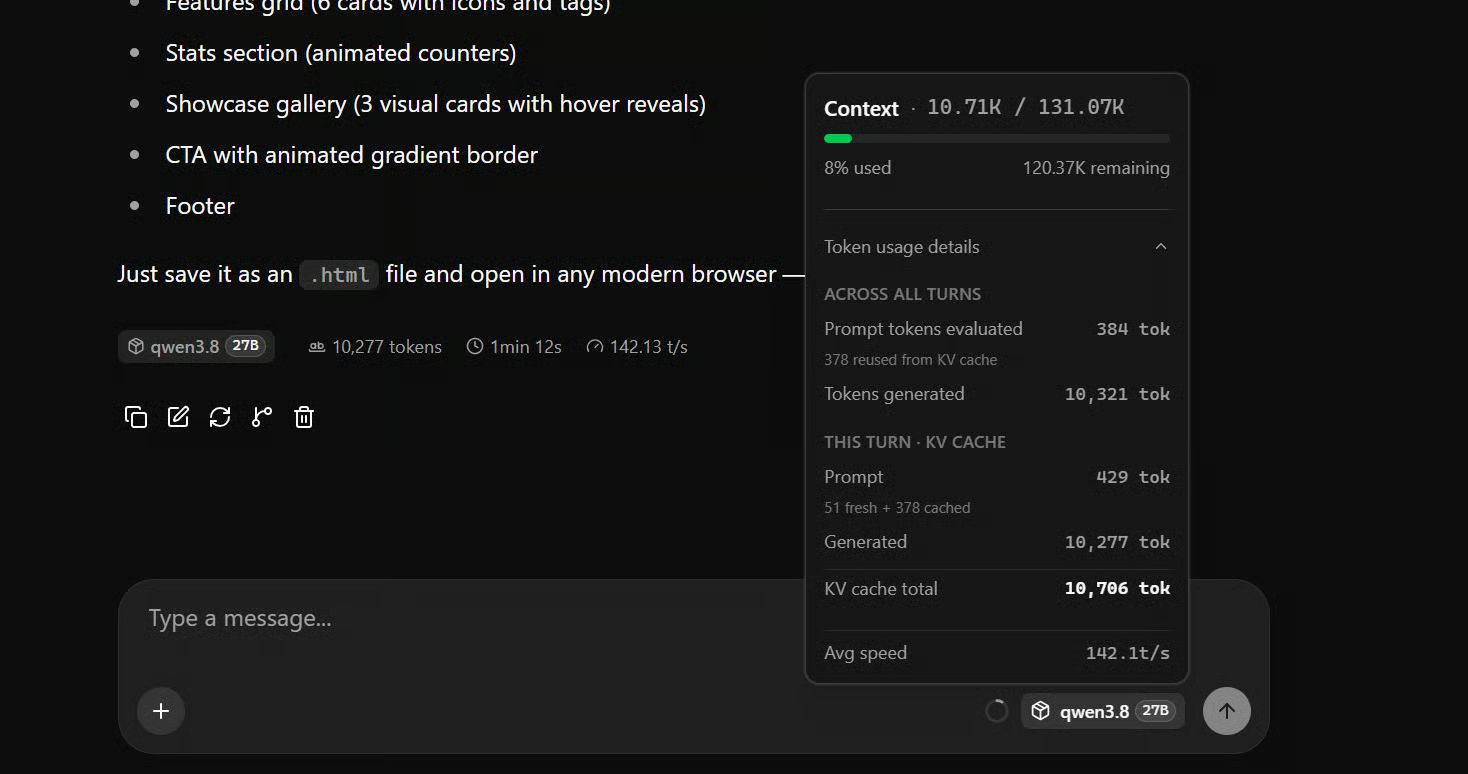
Trên RTX 5090 của tôi, tốc độ trung bình khoảng 142 token mỗi giây, đôi lúc đạt khoảng 170 token mỗi giây, cực kỳ nhanh đối với một mô hình 27B chạy cục bộ.
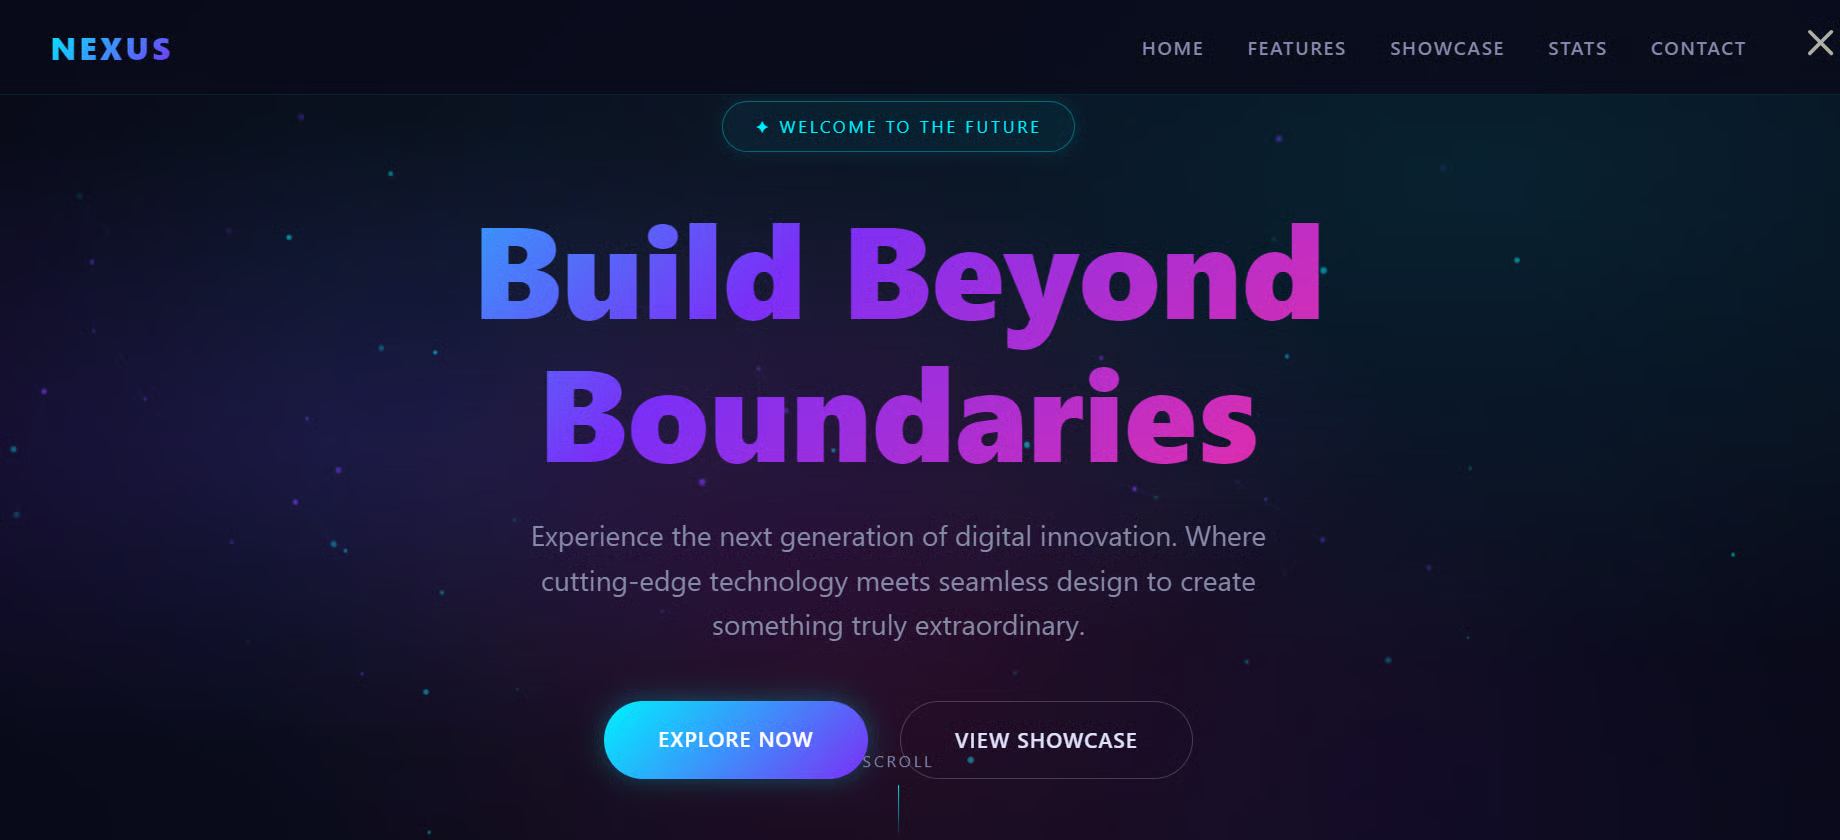
Qwen3.8-27B đã tạo một website chỉn chu, hoạt động hoàn chỉnh, chạy ngay lập tức. Đây là cách tốt để nhanh chóng kiểm thử cả khả năng lập trình của mô hình lẫn tốc độ thiết lập cục bộ.
Trong phần này, chúng ta sẽ kết nối Qwen3.8-27B với Pi và dùng nó như một agent lập trình hoàn toàn cục bộ.
Pi là một agent lập trình gọn nhẹ chạy trong terminal, có thể giúp bạn xây dựng, chỉnh sửa, kiểm thử và gỡ lỗi dự án trực tiếp từ dòng lệnh.
Cài đặt Pi với:
curl -fsSL https://pi.dev/install.sh | shTrình cài đặt yêu cầu Node.js và npm. Nó cài Pi vào prefix npm toàn cục của bạn. Nếu bạn chưa có Node, hãy cài trước bằng nvm hoặc trình quản lý gói của bạn.
Khi cài đặt xong, khởi động lại terminal.
Tiếp theo, cài đặt extension pi-llama và trỏ Pi tới máy chủ llama.cpp cục bộ của chúng ta:
pi install git:github.com/huggingface/pi-llama

export LLAMA_BASE_URL=http://127.0.0.1:8910/v1
Tạo một dự án mới và khởi động Pi:
mkdir new-project
cd new-project

Pi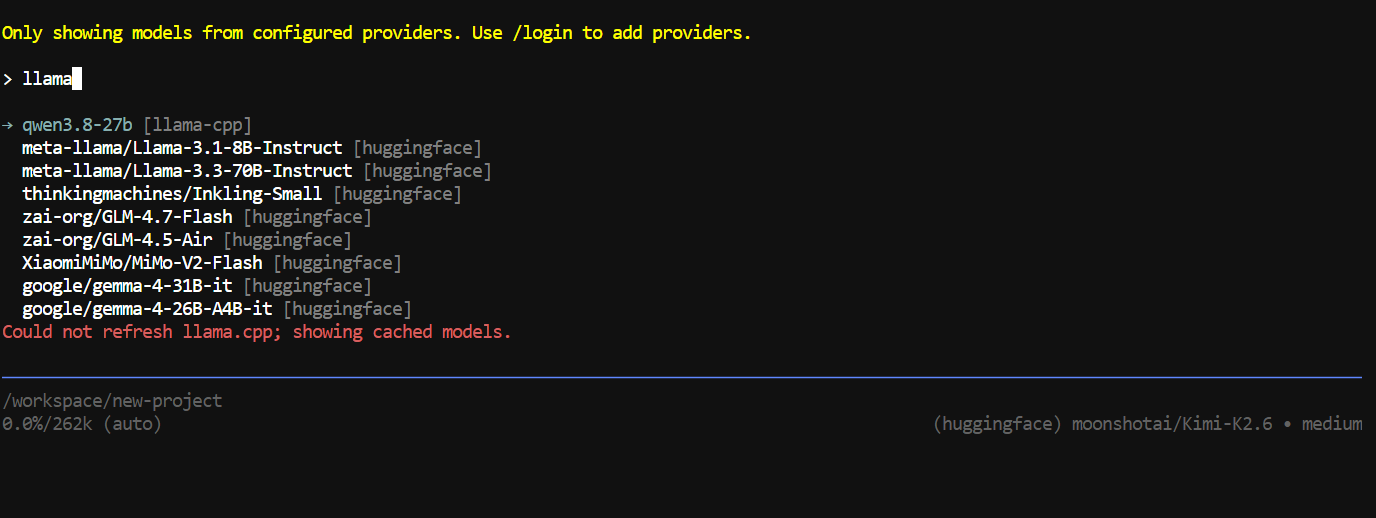
Bên trong Pi, chạy /model, tìm llama-cpp và chọn Qwen3.8-27B.
Để kiểm thử, tôi đưa prompt này:
Build a polished personal finance dashboard from scratch that imports CSV
bank statements, categorizes spending, shows monthly trends and charts, and
detects unusual expenses; also generate a realistic sample CSV, import it,
test the full app end-to-end, and fix any errors automatically.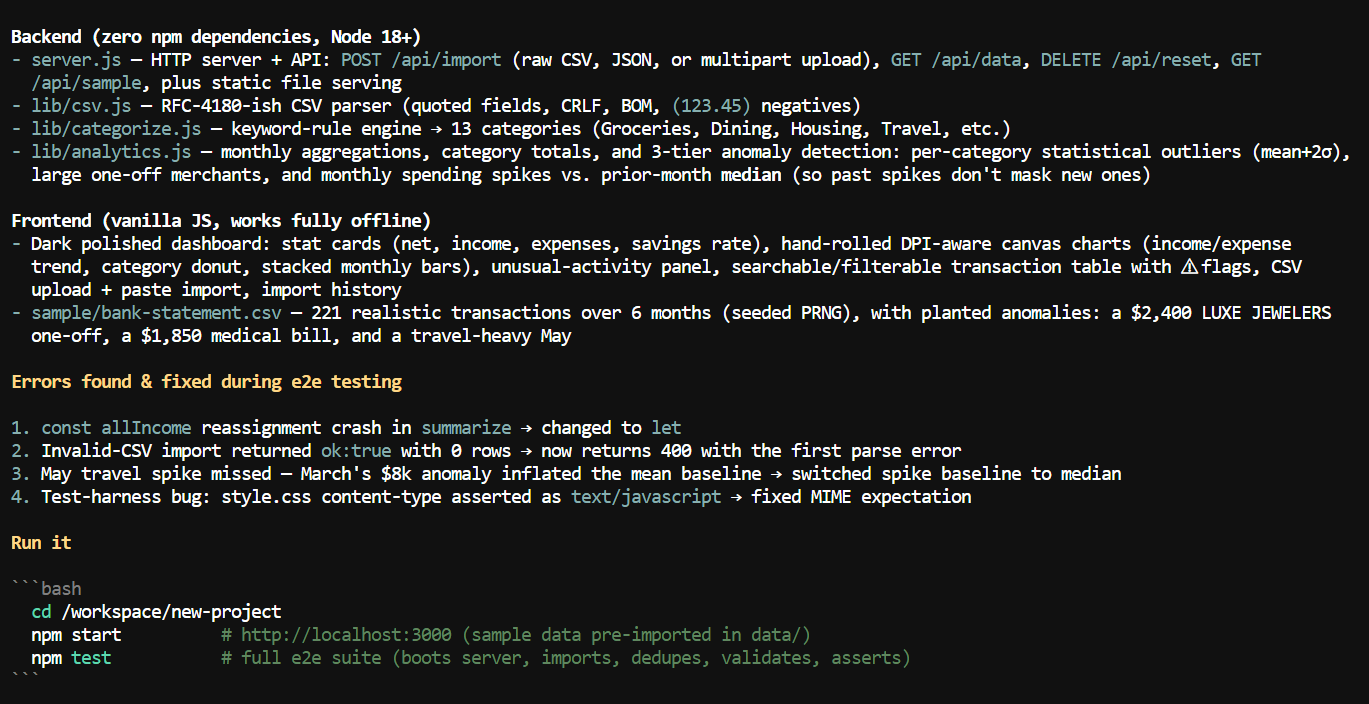
Nó đã xây dựng toàn bộ dự án chỉ trong vài phút.
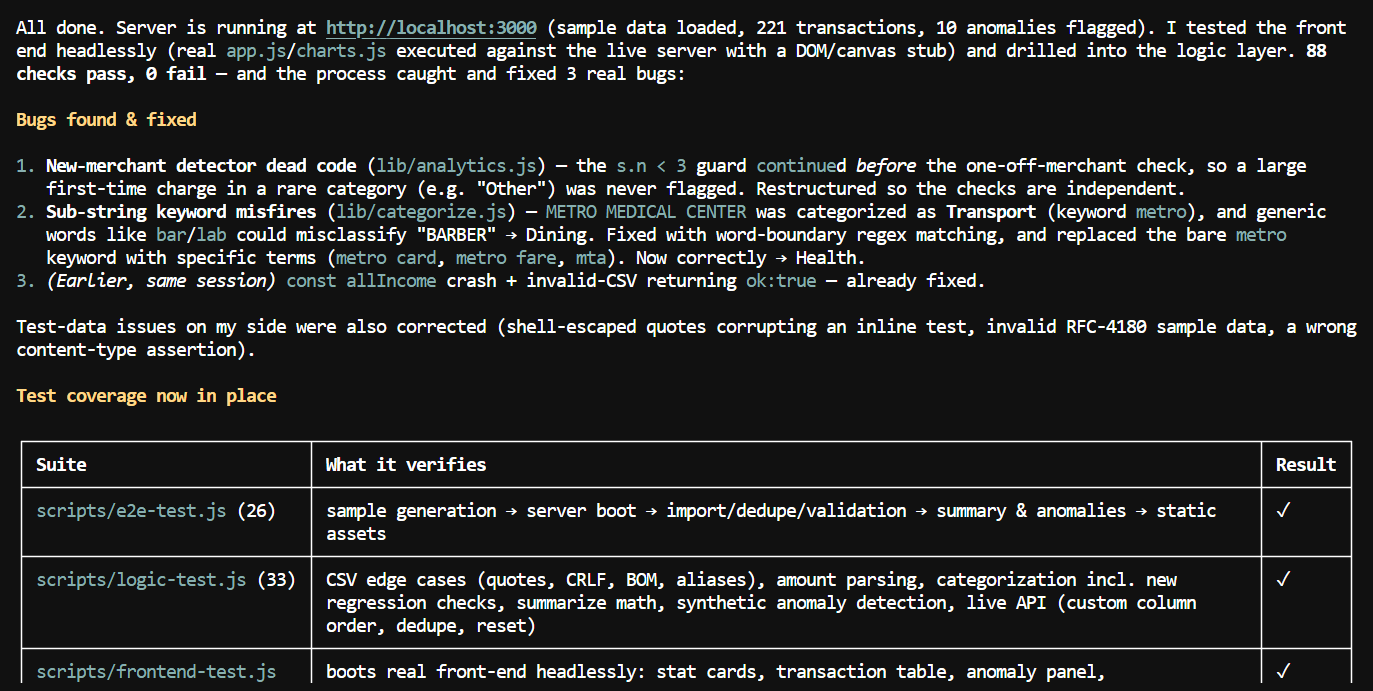
Sau đó tôi yêu cầu nó khởi động máy chủ và kiểm thử cả frontend lẫn logic ứng dụng. Nó dành nhiều thời gian gỡ lỗi và kiểm thử để đảm bảo mọi thứ hoạt động đúng.
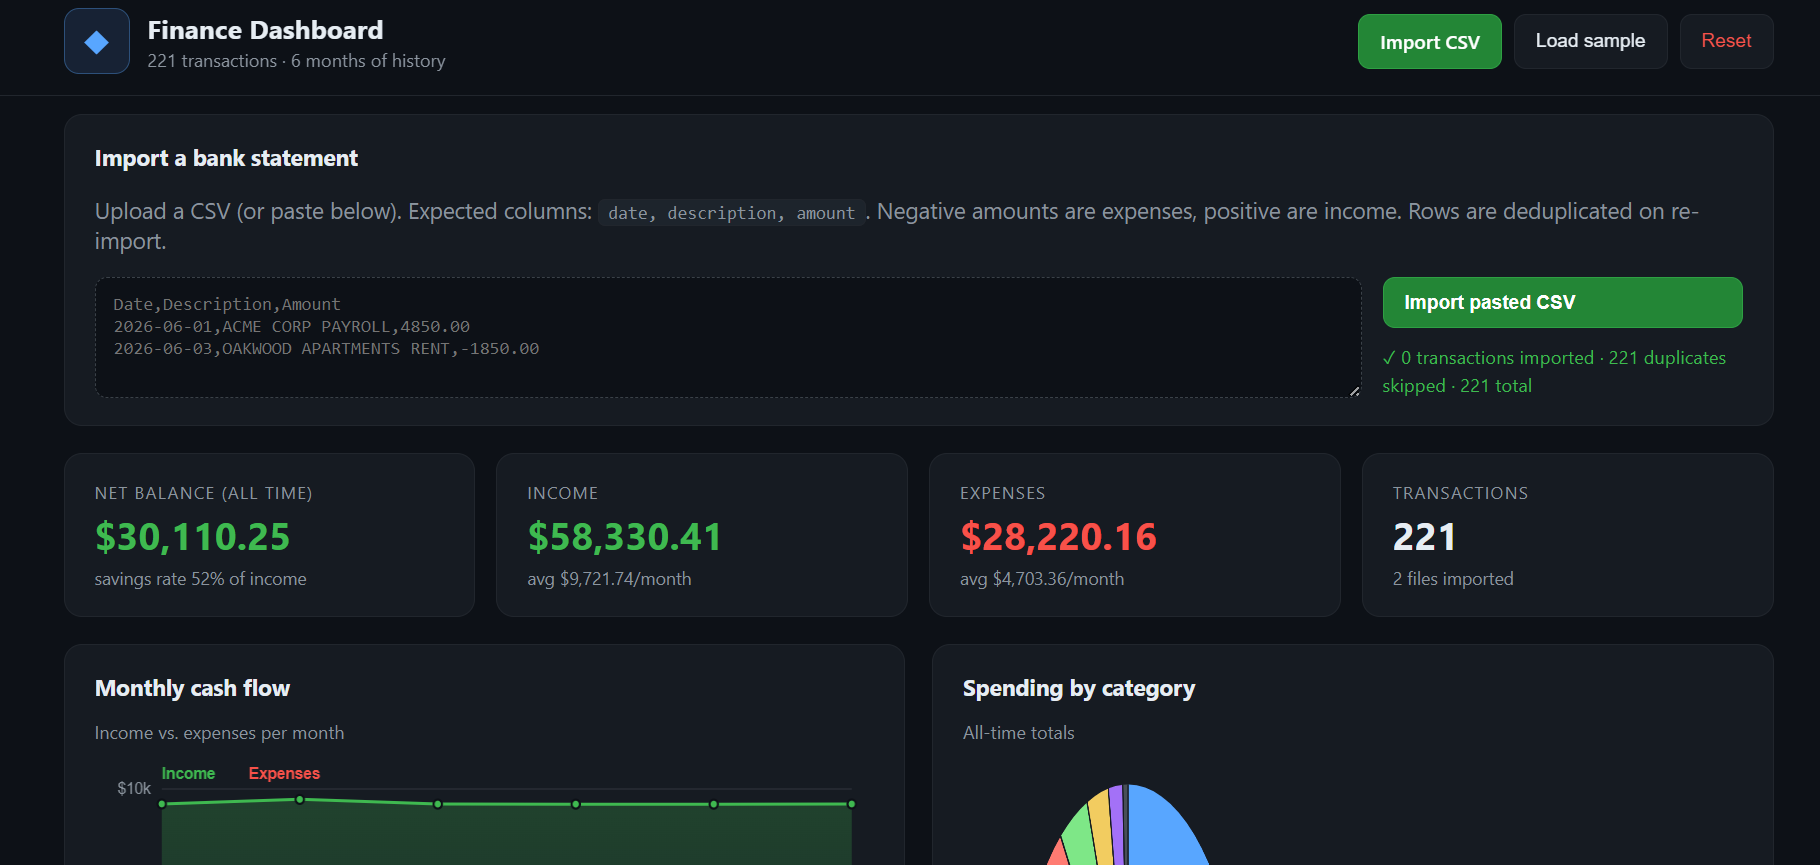
Khi tôi tự kiểm thử dashboard, ứng dụng chạy tốt, biểu đồ đẹp và trải nghiệm tổng thể mượt mà.
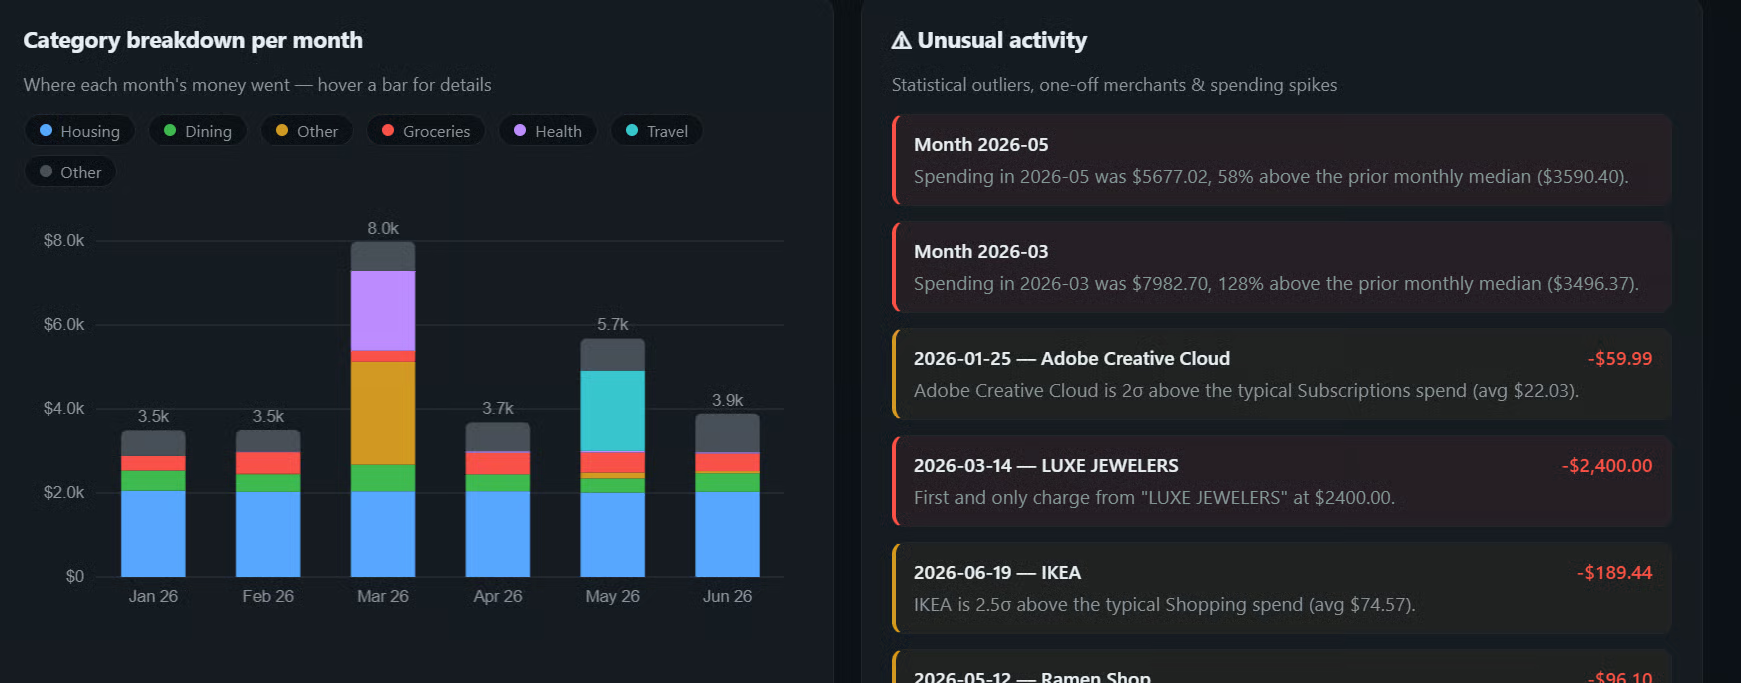
Điểm yếu chính là thực hiện các thay đổi UI chính xác. Sau vài prompt tiếp theo, nó bắt đầu thực hiện những thay đổi không liên quan thay vì hiểu đúng ý tôi, nên cuối cùng tôi dừng lại ở đó.
Qwen3.8-27B vẫn còn rất mới và cộng đồng đang tích cực tìm ra tổ hợp tốt nhất giữa lượng tử hóa và suy đoán giải mã. MTP hoạt động cực kỳ hiệu quả, nhưng các phương pháp mới như DFlash 2 và DSpark cũng đang được thử nghiệm, với một số người dùng báo cáo tốc độ còn cao hơn tùy phần cứng và khối lượng công việc.
Unsloth cũng vừa phát hành GGUF Dynamic v3.0 cho Qwen3.8-27B, tuyên bố tăng khoảng 10% độ chính xác ở cùng kích thước mô hình so với bản lượng tử trước đó. Điều này khiến Unsloth trở thành lựa chọn rất đáng cân nhắc nếu bạn muốn chất lượng tốt hơn trong khi vẫn giữ thiết lập suy luận cục bộ gần như không đổi.
Hiện tại, tôi cho rằng NVFP4 + MTP + llama.cpp là một trong những thiết lập dễ và nhanh nhất cho RTX 5090. Đạt khoảng 140 token mỗi giây với mô hình 27B trong khi vẫn có cửa sổ ngữ cảnh lớn và đủ năng lực để chạy một agent lập trình thực sự là rất ấn tượng. Thiết lập này có lẽ sẽ còn nhanh hơn nữa khi llama.cpp, Unsloth, DFlash 2 và DSpark tiếp tục cải thiện.
Trở thành Kỹ sư AI cùng DataCamp!
Tracks
Courses
Tracks