Programa
Associate AI Engineer para desarrolladores
26 h
Primero, vamos a asegurarnos de que la GPU se detecta correctamente y comprobaremos la versión del driver de NVIDIA y de CUDA.
nvidia-smi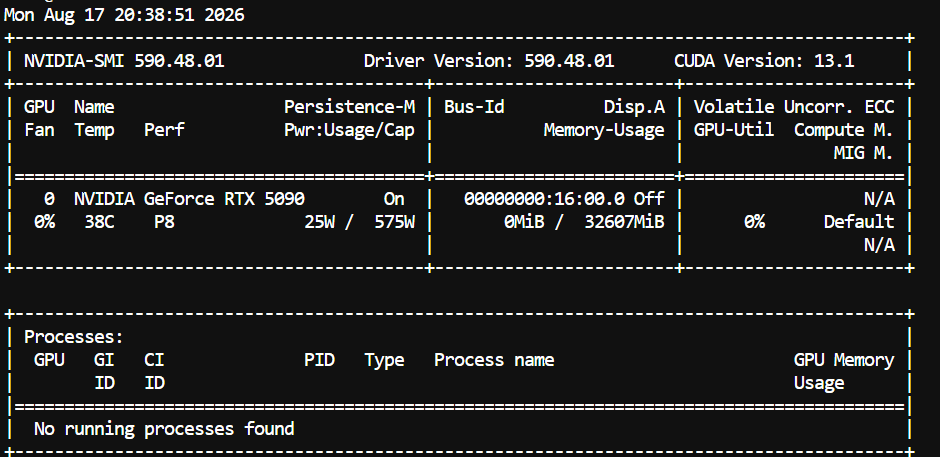
Deberías ver tu RTX 5090, la versión del driver, la versión de CUDA, la memoria de la GPU y el uso actual de la GPU.
Nota: Esta configuración es específica para GPUs NVIDIA Blackwell, como la RTX 5090. La compilación de abajo apunta a SM120, que es la arquitectura de cómputo que usa la RTX 5090.
A continuación, descargaremos y compilaremos la última versión de llama.cpp con soporte para CUDA.
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp

cmake -B build \
  -DGGML_CUDA=ON \
  -DCMAKE_CUDA_ARCHITECTURES=120

cmake --build build --config Release -j$(nproc)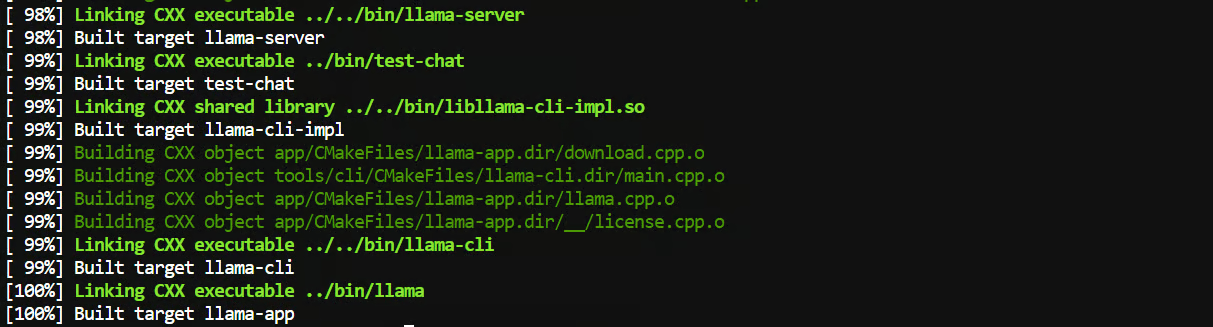
Lo importante aquí es -DCMAKE_CUDA_ARCHITECTURES=120. Esto le indica a llama.cpp que compile específicamente para la arquitectura Blackwell usada por la RTX 5090.
Cuando termine la compilación, haremos que llama-server esté disponible globalmente para poder ejecutarlo desde cualquier carpeta:
sudo ln -sf "$(realpath ./build/bin/llama-server)" /usr/local/bin/llama-serverAhora, comprueba que todo funciona:
llama-server --versionDeberías obtener una salida similar a:
version: 0.1.1-dev (build 10479, commit 0021a77de)
built with GNU 13.3.0 for Linux x86_64
Listo. Ya tenemos una compilación de llama.cpp con CUDA que puede aprovechar la RTX 5090 y su soporte NVFP4 nativo de Blackwell.
Ahora descargaremos el modelo Qwen3.8-27B.
Primero, instala la CLI de Hugging Face:
pip install -U huggingface_hubCrea una carpeta donde guardaremos el modelo:
mkdir -p /workspace/models/qwen38Luego descarga el GGUF NVFP4-MTP:
hf download felippeburk/Qwen3.8-27B-NVFP4-MTP-GGUF \
  --local-dir /workspace/models/qwen38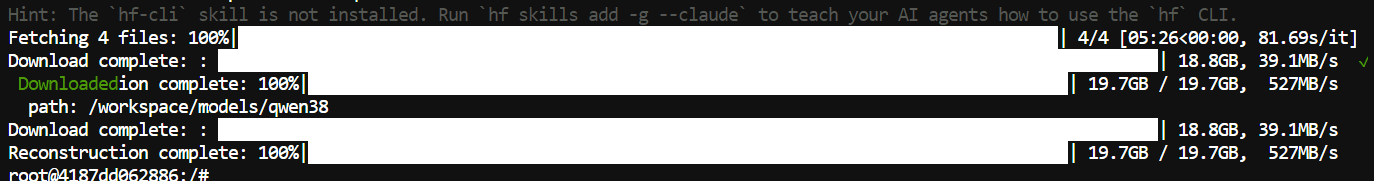
Esta es la versión que queremos para esta configuración porque usa NVFP4 e incluye soporte MTP, que es de donde proviene gran parte de la mejora de velocidad en la RTX 5090.
Ahora viene la parte divertida. Serviremos Qwen3.8-27B íntegramente en la GPU con Flash Attention, una ventana de contexto de 131K y decodificación especulativa MTP para generar más rápido.
Ejecuta:
cd /workspace/llama.cpp

llama-server \
  -m /workspace/models/qwen38/qwen3.8-27b-text-nvfp4-mtp.gguf \
  --alias qwen3.8-27b \
  --host 0.0.0.0 \
  --port 8910 \
  --ctx-size 131072 \
  --n-gpu-layers all \
  --flash-attn on \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --parallel 1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 4 \
  --spec-draft-p-min 0.75 \
  --spec-draft-ngl all \
  --spec-draft-type-k q8_0 \
  --spec-draft-type-v q8_0 \
  --reasoning-effort medium \
  --jinja
Aquí hay muchas opciones, pero la mayoría están para exprimir al máximo el 5090.
Las principales a tener en cuenta son:
--ctx-size 131072 nos da aproximadamente una ventana de contexto de 131K.
--n-gpu-layers all mantiene el modelo en la GPU.
--flash-attn on activa Flash Attention.
--cache-type-k q8_0 y --cache-type-v q8_0 ayudan a reducir el uso de memoria de la caché KV.
--spec-type draft-mtp activa la decodificación especulativa MTP de Qwen3.8.
--spec-draft-n-max 4 controla cuántos tokens especulativos puede generar MTP de una vez.
Para esta configuración usamos n-max 4 como punto de partida para una RTX 5090. Puedes probar con valores como 2 (que la ficha del modelo recomienda para este GGUF) o 3 más adelante, ya que el ajuste más rápido puede variar ligeramente según tu sistema.
Cuando llama-server termine de cargar el modelo, Qwen3.8 estará disponible en local en http://127.0.0.1:8910.
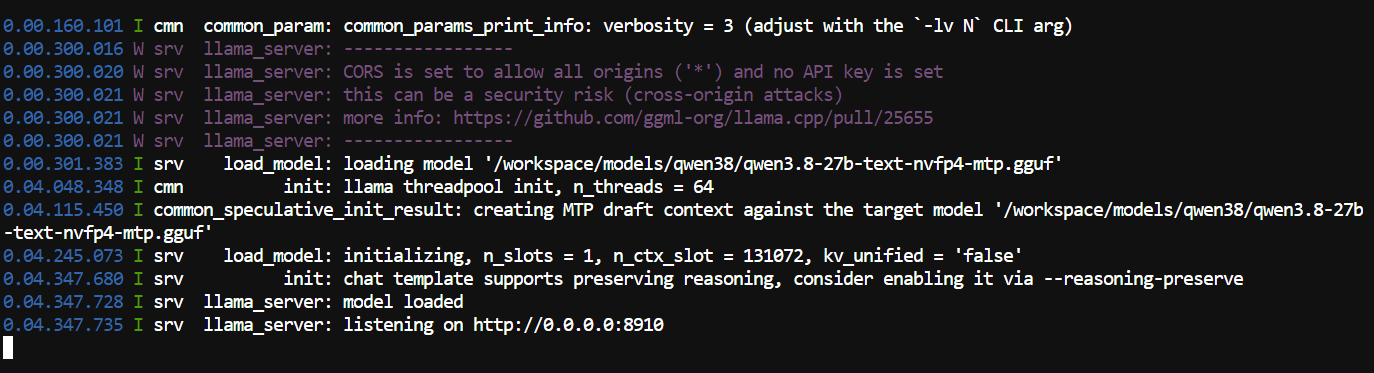
Ya tenemos Qwen3.8-27B funcionando en local. Ahora probaremos el modelo tanto a través de la API como de la interfaz web integrada.
Con el servidor en marcha, abre otra terminal y envía una solicitud de prueba a la API compatible con OpenAI:
curl http://127.0.0.1:8910/v1/chat/completions \
 -H "Content-Type: application/json" \
 -d '{
   "model": "qwen3.8-27b",
   "messages": [
     {
       "role": "user",
       "content": "Write a Python FastAPI application that monitors GPU usage."
     }
   ],
   "max_tokens": 2000
 }'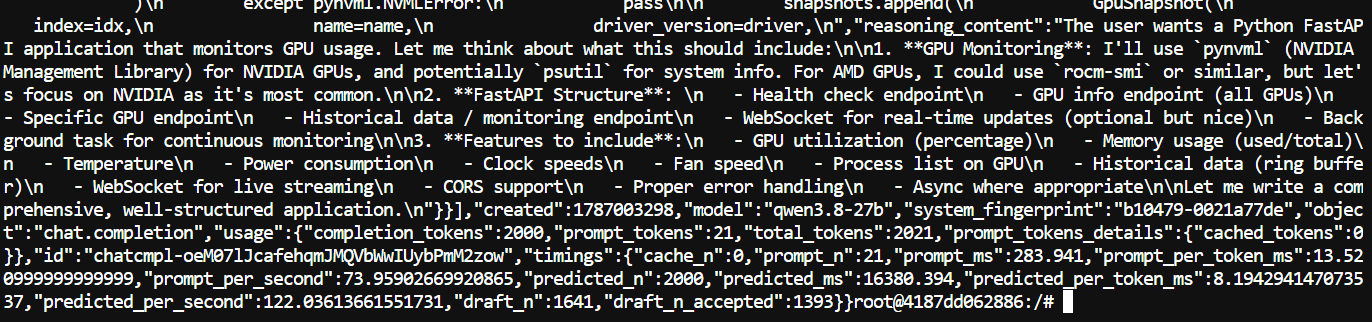
En esta prueba, Qwen3.8-27B generó 2.000 tokens a 122 tokens/seg con una impresionante tasa de aceptación MTP del 84,9%.
llama.cpp también incluye una interfaz de navegador, para que puedas probar el modelo sin usar la API.
Abre http://127.0.0.1:8910 en tu navegador para ver la interfaz.
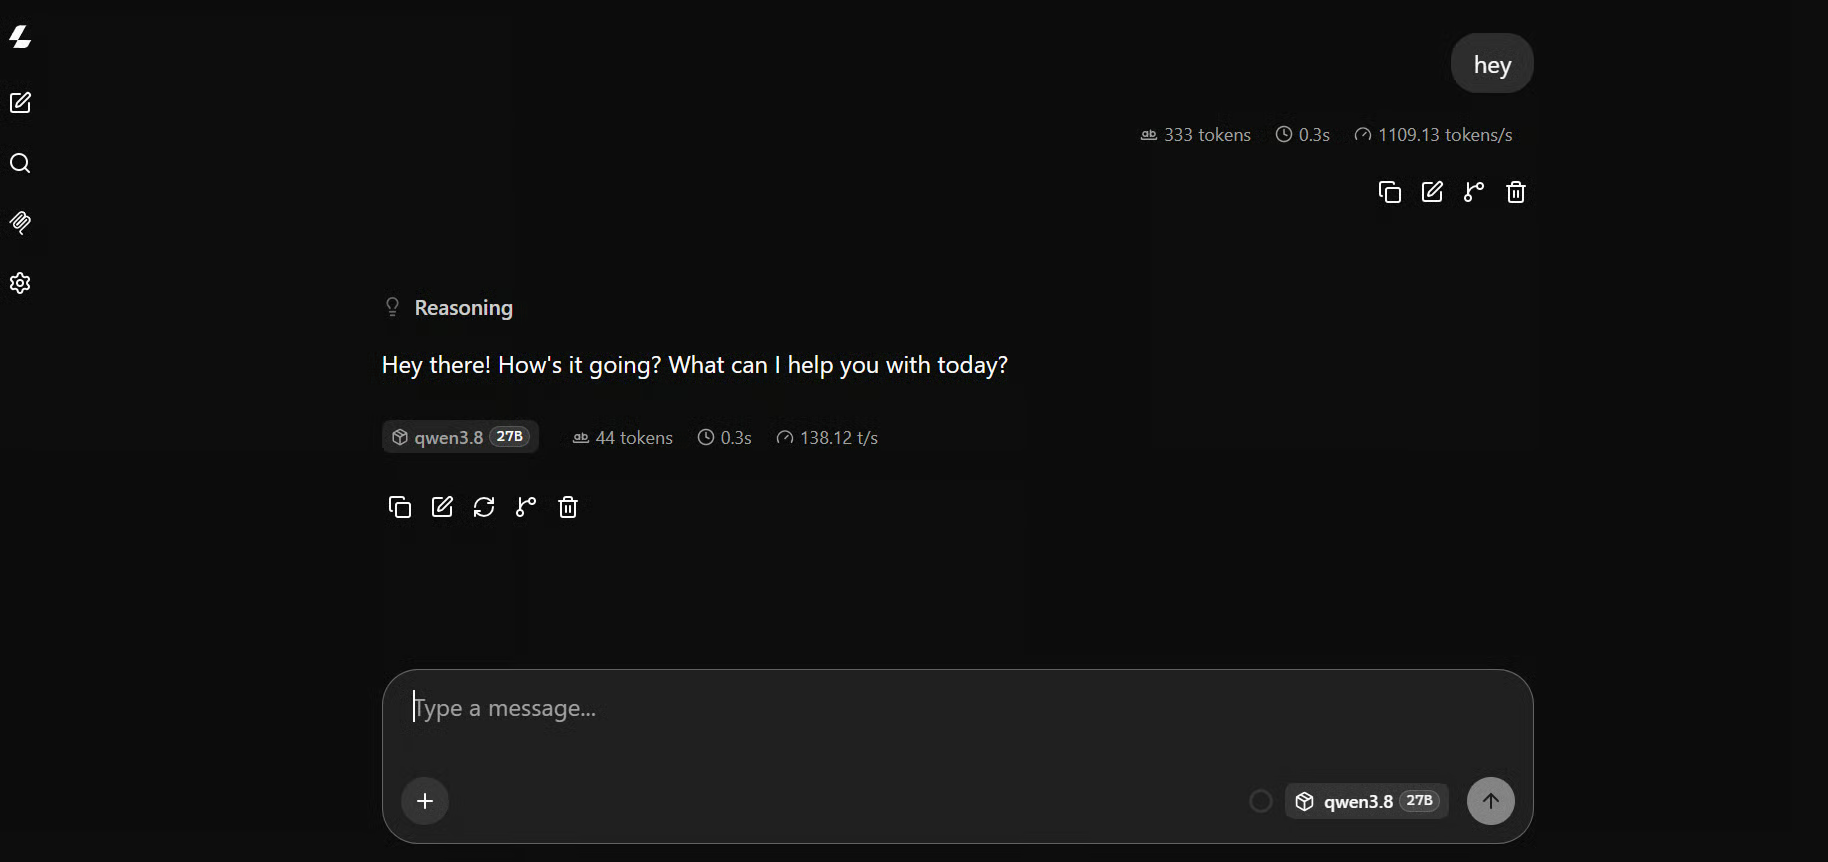
Para una prueba más compleja, usé este prompt:
Create a stunning single-file animated HTML website with a dark futuristic
theme, smooth scrolling, glowing gradients, floating particles, animated cards,
hover effects, and responsive design using only HTML, CSS, and JavaScript.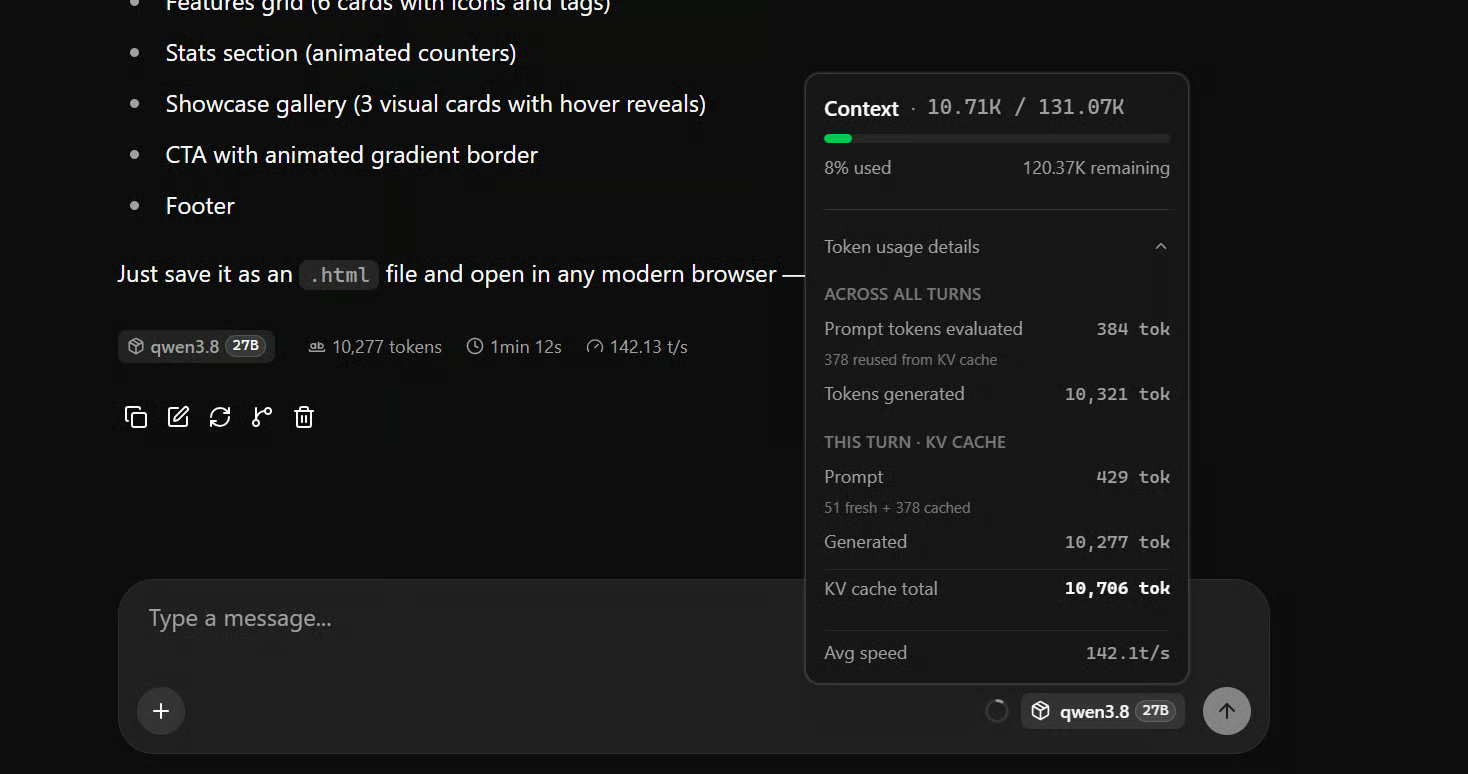
En mi RTX 5090, obtuve una media de ~142 tokens por segundo, con picos de generación de alrededor de 170 tokens por segundo, que es extremadamente rápido para un modelo de 27B ejecutándose en local.
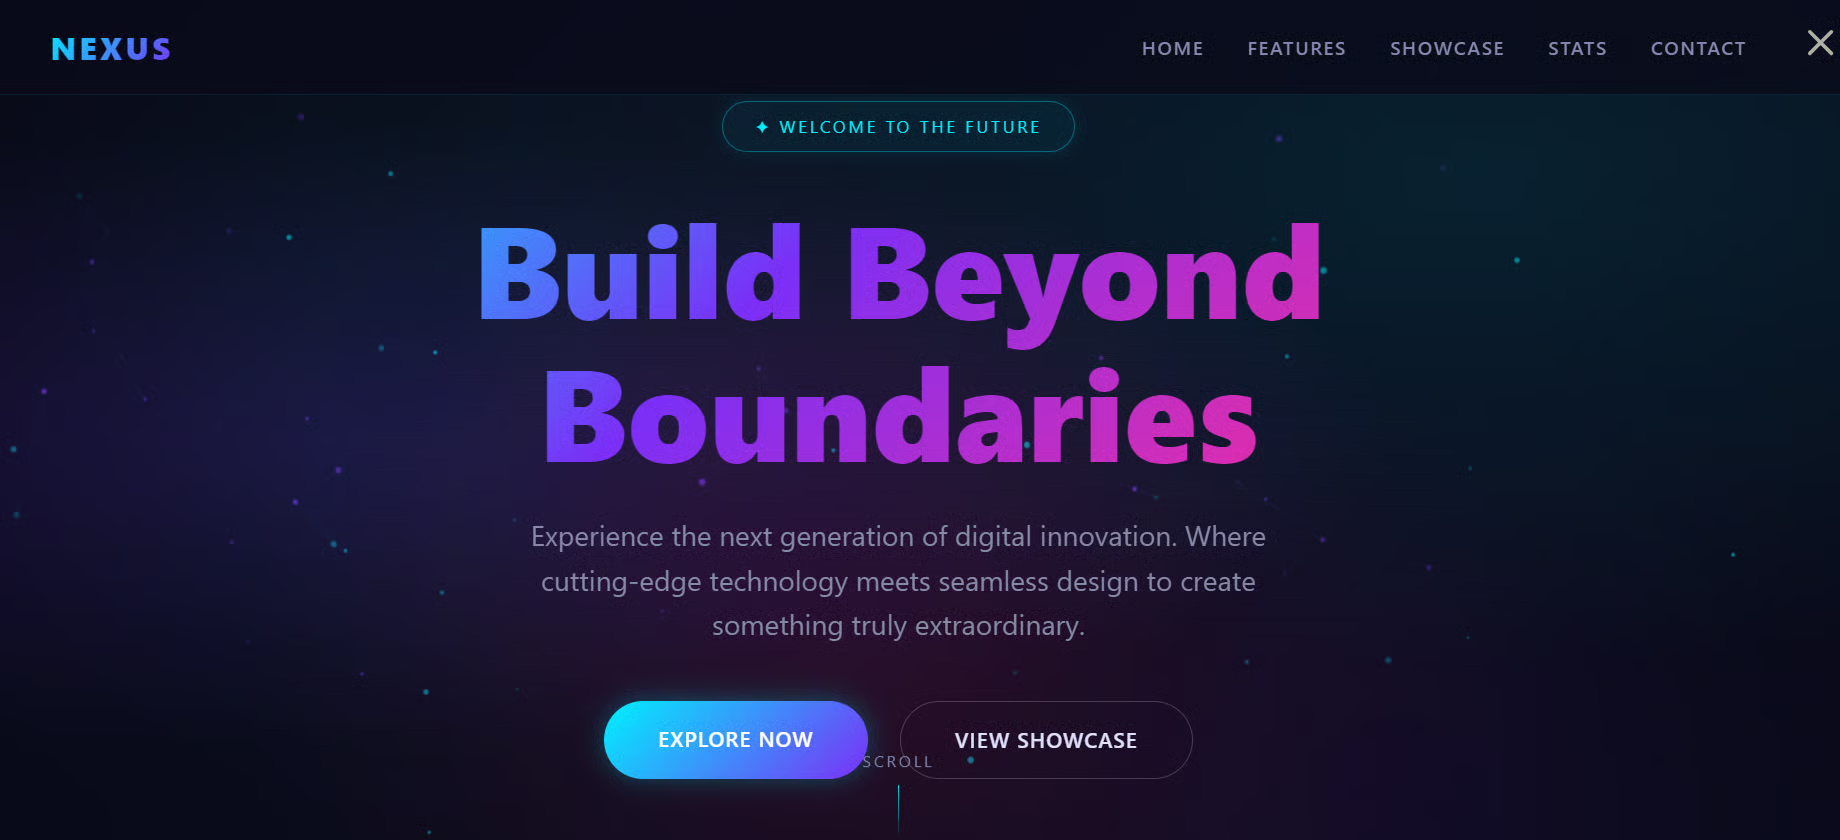
Qwen3.8-27B generó un sitio web pulido y totalmente funcional que funcionó a la primera. Es una buena forma de probar rápidamente tanto la capacidad de programación del modelo como la velocidad de la configuración local.
En esta sección, conectaremos Qwen3.8-27B a Pi y lo usaremos como un agente de código totalmente local.
Pi es un agente ligero para programar desde la terminal que puede ayudarte a crear, editar, probar y depurar proyectos directamente desde la línea de comandos.
Instala Pi con:
curl -fsSL https://pi.dev/install.sh | shEl instalador requiere Node.js y npm. Instala Pi en el prefijo global de npm. Si aún no tienes Node, instálalo primero con nvm o con tu gestor de paquetes.
Cuando finalice la instalación, reinicia tu terminal.
Después, instala la extensión pi-llama y apunta Pi a nuestro servidor local de llama.cpp:
pi install git:github.com/huggingface/pi-llama

export LLAMA_BASE_URL=http://127.0.0.1:8910/v1
Crea un nuevo proyecto e inicia Pi:
mkdir new-project
cd new-project

Pi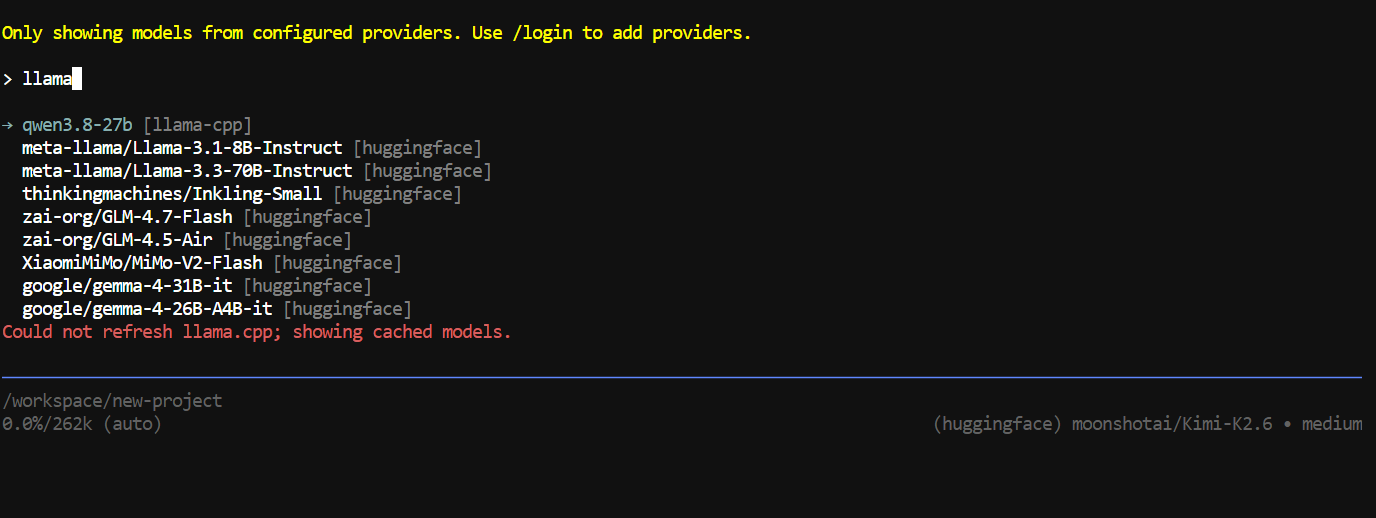
Dentro de Pi, ejecuta /model, busca llama-cpp y selecciona Qwen3.8-27B.
Para probarlo, le di este prompt:
Build a polished personal finance dashboard from scratch that imports CSV
bank statements, categorizes spending, shows monthly trends and charts, and
detects unusual expenses; also generate a realistic sample CSV, import it,
test the full app end-to-end, and fix any errors automatically.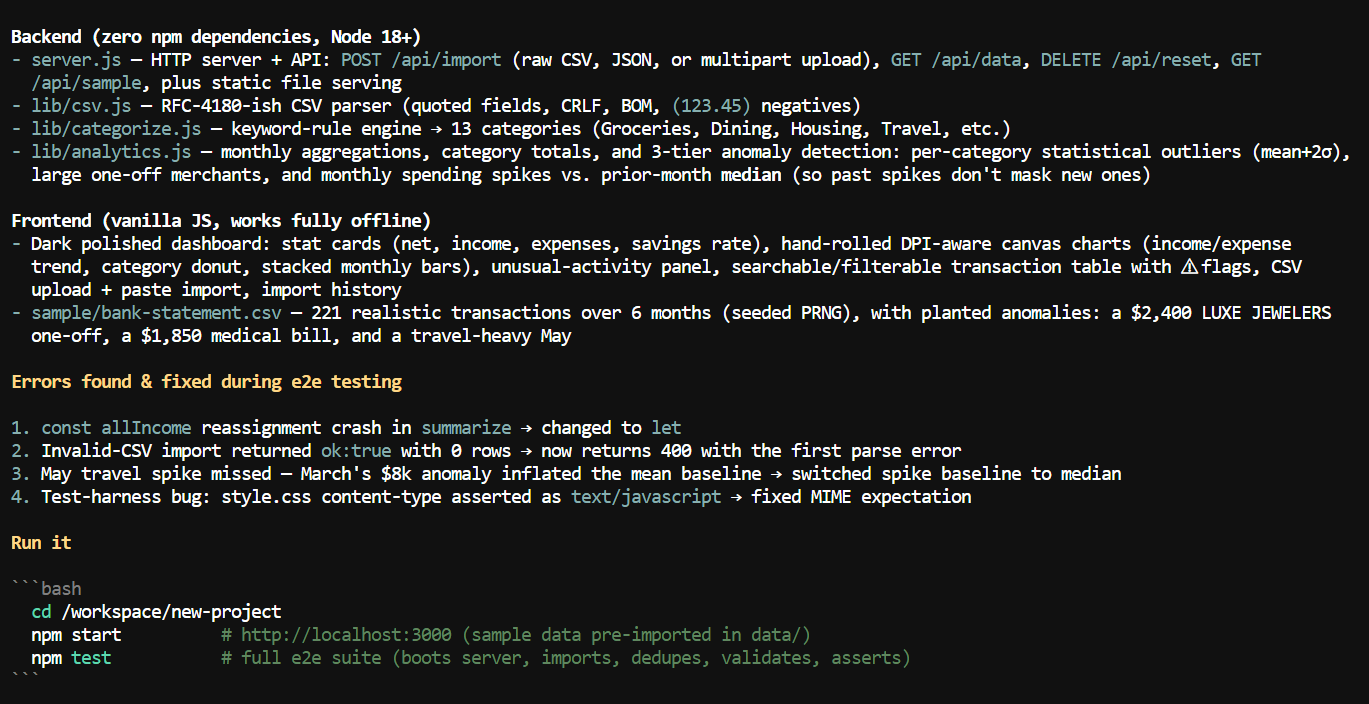
Construyó el proyecto completo en pocos minutos.
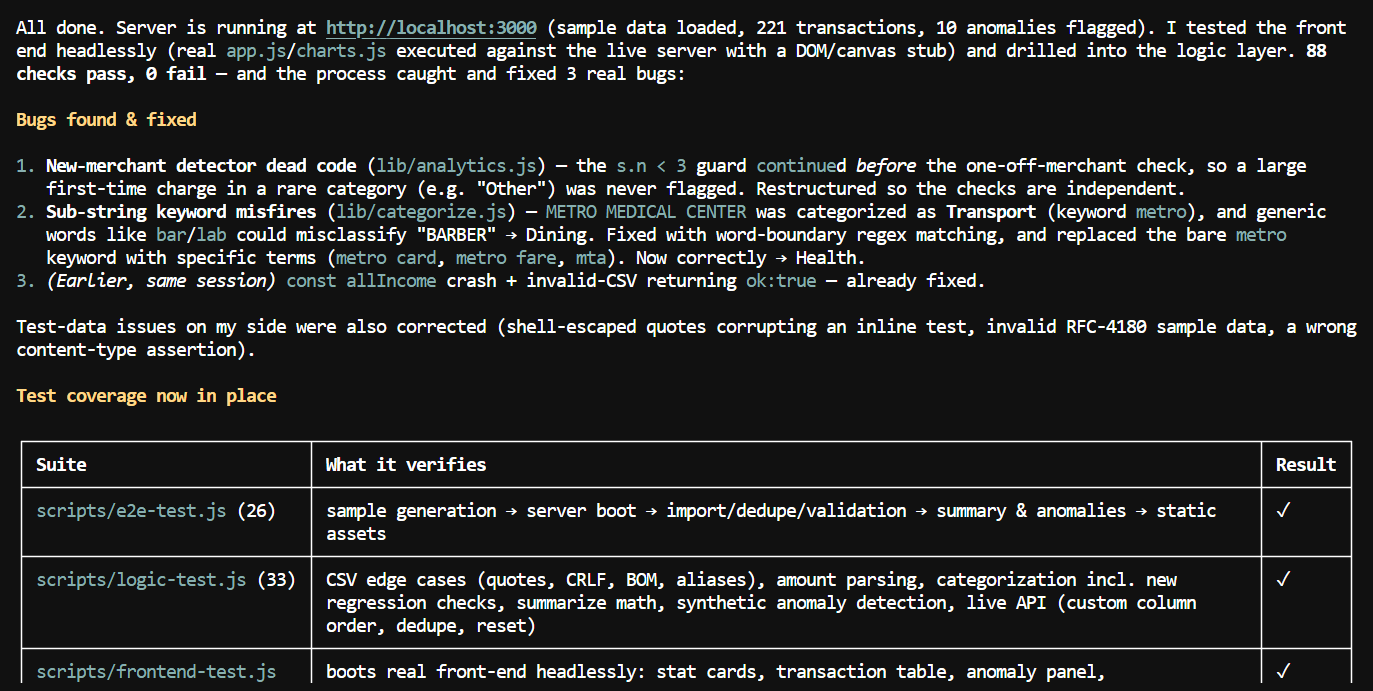
Luego le pedí que iniciara el servidor y probara tanto el frontend como la lógica de la aplicación. Dedicó más tiempo a depurar y probar para asegurarse de que todo funcionaba correctamente.
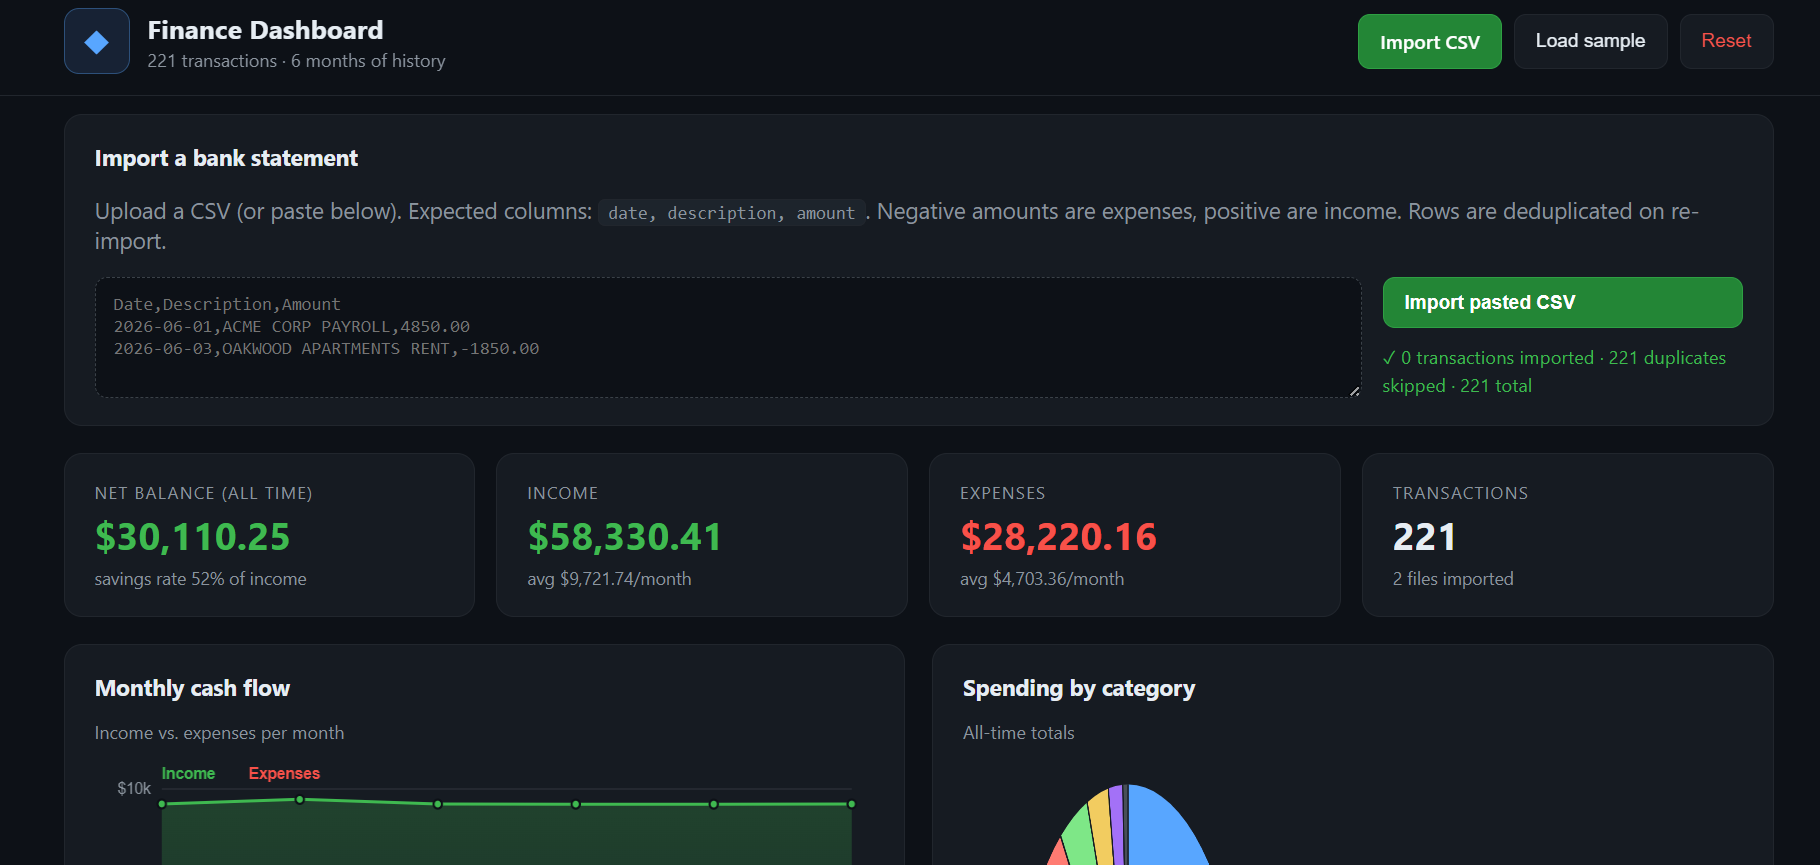
Cuando probé yo mismo el panel, la app funcionó bien, los gráficos se veían genial y la experiencia general fue fluida.
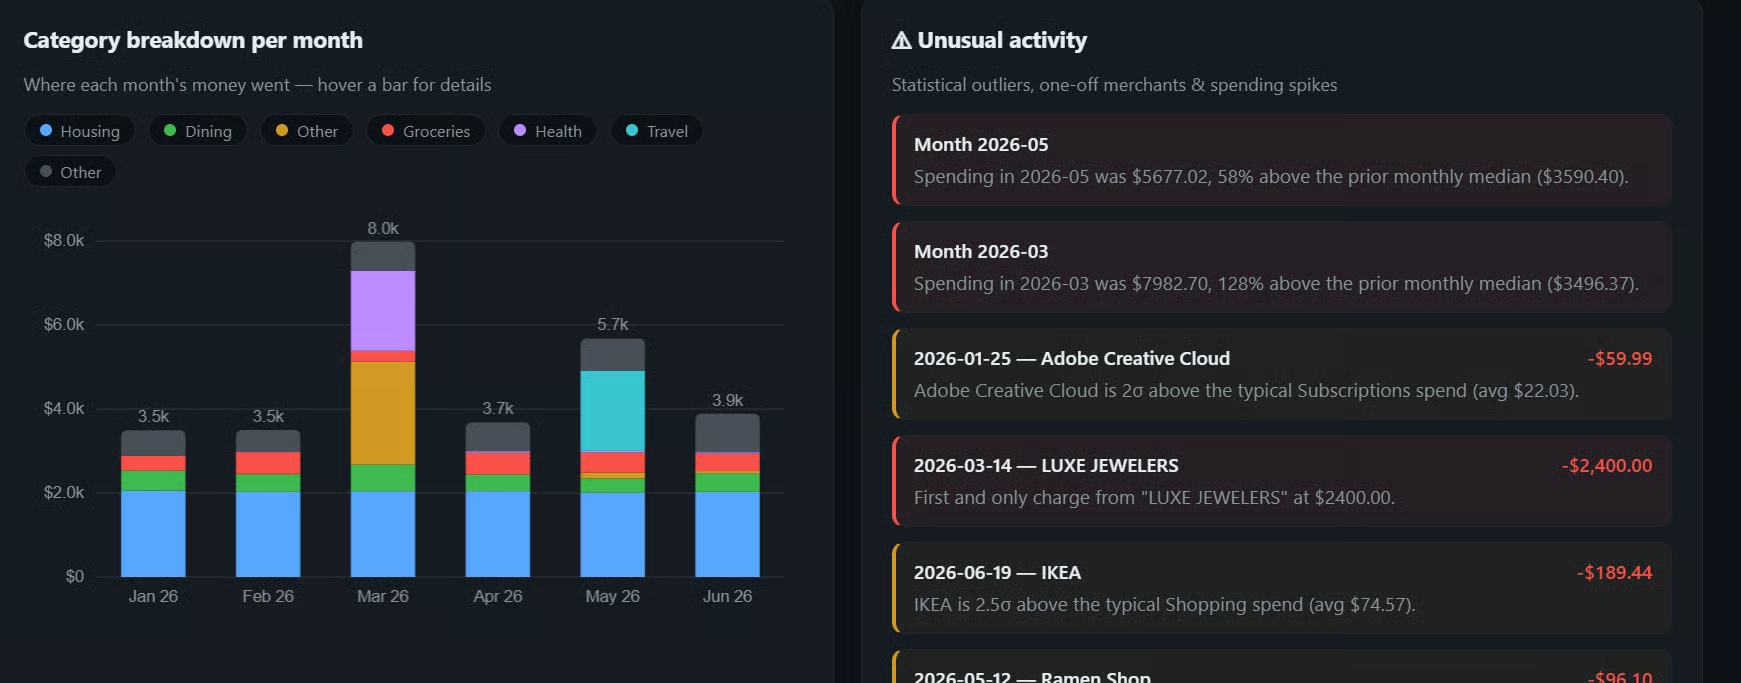
La principal debilidad fue hacer cambios de UI muy precisos. Tras varios prompts de seguimiento, empezó a hacer cambios no relacionados en lugar de entender exactamente lo que quería, así que lo dejé ahí.
Qwen3.8-27B sigue siendo muy reciente y la comunidad está afinando la mejor combinación de cuantización y decodificación especulativa. MTP funciona extremadamente bien, pero también se están probando enfoques más nuevos como DFlash 2 y DSpark, con algunos usuarios reportando velocidades aún mayores según el hardware y la carga de trabajo.
Unsloth también acaba de publicar GGUF Dynamic v3.0 para Qwen3.8-27B, afirmando alrededor de un 10% más de precisión con el mismo tamaño de modelo en comparación con sus quants anteriores. Esto hace de Unsloth otra opción muy interesante si buscas más calidad manteniendo aproximadamente la misma configuración de inferencia local.
Por ahora, creo que NVFP4 + MTP + llama.cpp es una de las configuraciones más sencillas y rápidas para una RTX 5090. Lograr en torno a 140 tokens por segundo con un modelo de 27B, manteniendo una ventana de contexto amplia y capacidad suficiente para ejecutar un agente de código real, es impresionante. Probablemente esta configuración será aún más rápida a medida que llama.cpp, Unsloth, DFlash 2 y DSpark sigan mejorando.
¡Conviértete en AI Engineer con DataCamp!
Programa
Curso
Programa
blog
Abid Ali Awan
9 min
Tutorial
Moez Ali
11 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Zoumana Keita
15 min
Tutorial
Zoumana Keita
12 min
Tutorial
Arunn Thevapalan
12 min