Accéder au contenu principal

Comment exécuter Qwen3.8-27B en local sur une NVIDIA RTX 5090

Apprenez à exécuter Qwen3.8-27B en local avec NVFP4 natif Blackwell et le décodage spéculatif MTP, jusqu'à 170 tokens par seconde avec llama.cpp.
Actualisé 31 août 2026  · 6 min lire

Explorez l'IA

ChatGPTClaudePerplexity

Qwen3.8-27B s'impose rapidement comme l'un des modèles les plus appréciés pour une IA locale. Malgré ses 27 milliards de paramètres, il rivalise avec des modèles bien plus volumineux sur des benchmarks de code, de raisonnement, d'agents et d'usages généraux. Il talonne même des modèles comme GLM-5.2 dans plusieurs domaines, ce qui en fait un choix de prédilection pour celles et ceux qui expérimentent sur du matériel local puissant.

La RTX 5090 est particulièrement adaptée à Qwen3.8-27B grâce à son architecture Blackwell qui prend en charge NVFP4, permettant au modèle de tourner à des vitesses très élevées tout en conservant une excellente qualité de sortie. Combiné au décodage spéculatif via la prédiction multi-tokens (MTP), à une build optimisée de llama.cpp et au bon modèle GGUF, Qwen3.8-27B peut dépasser largement les 100 tokens par seconde sur une seule RTX 5090.

Dans ce guide, nous allons mettre en place l'une des méthodes les plus simples pour obtenir le meilleur équilibre entre vitesse, précision et prise en charge de longs contextes sur une RTX 5090 ou un autre GPU Blackwell. Nous compilerons llama.cpp avec le support natif Blackwell, téléchargerons le GGUF Qwen3.8-27B NVFP4-MTP, l'exécuterons avec l'accélération GPU et le décodage spéculatif MTP, testerons l'API compatible OpenAI et l'interface web intégrée, puis nous le connecterons à Pi pour utiliser Qwen3.8-27B comme agent de code 100 % local.

Je vous recommande également de consulter notre guide sur Qwen3.8-Flash-Next, l'aperçu le plus récent de Qwen4, ainsi que le tutoriel sur la manière de faire tourner Qwen3.8-Flash-Next en local.

Ingénieur IA associé pour les scientifiques de données

Entraînez et affinez les derniers modèles d'IA pour la production, y compris les LLM comme le Llama 3. Commencez dès aujourd'hui votre parcours pour devenir ingénieur en IA !
Explorer Le Cursus

1. Configurer llama.cpp pour les GPU Blackwell

Pour commencer, vérifions que le GPU est bien détecté et contrôlons la version du pilote NVIDIA et de CUDA.

nvidia-smi
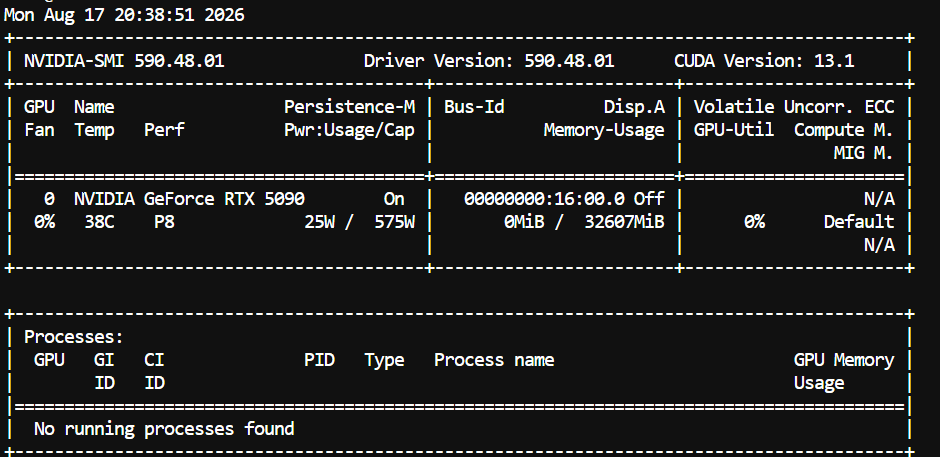
RTX 5090 GPU summary

Vous devriez voir votre RTX 5090, la version du pilote, la version de CUDA, la mémoire GPU et l'utilisation en cours du GPU.

Remarque : cette configuration vise spécifiquement les GPU NVIDIA Blackwell, comme la RTX 5090. La build ci-dessous cible SM120, l'architecture de calcul utilisée par la RTX 5090.

Ensuite, nous allons télécharger et compiler la dernière version de llama.cpp avec la prise en charge de CUDA.

cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp

cmake -B build \
  -DGGML_CUDA=ON \
  -DCMAKE_CUDA_ARCHITECTURES=120

cmake --build build --config Release -j$(nproc)
Building llama.cpp for the RTX 5090  GPU

L'élément clé ici est -DCMAKE_CUDA_ARCHITECTURES=120. Cela indique à llama.cpp de compiler spécifiquement pour l'architecture Blackwell utilisée par la RTX 5090.

Une fois la compilation terminée, nous allons rendre llama-server accessible globalement pour pouvoir l'exécuter depuis n'importe quel dossier :

sudo ln -sf "$(realpath ./build/bin/llama-server)" /usr/local/bin/llama-server

Maintenant, vérifiez que tout fonctionne :

llama-server --version

Vous devriez obtenir une sortie similaire à :

version: 0.1.1-dev (build 10479, commit 0021a77de)
built with GNU 13.3.0 for Linux x86_64

C'est tout. Nous avons maintenant une build de llama.cpp compatible CUDA, prête à exploiter la RTX 5090 et son support NVFP4 natif Blackwell.

2. Télécharger le modèle Qwen3.8-27B NVFP4-MTP

Téléchargeons à présent le modèle Qwen3.8-27B.

D'abord, installez la CLI Hugging Face :

pip install -U huggingface_hub

Créez un dossier pour stocker le modèle :

mkdir -p /workspace/models/qwen38

Puis téléchargez le GGUF NVFP4-MTP :

hf download felippeburk/Qwen3.8-27B-NVFP4-MTP-GGUF \
  --local-dir /workspace/models/qwen38
Downloading the Qwen3.8-27B-NVFP4-MTP-GGUF

C'est la version à privilégier pour cette configuration, car elle utilise NVFP4 et inclut la prise en charge MTP, à l'origine d'une grande partie du gain de vitesse sur la RTX 5090.

3. Démarrer le serveur Qwen3.8-27B

Passons au concret. Nous allons servir Qwen3.8-27B entièrement sur le GPU avec Flash Attention, une fenêtre de contexte de 131 K et le décodage spéculatif MTP pour accélérer la génération. 

Exécutez :

cd /workspace/llama.cpp

llama-server \
  -m /workspace/models/qwen38/qwen3.8-27b-text-nvfp4-mtp.gguf \
  --alias qwen3.8-27b \
  --host 0.0.0.0 \
  --port 8910 \
  --ctx-size 131072 \
  --n-gpu-layers all \
  --flash-attn on \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --parallel 1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 4 \
  --spec-draft-p-min 0.75 \
  --spec-draft-ngl all \
  --spec-draft-type-k q8_0 \
  --spec-draft-type-v q8_0 \
  --reasoning-effort medium \
  --jinja

Il y a de nombreux paramètres ici, mais la plupart servent simplement à tirer le meilleur de la 5090.

Les principaux à connaître :

  • --ctx-size 131072 nous donne environ 131 K de fenêtre de contexte.

  • --n-gpu-layers all maintient le modèle sur le GPU.

  • --flash-attn on active la Flash Attention.

  • --cache-type-k q8_0 et --cache-type-v q8_0 réduisent l'usage mémoire du cache KV.

  • --spec-type draft-mtp active le décodage spéculatif MTP de Qwen3.8.

  • --spec-draft-n-max 4 contrôle combien de tokens spéculatifs MTP peut proposer d'un coup.

Pour cette configuration, nous utilisons n-max 4 comme point de départ sur une RTX 5090. Vous pouvez tester des valeurs comme 2 (recommandé par la fiche du modèle pour ce GGUF) ou 3 ensuite, car le réglage le plus rapide peut varier légèrement selon votre système.

Une fois que llama-server a fini de charger le modèle, Qwen3.8 sera disponible en local à l'adresse http://127.0.0.1:8910.
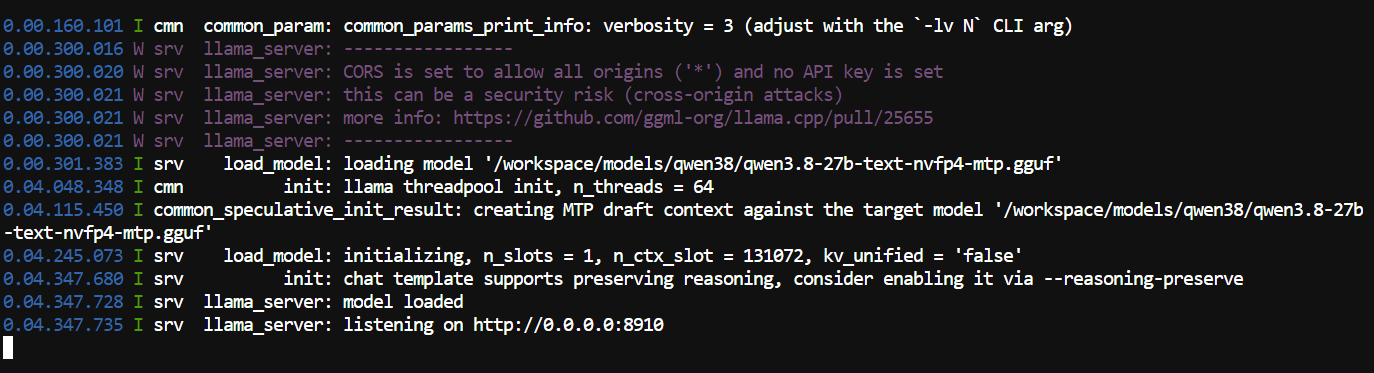
Serving the Qwen3.8-27B-NVFP4-MTP-GGUF using the llama.cpp

Nous avons maintenant Qwen3.8-27B qui tourne en local. Ensuite, nous allons tester le modèle via l'API et l'interface navigateur intégrée.

4. Tester la vitesse et les performances en code de Qwen3.8-27B

Avec le serveur actif, ouvrez un autre terminal et envoyez une requête de test à l'API compatible OpenAI :

curl http://127.0.0.1:8910/v1/chat/completions \
 -H "Content-Type: application/json" \
 -d '{
   "model": "qwen3.8-27b",
   "messages": [
     {
       "role": "user",
       "content": "Write a Python FastAPI application that monitors GPU usage."
     }
   ],
   "max_tokens": 2000
 }'
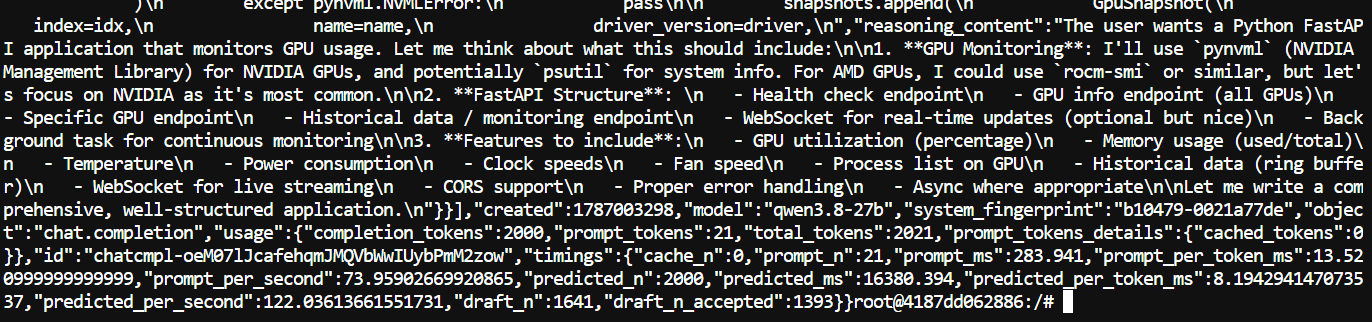
Testing the Qwen3.8-27B-NVFP4-MTP-GGUF using the CURL command

Dans ce test, Qwen3.8-27B a généré 2 000 tokens à 122 tokens/s avec un excellent taux d'acceptation MTP de 84,9 %.

llama.cpp inclut aussi une interface navigateur, ce qui permet de tester le modèle sans passer par l'API.

Ouvrez http://127.0.0.1:8910 dans votre navigateur pour afficher l'interface.
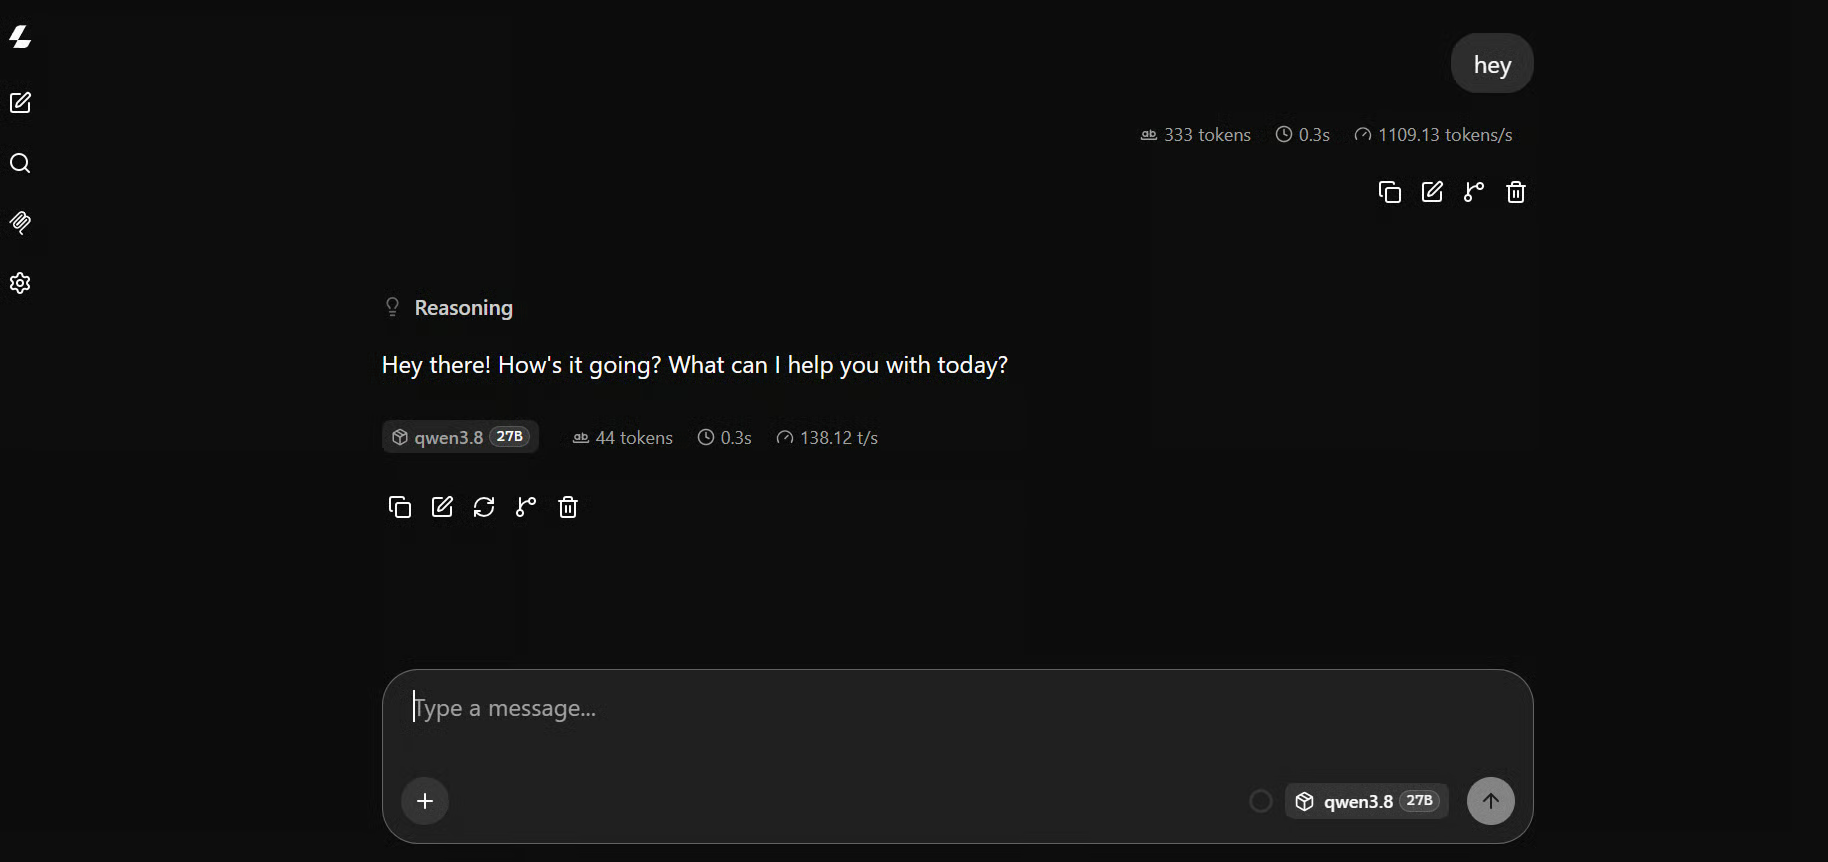
Testing the Qwen3.8-27B-NVFP4-MTP-GGUF inside the llama.cpp webui

Pour un test plus poussé, j'ai utilisé ce prompt :

Create a stunning single-file animated HTML website with a dark futuristic 
theme, smooth scrolling, glowing gradients, floating particles, animated cards,
hover effects, and responsive design using only HTML, CSS, and JavaScript.
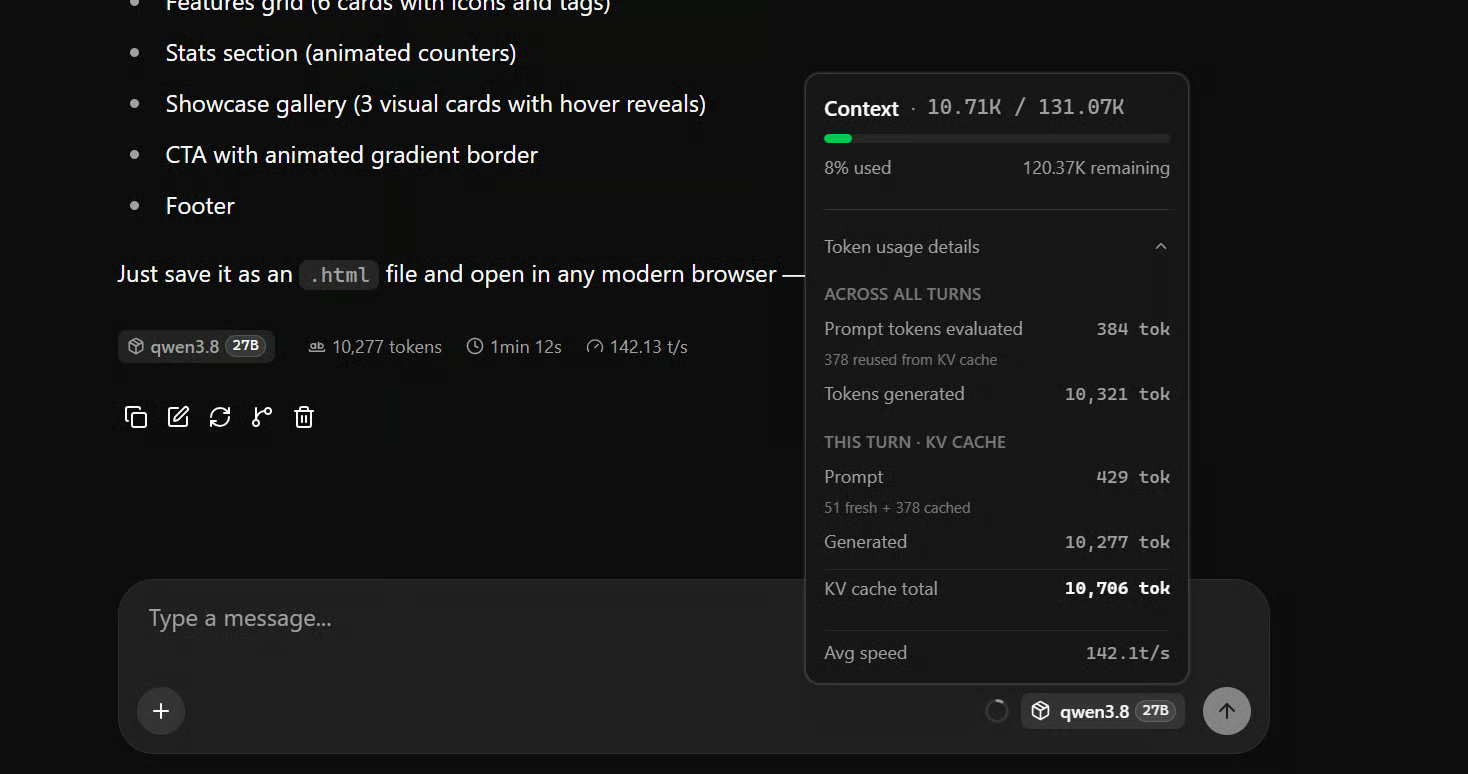
Testing the Qwen3.8-27B-NVFP4-MTP-GGUF inside the llama.cpp webui on coding task

Sur ma RTX 5090, j'obtenais en moyenne environ 142 tokens par seconde, avec des pointes avoisinant 170 tokens par seconde, ce qui est extrêmement rapide pour un modèle 27B exécuté en local. 
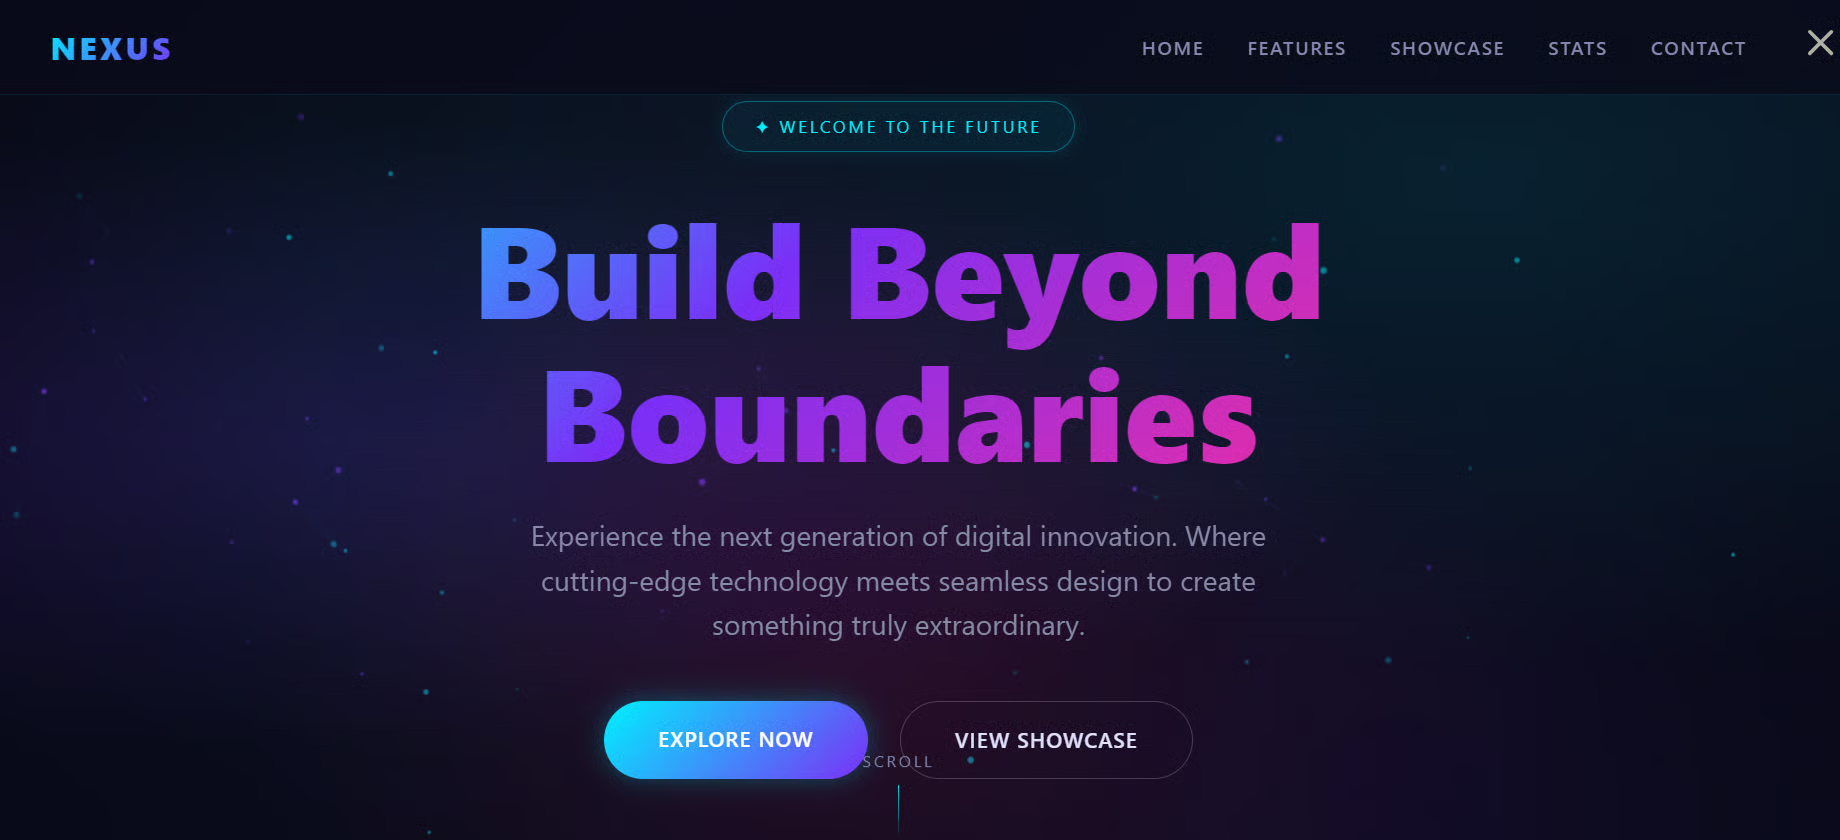
image4.png

Qwen3.8-27B a produit un site web soigné et pleinement fonctionnel, opérationnel immédiatement. C'est une bonne façon d'évaluer rapidement à la fois les capacités de code du modèle et la vitesse de votre configuration locale. 

5. Utiliser Qwen3.8-27B avec Pi

Dans cette section, nous allons connecter Qwen3.8-27B à Pi et l'utiliser comme agent de code entièrement local.

Pi est un agent de code léger en ligne de commande qui vous aide à créer, modifier, tester et déboguer des projets directement depuis le terminal.

Installez Pi avec :

curl -fsSL https://pi.dev/install.sh | sh

L'installeur requiert Node.js et npm. Il installe Pi dans votre préfixe npm global. Si vous n'avez pas encore Node, installez-le d'abord avec nvm ou votre gestionnaire de paquets.

Une fois l'installation terminée, redémarrez votre terminal.

Ensuite, installez l'extension pi-llama et faites pointer Pi vers notre serveur llama.cpp local :

pi install git:github.com/huggingface/pi-llama

export LLAMA_BASE_URL=http://127.0.0.1:8910/v1

Créez un nouveau projet et lancez Pi :

mkdir new-project
cd new-project

Pi
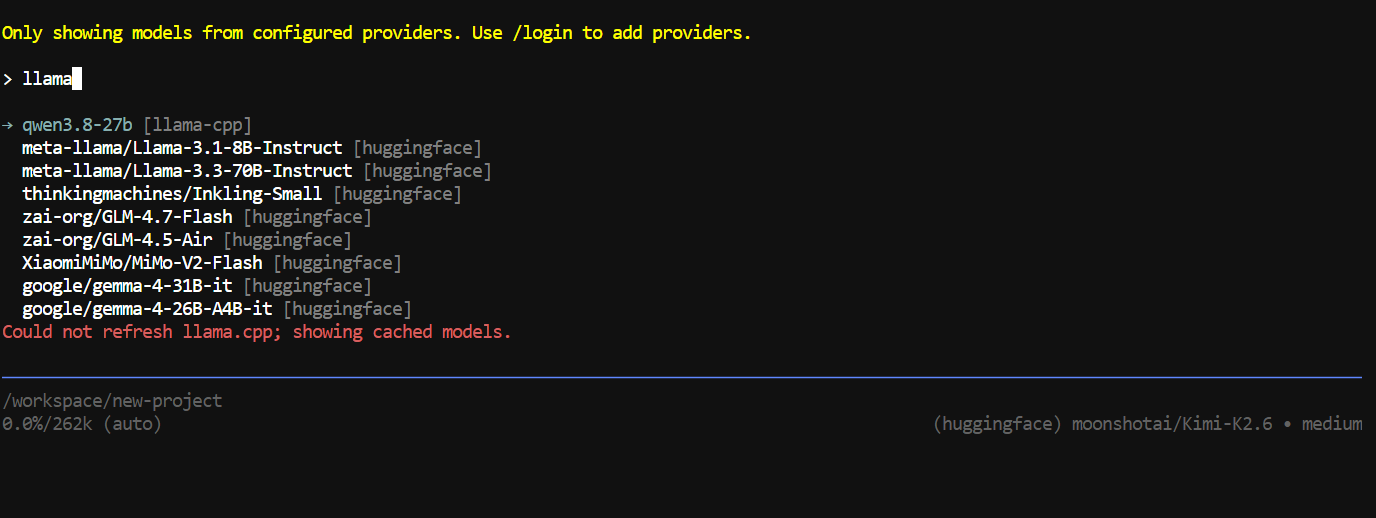
Setting up the qwen3.8-27b in the Pi coding agent

Dans Pi, exécutez /model, recherchez llama-cpp et sélectionnez Qwen3.8-27B.

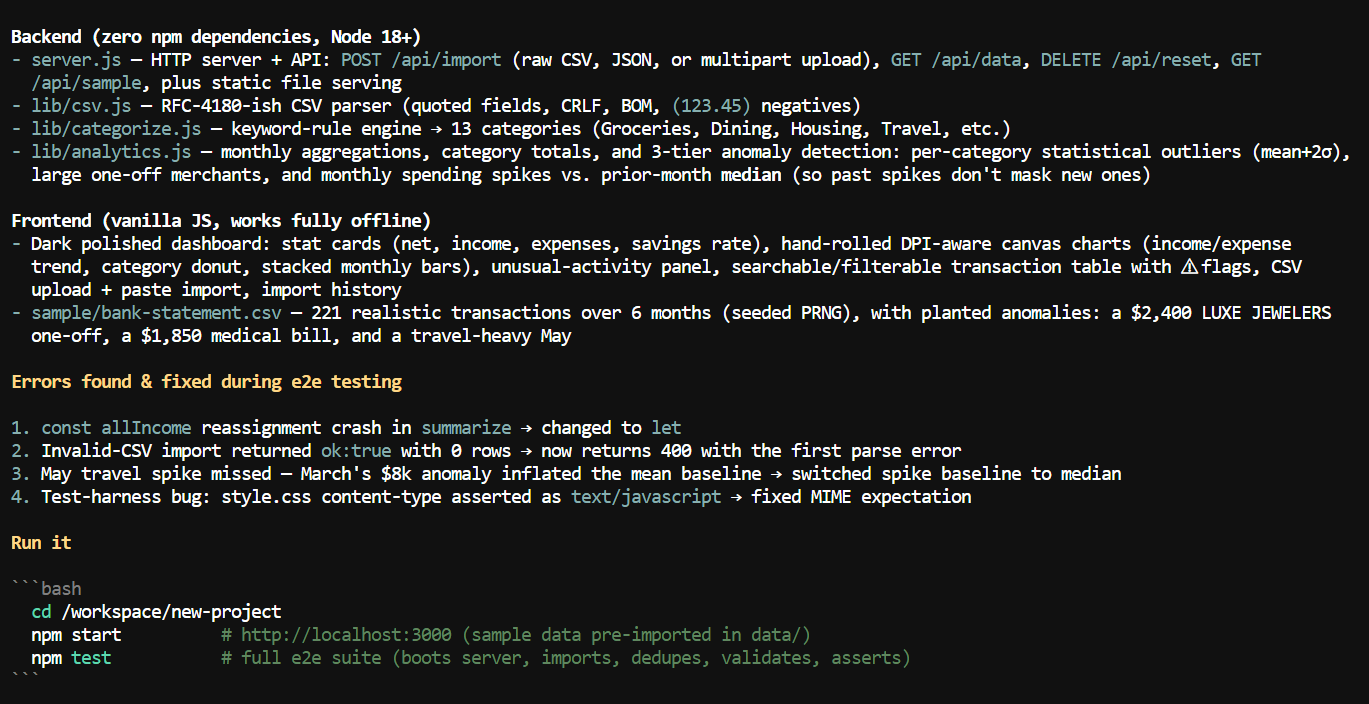
Pour tester, je lui ai donné ce prompt :

Build a polished personal finance dashboard from scratch that imports CSV 
bank statements, categorizes spending, shows monthly trends and charts, and 
detects unusual expenses; also generate a realistic sample CSV, import it, 
test the full app end-to-end, and fix any errors automatically.
Testing the qwen3.8-27b model with Pi coding agent

Il a construit l'ensemble du projet en quelques minutes. 
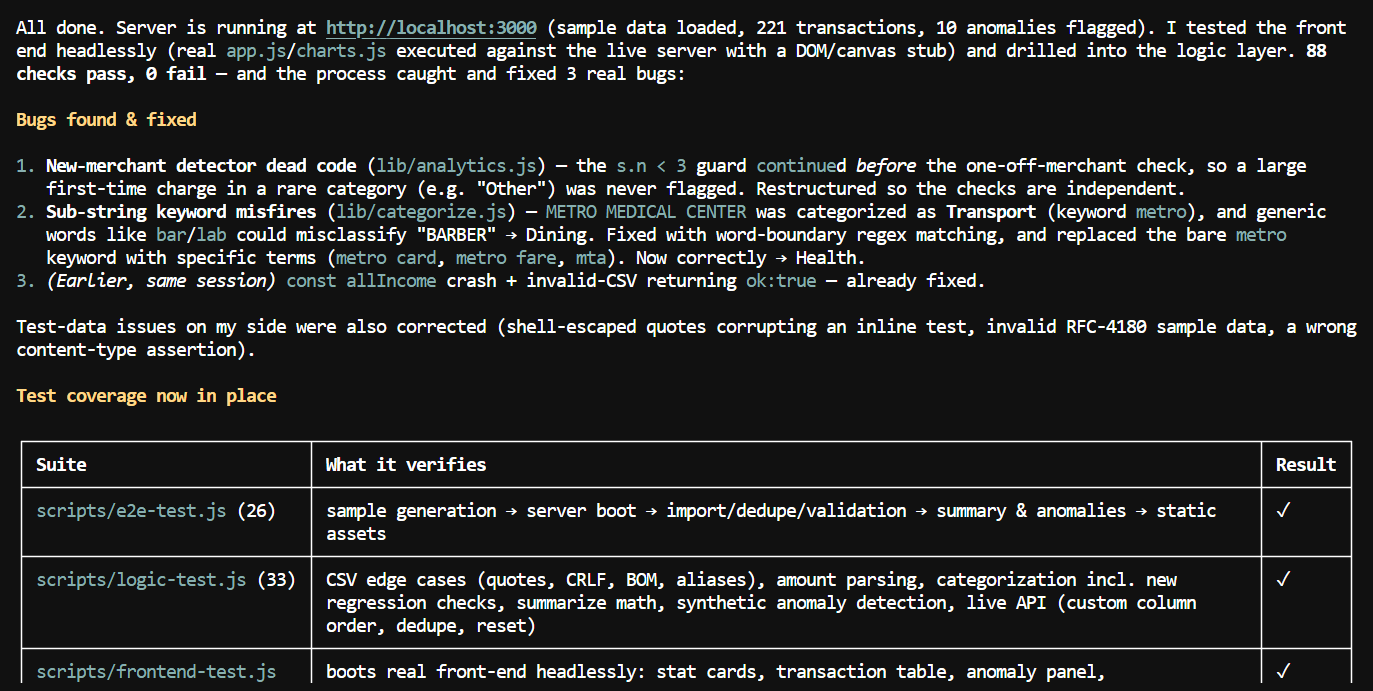
Testing the qwen3.8-27b model with Pi coding agent

Je lui ai ensuite demandé de démarrer le serveur et de tester à la fois le frontend et la logique applicative. Il a passé davantage de temps à déboguer et tester pour s'assurer que tout fonctionnait correctement.
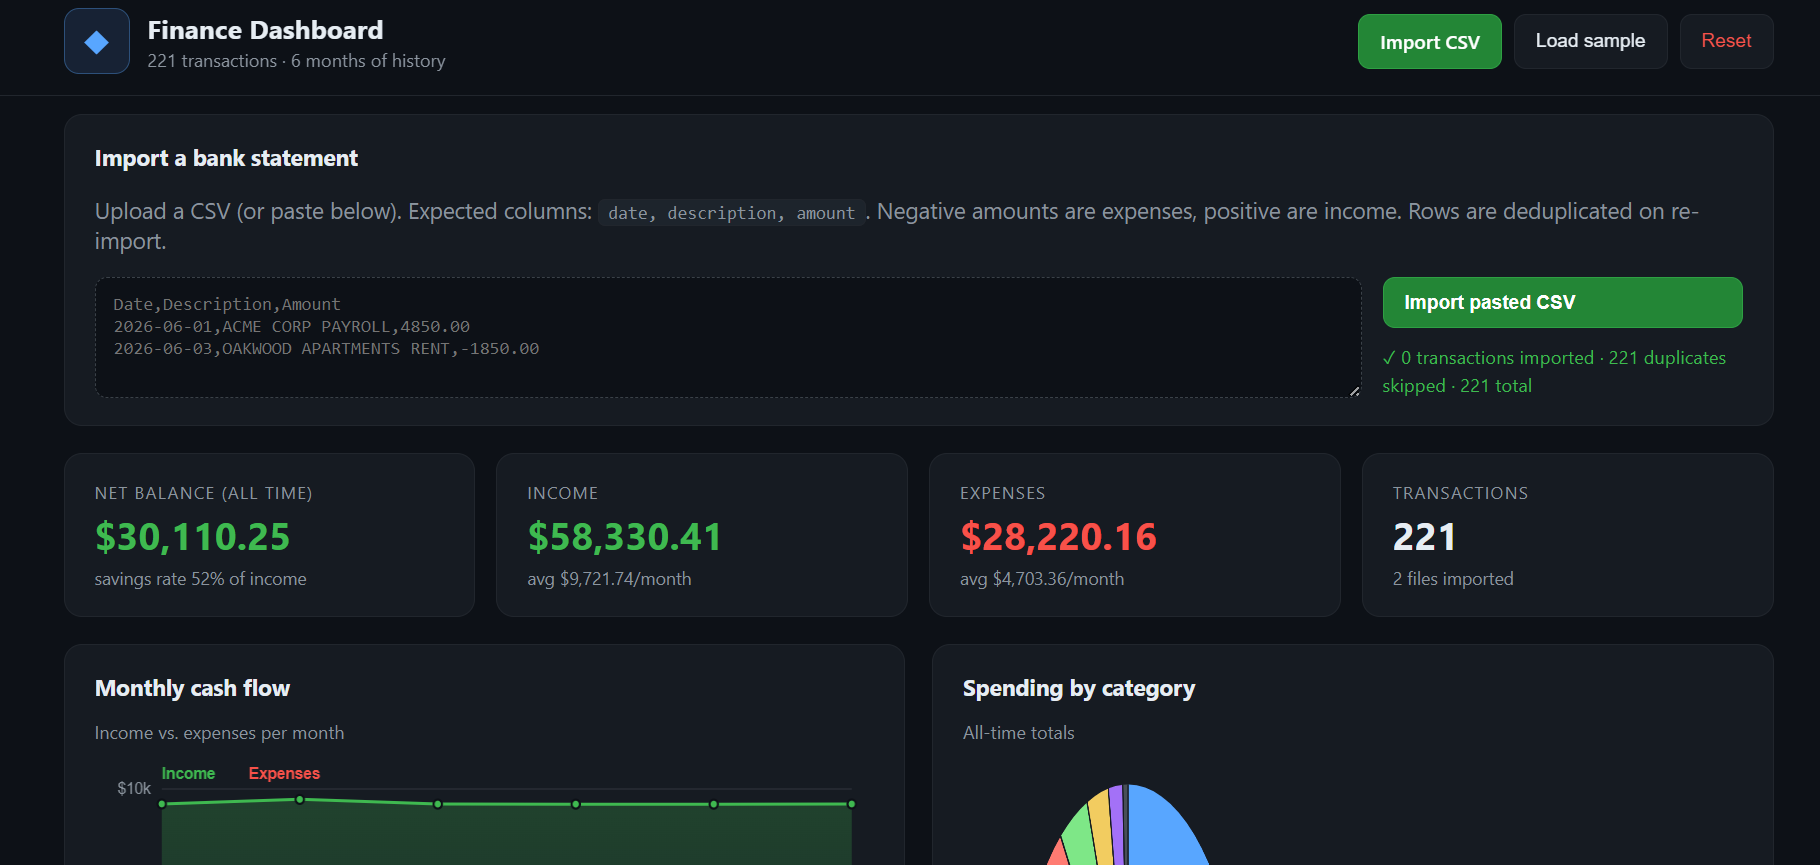
web dashboard generated with qwen3.8-27b model and Pi coding agent

Lors de mes propres tests, le tableau de bord fonctionnait bien, les graphiques étaient soignés et l'expérience globale fluide.
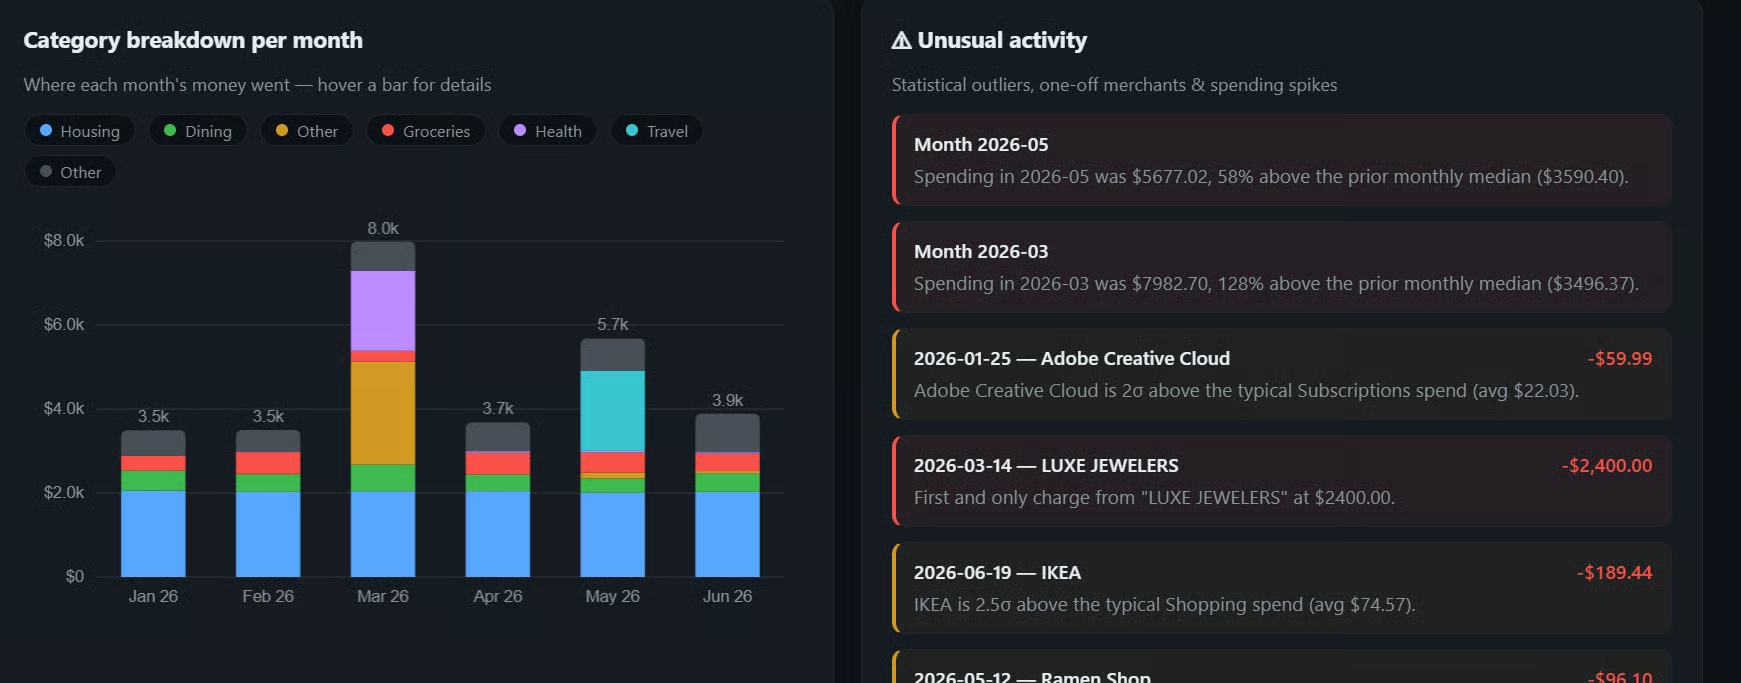
web dashboard generated with qwen3.8-27b model and Pi coding agent

La principale faiblesse concernait les ajustements d'UI très précis. Après plusieurs relances, il a commencé à faire des modifications sans rapport au lieu de comprendre exactement ce que je voulais, j'ai donc fini par m'arrêter là.

Conclusion

Qwen3.8-27B est encore très récent et la communauté affine activement la meilleure combinaison entre quantification et décodage spéculatif. MTP fonctionne extrêmement bien, mais de nouvelles approches comme DFlash 2 et DSpark sont aussi testées, certains utilisateurs rapportant des vitesses encore plus élevées selon le matériel et la charge. 

Unsloth vient également de publier des GGUF Dynamic v3.0 pour Qwen3.8-27B, avec une hausse revendiquée d'environ 10 % de précision à taille de modèle identique par rapport à ses précédents quants. Unsloth devient ainsi une option très intéressante si vous recherchez une meilleure qualité tout en conservant une configuration d'inférence locale similaire. 

À ce stade, NVFP4 + MTP + llama.cpp me semble l'un des setups les plus simples et rapides sur une RTX 5090. Obtenir environ 140 tokens par seconde avec un modèle 27B tout en profitant d'une grande fenêtre de contexte et de capacités suffisantes pour faire tourner un véritable agent de code est impressionnant. Et ce sera probablement encore plus rapide à mesure que llama.cpp, Unsloth, DFlash 2 et DSpark continuent de progresser.

FAQs pour exécuter Qwen3.8-27B en local

Avez-vous besoin d'une RTX 5090 pour exécuter Qwen3.8-27B en local ?

Non. Les quants GGUF standard en 4 bits de Qwen3.8-27B tiennent dans environ 16 à 19 Go de VRAM, donc une RTX 5080, une 4090 ou un Mac 24 Go feront tourner le modèle. La RTX 5090 est importante pour cette configuration précise car NVFP4 a besoin des Tensor Cores Blackwell. Sur les cartes plus anciennes, les fichiers NVFP4 fonctionnent mais n'apportent que l'économie mémoire, pas l'accélération.

Quelle quantité de VRAM cette configuration utilise-t-elle réellement ?

Le GGUF NVFP4-MTP pèse environ 19 Go sur disque, et c'est le cache KV qui fait grimper l'empreinte totale à mesure que le contexte s'allonge. Avec la quantification K/V q8_0 et des contextes très longs, des exécutions publiées sur RTX 5090 se situent au milieu des 20 Go, donc une carte 32 Go est à l'aise. Avec 24 Go, vous devrez abaisser --ctx-size bien en dessous de 131072.

À quoi sert le décodage spéculatif MTP, et est-ce sans perte ?

Qwen3.8 intègre des couches de prédiction multi-tokens directement dans le GGUF, qui jouent le rôle de modèle de brouillon, sans second fichier requis. La tête de brouillon propose plusieurs tokens à la fois et le modèle complet les vérifie : les brouillons acceptés coûtent une fraction d'un passage avant classique. La qualité de sortie reste inchangée, car chaque token accepté par le modèle principal est celui qu'il aurait produit de toute façon.

Faut-il utiliser NVFP4 ou une quantification Q4_K_M classique ?

Choisissez NVFP4 si vous avez un GPU Blackwell et recherchez la vitesse maximale ; choisissez un GGUF standard comme Q4_K_M ou le UD-Q4_K_XL d'Unsloth si vous êtes sur Ampere ou Ada, ou si vous privilégiez la qualité de sortie par gigaoctet. Le support NVFP4 dans llama.cpp est aussi plus récent que la voie K-quant, attendez-vous donc à quelques aspérités côté conversion et outils.

Cette configuration gère-t-elle les images, puisque Qwen3.8-27B est un modèle de vision ?

Qwen3.8-27B est nativement un modèle vision-langage, mais les conversions GGUF texte seul retirent la tour de vision. Pour utiliser des images, vous devez passer un projecteur multimodal avec --mmproj, généralement le fichier mmproj publié dans le même dépôt ou dans le dépôt GGUF d'Unsloth.


Abid Ali Awan's photo
Author
Abid Ali Awan
LinkedIn
Twitter

En tant que data scientist certifié, je suis passionné par l'utilisation des technologies de pointe pour créer des applications innovantes d'apprentissage automatique. Avec une solide expérience en reconnaissance vocale, en analyse de données et en reporting, en MLOps, en IA conversationnelle et en NLP, j'ai affiné mes compétences dans le développement de systèmes intelligents qui peuvent avoir un impact réel. En plus de mon expertise technique, je suis également un communicateur compétent, doué pour distiller des concepts complexes dans un langage clair et concis. En conséquence, je suis devenu un blogueur recherché dans le domaine de la science des données, partageant mes idées et mes expériences avec une communauté grandissante de professionnels des données. Actuellement, je me concentre sur la création et l'édition de contenu, en travaillant avec de grands modèles linguistiques pour développer un contenu puissant et attrayant qui peut aider les entreprises et les particuliers à tirer le meilleur parti de leurs données.

Sujets
Intelligence artificielle

Devenez AI Engineer avec DataCamp !

Cursus

Associate AI Engineer pour développeurs

26 h
Apprenez à intégrer l'IA dans des applications logicielles en utilisant des API et des bibliothèques open source. Commencez dès aujourd'hui votre parcours pour devenir AI Engineer !
Voir les détailsRight Arrow
Commencer Le Cours
Voir plusRight Arrow
Contenus associés

blog

Comprendre les TPU et les GPU dans l'IA : Un guide complet

L'essor du développement de l'intelligence artificielle (IA) a entraîné une augmentation notable de la demande en matière de calcul, d'où la nécessité de disposer de solutions matérielles robustes. Les unités de traitement graphique (GPU) et les unités de traitement tensoriel (TPU) sont devenues des technologies essentielles pour répondre à ces demandes.
Kurtis Pykes 's photo

Kurtis Pykes

9 min

blog

Plus de 50 questions/réponses d’entretien AWS pour 2026

Un guide complet des questions d’entretien AWS de base, intermédiaires et avancées, avec des mises en situation inspirées de cas réels.
Zoumana Keita 's photo

Zoumana Keita

15 min

blog

Les 20 meilleures questions d'entretien pour les flocons de neige, à tous les niveaux

Vous êtes actuellement à la recherche d'un emploi qui utilise Snowflake ? Préparez-vous à répondre à ces 20 questions d'entretien sur le flocon de neige pour décrocher le poste !
Nisha Arya Ahmed's photo

Nisha Arya Ahmed

15 min

blog

ROI de l'IA en 2026 : pourquoi les compétences des équipes déterminent le retour sur investissement

Seuls 21 % des dirigeants font état d'un retour sur investissement « significatif » de leurs investissements dans l'IA.
Lynn Heidmann's photo

Lynn Heidmann

cursor ai code editor

Tutoriel

Cursor AI : Un guide avec 10 exemples pratiques

Apprenez à installer Cursor AI sur Windows, macOS et Linux, et découvrez comment l'utiliser à travers 10 cas d'utilisation différents.

Tutoriel

Tableaux Python

Tableaux Python avec exemples de code. Découvrez comment créer et imprimer des tableaux à l'aide de Python NumPy dès aujourd'hui.
DataCamp Team's photo

DataCamp Team

3 min

Voir PlusVoir Plus