track
Inginer AI asociat pentru dezvoltatori
26 oră
Mai întâi, ne asigurăm că GPU-ul este detectat corect și verificăm versiunea de driver NVIDIA și CUDA.
nvidia-smi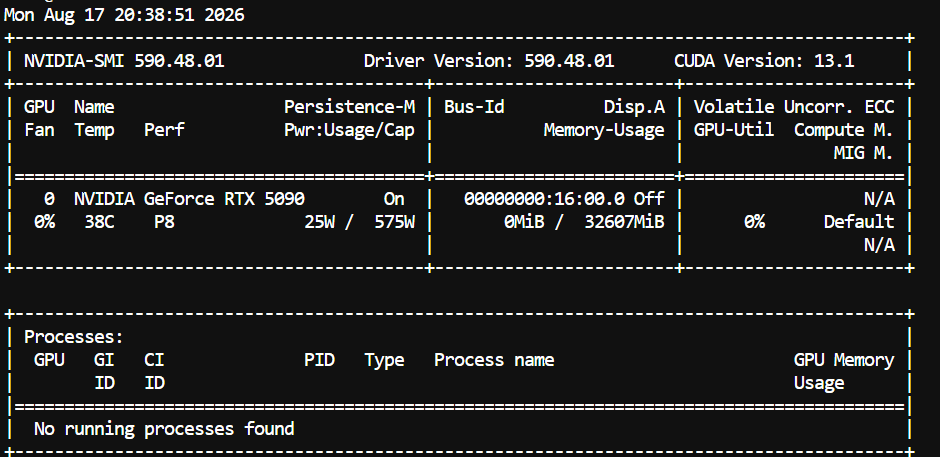
Ar trebui să vezi RTX 5090, versiunea de driver, versiunea CUDA, memoria GPU și utilizarea curentă a GPU-ului.
Notă: Această configurare este specifică pentru GPU-urile NVIDIA Blackwell, cum ar fi RTX 5090. Buildul de mai jos țintește SM120, arhitectura de calcul folosită de RTX 5090.
Apoi, vom descărca și compila cea mai recentă versiune de llama.cpp cu suport CUDA.
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp

cmake -B build \
  -DGGML_CUDA=ON \
  -DCMAKE_CUDA_ARCHITECTURES=120

cmake --build build --config Release -j$(nproc)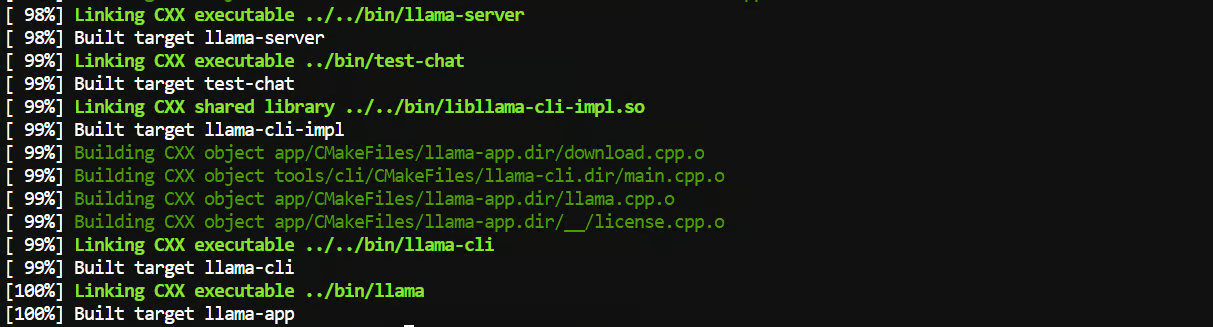
Partea importantă aici este -DCMAKE_CUDA_ARCHITECTURES=120. Asta îi spune lui llama.cpp să construiască special pentru arhitectura Blackwell folosită de RTX 5090.
După ce buildul se termină, vom face llama-server disponibil global ca să-l putem rula din orice folder:
sudo ln -sf "$(realpath ./build/bin/llama-server)" /usr/local/bin/llama-serverAcum, verifică dacă totul funcționează:
llama-server --versionAr trebui să primești un output similar cu:
version: 0.1.1-dev (build 10479, commit 0021a77de)
built with GNU 13.3.0 for Linux x86_64
Asta e tot. Avem acum un build llama.cpp cu CUDA care poate beneficia de RTX 5090 și de suportul nativ NVFP4 al Blackwell.
Acum vom descărca modelul Qwen3.8-27B.
Mai întâi, instalează Hugging Face CLI:
pip install -U huggingface_hubCreează un folder unde vom păstra modelul:
mkdir -p /workspace/models/qwen38Apoi descarcă GGUF-ul NVFP4-MTP:
hf download felippeburk/Qwen3.8-27B-NVFP4-MTP-GGUF \
  --local-dir /workspace/models/qwen38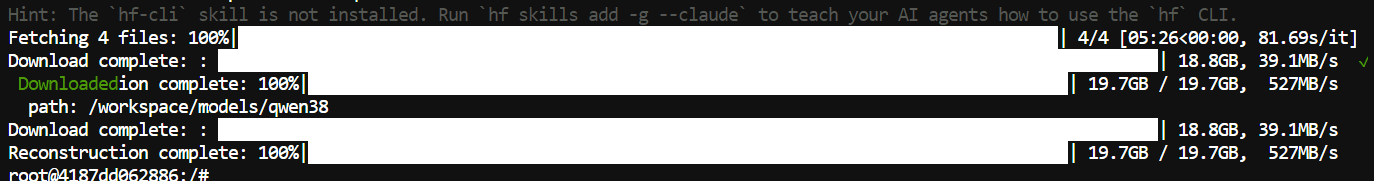
Aceasta este versiunea pe care o vrem pentru această configurare, deoarece folosește NVFP4 și include suport MTP, de unde vine o mare parte din creșterea de viteză pe RTX 5090.
Acum urmează partea distractivă. Vom servi Qwen3.8-27B complet pe GPU, cu Flash Attention, o fereastră de context de 131K și decodare speculativă MTP pentru generare mai rapidă.
Rulează:
cd /workspace/llama.cpp

llama-server \
  -m /workspace/models/qwen38/qwen3.8-27b-text-nvfp4-mtp.gguf \
  --alias qwen3.8-27b \
  --host 0.0.0.0 \
  --port 8910 \
  --ctx-size 131072 \
  --n-gpu-layers all \
  --flash-attn on \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --parallel 1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 4 \
  --spec-draft-p-min 0.75 \
  --spec-draft-ngl all \
  --spec-draft-type-k q8_0 \
  --spec-draft-type-v q8_0 \
  --reasoning-effort medium \
  --jinja
Sunt multe opțiuni aici, dar majoritatea sunt doar pentru a scoate maximumul de performanță din 5090.
Cele principale de știut sunt:
--ctx-size 131072 ne oferă aproximativ o fereastră de context de 131K.
--n-gpu-layers all păstrează modelul pe GPU.
--flash-attn on activează Flash Attention.
--cache-type-k q8_0 și --cache-type-v q8_0 ajută la reducerea memoriei folosite de cache-ul KV.
--spec-type draft-mtp activează decodarea speculativă MTP a Qwen3.8.
--spec-draft-n-max 4 controlează câte tokenuri speculative poate genera MTP simultan.
Pentru această configurare, folosim n-max 4 ca punct de plecare pe un RTX 5090. Poți experimenta ulterior cu valori precum 2 (pe care fișa modelului o recomandă pentru acest GGUF) sau 3, deoarece setarea cea mai rapidă poate varia ușor în funcție de sistem.
După ce llama-server termină de încărcat modelul, Qwen3.8 va fi disponibil local la http://127.0.0.1:8910.
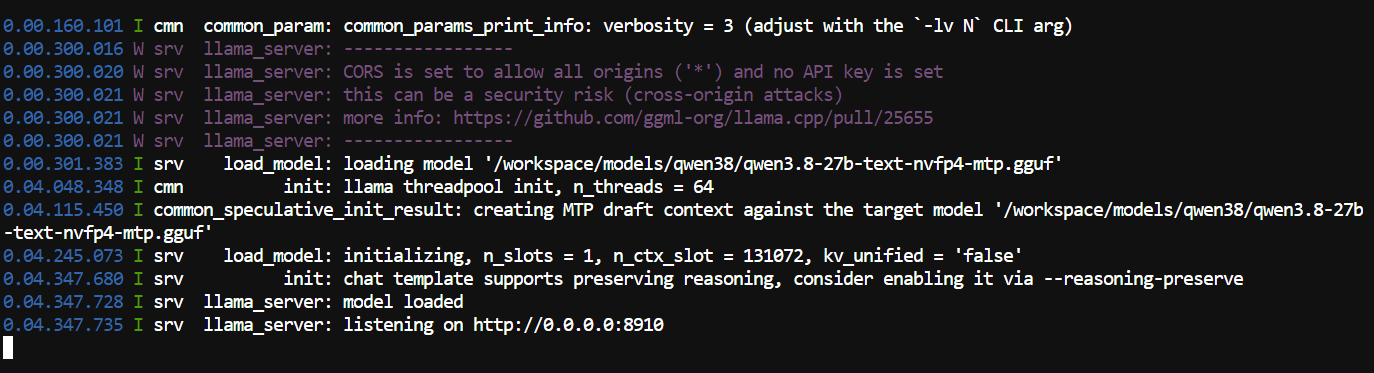
Acum avem Qwen3.8-27B rulând local. În continuare, vom testa modelul atât prin API, cât și prin interfața de browser integrată.
Cu serverul pornit, deschide un alt terminal și trimite o cerere de test către API-ul compatibil OpenAI:
curl http://127.0.0.1:8910/v1/chat/completions \
 -H "Content-Type: application/json" \
 -d '{
   "model": "qwen3.8-27b",
   "messages": [
     {
       "role": "user",
       "content": "Write a Python FastAPI application that monitors GPU usage."
     }
   ],
   "max_tokens": 2000
 }'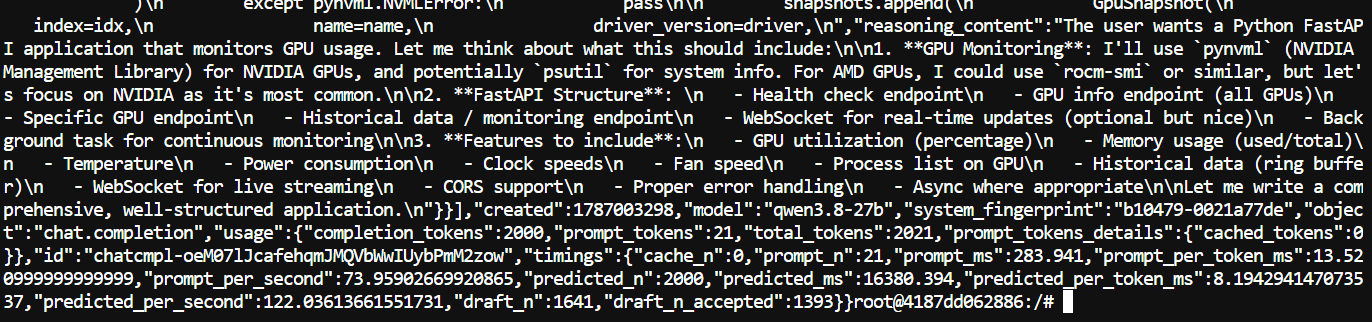
În acest test, Qwen3.8-27B a generat 2.000 de tokenuri la 122 tokenuri/sec cu o rată de acceptare MTP impresionantă de 84,9%.
llama.cpp include și o interfață de browser, astfel încât poți testa modelul fără să folosești API-ul.
Deschide http://127.0.0.1:8910 în browser pentru a vedea interfața.
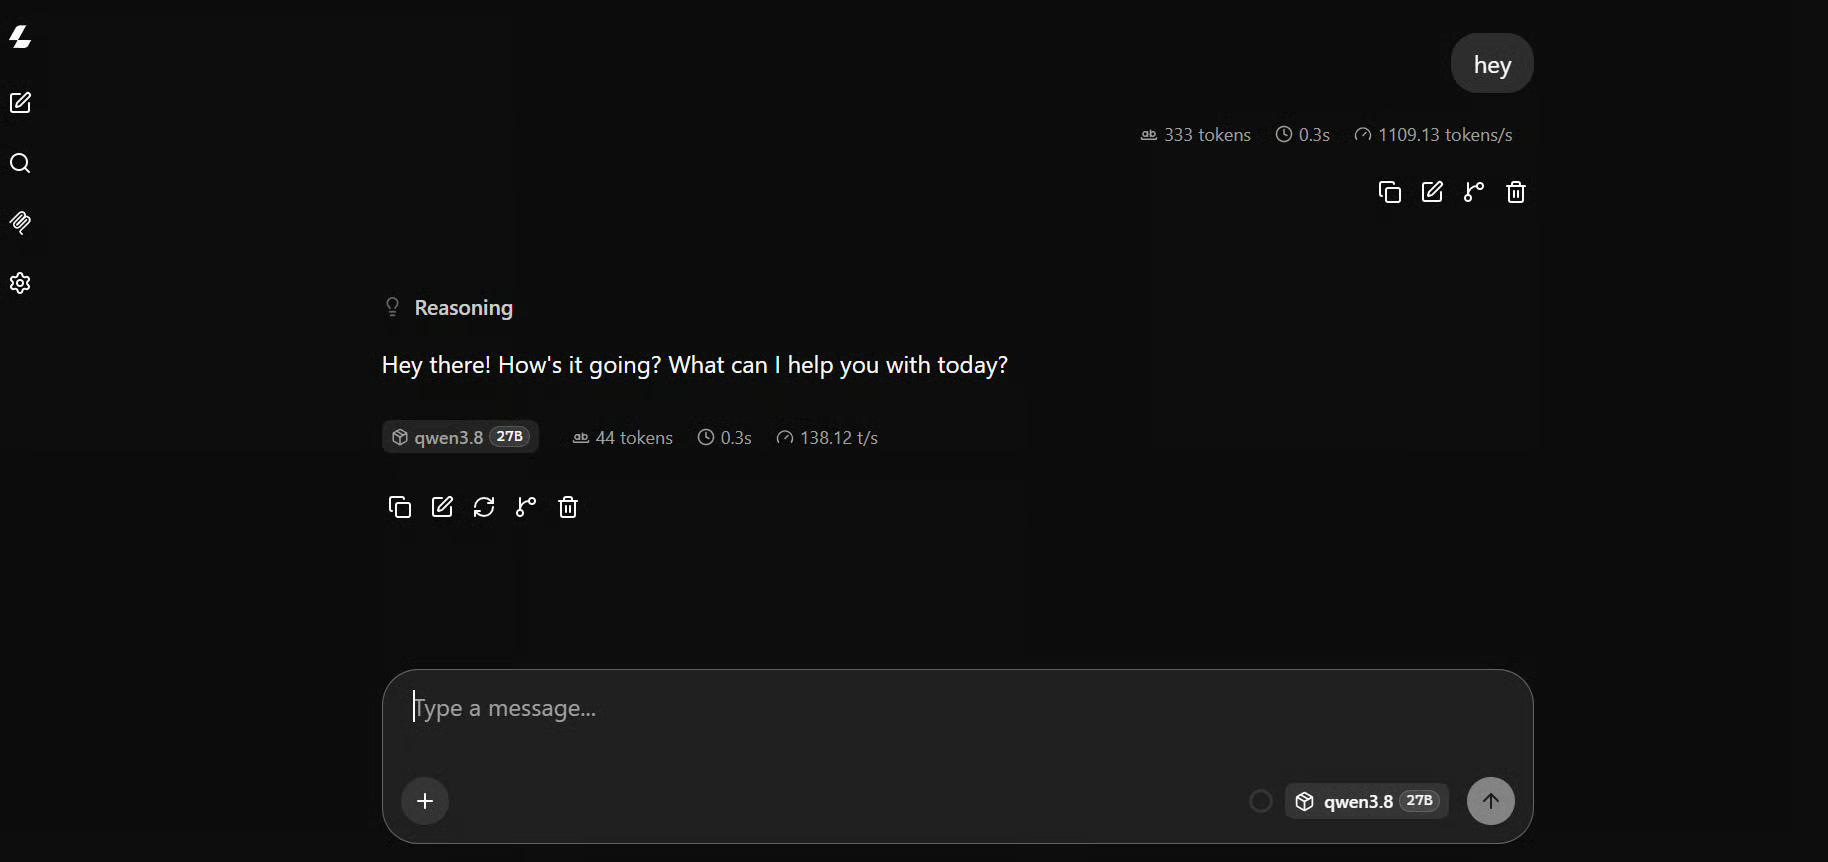
Pentru un test mai complex, am folosit acest prompt:
Create a stunning single-file animated HTML website with a dark futuristic
theme, smooth scrolling, glowing gradients, floating particles, animated cards,
hover effects, and responsive design using only HTML, CSS, and JavaScript.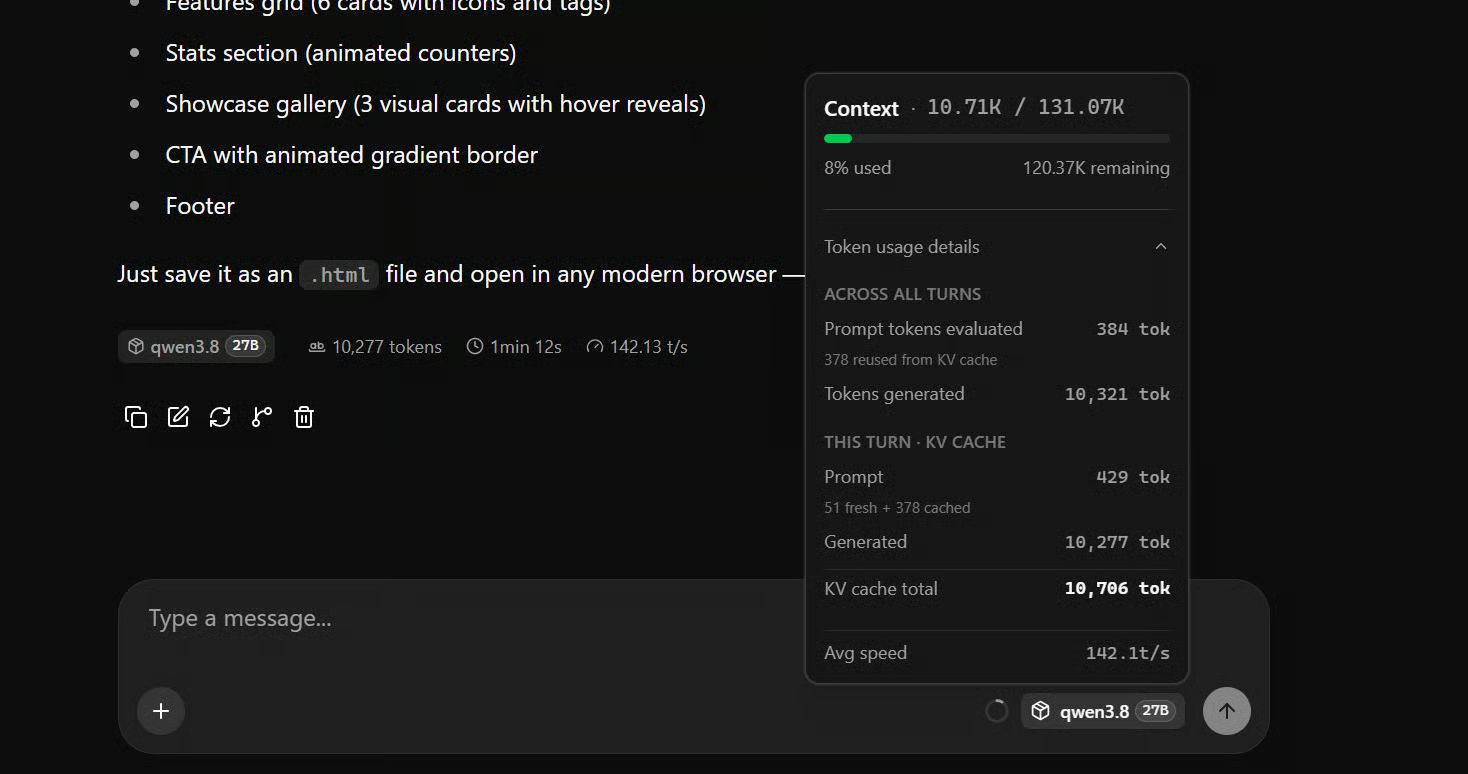
Pe RTX 5090-ul meu, am obținut în medie aproximativ 142 tokenuri pe secundă, cu viteze care ajungeau uneori la circa 170 tokenuri pe secundă, ceea ce este extrem de rapid pentru un model de 27B care rulează local.
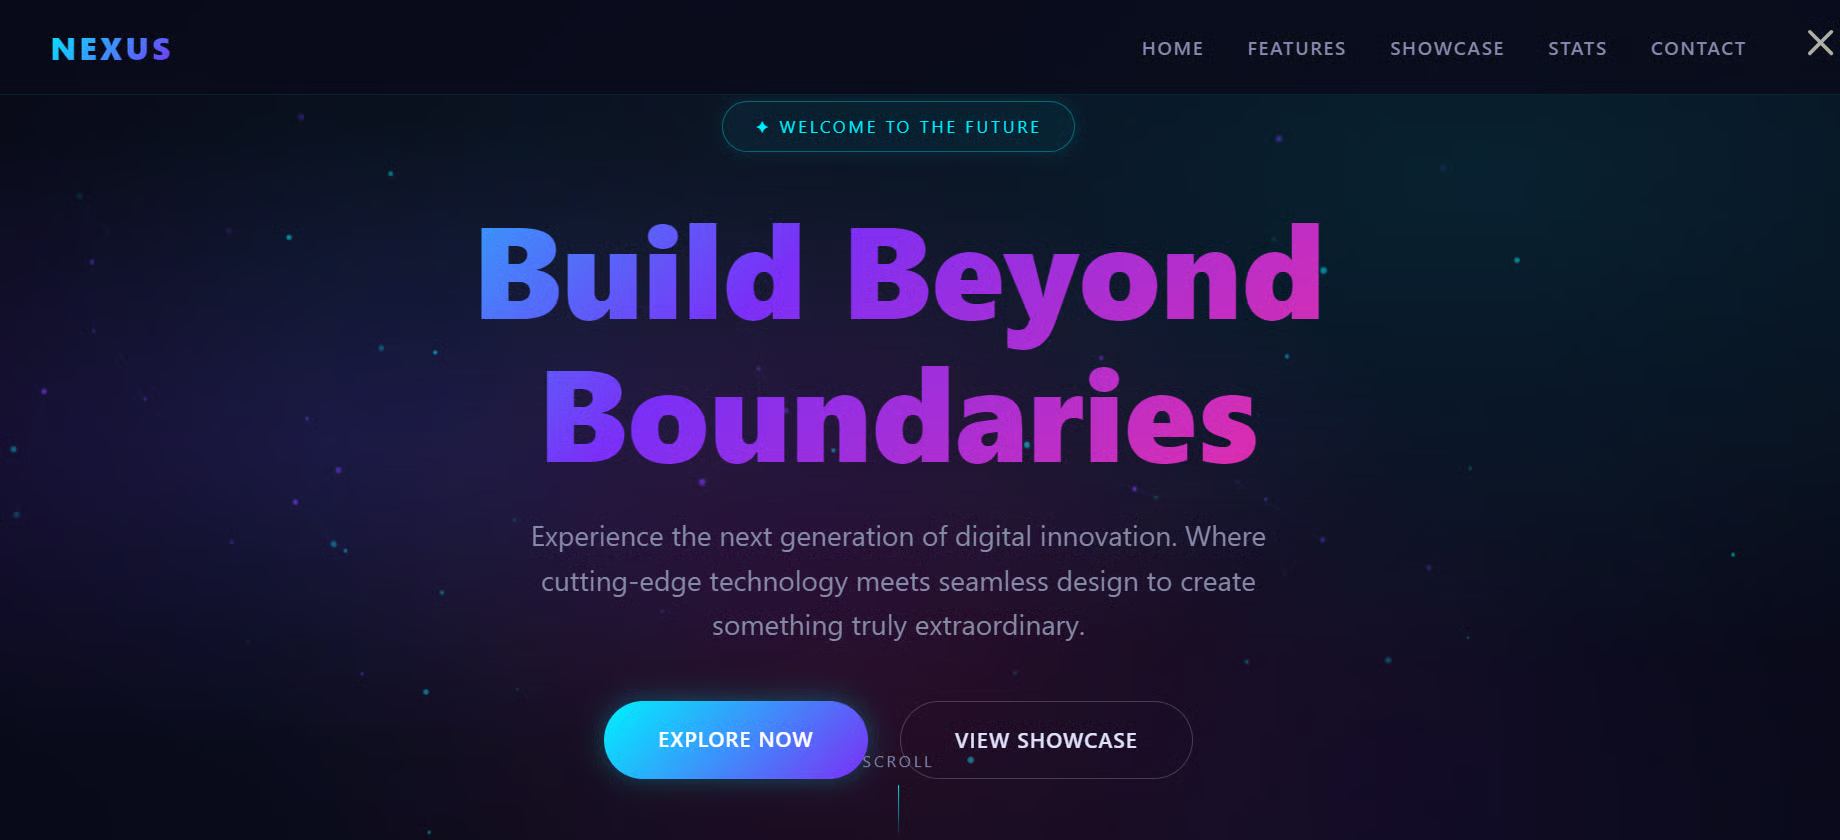
Qwen3.8-27B a generat un site web finisat, complet funcțional, care a rulat din prima. Este o modalitate bună de a testa rapid atât abilitatea de codare a modelului, cât și viteza configurației locale.
În această secțiune, vom conecta Qwen3.8-27B la Pi și îl vom folosi ca agent de codare complet local.
Pi este un agent de codare ușor, bazat pe terminal, care te poate ajuta să construiești, editezi, testezi și debugezi proiecte direct din linia de comandă.
Instalează Pi cu:
curl -fsSL https://pi.dev/install.sh | shProgramul de instalare necesită Node.js și npm. Instalează Pi în prefixul npm global. Dacă nu ai încă Node, instalează-l mai întâi cu nvm sau cu managerul tău de pachete.
După ce instalarea se încheie, repornește terminalul.
Apoi, instalează extensia pi-llama și indică lui Pi serverul nostru local llama.cpp:
pi install git:github.com/huggingface/pi-llama

export LLAMA_BASE_URL=http://127.0.0.1:8910/v1
Creează un proiect nou și pornește Pi:
mkdir new-project
cd new-project

Pi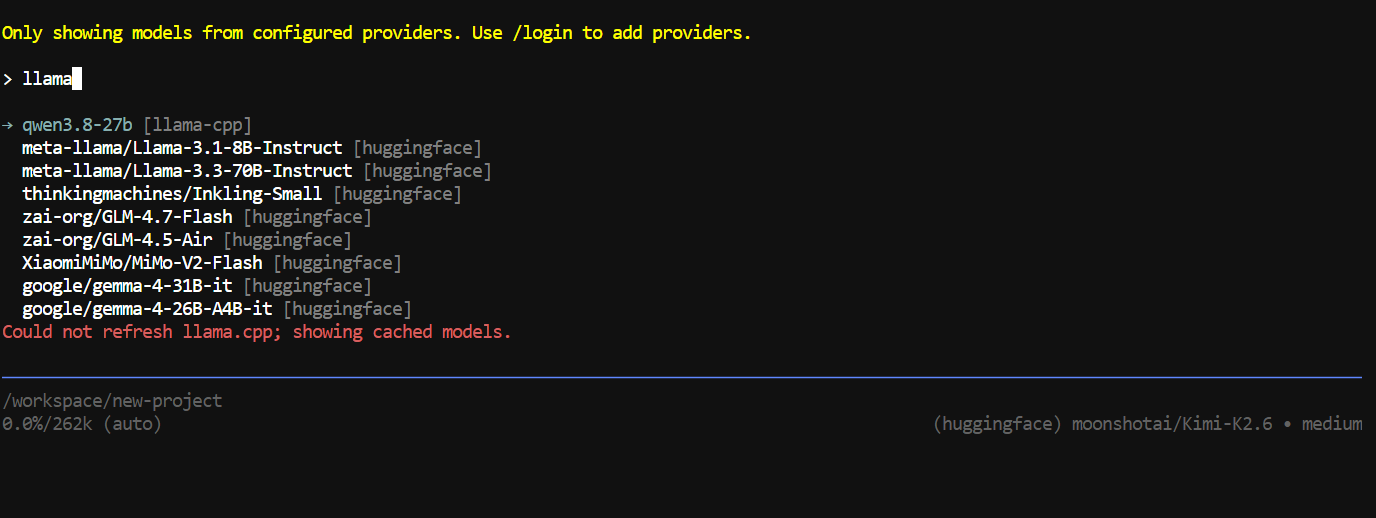
În interiorul lui Pi, rulează /model, caută llama-cpp și selectează Qwen3.8-27B.
Pentru testare, i-am dat acest prompt:
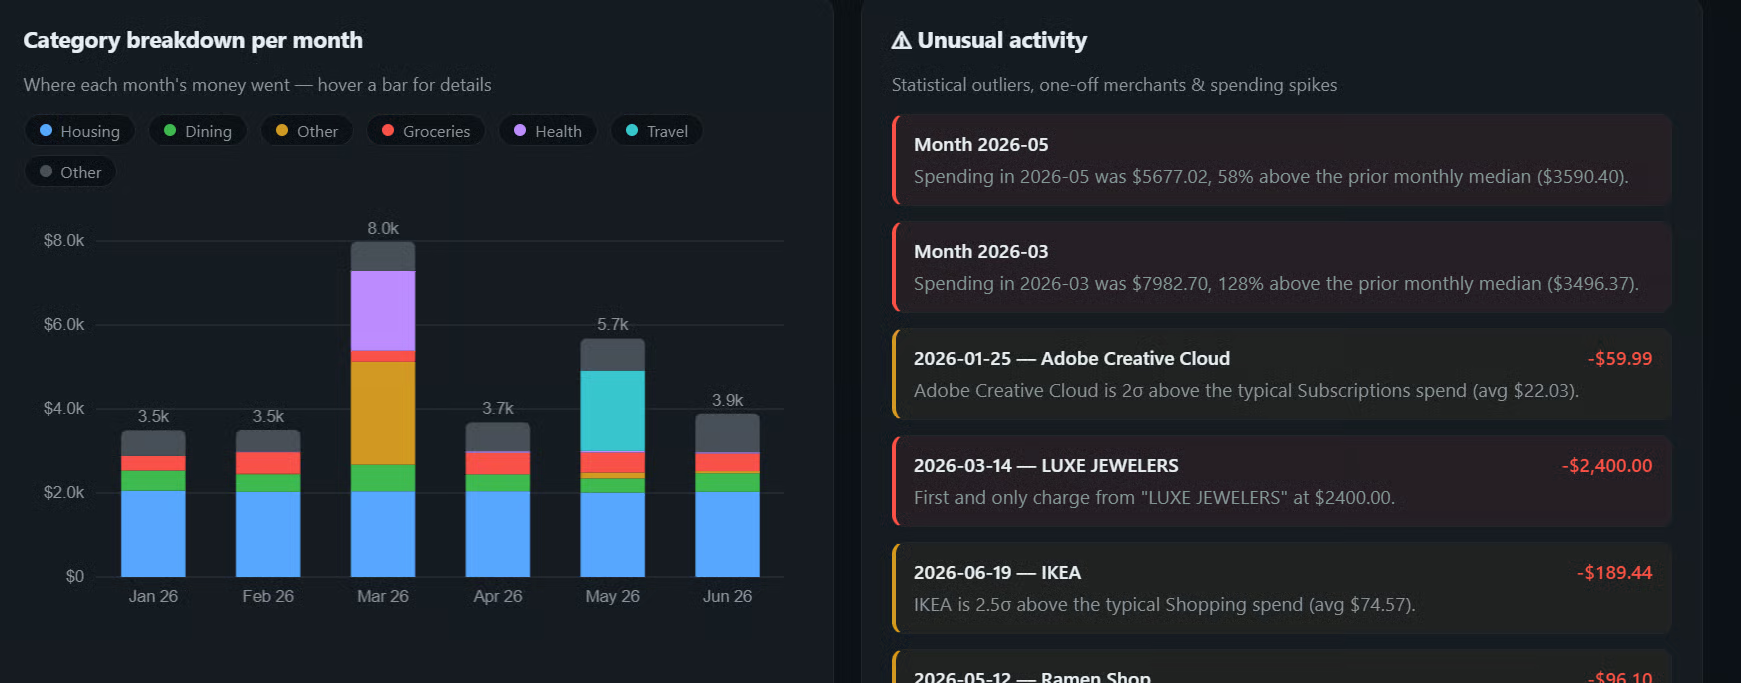
Build a polished personal finance dashboard from scratch that imports CSV
bank statements, categorizes spending, shows monthly trends and charts, and
detects unusual expenses; also generate a realistic sample CSV, import it,
test the full app end-to-end, and fix any errors automatically.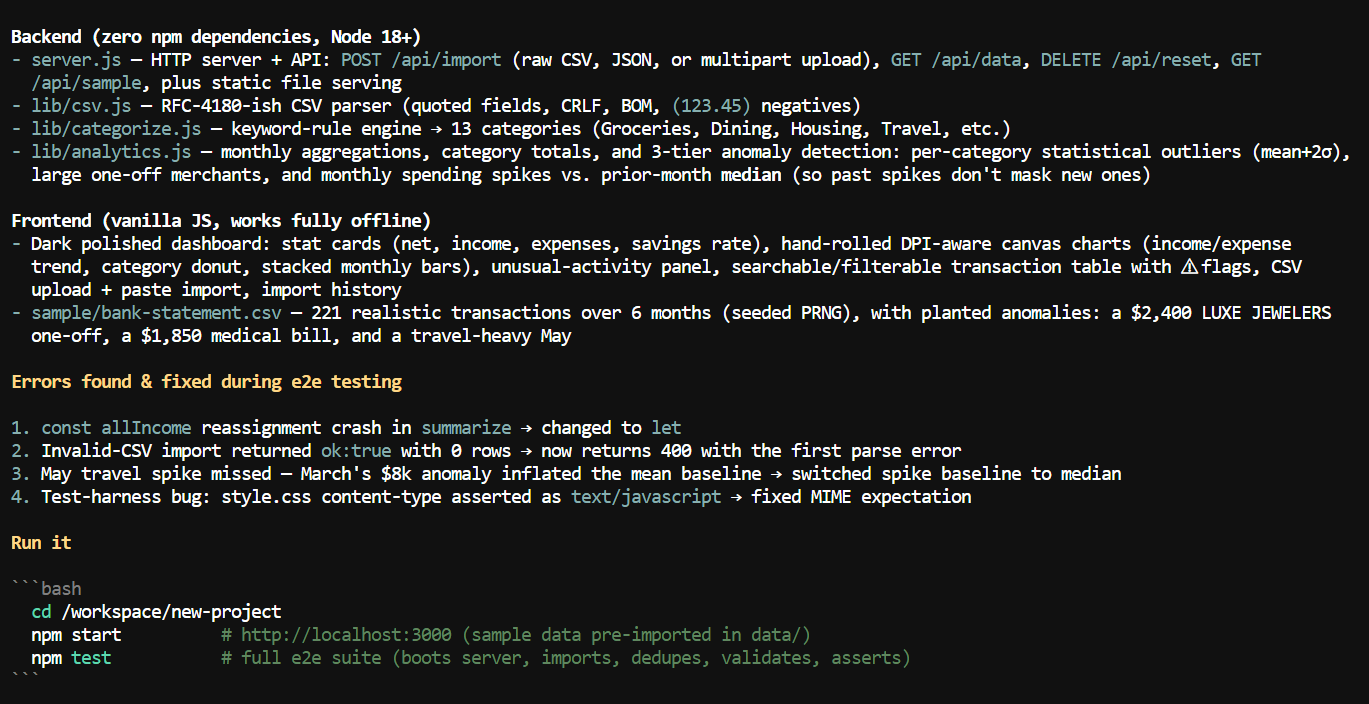
A construit întregul proiect în câteva minute.
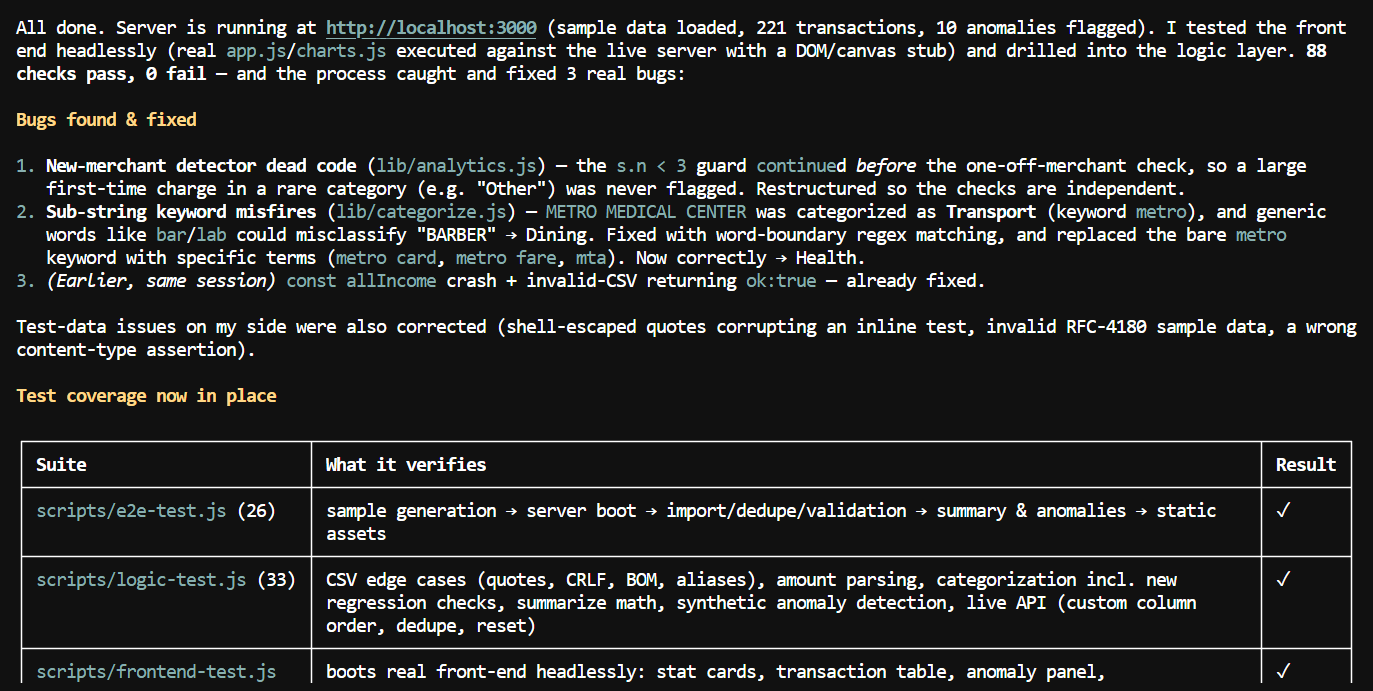
Apoi i-am cerut să pornească serverul și să testeze atât frontendul, cât și logica aplicației. A petrecut mai mult timp făcând debugging și testând pentru a se asigura că totul funcționează corect.
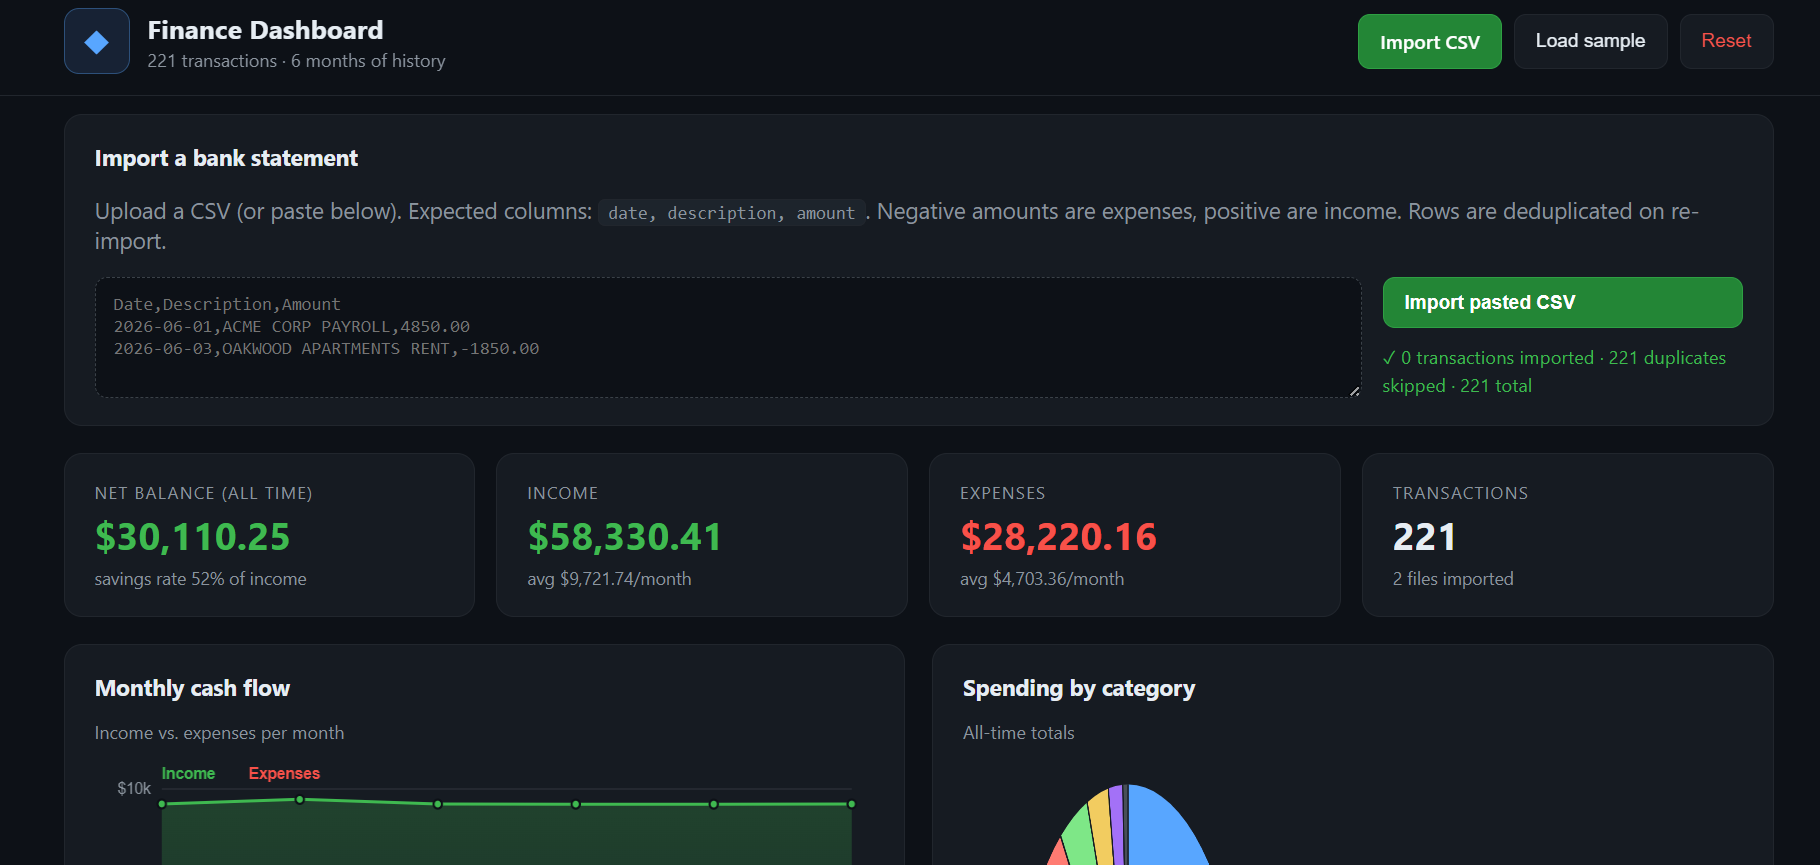
Când am testat eu panoul, aplicația a mers bine, graficele arătau grozav, iar experiența generală a fost fluentă.
Principala slăbiciune a fost realizarea de modificări UI foarte precise. După mai multe prompturi succesive, a început să facă schimbări fără legătură, în loc să înțeleagă exact ce îmi doream, așa că m-am oprit acolo.
Qwen3.8-27B este încă foarte nou, iar comunitatea caută activ cea mai bună combinație de cuantizare și decodare speculativă. MTP funcționează extrem de bine, dar se testează și abordări mai noi precum DFlash 2 și DSpark, unii utilizatori raportând viteze și mai mari în funcție de hardware și tipul de sarcină.
Unsloth tocmai a lansat și GGUF-uri Dynamic v3.0 pentru Qwen3.8-27B, pretinzând aproximativ 10% acuratețe mai mare la aceeași dimensiune de model față de cuantizările anterioare. Asta face din Unsloth o opțiune foarte interesantă dacă vrei calitate mai bună păstrând în linii mari aceeași configurare locală de inferență.
Pentru moment, cred că NVFP4 + MTP + llama.cpp este una dintre cele mai simple și rapide configurații pentru un RTX 5090. Să obții circa 140 de tokenuri pe secundă dintr-un model de 27B, având în același timp o fereastră de context mare și suficientă capacitate pentru a rula un agent de codare real, este impresionant. Configurația probabil va deveni și mai rapidă pe măsură ce llama.cpp, Unsloth, DFlash 2 și DSpark continuă să se îmbunătățească.
Devino AI Engineer cu DataCamp!
track
course
track