Programa
Associate AI Engineer para desenvolvedores
26 h
Primeiro, vamos garantir que a GPU foi detectada corretamente e verificar a versão do driver NVIDIA e do CUDA.
nvidia-smi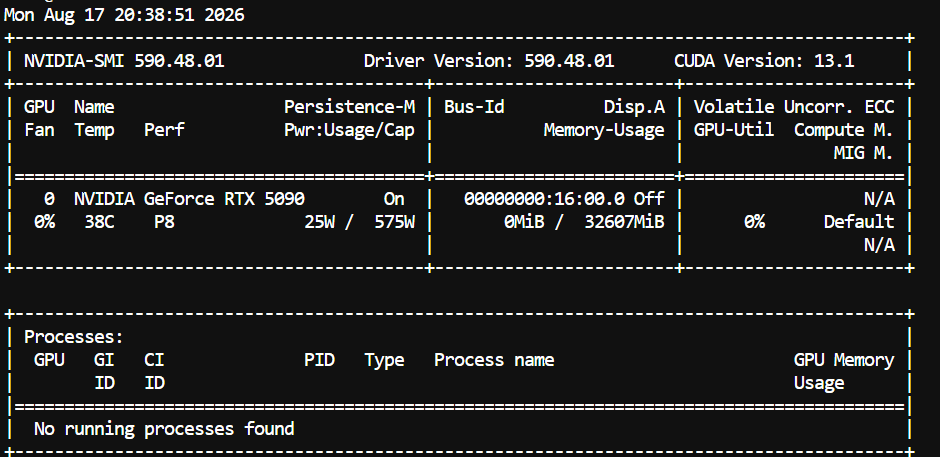
Você deve ver sua RTX 5090, a versão do driver, a versão do CUDA, a memória da GPU e o uso atual da GPU.
Observação: esta configuração é específica para GPUs NVIDIA Blackwell, como a RTX 5090. A build abaixo tem como alvo o SM120, que é a arquitetura de compute usada pela RTX 5090.
Em seguida, vamos baixar e compilar a versão mais recente do llama.cpp com suporte a CUDA.
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp

cmake -B build \
  -DGGML_CUDA=ON \
  -DCMAKE_CUDA_ARCHITECTURES=120

cmake --build build --config Release -j$(nproc)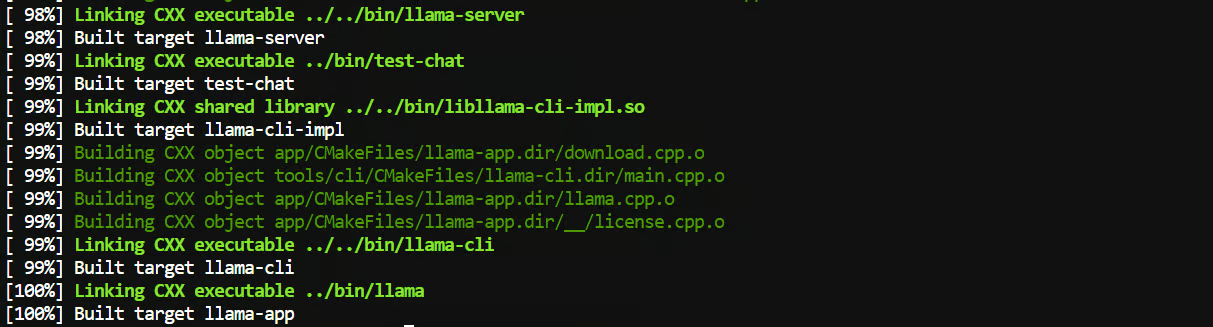
A parte importante aqui é -DCMAKE_CUDA_ARCHITECTURES=120. Isso indica ao llama.cpp para compilar especificamente para a arquitetura Blackwell usada pela RTX 5090.
Quando a build terminar, vamos tornar o llama-server disponível globalmente para podermos executá-lo de qualquer pasta:
sudo ln -sf "$(realpath ./build/bin/llama-server)" /usr/local/bin/llama-serverAgora, verifique se tudo está funcionando:
llama-server --versionVocê deve receber uma saída semelhante a:
version: 0.1.1-dev (build 10479, commit 0021a77de)
built with GNU 13.3.0 for Linux x86_64
Pronto. Agora temos uma build do llama.cpp com CUDA que aproveita a RTX 5090 e seu suporte nativo a NVFP4 do Blackwell.
Agora vamos baixar o modelo Qwen3.8-27B.
Primeiro, instale o CLI do Hugging Face:
pip install -U huggingface_hubCrie uma pasta para guardar o modelo:
mkdir -p /workspace/models/qwen38Depois, baixe o GGUF NVFP4-MTP:
hf download felippeburk/Qwen3.8-27B-NVFP4-MTP-GGUF \
  --local-dir /workspace/models/qwen38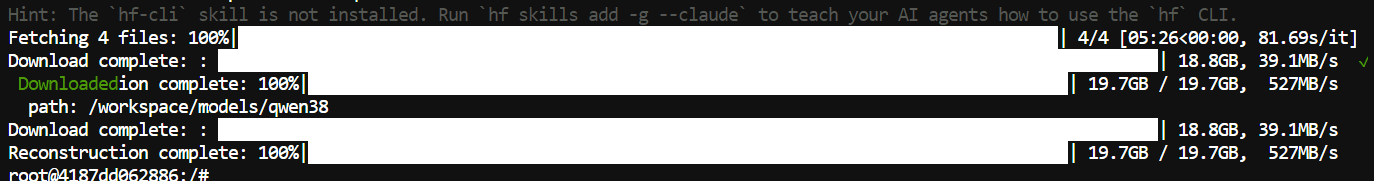
Essa é a versão ideal para esta configuração porque usa NVFP4 e inclui suporte a MTP, que é o principal responsável pelo ganho de velocidade na RTX 5090.
Agora vem a parte divertida. Vamos servir o Qwen3.8-27B totalmente na GPU com Flash Attention, uma janela de contexto de 131K e decodificação especulativa MTP para gerar mais rápido.
Execute:
cd /workspace/llama.cpp

llama-server \
  -m /workspace/models/qwen38/qwen3.8-27b-text-nvfp4-mtp.gguf \
  --alias qwen3.8-27b \
  --host 0.0.0.0 \
  --port 8910 \
  --ctx-size 131072 \
  --n-gpu-layers all \
  --flash-attn on \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --parallel 1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 4 \
  --spec-draft-p-min 0.75 \
  --spec-draft-ngl all \
  --spec-draft-type-k q8_0 \
  --spec-draft-type-v q8_0 \
  --reasoning-effort medium \
  --jinja
Há muitas opções aqui, mas a maioria está aí para extrair o melhor desempenho da 5090.
As principais são:
--ctx-size 131072 nos dá cerca de 131K de janela de contexto.
--n-gpu-layers all mantém o modelo na GPU.
--flash-attn on ativa o Flash Attention.
--cache-type-k q8_0 e --cache-type-v q8_0 ajudam a reduzir o uso de memória do cache KV.
--spec-type draft-mtp ativa a decodificação especulativa MTP do Qwen3.8.
--spec-draft-n-max 4 controla quantos tokens especulativos o MTP pode gerar de uma vez.
Nesta configuração, usamos n-max 4 como ponto de partida para uma RTX 5090. Você pode experimentar valores como 2 (recomendado no model card deste GGUF) ou 3 depois, pois a configuração mais rápida pode variar um pouco conforme o seu sistema.
Assim que o llama-server terminar de carregar o modelo, o Qwen3.8 estará disponível localmente em http://127.0.0.1:8910.
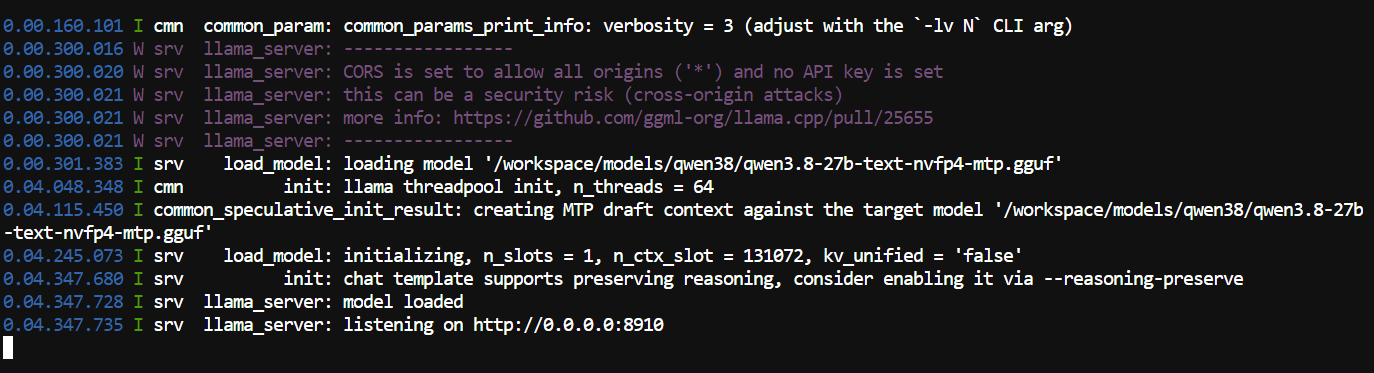
Agora temos o Qwen3.8-27B rodando localmente. Em seguida, vamos testar o modelo pela API e pela interface no navegador.
Com o servidor em execução, abra outro terminal e envie uma requisição de teste para a API compatível com OpenAI:
curl http://127.0.0.1:8910/v1/chat/completions \
 -H "Content-Type: application/json" \
 -d '{
   "model": "qwen3.8-27b",
   "messages": [
     {
       "role": "user",
       "content": "Write a Python FastAPI application that monitors GPU usage."
     }
   ],
   "max_tokens": 2000
 }'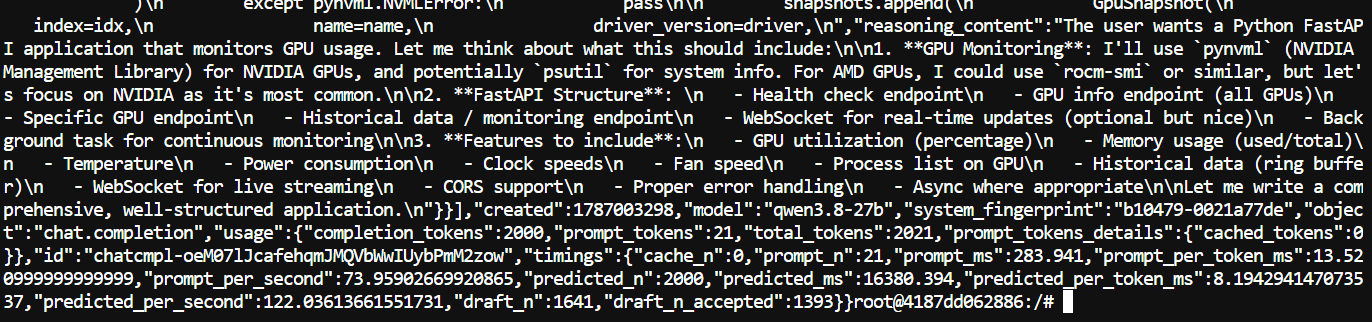
Neste teste, o Qwen3.8-27B gerou 2.000 tokens a 122 tokens/s com uma taxa de aceitação MTP impressionante de 84,9%.
O llama.cpp também inclui uma interface no navegador, para você testar o modelo sem usar a API.
Abra http://127.0.0.1:8910 no seu navegador para ver a UI.
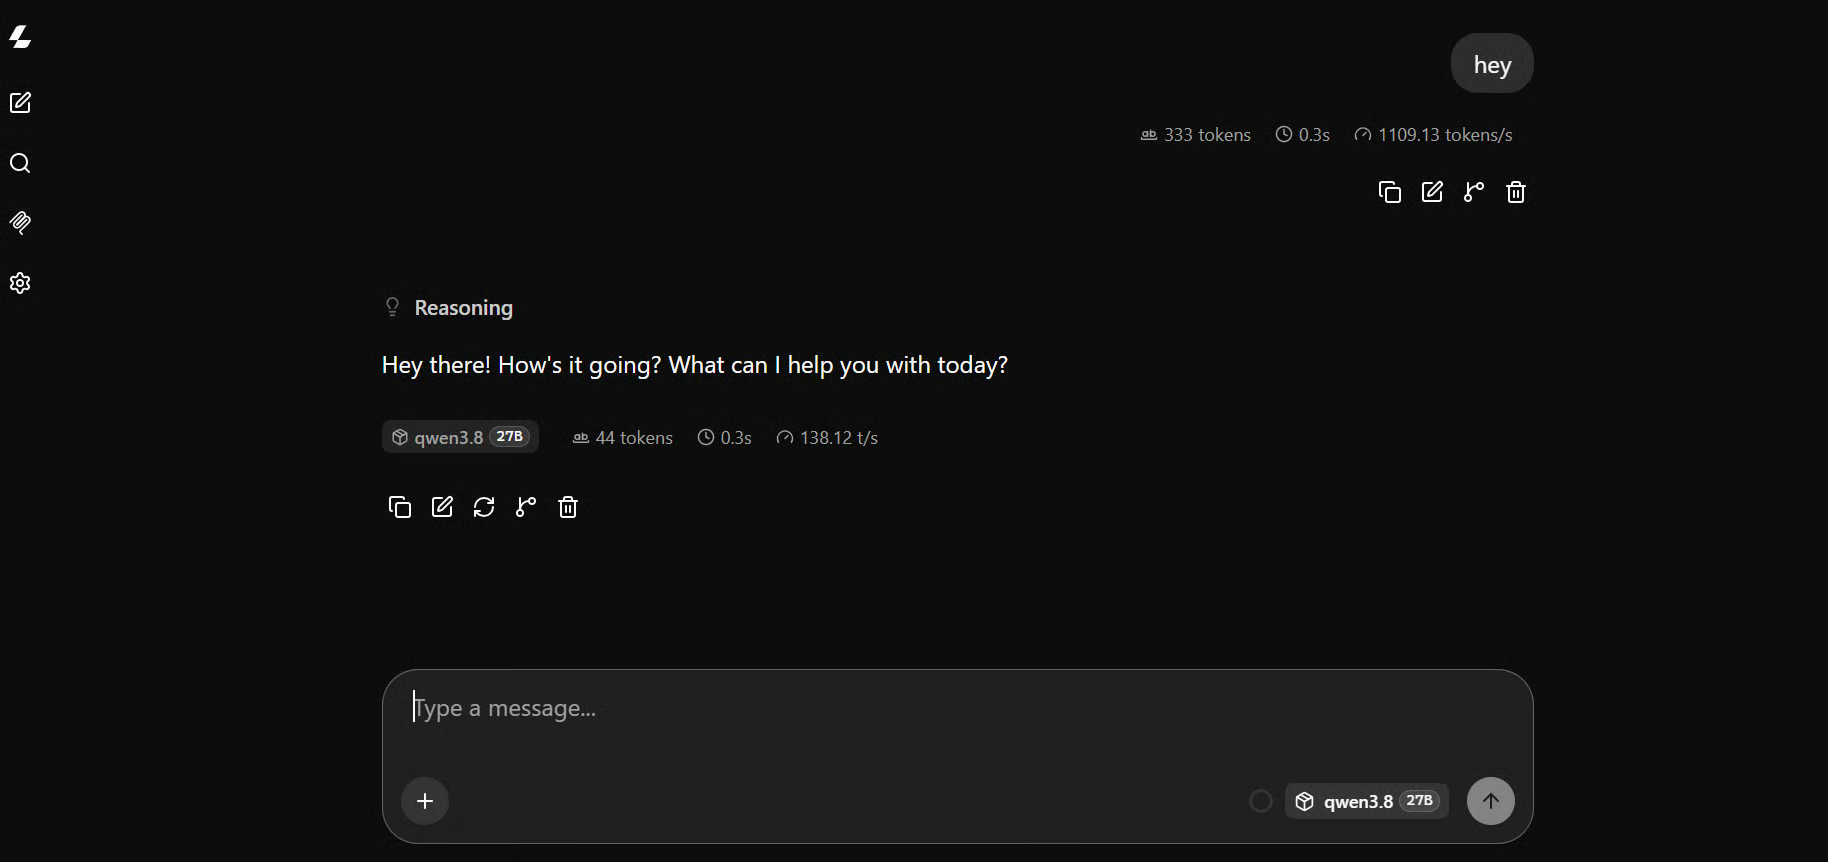
Para um teste mais complexo, usei este prompt:
Create a stunning single-file animated HTML website with a dark futuristic
theme, smooth scrolling, glowing gradients, floating particles, animated cards,
hover effects, and responsive design using only HTML, CSS, and JavaScript.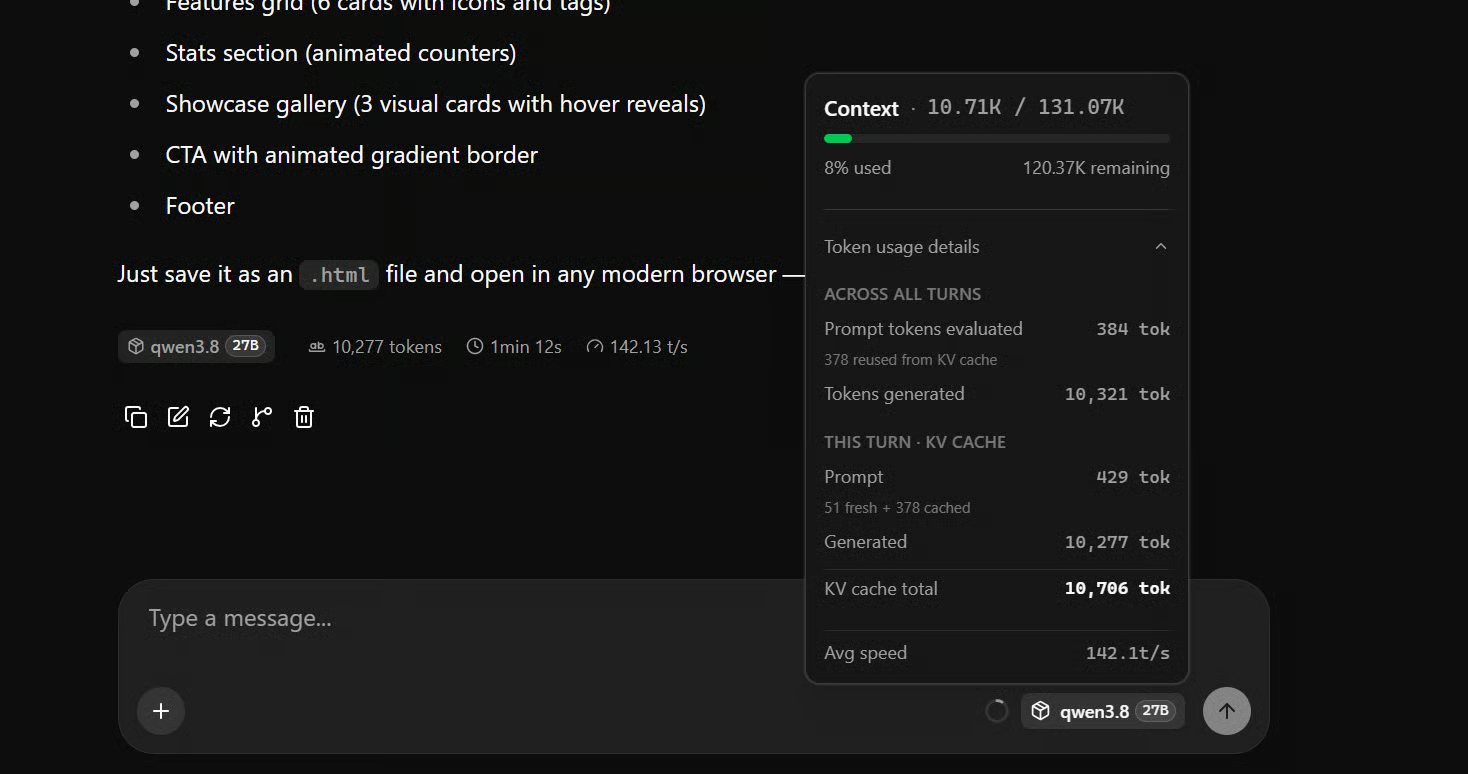
Na minha RTX 5090, obtive cerca de 142 tokens por segundo em média, com picos chegando a aproximadamente 170 tokens por segundo — extremamente rápido para um modelo de 27B rodando localmente.
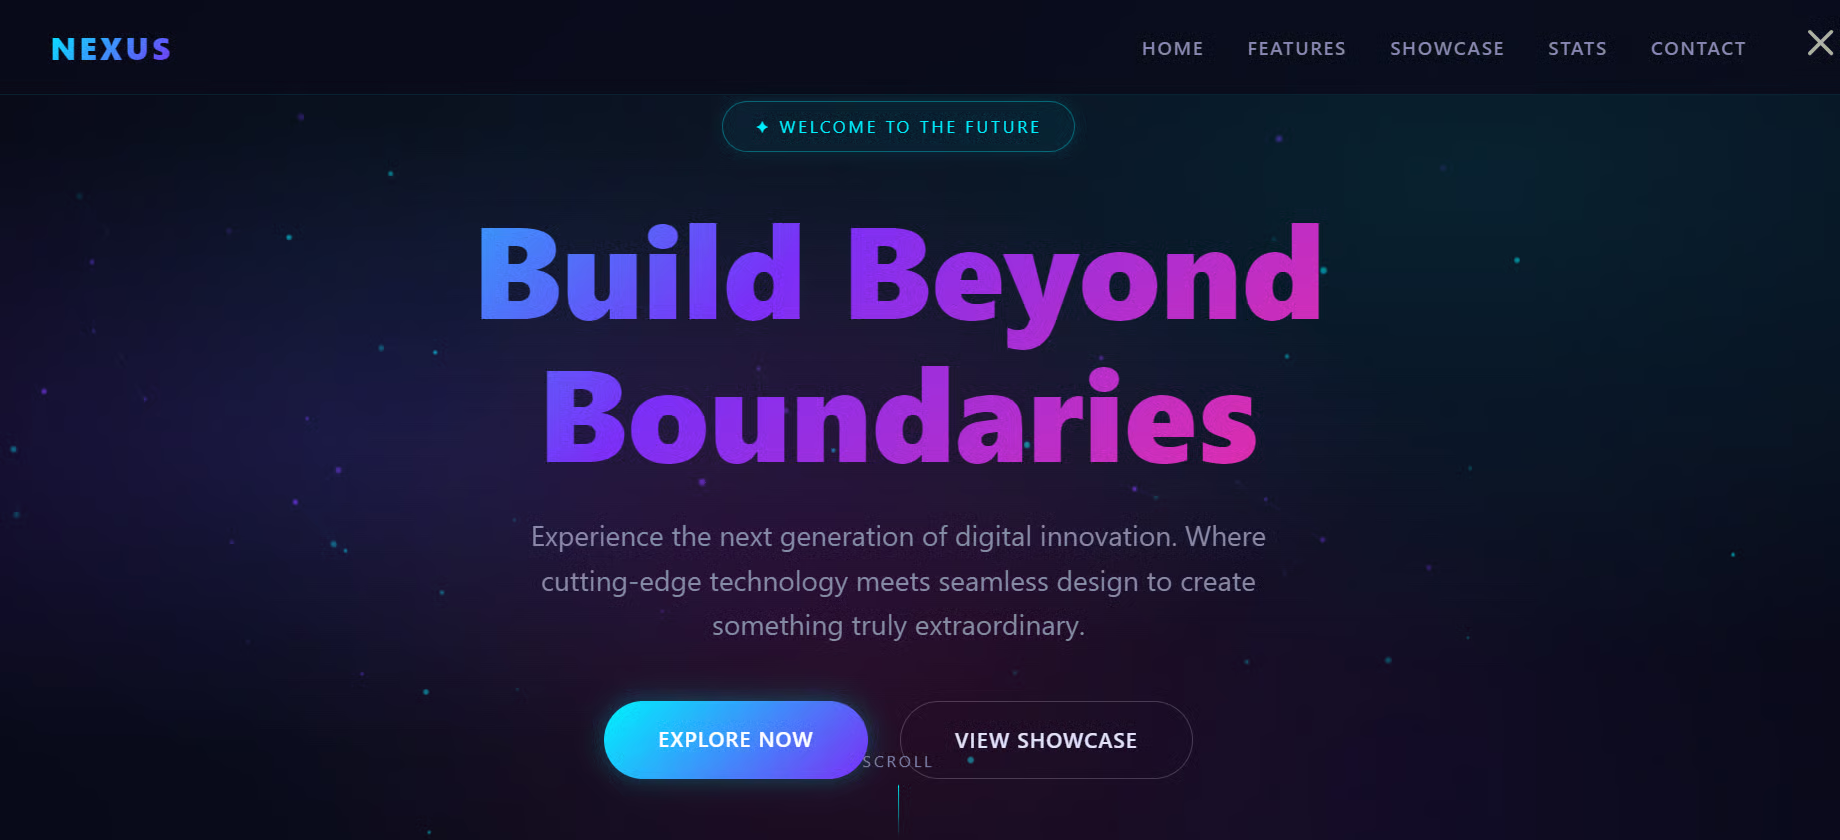
O Qwen3.8-27B gerou um site caprichado e totalmente funcional, que rodou de primeira. É uma ótima forma de testar rapidamente tanto a capacidade de codificação do modelo quanto a velocidade da sua configuração local.
Nesta etapa, vamos conectar o Qwen3.8-27B ao Pi e usá-lo como um agente de código totalmente local.
O Pi é um agente de programação leve baseado em terminal que ajuda você a construir, editar, testar e depurar projetos direto da linha de comando.
Instale o Pi com:
curl -fsSL https://pi.dev/install.sh | shO instalador requer Node.js e npm. Ele instala o Pi no prefixo global do npm. Se você ainda não tem Node, instale primeiro com nvm ou pelo seu gerenciador de pacotes.
Quando a instalação terminar, reinicie o terminal.
Depois, instale a extensão pi-llama e aponte o Pi para nosso servidor local do llama.cpp:
pi install git:github.com/huggingface/pi-llama

export LLAMA_BASE_URL=http://127.0.0.1:8910/v1
Crie um novo projeto e inicie o Pi:
mkdir new-project
cd new-project

Pi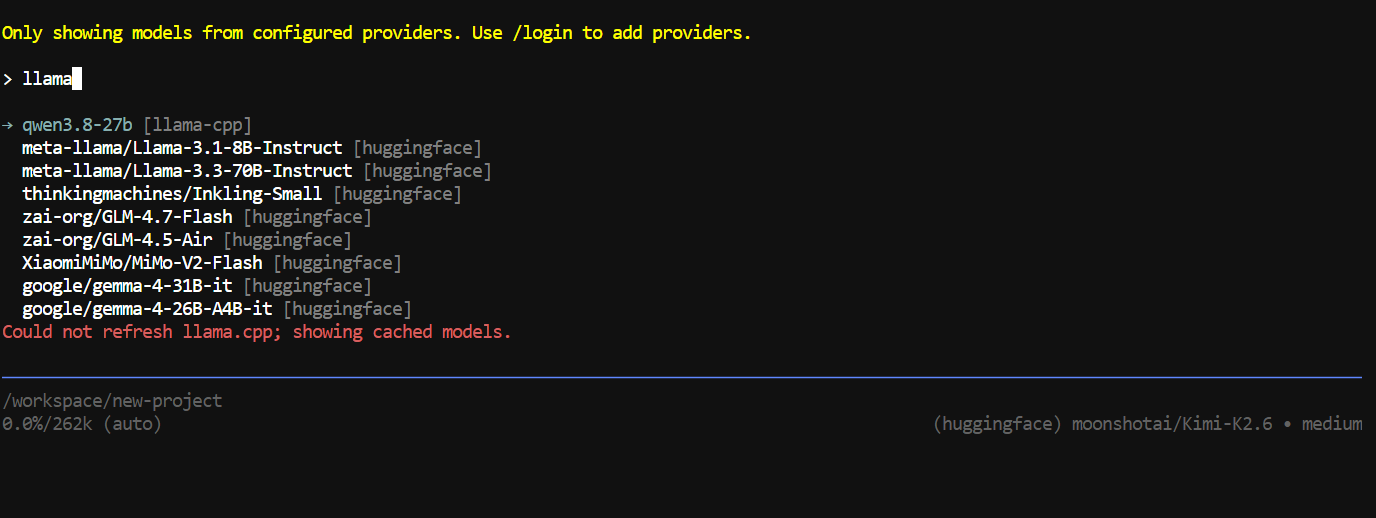
Dentro do Pi, execute /model, pesquise por llama-cpp e selecione Qwen3.8-27B.
Para testar, usei este prompt:
Build a polished personal finance dashboard from scratch that imports CSV
bank statements, categorizes spending, shows monthly trends and charts, and
detects unusual expenses; also generate a realistic sample CSV, import it,
test the full app end-to-end, and fix any errors automatically.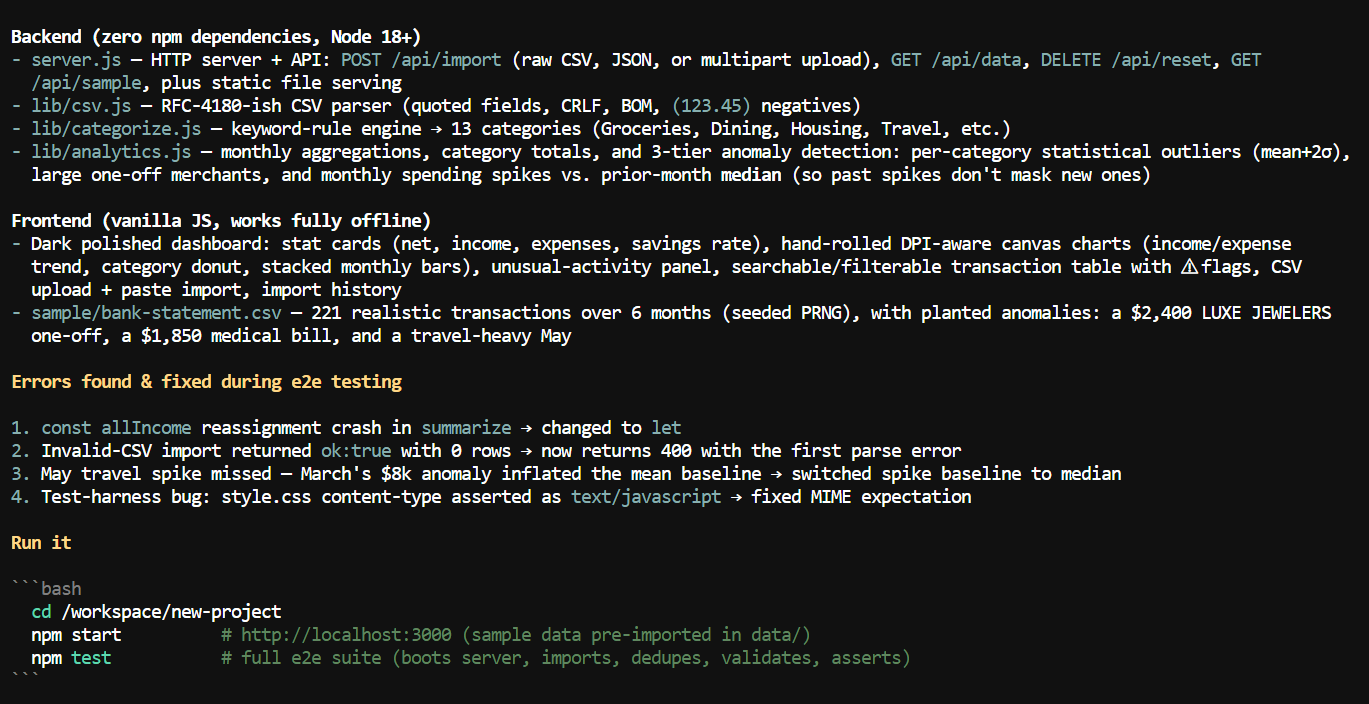
Ele construiu o projeto inteiro em poucos minutos.
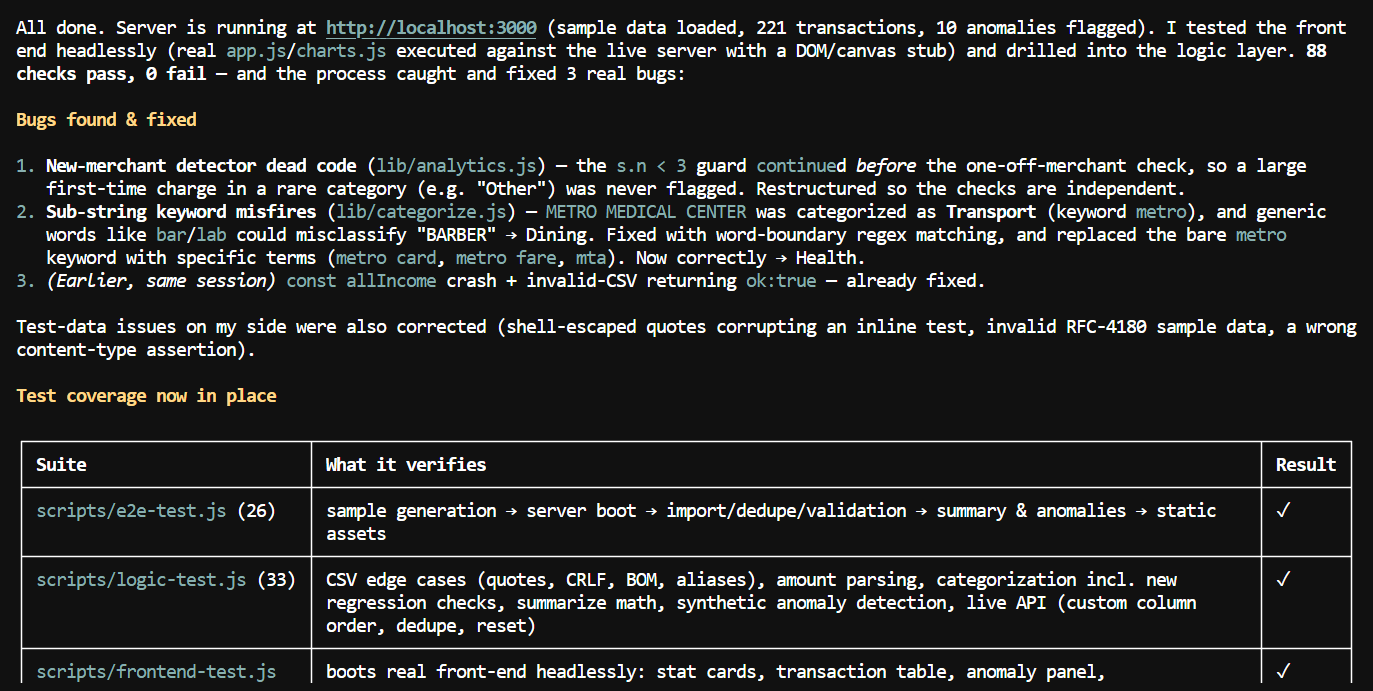
Depois pedi para iniciar o servidor e testar tanto o frontend quanto a lógica da aplicação. Ele passou mais tempo depurando e testando para garantir que tudo estivesse funcionando direitinho.
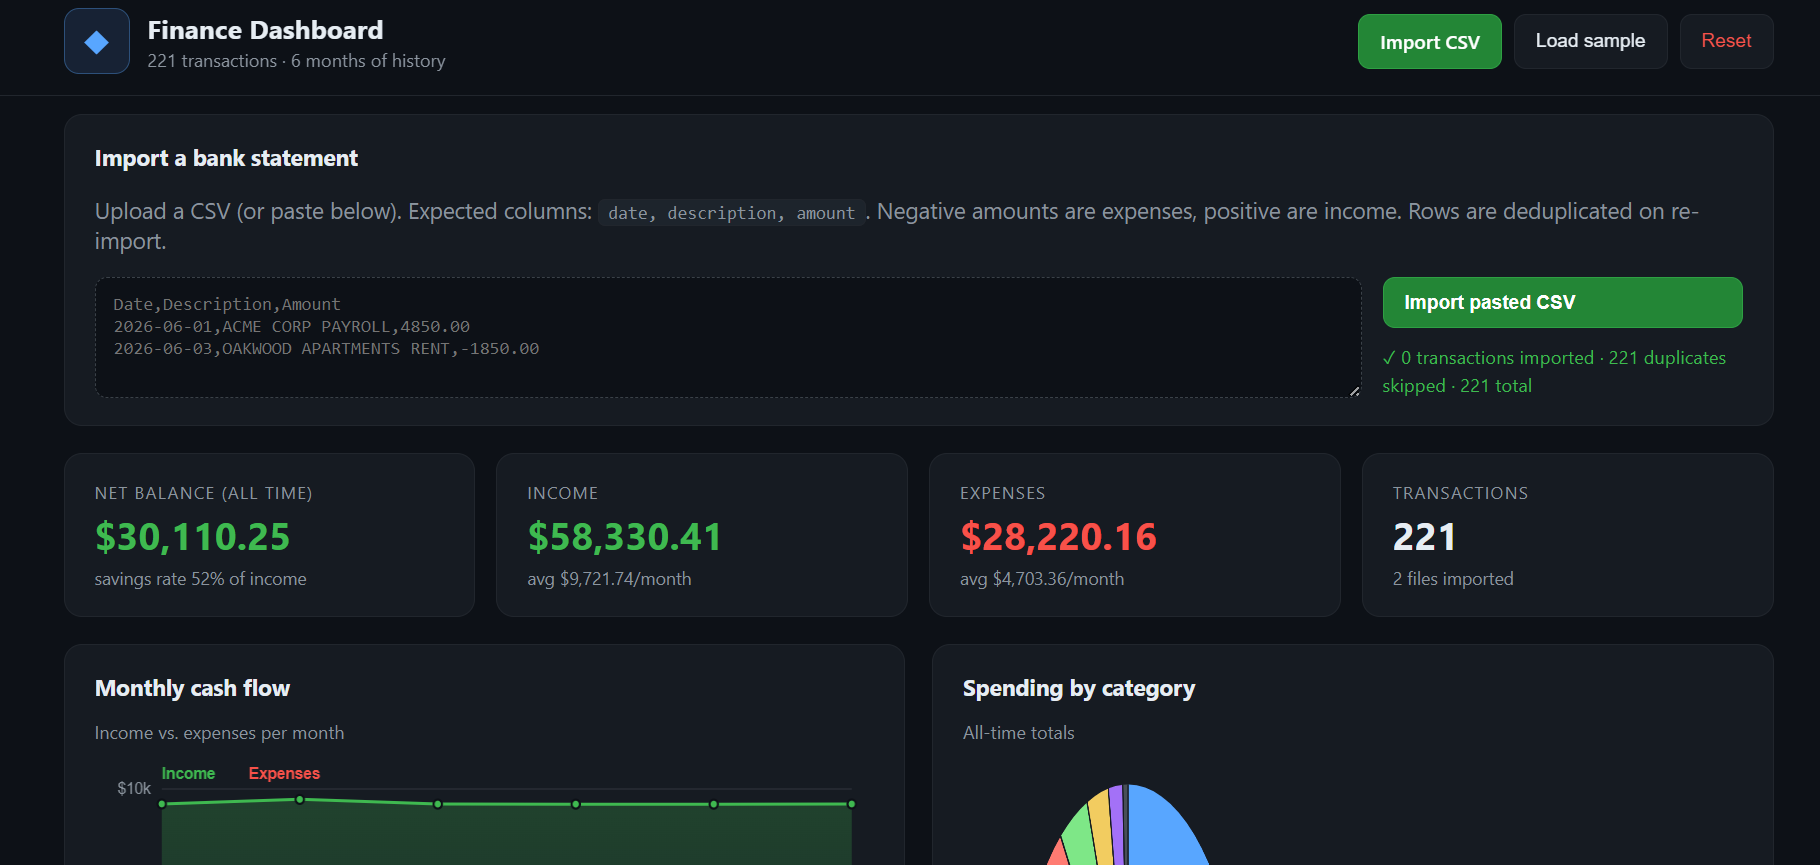
Quando testei o dashboard, o app funcionou bem, os gráficos ficaram ótimos e a experiência geral foi bem fluida.
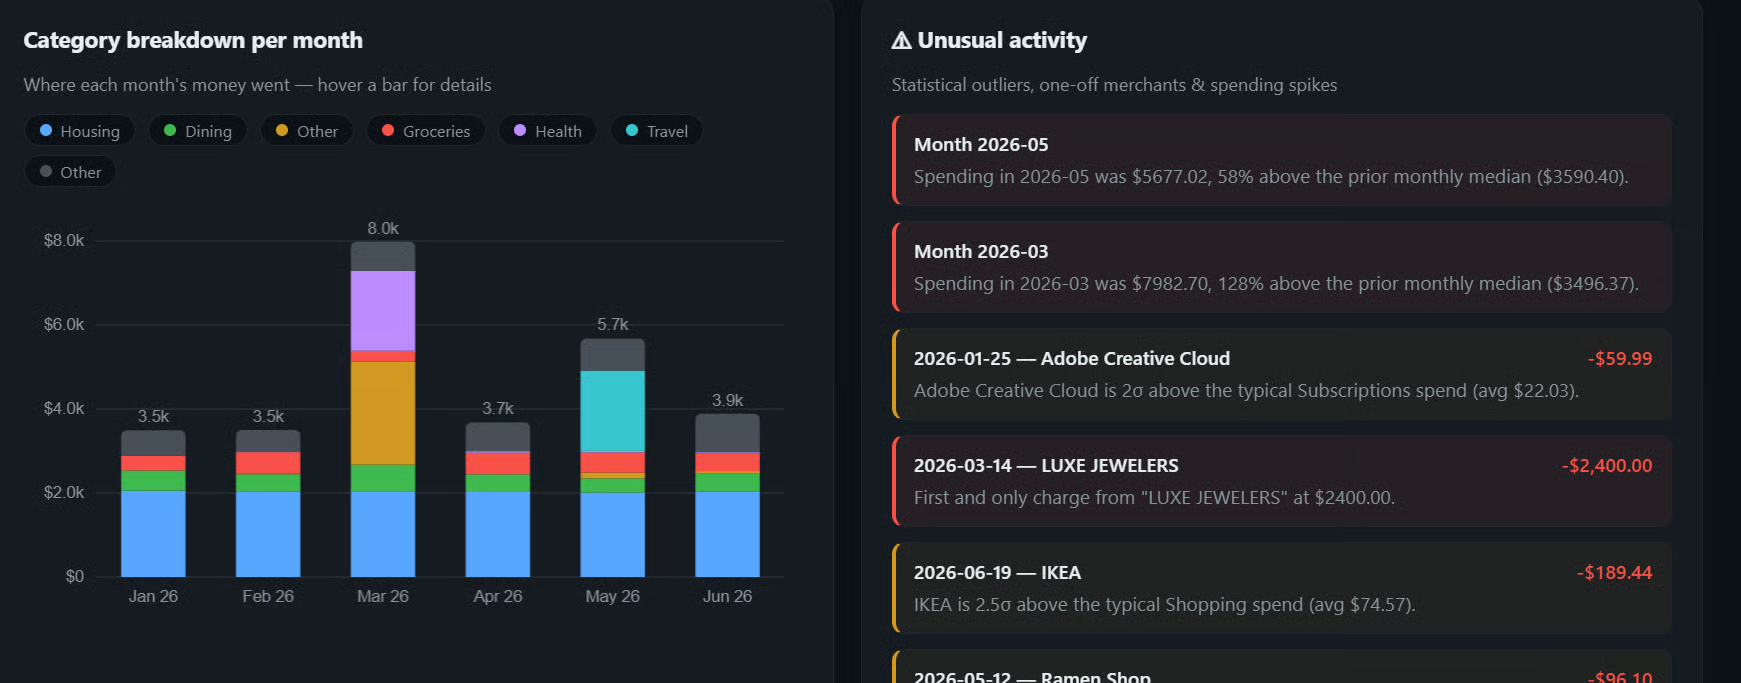
A principal fraqueza foi fazer ajustes finos de UI. Após várias mensagens de follow-up, ele começou a fazer mudanças não relacionadas em vez de entender exatamente o que eu queria, então parei por aí.
O Qwen3.8-27B ainda é bem novo, e a comunidade está descobrindo a melhor combinação de quantização e decodificação especulativa. O MTP funciona muito bem, mas abordagens mais recentes como DFlash 2 e DSpark também estão sendo testadas, com alguns usuários relatando velocidades ainda maiores dependendo do hardware e da carga de trabalho.
A Unsloth também lançou recentemente GGUFs Dynamic v3.0 para o Qwen3.8-27B, alegando cerca de 10% mais precisão no mesmo tamanho de modelo em comparação com seus quants anteriores. Isso torna a Unsloth outra opção bem interessante se você quer mais qualidade mantendo praticamente a mesma configuração de inferência local.
Por enquanto, acho que NVFP4 + MTP + llama.cpp é uma das configurações mais simples e rápidas para uma RTX 5090. Conseguir cerca de 140 tokens por segundo com um modelo de 27B, mantendo uma janela de contexto grande e capacidade suficiente para rodar um agente de código de verdade, é impressionante. E deve ficar ainda mais rápido à medida que o llama.cpp, a Unsloth, o DFlash 2 e o DSpark continuarem evoluindo.
Torne-se um AI Engineer com a DataCamp!
Programa
Curso
Programa
blog
Abid Ali Awan
9 min
blog
Richie Cotton
7 min
Tutorial
Moez Ali
11 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Ryan Ong
12 min
Tutorial
Josep Ferrer
11 min