Трек
Ассоциированный AI-инженер для разработчиков
26 ч
Сначала убедимся, что GPU корректно определяется, и проверим версию драйвера NVIDIA и CUDA.
nvidia-smi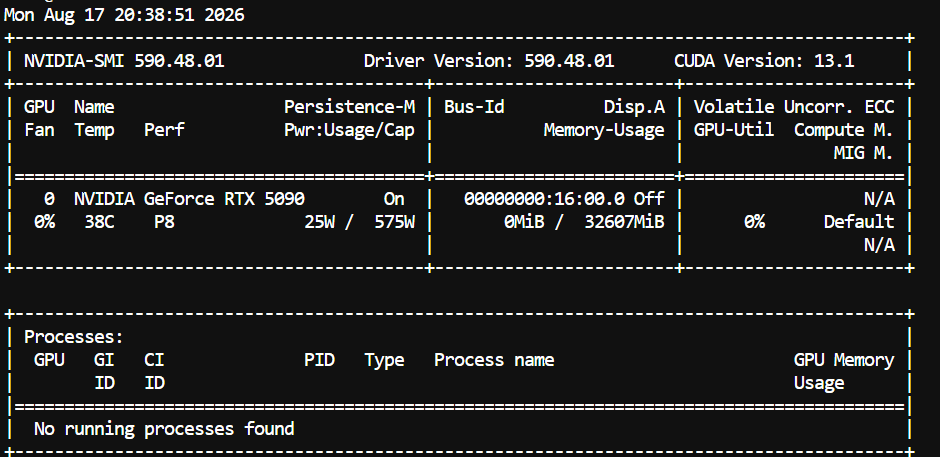
Вы должны увидеть свою RTX 5090, версию драйвера, версию CUDA, объём памяти GPU и текущее использование GPU.
Примечание: эта настройка предназначена специально для GPU NVIDIA Blackwell, таких как RTX 5090. Сборка ниже нацелена на SM120 — вычислительную архитектуру, используемую в RTX 5090.
Далее мы скачаем и скомпилируем последнюю версию llama.cpp с поддержкой CUDA.
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp

cmake -B build \
  -DGGML_CUDA=ON \
  -DCMAKE_CUDA_ARCHITECTURES=120

cmake --build build --config Release -j$(nproc)
Здесь важно -DCMAKE_CUDA_ARCHITECTURES=120. Это указывает llama.cpp собираться специально под архитектуру Blackwell, используемую RTX 5090.
Когда сборка завершится, сделаем llama-server доступным глобально, чтобы можно было запускать его из любой папки:
sudo ln -sf "$(realpath ./build/bin/llama-server)" /usr/local/bin/llama-serverТеперь проверьте, что всё работает:
llama-server --versionВы должны получить вывод примерно такого вида:
version: 0.1.1-dev (build 10479, commit 0021a77de)
built with GNU 13.3.0 for Linux x86_64
Вот и всё. У нас есть сборка llama.cpp с поддержкой CUDA, которая сможет использовать преимущества RTX 5090 и нативной поддержки Blackwell NVFP4.
Теперь загрузим модель Qwen3.8-27B.
Сначала установите Hugging Face CLI:
pip install -U huggingface_hubСоздайте папку для модели:
mkdir -p /workspace/models/qwen38Затем скачайте NVFP4-MTP GGUF:
hf download felippeburk/Qwen3.8-27B-NVFP4-MTP-GGUF \
  --local-dir /workspace/models/qwen38
Это нужная версия для нашей конфигурации, поскольку она использует NVFP4 и включает поддержку MTP — за счёт этого на RTX 5090 достигается значительное ускорение.
Теперь самое интересное. Мы поднимем Qwen3.8-27B полностью на GPU с Flash Attention, окном контекста 131K (context window) и MTP-спекулятивным декодированием для более быстрой генерации.
Выполните:
cd /workspace/llama.cpp

llama-server \
  -m /workspace/models/qwen38/qwen3.8-27b-text-nvfp4-mtp.gguf \
  --alias qwen3.8-27b \
  --host 0.0.0.0 \
  --port 8910 \
  --ctx-size 131072 \
  --n-gpu-layers all \
  --flash-attn on \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --parallel 1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 4 \
  --spec-draft-p-min 0.75 \
  --spec-draft-ngl all \
  --spec-draft-type-k q8_0 \
  --spec-draft-type-v q8_0 \
  --reasoning-effort medium \
  --jinja
Параметров здесь много, но большинство из них нужны просто для максимальной производительности 5090.
Ключевые параметры:
--ctx-size 131072 даёт окно контекста примерно 131K.
--n-gpu-layers all удерживает модель на GPU.
--flash-attn on включает Flash Attention.
--cache-type-k q8_0 и --cache-type-v q8_0 помогают снизить потребление памяти KV-кэшем.
--spec-type draft-mtp включает MTP-спекулятивное декодирование в Qwen3.8.
--spec-draft-n-max 4 управляет числом спекулятивных токенов, которые MTP может предлагать за раз.
В этой конфигурации мы используем n-max 4 как отправную точку для RTX 5090. Можно поэкспериментировать со значениями 2 (которое рекомендует карточка модели для этого GGUF) или 3 — самое быстрое значение может немного варьироваться в зависимости от вашей системы.
После того как llama-server завершит загрузку модели, Qwen3.8 будет доступна локально по адресу http://127.0.0.1:8910.
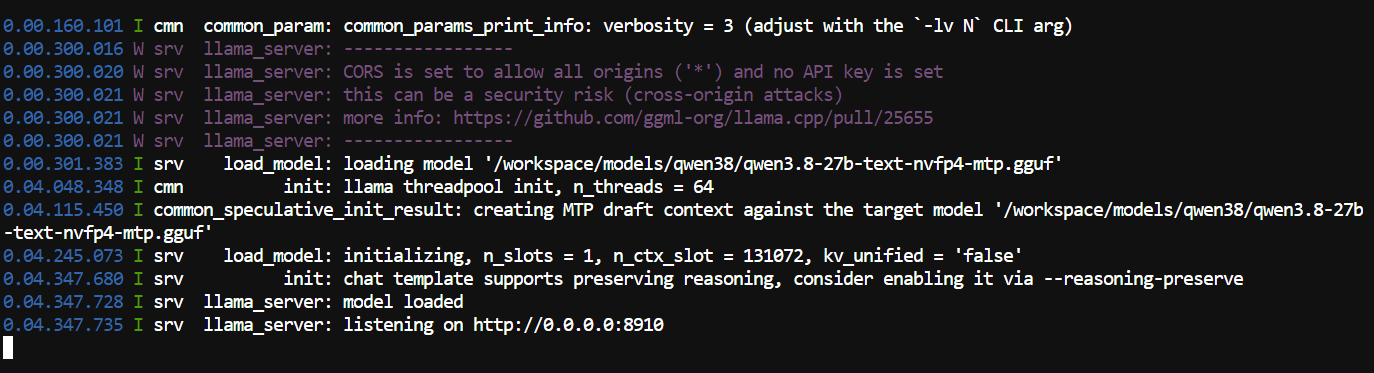
Теперь у нас локально запущена Qwen3.8-27B. Далее протестируем модель через API и встроенный браузерный интерфейс.
Пока сервер работает, откройте другой терминал и отправьте тестовый запрос в API, совместимый с OpenAI:
curl http://127.0.0.1:8910/v1/chat/completions \
 -H "Content-Type: application/json" \
 -d '{
   "model": "qwen3.8-27b",
   "messages": [
     {
       "role": "user",
       "content": "Write a Python FastAPI application that monitors GPU usage."
     }
   ],
   "max_tokens": 2000
 }'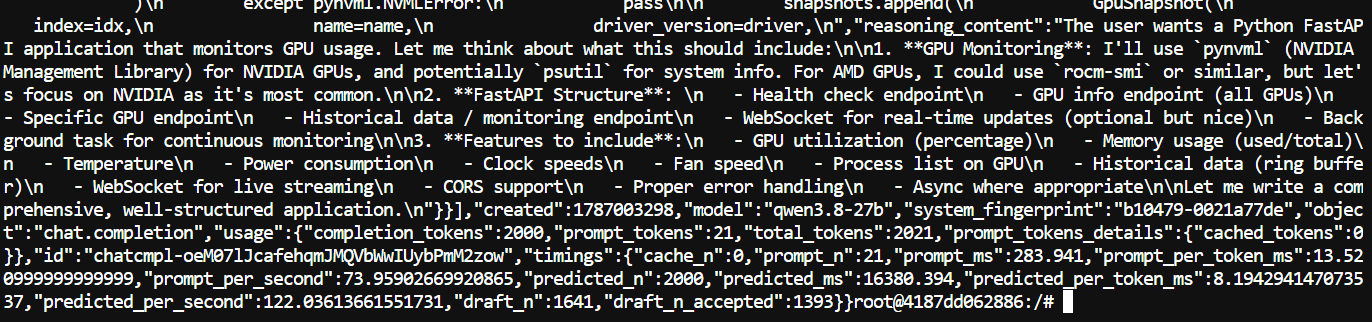
В этом тесте Qwen3.8-27B сгенерировала 2 000 токенов со скоростью 122 токена/с при впечатляющем уровне принятия MTP 84,9%.
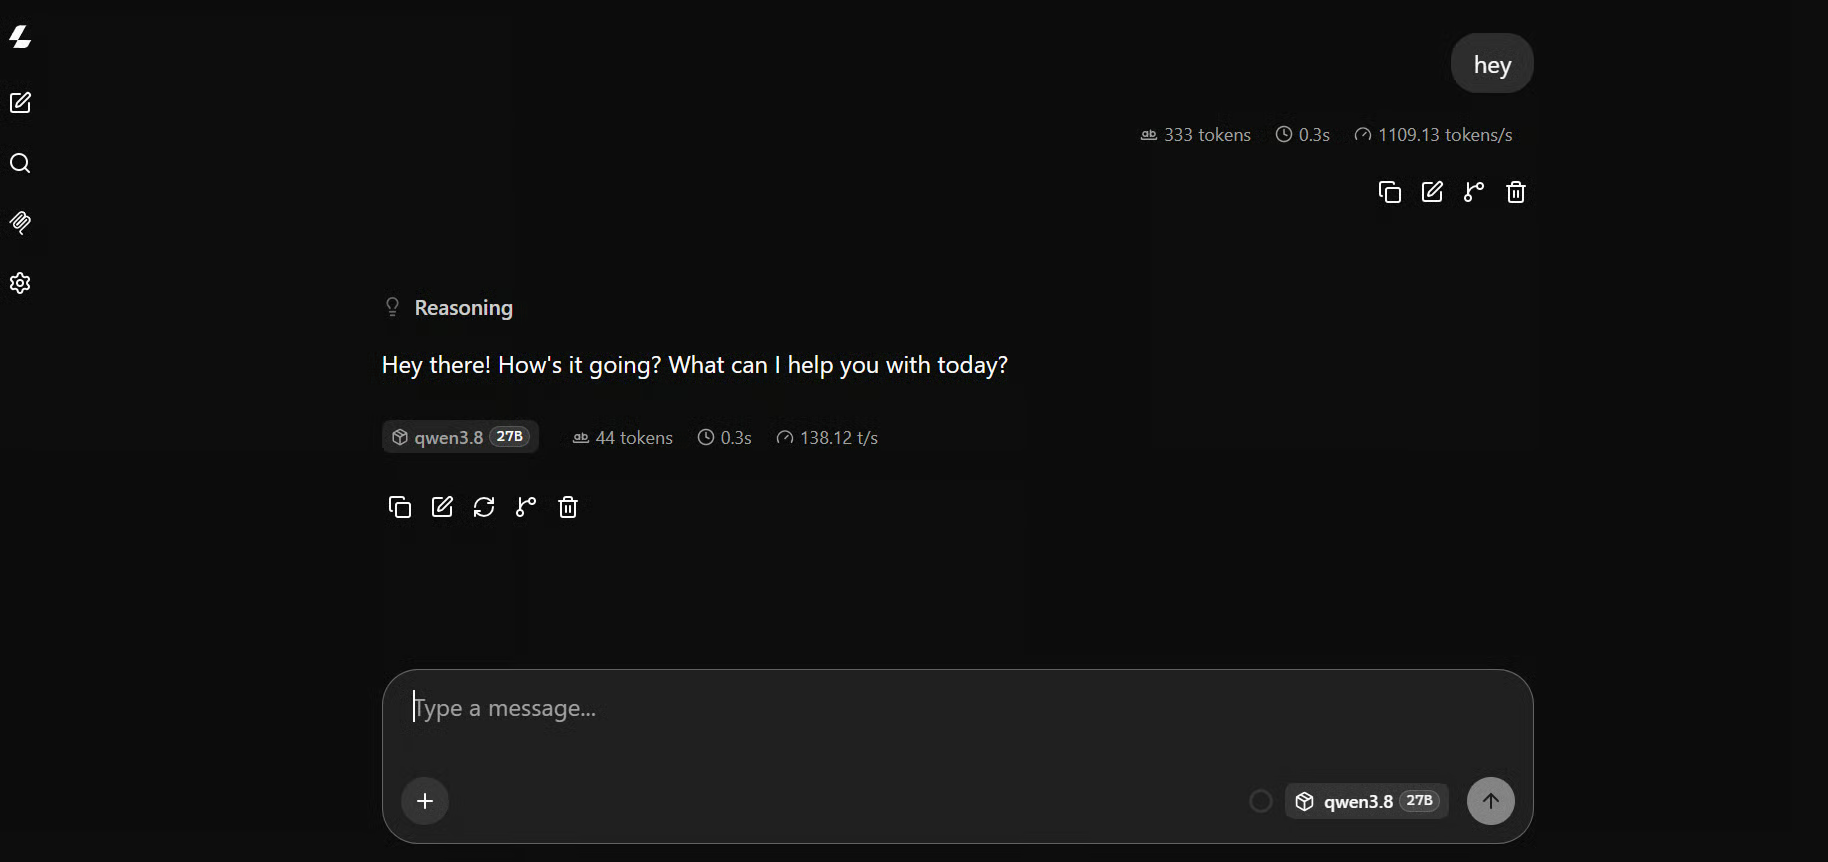
В llama.cpp также есть браузерный интерфейс, так что можно протестировать модель без использования API.
Откройте http://127.0.0.1:8910 в браузере, чтобы увидеть интерфейс.
Для более сложного теста я использовал такой промпт:
Create a stunning single-file animated HTML website with a dark futuristic
theme, smooth scrolling, glowing gradients, floating particles, animated cards,
hover effects, and responsive design using only HTML, CSS, and JavaScript.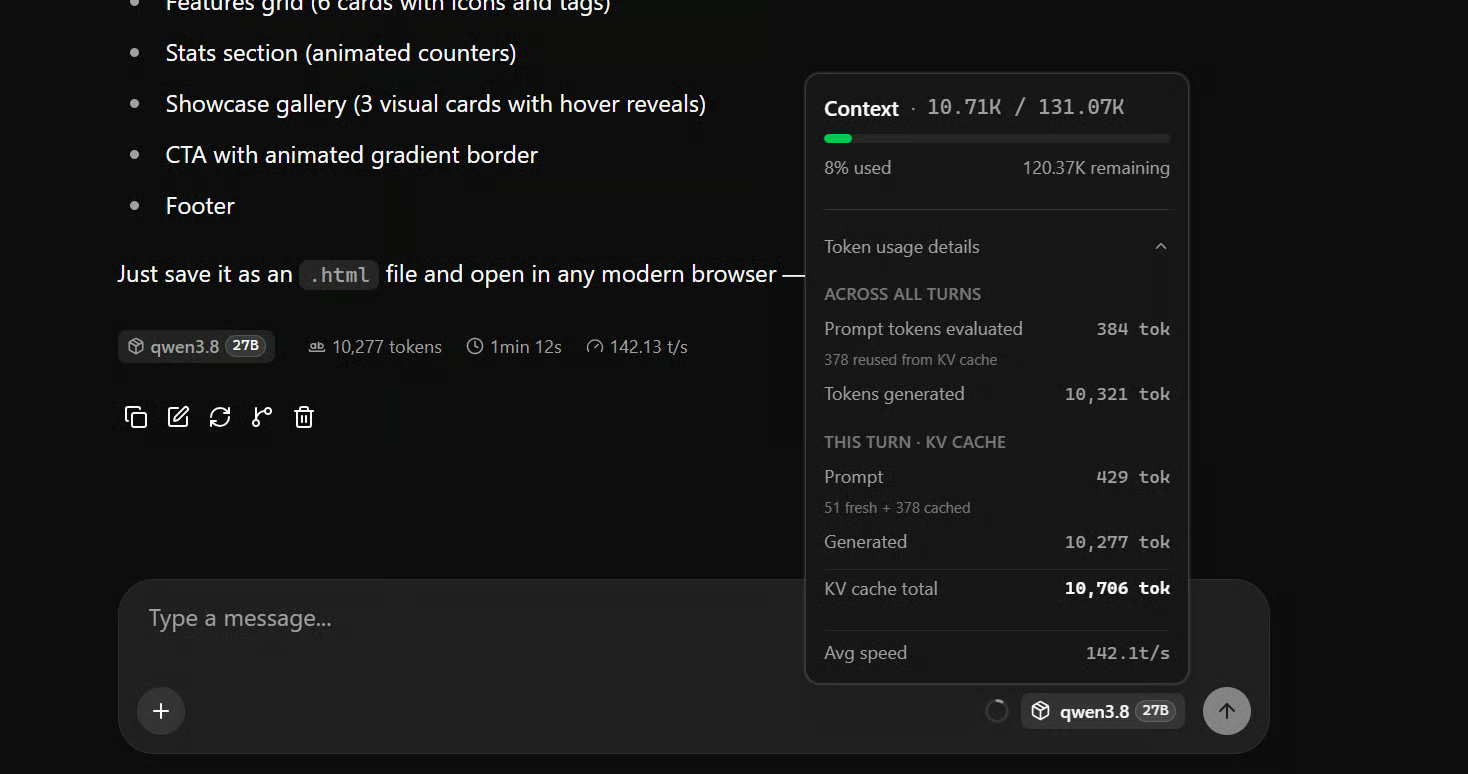
На моей RTX 5090 средняя скорость составляла около 142 токенов в секунду, а местами генерация достигала примерно 170 токенов в секунду — это крайне быстро для локально запущенной модели на 27B.
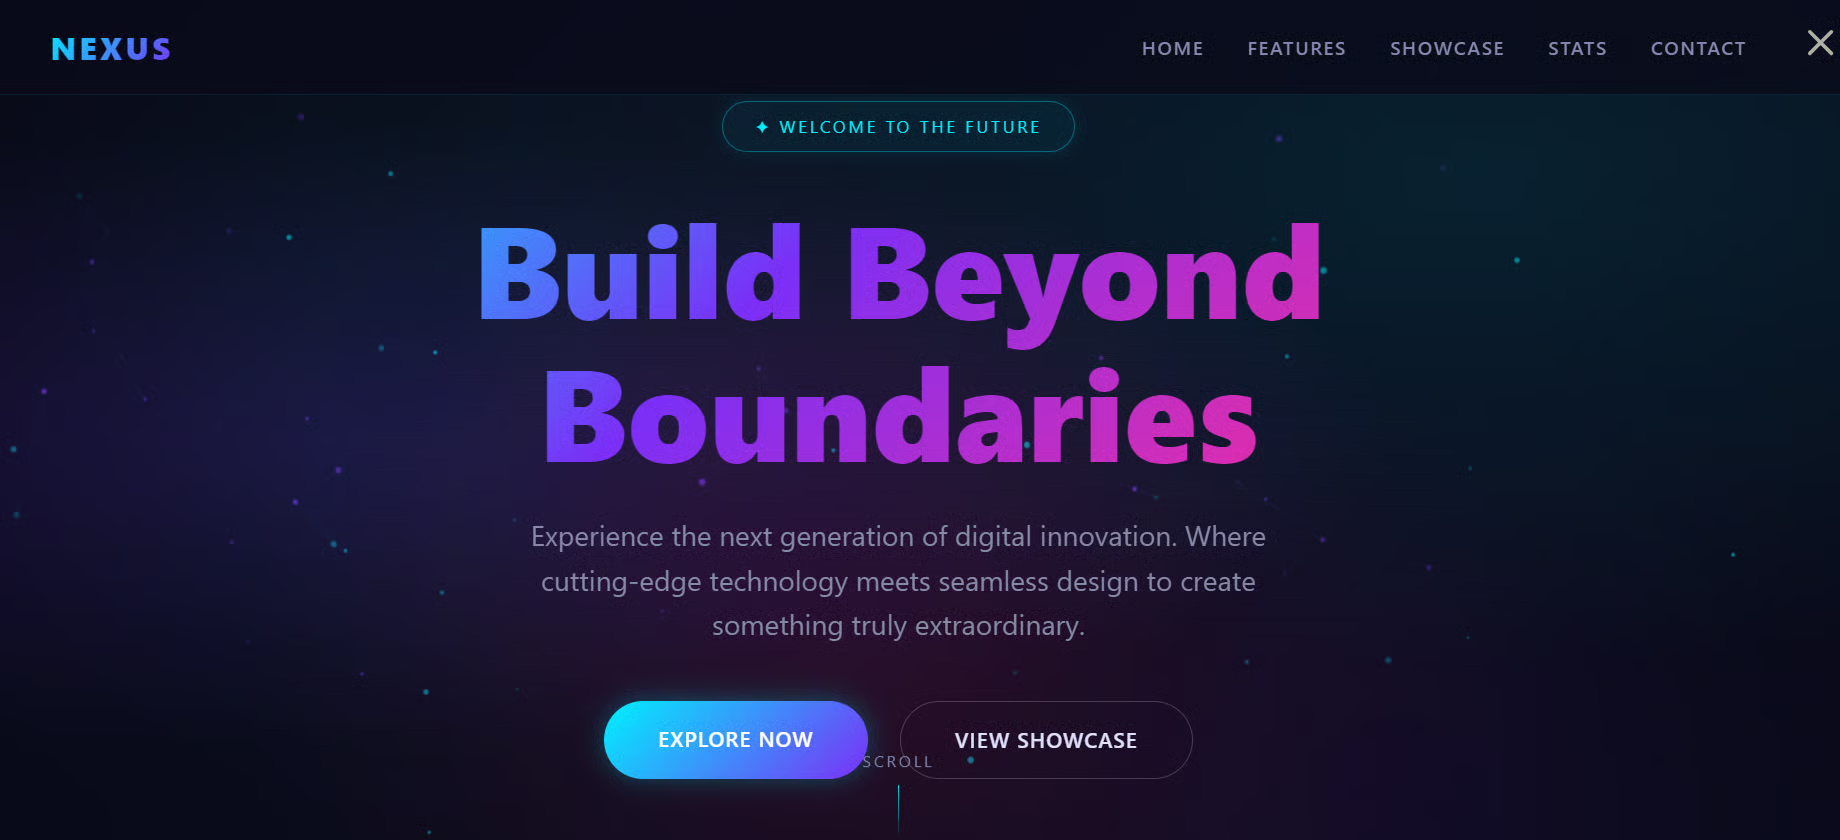
Qwen3.8-27B сгенерировала аккуратный, полностью рабочий сайт, который заработал «из коробки». Это хороший способ быстро проверить и способности модели в кодинге, и скорость локальной конфигурации.
В этом разделе мы подключим Qwen3.8-27B к Pi и используем её как полностью локального кодового агента.
Pi — это лёгкий терминальный агент для кодинга, который помогает собирать, редактировать, тестировать и отлаживать проекты прямо из командной строки.
Установите Pi с помощью:
curl -fsSL https://pi.dev/install.sh | shУстановщику требуются Node.js и npm. Он устанавливает Pi в глобальный префикс npm. Если Node ещё нет, сначала установите его через nvm или ваш менеджер пакетов.
После завершения установки перезапустите терминал.
Далее установите расширение pi-llama и укажите Pi наш локальный сервер llama.cpp:
pi install git:github.com/huggingface/pi-llama

export LLAMA_BASE_URL=http://127.0.0.1:8910/v1
Создайте новый проект и запустите Pi:
mkdir new-project
cd new-project

Pi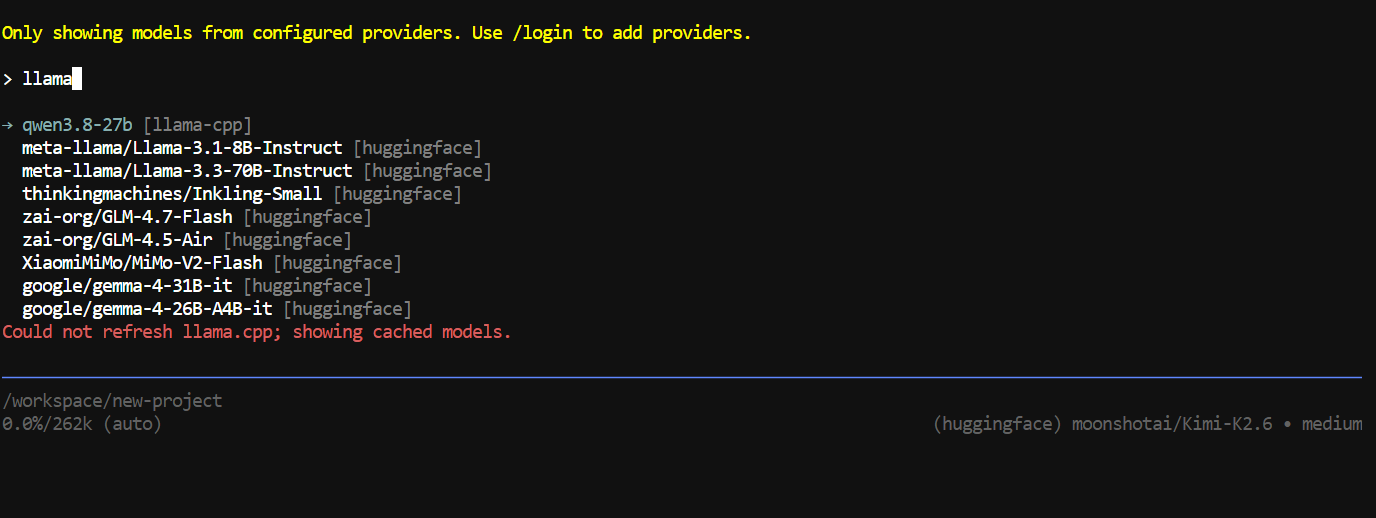
Внутри Pi выполните /model, найдите llama-cpp и выберите Qwen3.8-27B.
Для теста я дал такой промпт:
Build a polished personal finance dashboard from scratch that imports CSV
bank statements, categorizes spending, shows monthly trends and charts, and
detects unusual expenses; also generate a realistic sample CSV, import it,
test the full app end-to-end, and fix any errors automatically.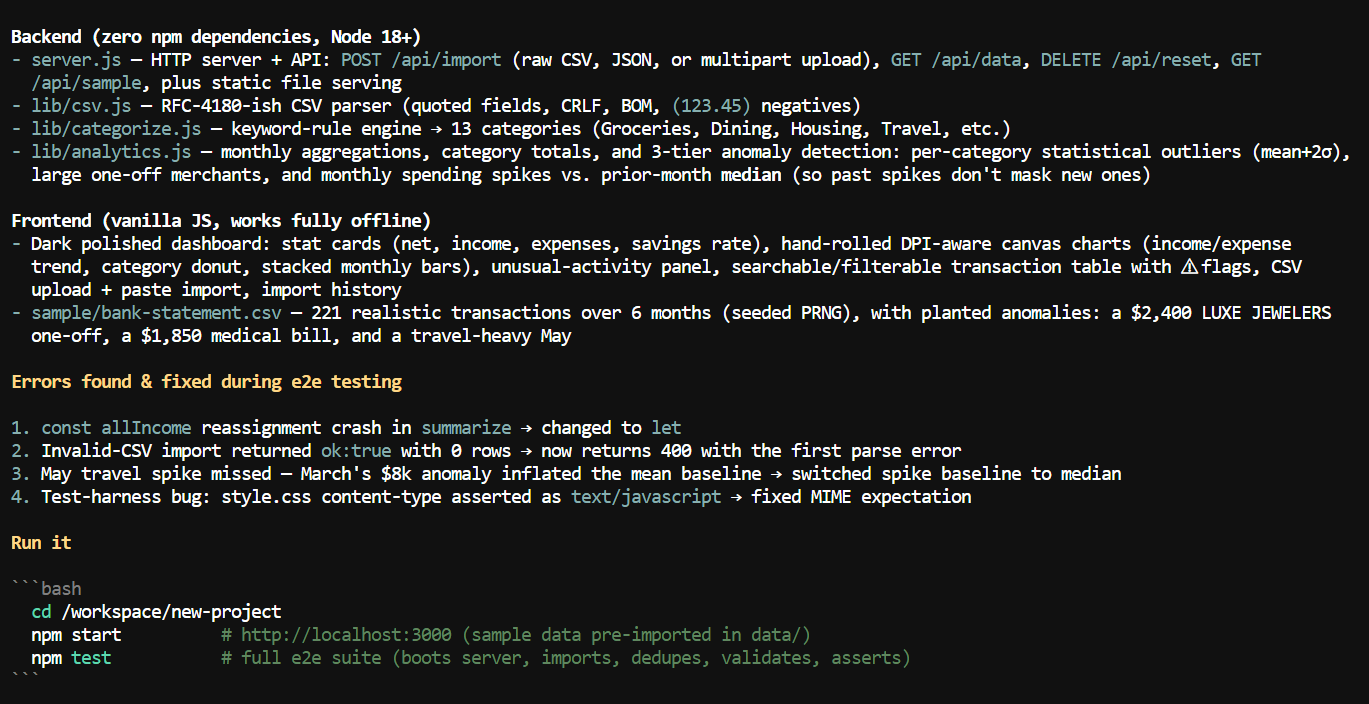
Он собрал весь проект за несколько минут.
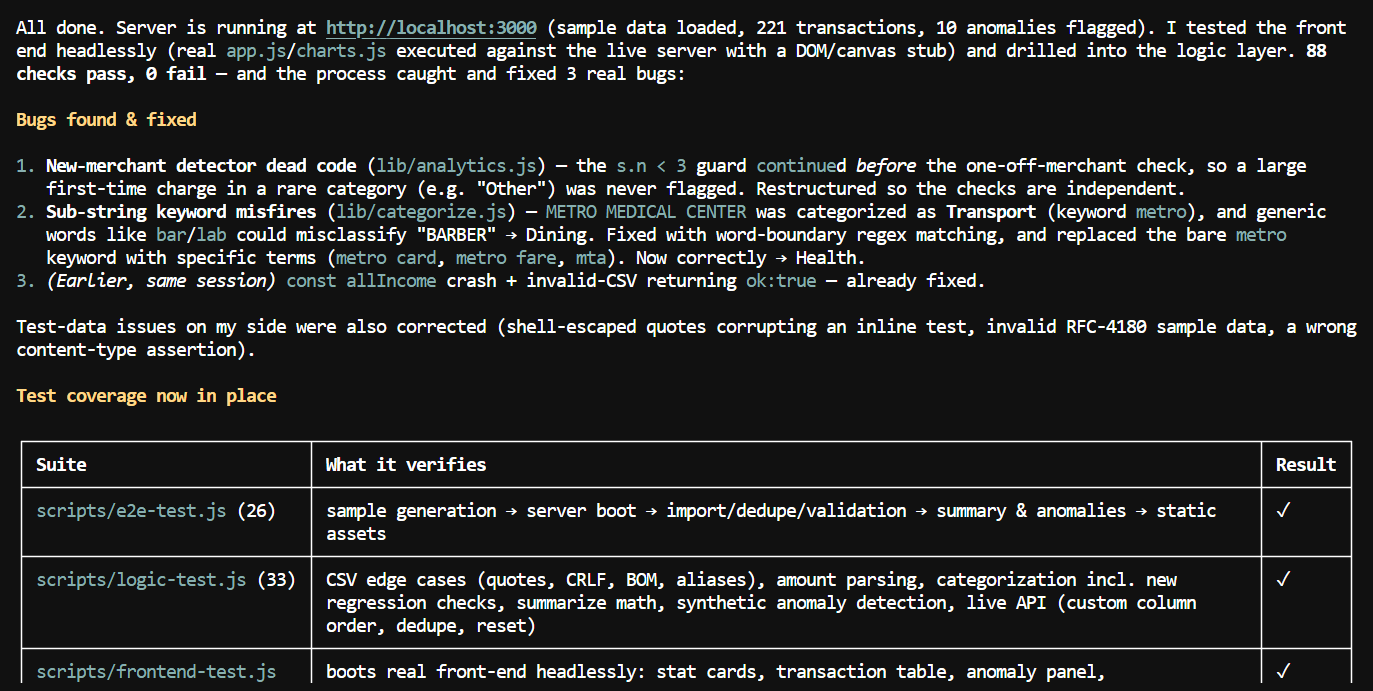
Затем я попросил запустить сервер и протестировать как фронтенд, так и логику приложения. Он уделил больше времени отладке и тестированию, чтобы убедиться, что всё работает корректно.
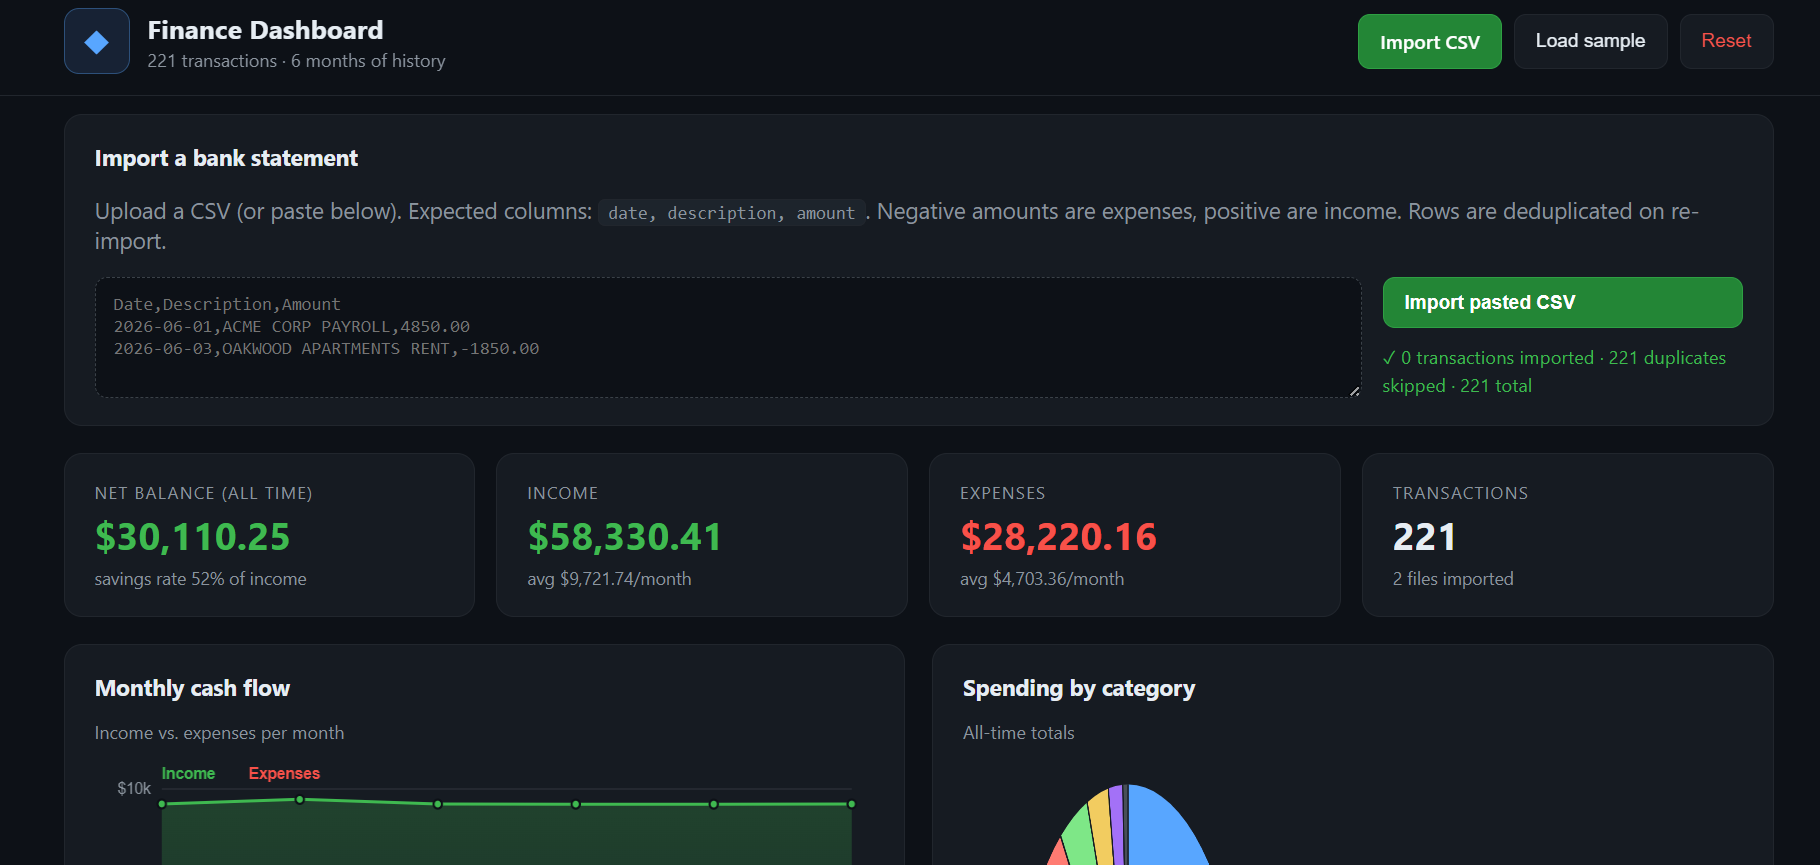
Когда я протестировал дашборд сам, приложение работало хорошо, графики выглядели отлично, а общий опыт был плавным.
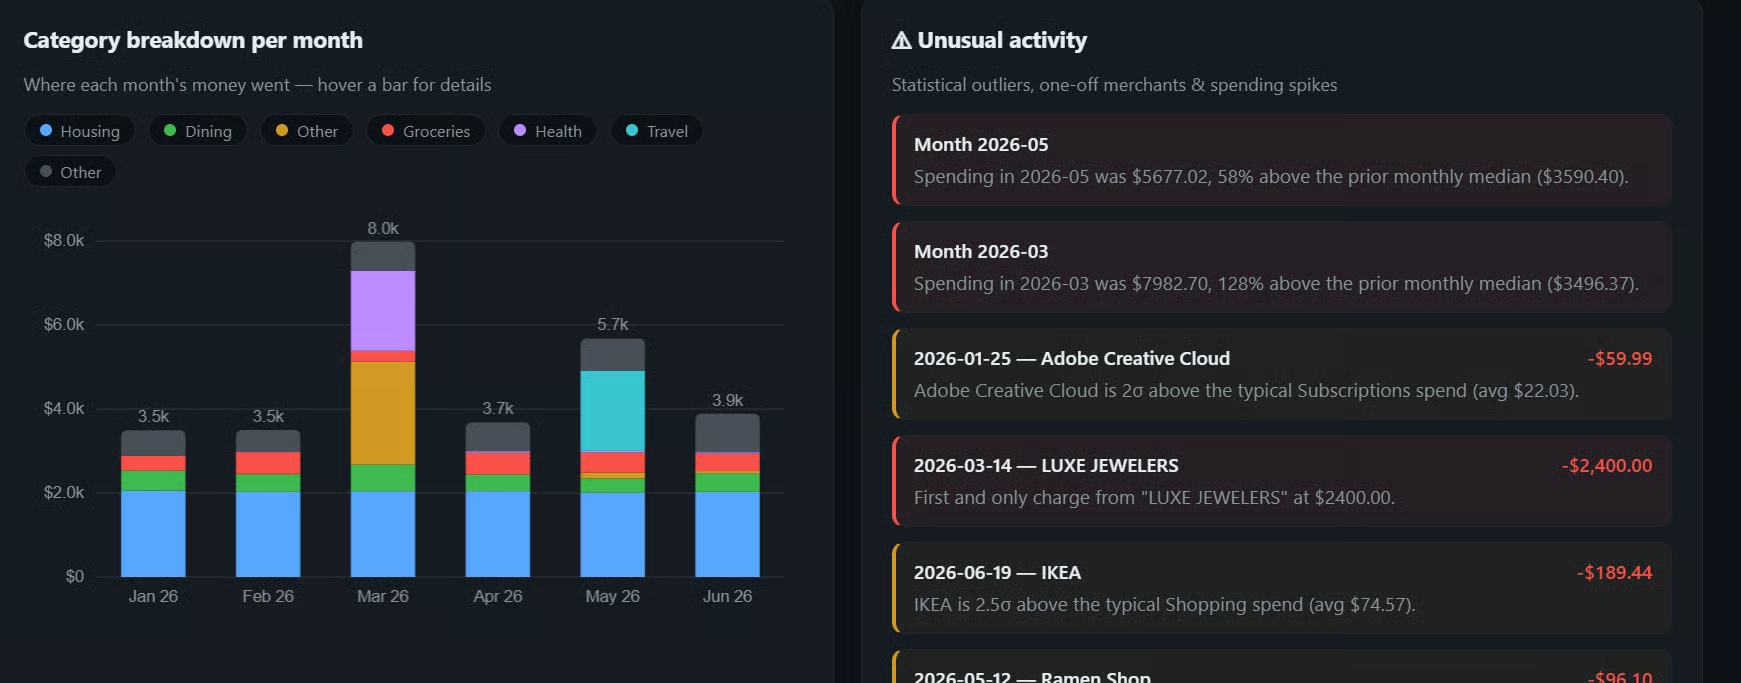
Главной слабостью оказались точечные изменения интерфейса. После нескольких уточняющих промптов он начал делать несвязанные правки вместо того, чтобы точно понять, что именно требуется, поэтому на этом я остановился.
Qwen3.8-27B всё ещё очень новая, и сообщество активно подбирает лучшую комбинацию квантизации и спекулятивного декодирования. MTP работает крайне хорошо, но также тестируются новые подходы, такие как DFlash 2 и DSpark — некоторые пользователи сообщают о ещё более высоких скоростях в зависимости от «железа» и нагрузки.
Unsloth также выпустили Dynamic v3.0 GGUF для Qwen3.8-27B, заявляя примерно на 10% более высокую точность при том же размере модели по сравнению с предыдущими квантами. Это делает Unsloth ещё одной очень интересной опцией, если вам нужна лучшая точность при примерно той же локальной схеме инференса.
Пока что NVFP4 + MTP + llama.cpp — один из самых простых и быстрых вариантов для RTX 5090. Получать около 140 токенов в секунду от модели на 27B, сохраняя при этом большое окно контекста и достаточные возможности для запуска реального агентa кодирования, впечатляет. Вероятно, конфигурация станет ещё быстрее по мере развития llama.cpp, Unsloth, DFlash 2 и DSpark.
Станьте AI Engineer вместе с DataCamp!
Трек
Курс
Трек