लर्निंग पाथ
डेवलपर्स के लिए एसोसिएट AI इंजीनियर
26 घंटा
सबसे पहले, हम सुनिश्चित करेंगे कि GPU सही से डिटेक्ट हो रहा है और NVIDIA ड्राइवर व CUDA वर्ज़न जाँचेंगे।
nvidia-smi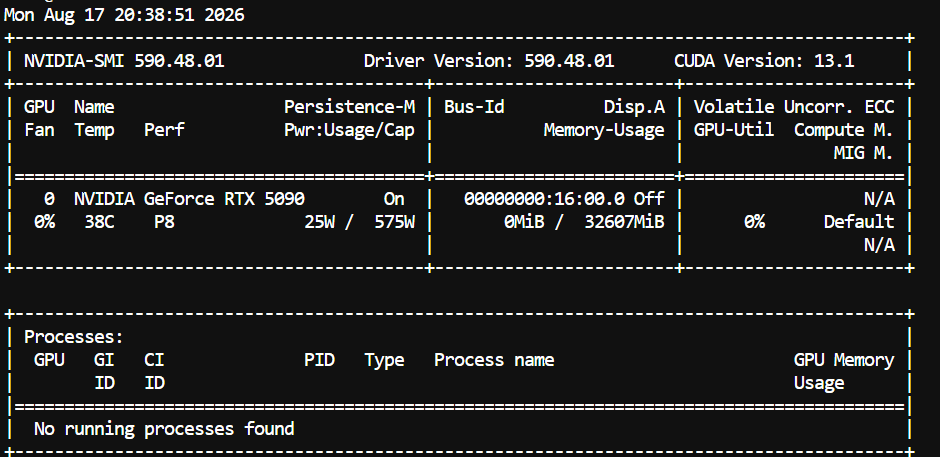
आपको अपना RTX 5090, ड्राइवर वर्ज़न, CUDA वर्ज़न, GPU मेमोरी, और मौजूदा GPU उपयोग दिखाई देना चाहिए।
नोट: यह सेटअप विशेष रूप से NVIDIA Blackwell GPUs, जैसे RTX 5090, के लिए है। नीचे दिया गया बिल्ड SM120 को टार्गेट करता है, जो RTX 5090 द्वारा उपयोग की जाने वाली compute आर्किटेक्चर है।
अगले चरण में, हम CUDA सपोर्ट के साथ llama.cpp का नवीनतम वर्ज़न डाउनलोड और कंपाइल करेंगे।
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp

cmake -B build \
  -DGGML_CUDA=ON \
  -DCMAKE_CUDA_ARCHITECTURES=120

cmake --build build --config Release -j$(nproc)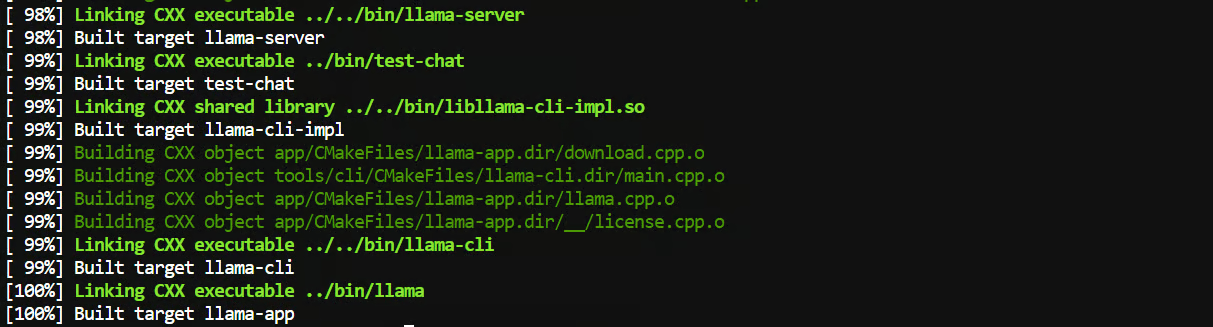
यहाँ महत्वपूर्ण हिस्सा है -DCMAKE_CUDA_ARCHITECTURES=120। यह llama.cpp को बताता है कि RTX 5090 में उपयोग होने वाली Blackwell आर्किटेक्चर के लिए विशेष रूप से बिल्ड करें।
बिल्ड पूरा हो जाने के बाद, हम llama-server को ग्लोबली उपलब्ध कराएँगे ताकि इसे किसी भी फ़ोल्डर से चला सकें:
sudo ln -sf "$(realpath ./build/bin/llama-server)" /usr/local/bin/llama-serverअब जाँचें कि सब कुछ काम कर रहा है:
llama-server --versionआपको कुछ इस तरह का आउटपुट मिलना चाहिए:
version: 0.1.1-dev (build 10479, commit 0021a77de)
built with GNU 13.3.0 for Linux x86_64
बस इतना ही। अब हमारे पास CUDA-सक्षम llama.cpp बिल्ड है जो RTX 5090 और उसकी नेटिव Blackwell NVFP4 सपोर्ट का लाभ उठा सकता है।
अब हम Qwen3.8-27B मॉडल डाउनलोड करेंगे।
पहले, Hugging Face CLI इंस्टॉल करें:
pip install -U huggingface_hubएक फ़ोल्डर बनाएँ जहाँ हम मॉडल रखेंगे:
mkdir -p /workspace/models/qwen38फिर NVFP4-MTP GGUF डाउनलोड करें:
hf download felippeburk/Qwen3.8-27B-NVFP4-MTP-GGUF \
  --local-dir /workspace/models/qwen38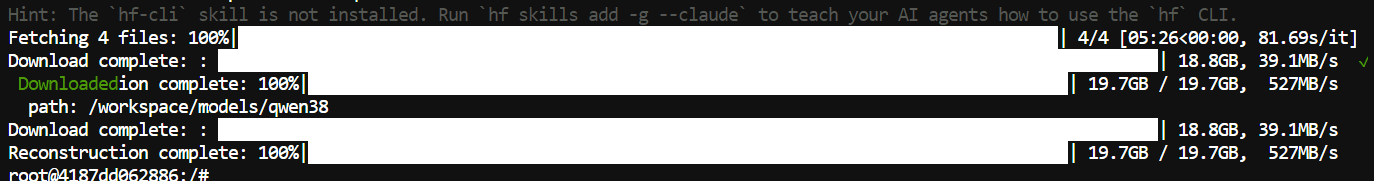
यह वही वर्ज़न है जिसकी हमें इस सेटअप के लिए ज़रूरत है, क्योंकि यह NVFP4 का उपयोग करता है और MTP सपोर्ट शामिल है—यही वह जगह है जहाँ RTX 5090 पर स्पीड में बड़ा सुधार मिलता है।
अब मज़ेदार हिस्सा आता है। हम Qwen3.8-27B को पूरी तरह GPU पर Flash Attention, 131K context window, और तेज़ जनरेशन के लिए MTP speculative decoding के साथ सर्व करेंगे।
चलाएँ:
cd /workspace/llama.cpp

llama-server \
  -m /workspace/models/qwen38/qwen3.8-27b-text-nvfp4-mtp.gguf \
  --alias qwen3.8-27b \
  --host 0.0.0.0 \
  --port 8910 \
  --ctx-size 131072 \
  --n-gpu-layers all \
  --flash-attn on \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --parallel 1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 4 \
  --spec-draft-p-min 0.75 \
  --spec-draft-ngl all \
  --spec-draft-type-k q8_0 \
  --spec-draft-type-v q8_0 \
  --reasoning-effort medium \
  --jinja
यहाँ बहुत सारे विकल्प हैं, लेकिन इनमें से अधिकांश 5090 से सर्वश्रेष्ठ प्रदर्शन निकालने के लिए ही हैं।
मुख्य विकल्प जिनके बारे में जानना ज़रूरी है:
--ctx-size 131072 हमें लगभग 131K का context window देता है।
--n-gpu-layers all मॉडल को GPU पर ही रखता है।
--flash-attn on Flash Attention सक्षम करता है।
--cache-type-k q8_0 और --cache-type-v q8_0 KV cache मेमोरी उपयोग को घटाने में मदद करते हैं।
--spec-type draft-mtp Qwen3.8 का MTP speculative decoding सक्षम करता है।
--spec-draft-n-max 4 नियंत्रित करता है कि MTP एक बार में कितने speculative टोकन जनरेट कर सकता है।
इस सेटअप के लिए, हम RTX 5090 पर शुरुआती बिंदु के रूप में n-max 4 का उपयोग कर रहे हैं। आप बाद में 2 (जिसकी इस GGUF के लिए मॉडल कार्ड सिफारिश करता है) या 3 के साथ प्रयोग कर सकते हैं, क्योंकि सबसे तेज़ सेटिंग आपके सिस्टम पर थोड़ा-बहुत भिन्न हो सकती है।
जब llama-server मॉडल लोड करना पूरा कर लेगा, तब Qwen3.8 लोकली http://127.0.0.1:8910 पर उपलब्ध होगा।
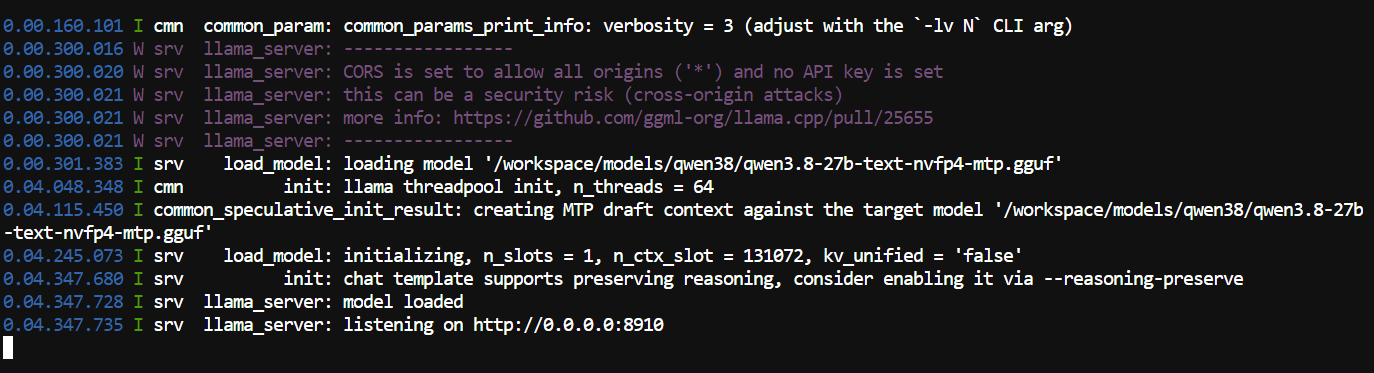
अब हमारे पास Qwen3.8-27B लोकली चल रहा है। अगला कदम है API और बिल्ट-इन ब्राउज़र इंटरफ़ेस—दोनों के जरिए मॉडल को टेस्ट करना।
सर्वर चल रहा हो तो, दूसरा टर्मिनल खोलें और OpenAI-कंपैटिबल API को एक टेस्ट रिक्वेस्ट भेजें:
curl http://127.0.0.1:8910/v1/chat/completions \
 -H "Content-Type: application/json" \
 -d '{
   "model": "qwen3.8-27b",
   "messages": [
     {
       "role": "user",
       "content": "Write a Python FastAPI application that monitors GPU usage."
     }
   ],
   "max_tokens": 2000
 }'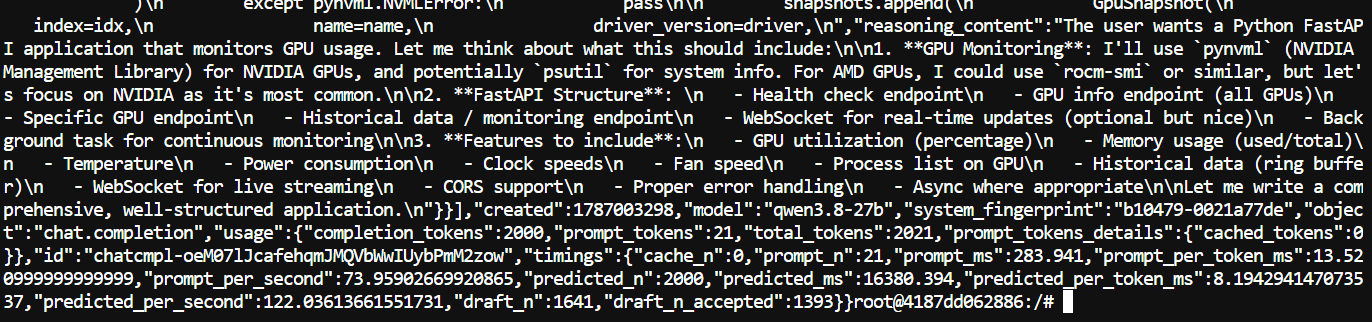
इस टेस्ट में, Qwen3.8-27B ने 2,000 टोकन 122 टोकन/सेकंड की गति से जनरेट किए, और 84.9% का प्रभावशाली MTP स्वीकृति दर मिली।
llama.cpp में एक ब्राउज़र इंटरफ़ेस भी शामिल है, जिससे आप API का उपयोग किए बिना मॉडल को टेस्ट कर सकते हैं।
UI देखने के लिए अपने ब्राउज़र में http://127.0.0.1:8910 खोलें।
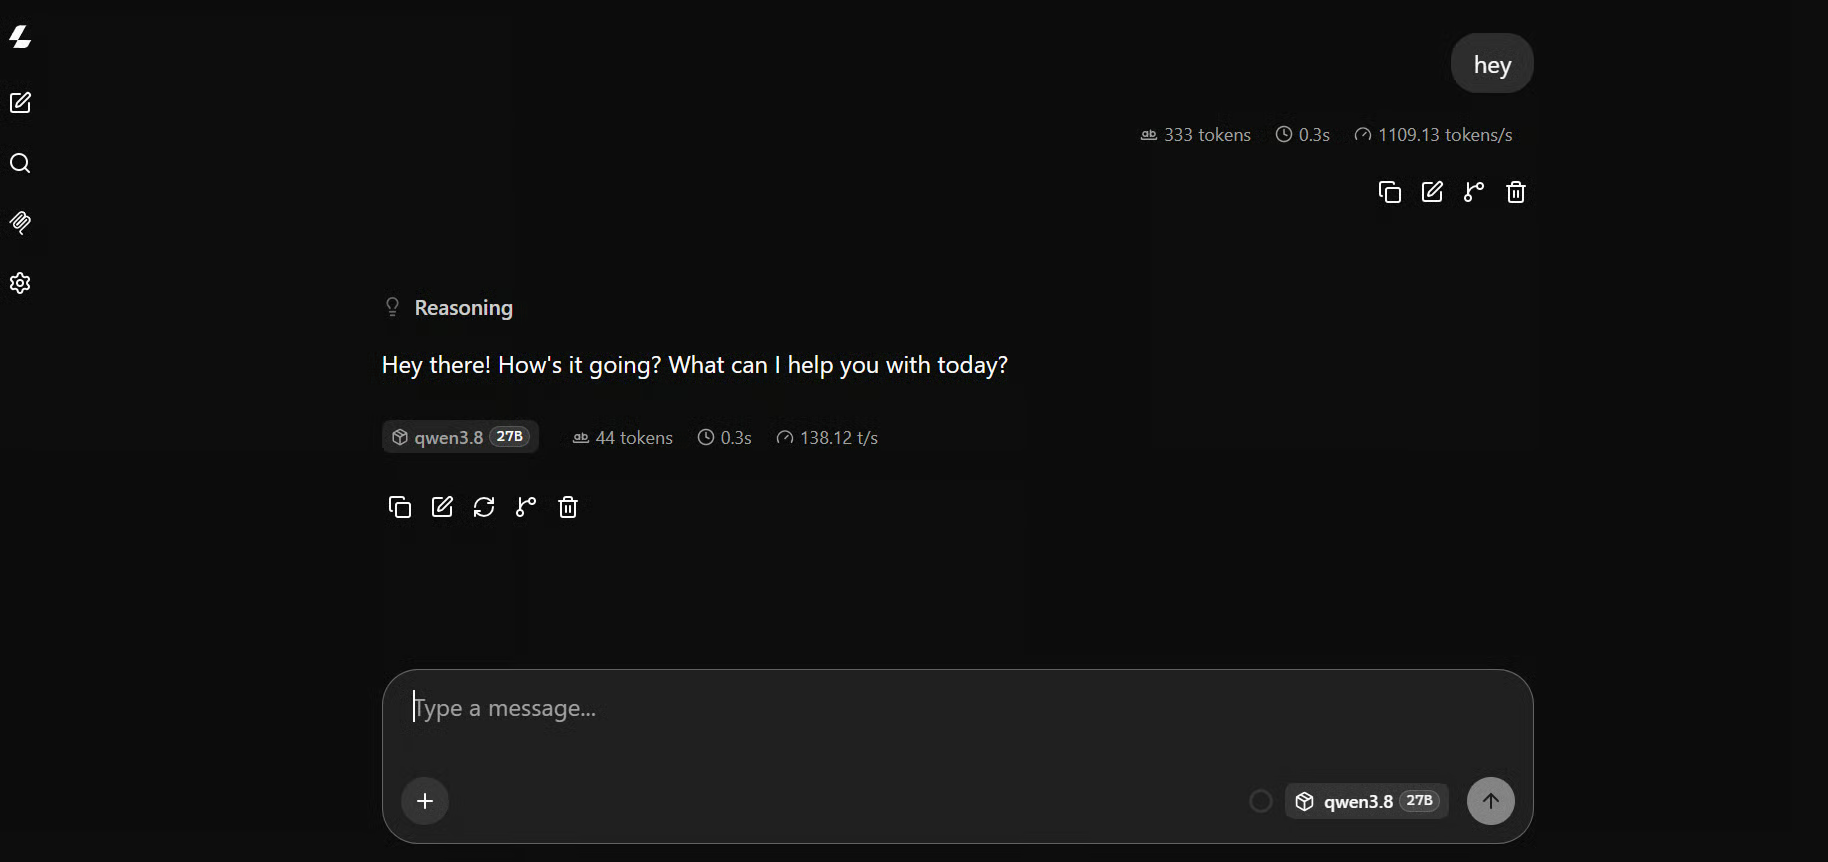
एक अधिक जटिल टेस्ट के लिए, मैंने यह प्रॉम्प्ट इस्तेमाल किया:
Create a stunning single-file animated HTML website with a dark futuristic
theme, smooth scrolling, glowing gradients, floating particles, animated cards,
hover effects, and responsive design using only HTML, CSS, and JavaScript.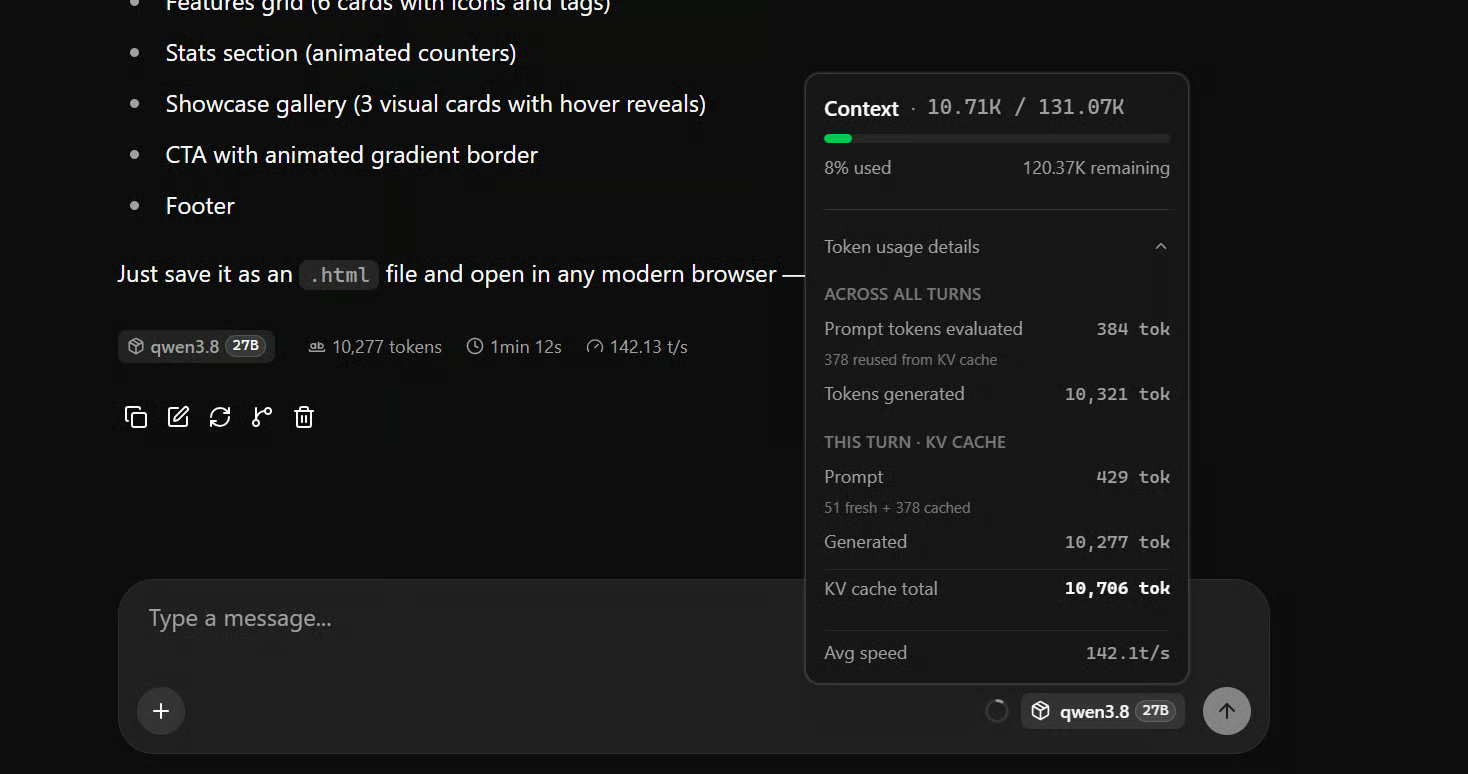
मेरे RTX 5090 पर, औसतन लगभग 142 टोकन प्रति सेकंड मिल रहे थे, और कभी-कभी जनरेशन स्पीड लगभग 170 टोकन प्रति सेकंड तक पहुँच रही थी—जो लोकली चल रहे 27B मॉडल के लिए बेहद तेज़ है।
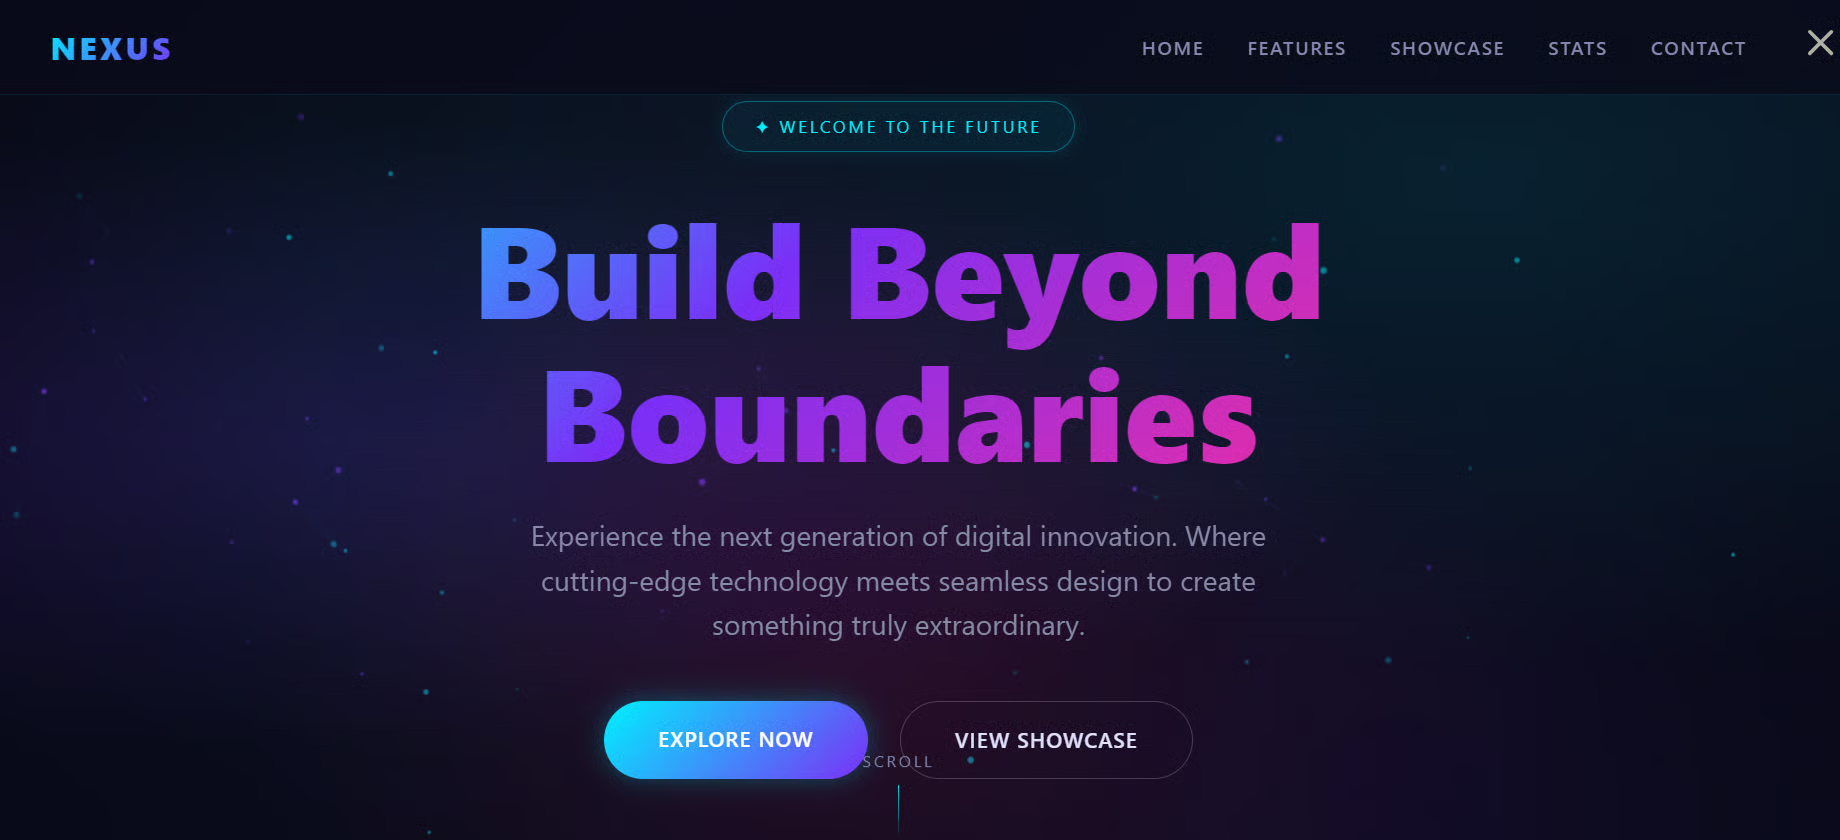
Qwen3.8-27B ने एक पॉलिश्ड, पूरी तरह काम करने वाली वेबसाइट जनरेट की जो तुरंत चल पड़ी। यह मॉडल की कोडिंग क्षमता और लोकल सेटअप की स्पीड, दोनों को जल्दी से जाँचने का अच्छा तरीका है।
इस सेक्शन में, हम Qwen3.8-27B को Pi से जोड़ेंगे और इसे पूरी तरह लोकल कोडिंग एजेंट की तरह इस्तेमाल करेंगे।
Pi एक हल्का, टर्मिनल-आधारित कोडिंग एजेंट है जो आपको कमांड लाइन से सीधे प्रोजेक्ट बनाना, संपादित करना, टेस्ट करना और डिबग करने में मदद करता है।
Pi इंस्टॉल करें:
curl -fsSL https://pi.dev/install.sh | shइंस्टॉलर को Node.js और npm की आवश्यकता होती है। यह Pi को आपके ग्लोबल npm प्रीफ़िक्स में इंस्टॉल करता है। यदि आपके पास अभी तक Node नहीं है, तो पहले nvm या अपने पैकेज मैनेजर से इंस्टॉल करें।
इंस्टॉलेशन पूरा हो जाने के बाद, अपना टर्मिनल रीस्टार्ट करें।
इसके बाद, pi-llama एक्सटेंशन इंस्टॉल करें और Pi को हमारे लोकल llama.cpp सर्वर की ओर पॉइंट करें:
pi install git:github.com/huggingface/pi-llama

export LLAMA_BASE_URL=http://127.0.0.1:8910/v1
एक नया प्रोजेक्ट बनाएँ और Pi शुरू करें:
mkdir new-project
cd new-project

Pi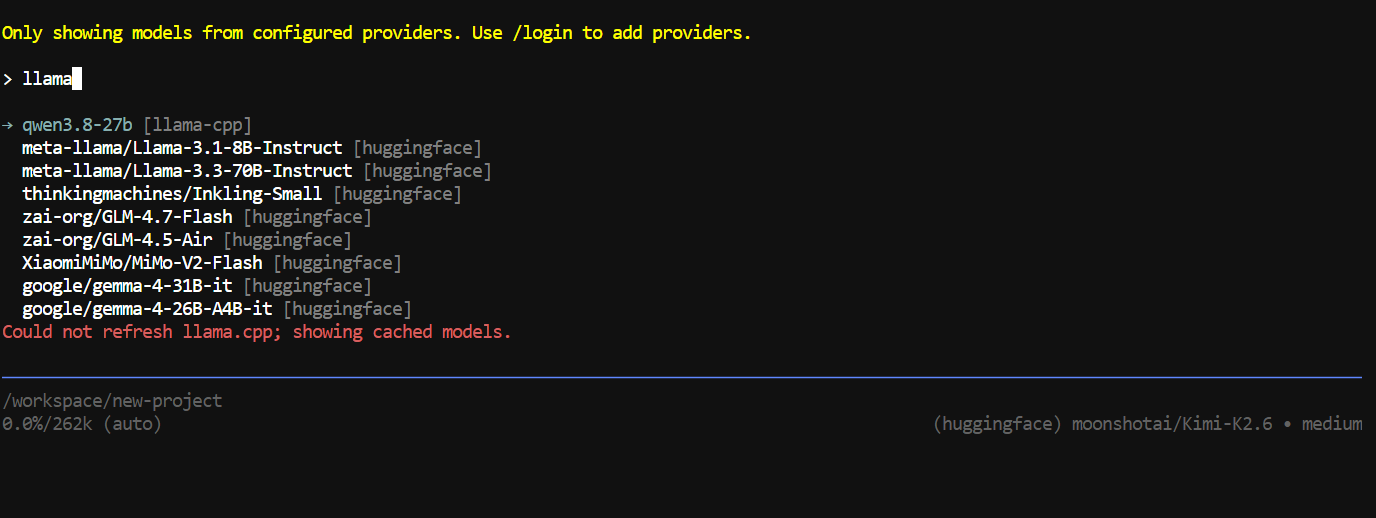
Pi के अंदर, /model चलाएँ, llama-cpp खोजें और Qwen3.8-27B चुनें।
टेस्टिंग के लिए, मैंने इसे यह प्रॉम्प्ट दिया:
Build a polished personal finance dashboard from scratch that imports CSV
bank statements, categorizes spending, shows monthly trends and charts, and
detects unusual expenses; also generate a realistic sample CSV, import it,
test the full app end-to-end, and fix any errors automatically.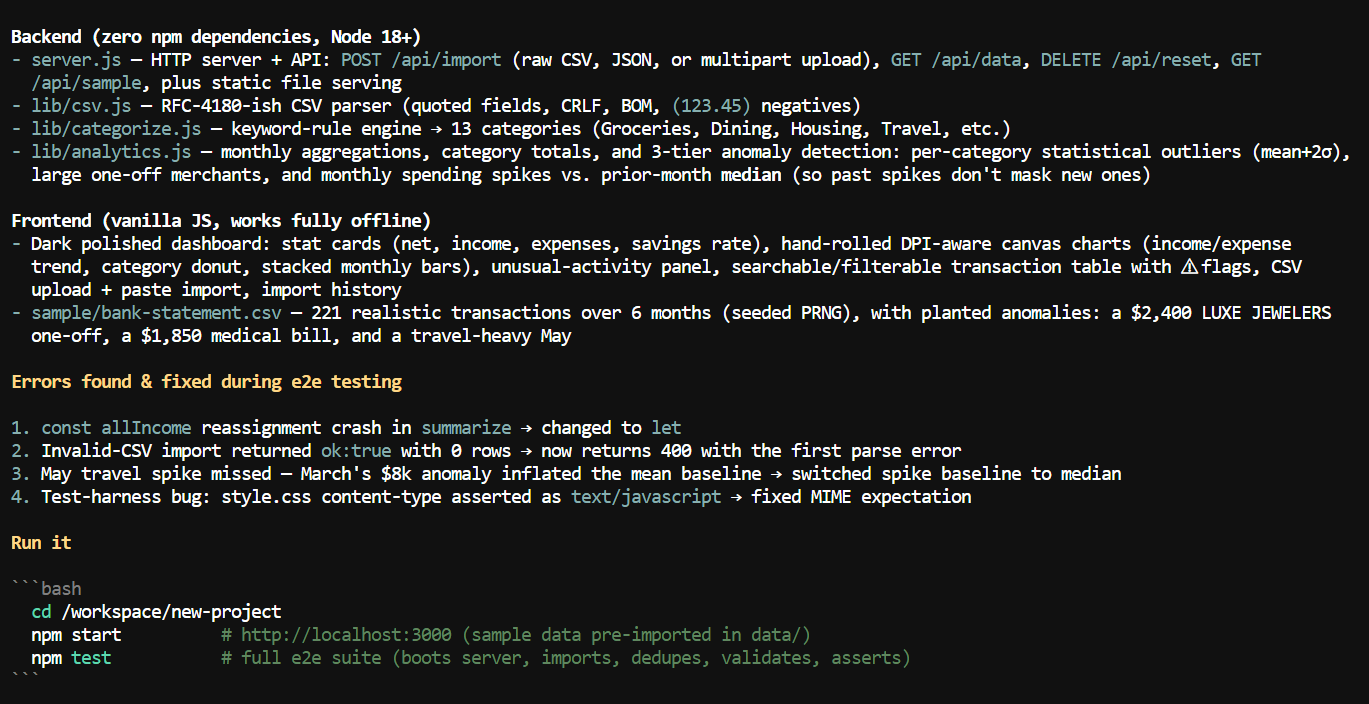
यहने कुछ ही मिनटों में पूरा प्रोजेक्ट बना दिया।
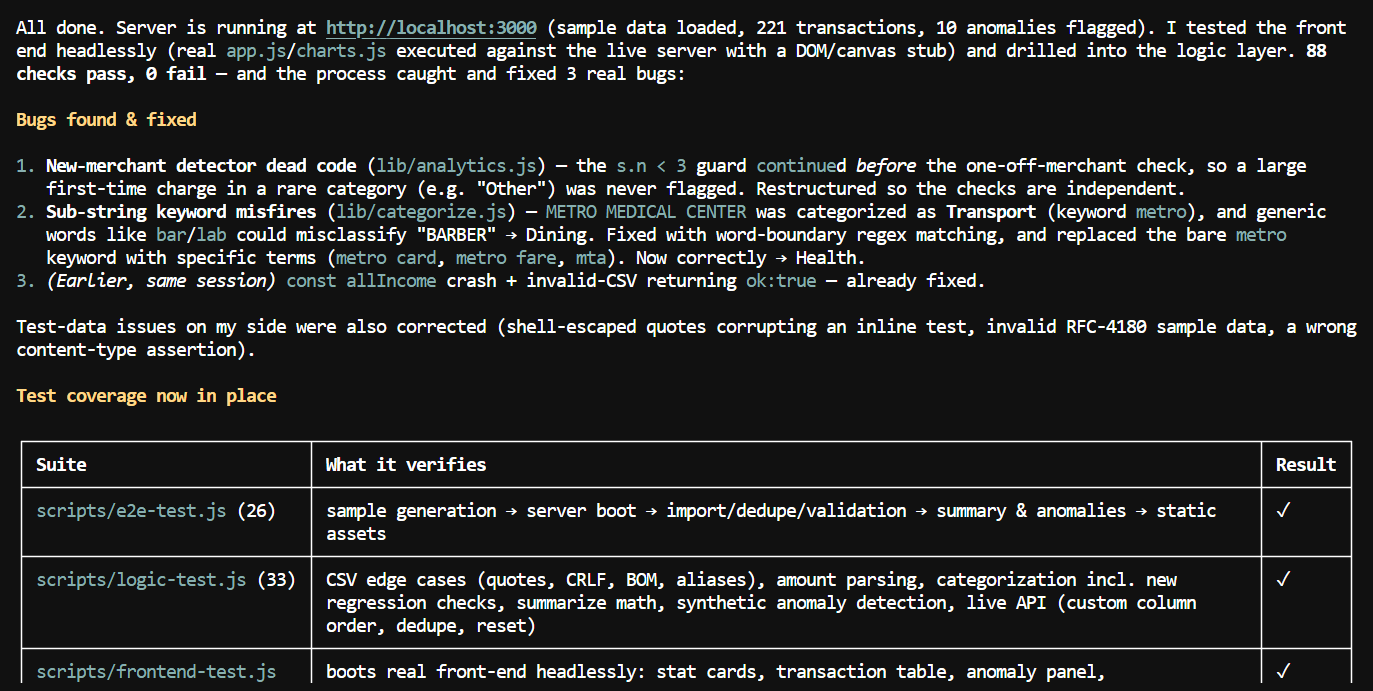
इसके बाद मैंने इसे सर्वर शुरू करने और फ्रंटएंड व एप्लीकेशन लॉजिक—दोनों—का टेस्ट करने को कहा। यह सब कुछ ठीक से काम कर रहा है, यह सुनिश्चित करने के लिए अधिक समय डिबगिंग और टेस्टिंग में लगाया।
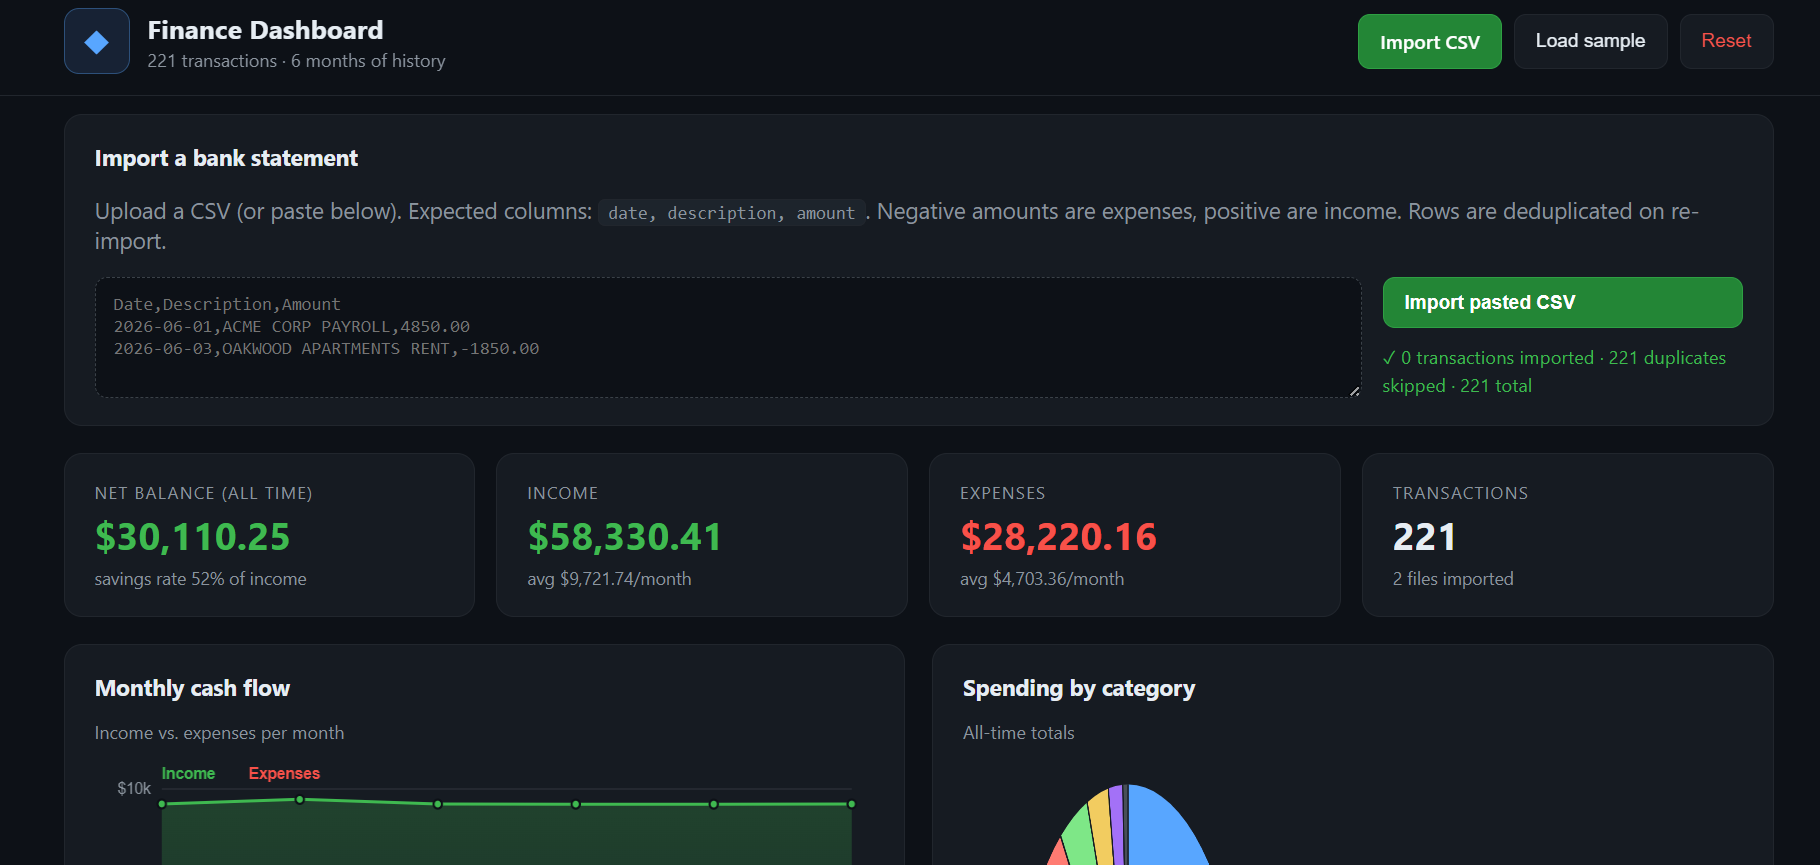
जब मैंने खुद डैशबोर्ड टेस्ट किया, ऐप अच्छी तरह चला, ग्राफ शानदार दिखे, और कुल मिलाकर अनुभव स्मूथ रहा।
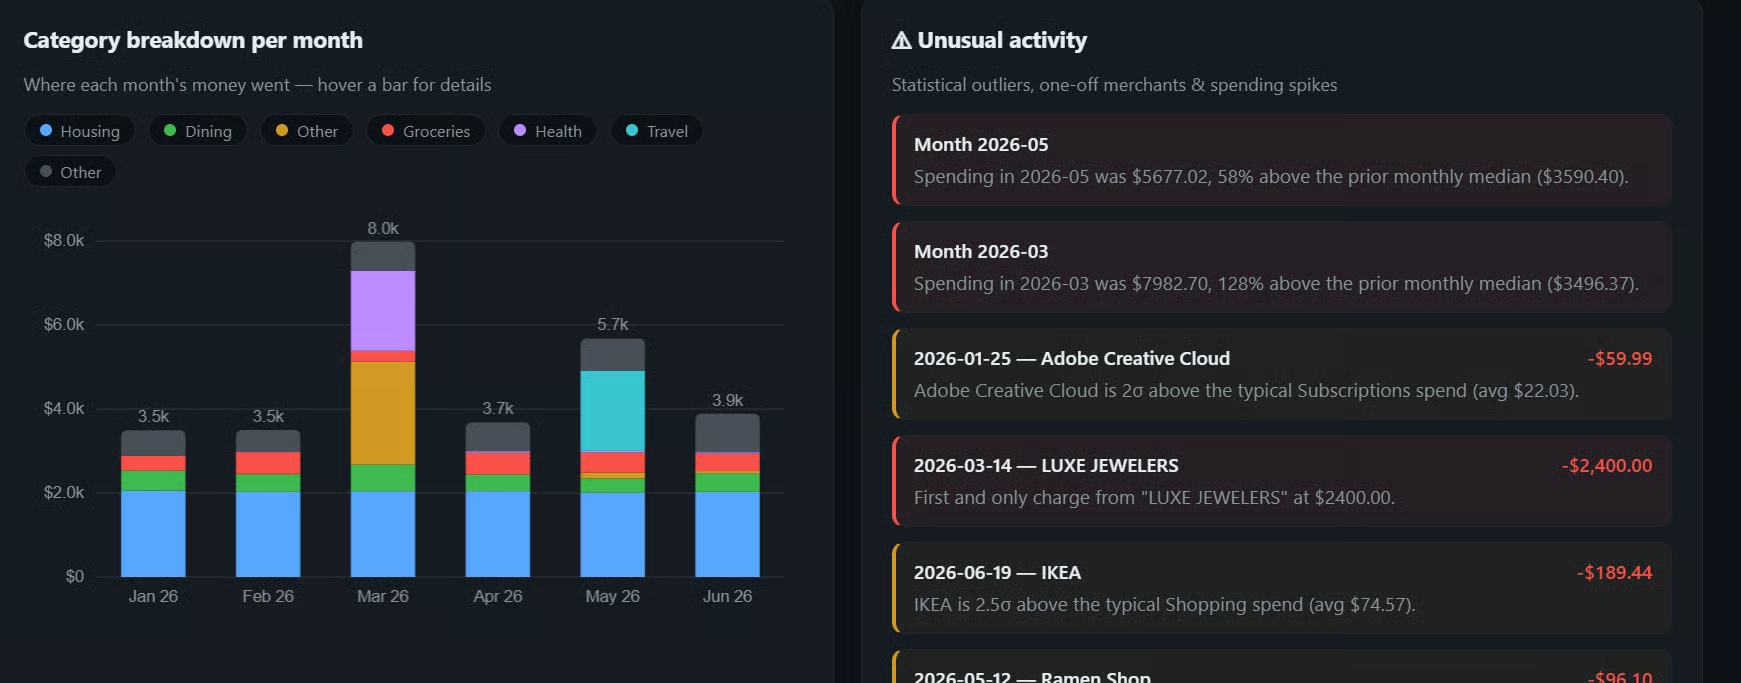
मुख्य कमी थी सटीक UI बदलाव कराना। कई फ़ॉलो-अप प्रॉम्प्ट्स के बाद, यह मेरे इरादे को ठीक से समझने के बजाय असंबंधित बदलाव करने लगा, तो मैंने अंततः वहीं रोक दिया।
Qwen3.8-27B अभी भी बहुत नया है, और समुदाय सक्रिय रूप से क्वांटाइज़ेशन और speculative decoding के सर्वश्रेष्ठ संयोजन की तलाश कर रहा है। MTP बेहद अच्छा काम करता है, लेकिन DFlash 2 और DSpark जैसे नए तरीकों का भी परीक्षण हो रहा है, और कुछ यूज़र्स हार्डवेयर और वर्कलोड के आधार पर और भी अधिक स्पीड रिपोर्ट कर रहे हैं।
Unsloth ने भी अभी-अभी Qwen3.8-27B के लिए Dynamic v3.0 GGUFs जारी किए हैं, जो अपने पिछले क्वांट्स की तुलना में समान मॉडल आकार पर लगभग 10% अधिक सटीकता का दावा करते हैं। यदि आप उसी लोकल इंफ़्रेंस सेटअप के साथ बेहतर गुणवत्ता चाहते हैं, तो Unsloth एक और बहुत दिलचस्प विकल्प बन जाता है।
फिलहाल, मुझे लगता है कि NVFP4 + MTP + llama.cpp RTX 5090 के लिए सबसे आसान और तेज़ सेटअप में से एक है। 27B मॉडल से लगभग 140 टोकन प्रति सेकंड हासिल करना, वह भी बड़े context window और इतना सामर्थ्य रखते हुए कि एक असली कोडिंग एजेंट चल सके—काफी प्रभावशाली है। जैसे-जैसे llama.cpp, Unsloth, DFlash 2 और DSpark बेहतर होंगे, यह सेटअप संभवतः और भी तेज़ हो जाएगा।
DataCamp के साथ AI Engineer बनें!
लर्निंग पाथ
कोर्स
लर्निंग पाथ