Programma
Ingegnere AI associato per sviluppatori
26 ore
Per prima cosa, assicuriamoci che la GPU sia rilevata correttamente e verifichiamo versione del driver NVIDIA e di CUDA.
nvidia-smi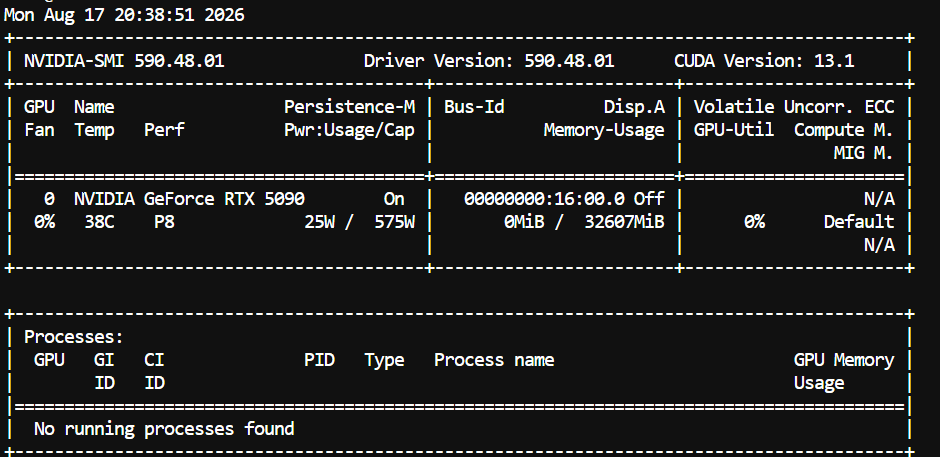
Dovresti vedere la tua RTX 5090, la versione del driver, la versione di CUDA, la memoria della GPU e l’uso corrente della GPU.
Nota: questa configurazione è specifica per le GPU NVIDIA Blackwell, come la RTX 5090. La build qui sotto è mirata a SM120, l’architettura di calcolo usata dalla RTX 5090.
Poi scaricheremo e compileremo l’ultima versione di llama.cpp con supporto CUDA.
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp

cmake -B build \
  -DGGML_CUDA=ON \
  -DCMAKE_CUDA_ARCHITECTURES=120

cmake --build build --config Release -j$(nproc)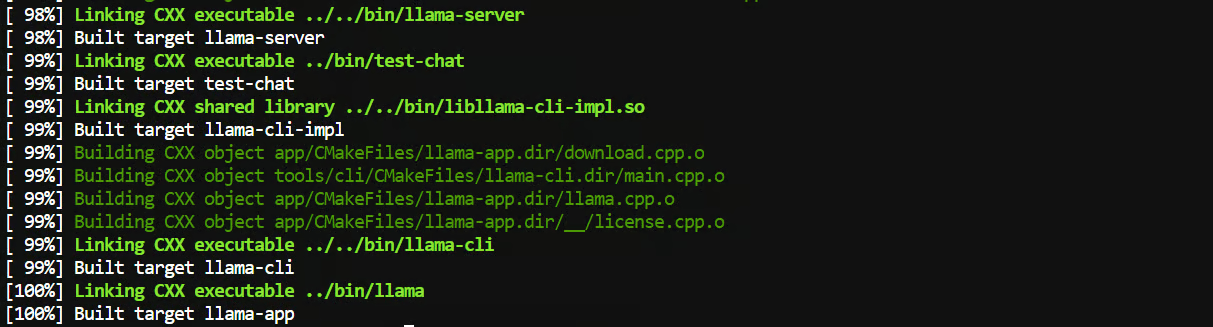
La parte importante qui è -DCMAKE_CUDA_ARCHITECTURES=120. Indica a llama.cpp di compilare specificamente per l’architettura Blackwell usata dalla RTX 5090.
Una volta terminata la build, renderemo llama-server disponibile globalmente così da poterlo eseguire da qualsiasi cartella:
sudo ln -sf "$(realpath ./build/bin/llama-server)" /usr/local/bin/llama-serverOra verifica che tutto funzioni:
llama-server --versionDovresti ottenere un output simile a:
version: 0.1.1-dev (build 10479, commit 0021a77de)
built with GNU 13.3.0 for Linux x86_64
Ecco fatto. Ora abbiamo una build di llama.cpp con CUDA che può sfruttare la RTX 5090 e il supporto NVFP4 nativo di Blackwell.
Ora scaricheremo il modello Qwen3.8-27B.
Per prima cosa, installa la CLI di Hugging Face:
pip install -U huggingface_hubCrea una cartella in cui manterremo il modello:
mkdir -p /workspace/models/qwen38Poi scarica il GGUF NVFP4-MTP:
hf download felippeburk/Qwen3.8-27B-NVFP4-MTP-GGUF \
  --local-dir /workspace/models/qwen38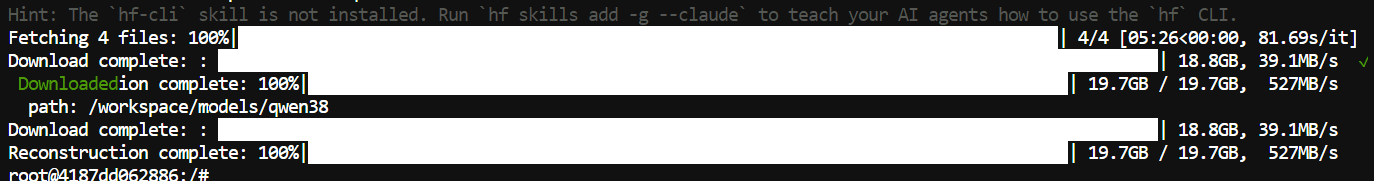
Questa è la versione che vogliamo per questa configurazione perché usa NVFP4 e include il supporto MTP, da cui derivano gran parte dei miglioramenti di velocità sulla RTX 5090.
Ora arriva la parte divertente. Serviremo Qwen3.8-27B interamente su GPU con Flash Attention, una finestra di contesto da 131K e decodifica speculativa MTP per generazioni più veloci.
Esegui:
cd /workspace/llama.cpp

llama-server \
  -m /workspace/models/qwen38/qwen3.8-27b-text-nvfp4-mtp.gguf \
  --alias qwen3.8-27b \
  --host 0.0.0.0 \
  --port 8910 \
  --ctx-size 131072 \
  --n-gpu-layers all \
  --flash-attn on \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --parallel 1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 4 \
  --spec-draft-p-min 0.75 \
  --spec-draft-ngl all \
  --spec-draft-type-k q8_0 \
  --spec-draft-type-v q8_0 \
  --reasoning-effort medium \
  --jinja
Qui ci sono molte opzioni, ma la maggior parte serve semplicemente a ottenere le migliori prestazioni dalla 5090.
Le principali da conoscere sono:
--ctx-size 131072 ci dà una finestra di contesto di circa 131K.
--n-gpu-layers all mantiene il modello sulla GPU.
--flash-attn on abilita la Flash Attention.
--cache-type-k q8_0 e --cache-type-v q8_0 aiutano a ridurre l’uso di memoria della KV cache.
--spec-type draft-mtp abilita la decodifica speculativa MTP di Qwen3.8.
--spec-draft-n-max 4 controlla quanti token speculativi MTP può generare alla volta.
Per questa configurazione usiamo n-max 4 come punto di partenza per una RTX 5090. Puoi sperimentare con valori come 2 (che la scheda del modello consiglia per questo GGUF) o 3 in seguito, dato che l’impostazione più veloce può variare leggermente in base al tuo sistema.
Una volta che llama-server termina di caricare il modello, Qwen3.8 sarà disponibile in locale su http://127.0.0.1:8910.
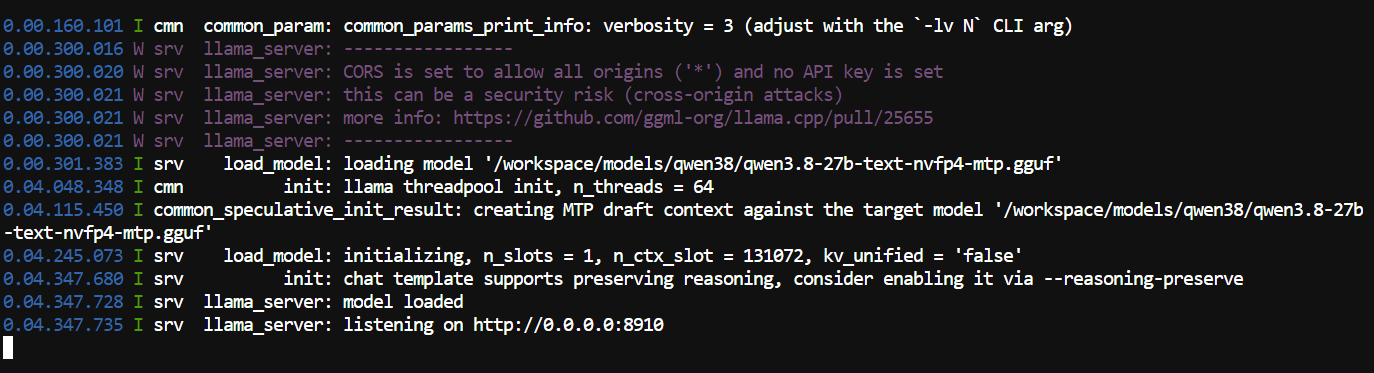
Ora abbiamo Qwen3.8-27B in esecuzione in locale. Successivamente, testeremo il modello sia tramite API sia tramite l’interfaccia browser integrata.
Con il server in esecuzione, apri un altro terminale e invia una richiesta di test all’API compatibile con OpenAI:
curl http://127.0.0.1:8910/v1/chat/completions \
 -H "Content-Type: application/json" \
 -d '{
   "model": "qwen3.8-27b",
   "messages": [
     {
       "role": "user",
       "content": "Write a Python FastAPI application that monitors GPU usage."
     }
   ],
   "max_tokens": 2000
 }'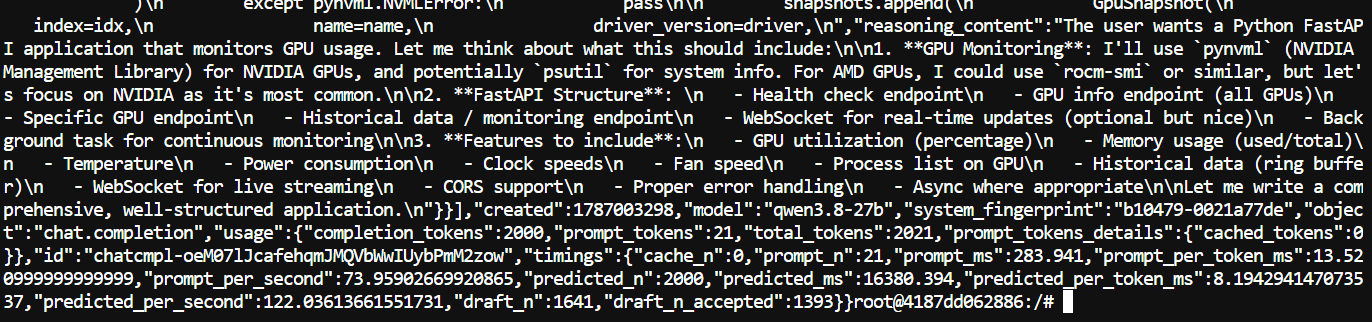
In questo test, Qwen3.8-27B ha generato 2.000 token a 122 token/sec con un notevole tasso di accettazione MTP dell’84,9%.
llama.cpp include anche un’interfaccia browser, così puoi testare il modello senza usare l’API.
Apri http://127.0.0.1:8910 nel browser per vedere l’interfaccia.
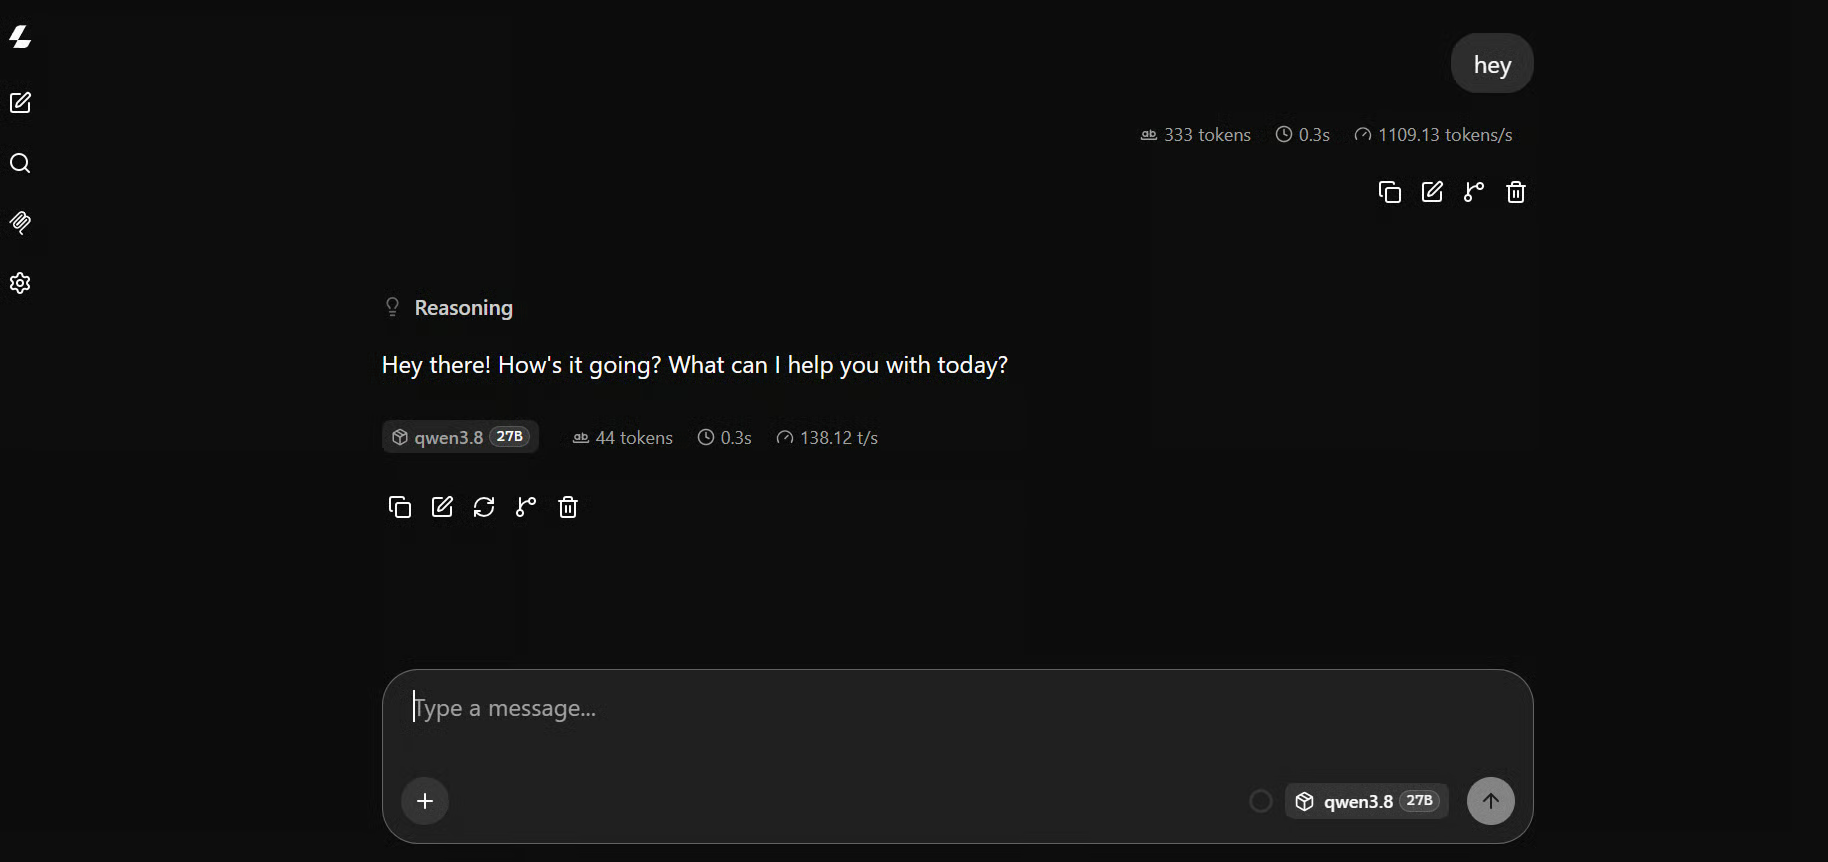
Per un test più complesso, ho usato questo prompt:
Create a stunning single-file animated HTML website with a dark futuristic
theme, smooth scrolling, glowing gradients, floating particles, animated cards,
hover effects, and responsive design using only HTML, CSS, and JavaScript.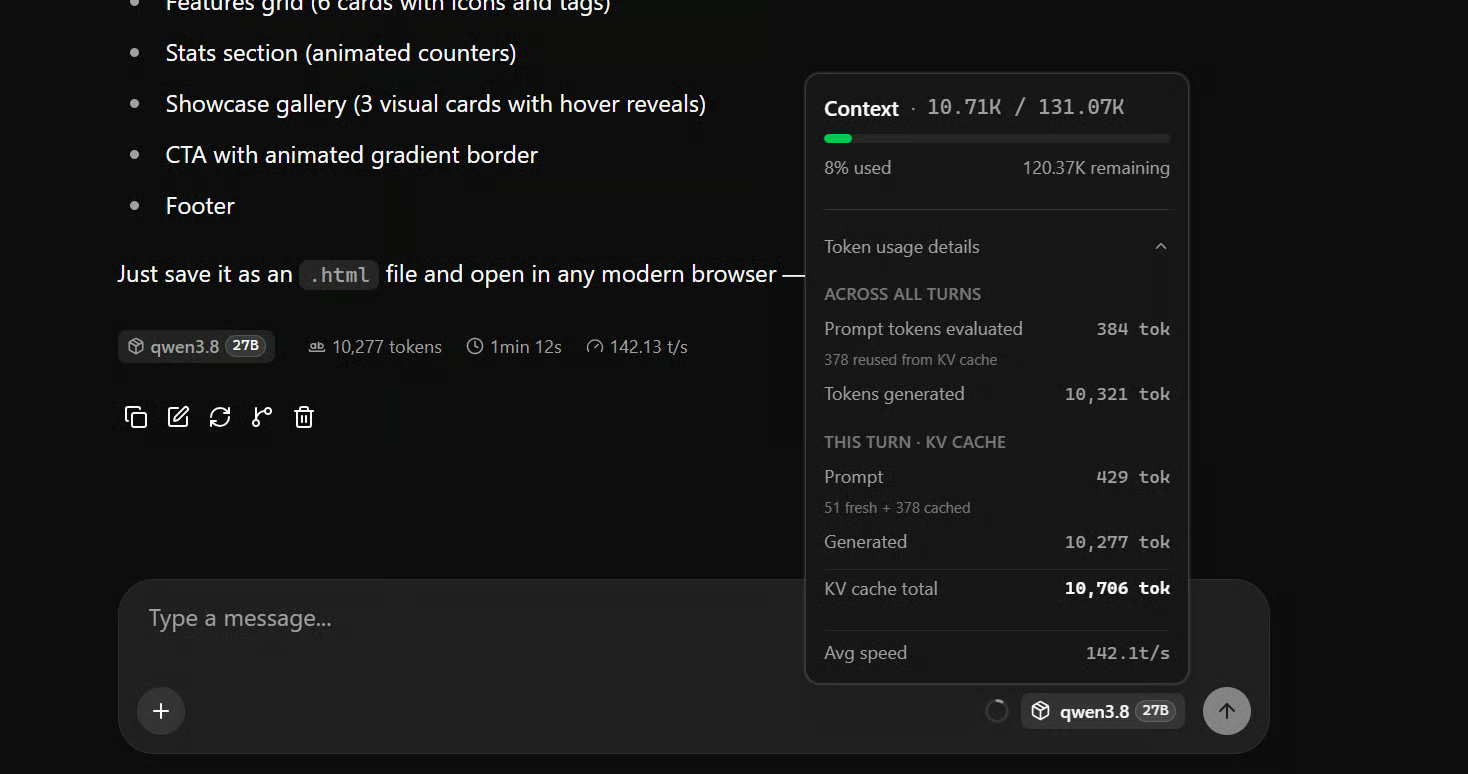
Sulla mia RTX 5090, ho ottenuto in media circa 142 token al secondo, con picchi occasionali intorno a 170 token al secondo: estremamente veloce per un modello 27B in locale.
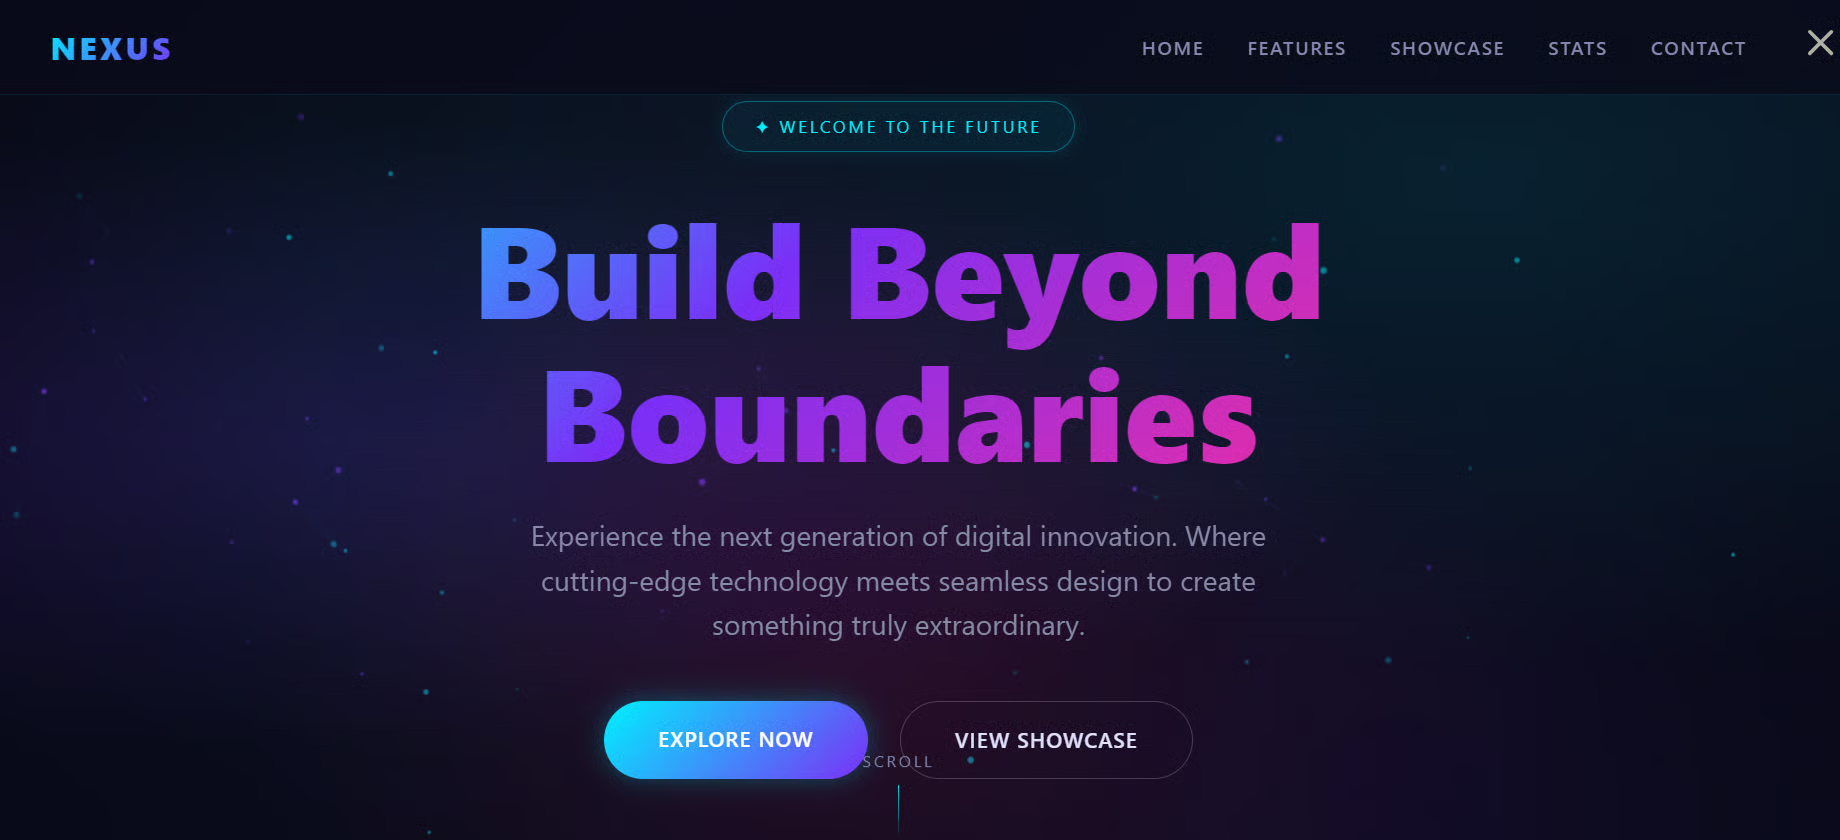
Qwen3.8-27B ha generato un sito web curato e perfettamente funzionante pronto all’uso. È un buon modo per testare rapidamente sia la capacità di coding del modello sia la velocità della configurazione locale.
In questa sezione collegheremo Qwen3.8-27B a Pi e lo useremo come agente di coding completamente locale.
Pi è un agente di coding leggero basato su terminale che può aiutarti a creare, modificare, testare e fare debug dei progetti direttamente dalla riga di comando.
Installa Pi con:
curl -fsSL https://pi.dev/install.sh | shL’installer richiede Node.js e npm. Installa Pi nel tuo prefisso npm globale. Se non hai ancora Node, installalo prima con nvm o con il tuo gestore pacchetti.
Una volta terminata l’installazione, riavvia il terminale.
Poi installa l’estensione pi-llama e punta Pi al nostro server locale di llama.cpp:
pi install git:github.com/huggingface/pi-llama

export LLAMA_BASE_URL=http://127.0.0.1:8910/v1
Crea un nuovo progetto e avvia Pi:
mkdir new-project
cd new-project

Pi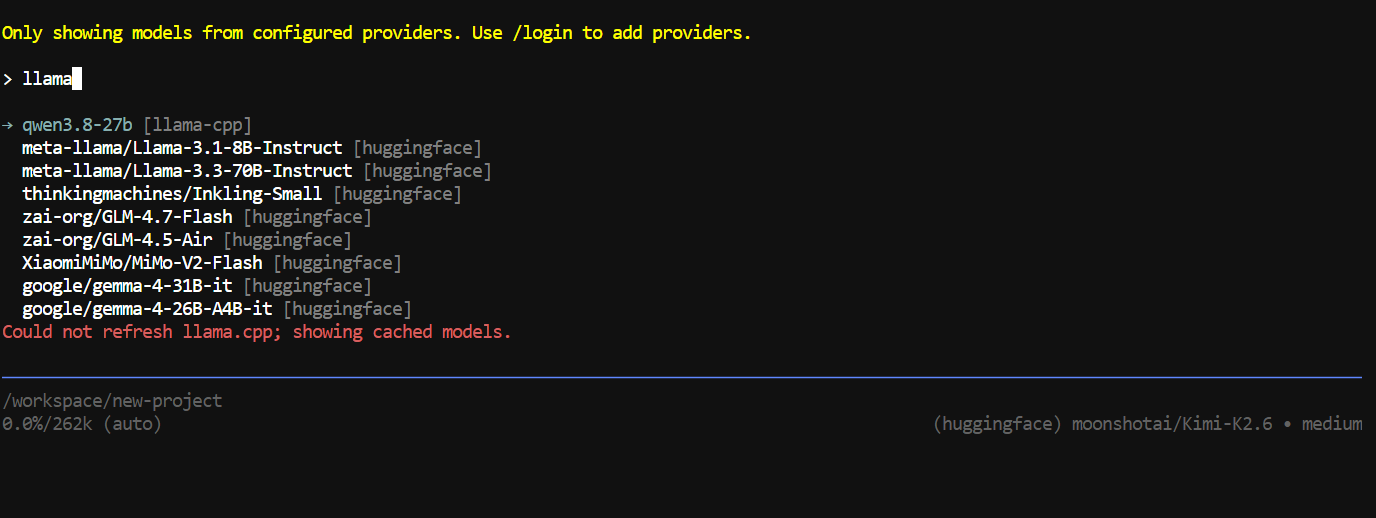
All’interno di Pi, esegui /model, cerca llama-cpp e seleziona Qwen3.8-27B.
Per il test, gli ho dato questo prompt:
Build a polished personal finance dashboard from scratch that imports CSV
bank statements, categorizes spending, shows monthly trends and charts, and
detects unusual expenses; also generate a realistic sample CSV, import it,
test the full app end-to-end, and fix any errors automatically.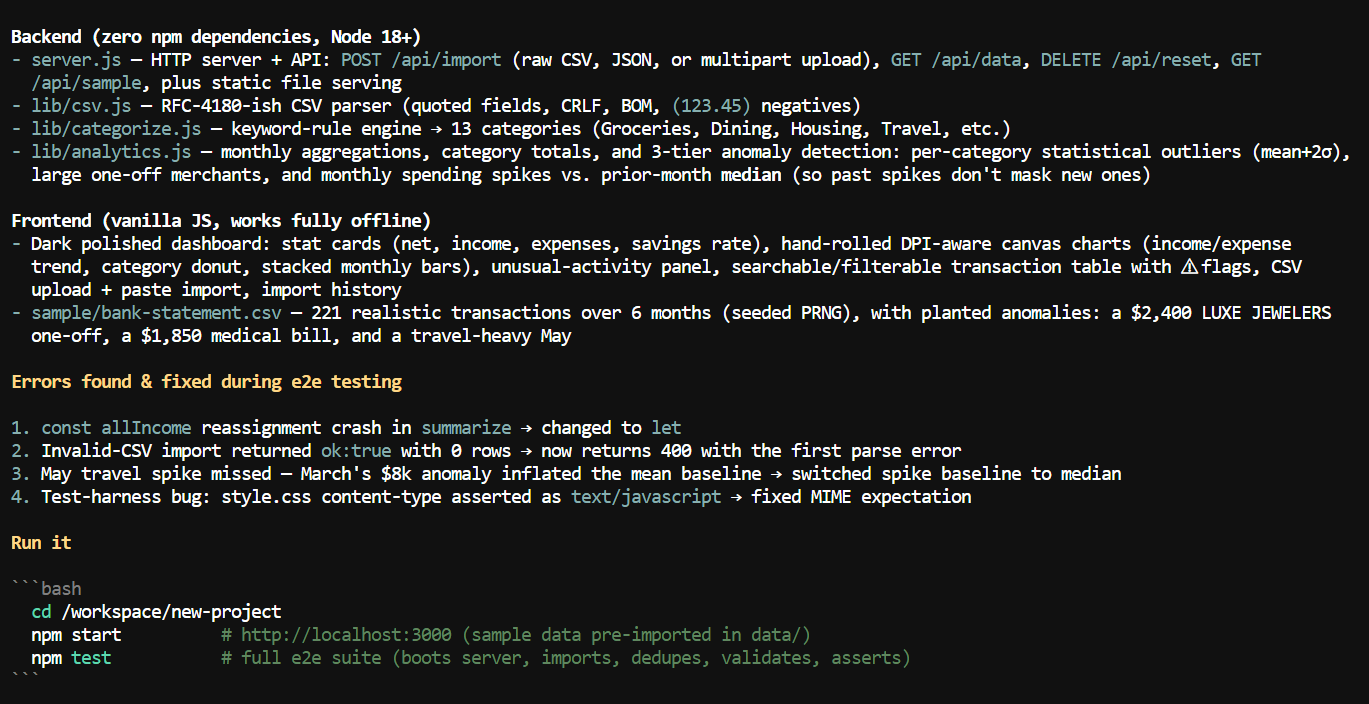
Ha costruito l’intero progetto in pochi minuti.
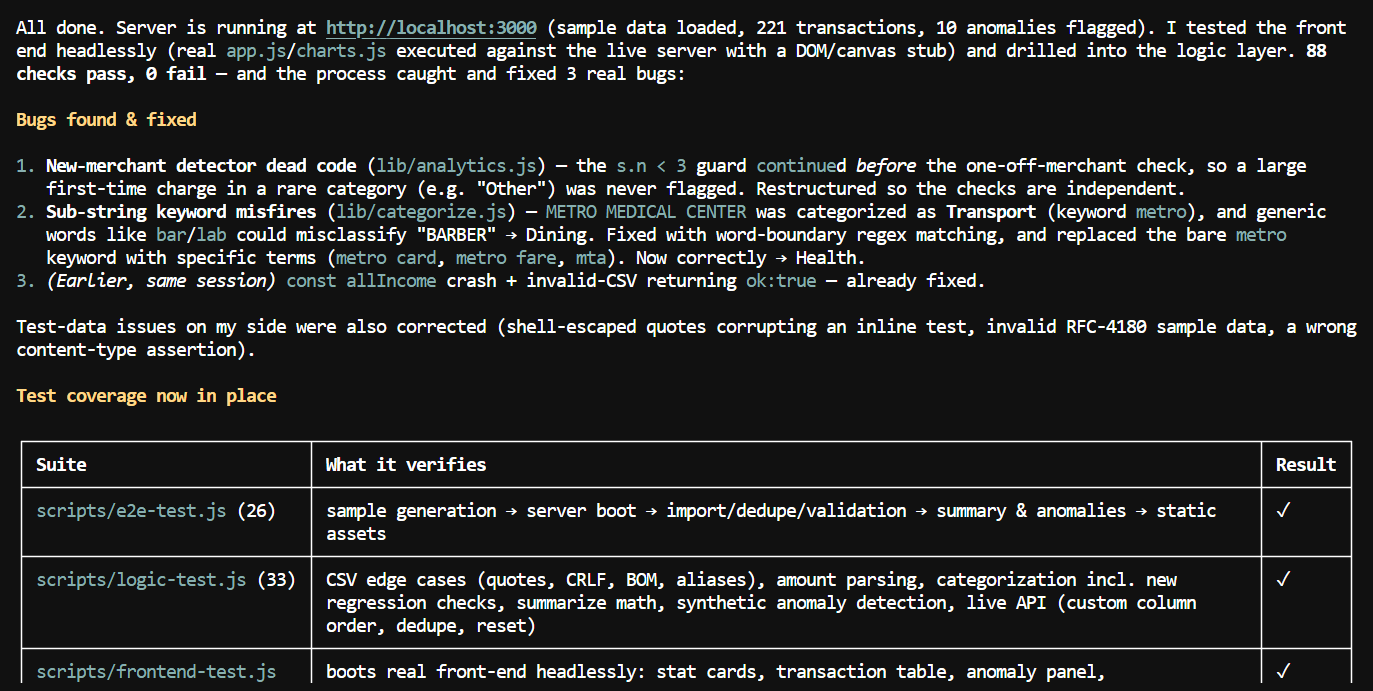
Poi gli ho chiesto di avviare il server e testare sia il frontend sia la logica dell’applicazione. Ha impiegato più tempo a fare debugging e test per assicurarsi che tutto funzionasse correttamente.
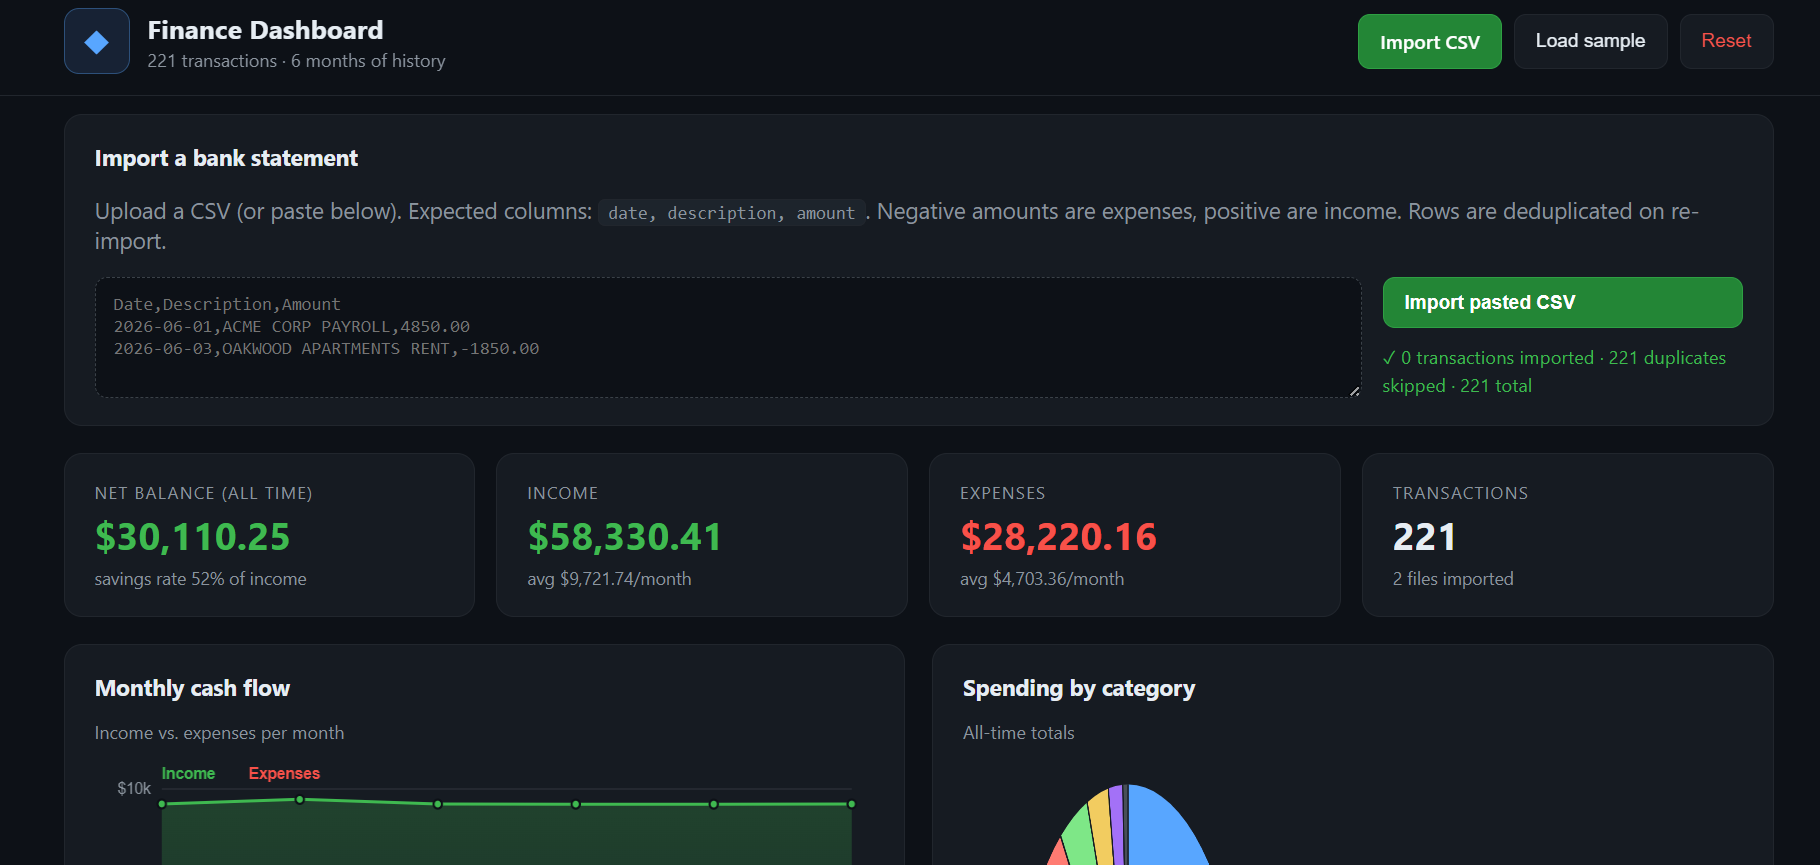
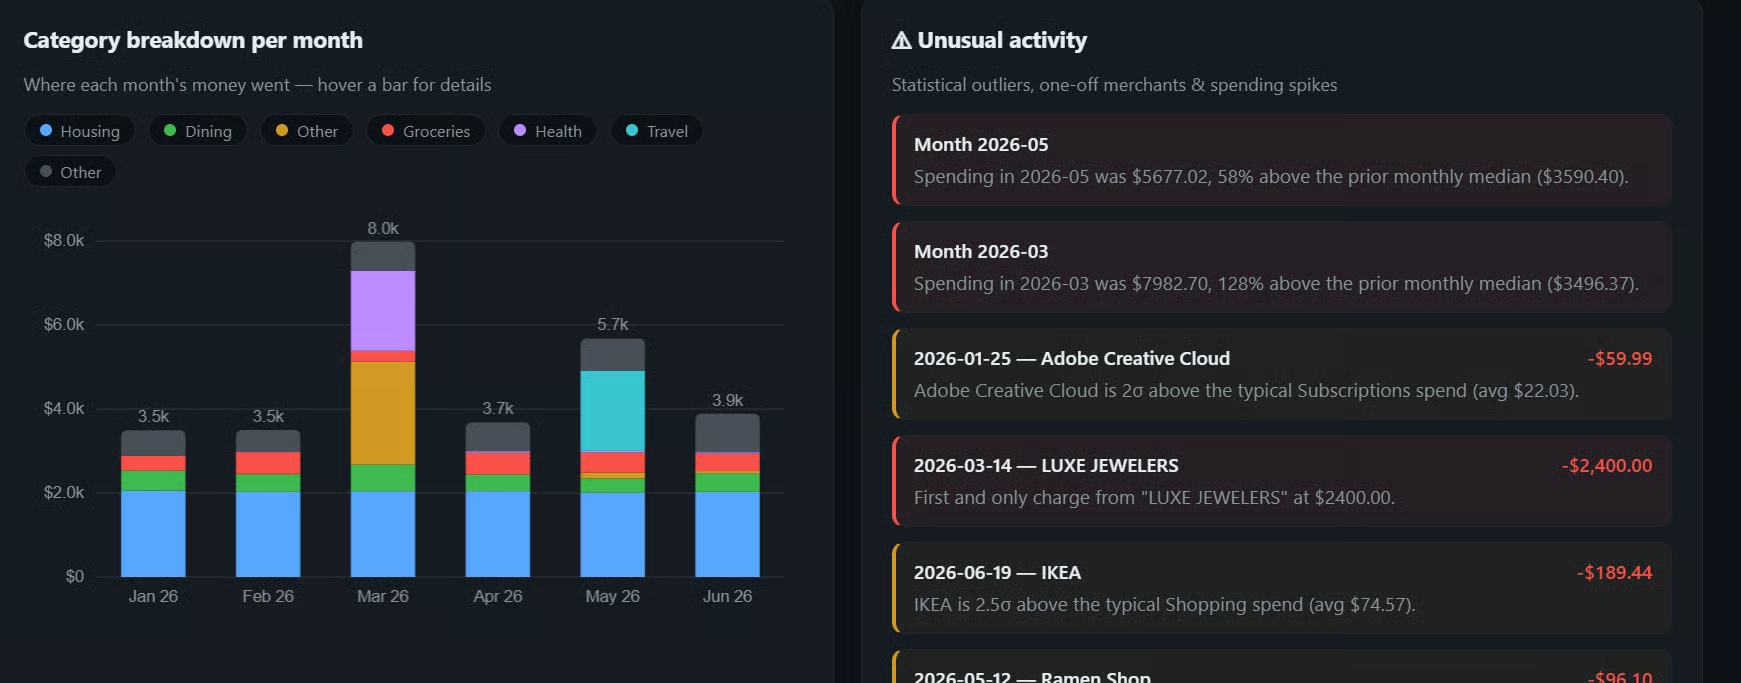
Quando ho testato io stesso la dashboard, l’app funzionava bene, i grafici erano ottimi e l’esperienza generale era fluida.
La principale debolezza è stata apportare modifiche UI precise. Dopo vari prompt di follow-up, ha iniziato a fare modifiche non correlate invece di capire esattamente cosa volessi, quindi alla fine mi sono fermato lì.
Qwen3.8-27B è ancora molto nuovo e la community sta attivamente individuando la migliore combinazione tra quantizzazione e decodifica speculativa. MTP funziona estremamente bene, ma si stanno testando anche approcci più recenti come DFlash 2 e DSpark, con alcuni utenti che riportano velocità ancora più alte a seconda dell’hardware e del carico di lavoro.
Unsloth ha anche appena rilasciato GGUF Dynamic v3.0 per Qwen3.8-27B, dichiarando circa il 10% di accuratezza in più a parità di dimensioni del modello rispetto ai quant precedenti. Questo rende Unsloth un’altra opzione molto interessante se vuoi una qualità migliore mantenendo grosso modo la stessa configurazione di inferenza locale.
Per ora, penso che NVFP4 + MTP + llama.cpp sia una delle configurazioni più semplici e veloci per una RTX 5090. Ottenere circa 140 token al secondo da un modello 27B, pur mantenendo una grande finestra di contesto e capacità sufficienti per eseguire un vero agente di coding, è notevole. La configurazione probabilmente diventerà ancora più veloce man mano che llama.cpp, Unsloth, DFlash 2 e DSpark continueranno a migliorare.
Diventa un AI Engineer con DataCamp!
Programma
Corso
Programma
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min