Program
Insinyur Kecerdasan Buatan (AI) untuk Pengembang
26 Hr
Pertama, pastikan GPU terdeteksi dengan benar dan periksa versi driver NVIDIA serta CUDA.
nvidia-smi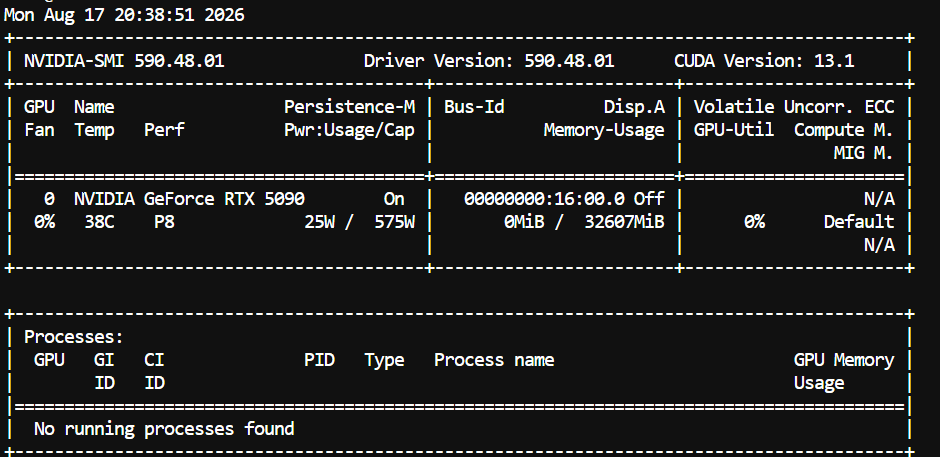
Anda akan melihat RTX 5090 Anda, versi driver, versi CUDA, memori GPU, dan penggunaan GPU saat ini.
Catatan: Penyiapan ini khusus untuk GPU NVIDIA Blackwell, seperti RTX 5090. Build di bawah ini menargetkan SM120, yaitu arsitektur komputasi yang digunakan oleh RTX 5090.
Selanjutnya, kita akan mengunduh dan mengompilasi versi terbaru llama.cpp dengan dukungan CUDA.
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp

cmake -B build \
  -DGGML_CUDA=ON \
  -DCMAKE_CUDA_ARCHITECTURES=120

cmake --build build --config Release -j$(nproc)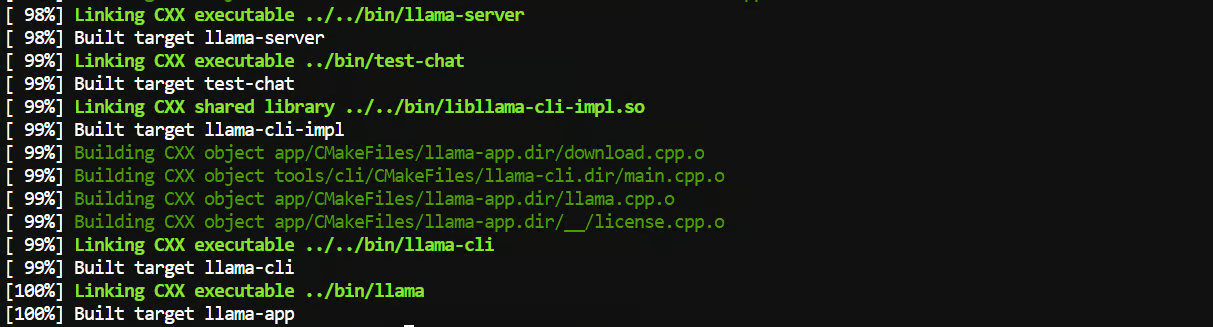
Bagian penting di sini adalah -DCMAKE_CUDA_ARCHITECTURES=120. Ini memberi tahu llama.cpp untuk membangun khusus untuk arsitektur Blackwell yang digunakan oleh RTX 5090.
Setelah build selesai, kita akan membuat llama-server tersedia secara global sehingga dapat dijalankan dari folder mana pun:
sudo ln -sf "$(realpath ./build/bin/llama-server)" /usr/local/bin/llama-serverSekarang, periksa apakah semuanya berfungsi:
llama-server --versionAnda akan mendapatkan keluaran serupa dengan:
version: 0.1.1-dev (build 10479, commit 0021a77de)
built with GNU 13.3.0 for Linux x86_64
Selesai. Kita sekarang memiliki build llama.cpp berkemampuan CUDA yang dapat memanfaatkan RTX 5090 dan dukungan NVFP4 native Blackwell.
Sekarang kita akan mengunduh model Qwen3.8-27B.
Pertama, instal Hugging Face CLI:
pip install -U huggingface_hubBuat folder tempat kita akan menyimpan model:
mkdir -p /workspace/models/qwen38Lalu unduh NVFP4-MTP GGUF:
hf download felippeburk/Qwen3.8-27B-NVFP4-MTP-GGUF \
  --local-dir /workspace/models/qwen38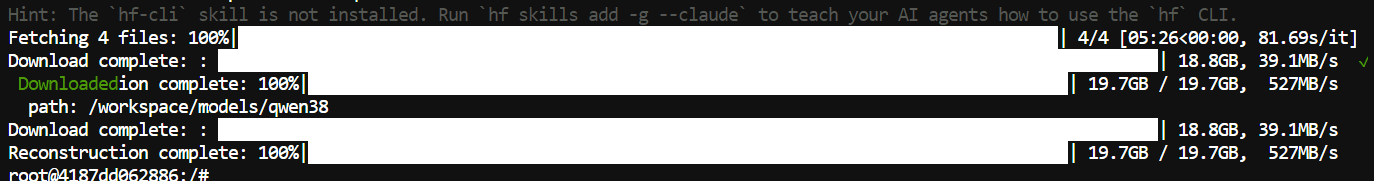
Ini adalah versi yang kita inginkan untuk penyiapan ini karena menggunakan NVFP4 dan mencakup dukungan MTP, yang menjadi sumber utama peningkatan kecepatan pada RTX 5090.
Sekarang bagian yang menyenangkan. Kita akan menyajikan Qwen3.8-27B sepenuhnya di GPU dengan Flash Attention, jendela konteks 131K, dan decoding spekulatif MTP untuk generasi yang lebih cepat.
Jalankan:
cd /workspace/llama.cpp

llama-server \
  -m /workspace/models/qwen38/qwen3.8-27b-text-nvfp4-mtp.gguf \
  --alias qwen3.8-27b \
  --host 0.0.0.0 \
  --port 8910 \
  --ctx-size 131072 \
  --n-gpu-layers all \
  --flash-attn on \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --parallel 1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 4 \
  --spec-draft-p-min 0.75 \
  --spec-draft-ngl all \
  --spec-draft-type-k q8_0 \
  --spec-draft-type-v q8_0 \
  --reasoning-effort medium \
  --jinja
Ada banyak opsi di sini, namun sebagian besar hanya untuk mendapatkan performa terbaik dari 5090.
Yang utama untuk diketahui adalah:
--ctx-size 131072 memberi kita jendela konteks sekitar 131K.
--n-gpu-layers all menjaga model tetap di GPU.
--flash-attn on mengaktifkan Flash Attention.
--cache-type-k q8_0 dan --cache-type-v q8_0 membantu mengurangi penggunaan memori KV cache.
--spec-type draft-mtp mengaktifkan decoding spekulatif MTP milik Qwen3.8.
--spec-draft-n-max 4 mengontrol berapa banyak token spekulatif yang dapat dihasilkan MTP sekaligus.
Untuk penyiapan ini, kita menggunakan n-max 4 sebagai titik awal untuk RTX 5090. Anda dapat bereksperimen dengan nilai seperti 2 (yang direkomendasikan kartu model untuk GGUF ini) atau 3 nanti, karena setelan tercepat dapat sedikit berbeda tergantung sistem Anda.
Setelah llama-server selesai memuat model, Qwen3.8 akan tersedia secara lokal di http://127.0.0.1:8910.
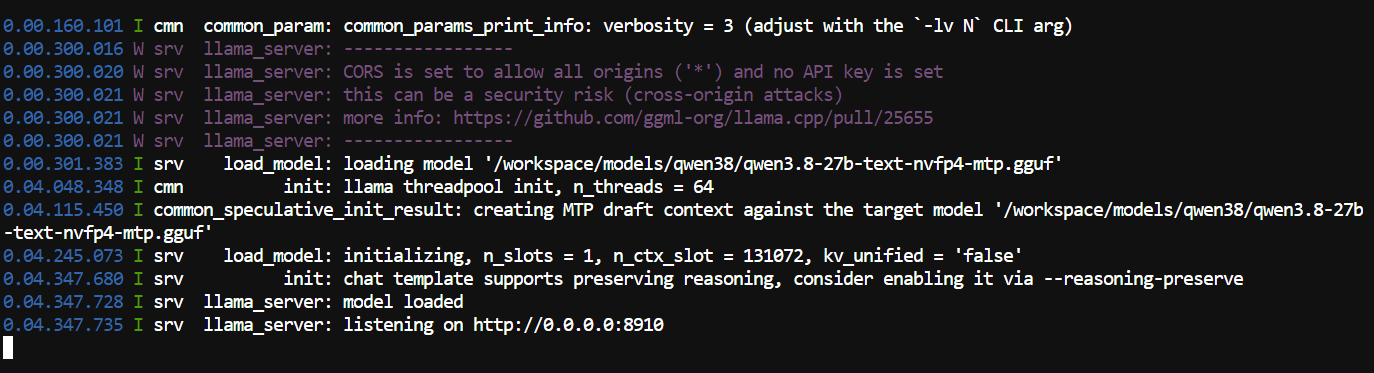
Sekarang kita telah menjalankan Qwen3.8-27B secara lokal. Berikutnya, kita akan menguji model melalui API dan antarmuka browser bawaan.
Dengan server berjalan, buka terminal lain dan kirim permintaan uji ke API yang kompatibel dengan OpenAI:
curl http://127.0.0.1:8910/v1/chat/completions \
 -H "Content-Type: application/json" \
 -d '{
   "model": "qwen3.8-27b",
   "messages": [
     {
       "role": "user",
       "content": "Write a Python FastAPI application that monitors GPU usage."
     }
   ],
   "max_tokens": 2000
 }'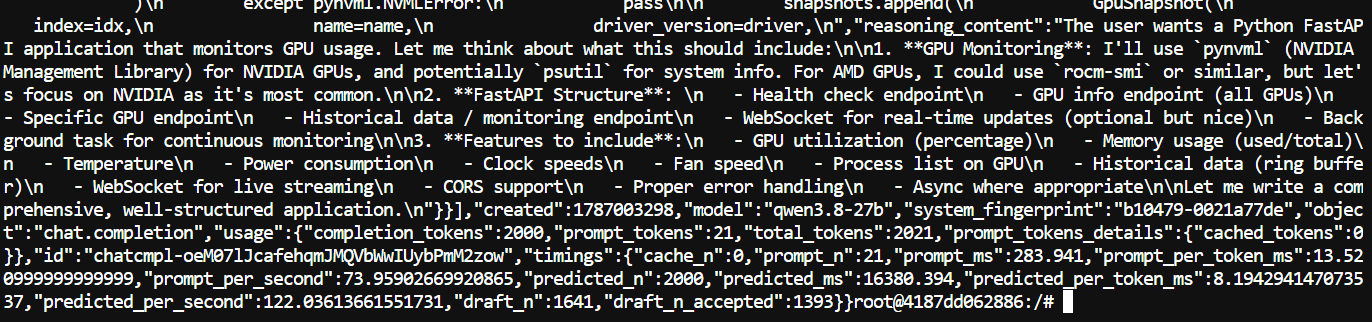
Dalam pengujian ini, Qwen3.8-27B menghasilkan 2.000 token pada 122 token/detik dengan tingkat penerimaan MTP yang impresif sebesar 84,9%.
llama.cpp juga menyertakan antarmuka browser, sehingga Anda dapat menguji model tanpa menggunakan API.
Buka http://127.0.0.1:8910 di browser Anda untuk melihat UI.
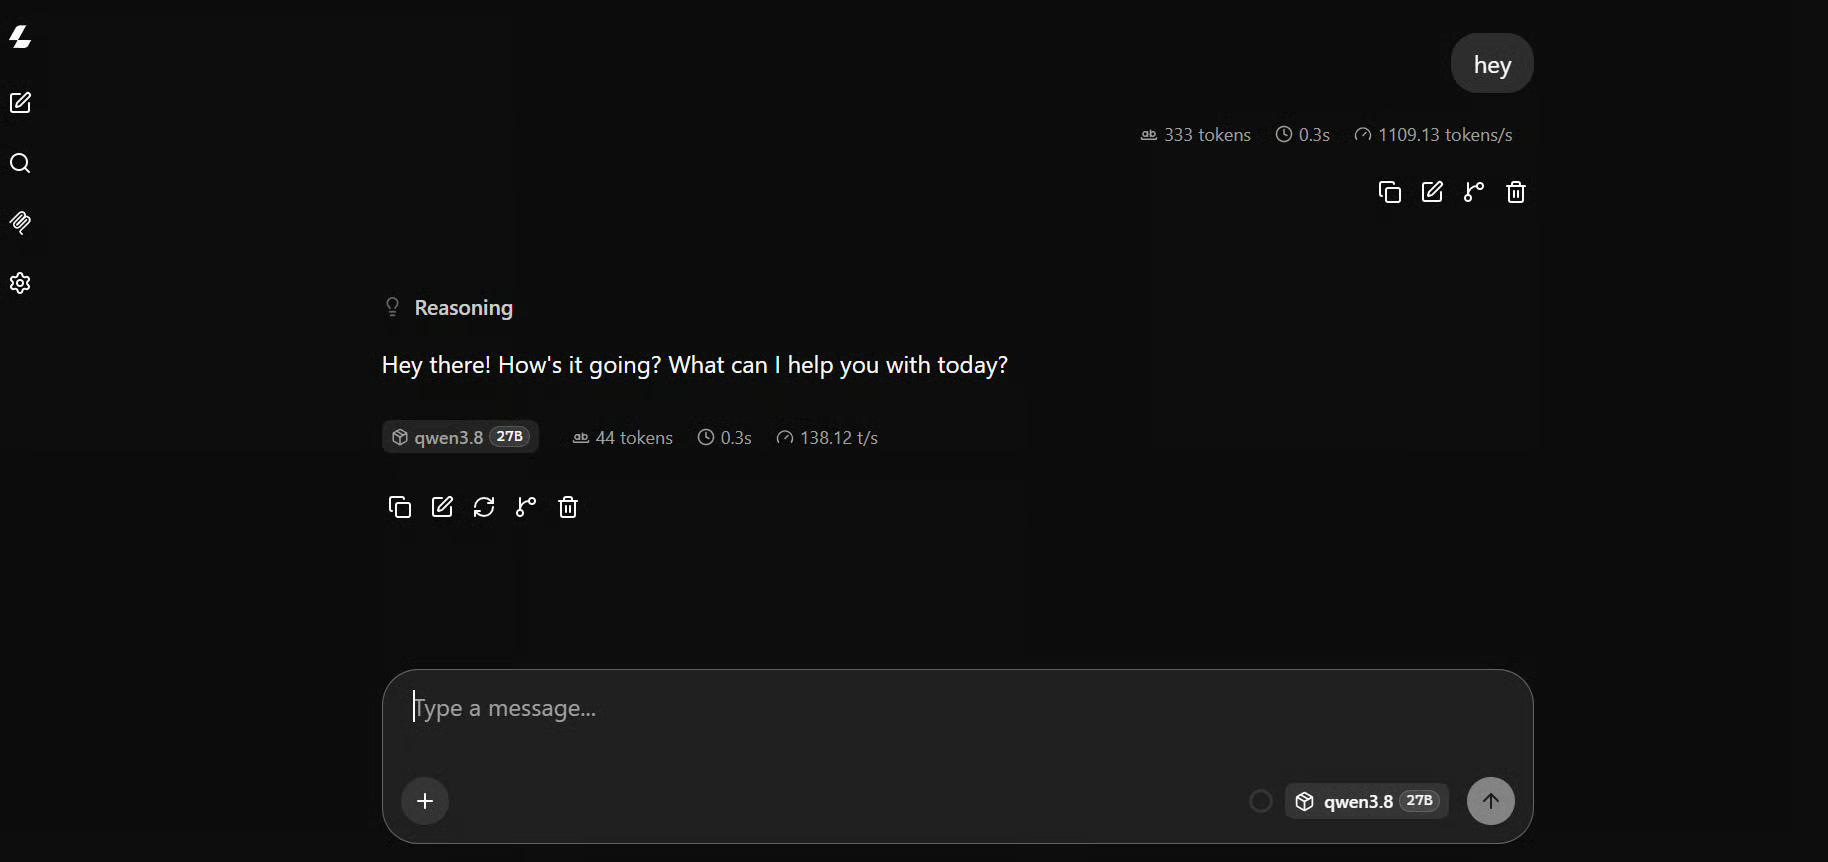
Untuk uji yang lebih kompleks, saya menggunakan prompt ini:
Create a stunning single-file animated HTML website with a dark futuristic
theme, smooth scrolling, glowing gradients, floating particles, animated cards,
hover effects, and responsive design using only HTML, CSS, and JavaScript.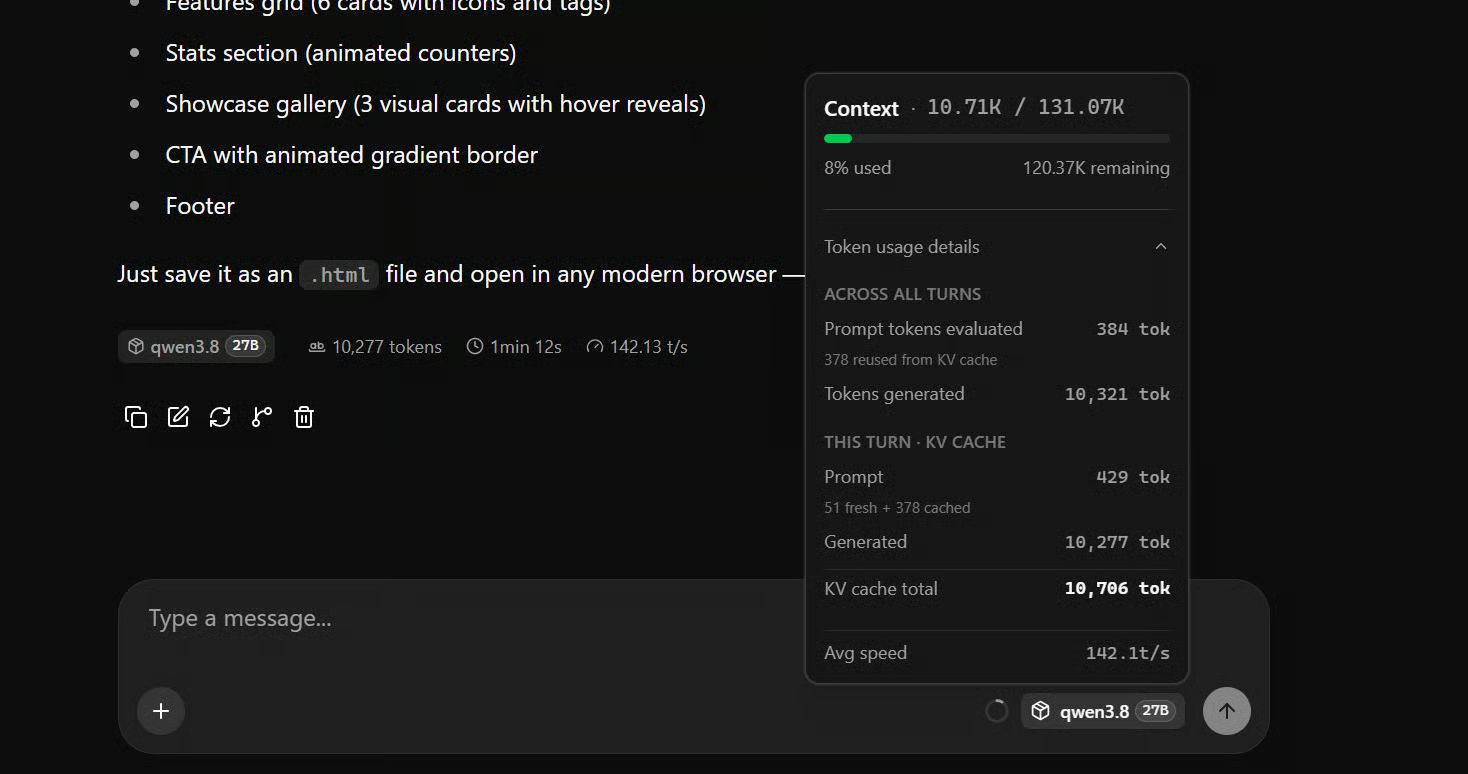
Di RTX 5090 saya, saya mendapatkan sekitar 142 token per detik rata-rata, dengan kecepatan generasi sesekali mencapai sekitar 170 token per detik, yang sangat cepat untuk model 27B yang berjalan secara lokal.
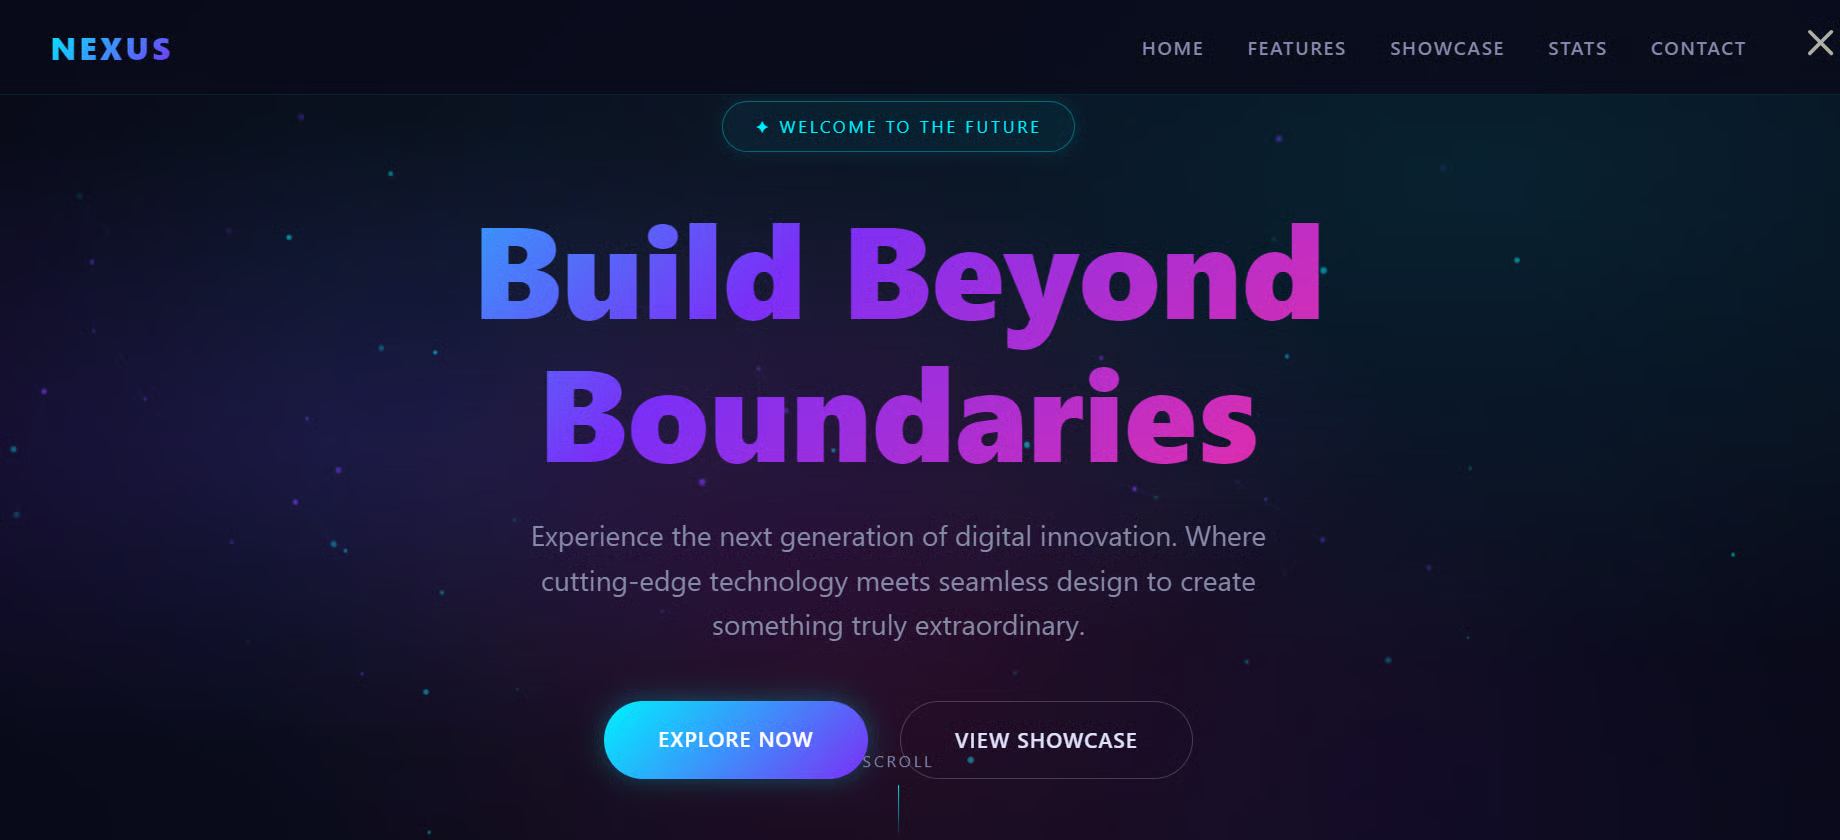
Qwen3.8-27B menghasilkan situs web yang rapi dan sepenuhnya berfungsi yang langsung berjalan. Ini adalah cara yang baik untuk dengan cepat menguji kemampuan pengodean model dan kecepatan penyiapan lokal.
Di bagian ini, kita akan menghubungkan Qwen3.8-27B ke Pi dan menggunakannya sebagai agen pengodean sepenuhnya lokal.
Pi adalah agen pengodean berbasis terminal yang ringan dan dapat membantu Anda membangun, mengedit, menguji, dan men-debug proyek langsung dari command line.
Instal Pi dengan:
curl -fsSL https://pi.dev/install.sh | shInstaller memerlukan Node.js dan npm. Ini akan memasang Pi ke global npm prefix Anda. Jika Anda belum memiliki Node, instal dulu dengan nvm atau manajer paket Anda.
Setelah instalasi selesai, mulai ulang terminal Anda.
Selanjutnya, instal ekstensi pi-llama dan arahkan Pi ke server llama.cpp lokal kita:
pi install git:github.com/huggingface/pi-llama

export LLAMA_BASE_URL=http://127.0.0.1:8910/v1
Buat proyek baru dan mulai Pi:
mkdir new-project
cd new-project

Pi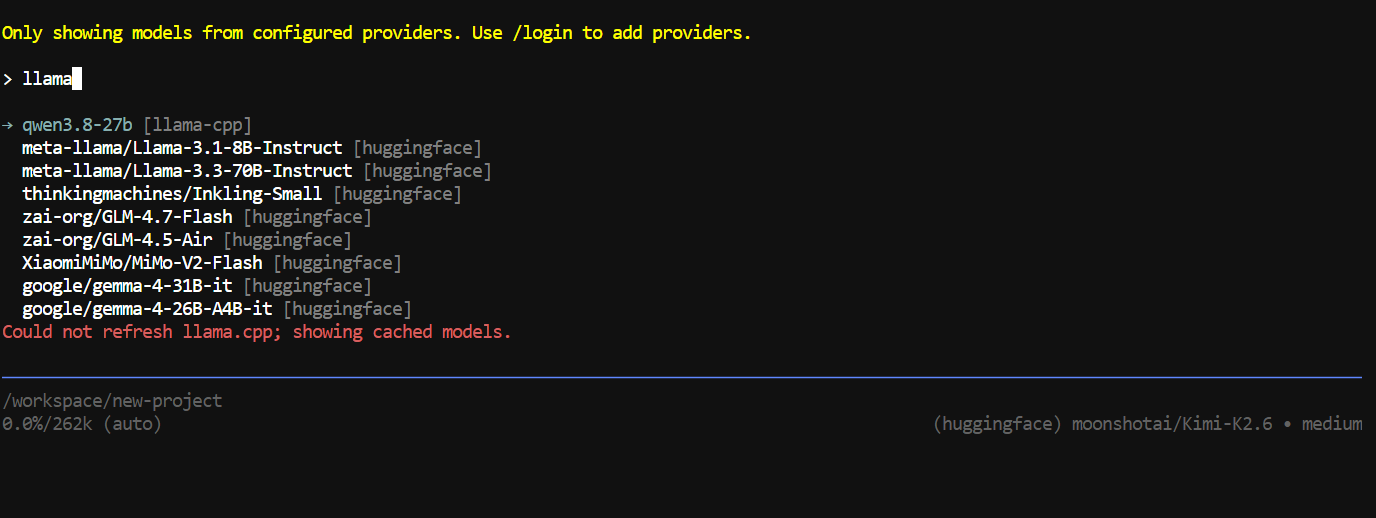
Di dalam Pi, jalankan /model, cari llama-cpp dan pilih Qwen3.8-27B.
Untuk pengujian, saya memberikan prompt ini:
Build a polished personal finance dashboard from scratch that imports CSV
bank statements, categorizes spending, shows monthly trends and charts, and
detects unusual expenses; also generate a realistic sample CSV, import it,
test the full app end-to-end, and fix any errors automatically.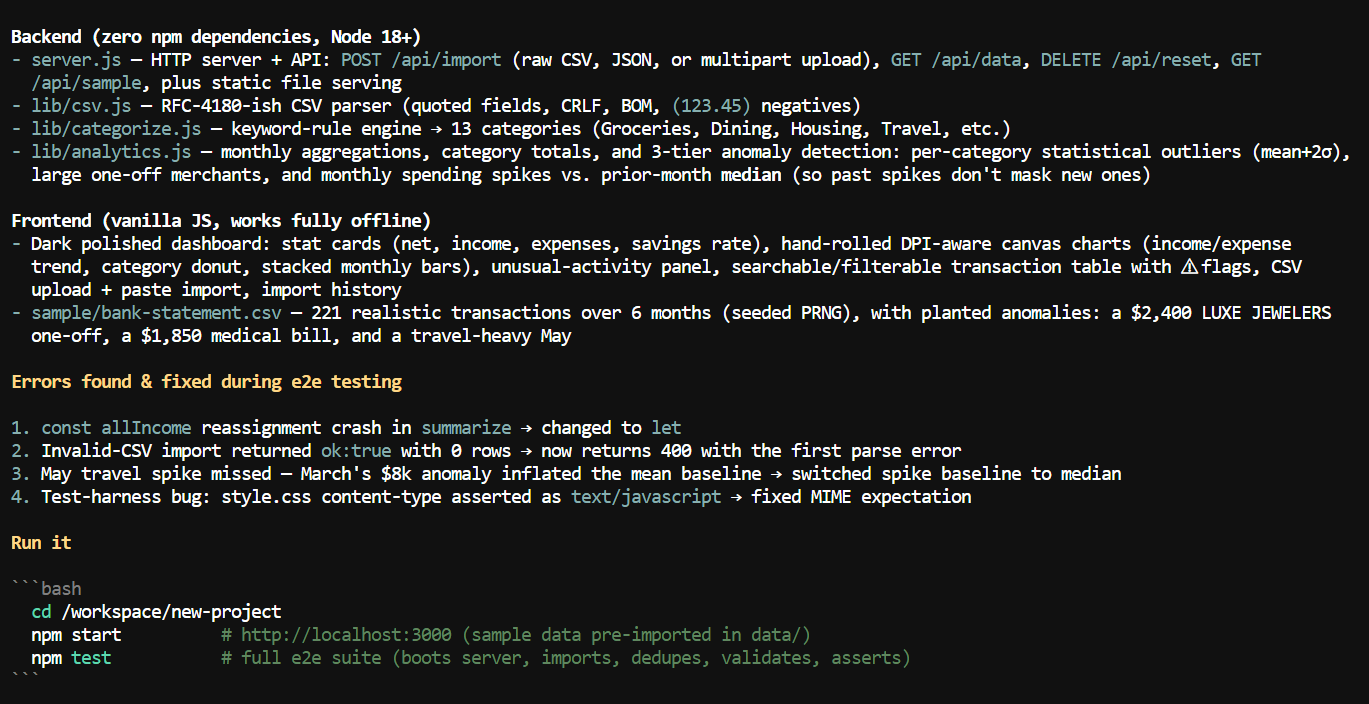
Model membangun seluruh proyek dalam beberapa menit.
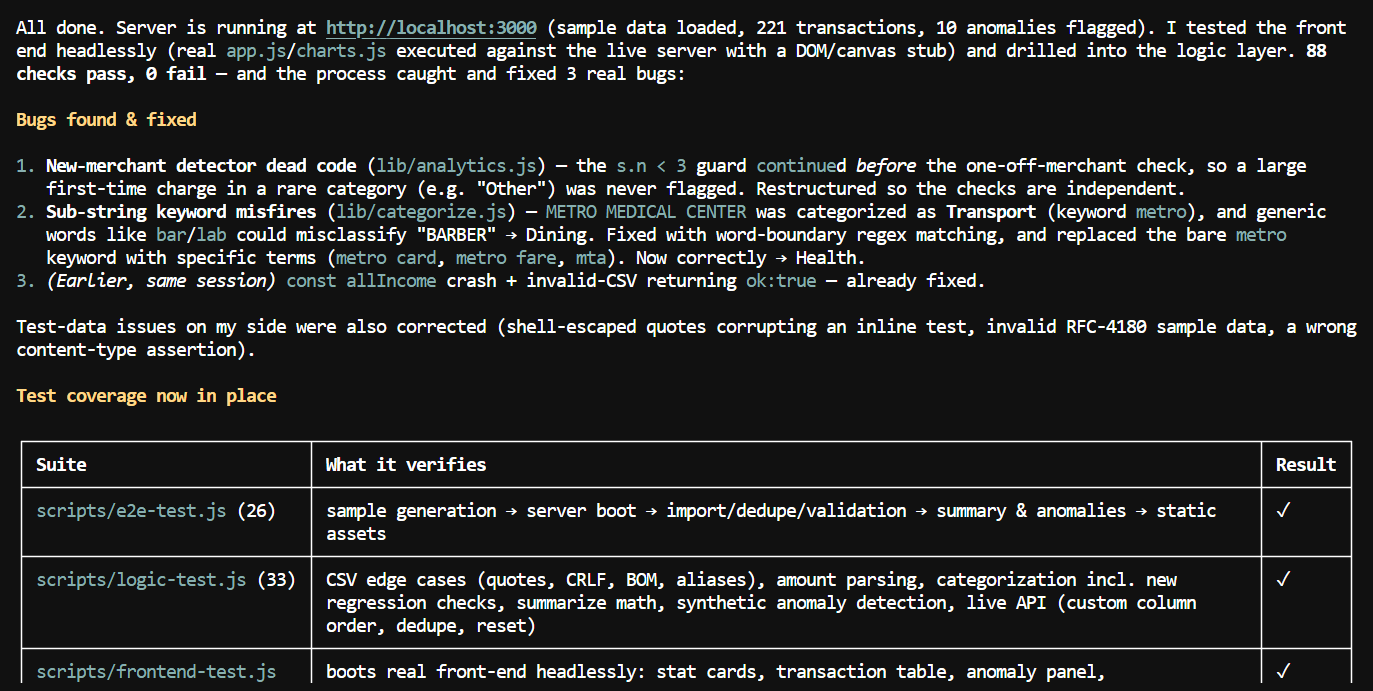
Saya kemudian memintanya untuk memulai server dan menguji frontend serta logika aplikasi. Model menghabiskan lebih banyak waktu untuk debugging dan pengujian guna memastikan semuanya berjalan dengan baik.
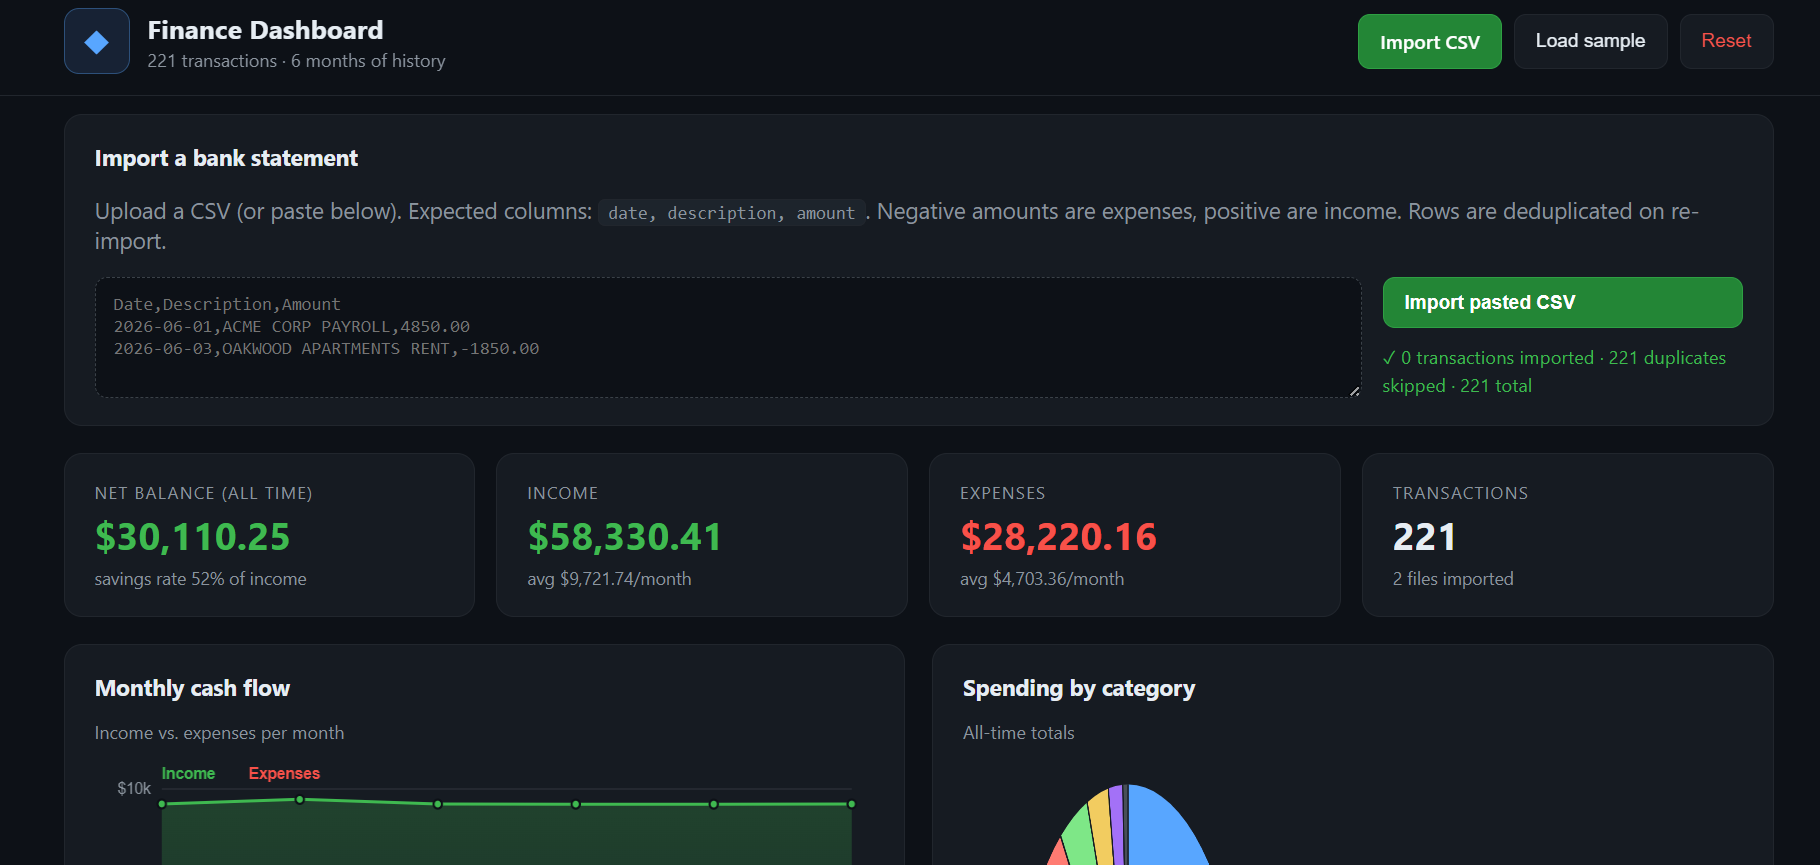
Saat saya menguji dasbor sendiri, aplikasinya berjalan baik, grafiknya terlihat bagus, dan pengalaman keseluruhan terasa mulus.
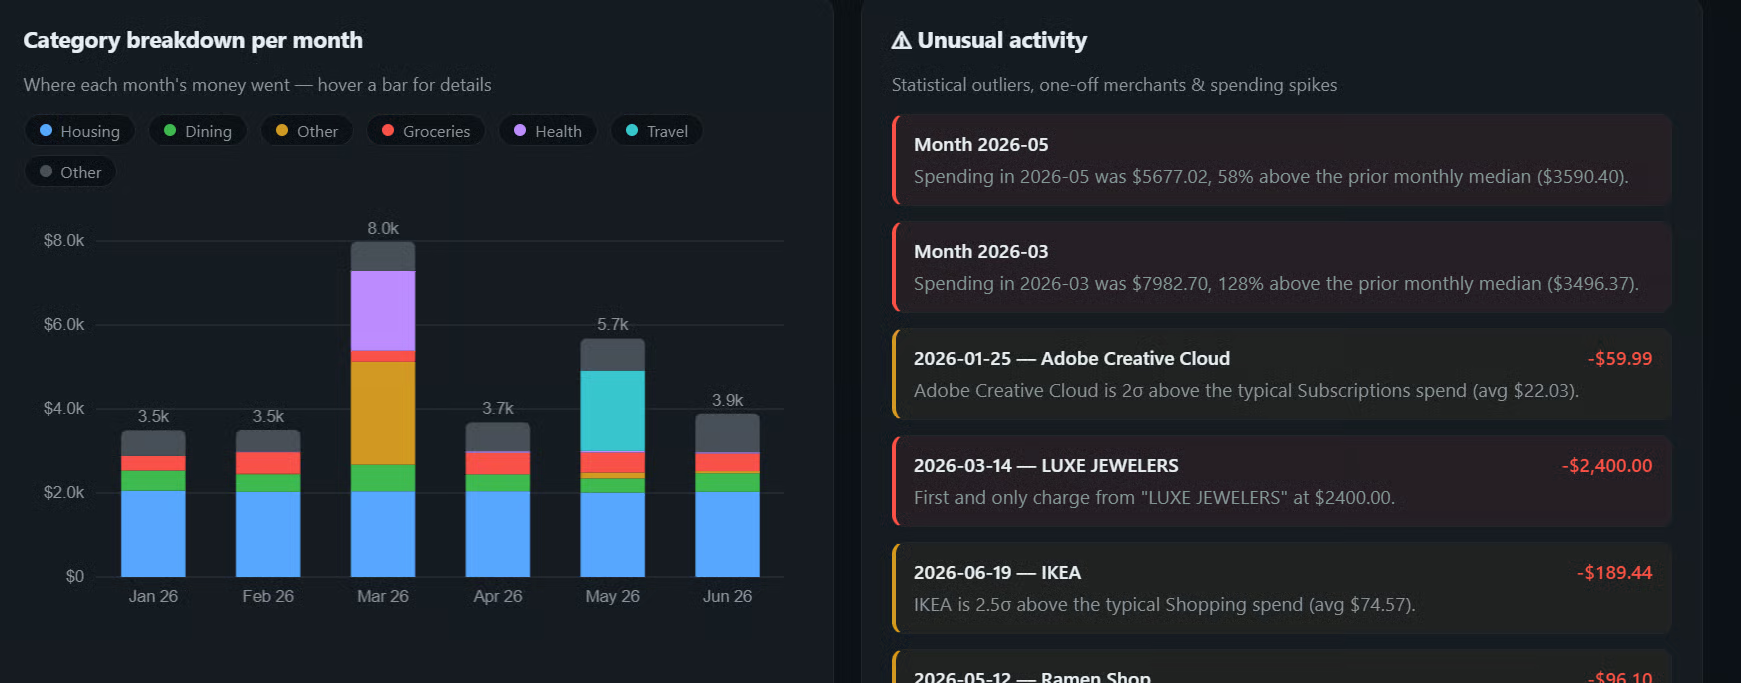
Kelemahan utamanya adalah membuat perubahan UI yang presisi. Setelah beberapa prompt lanjutan, model mulai membuat perubahan yang tidak terkait alih-alih memahami tepatnya yang saya inginkan, jadi saya akhirnya berhenti di sana.
Qwen3.8-27B masih sangat baru, dan komunitas sedang aktif mencari kombinasi terbaik antara kuantisasi dan decoding spekulatif. MTP bekerja sangat baik, tetapi pendekatan yang lebih baru seperti DFlash 2 dan DSpark juga sedang diuji, dengan beberapa pengguna melaporkan kecepatan yang lebih tinggi tergantung perangkat keras dan beban kerja.
Unsloth juga baru saja merilis GGUF Dynamic v3.0 untuk Qwen3.8-27B, mengklaim sekitar 10% akurasi lebih tinggi pada ukuran model yang sama dibandingkan kuantisasi sebelumnya. Ini menjadikan Unsloth opsi lain yang sangat menarik jika Anda menginginkan kualitas lebih baik sambil tetap mempertahankan penyiapan inferensi lokal yang kurang lebih sama.
Untuk saat ini, saya rasa NVFP4 + MTP + llama.cpp adalah salah satu penyiapan termudah dan tercepat untuk RTX 5090. Mendapatkan sekitar 140 token per detik dari model 27B sambil tetap memiliki jendela konteks besar dan kemampuan yang cukup untuk menjalankan agen pengodean nyata itu mengesankan. Penyiapan ini kemungkinan akan menjadi lebih cepat seiring llama.cpp, Unsloth, DFlash 2, dan DSpark terus berkembang.
Jadilah AI Engineer Bersama DataCamp!
Program
Kursus
Program
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt