Weiter zum Inhalt

Qwen3.8-27B lokal auf einer NVIDIA RTX 5090 ausführen

Lerne, wie du Qwen3.8-27B lokal mit Blackwell-nativem NVFP4 und MTP-Spekulations-Decoding betreibst – mit bis zu 170 Tokens pro Sekunde in llama.cpp.
Aktualisiert 31. Aug. 2026  · 6 Min. lesen

Mit KI erkunden

ChatGPTClaudePerplexity

Qwen3.8-27B entwickelt sich rasant zu einem der beliebtesten Modelle für lokale KI. Trotz nur 27 Milliarden Parametern liefert es Leistung, die mit deutlich größeren Modellen bei Coding-, Reasoning-, Agenten- und General-Purpose-Benchmarks mithalten kann. In mehreren Bereichen nähert es sich sogar Modellen wie GLM-5.2 an – besonders spannend für alle, die mit starker lokaler Hardware experimentieren.

Die RTX 5090 passt besonders gut zu Qwen3.8-27B, weil ihre Blackwell-Architektur NVFP4 unterstützt. So läuft das Modell extrem schnell bei gleichzeitig hoher Ausgabequalität. In Kombination mit spekulativem Decoding via Multi-Token Prediction (MTP), einem optimierten llama.cpp-Build und dem passenden GGUF-Modell schafft Qwen3.8-27B auf einer einzelnen RTX 5090 weit über 100 Tokens pro Sekunde.

In diesem Guide richten wir einen der einfachsten Wege ein, um auf einer RTX 5090 oder einer anderen Blackwell-GPU ein optimales Verhältnis aus Geschwindigkeit, Genauigkeit und Langkontext zu bekommen. Wir kompilieren llama.cpp mit nativer Blackwell-Unterstützung, laden das Qwen3.8-27B NVFP4-MTP-GGUF, starten es mit GPU-Beschleunigung und MTP-Spekulations-Decoding, testen die OpenAI-kompatible API und das integrierte Webinterface und verbinden es schließlich mit Pi, um Qwen3.8-27B als vollständig lokalen Coding-Agenten zu nutzen.

Schau dir außerdem unseren Guide zu Qwen3.8-Flash-Next, der Vorschau auf Qwen4, sowie das Tutorial zum lokalen Ausführen von Qwen3.8-Flash-Next an.

Associate AI Engineer für Datenwissenschaftler

Trainiere und stimme die neuesten KI-Modelle für die Produktion ab, einschließlich LLMs wie Llama 3. Beginne deine Reise zum KI-Ingenieur noch heute!
Lernpfad Erkunden

1. llama.cpp für Blackwell-GPUs einrichten

Zuerst stellen wir sicher, dass die GPU korrekt erkannt wird, und prüfen die NVIDIA-Treiber- sowie CUDA-Version.

nvidia-smi
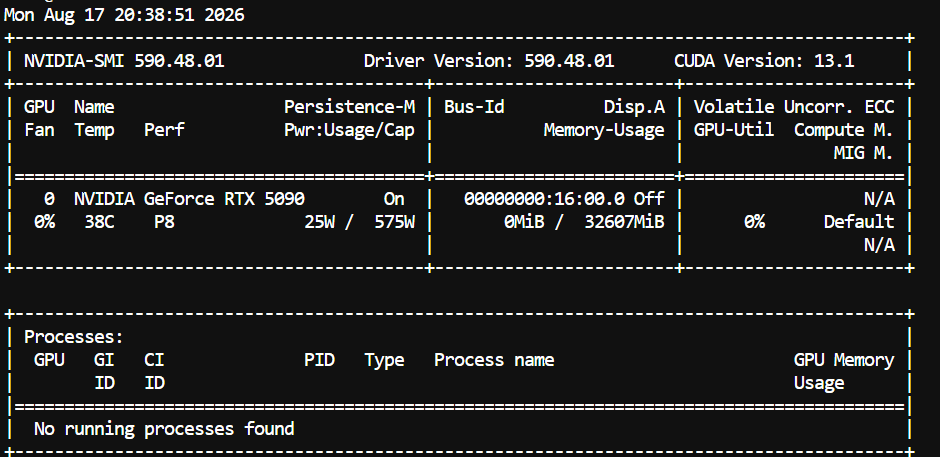
RTX 5090 GPU summary

Du solltest deine RTX 5090, die Treiberversion, die CUDA-Version, den GPU-Speicher und die aktuelle GPU-Auslastung sehen.

Hinweis: Dieses Setup ist speziell für NVIDIA-Blackwell-GPUs wie die RTX 5090. Der untenstehende Build zielt auf SM120 ab – die Compute-Architektur der RTX 5090.

Als Nächstes laden wir die aktuelle Version von llama.cpp herunter und kompilieren sie mit CUDA-Unterstützung.

cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp

cmake -B build \
  -DGGML_CUDA=ON \
  -DCMAKE_CUDA_ARCHITECTURES=120

cmake --build build --config Release -j$(nproc)
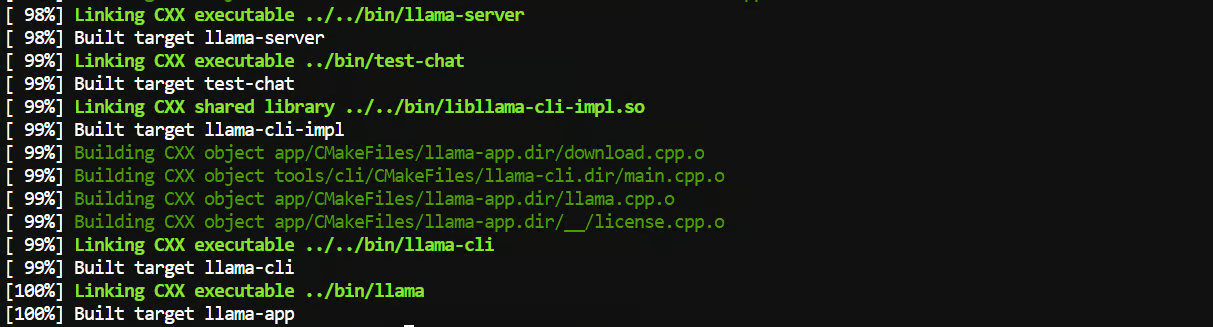
Building llama.cpp for the RTX 5090  GPU

Wichtig ist hier -DCMAKE_CUDA_ARCHITECTURES=120. Damit baut llama.cpp gezielt für die Blackwell-Architektur der RTX 5090.

Sobald der Build fertig ist, machen wir llama-server global verfügbar, damit wir es aus jedem Ordner starten können:

sudo ln -sf "$(realpath ./build/bin/llama-server)" /usr/local/bin/llama-server

Prüfe nun, ob alles läuft:

llama-server --version

Die Ausgabe sollte in etwa so aussehen:

version: 0.1.1-dev (build 10479, commit 0021a77de)
built with GNU 13.3.0 for Linux x86_64

Das war’s. Wir haben jetzt einen CUDA-fähigen llama.cpp-Build, der die RTX 5090 und ihr natives Blackwell-NVFP4 nutzt.

2. Qwen3.8-27B NVFP4-MTP-Modell herunterladen

Jetzt laden wir das Qwen3.8-27B-Modell herunter.

Installiere zuerst die Hugging Face CLI:

pip install -U huggingface_hub

Lege einen Ordner an, in dem wir das Modell ablegen:

mkdir -p /workspace/models/qwen38

Dann lade das NVFP4-MTP-GGUF:

hf download felippeburk/Qwen3.8-27B-NVFP4-MTP-GGUF \
  --local-dir /workspace/models/qwen38
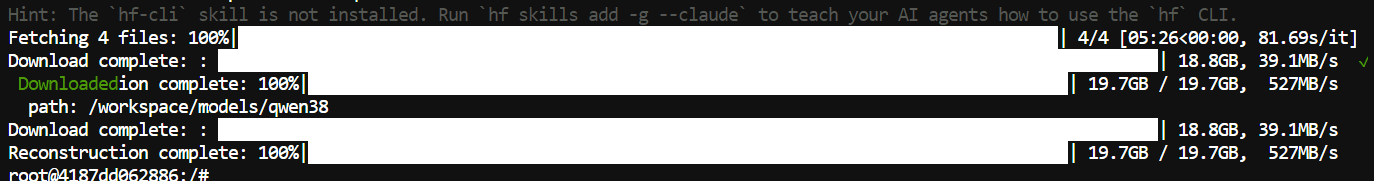
Downloading the Qwen3.8-27B-NVFP4-MTP-GGUF

Diese Version ist für unser Setup ideal, weil sie NVFP4 nutzt und MTP unterstützt – der Hauptgrund für den großen Geschwindigkeitsschub auf der RTX 5090.

3. Qwen3.8-27B-Server starten

Jetzt kommt der spannende Teil. Wir servieren Qwen3.8-27B vollständig auf der GPU – mit Flash Attention, einem 131K-Kontextfenster und MTP-Spekulations-Decoding für schnellere Generierung. 

Führe aus:

cd /workspace/llama.cpp

llama-server \
  -m /workspace/models/qwen38/qwen3.8-27b-text-nvfp4-mtp.gguf \
  --alias qwen3.8-27b \
  --host 0.0.0.0 \
  --port 8910 \
  --ctx-size 131072 \
  --n-gpu-layers all \
  --flash-attn on \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --parallel 1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 4 \
  --spec-draft-p-min 0.75 \
  --spec-draft-ngl all \
  --spec-draft-type-k q8_0 \
  --spec-draft-type-v q8_0 \
  --reasoning-effort medium \
  --jinja

Es gibt hier viele Optionen, aber die meisten dienen einfach dazu, das Maximum aus der 5090 herauszuholen.

Die wichtigsten sind:

  • --ctx-size 131072 gibt uns etwa ein 131K-Kontextfenster.

  • --n-gpu-layers all hält das Modell vollständig auf der GPU.

  • --flash-attn on aktiviert Flash Attention.

  • --cache-type-k q8_0 und --cache-type-v q8_0 reduzieren den Speicherbedarf des KV-Caches.

  • --spec-type draft-mtp schaltet das MTP-Spekulations-Decoding von Qwen3.8 ein.

  • --spec-draft-n-max 4 steuert, wie viele spekulative Tokens MTP auf einmal vorschlagen kann.

Für dieses Setup nutzen wir n-max 4 als Startwert für eine RTX 5090. Du kannst mit Werten wie 2 (vom Model-Card für dieses GGUF empfohlen) oder 3 experimentieren, da das schnellste Setting je nach System leicht variiert.

Sobald llama-server das Modell geladen hat, ist Qwen3.8 lokal unter http://127.0.0.1:8910 erreichbar.
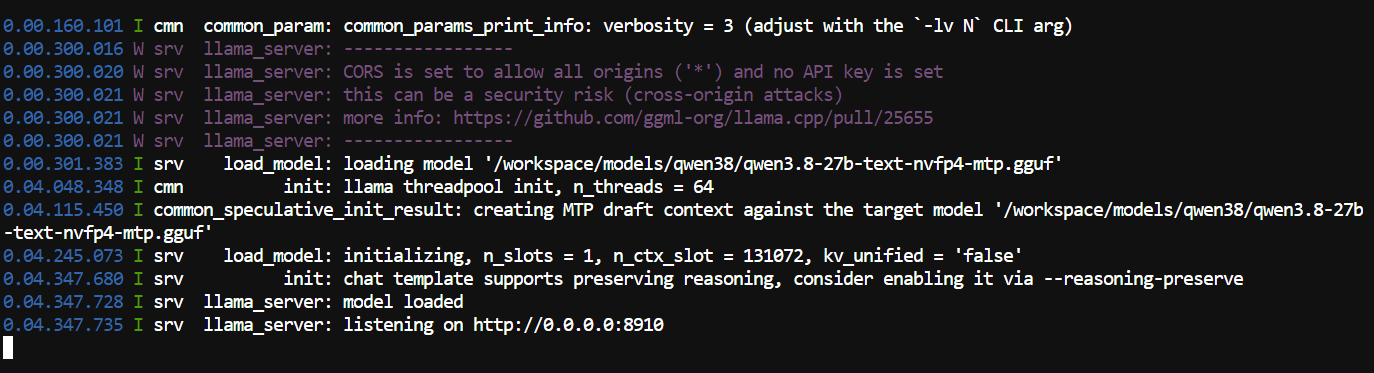
Serving the Qwen3.8-27B-NVFP4-MTP-GGUF using the llama.cpp

Qwen3.8-27B läuft jetzt lokal. Als Nächstes testen wir das Modell sowohl über die API als auch über die integrierte Browseroberfläche.

4. Geschwindigkeit und Coding-Performance von Qwen3.8-27B testen

Mit laufendem Server öffnest du ein weiteres Terminal und sendest eine Testanfrage an die OpenAI-kompatible API:

curl http://127.0.0.1:8910/v1/chat/completions \
 -H "Content-Type: application/json" \
 -d '{
   "model": "qwen3.8-27b",
   "messages": [
     {
       "role": "user",
       "content": "Write a Python FastAPI application that monitors GPU usage."
     }
   ],
   "max_tokens": 2000
 }'
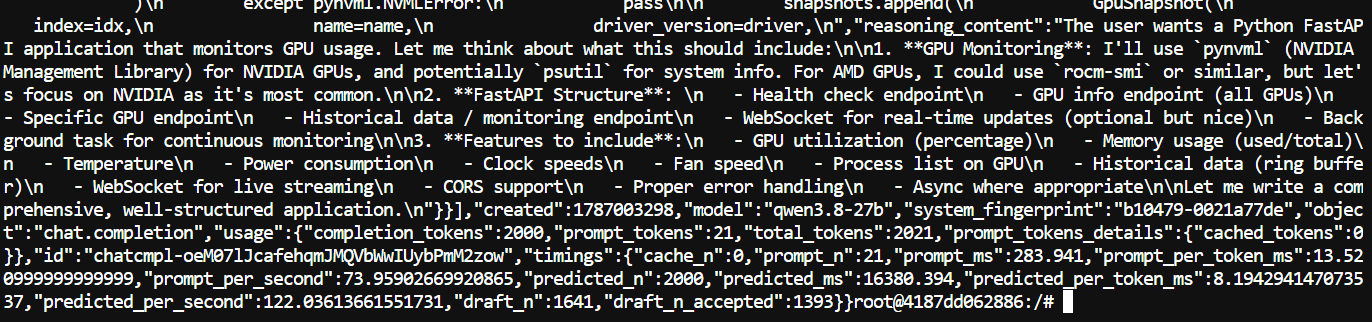
Testing the Qwen3.8-27B-NVFP4-MTP-GGUF using the CURL command

In diesem Test generierte Qwen3.8-27B 2.000 Tokens mit 122 Tokens/Sek. und einer beeindruckenden MTP-Akzeptanzrate von 84,9%. 

llama.cpp enthält auch ein Browser-Interface, sodass du das Modell ohne API testen kannst.

Öffne http://127.0.0.1:8910 in deinem Browser, um die UI zu sehen.
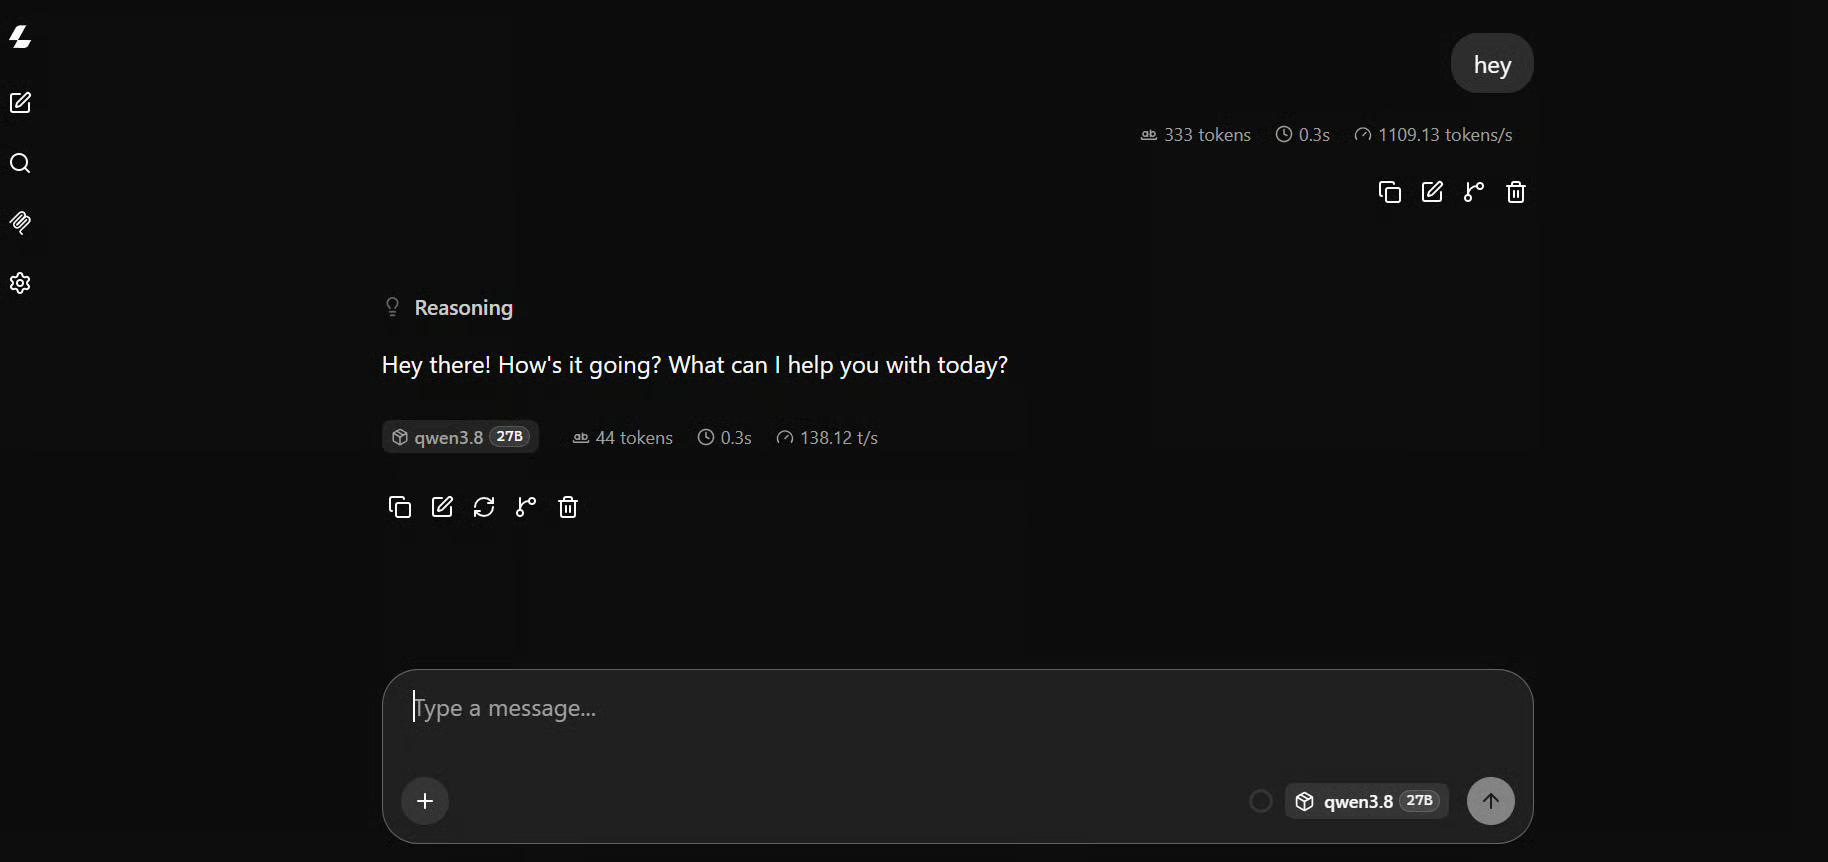
Testing the Qwen3.8-27B-NVFP4-MTP-GGUF inside the llama.cpp webui

Für einen komplexeren Test habe ich diesen Prompt genutzt:

Create a stunning single-file animated HTML website with a dark futuristic 
theme, smooth scrolling, glowing gradients, floating particles, animated cards,
hover effects, and responsive design using only HTML, CSS, and JavaScript.
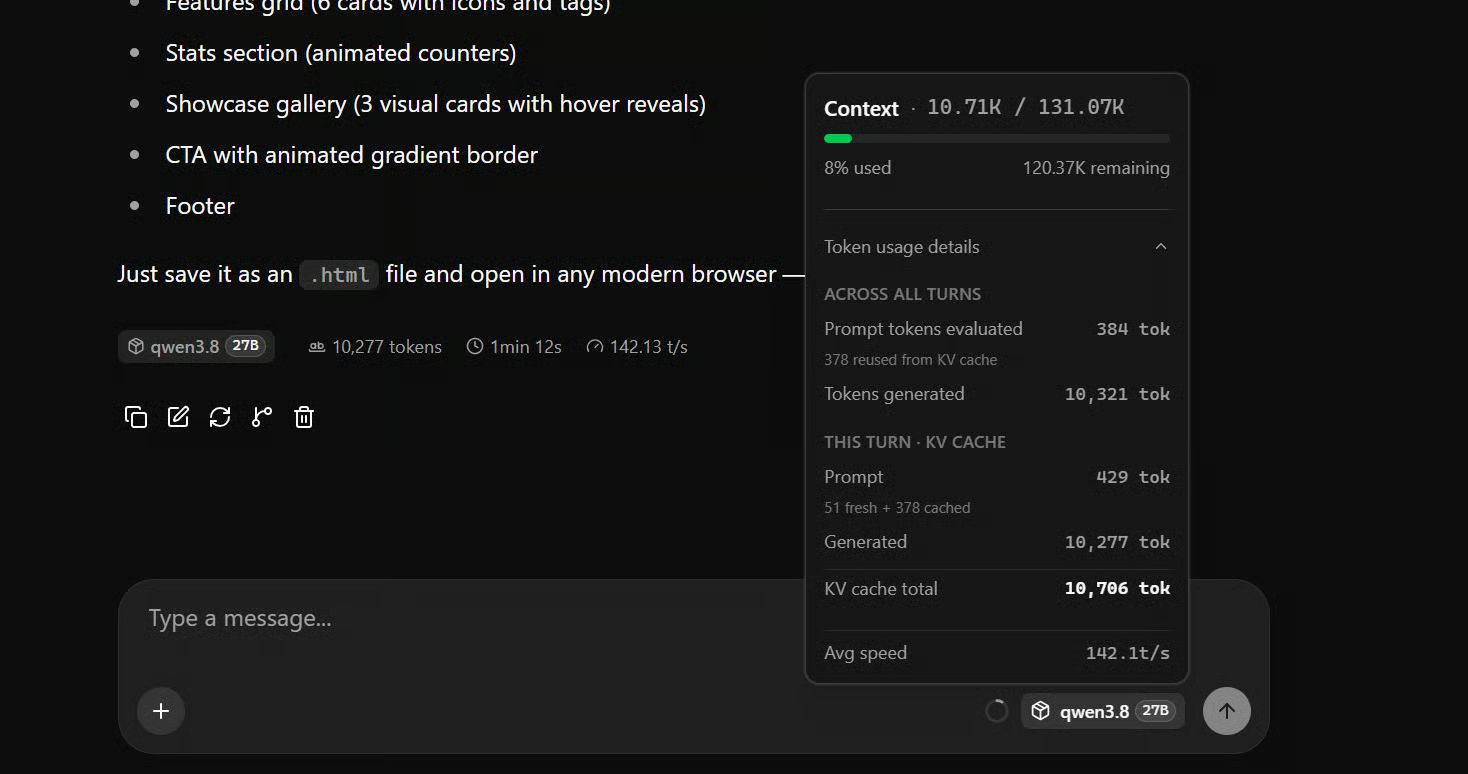
Testing the Qwen3.8-27B-NVFP4-MTP-GGUF inside the llama.cpp webui on coding task

Auf meiner RTX 5090 lag der Durchschnitt bei rund 142 Tokens pro Sekunde, mit Spitzen bis etwa 170 Tokens pro Sekunde – extrem schnell für ein lokales 27B-Modell. 
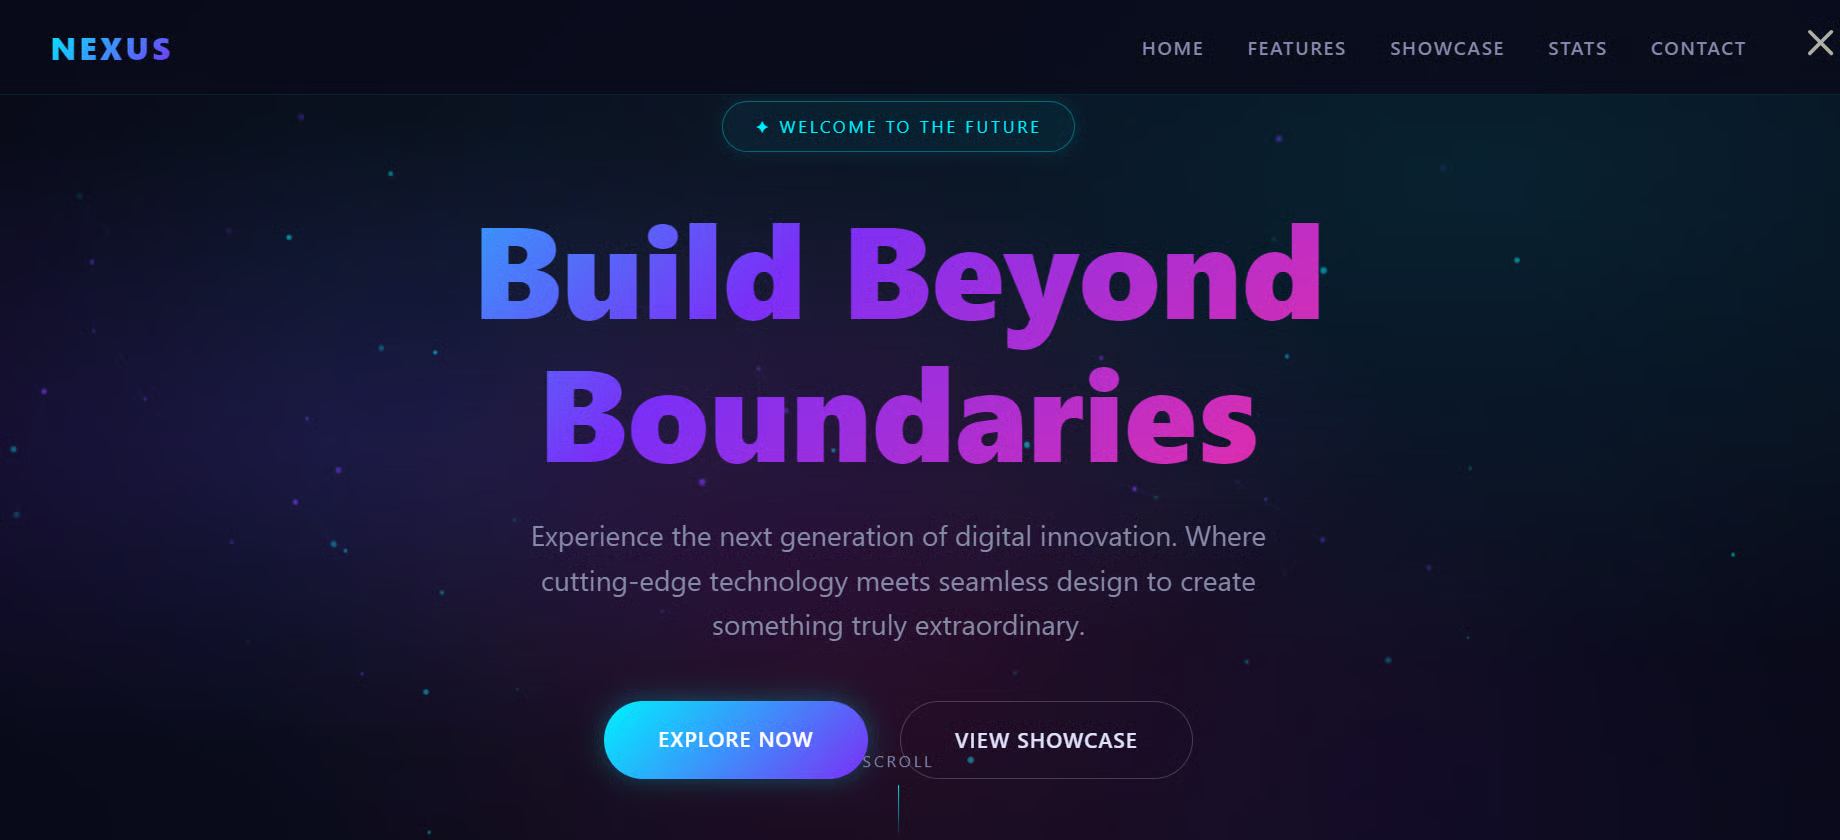
image4.png

Qwen3.8-27B erzeugte eine saubere, voll funktionsfähige Website, die sofort lief. So lässt sich sowohl die Coding-Fähigkeit des Modells als auch die Geschwindigkeit des lokalen Setups schnell testen. 

5. Qwen3.8-27B mit Pi nutzen

In diesem Abschnitt verbinden wir Qwen3.8-27B mit Pi und nutzen es als vollständig lokalen Coding-Agenten.

Pi ist ein schlanker, terminalbasierter Coding-Agent, der dir hilft, Projekte direkt in der Kommandozeile zu bauen, zu bearbeiten, zu testen und zu debuggen.

Installiere Pi mit:

curl -fsSL https://pi.dev/install.sh | sh

Der Installer benötigt Node.js und npm. Er installiert Pi in deinem globalen npm-Prefix. Falls du Node noch nicht hast, installiere es zuerst mit nvm oder deinem Paketmanager.

Starte nach Abschluss der Installation dein Terminal neu.

Installiere anschließend die pi-llama-Erweiterung und verweise Pi auf unseren lokalen llama.cpp-Server:

pi install git:github.com/huggingface/pi-llama

export LLAMA_BASE_URL=http://127.0.0.1:8910/v1

Erstelle ein neues Projekt und starte Pi:

mkdir new-project
cd new-project

Pi
Setting up the qwen3.8-27b in the Pi coding agent

Führe in Pi /model aus, suche nach llama-cpp und wähle Qwen3.8-27B.

Zum Testen habe ich diesen Prompt verwendet:

Build a polished personal finance dashboard from scratch that imports CSV 
bank statements, categorizes spending, shows monthly trends and charts, and 
detects unusual expenses; also generate a realistic sample CSV, import it, 
test the full app end-to-end, and fix any errors automatically.
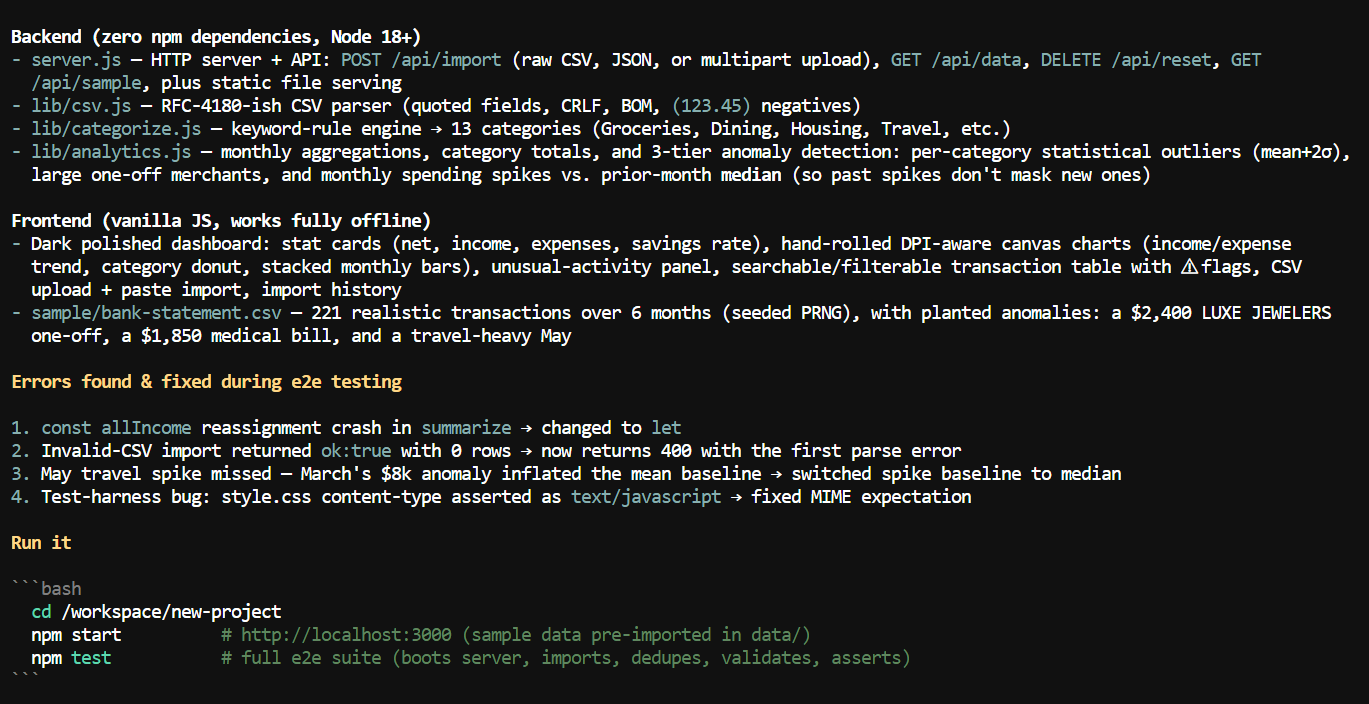
Testing the qwen3.8-27b model with Pi coding agent

Das komplette Projekt war in wenigen Minuten gebaut. 
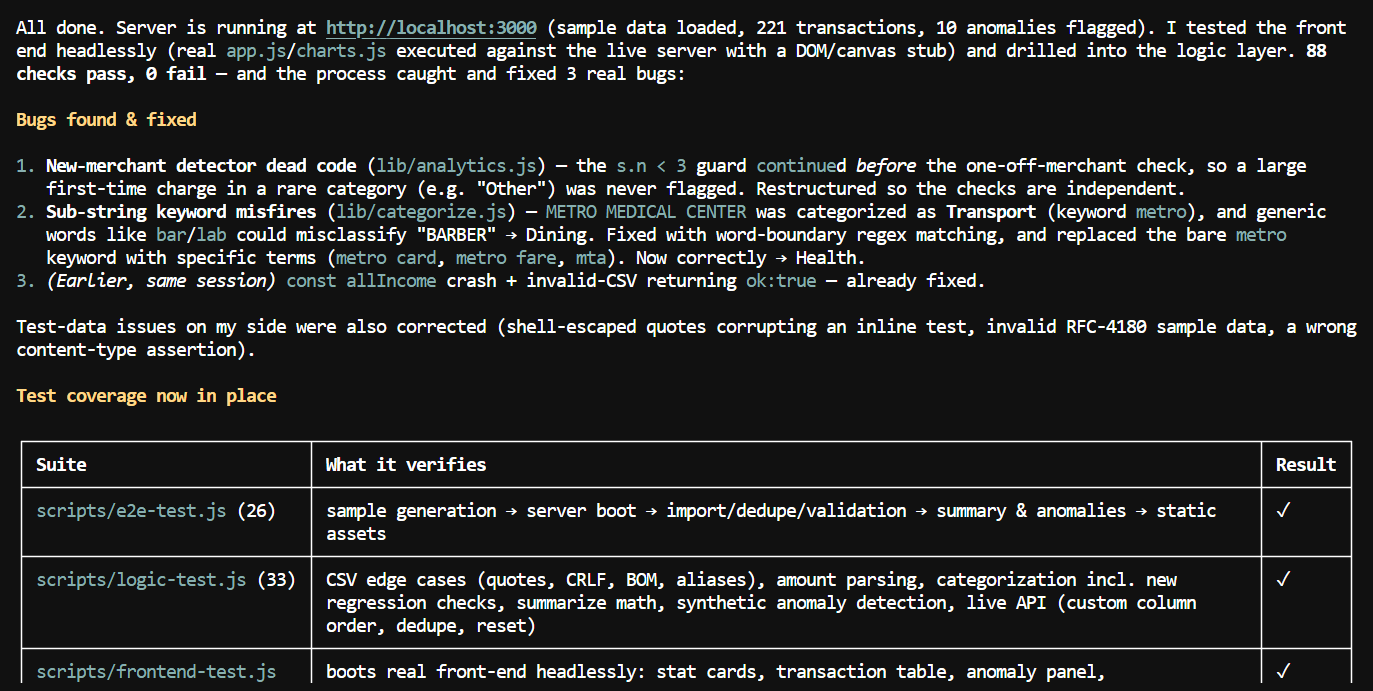
Testing the qwen3.8-27b model with Pi coding agent

Anschließend ließ ich den Server starten und sowohl Frontend als auch Logik testen. Es verbrachte mehr Zeit mit Debugging und Tests, um sicherzugehen, dass alles korrekt läuft.
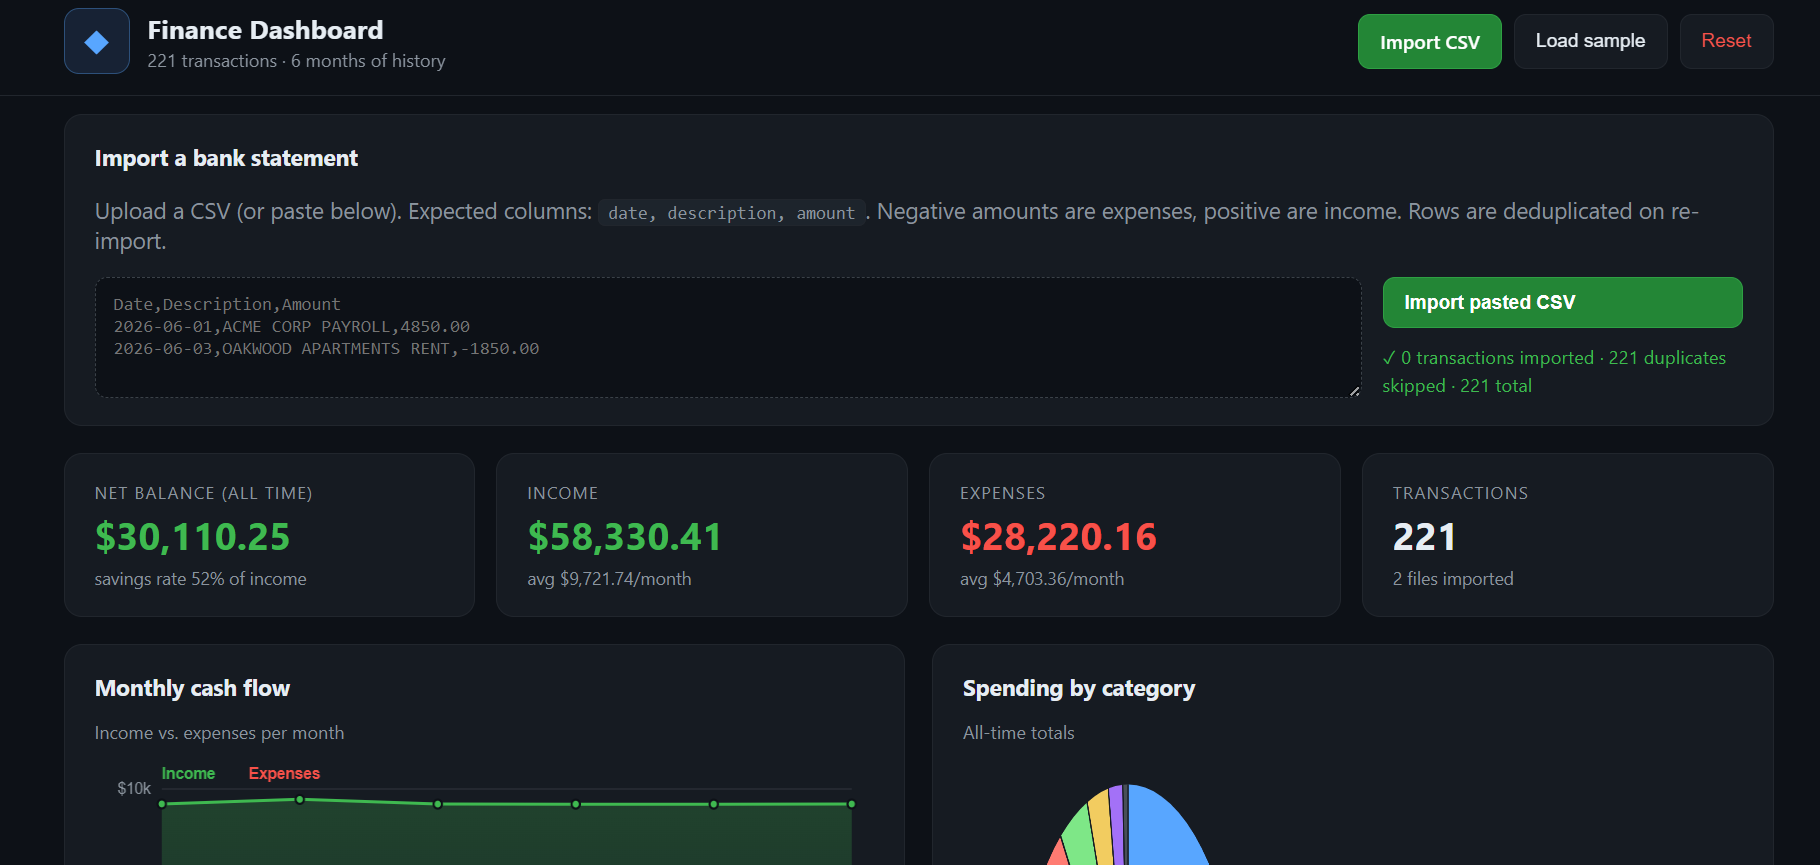
web dashboard generated with qwen3.8-27b model and Pi coding agent

Im eigenen Test lief das Dashboard gut, die Diagramme sahen stark aus und das Gesamterlebnis war rund.
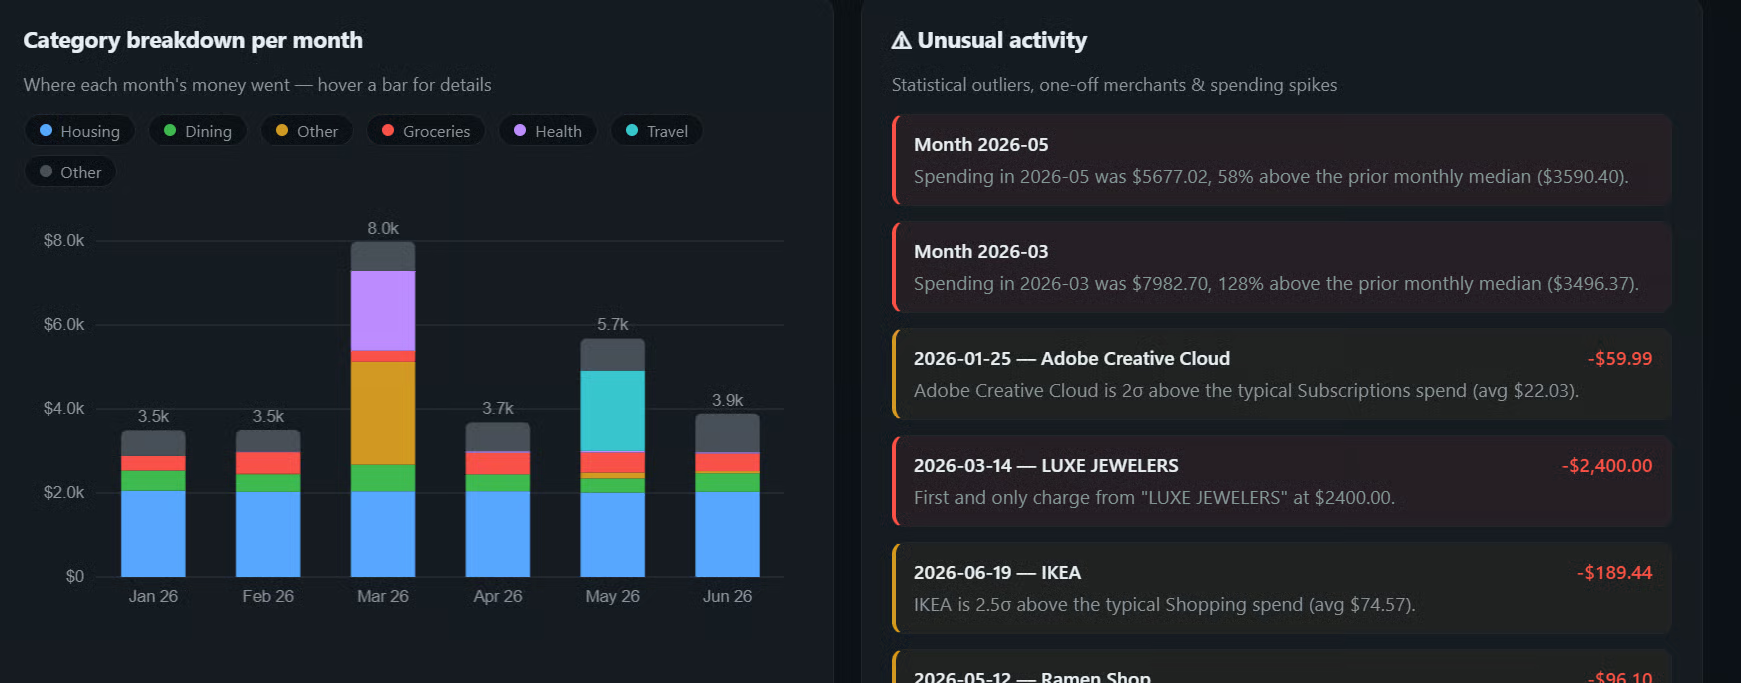
web dashboard generated with qwen3.8-27b model and Pi coding agent

Die größte Schwäche waren präzise UI-Anpassungen. Nach mehreren Nachfragen nahm es teils unzusammenhängende Änderungen vor, statt genau zu verstehen, was ich wollte – dort habe ich schließlich aufgehört.

Fazit

Qwen3.8-27B ist noch sehr neu, und die Community lotet aktiv die beste Kombination aus Quantisierung und spekulativem Decoding aus. MTP funktioniert extrem gut, aber neuere Ansätze wie DFlash 2 und DSpark werden ebenfalls getestet – teils mit noch höheren Geschwindigkeiten, abhängig von Hardware und Workload. 

Unsloth hat außerdem gerade Dynamic v3.0-GGUFs für Qwen3.8-27B veröffentlicht und beansprucht etwa 10% höhere Genauigkeit bei gleicher Modellgröße gegenüber den bisherigen Quants. Wenn du bei ähnlichem lokalen Inference-Setup mehr Qualität willst, ist Unsloth damit eine sehr interessante Option. 

Aktuell halte ich NVFP4 + MTP + llama.cpp für eines der einfachsten und schnellsten Setups auf einer RTX 5090. Rund 140 Tokens pro Sekunde aus einem 27B-Modell, dazu ein großes Kontextfenster und genug Fähigkeiten für einen echten Coding-Agenten – das ist beeindruckend. Mit weiteren Verbesserungen bei llama.cpp, Unsloth, DFlash 2 und DSpark dürfte das Setup noch schneller werden.

FAQs zur lokalen Ausführung von Qwen3.8-27B

Brauchst du eine RTX 5090, um Qwen3.8-27B lokal auszuführen?

Nein. Standard-4-Bit-GGUF-Quants von Qwen3.8-27B passen in etwa 16–19 GB VRAM, daher laufen das Modell auch auf einer RTX 5080, einer 4090 oder einem Mac mit 24 GB. Die RTX 5090 ist für dieses spezielle Setup wichtig, weil NVFP4 Blackwell-Tensor-Cores benötigt. Auf älteren Karten laufen NVFP4-Dateien zwar, bringen aber nur die Speichereinsparung, nicht den Speedup.

Wie viel VRAM benötigt diese Konfiguration tatsächlich?

Das NVFP4-MTP-GGUF belegt rund 19 GB auf der Platte, und der KV-Cache treibt den Gesamtbedarf mit wachsendem Kontext nach oben. Mit q8_0-K/V-Quantisierung bei sehr langem Kontext landen veröffentlichte RTX-5090-Runs in der mittleren 20-GB-Spanne, eine 32-GB-Karte ist also komfortabel. Mit 24 GB musst du --ctx-size deutlich unter 131072 setzen.

Was macht MTP-Spekulations-Decoding, und ist es verlustfrei?

Qwen3.8 enthält MTP-Schichten direkt im GGUF, die als integriertes Draft-Modell fungieren – es wird keine zweite Datei benötigt. Der Draft-Head schlägt mehrere Tokens zugleich vor, das Vollmodell verifiziert sie. Akzeptierte Drafts kosten nur einen Bruchteil eines normalen Forward-Passes. Die Ausgabequalität bleibt unverändert, weil jedes akzeptierte Token eines ist, das das Hauptmodell ohnehin erzeugt hätte.

Solltest du NVFP4 oder ein reguläres Q4_K_M-Quant nutzen?

Wähle NVFP4, wenn du eine Blackwell-GPU hast und maximale Geschwindigkeit willst; wähle ein Standard-GGUF wie Q4_K_M oder Unsloths UD-Q4_K_XL, wenn du auf Ampere oder Ada bist oder dir Qualität pro Gigabyte wichtiger ist. NVFP4-Unterstützung in llama.cpp ist zudem jünger als der K-Quant-Pfad – rechne also mit mehr Ecken und Kanten bei Konvertierung und Tools.

Kann dieses Setup mit Bildern umgehen, da Qwen3.8-27B ein Vision-Modell ist?

Qwen3.8-27B ist ein natives Vision-Language-Modell, aber text-only-GGUF-Konvertierungen entfernen den Vision-Tower. Um Bilder zu nutzen, musst du einen multimodalen Projektor mit --mmproj neben dem Modell laden – in der Regel die mmproj-Datei aus demselben Repo oder aus Unsloths GGUF-Repo.


Abid Ali Awan's photo
Author
Abid Ali Awan
LinkedIn
Twitter

Als zertifizierter Data Scientist ist es meine Leidenschaft, modernste Technologien zu nutzen, um innovative Machine Learning-Anwendungen zu entwickeln. Mit meinem fundierten Hintergrund in den Bereichen Spracherkennung, Datenanalyse und Reporting, MLOps, KI und NLP habe ich meine Fähigkeiten bei der Entwicklung intelligenter Systeme verfeinert, die wirklich etwas bewirken können. Neben meinem technischen Fachwissen bin ich auch ein geschickter Kommunikator mit dem Talent, komplexe Konzepte in eine klare und prägnante Sprache zu fassen. Das hat dazu geführt, dass ich ein gefragter Blogger zum Thema Datenwissenschaft geworden bin und meine Erkenntnisse und Erfahrungen mit einer wachsenden Gemeinschaft von Datenexperten teile. Zurzeit konzentriere ich mich auf die Erstellung und Bearbeitung von Inhalten und arbeite mit großen Sprachmodellen, um aussagekräftige und ansprechende Inhalte zu entwickeln, die sowohl Unternehmen als auch Privatpersonen helfen, das Beste aus ihren Daten zu machen.

Themen
Künstliche Intelligenz

Werde AI Engineer mit DataCamp!

Lernpfad

Associate AI Engineer für Entwickler

26 Std.
Lerne, wie du KI mithilfe von APIs und Open-Source-Bibliotheken in Softwareanwendungen integrierst. Starte noch heute deine Reise zum AI Engineer!
Details anzeigenRight Arrow
Kurs Starten
Mehr anzeigenRight Arrow
Verwandt

Blog

Die 36 wichtigsten Fragen und Antworten zum Thema generative KI für 2026

Dieser Blog hat eine ganze Reihe von Fragen und Antworten zu generativer KI, von den Grundlagen bis hin zu fortgeschrittenen Themen.
Hesam Sheikh Hassani's photo

Hesam Sheikh Hassani

15 Min.

Blog

Q2 2023 DataCamp Donates Digest

DataCamp Donates hat im zweiten Quartal 2023 über 20.000 Stipendien an unsere gemeinnützigen Partner vergeben. Erfahre, wie fleißige benachteiligte Lernende diese Chancen in lebensverändernde berufliche Erfolge verwandelt haben.
Nathaniel Taylor-Leach's photo

Nathaniel Taylor-Leach

Blog

Top 50+ AWS-Interviewfragen und Antworten für 2026

Ein kompletter Guide mit grundlegenden, fortgeschrittenen und szenariobasierten AWS-Interviewfragen – mit Beispielen aus der Praxis.
Zoumana Keita 's photo

Zoumana Keita

15 Min.

Tutorial

Zahlen in Python quadrieren: Grundlagen und fortgeschrittene Methoden

Quadrieren in Python ist einfach: Nutze den eingebauten Operator ** oder setze für vielseitigere Lösungen NumPy, pow(), math.pow(), Bitoperatoren und weitere Funktionen ein.
Allan Ouko's photo

Allan Ouko

11 Min.

Tutorial

30 coole Python-Tricks für besseren Code mit Beispielen

Wir haben 30 coole Python-Tricks zusammengestellt, mit denen du deinen Code verbesserst und deine Python-Kompetenzen ausbaust.
Kurtis Pykes 's photo

Kurtis Pykes

15 Min.

Tutorial

Fibonacci-Folge in Python: Lerne und entdecke Programmiertechniken

Finde raus, wie die Fibonacci-Folge funktioniert. Schau dir die mathematischen Eigenschaften und die Anwendungen in der echten Welt an.
Laiba Siddiqui's photo

Laiba Siddiqui

6 Min.

Mehr AnzeigenMehr Anzeigen