Program
Geliştiriciler için Yardımcı Yapay Zeka Mühendisi
26 sa
Önce GPU’nun doğru algılandığından emin olacak ve NVIDIA sürücüsünü ile CUDA sürümünü kontrol edeceğiz.
nvidia-smi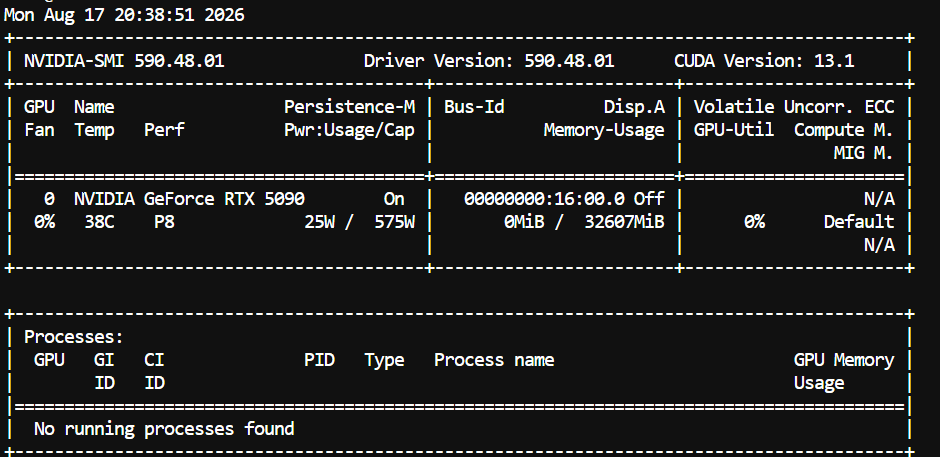
RTX 5090’unuzu, sürüm numarasını, CUDA sürümünü, GPU belleğini ve mevcut GPU kullanımını görmelisiniz.
Not: Bu kurulum, RTX 5090 gibi NVIDIA Blackwell GPU’larına özeldir. Aşağıdaki derleme, RTX 5090’un kullandığı hesaplama mimarisi olan SM120’yi hedefler.
Sonraki adımda, llama.cpp’nin en son sürümünü CUDA desteğiyle indirip derleyeceğiz.
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp

cmake -B build \
  -DGGML_CUDA=ON \
  -DCMAKE_CUDA_ARCHITECTURES=120

cmake --build build --config Release -j$(nproc)
Buradaki kritik kısım -DCMAKE_CUDA_ARCHITECTURES=120. Bu, llama.cpp’ye RTX 5090’un kullandığı Blackwell mimarisi için özel olarak derleme yapmasını söyler.
Derleme tamamlandığında, llama-server’ı global olarak kullanılabilir hale getirip herhangi bir klasörden çalıştıracağız:
sudo ln -sf "$(realpath ./build/bin/llama-server)" /usr/local/bin/llama-serverŞimdi her şeyin çalıştığını kontrol edin:
llama-server --versionŞuna benzer bir çıktı almalısınız:
version: 0.1.1-dev (build 10479, commit 0021a77de)
built with GNU 13.3.0 for Linux x86_64
Bu kadar. Artık RTX 5090 ve yerel Blackwell NVFP4 desteğinden yararlanabilen CUDA etkin bir llama.cpp derlememiz var.
Şimdi Qwen3.8-27B modelini indireceğiz.
Önce Hugging Face CLI’ı kurun:
pip install -U huggingface_hubModeli saklayacağımız bir klasör oluşturun:
mkdir -p /workspace/models/qwen38Ardından NVFP4-MTP GGUF’u indirin:
hf download felippeburk/Qwen3.8-27B-NVFP4-MTP-GGUF \
  --local-dir /workspace/models/qwen38
Bu kurulum için istediğimiz sürüm budur; çünkü NVFP4 kullanır ve MTP desteğini içerir. RTX 5090’da hız artışının büyük kısmı buradan gelir.
Şimdi işin eğlenceli kısmına geldik. Qwen3.8-27B’yi tamamen GPU üzerinde, Flash Attention, 131K bağlam penceresi ve daha hızlı üretim için MTP spekülatif kod çözme ile sunacağız.
Şunu çalıştırın:
cd /workspace/llama.cpp

llama-server \
  -m /workspace/models/qwen38/qwen3.8-27b-text-nvfp4-mtp.gguf \
  --alias qwen3.8-27b \
  --host 0.0.0.0 \
  --port 8910 \
  --ctx-size 131072 \
  --n-gpu-layers all \
  --flash-attn on \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --parallel 1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 4 \
  --spec-draft-p-min 0.75 \
  --spec-draft-ngl all \
  --spec-draft-type-k q8_0 \
  --spec-draft-type-v q8_0 \
  --reasoning-effort medium \
  --jinja
Burada çok sayıda seçenek var; ancak çoğu, 5090’dan en iyi performansı almak için bulunuyor.
Bilmeniz gereken başlıca seçenekler:
--ctx-size 131072 bize yaklaşık 131K’lık bir bağlam penceresi verir.
--n-gpu-layers all modeli GPU üzerinde tutar.
--flash-attn on Flash Attention’ı etkinleştirir.
--cache-type-k q8_0 ve --cache-type-v q8_0 KV önbellek bellek kullanımını azaltmaya yardımcı olur.
--spec-type draft-mtp Qwen3.8’in MTP spekülatif kod çözmesini etkinleştirir.
--spec-draft-n-max 4 MTP’nin aynı anda kaç spekülatif token üretebileceğini kontrol eder.
Bu kurulumda, RTX 5090 için başlangıç noktası olarak n-max 4 kullanıyoruz. Model kartının bu GGUF için önerdiği 2 veya daha sonra 3 gibi değerlerle deney yapabilirsiniz; zira en hızlı ayar sisteminize göre biraz değişebilir.
Model yüklemesini llama-server tamamladığında, Qwen3.8 yerelde http://127.0.0.1:8910 adresinde kullanılabilir olacaktır.
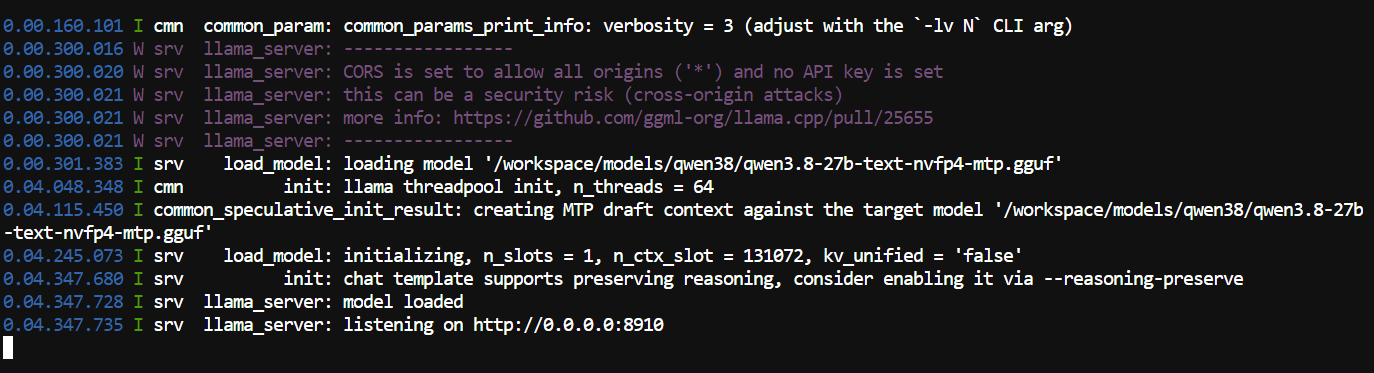
Artık Qwen3.8-27B yerelde çalışıyor. Sırada modeli hem API hem de yerleşik tarayıcı arayüzü üzerinden test etmek var.
Sunucu çalışırken başka bir terminal açın ve OpenAI uyumlu API’ye bir test isteği gönderin:
curl http://127.0.0.1:8910/v1/chat/completions \
 -H "Content-Type: application/json" \
 -d '{
   "model": "qwen3.8-27b",
   "messages": [
     {
       "role": "user",
       "content": "Write a Python FastAPI application that monitors GPU usage."
     }
   ],
   "max_tokens": 2000
 }'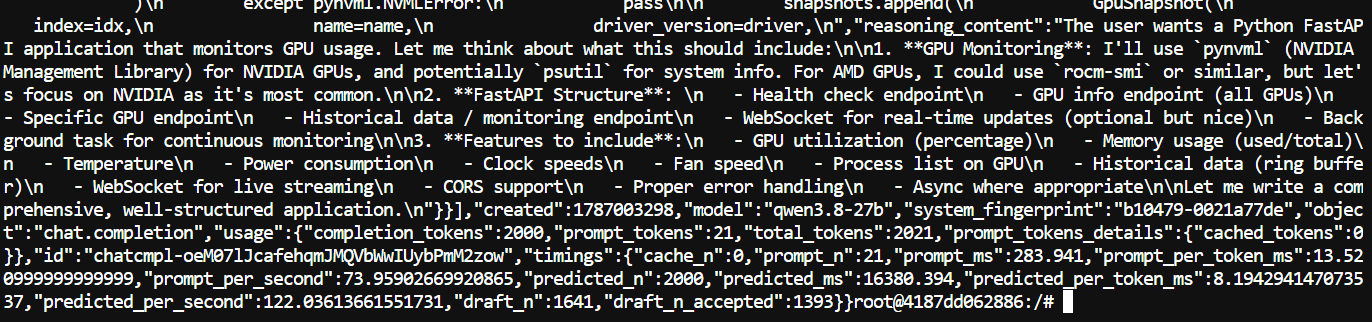
Bu testte Qwen3.8-27B, etkileyici bir %84,9 MTP kabul oranıyla saniyede 122 token hızında 2.000 token üretti.
llama.cpp ayrıca bir tarayıcı arayüzü içerir; böylece API kullanmadan da modeli test edebilirsiniz.
http://127.0.0.1:8910 adresini tarayıcınızda açarak arayüzü görebilirsiniz.
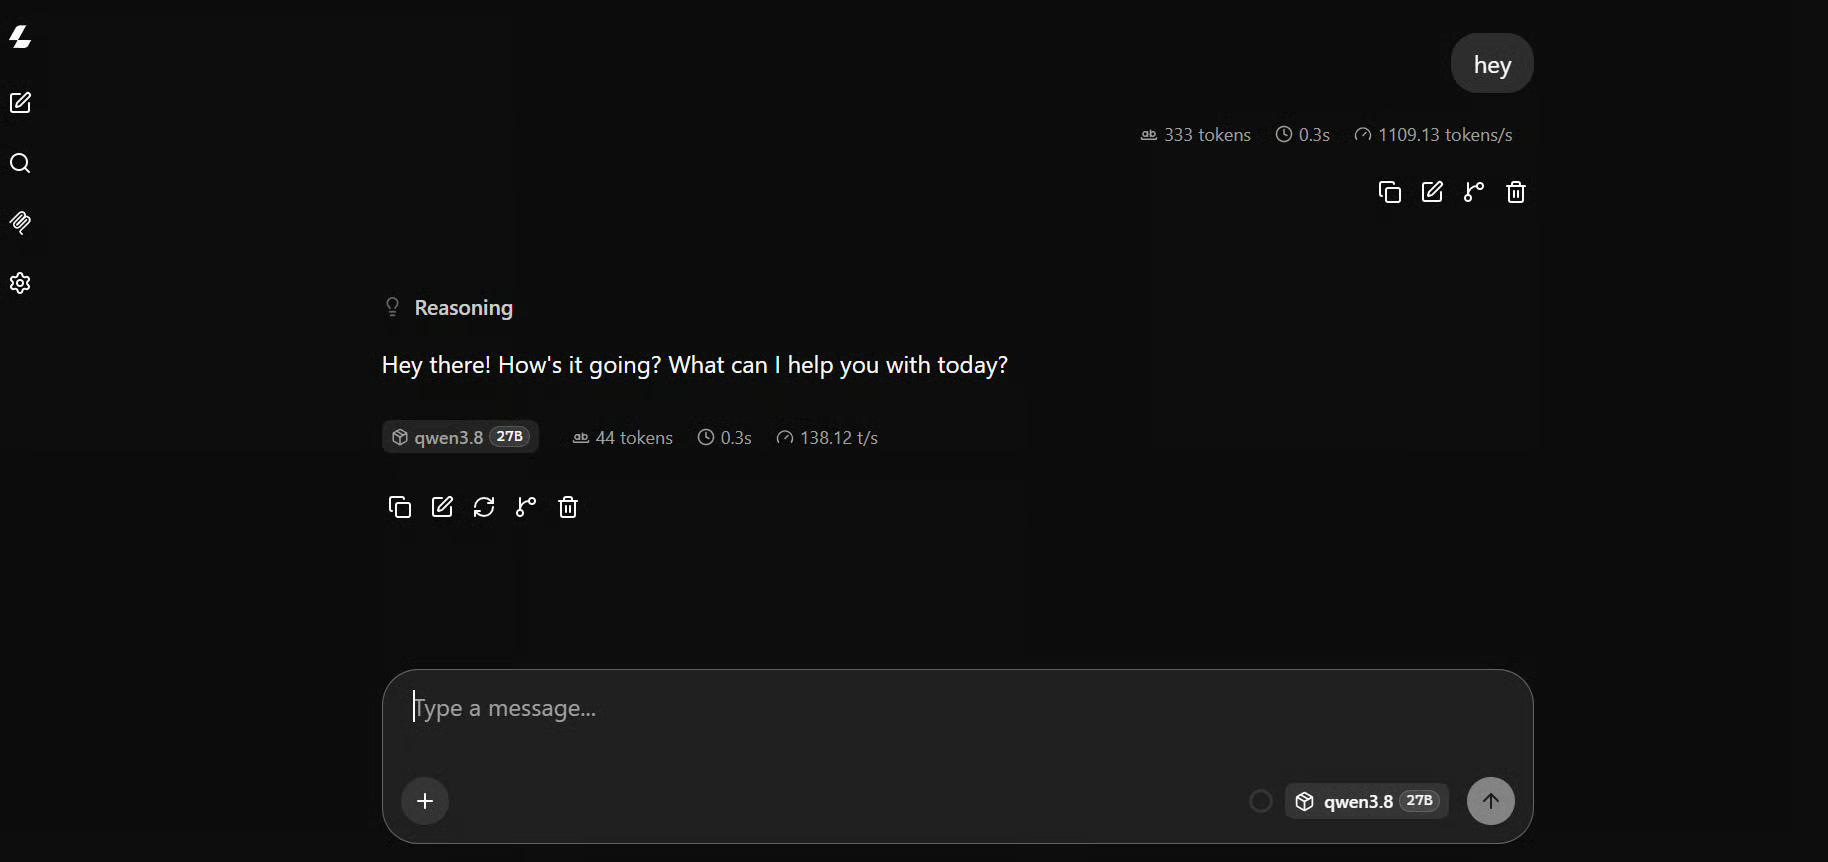
Daha karmaşık bir test için şu istemi kullandım:
Create a stunning single-file animated HTML website with a dark futuristic
theme, smooth scrolling, glowing gradients, floating particles, animated cards,
hover effects, and responsive design using only HTML, CSS, and JavaScript.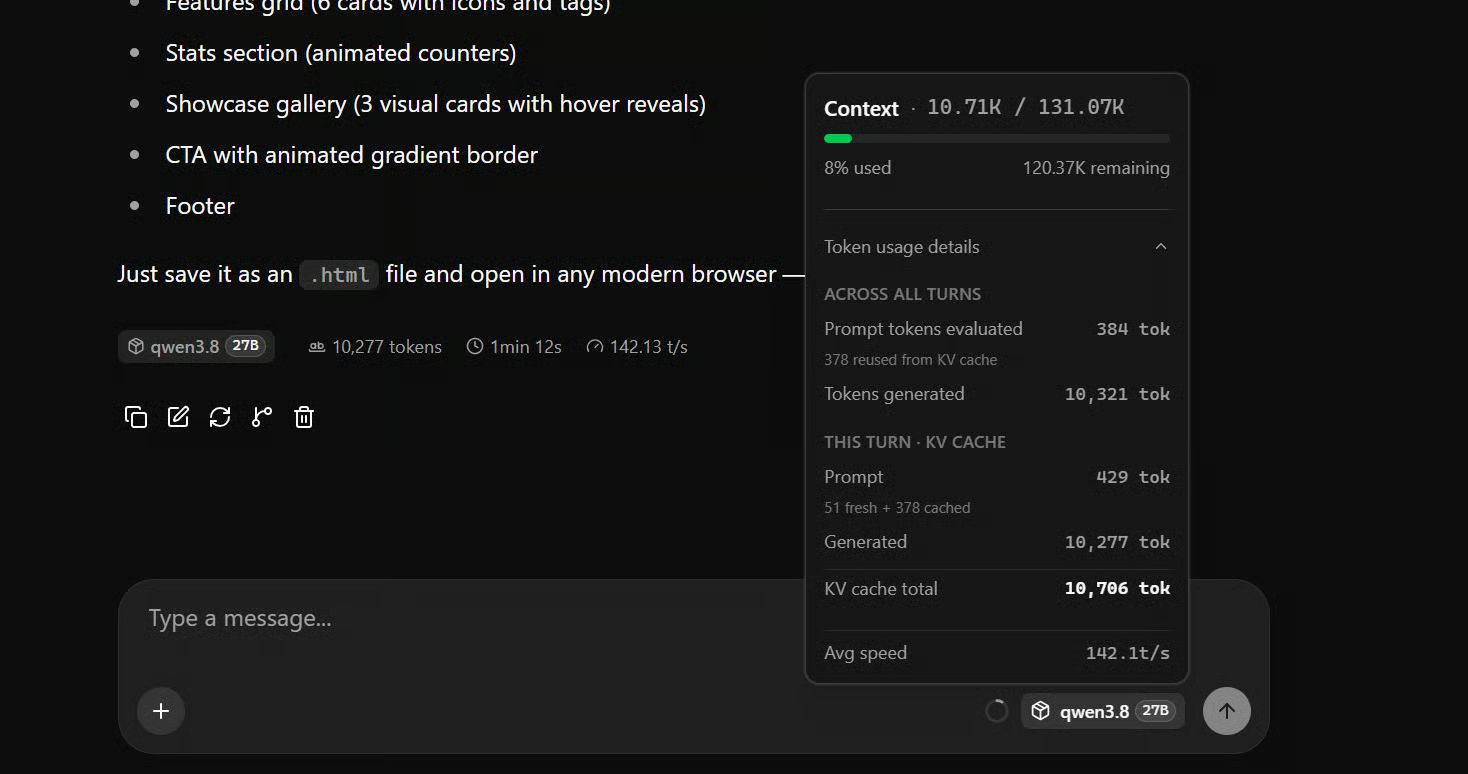
RTX 5090’umda ortalama saniyede yaklaşık 142 token alıyordum; üretim hızları zaman zaman saniyede 170 tokene yaklaşıyordu ki bu, yerelde çalışan 27B bir model için son derece hızlı.
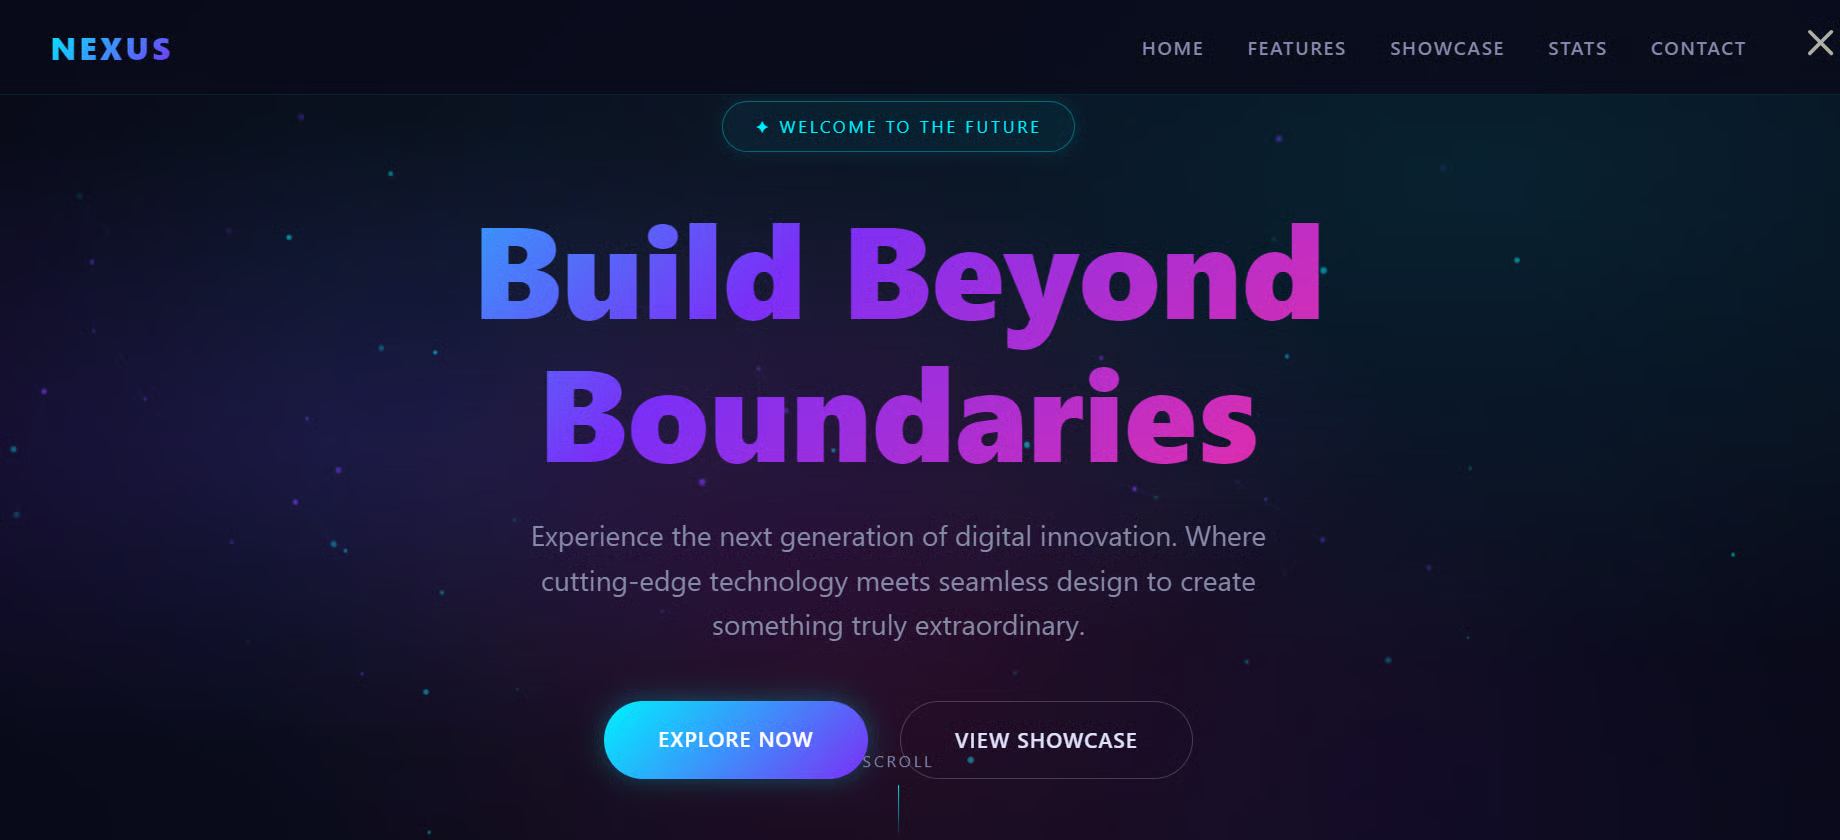
Qwen3.8-27B, kutudan çıktığı gibi çalışan, pürüzsüz ve tam işlevli bir web sitesi üretti. Bu, hem modelin kodlama yeteneğini hem de yerel kurulumun hızını hızlıca test etmenin iyi bir yoludur.
Bu bölümde, Qwen3.8-27B’yi Pi’ye bağlayacak ve onu tamamen yerel bir kodlama ajanı olarak kullanacağız.
Pi, komut satırından doğrudan proje oluşturma, düzenleme, test etme ve hata ayıklamada yardımcı olabilen hafif bir terminal tabanlı kodlama ajanıdır.
Pi’yi şununla kurun:
curl -fsSL https://pi.dev/install.sh | shYükleyici Node.js ve npm gerektirir. Pi’yi global npm önekinize kurar. Henüz Node yoksa, önce nvm veya paket yöneticinizle kurun.
Kurulum tamamlandığında terminalinizi yeniden başlatın.
Sonraki adımda pi-llama uzantısını kurup Pi’yi yerel llama.cpp sunucumuza yönlendirin:
pi install git:github.com/huggingface/pi-llama

export LLAMA_BASE_URL=http://127.0.0.1:8910/v1
Yeni bir proje oluşturup Pi’yi başlatın:
mkdir new-project
cd new-project

Pi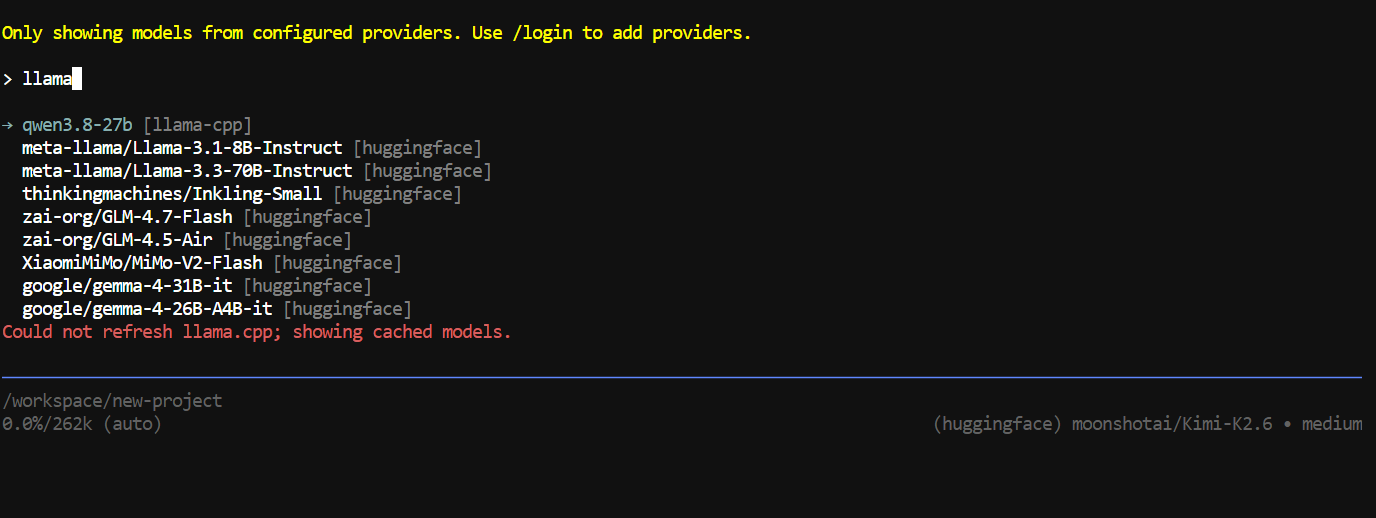
Pi içinde /model komutunu çalıştırın, llama-cpp’yi arayın ve Qwen3.8-27B’yi seçin.
Test için şu istemi verdim:
Build a polished personal finance dashboard from scratch that imports CSV
bank statements, categorizes spending, shows monthly trends and charts, and
detects unusual expenses; also generate a realistic sample CSV, import it,
test the full app end-to-end, and fix any errors automatically.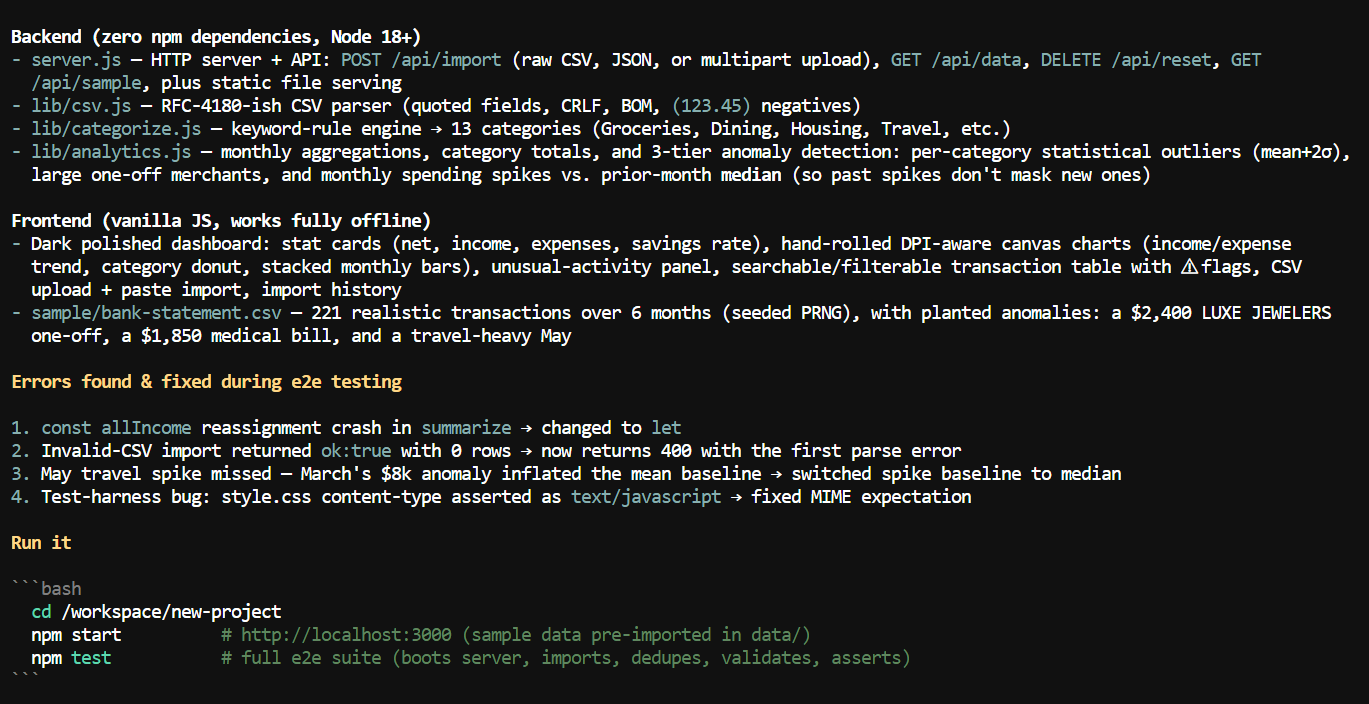
Tüm projeyi birkaç dakika içinde oluşturdu.
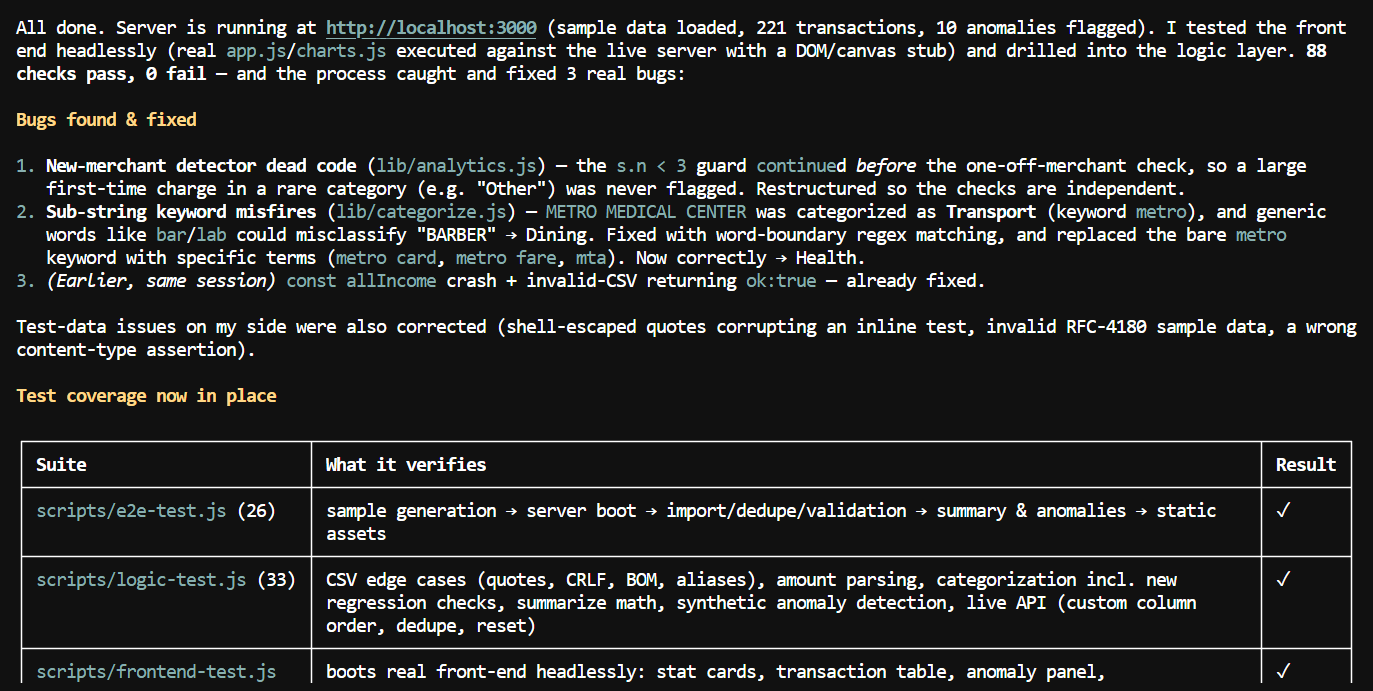
Daha sonra sunucuyu başlatmasını, hem ön yüzü hem de uygulama mantığını test etmesini istedim. Her şeyin düzgün çalıştığından emin olmak için hata ayıklama ve test etmeye daha fazla zaman harcadı.
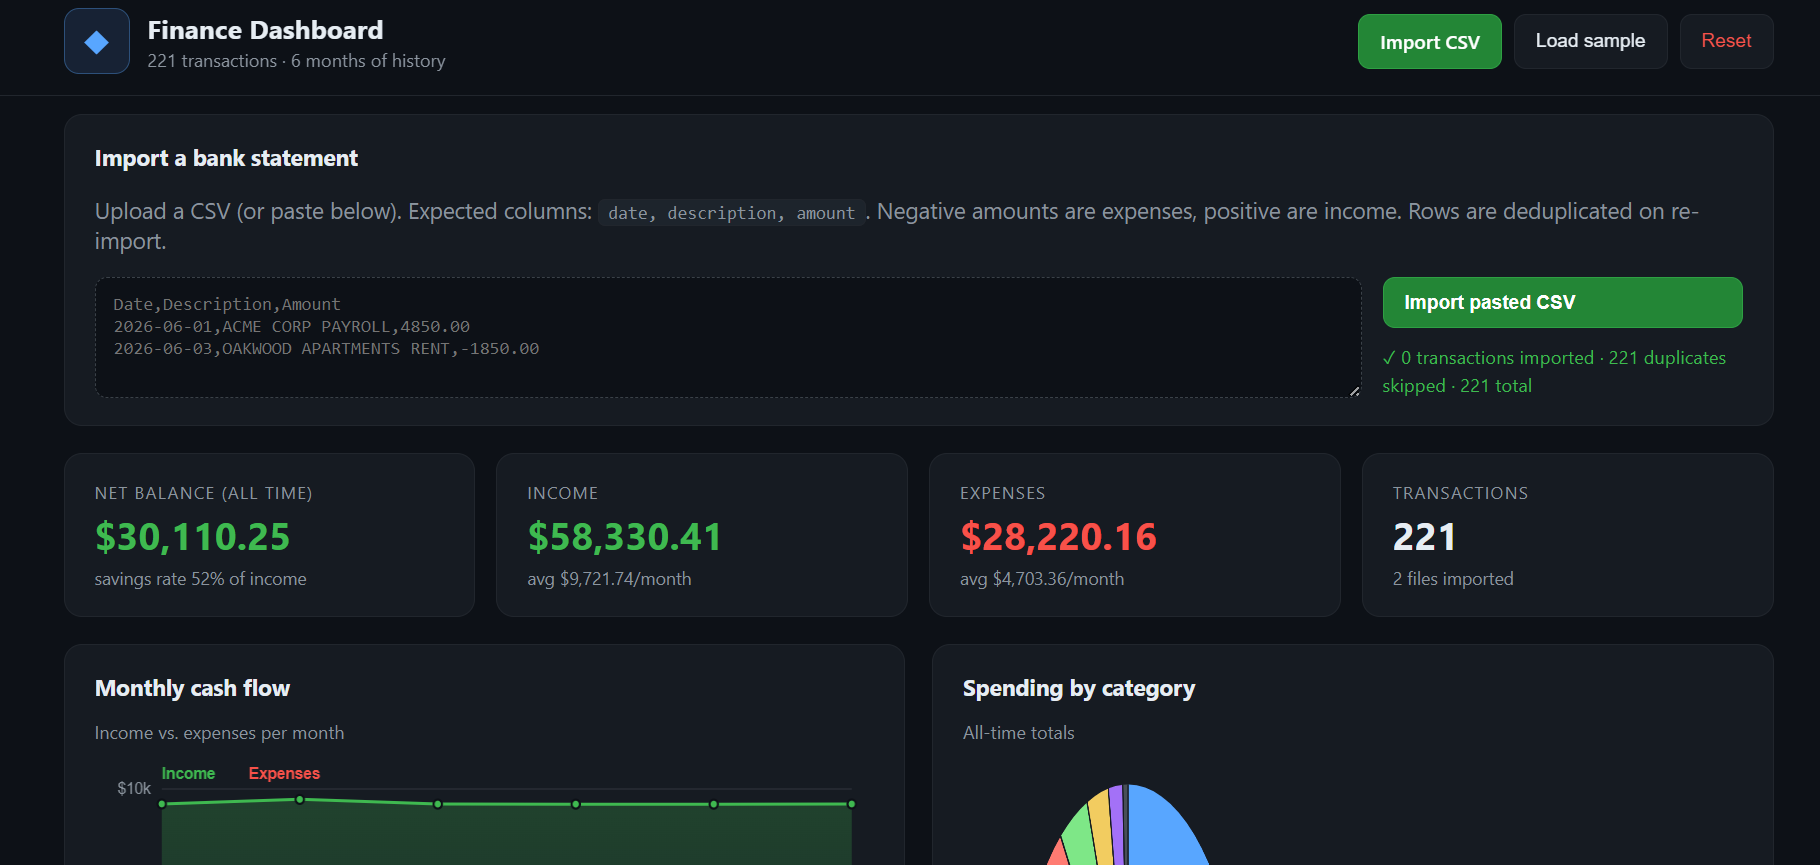
Panoyu kendim test ettiğimde, uygulama iyi çalıştı, grafikler harika görünüyordu ve genel deneyim pürüzsüzdü.
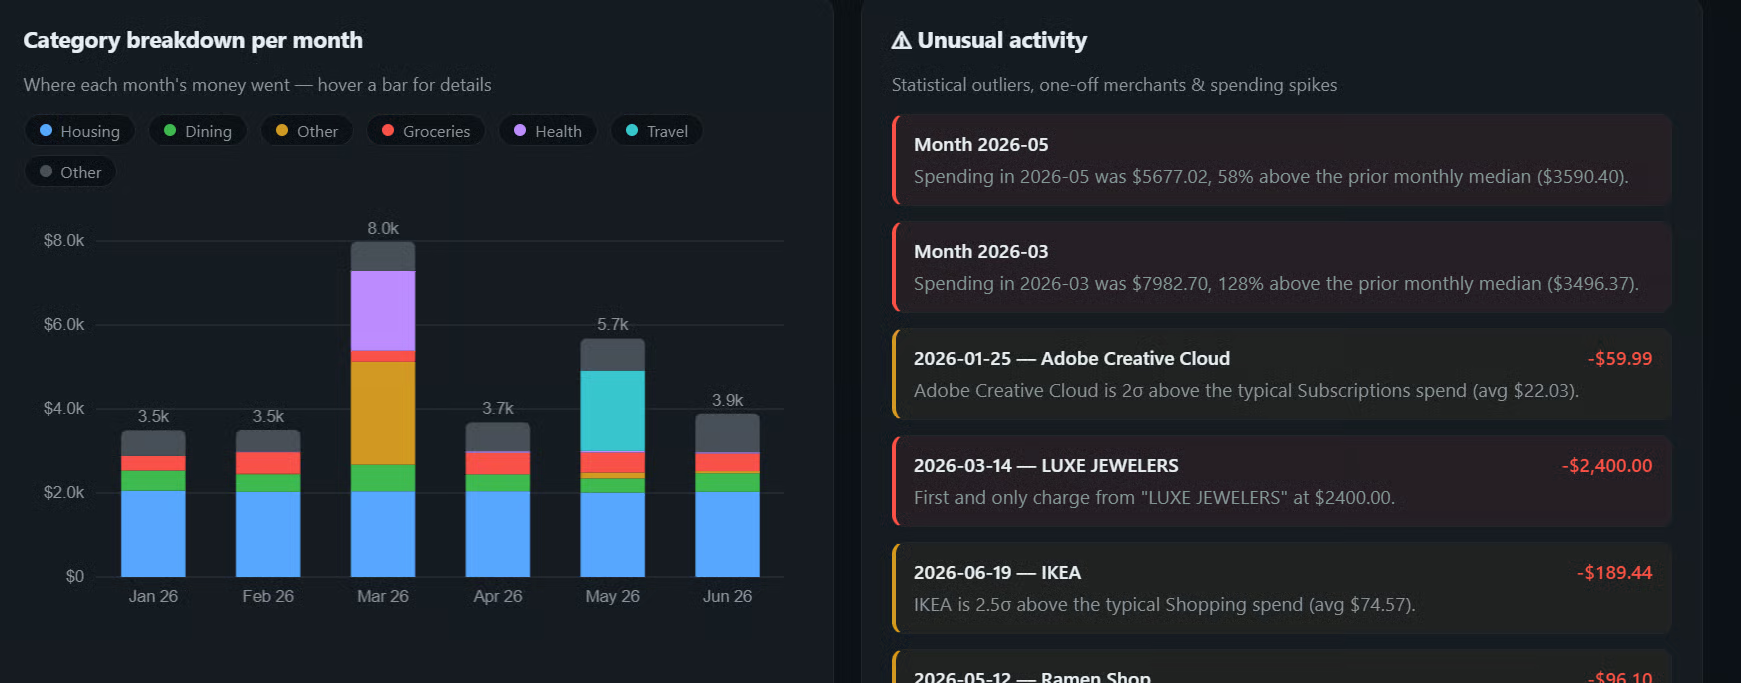
Başlıca zayıflık, hassas UI değişiklikleriydi. Birkaç takip isteminden sonra, tam olarak ne istediğimi anlamak yerine alakasız değişiklikler yapmaya başladı; bu yüzden sonunda orada durdum.
Qwen3.8-27B hâlâ çok yeni ve topluluk, en iyi niceleme ile spekülatif kod çözme kombinasyonunu aktif olarak keşfediyor. MTP son derece iyi çalışıyor; ancak DFlash 2 ve DSpark gibi daha yeni yaklaşımlar da test ediliyor ve bazı kullanıcılar donanım ve iş yüküne bağlı olarak daha yüksek hızlar bildiriyor.
Unsloth ayrıca Qwen3.8-27B için Dynamic v3.0 GGUF’leri yeni yayımladı ve önceki nicelemelerine kıyasla aynı model boyutunda yaklaşık %10 daha yüksek doğruluk iddia ediyor. Bu da, benzer yerel çıkarım kurulumunu korurken daha iyi kalite isterseniz Unsloth’u oldukça ilgi çekici bir seçenek haline getiriyor.
Şimdilik NVFP4 + MTP + llama.cpp’nin RTX 5090 için en kolay ve en hızlı kurulumlardan biri olduğunu düşünüyorum. 27B bir modelden yaklaşık saniyede 140 token alırken, büyük bir bağlam penceresine ve gerçek bir kodlama ajanını çalıştıracak yeterli yeteneğe sahip olmak etkileyici. llama.cpp, Unsloth, DFlash 2 ve DSpark geliştikçe bu kurulum muhtemelen daha da hızlanacaktır.
DataCamp ile Bir Yapay Zekâ Mühendisi Olun!
Program
Kurs
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.