Lärstig
Associate AI Engineer för utvecklare
26 tim
Först säkerställer vi att GPU:n upptäcks korrekt och kontrollerar NVIDIA-drivrutinen och CUDA-versionen.
nvidia-smi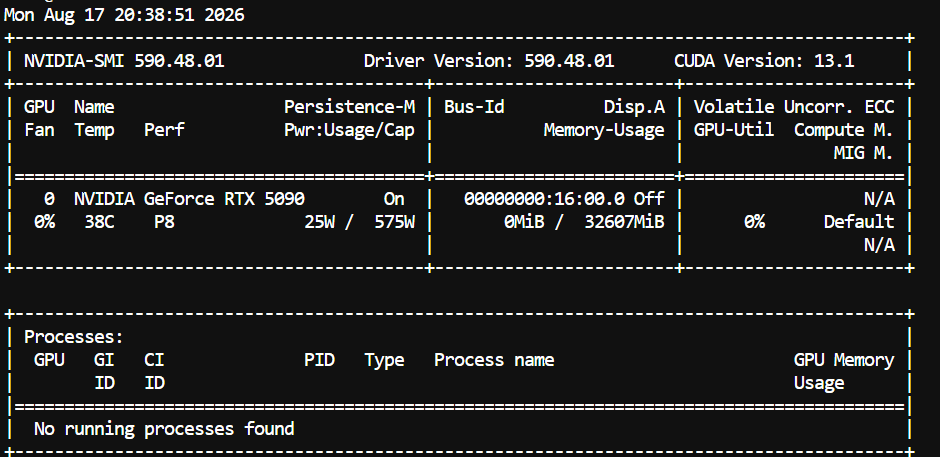
Du bör se din RTX 5090, drivrutinsversion, CUDA-version, GPU-minne och aktuell GPU-användning.
Obs: Den här installationen är specifikt för NVIDIA Blackwell-GPU:er, såsom RTX 5090. Bygget nedan riktar in sig på SM120, som är den beräkningsarkitektur som används av RTX 5090.
Nästa steg är att ladda ner och kompilera den senaste versionen av llama.cpp med CUDA-stöd.
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp

cmake -B build \
  -DGGML_CUDA=ON \
  -DCMAKE_CUDA_ARCHITECTURES=120

cmake --build build --config Release -j$(nproc)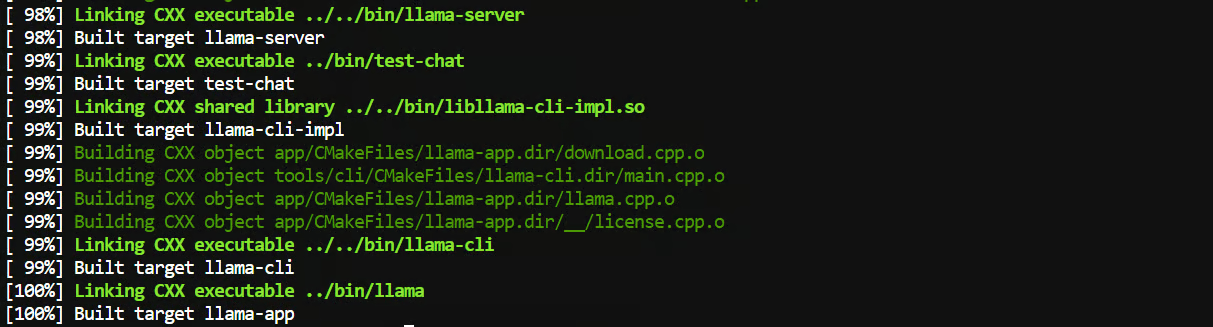
Det viktiga här är -DCMAKE_CUDA_ARCHITECTURES=120. Detta instruerar llama.cpp att bygga specifikt för Blackwell-arkitekturen som används av RTX 5090.
När bygget är klart gör vi llama-server tillgängligt globalt så att vi kan köra det från valfri mapp:
sudo ln -sf "$(realpath ./build/bin/llama-server)" /usr/local/bin/llama-serverKontrollera nu att allt fungerar:
llama-server --versionDu bör få utdata liknande:
version: 0.1.1-dev (build 10479, commit 0021a77de)
built with GNU 13.3.0 for Linux x86_64
Det var allt. Vi har nu en CUDA-aktiverad llama.cpp-build som kan dra nytta av RTX 5090 och dess inbyggda Blackwell NVFP4-stöd.
Nu laddar vi ner Qwen3.8-27B-modellen.
Installera först Hugging Face CLI:
pip install -U huggingface_hubSkapa en mapp där vi ska lägga modellen:
mkdir -p /workspace/models/qwen38Ladda sedan ner NVFP4-MTP GGUF:
hf download felippeburk/Qwen3.8-27B-NVFP4-MTP-GGUF \
  --local-dir /workspace/models/qwen38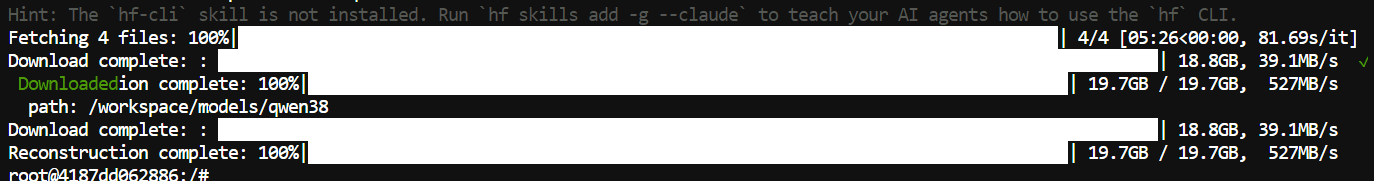
Det här är den version vi vill ha för den här installationen eftersom den använder NVFP4 och inkluderar MTP-stöd, vilket står för en stor del av hastighetsförbättringen på RTX 5090.
Nu kommer den roliga delen. Vi serverar Qwen3.8-27B helt på GPU:n med Flash Attention, ett 131K kontextfönster och MTP spekulativ avkodning för snabbare generering.
Kör:
cd /workspace/llama.cpp

llama-server \
  -m /workspace/models/qwen38/qwen3.8-27b-text-nvfp4-mtp.gguf \
  --alias qwen3.8-27b \
  --host 0.0.0.0 \
  --port 8910 \
  --ctx-size 131072 \
  --n-gpu-layers all \
  --flash-attn on \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --parallel 1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 4 \
  --spec-draft-p-min 0.75 \
  --spec-draft-ngl all \
  --spec-draft-type-k q8_0 \
  --spec-draft-type-v q8_0 \
  --reasoning-effort medium \
  --jinja
Det finns många flaggor här, men de flesta är helt enkelt till för att få ut bästa prestanda från 5090.
De viktigaste att känna till är:
--ctx-size 131072 ger oss ungefär ett 131K kontextfönster.
--n-gpu-layers all håller modellen på GPU:n.
--flash-attn on aktiverar Flash Attention.
--cache-type-k q8_0 och --cache-type-v q8_0 hjälper till att minska KV-cacheminnesanvändningen.
--spec-type draft-mtp aktiverar Qwen3.8:s MTP spekulativa avkodning.
--spec-draft-n-max 4 styr hur många spekulativa token MTP kan generera åt gången.
För den här installationen använder vi n-max 4 som startvärde för ett RTX 5090. Du kan experimentera med värden som 2 (som modellkortet rekommenderar för denna GGUF) eller 3 senare, eftersom den snabbaste inställningen kan variera något beroende på ditt system.
När llama-server har laddat modellen är Qwen3.8 tillgänglig lokalt på http://127.0.0.1:8910.
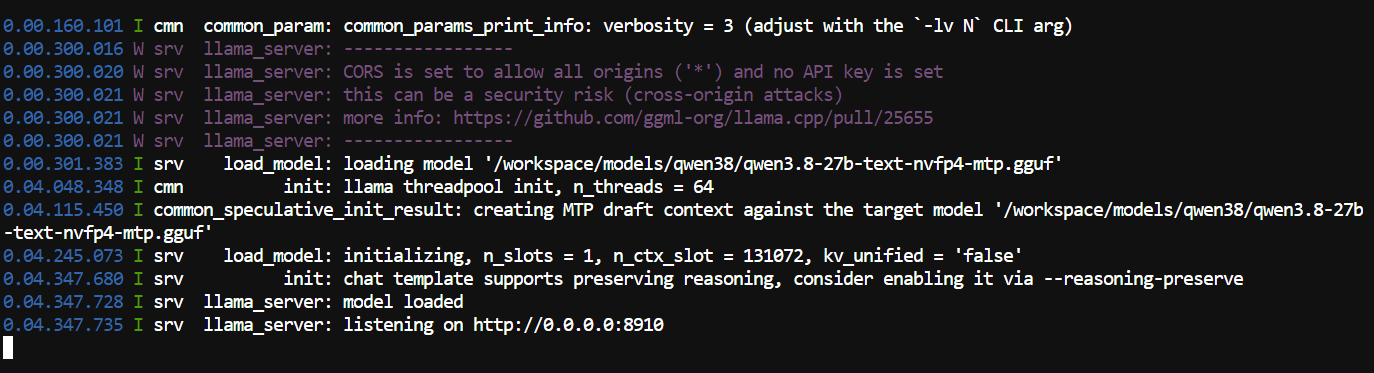
Vi har nu Qwen3.8-27B igång lokalt. Därefter testar vi modellen via både API:et och det inbyggda webbläsargränssnittet.
Med servern igång, öppna en annan terminal och skicka en testrådgivning till det OpenAI-kompatibla API:et:
curl http://127.0.0.1:8910/v1/chat/completions \
 -H "Content-Type: application/json" \
 -d '{
   "model": "qwen3.8-27b",
   "messages": [
     {
       "role": "user",
       "content": "Write a Python FastAPI application that monitors GPU usage."
     }
   ],
   "max_tokens": 2000
 }'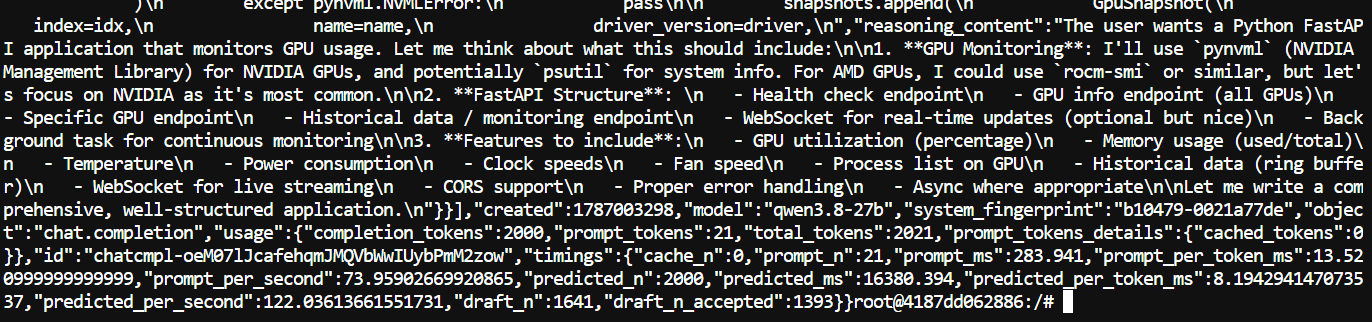
I det här testet genererade Qwen3.8-27B 2 000 token med 122 token/s och en imponerande MTP-acceptansgrad på 84,9%.
llama.cpp inkluderar också ett webbläsargränssnitt, så du kan testa modellen utan att använda API:et.
Öppna http://127.0.0.1:8910 i din webbläsare för att se gränssnittet.
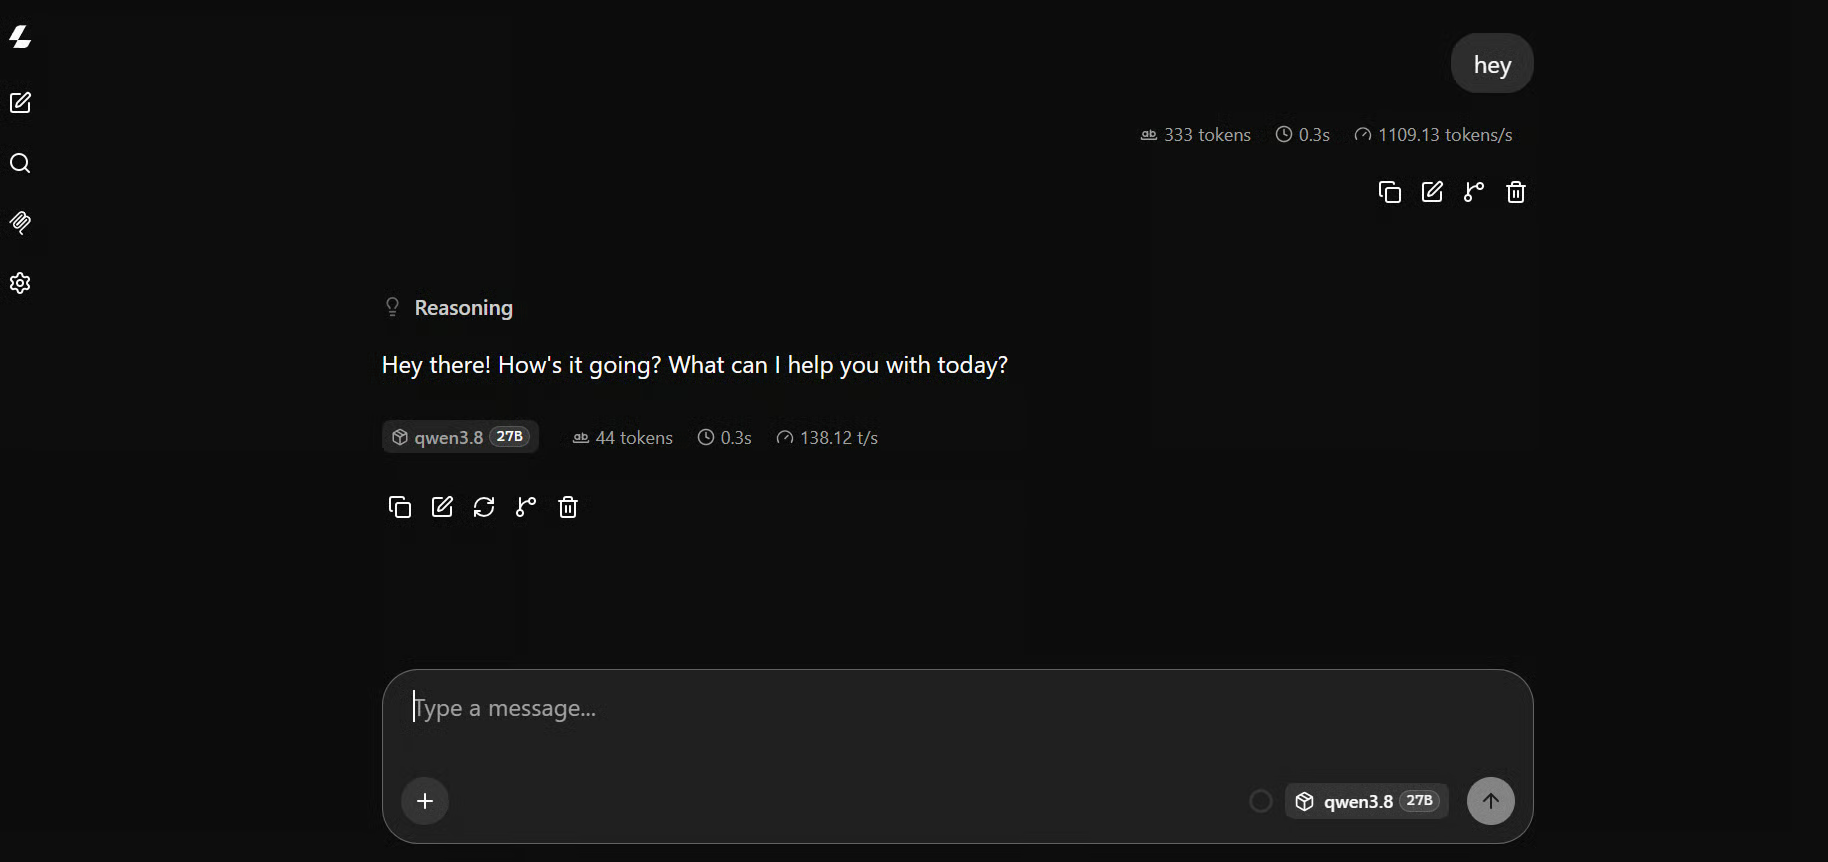
För ett mer komplext test använde jag denna prompt:
Create a stunning single-file animated HTML website with a dark futuristic
theme, smooth scrolling, glowing gradients, floating particles, animated cards,
hover effects, and responsive design using only HTML, CSS, and JavaScript.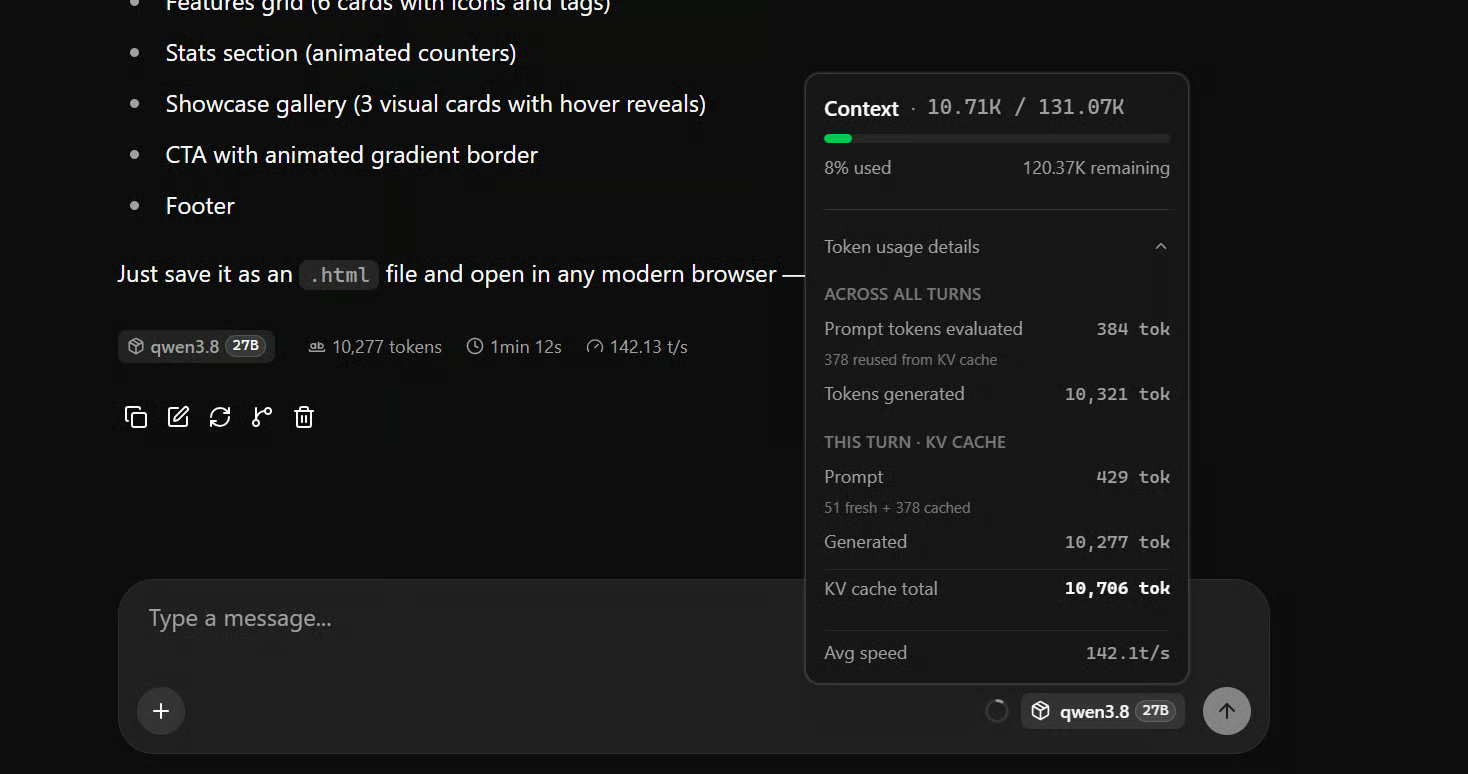
På mitt RTX 5090 fick jag i genomsnitt runt 142 token per sekund, med genereringshastigheter som ibland nådde runt 170 token per sekund, vilket är extremt snabbt för en 27B-modell som körs lokalt.
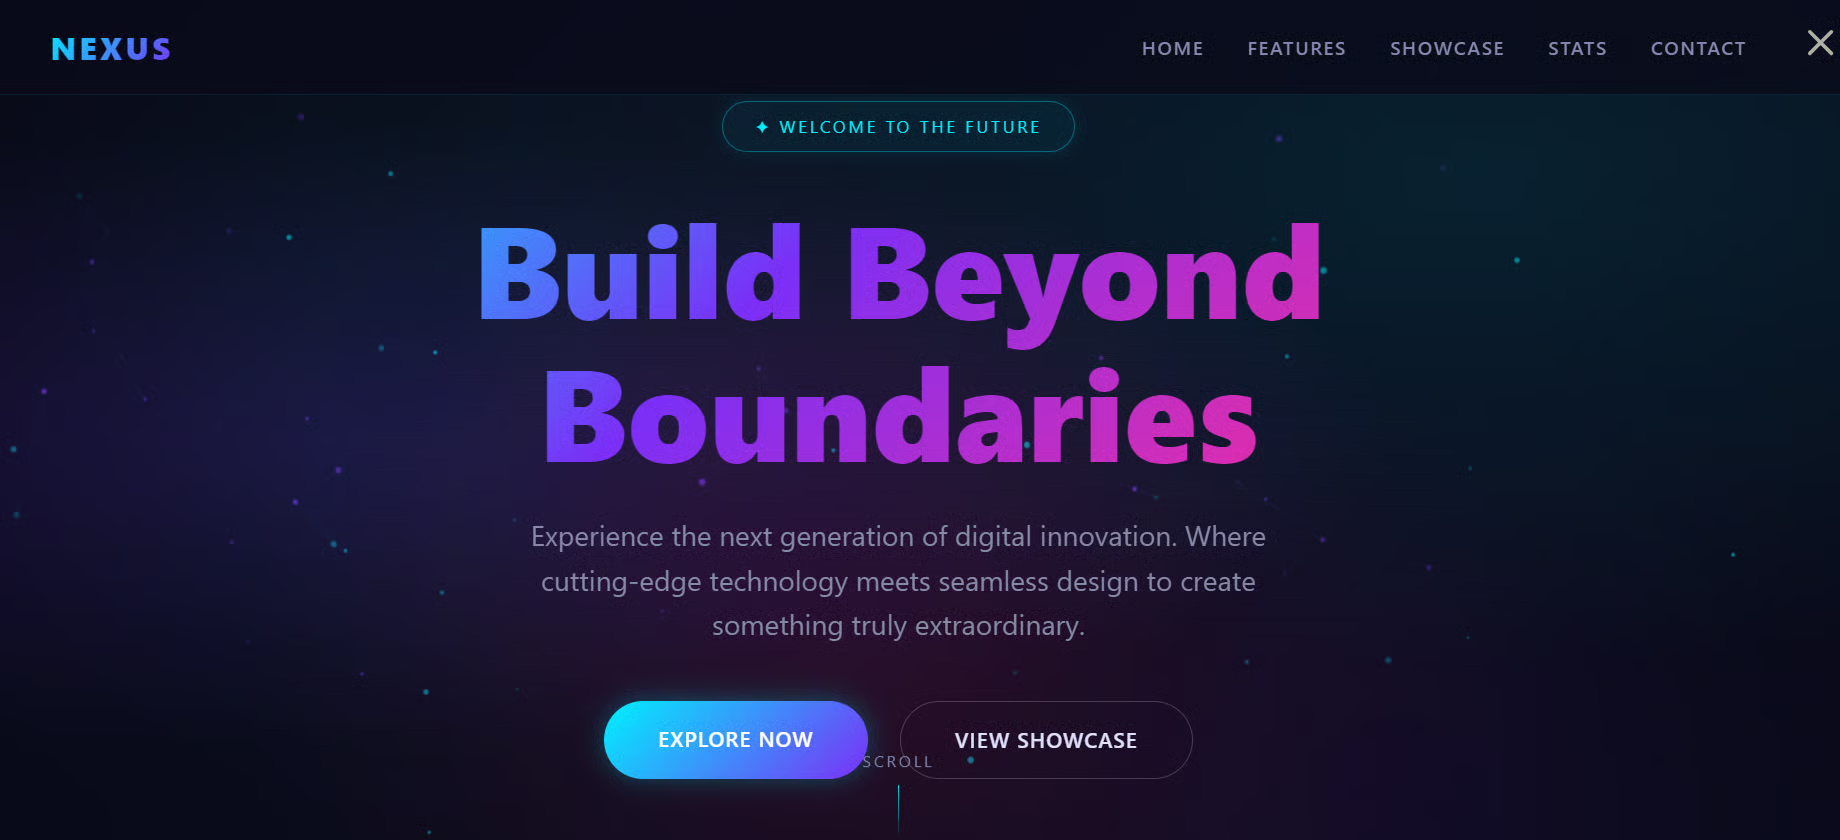
Qwen3.8-27B genererade en snygg, fullt fungerande webbplats som körde direkt. Det här är ett bra sätt att snabbt testa både modellens kodningsförmåga och hastigheten i den lokala installationen.
I det här avsnittet kopplar vi Qwen3.8-27B till Pi och använder den som en helt lokal kodningsagent.
Pi är en lättviktig terminalbaserad kodningsagent som kan hjälpa dig att bygga, redigera, testa och felsöka projekt direkt från kommandoraden.
Installera Pi med:
curl -fsSL https://pi.dev/install.sh | shInstallationsprogrammet kräver Node.js och npm. Det installerar Pi i ditt globala npm-prefix. Om du inte har Node ännu, installera det först med nvm eller din pakethanterare.
När installationen är klar, starta om din terminal.
Installera sedan tillägget pi-llama och peka Pi mot vår lokala llama.cpp-server:
pi install git:github.com/huggingface/pi-llama

export LLAMA_BASE_URL=http://127.0.0.1:8910/v1
Skapa ett nytt projekt och starta Pi:
mkdir new-project
cd new-project

Pi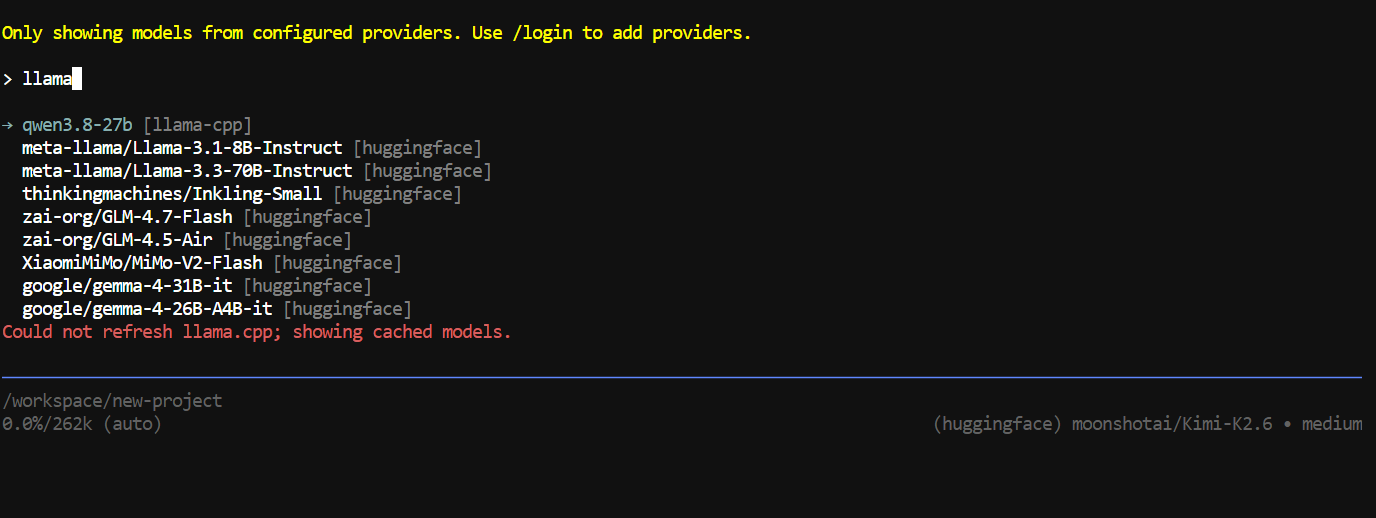
Inuti Pi, kör /model, sök efter llama-cpp och välj Qwen3.8-27B.
För testning gav jag den den här prompten:
Build a polished personal finance dashboard from scratch that imports CSV
bank statements, categorizes spending, shows monthly trends and charts, and
detects unusual expenses; also generate a realistic sample CSV, import it,
test the full app end-to-end, and fix any errors automatically.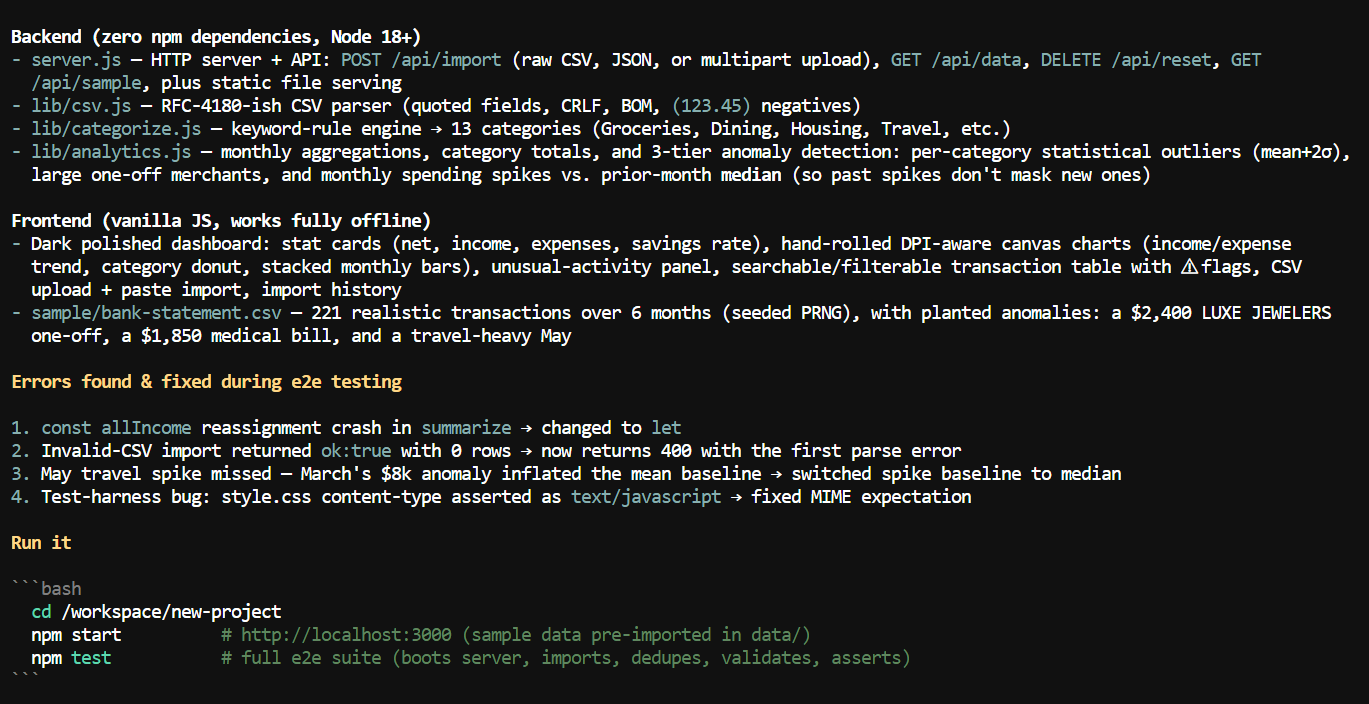
Den byggde hela projektet inom några minuter.
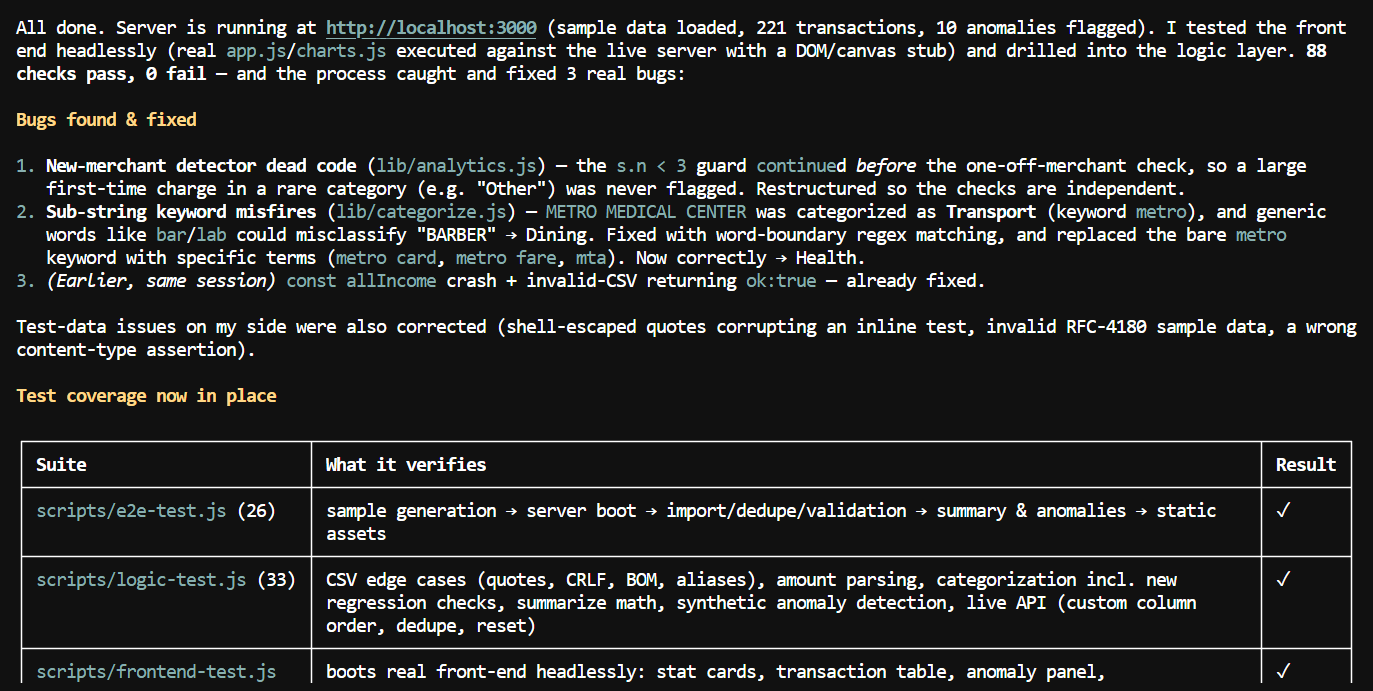
Jag bad den sedan att starta servern och testa både frontend och applikationslogik. Den lade mer tid på felsökning och testning för att säkerställa att allt fungerade som det skulle.
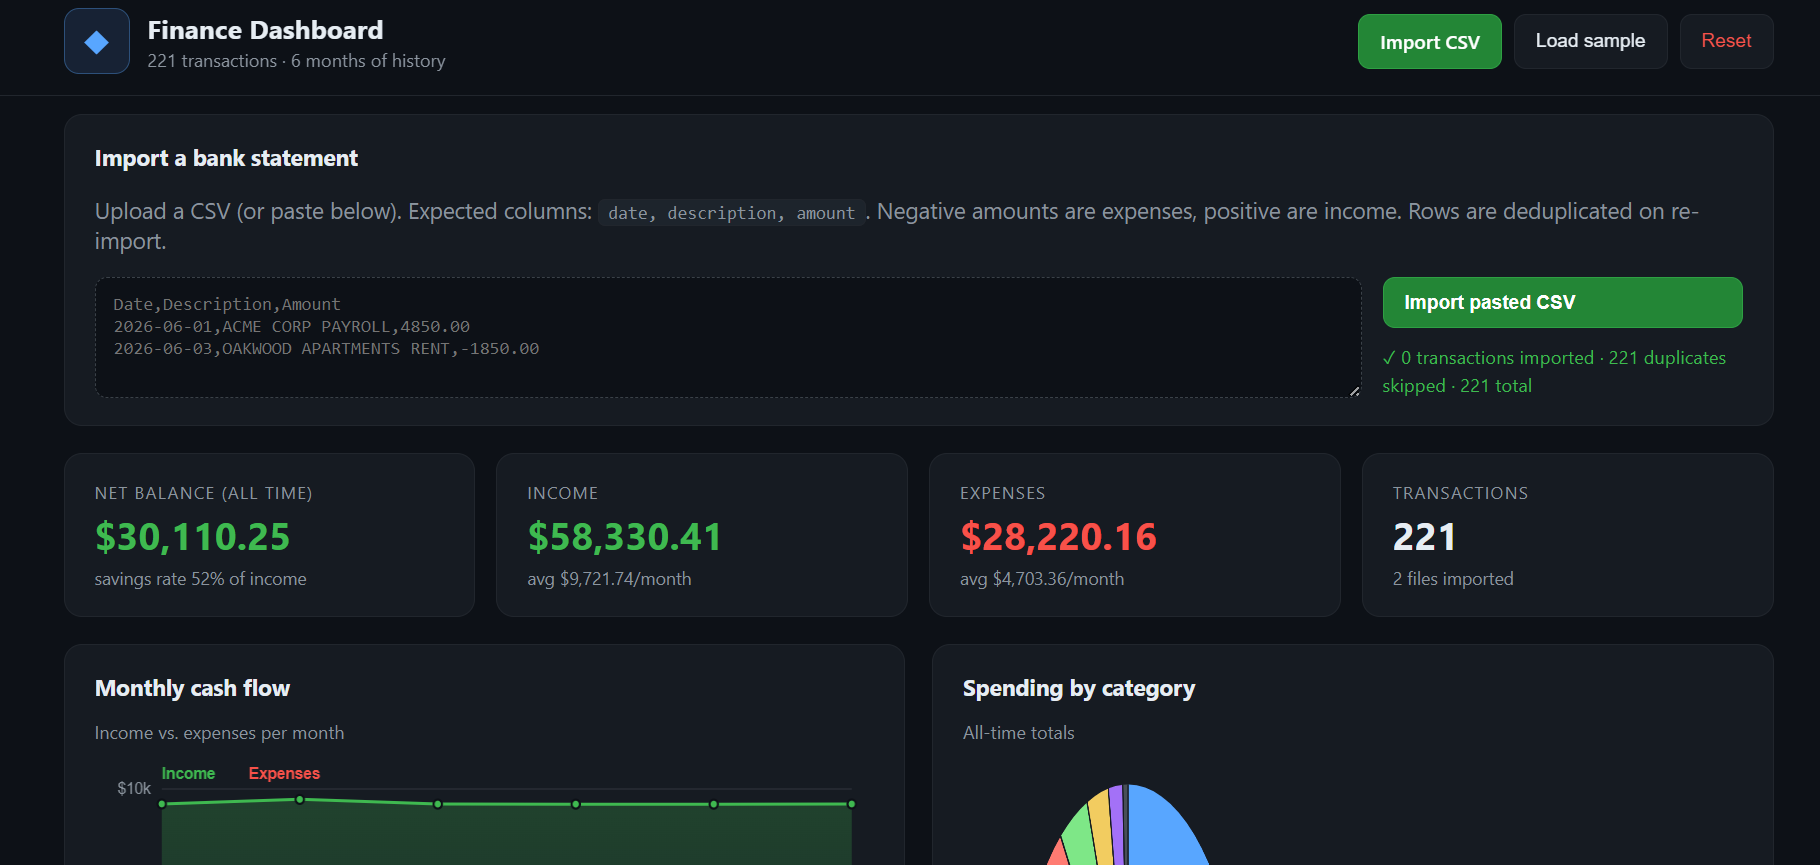
När jag testade instrumentpanelen själv fungerade appen bra, graferna såg utmärkt ut och helhetsupplevelsen var smidig.
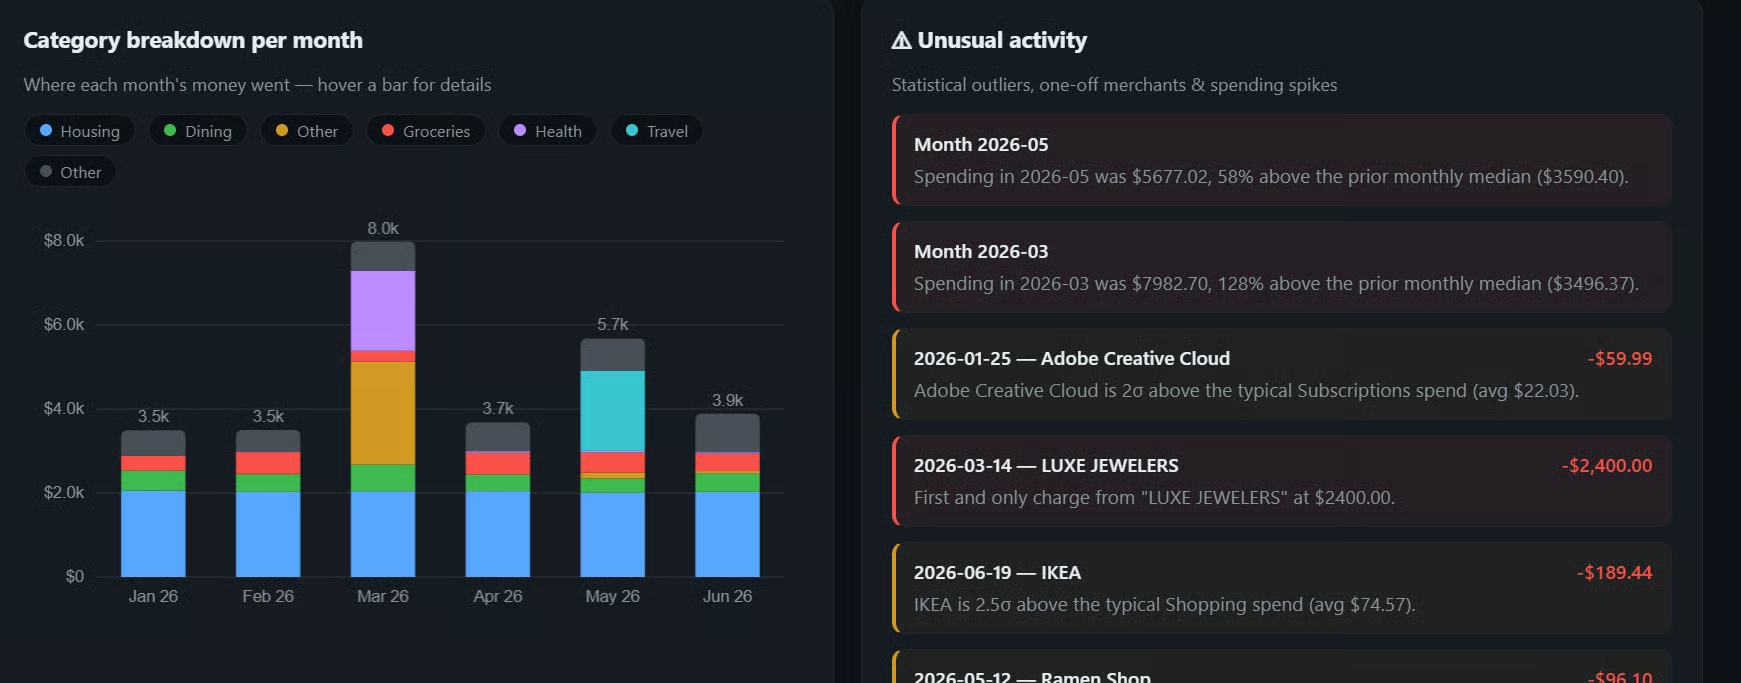
Den största svagheten var att göra precisa UI-ändringar. Efter flera följdprompter började den göra orelaterade ändringar i stället för att förstå exakt vad jag ville, så jag avslutade där.
Qwen3.8-27B är fortfarande väldigt ny, och communityt utforskar aktivt den bästa kombinationen av kvantisering och spekulativ avkodning. MTP fungerar extremt bra, men nyare metoder som DFlash 2 och DSpark testas också, och vissa användare rapporterar ännu högre hastigheter beroende på hårdvara och arbetsbelastning.
Unsloth har också precis släppt Dynamic v3.0 GGUF:er för Qwen3.8-27B, med påståenden om cirka 10% högre noggrannhet vid samma modellstorlek jämfört med deras tidigare kvantiseringar. Detta gör Unsloth till ytterligare ett mycket intressant alternativ om du vill ha bättre kvalitet samtidigt som du behåller ungefär samma lokala inferensupplägg.
För tillfället tycker jag att NVFP4 + MTP + llama.cpp är en av de enklaste och snabbaste installationerna för ett RTX 5090. Att få runt 140 token per sekund från en 27B-modell samtidigt som man har ett stort kontextfönster och tillräcklig kapacitet för att köra en riktig kodningsagent är imponerande. Upplägget blir förmodligen ännu snabbare i takt med att llama.cpp, Unsloth, DFlash 2 och DSpark fortsätter att förbättras.
Bli AI-ingenjör med DataCamp!
Lärstig
Kurs
Lärstig