Tracks
面向开发者的 AI 工程师助理
26小时
首先,确保正确检测到 GPU,并检查 NVIDIA 驱动和 CUDA 版本。
nvidia-smi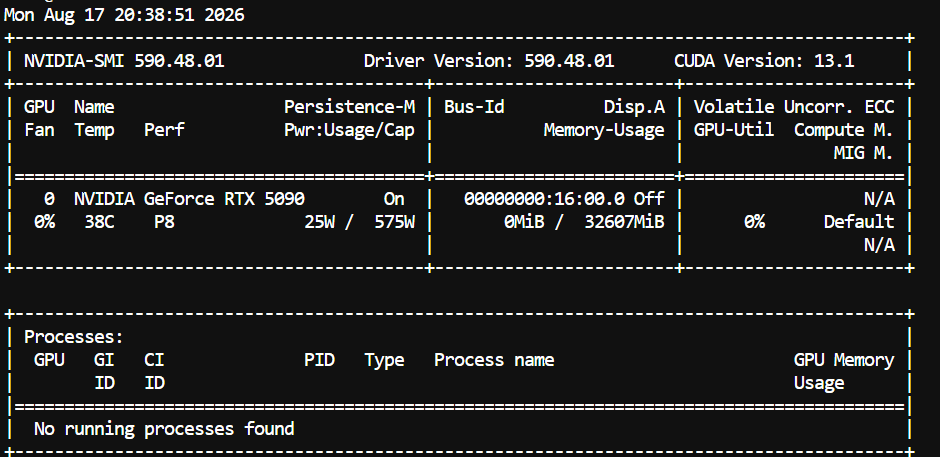
您应能看到 RTX 5090、驱动版本、CUDA 版本、GPU 显存以及当前 GPU 使用情况。
注意:此配置专为 NVIDIA Blackwell GPU(如 RTX 5090)准备。下面的构建目标为 SM120,即 RTX 5090 所用的计算架构。
接下来,我们将下载并编译带 CUDA 支持的最新版 llama.cpp。
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp

cmake -B build \
  -DGGML_CUDA=ON \
  -DCMAKE_CUDA_ARCHITECTURES=120

cmake --build build --config Release -j$(nproc)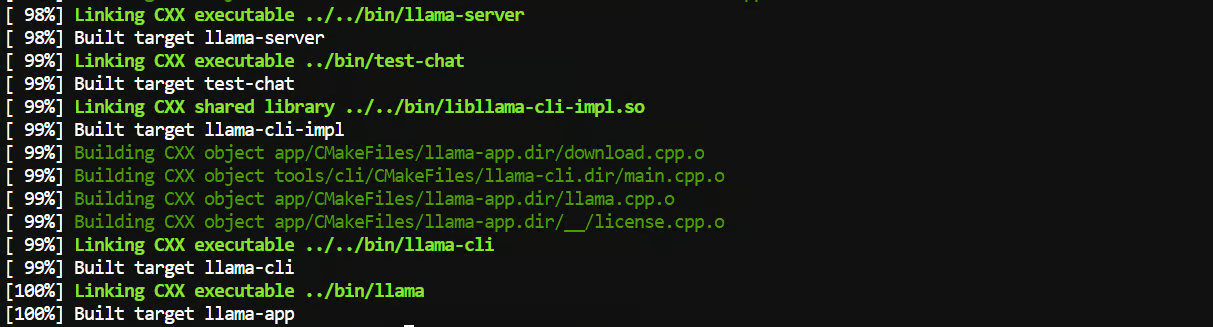
这里的关键是 -DCMAKE_CUDA_ARCHITECTURES=120。它告诉 llama.cpp 针对 RTX 5090 使用的 Blackwell 架构进行构建。
构建完成后,我们将把 llama-server 放到全局路径,便于在任意文件夹运行:
sudo ln -sf "$(realpath ./build/bin/llama-server)" /usr/local/bin/llama-server现在,检查一切是否正常:
llama-server --version您应会看到类似输出:
version: 0.1.1-dev (build 10479, commit 0021a77de)
built with GNU 13.3.0 for Linux x86_64
就这样。我们已经获得一个启用 CUDA 的 llama.cpp 构建,可利用 RTX 5090 及其原生 Blackwell NVFP4 支持。
现在我们来下载 Qwen3.8-27B 模型。
首先安装 Hugging Face CLI:
pip install -U huggingface_hub创建一个用于保存模型的文件夹:
mkdir -p /workspace/models/qwen38然后下载 NVFP4-MTP GGUF:
hf download felippeburk/Qwen3.8-27B-NVFP4-MTP-GGUF \
  --local-dir /workspace/models/qwen38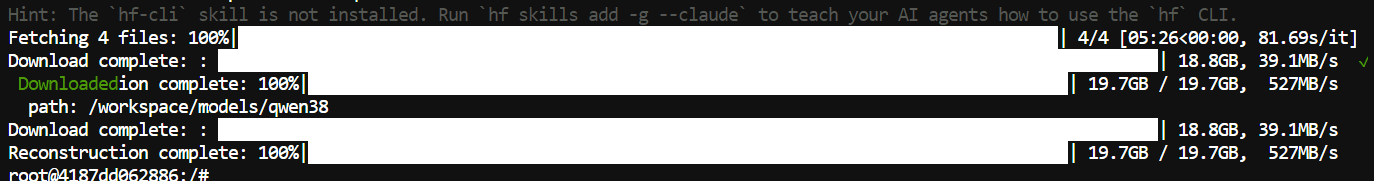
这是我们在本次配置中需要的版本,因为它采用 NVFP4 并包含 MTP 支持,这也是在 RTX 5090 上获得大幅加速的关键所在。
接下来就有趣了。我们将在 GPU 上完整加载 Qwen3.8-27B,启用 Flash Attention、131K 的上下文窗口,并使用 MTP 推测解码以更快生成。
运行:
cd /workspace/llama.cpp

llama-server \
  -m /workspace/models/qwen38/qwen3.8-27b-text-nvfp4-mtp.gguf \
  --alias qwen3.8-27b \
  --host 0.0.0.0 \
  --port 8910 \
  --ctx-size 131072 \
  --n-gpu-layers all \
  --flash-attn on \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --parallel 1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 4 \
  --spec-draft-p-min 0.75 \
  --spec-draft-ngl all \
  --spec-draft-type-k q8_0 \
  --spec-draft-type-v q8_0 \
  --reasoning-effort medium \
  --jinja
这里有不少参数,但大多只是为了从 5090 中榨取最佳性能。
需要重点了解的是:
--ctx-size 131072 提供约 131K 的上下文窗口。
--n-gpu-layers all 将模型完全放在 GPU 上。
--flash-attn on 启用 Flash Attention。
--cache-type-k q8_0 和 --cache-type-v q8_0 有助于降低 KV 缓存的显存占用。
--spec-type draft-mtp 启用 Qwen3.8 的 MTP 推测解码。
--spec-draft-n-max 4 控制 MTP 一次可推测生成的 token 数量。
在本次配置中,我们以 n-max 4 作为 RTX 5090 的起始设置。您可以进一步尝试 2(模型卡建议该 GGUF 使用)或 3,因为最快的设置会随系统略有差异。
当 llama-server 完成模型加载后,Qwen3.8 将在本地可用,地址为 http://127.0.0.1:8910。
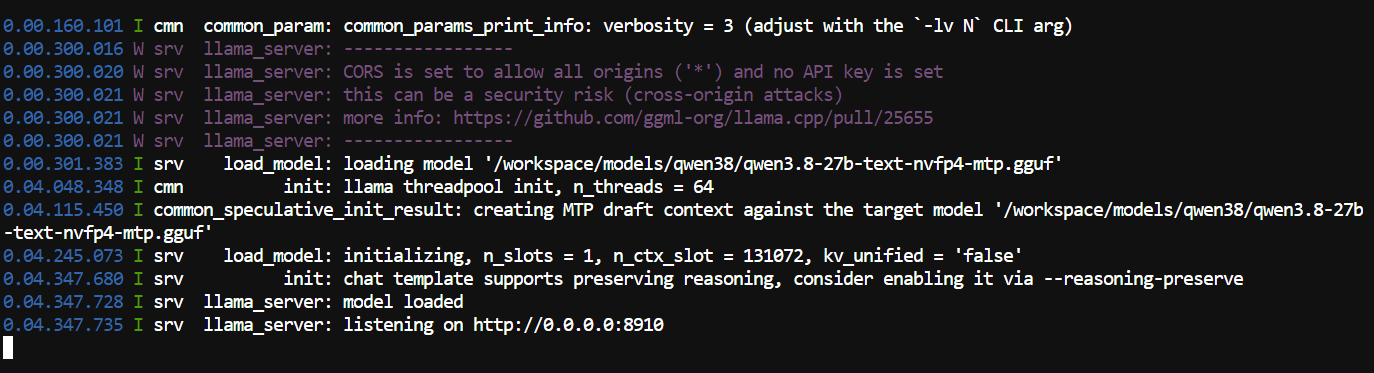
我们已经在本地运行起 Qwen3.8-27B。接下来,我们将通过 API 和内置浏览器界面测试该模型。
在服务运行的同时,打开另一个终端,向 OpenAI 兼容 API 发送测试请求:
curl http://127.0.0.1:8910/v1/chat/completions \
 -H "Content-Type: application/json" \
 -d '{
   "model": "qwen3.8-27b",
   "messages": [
     {
       "role": "user",
       "content": "Write a Python FastAPI application that monitors GPU usage."
     }
   ],
   "max_tokens": 2000
 }'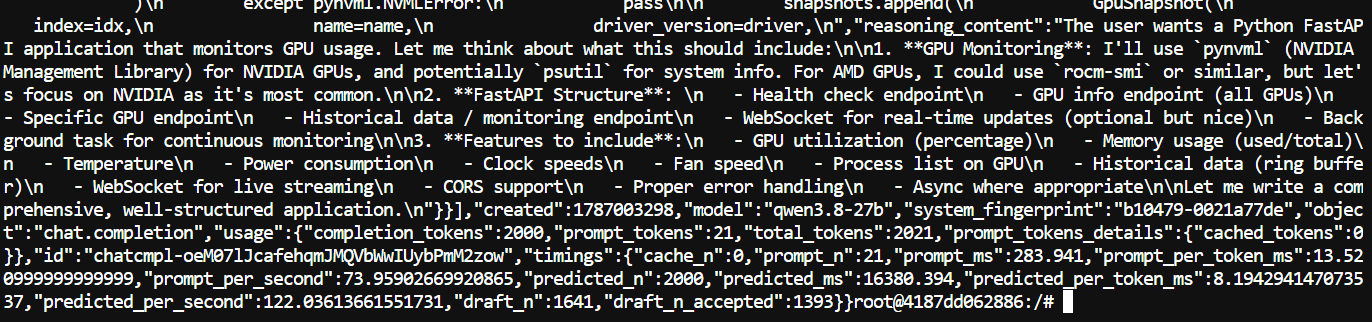
在这个测试中,Qwen3.8-27B 以每秒 122 个 token 的速度生成了 2,000 个 token,MTP 接受率高达 84.9%,表现相当出色。
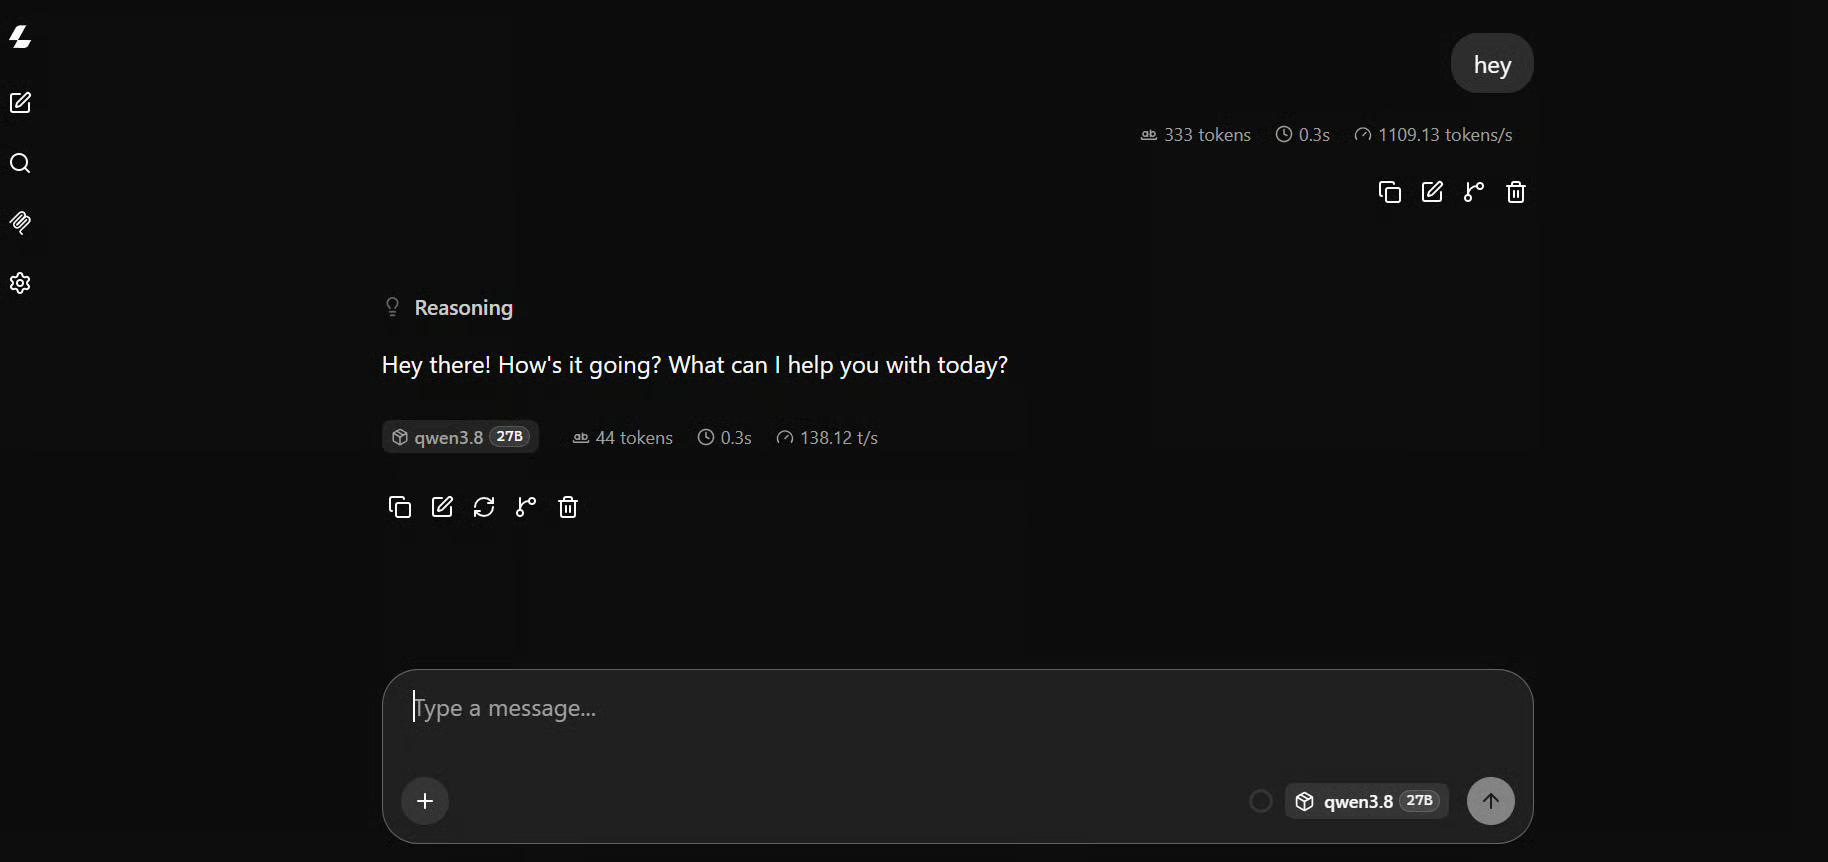
llama.cpp 还包含一个浏览器界面,因此您无需使用 API 也能测试模型。
在浏览器中打开 http://127.0.0.1:8910 查看界面。
更复杂的测试中,我使用了以下提示词:
Create a stunning single-file animated HTML website with a dark futuristic
theme, smooth scrolling, glowing gradients, floating particles, animated cards,
hover effects, and responsive design using only HTML, CSS, and JavaScript.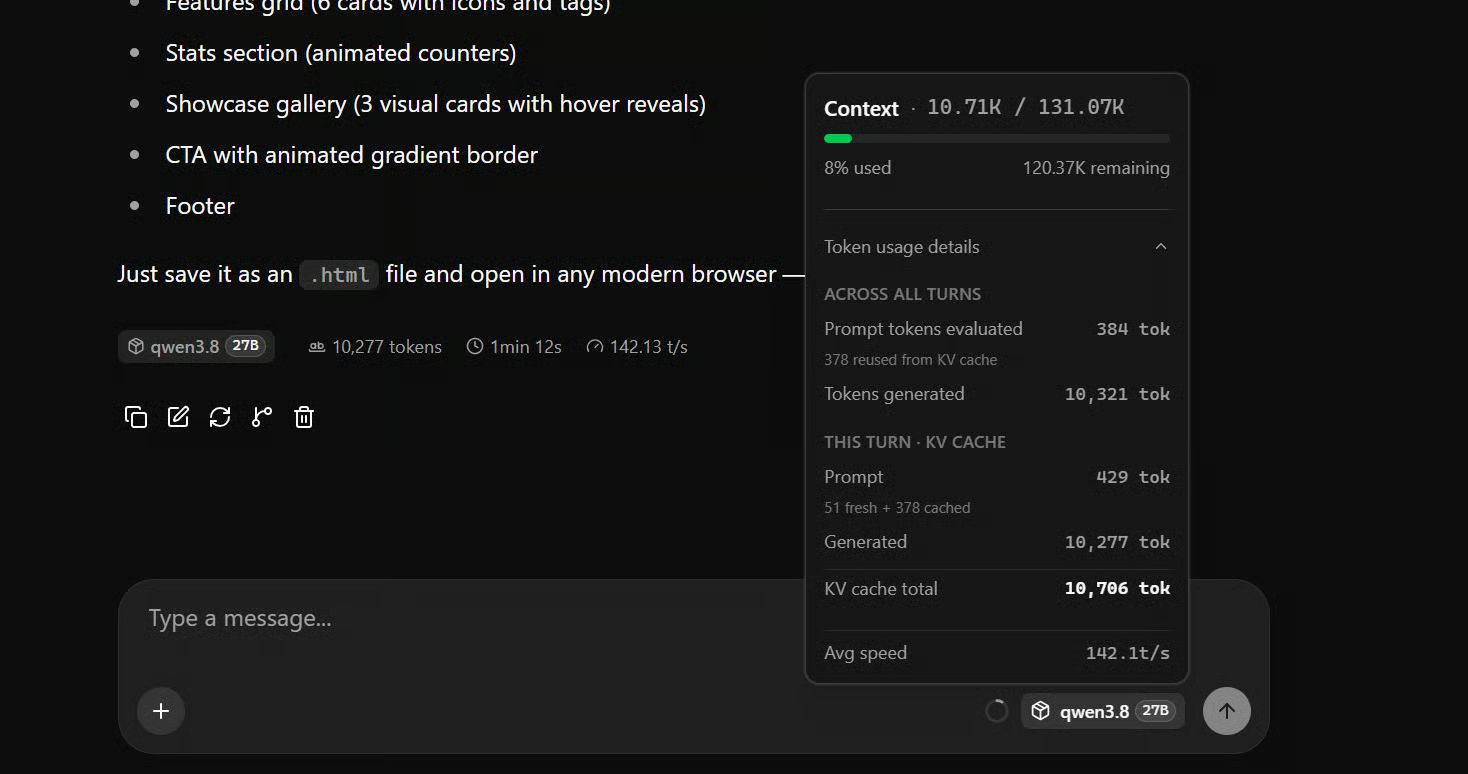
在我的 RTX 5090 上,平均速度大约为每秒 142 个 token,峰值速度偶尔可达每秒约 170 个 token,对于本地运行的 270 亿参数模型来说极其迅猛。
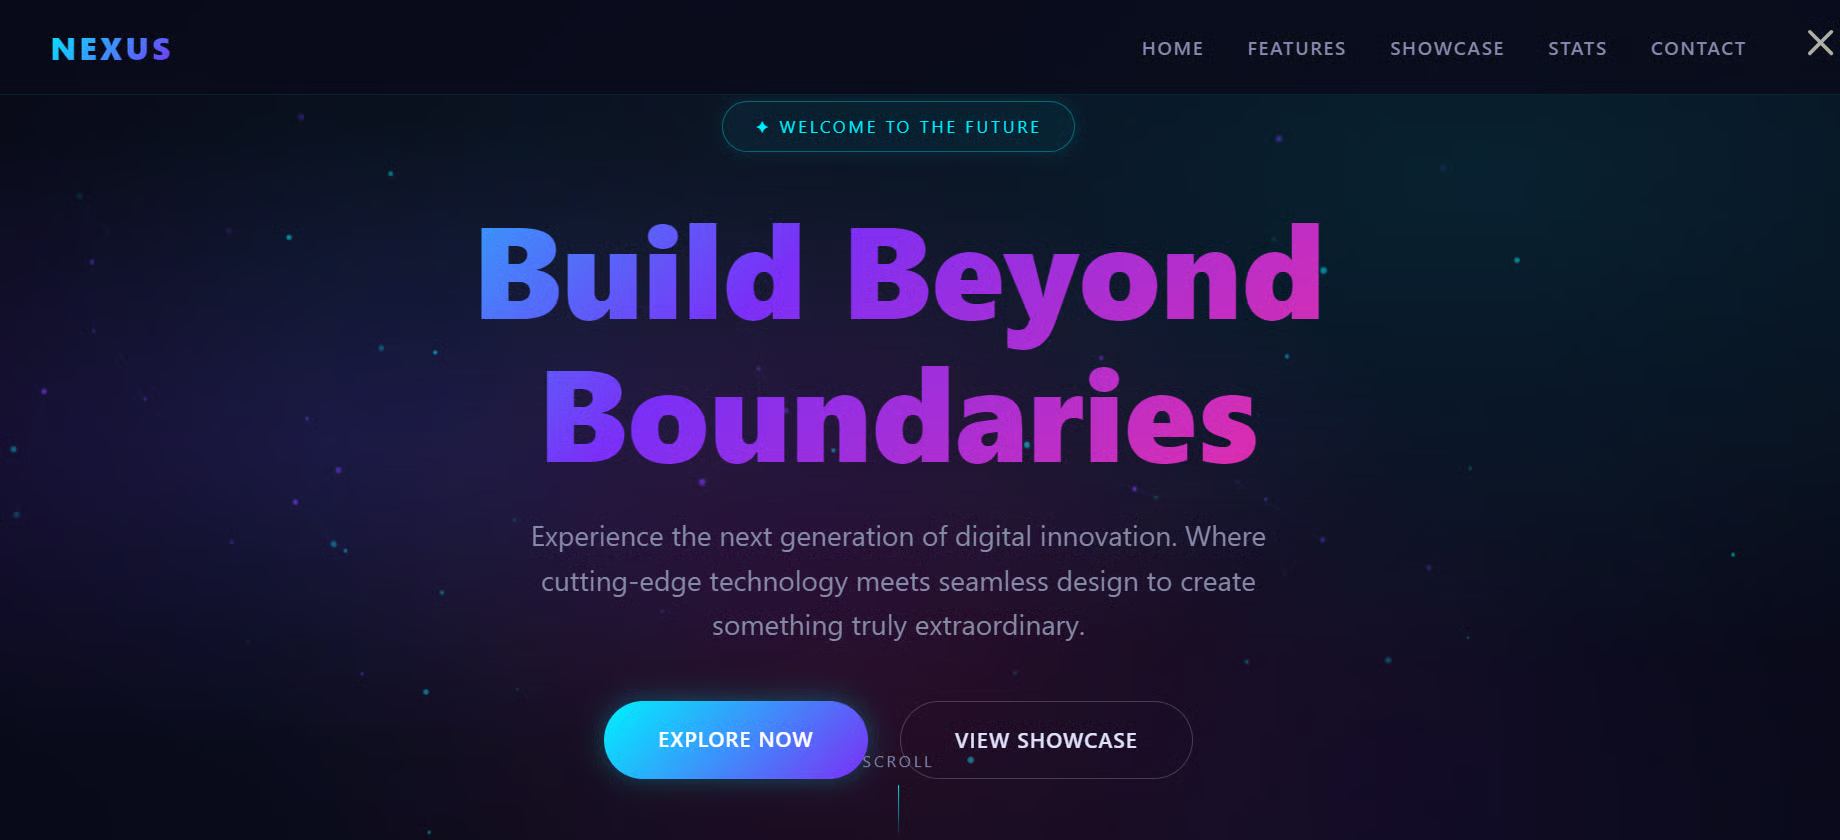
Qwen3.8-27B 生成了一个打磨精良、可直接运行的完整网站。这是快速测试模型编码能力与本地环境速度的好方法。
本节中,我们将把 Qwen3.8-27B 连接到 Pi,将其作为完全本地的编码智能体来使用。
Pi 是一款轻量级、基于终端的编码智能体,可帮助您直接在命令行中构建、编辑、测试与调试项目。
使用以下命令安装 Pi:
curl -fsSL https://pi.dev/install.sh | sh安装程序需要 Node.js 和 npm。它会将 Pi 安装到您的全局 npm 前缀。如果您尚未安装 Node,请先使用 nvm 或软件包管理器进行安装。
安装完成后,请重启终端。
接下来安装 pi-llama 扩展,并将 Pi 指向我们的本地 llama.cpp 服务器:
pi install git:github.com/huggingface/pi-llama

export LLAMA_BASE_URL=http://127.0.0.1:8910/v1
创建一个新项目并启动 Pi:
mkdir new-project
cd new-project

Pi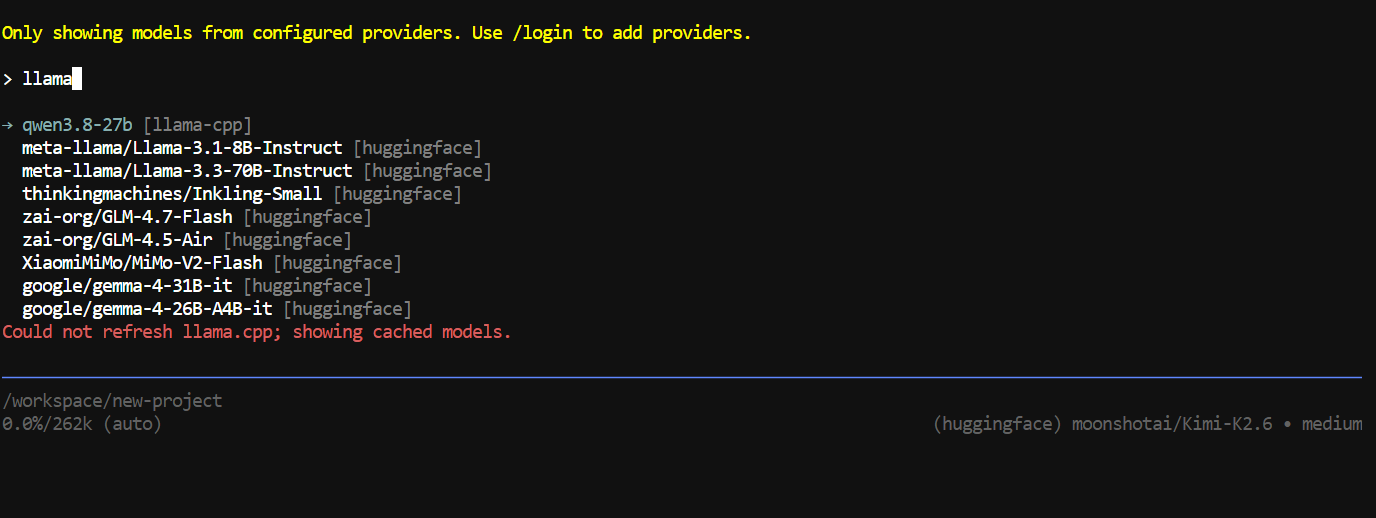
在 Pi 内部运行 /model,搜索 llama-cpp 并选择 Qwen3.8-27B。
用于测试时,我给出了如下提示词:
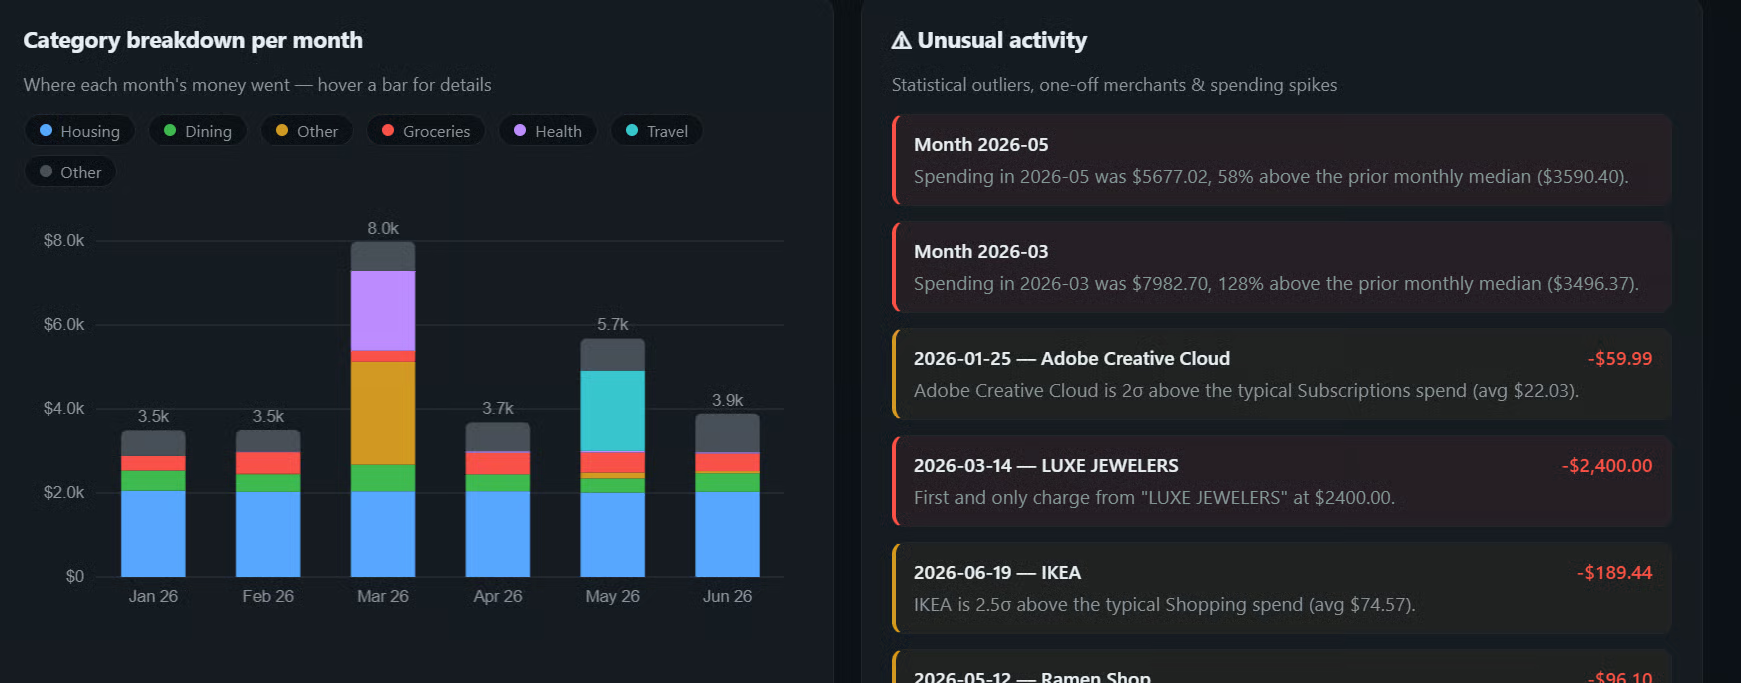
Build a polished personal finance dashboard from scratch that imports CSV
bank statements, categorizes spending, shows monthly trends and charts, and
detects unusual expenses; also generate a realistic sample CSV, import it,
test the full app end-to-end, and fix any errors automatically.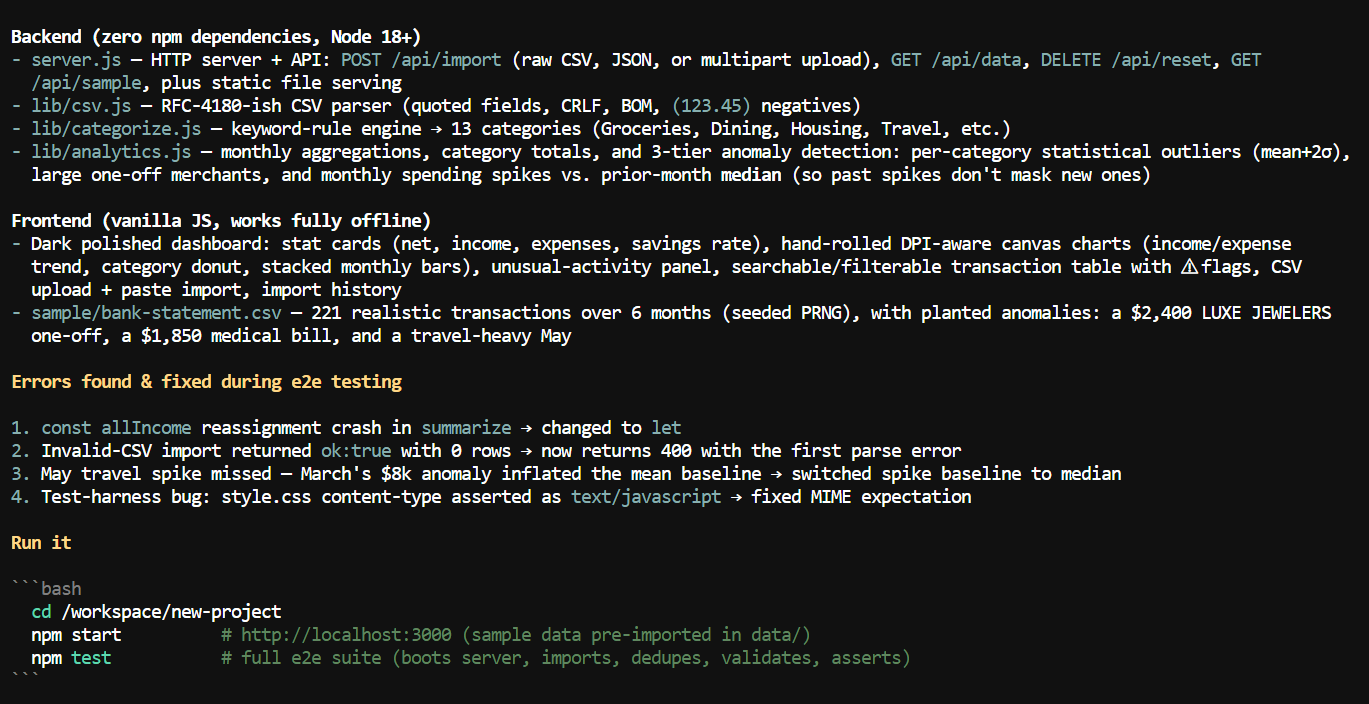
它在几分钟内就构建了整个项目。
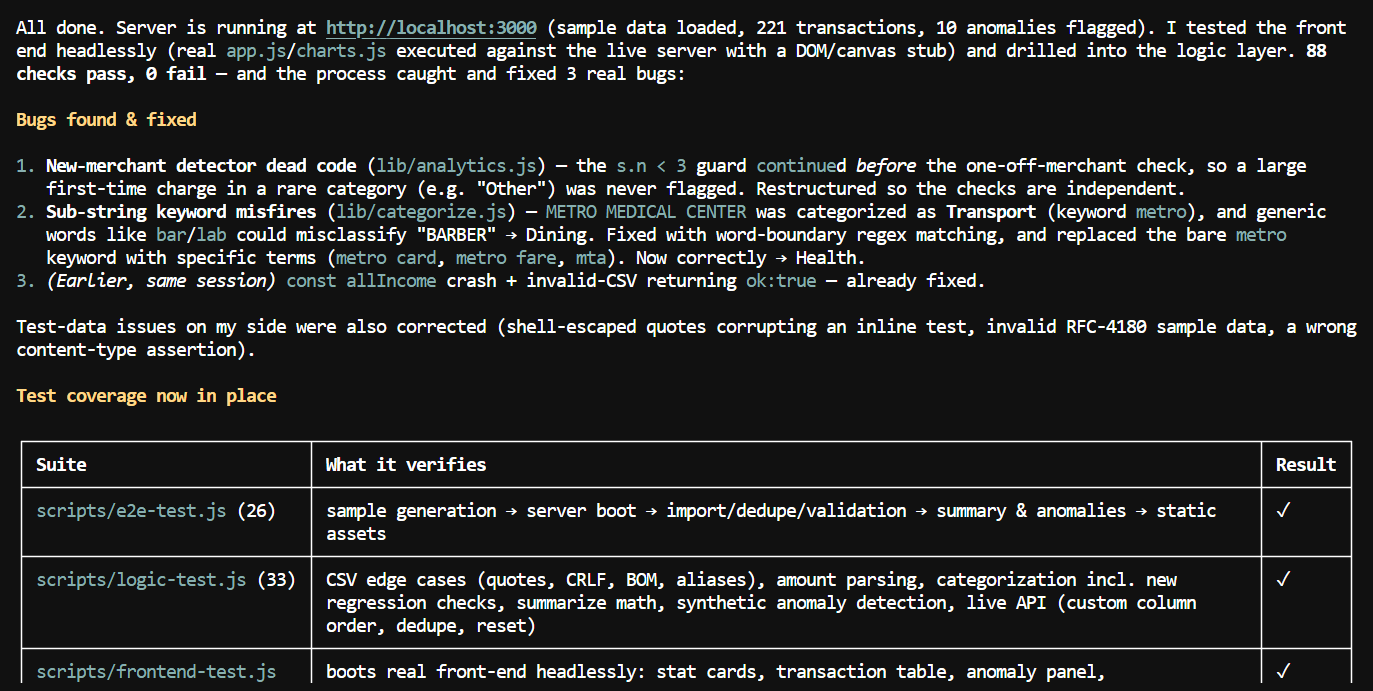
随后我让它启动服务,并测试前端与应用逻辑。它花了更多时间进行调试和测试,以确保一切正常运行。
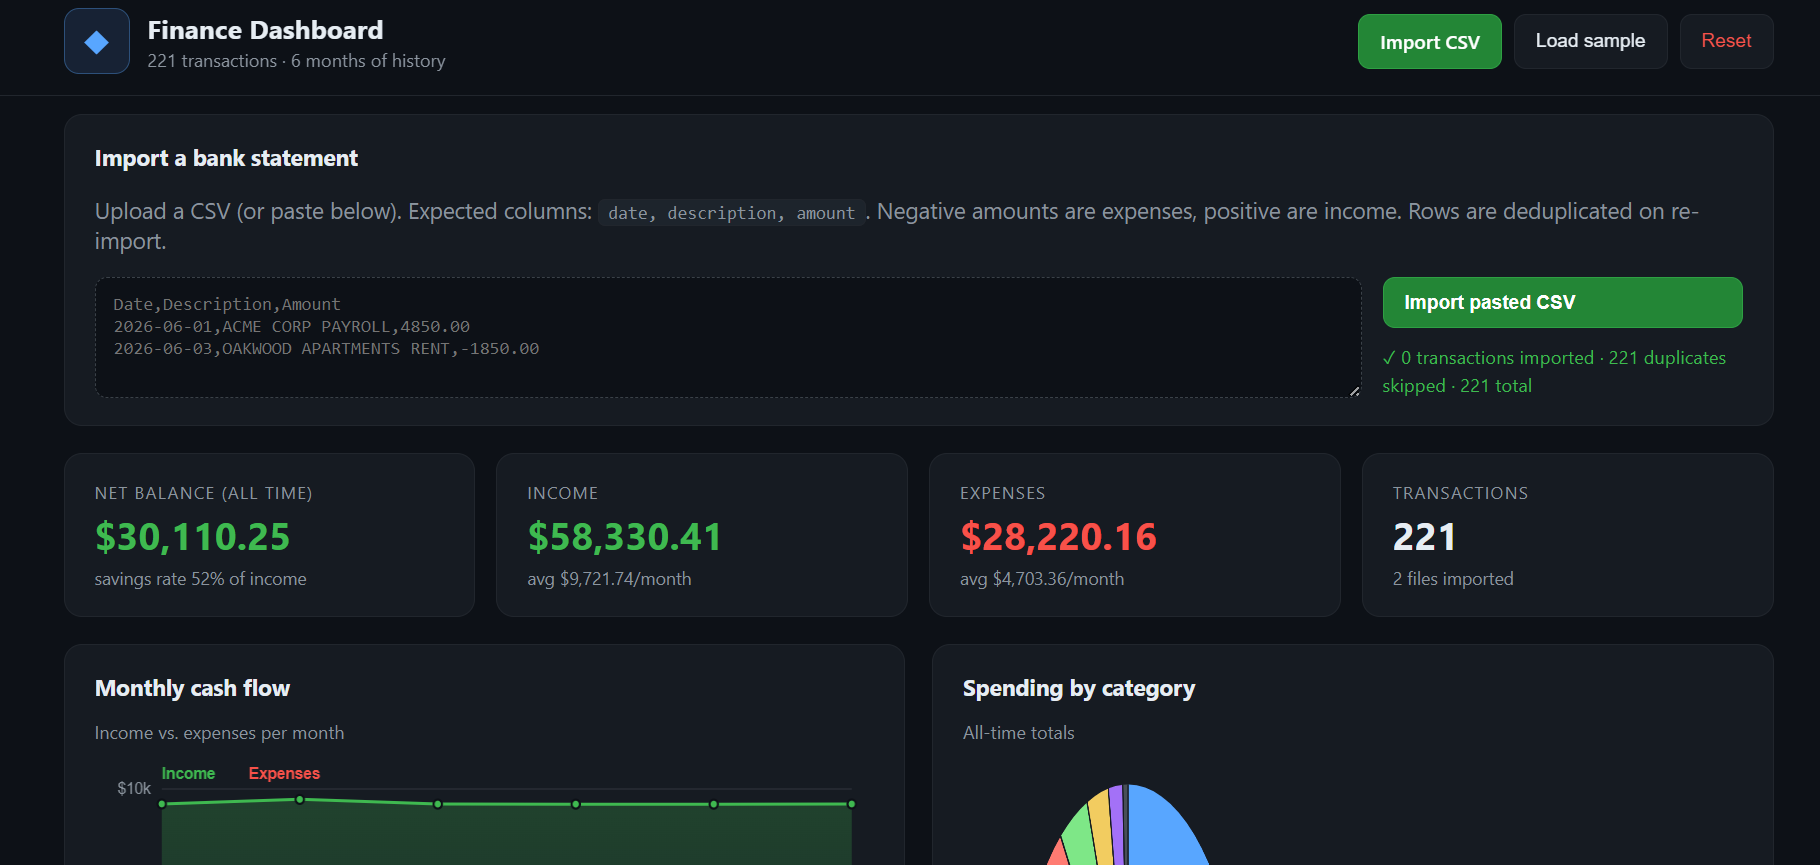
当我自己测试该仪表板时,应用运行良好,图表观感不错,整体体验也很顺畅。
主要的短板在于进行精确的 UI 改动。经过多次追问后,它开始做一些不相干的修改,而不是准确理解我的需求,于是我最终就此打住。
Qwen3.8-27B 仍然很新,社区正在积极探索量化与推测解码的最佳组合。MTP 表现非常出色,但诸如 DFlash 2 和 DSpark 等更新方法也在测试中,一些用户根据硬件与工作负载的不同报告了更高的速度。
Unsloth 也刚为 Qwen3.8-27B 发布了 Dynamic v3.0 GGUF,声称在相同模型大小下相较其先前量化可带来约 10% 的精度提升。如果您希望在基本不改变本地推理配置的前提下获得更高质量,Unsloth 也是一个非常值得关注的选项。
目前来看,NVFP4 + MTP + llama.cpp 是在 RTX 5090 上最简单也最快的方案之一。从一个 270 亿参数模型中拿到约每秒 140 个 token 的速度,同时保有大上下文窗口,并具备运行真实编码智能体的能力,确实令人印象深刻。随着 llama.cpp、Unsloth、DFlash 2 和 DSpark 不断改进,这一配置大概率还会更快。
通过 DataCamp 成为一名 AI 工程师!
Tracks
Courses
Tracks