

Czym są transformatory?
Transformatory powstały, by rozwiązać problem transdukcji sekwencji, czyli neuronowego tłumaczenia maszynowego — a więc do każdego zadania, które przekształca sekwencję wejściową w sekwencję wyjściową. Stąd nazwa „Transformers”.
Ale zacznijmy od początku.
Prosta definicja
Model transformer to sieć neuronowa, która uczy się kontekstu danych sekwencyjnych i na jego podstawie generuje nowe dane.
Mówiąc prościej:
Transformer to rodzaj modelu sztucznej inteligencji, który uczy się rozumieć i generować tekst przypominający ludzki, analizując wzorce w dużych zbiorach danych tekstowych.
Transformatory to obecnie czołowe modele NLP i uważa się je za ewolucję architektury enkoder–dekoder. Jednak podczas gdy ta architektura w dużej mierze opierała się na rekurencyjnych sieciach neuronowych (RNN) do wydobywania informacji sekwencyjnych, transformatory całkowicie pozbawione są rekurencji.
Więc jak to robią?
Są zaprojektowane specjalnie do uchwycenia kontekstu i znaczenia poprzez analizę relacji między elementami i niemal w całości opierają się na technice matematycznej zwanej attention.
Ilustracja autora.
Kontekst historyczny
Transformatory wprowadzili badacze Google w pracy z 2017 roku "Attention is All You Need". Kod wydano w pakiecie TensorFlow Tensor2Tensor, a grupa Harvard NLP przygotowała skommentowany przewodnik po pracy w PyTorchu. W osobnym tutorialu możesz też nauczyć się jak zaimplementować Transformera od zera.
W ciągu roku BERT Google i GPT-1 OpenAI pokazały, że transformer wstępnie wytrenowany na nieetykietowanym tekście można dostroić do niemal każdego zadania językowego. GPT-3 pojawił się w 2020 r., a badacze ze Stanfordu ukuli termin „modele fundamentowe” dla tej nowej klasy modeli.
Od tego czasu wszystko przyspieszyło: modele z otwartymi wagami jak Llama Meta (2023), modele multimodalne jak GPT-4o (2024), modele rozumujące jak o1 OpenAI i DeepSeek-R1 (koniec 2024 – początek 2025) oraz modele agentyczne jak GPT-5 (2025) i GPT-6 Astra (2026). Modele o publicznie opisanej konstrukcji wciąż są transformerami. Pełną historię znajdziesz w naszym artykule o historii dużych modeli językowych.
Przejście od modeli RNN do transformerów
Gdy Transformer się pojawił, rekurencyjne sieci neuronowe (RNN) i ich wariant LSTM były podstawowymi modelami do danych sekwencyjnych. Przetwarzają wejście element po elemencie, co powoduje dwa główne problemy:
- Wolne trenowanie: każdy krok czeka na poprzedni, więc RNN-y nie potrafią wykorzystać równoległych obliczeń, do których stworzono GPU.
- Zapominanie na długich dystansach: informacja przekazywana jest krok po kroku i im dłuższy łańcuch, tym większe ryzyko utraty.
Transformatory zachowały pomysł enkoder–dekoder z RNN, ale zastąpiły rekurencję mechanizmem attention, co rozwiązuje oba problemy: każde słowo może odwołać się bezpośrednio do każdego innego, niezależnie od odległości, a cała sekwencja jest przetwarzana równolegle.
Teraz zobaczmy, jak działają transformatory.
Jak działa architektura transformera?
Początkowo zaprojektowane do transdukcji sekwencji lub neuronowego tłumaczenia maszynowego, transformatory świetnie zamieniają sekwencje wejściowe na wyjściowe. To pierwszy model transdukcyjny oparty całkowicie na self-attention do obliczania reprezentacji wejścia i wyjścia, bez użycia sekwencyjnie wyrównanych RNN-ów czy konwolucji. Główną cechą rdzeniową architektury Transformerów jest utrzymanie modelu enkoder–dekoder.
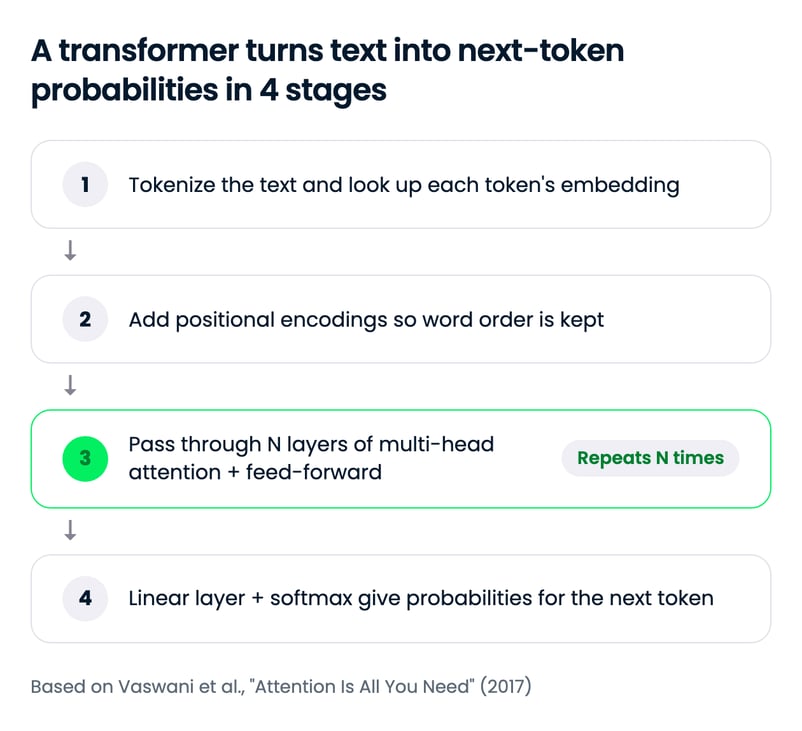
Jeśli potraktujemy Transformera do tłumaczenia języka jako prostą czarną skrzynkę, przyjmie zdanie w jednym języku, np. po angielsku, jako wejście i zwróci jego tłumaczenie po hiszpańsku.
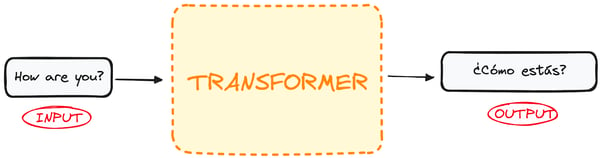
Ilustracja autora.
Gdy zajrzymy głębiej, zobaczymy, że ta czarna skrzynka składa się z dwóch głównych części:
- Enkoder przyjmuje wejście i zwraca jego reprezentację macierzową. Na przykład angielskie zdanie „How are you?”
- Dekoder przyjmuje tę zakodowaną reprezentację i iteracyjnie generuje wyjście. W naszym przykładzie przetłumaczone zdanie „¿Cómo estás?”
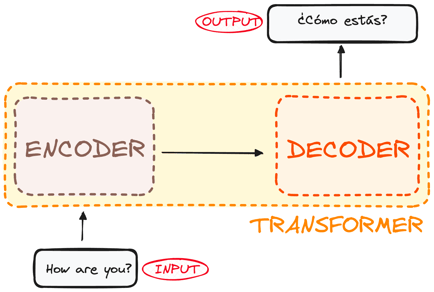
Ilustracja autora. Globalna struktura enkodera i dekodera.
Jednak zarówno enkoder, jak i dekoder to tak naprawdę stos wielu warstw (po tyle samo każdej). Wszystkie enkodery mają tę samą strukturę; wejście trafia do każdego z nich i przekazywane jest dalej. Wszystkie dekodery również mają tę samą strukturę i otrzymują wejście z ostatniego enkodera i poprzedniego dekodera.
Oryginalna architektura miała 6 enkoderów i 6 dekoderów, ale możemy powielać tyle warstw, ile chcemy. Przyjmijmy więc N warstw każdego typu.
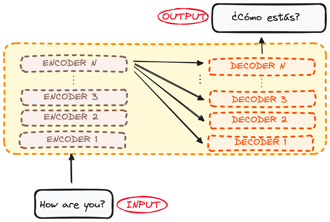
Ilustracja autora. Globalna struktura enkoder–dekoder. Wiele warstw.
Mając już ogólny obraz architektury Transformera, skupmy się na enkoderach i dekoderach, by lepiej zrozumieć ich przepływ działania:
Jak działa enkoder transformera?
Enkoder to podstawowy komponent architektury Transformera. Jego główną funkcją jest przekształcenie tokenów wejściowych w uwarunkowane kontekstem reprezentacje. W przeciwieństwie do wcześniejszych modeli, które przetwarzały tokeny niezależnie, enkoder Transformera uchwytuje kontekst każdego tokena względem całej sekwencji.
Jego struktura składa się z następujących elementów:
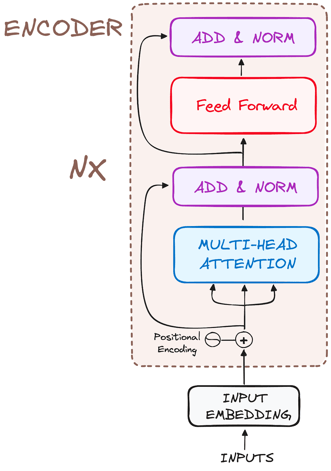
Ilustracja autora. Globalna struktura enkoderów.
Rozbijmy więc jego działanie na najprostsze kroki:
Krok 1: Osadzenia wejściowe
Osadzanie odbywa się tylko w najniższym enkoderze. Najpierw tokenizator dzieli tekst na tokeny, czyli słowa lub ich fragmenty, a każdy token mapowany jest na wyuczony wektor zwany osadzeniem. Tokeny o pokrewnych znaczeniach kończą z podobnymi wektorami.
Wszystkie enkodery otrzymują listę wektorów, każdy o 512 wymiarach w oryginalnej pracy (dmodel = 512). W najniższym enkoderze są to osadzenia słów, a w wyższych — wyjście bezpośrednio niższego enkodera.
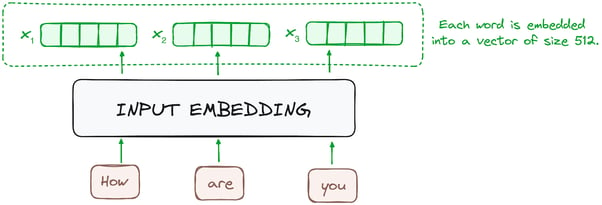
Ilustracja autora. Przepływ w enkoderze. Osadzenia wejściowe.
Krok 2: Kodowanie pozycyjne
Ponieważ Transformatory nie mają mechanizmu rekurencji jak RNN-y, używają kodowań pozycyjnych dodawanych do osadzeń wejściowych, aby dostarczyć informacji o położeniu każdego tokena w sekwencji. Pozwala im to rozumieć pozycję słów w zdaniu.
Aby to osiągnąć, badacze zaproponowali użycie kombinacji różnych funkcji sinus i cosinus do tworzenia wektorów pozycyjnych, co umożliwia stosowanie takiego kodowania dla zdań dowolnej długości.
W tym podejściu każdy wymiar reprezentowany jest unikalnymi częstotliwościami i przesunięciami fali, a wartości mieszczą się w zakresie od -1 do 1, skutecznie reprezentując każdą pozycję.
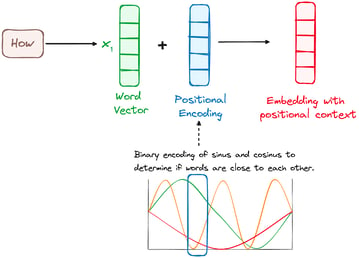
Ilustracja autora. Przepływ w enkoderze. Kodowanie pozycyjne.
Krok 3: Stos warstw enkodera
Enkoder Transformera składa się ze stosu identycznych warstw (6 w oryginalnym modelu).
Warstwa enkodera przekształca całe sekwencje wejściowe w ciągłą, abstrakcyjną reprezentację, która zawiera wyuczone informacje z całej sekwencji. Ta warstwa ma dwa podmoduły:
- Wielogłowy mechanizm attention.
- Sieć w pełni połączoną.
Dodatkowo obejmuje połączenia rezydualne wokół każdego podmodułu, po których następuje normalizacja warstwowa.
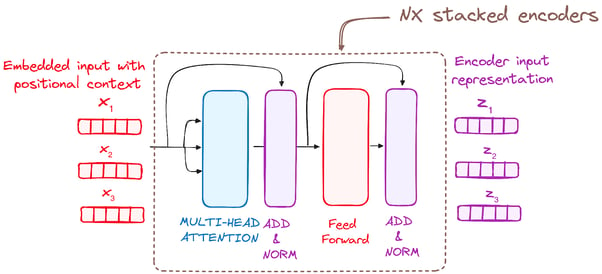
Ilustracja autora. Przepływ w enkoderze. Stos warstw enkodera
Krok 3.1: Wielogłowy mechanizm self-attention
W enkoderze wielogłowy attention wykorzystuje specjalny mechanizm uwagi zwany self-attention. Pozwala on modelom powiązać każde słowo wejścia z innymi słowami. Na przykład model może nauczyć się łączyć słowo „are” z „you”.
Mechanizm ten umożliwia enkoderowi skupianie się na różnych częściach sekwencji wejściowej podczas przetwarzania każdego tokena. Oblicza on wyniki uwagi na podstawie:
- Query to wektor reprezentujący konkretne słowo lub token z sekwencji wejściowej w mechanizmie uwagi.
- Key to również wektor w mechanizmie uwagi, odpowiadający każdemu słowu lub tokenowi w sekwencji wejściowej.
- Każda value jest powiązana z kluczem i służy do konstruowania wyjścia warstwy uwagi. Gdy query i key dobrze do siebie pasują, czyli mają wysoki wynik uwagi, odpowiadająca im value jest silniej akcentowana w wyjściu.
Ten pierwszy moduł self-attention pozwala modelowi uchwycić informacje kontekstowe z całej sekwencji. Zamiast wykonywać pojedynczą funkcję uwagi, zapytania, klucze i wartości są liniowo rzutowane h razy. Na każdej z tych zrzutowanych wersji query, key i value mechanizm uwagi działa równolegle, dając wyjście o wymiarze dv (64 w oryginalnej pracy, gdzie h = 8).
Szczegółowa architektura wygląda następująco:
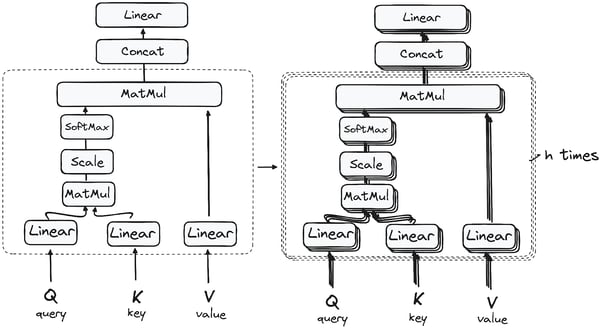
Mnożenie macierzy (MatMul): iloczyn skalarny query i key
Po przejściu wektorów query, key i value przez warstwę liniową wykonuje się mnożenie macierzowe iloczynem skalarnym między zapytaniami i kluczami, co skutkuje powstaniem macierzy wyników.
Macierz wyników określa, jak bardzo każde słowo powinno kłaść nacisk na inne słowa. Każdemu słowu przypisuje się więc wynik względem innych słów w tym samym kroku czasowym. Wyższy wynik oznacza większe skupienie.
Proces ten skutecznie odwzorowuje zapytania na odpowiadające im klucze.
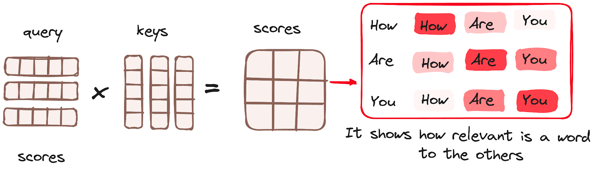
Ilustracja autora. Przepływ w enkoderze. Mechanizm uwagi — mnożenie macierzy.
Zmniejszanie skali wyników uwagi
Następnie wyniki są skalowane w dół przez podzielenie przez pierwiastek kwadratowy z wymiaru wektorów query i key. Ten krok zapewnia stabilniejsze gradienty, ponieważ mnożenie wartości może prowadzić do nadmiernie dużych efektów.
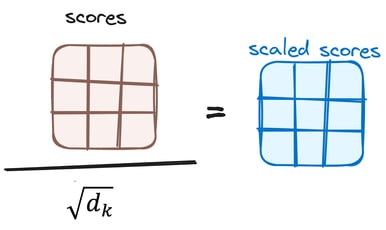
Ilustracja autora. Przepływ w enkoderze. Zmniejszanie wyników uwagi.
Zastosowanie softmax do skorygowanych wyników
Następnie do skorygowanych wyników stosuje się funkcję softmax, aby uzyskać wagi uwagi. Daje to wartości prawdopodobieństwa od 0 do 1. Funkcja softmax wzmacnia wyższe wyniki, a obniża niższe, zwiększając zdolność modelu do skutecznego określania, które słowa powinny otrzymać większą uwagę.
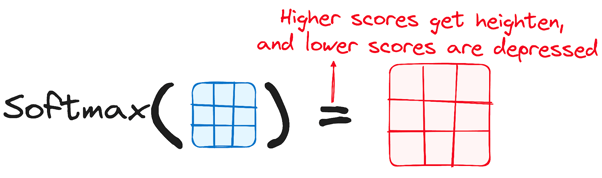
Ilustracja autora. Przepływ w enkoderze. Softmax skorygowanych wyników.
Łączenie wyników softmax z wektorem value
Kolejnym krokiem mechanizmu uwagi jest pomnożenie wag uzyskanych z funkcji softmax przez wektor value, co daje wektor wyjściowy.
Słowa z wysokimi wagami softmax dominują wynik, a słowa z wagami bliskimi 0 praktycznie nie wnoszą wkładu. Na koniec ten wektor wyjściowy trafia do warstwy liniowej w celu dalszego przetwarzania.
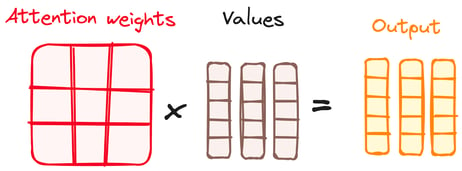
Ilustracja autora. Przepływ w enkoderze. Łączenie wyników Softmax z wektorem value.
I wreszcie otrzymujemy wyjście mechanizmu uwagi!
„Multi-head” wynika z uruchamiania tego procesu równolegle kilka razy. Zanim zacznie się uwaga, zapytania, klucze i wartości dzieli się na h mniejszych zestawów zwanych głowami i każda głowa wykonuje powyższe kroki na swojej części.
Wyniki głów są konkatenowane i przekazywane przez końcową warstwę liniową. Ponieważ każda głowa uczy się własnych projekcji, różne głowy mogą wychwytywać różne relacje, takie jak odniesienie zaimka do rzeczownika czy sąsiedztwo słów.
Aby głębiej zrozumieć mechanizm uwagi, zobacz nasz tutorial o wielogłowym attention w Transformerach.
Krok 3.2: Normalizacja i połączenia rezydualne
Każdy podmoduł w warstwie enkodera jest zakończony krokiem normalizacji. Dodatkowo wyjście każdego podmodułu dodaje się do jego wejścia (połączenie rezydualne), by łagodzić problem zanikającego gradientu i umożliwić budowę głębszych modeli. Ten proces powtórzy się także po sieci feed-forward.
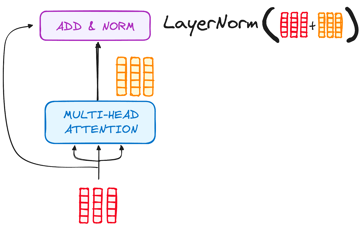
Ilustracja autora. Przepływ w enkoderze. Normalizacja i połączenie rezydualne po Multi-Head Attention.
Krok 3.3: Sieć neuronowa feed-forward
Następnie wyjście trafia do pozycyjnie działającej sieci feed-forward: 2 warstw liniowych z aktywacją ReLU między nimi, stosowanych osobno do każdego tokena. W oryginalnej pracy wewnętrzna warstwa ma 2048 wymiarów, czyli 4 razy więcej niż szerokość modelu 512.
Podobnie jak w attention, wejście sieci dodaje się z powrotem do jej wyjścia (połączenie rezydualne), a wynik się normalizuje.
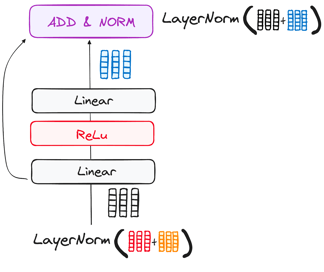
Ilustracja autora. Przepływ w enkoderze. Podwarstwa sieci feed-forward.
Krok 4: Wyjście enkodera
Wyjście końcowej warstwy enkodera to zestaw wektorów, z których każdy reprezentuje sekwencję wejściową z bogatym zrozumieniem kontekstu. Następnie służy ono jako wejście dla dekodera w modelu Transformera.
To staranne kodowanie toruje drogę dekoderowi, wskazując mu, na które słowa z wejścia ma zwracać uwagę podczas dekodowania.
Układanie N warstw enkodera pozwala każdej warstwie budować na reprezentacjach poniższej. Oryginalny model używał N = 6; BERT-Base używa 12, a BERT-Large 24.
Jak działa dekoder transformera?
Dekoder generuje sekwencję wyjściową. Jego warstwy odzwierciedlają enkoder z 1 dodatkiem: każda warstwa ma 2 podwarstwy wielogłowego attention zamiast 1, po których następuje pozycyjna sieć feed-forward, z połączeniem rezydualnym i normalizacją wokół każdej podwarstwy.
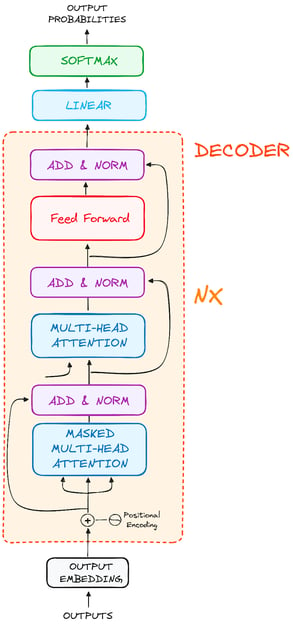
Ilustracja autora. Globalna struktura dekoderów.
Te komponenty działają podobnie jak warstwy enkodera, ale z istotnym zwrotem akcji: każda warstwa wielogłowego attention w dekoderze ma własną misję.
Ostatni etap procesu dekodera obejmuje warstwę liniową, pełniącą rolę klasyfikatora, a na końcu funkcję softmax do obliczania prawdopodobieństw różnych słów.
Dekoder Transformera ma strukturę zaprojektowaną specjalnie do generowania tego wyjścia przez stopniowe dekodowanie zakodowanej informacji.
Dekoder działa autoregresywnie: zaczyna od tokena początku sekwencji i na każdym kroku przyjmuje jako wejście tokeny wygenerowane do tej pory wraz z wyjściem enkodera.
Kończy, gdy wygeneruje token końca sekwencji.
Krok 1: Osadzenia wyjściowe
Na starcie dekodera proces odzwierciedla ten z enkodera. Wejście najpierw przechodzi przez warstwę osadzeń.
Krok 2: Kodowanie pozycyjne
Po osadzeniach, znów jak w enkoderze, wejście przechodzi przez warstwę kodowania pozycyjnego. Ta sekwencja wytwarza osadzenia pozycyjne.
Następnie te osadzenia trafiają do pierwszej warstwy wielogłowego attention dekodera, gdzie obliczane są wyniki uwagi dla samego wejścia dekodera.
Krok 3: Stos warstw dekodera
Dekoder składa się ze stosu identycznych warstw (6 w oryginalnym modelu). Każda warstwa ma trzy główne podkomponenty:
Krok 3.1: Maskowany mechanizm self-attention
To podobne do mechanizmu self-attention w enkoderze, ale z kluczową różnicą: uniemożliwia pozycjom zwracanie uwagi na kolejne pozycje, co oznacza, że każde słowo w sekwencji nie jest wpływane przez przyszłe tokeny.
Na przykład podczas obliczania wyników uwagi dla słowa „Cómo” ważne jest, by „Cómo” nie zerkało na „estás”, które jest kolejnym słowem w sekwencji wyjściowej.
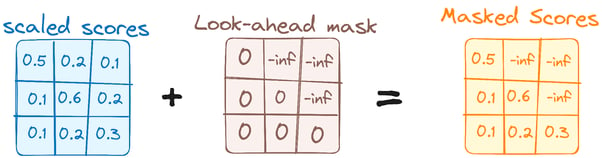
Ilustracja autora. Przepływ w dekoderze. Pierwsza maska Multi-Head Attention.
To maskowanie zapewnia, że predykcje dla danej pozycji mogą zależeć tylko od znanych wyjść na wcześniejszych pozycjach.
Krok 3.2: Uwaga enkoder–dekoder (cross-attention)
Druga podwarstwa uwagi łączy dekoder z enkoderem. Tutaj zapytania pochodzą z wyjścia maskowanego self-attention dekodera, a klucze i wartości — z końcowego wyjścia enkodera.
To pozwala każdej pozycji w dekoderze zwracać uwagę na wszystkie pozycje w zdaniu wejściowym, więc generując „estás”, dekoder może skupić się na „are you”. Wynik trafia następnie do podwarstwy feed-forward.
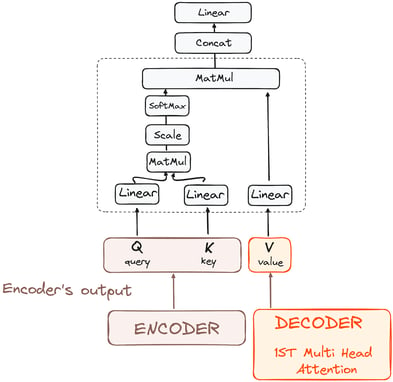
Ilustracja autora. Przepływ w dekoderze. Uwaga enkoder–dekoder.
Krok 3.3: Sieć neuronowa feed-forward
Podobnie jak w enkoderze, każda warstwa dekodera zawiera w pełni połączoną sieć feed-forward, stosowaną osobno i identycznie do każdej pozycji.
Krok 4: Klasyfikator liniowy i softmax
Podróż danych przez model transformera kończy się przejściem przez końcową warstwę liniową, która działa jak klasyfikator.
Rozmiar tego klasyfikatora odpowiada łącznej liczbie klas (liczbie słów w słowniku). Na przykład przy 1000 odrębnych klas, reprezentujących 1000 różnych słów, wyjście klasyfikatora będzie tablicą o 1000 elementach.
To wyjście trafia następnie do warstwy softmax, która przekształca je w rozkład prawdopodobieństw w zakresie 0–1. Token o najwyższym prawdopodobieństwie to najlepsze przypuszczenie modelu co do następnego słowa. Zachłanne dekodowanie zawsze go wybiera; większość modeli czatowych zamiast tego próbuje próbkujaco z rozkładu, z temperaturą kontrolującą poziom losowości.
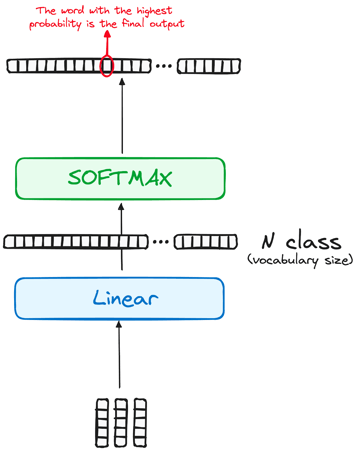
Ilustracja autora. Przepływ w dekoderze. Ostateczne wyjście Transformera.
Normalizacja i połączenia rezydualne
Każda podwarstwa (maskowany self-attention, uwaga enkoder–dekoder, sieć feed-forward) jest zakończona krokiem normalizacji i ma wokół siebie połączenie rezydualne.
Wyjście dekodera
Wyjście końcowej warstwy jest przekształcane w przewidywaną sekwencję, zwykle poprzez warstwę liniową, a następnie softmax do wygenerowania rozkładu po słowniku.
Dekoder w swoim przepływie działania włącza świeżo wygenerowane wyjście do rosnącej listy wejść, po czym kontynuuje dekodowanie. Cykl powtarza się, aż model przewidzi konkretny token, sygnalizujący zakończenie.
Podobnie jak enkoder, dekoder to stos N identycznych warstw (6 w oryginalnym modelu), z których każda buduje na wyjściu warstwy poniżej i na wyjściu enkodera. Głębsze stosy pozwalają różnym warstwom i głowom uchwycić różne wzorce uwagi.
Końcowa architektura wygląda tak (z oryginalnej pracy):
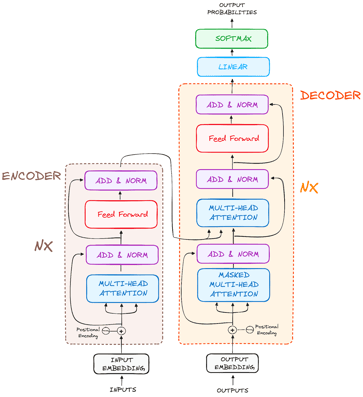
Ilustracja autora. Oryginalna struktura Transformerów.
Aby lepiej zrozumieć tę architekturę, polecam spróbować zastosować Transformera od zera, korzystając z tutorialu budowy transformera w PyTorch.
Transformatory tylko z enkoderem, tylko z dekoderem i enkoder–dekoder
Modele Transformer dzielą się na 3 rodziny, w zależności od tego, którą połowę oryginalnej architektury zachowują. Ten wybór decyduje, w czym model jest dobry: enkodery czytają, dekodery piszą, a enkodery–dekodery odwzorowują jedną sekwencję na drugą.
| Rodzina | Co zachowuje | Attention | Zadanie pre-treningowe | Typowe zastosowania | Przykłady |
|---|---|---|---|---|---|
| Tylko enkoder | Stos enkodera | Dwukierunkowe: każdy token widzi każdy token | Uzupełnianie maskowanych tokenów | Klasyfikacja, osadzenia do wyszukiwania, rozpoznawanie nazwanych encji | BERT, RoBERTa |
| Tylko dekoder | Stos dekodera, bez cross-attention | Przyczynowe: każdy token widzi tylko wcześniejsze tokeny | Przewidywanie następnego tokena | Czat, generowanie kodu, agenci | GPT-3, Llama, Gemini |
| Enkoder–dekoder | Oba stosy | Dwukierunkowy enkoder, przyczynowy dekoder, plus cross-attention | Odwzoruj sekwencję wejściową na sekwencję wyjściową | Tłumaczenie, streszczenia, rozpoznawanie mowy | Oryginalny Transformer, T5, Whisper |
Większość LLM-ów wydanych od GPT-3 to modele tylko z dekoderem. Przewidywanie następnego tokena działa na każdym surowym tekście, więc danych treningowych jest pod dostatkiem, a jeden model może obsłużyć tłumaczenie, streszczanie i odpowiadanie na pytania, traktując każde z tych zadań jako kontynuację tekstu.
Które modele używają architektury transformera?
BERT
BERT (Bidirectional Encoder Representations from Transformers), wydany jako open source przez Google w 2018 r., to transformer tylko z enkoderem. Zamiast przewidywać następne słowo, był wstępnie trenowany do uzupełniania maskowanych słów, korzystając z kontekstu z obu stron, co czyniło go silniejszym w zadaniach rozumienia niż ówczesne modele lewo‑do‑prawo.
Dzięki zrozumieniu kontekstu ze wszystkich stron słowa, BERT prześcignął wcześniejsze modele w zadaniach takich jak odpowiadanie na pytania i rozumienie niejednoznacznego języka. Jego rdzeń wykorzystuje Transformatory, dynamicznie łącząc każde wyjście i wejście.
BERT był wstępnie trenowany na angielskiej Wikipedii i zbiorze BooksCorpus, a Google dodało go do Wyszukiwarki w 2019 r., by lepiej interpretować zapytania w języku naturalnym. Zapoczątkował wyścig w budowie większych wstępnie trenowanych modeli językowych.
Aby dowiedzieć się więcej o BERT, zajrzyj do naszego osobnego artykułu, który wprowadza model BERT.
LaMDA
LaMDA (Language Model for Dialogue Applications) to model oparty na Transformerze opracowany przez Google, zaprojektowany specjalnie do zadań konwersacyjnych i zaprezentowany podczas keynote Google I/O w 2021 r. Jest projektowany tak, by generować bardziej naturalne i kontekstowo trafne odpowiedzi, poprawiając interakcje użytkowników w różnych aplikacjach.
Konstrukcja LaMDA pozwala mu rozumieć i odpowiadać na szeroki zakres tematów i intencji użytkowników, co czyni go idealnym do chatbotów, asystentów wirtualnych i innych interaktywnych systemów AI, gdzie kluczowa jest dynamiczna rozmowa.
Później Google zastąpiło LaMDA w czacie Bard modelem PaLM 2, a następnie Gemini, ale LaMDA był jednym z pierwszych modeli transformerów trenowanych specjalnie na dialogach.
Jeśli chcesz lepiej zrozumieć modele LaMDA, sięgnij po nasz artykuł o LaMDA.
GPT i ChatGPT
GPT i ChatGPT, opracowane przez OpenAI, to zaawansowane modele generatywne znane ze zdolności tworzenia spójnego i kontekstowo trafnego tekstu. GPT-1 był pierwszym modelem, uruchomionym w czerwcu 2018 r., a GPT-3, jeden z najbardziej wpływowych, pojawił się dwa lata później, w 2020 r.
Modele te świetnie sprawdzają się w wielu zadaniach, w tym w tworzeniu treści, rozmowie, tłumaczeniu języka i nie tylko. Architektura GPT pozwala generować tekst bardzo podobny do ludzkiego, co przydaje się w kreatywnym pisaniu, obsłudze klienta, a nawet asystowaniu w kodowaniu. ChatGPT, wariant zoptymalizowany pod rozmowę, doskonale generuje dialog przypominający ludzki, co zwiększa jego zastosowanie w chatbotach i asystentach wirtualnych.
OpenAI przestało publikować szczegóły architektury po GPT-3 (poza ich modelami z otwartymi wagami gpt-oss), ale rodzina stale rośnie, ostatnio wraz z GPT-6 Astra w 2026 r.
Claude
Claude, opracowany przez Anthropic, to rodzina asystentów AI opartych na Transformerach, zaprojektowanych z naciskiem na bezpieczeństwo i użyteczność. Claude używa Constitutional AI (CAI), podejścia treningowego, w którym model kieruje się zbiorem zasad, by generować pomocne, nieszkodliwe i uczciwe odpowiedzi.
Claude 3 (wydany w 2024 r.) wprowadził trzy poziomy modeli: Haiku, Sonnet i Opus, oferujące różne kompromisy między szybkością a możliwościami. Modele te wyróżniają się niuansowanym rozumowaniem, wykonywaniem złożonych instrukcji i utrzymywaniem kontekstu w długich rozmowach (do 200 tys. tokenów).
Anthropic odtąd wydaje nowe generacje co kilka miesięcy. Obecna linia Claude 5 obejmuje Claude Fable 5.1 i Claude Opus 5.5, oba wydane w 2026 r. Podobnie jak OpenAI, Anthropic nie publikuje szczegółów architektury.
Inne warianty
Liczba modeli transformerów szybko rośnie. Katalog modeli transformerów Xaviera Amatriaina klasyfikuje dziesiątki z nich według architektury i celu treningu, a benchmark HELM Stanfordu porównał 30 prominentnych modeli językowych obok siebie.
Coraz silniejszy jest trend otwierania tych modeli, a prym wiedzie hub modeli Hugging Face. Powstało też wiele modeli opartych na Transformerach, każdy wyspecjalizowany do różnych zadań NLP, co pokazuje wszechstronność i wydajność tej architektury w różnorodnych zastosowaniach.
Więcej o wszystkich istniejących modelach fundamentowych przeczytasz w osobnym artykule, który wyjaśnia, czym są i które są najczęściej używane.
Jak transformatory zmieniły się od 2017 roku?
Od oryginalnej architektury z 2017 r. Transformatory znacząco się rozwinęły, by pokonać ograniczenia i wejść w nowe domeny.
Czym nowoczesne LLM-y różnią się od oryginalnego Transformera
Dzisiejsze modele LLM z otwartymi wagami wciąż podążają za szkicem z 2017 r., ale niemal każdy komponent zastąpiono wariantem stabilniej trenującym lub tańszym w działaniu. Meta dokumentuje większość tych zmian w pracach LLaMA i Llama 3:
| Komponent | Oryginalny Transformer (2017) | Typowy dzisiejszy LLM z otwartymi wagami |
|---|---|---|
| Architektura | Enkoder–dekoder, 6 + 6 warstw | Tylko dekoder, od 32 warstw (Llama 3 8B) do 126 warstw (Llama 3 405B) |
| Szerokość modelu | 512 | 4096 (Llama 3 8B) do 16 384 (Llama 3 405B) |
| Informacja o pozycji | Stałe kodowania sinus/cosinus dodawane do osadzeń | Obrotowe osadzenia pozycyjne (RoPE) stosowane wewnątrz attention |
| Normalizacja | LayerNorm po każdej podwarstwie (post-norm) | RMSNorm przed każdą podwarstwą (pre-norm) |
| Aktywacja w feed-forward | ReLU | SwiGLU |
| Głowy uwagi | Multi-head attention, 8 głów | Grouped-query attention: kilka głów query współdzieli 1 głowę key–value (8 głów key–value w Llama 3) |
| Warstwa feed-forward | Gęsta | Gęsta lub mixture of experts (Llama 4, DeepSeek-V3) |
Vision Transformers (ViT)
Vision Transformers stosują mechanizm self-attention do obrazów, dzieląc je na łatki i traktując każdą łatkę jak token. To podejście okazało się bardzo skuteczne w klasyfikacji obrazów, detekcji obiektów i generowaniu obrazów, często przewyższając tradycyjne CNN-y na dużych zbiorach danych.
Transformatory multimodalne
Nowoczesne modele, takie jak GPT-5, Gemini 3 i Llama 4, przetwarzają wiele typów wejść (tekst, obrazy, audio, wideo) w jednej architekturze. Te multimodalne Transformatory używają zunifikowanych przestrzeni osadzeń i mechanizmów cross-attention, aby jednocześnie rozumować między różnymi modalnościami.
Transformatory wydajne
Kwadratowa złożoność self-attention ogranicza długość kontekstu. Kilka innowacji adresuje ten problem:
- Flash Attention: Oblicza dokładny attention w kafelkach mieszczących się w szybkiej pamięci na chipie GPU, więc użycie pamięci rośnie liniowo z długością sekwencji zamiast kwadratowo
- Rotary Position Embeddings (RoPE): Kodują informację o pozycji poprzez macierze obrotu, umożliwiając lepszą ekstrapolację do dłuższych sekwencji
- Uwaga liniowa i rzadka: Linformer i Performer aproksymują uwagę, a Longformer ogranicza większość tokenów do lokalnego okna, sprowadzając koszt do O(n) dla bardzo długich dokumentów
- Mixture of Experts (MoE): Aktywuje tylko podzbiór parametrów na token, umożliwiając większe modele przy podobnych kosztach obliczeń
Transformatory vs. RNN-y i CNN-y
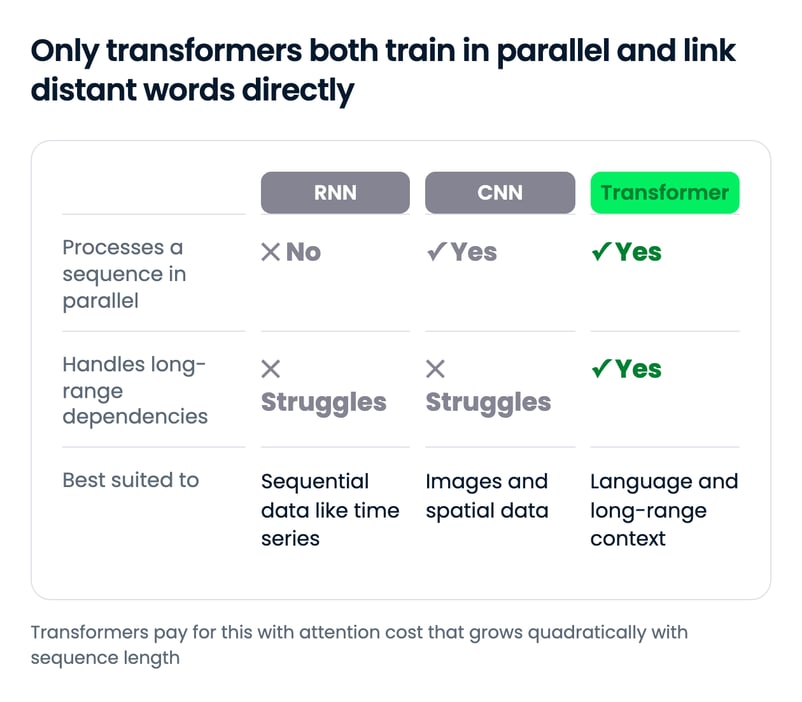
Transformatory zwykle porównuje się z 2 innymi klockami sieci neuronowych: warstwami rekurencyjnymi (RNN) i konwolucyjnymi (CNN). Każde lepiej pasuje do innego rodzaju danych.
Warstwy rekurencyjne
Warstwy rekurencyjne, filar rekurencyjnych sieci neuronowych (RNN), świetnie radzą sobie z danymi sekwencyjnymi. Siła tej architektury leży w zdolności do operacji sekwencyjnych, kluczowych w przetwarzaniu języka czy analizie szeregów czasowych. W warstwie rekurencyjnej wyjście z poprzedniego kroku trafia z powrotem jako wejście do kolejnego. Ta pętla pozwala sieci „pamiętać” wcześniejsze informacje, co jest istotne dla zrozumienia kontekstu sekwencji.
Jednak, jak już omawialiśmy, takie sekwencyjne przetwarzanie ma dwie główne konsekwencje:
- Może prowadzić do dłuższego treningu, ponieważ każdy krok zależy od poprzedniego, co utrudnia przetwarzanie równoległe.
- Często mają problem z długoterminowymi zależnościami z powodu zanikającego gradientu, przez co sieć gorzej uczy się z punktów danych odległych w sekwencji.
Modele Transformer znacząco różnią się od architektur z warstwami rekurencyjnymi, ponieważ nie mają rekurencji. Jak widzieliśmy, warstwa Attention w Transformerze rozwiązuje oba problemy, czyniąc je naturalną ewolucją RNN-ów dla zastosowań NLP.
Warstwy konwolucyjne
Z kolei warstwy konwolucyjne, budulec konwolucyjnych sieci neuronowych (CNN), słyną z efektywności w przetwarzaniu danych przestrzennych, takich jak obrazy.
Warstwy te używają jąder (filtrów), które skanują wejście, by wydobywać cechy. Szerokość tych jąder można regulować, pozwalając skupić się na małych lub dużych cechach, w zależności od zadania.
Choć warstwy konwolucyjne świetnie wychwytują hierarchie i wzorce przestrzenne w danych, zmagają się z długoterminowymi zależnościami. Z natury nie uwzględniają informacji sekwencyjnej, przez co gorzej nadają się do zadań wymagających zrozumienia kolejności lub kontekstu sekwencji.
Dlatego CNN-y i Transformatory są skrojone pod różne dane i zadania. CNN-y dominują w wizji komputerowej dzięki efektywności w przetwarzaniu informacji przestrzennej, a Transformatory są pierwszym wyborem do złożonych zadań sekwencyjnych, zwłaszcza w NLP, dzięki zdolności do rozumienia dalekich zależności.
Wady i ograniczenia transformerów
Mimo sukcesów Transformatory mają istotne ograniczenia:
- Złożoność kwadratowa: Self-attention skalują się jak O(n²) z długością sekwencji, co sprawia, że bardzo długie okna kontekstu są kosztowne obliczeniowo
- Wymagania pamięciowe: Duże modele wymagają znacznej pamięci GPU, co ogranicza opcje wdrożeń
- Wymagania danych treningowych: Transformatory zwykle potrzebują ogromnych zbiorów danych, by osiągnąć wysoką wydajność
- Halucynacje: Transformatory przewidują najbardziej prawdopodobne tokeny zamiast „sprawdzać fakty”, więc potrafią pewnie podawać fałszywe informacje. Modele rozumujące to ograniczają, ale nie eliminują
- Ograniczenia kodowania pozycji: Standardowe kodowania pozycyjne mają problem z uogólnianiem na długości sekwencji niewidziane podczas treningu
Badania nadal adresują te ograniczenia poprzez innowacje architektoniczne, takie jak Flash Attention, mixture-of-experts i generowanie wspomagane wyszukiwaniem (RAG).
Na koniec
Transformer działa, pozwalając każdemu tokenowi „spojrzeć” na każdy inny token poprzez self-attention, a następnie rafinując te reprezentacje przez stos identycznych warstw. Ten jeden wybór projektowy umożliwił równoległy trening na GPU i rozwiązał problem dalekiej pamięci, który ograniczał RNN-y.
Najbardziej uderza mnie, jak niewiele rdzeń się zmienił. LLM z 2026 r. podmienia kodowanie pozycji, normalizację i głowy uwagi na tańsze warianty, ale wciąż rozpoznasz w nim diagram z 2017 r. Otwartym pytaniem jest, czy modele przestrzeni stanów i hybrydy przejmą długie konteksty, czy może takie jądra jak FlashAttention utrzymają kwadratowy koszt uwagi na akceptowalnym poziomie.
Aby przećwiczyć to w praktyce, zbuduj Transformera w PyTorch w naszym przewodniku krok po kroku albo zacznij od modeli pretrained w naszym wprowadzeniu do Transformerów i Hugging Face. Jeśli chcesz zgłębić temat, polecam kurs Transformer Models with PyTorch lub ścieżkę Developing Large Language Models dla pełnej drogi.
FAQs
Jak działa architektura transformera?
Transformer dzieli tekst na tokeny, zamienia każdy token w osadzenie i dodaje informację o pozycji. Następnie stos warstw stosuje wielogłowy mechanizm self-attention, który pozwala każdemu tokenowi ważyć każdy inny token, po czym następuje sieć feed-forward, z połączeniami rezydualnymi i normalizacją wokół każdego kroku. Końcowa warstwa liniowa i softmax generują prawdopodobieństwa dla następnego tokena.
Czym różnią się transformatory tylko z enkoderem, tylko z dekoderem i enkoder–dekoder?
Modele tylko z enkoderem, takie jak BERT, czytają całe wejście dwukierunkowo i nadają się do klasyfikacji i wyszukiwania. Modele tylko z dekoderem, takie jak GPT i Llama, widzą tylko wcześniejsze tokeny i są trenowane do przewidywania następnego, co czyni je standardem dla czatowych LLM-ów. Modele enkoder–dekoder, takie jak T5 i oryginalny Transformer, odwzorowują sekwencję wejściową na sekwencję wyjściową, jak w tłumaczeniu.
Dlaczego transformatory zastąpiły RNN-y i LSTM-y?
RNN-y i LSTM-y przetwarzają tokeny po jednym, co spowalnia trening na GPU i powoduje zanikanie informacji na długich sekwencjach. Self-attention łączy każdy token bezpośrednio z każdym innym i przetwarza całą sekwencję równolegle, więc transformatory trenują szybciej i lepiej radzą sobie z dalekimi zależnościami.
Czy ChatGPT to transformer?
Tak. GPT oznacza Generative Pre-trained Transformer, a modele GPT stojące za ChatGPT to transformatory tylko z dekoderem, trenowane do przewidywania następnego tokena. OpenAI nie publikuje szczegółów architektury od GPT-3, ale każdy GPT jest zbudowany na projekcie transformera.
Jakie są główne ograniczenia transformerów?
Koszt self-attention rośnie kwadratowo z długością sekwencji, więc długie okna kontekstu są kosztowne obliczeniowo i pamięciowo. Transformatory potrzebują też dużych zbiorów treningowych i mogą „halucynować”, pewnie podając nieprawdziwe informacje. Techniki takie jak FlashAttention, grouped-query attention, mixture of experts i hybrydy z modelami przestrzeni stanów adresują te koszty.
Transformer to sieć neuronowa, która odczytuje wszystkie tokeny sekwencji jednocześnie i za pomocą self-attention decyduje, jak bardzo każdy token powinien czerpać z innych tokenów. Badacze Google przedstawili ją w pracy z 2017 roku „Attention Is All You Need”, a dziś stanowi podstawę niemal każdego dużego modelu językowego (LLM), od GPT i Llama po Gemini.
Architektura działa w 4 etapach. Tekst jest dzielony na tokeny i mapowany na osadzenia, dodawana jest informacja o położeniu, stos warstw przeplata wielogłowy mechanizm self-attention z sieciami feed-forward (każda owinięta połączeniem rezydualnym i normalizacją), a końcowa warstwa liniowa z softmaxem zamienia ostatni wektor w rozkład prawdopodobieństw po słowniku. Oryginalny model łączył enkoder z dekoderem; większość dzisiejszych LLM-ów zachowuje tylko dekoder.
W tym tutorialu przeprowadzę cię przez każdy etap oryginalnego projektu enkoder–dekoder, a potem pokażę, jak BERT, GPT i współczesne LLM-y go zmieniły. Jeśli wolisz najpierw intuicję, przeczytaj nasze wyjaśnienia mechanizmu attention i self-attention.
TL;DR