

トランスフォーマーとは?
トランスフォーマーは、系列変換(シーケンストランスダクション)すなわちニューラル機械翻訳の問題を解くために最初に開発されました。つまり、入力の系列を出力の系列に変換するあらゆるタスクを解くためのものです。これが「Transformer(変換器)」という名前の由来です。
では、基礎から見ていきましょう。
簡単な定義
トランスフォーマーモデルは、逐次データの文脈を学習し、そこから新しいデータを生成するニューラルネットワークです。
噛み砕いて言うと:
トランスフォーマーは、大量のテキストデータに潜むパターンを分析して、人間らしい文章を理解・生成することを学ぶAIモデルの一種です。
トランスフォーマーは現在のNLPにおける最先端モデルであり、エンコーダ・デコーダアーキテクチャの発展形と見なされています。ただし、エンコーダ・デコーダが主にRNN(再帰型ニューラルネットワーク)に依拠して逐次情報を抽出していたのに対し、トランスフォーマーには再帰性が一切ありません。
では、どうやって実現しているのでしょうか?
トランスフォーマーは、要素間の関係性を分析して文脈や意味を理解するよう特別に設計されており、そのためにほぼ完全に「注意(attention)」という数学的手法に依存します。
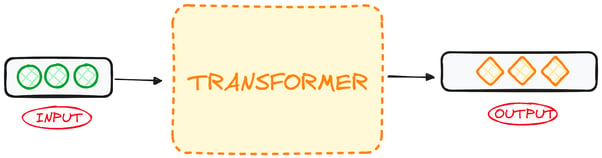
画像:筆者作成
歴史的背景
トランスフォーマーは2017年、Googleの研究者による論文「Attention is All You Need」で提案されました。コードはTensorFlowのTensor2Tensorパッケージで公開され、Harvard NLPグループがPyTorchで注釈付きガイドを続けて発表しました。別のチュートリアルでは、Transformerをゼロから実装する方法も学べます。
1年以内に、GoogleのBERTとOpenAIのGPT-1が、ラベルなしテキストで事前学習したトランスフォーマーが、ほぼあらゆる言語タスクに微調整可能であることを示しました。2020年にはGPT-3が登場し、スタンフォードの研究者はこの新しいモデル群を「基盤モデル」と名付けました。
それ以降の進化は目覚ましく、MetaのLlama(2023)のようなオープンウェイトモデル、GPT-4o(2024)のようなマルチモーダルモデル、OpenAIのo1やDeepSeek-R1(2024年末〜2025年初頭)のような推論モデル、GPT-5(2025)やGPT-6 Astra(2026)のようなエージェント的モデルが現れました。設計が公開されているモデルは、依然としてすべてトランスフォーマーに基づいています。全体像は大規模言語モデルの歴史をご覧ください。
RNNモデルからトランスフォーマーへの転換
トランスフォーマーが登場した当時、再帰型ニューラルネットワーク(RNN)やその変種であるLSTMが逐次データの定番でした。これらは入力を1要素ずつ処理するため、主に2つの問題が生じます:
- 学習が遅い:各ステップが前のステップを待つため、GPUが得意とする並列計算を活用できない。
- 長距離での忘却:情報がステップごとに受け渡されるため、チェーンが長くなるほど失われやすい。
トランスフォーマーはRNNのエンコーダ・デコーダという発想を保ちつつ、再帰を注意に置き換えました。これにより両方の問題が解決されます。離れた単語同士でも直接参照でき、系列全体を並列に処理できるからです。
それでは、トランスフォーマーの仕組みを見ていきましょう。
トランスフォーマーのアーキテクチャはどう動く?
もともと系列変換やニューラル機械翻訳のために考案されたトランスフォーマーは、入力系列を出力系列に変換するのが得意です。これは、系列整列したRNNや畳み込みを使わず、自己注意のみによって入出力の表現を計算する初のトランスダクションモデルでした。トランスフォーマーの中核的特徴は、エンコーダ・デコーダモデルを維持している点です。
翻訳のためのブラックボックスとして単純化して考えると、英語などのある言語の文を入力として受け取り、スペイン語への翻訳を出力します。
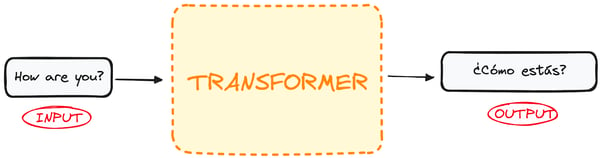
画像:筆者作成
少し中を覗くと、このブラックボックスは2つの主要部分で構成されています:
- エンコーダは入力を受け取り、その行列表現を出力します。例:英語文 “How are you?”
- デコーダはその符号化表現を受け取り、反復的に出力を生成します。例:翻訳された文 “¿Cómo estás?”
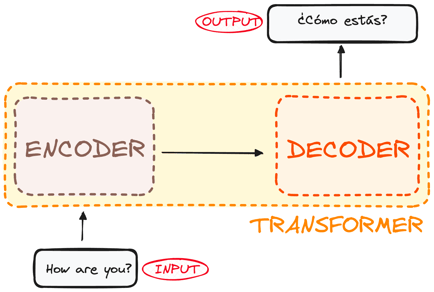
画像:筆者作成(エンコーダ・デコーダの全体構造)
ただし、エンコーダとデコーダはいずれも複数層のスタックです(それぞれ同数)。すべてのエンコーダは同じ構造で、入力は各層を順に通過します。デコーダも同様に同じ構造で、最後のエンコーダと直前のデコーダから入力を受け取ります。
元のアーキテクチャはエンコーダ6層、デコーダ6層でしたが、層数は任意に複製可能です。ここでは各N層と仮定しましょう。
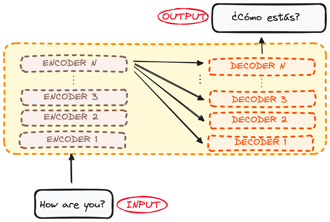
画像:筆者作成(エンコーダ・デコーダの全体構造:多層)
全体像が掴めたところで、エンコーダとデコーダそれぞれの処理フローに焦点を当てましょう。
トランスフォーマーのエンコーダはどう動く?
エンコーダはトランスフォーマーの基本構成要素です。主な役割は、入力トークンを文脈化された表現へと変換すること。従来のトークンを独立に処理するモデルと異なり、トランスフォーマーのエンコーダは系列全体に対する各トークンの文脈を捉えます。
構造は次のように構成されます:
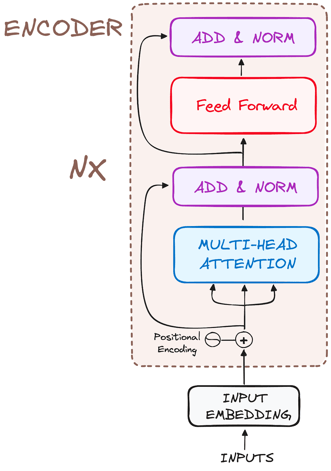
画像:筆者作成(エンコーダの全体構造)
では、ワークフローを基本ステップに分解します。
ステップ1:入力埋め込み(embedding)
埋め込みは最下層のエンコーダでのみ行われます。まずトークナイザがテキストをトークン(単語または単語の一部)に分割し、各トークンを埋め込みと呼ばれる学習済みベクトルに対応付けます。意味が近いトークンは類似したベクトルになります。
すべてのエンコーダはベクトルのリストを受け取ります。元論文では各ベクトルは512次元(dmodel = 512)です。最下層では単語埋め込みですが、それ以外の層では直下のエンコーダの出力になります。
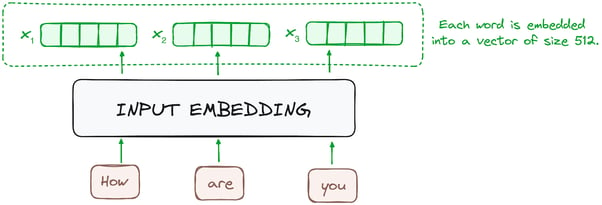
画像:筆者作成。エンコーダのワークフロー:入力埋め込み
ステップ2:位置エンコーディング
トランスフォーマーにはRNNのような再帰機構がないため、系列内の各トークンの位置情報を付与するために位置エンコーディングを入力埋め込みに加えます。これにより、文中での各単語の位置を理解できます。
研究者は、さまざまな正弦波・余弦波の組み合わせで位置ベクトルを作る方法を提案し、任意長の文にも対応できる位置エンコーディングを実現しました。
この手法では、各次元が固有の周波数と位相オフセットで表され、値は-1から1の範囲を取り、位置を効果的に表現します。
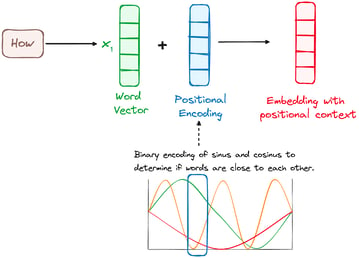
画像:筆者作成。エンコーダのワークフロー:位置エンコーディング
ステップ3:エンコーダ層のスタック
トランスフォーマーのエンコーダは、同一の層を積み重ねたスタックで構成されます(元のモデルでは6層)。
エンコーダ層は、全入力系列を連続的・抽象的な表現に変換し、系列全体から学習した情報をまとめ上げます。層は2つのサブモジュールから構成されます:
- マルチヘッド注意機構
- 全結合ネットワーク
さらに、各サブ層の周囲に残差接続を設け、その後に層正規化を行います。
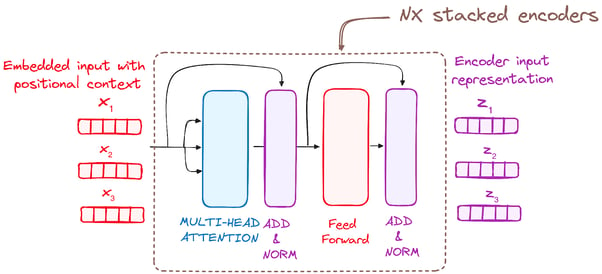
画像:筆者作成。エンコーダのワークフロー:エンコーダ層のスタック
ステップ3.1:マルチヘッド自己注意機構
エンコーダでは、マルチヘッド注意は自己注意と呼ばれる特殊な注意機構を用います。これにより、入力中の各単語同士を関連付けられます。たとえば、“are”と“you”を結びつける、といった具合です。
この機構により、エンコーダは各トークンを処理するときに、入力系列の異なる部分に焦点を当てられます。注意スコアは次に基づいて計算されます:
- クエリ(query):注意機構における、入力系列中の特定の単語(トークン)を表すベクトル。
- キー(key):注意機構において、入力系列の各単語(トークン)に対応するベクトル。
- バリュー(value):各キーに対応するベクトルで、注意層の出力を構成します。クエリとキーの一致度(注意スコア)が高いほど、対応するバリューが出力で強調されます。
この最初の自己注意モジュールにより、モデルは系列全体から文脈情報を捉えられます。単一の注意ではなく、クエリ・キー・バリューをそれぞれh回だけ線形射影します。各投影に対して注意機構を並列に実行し、各々がdv次元の出力を生成します(元論文では64、h = 8)。
詳細なアーキテクチャは次の通りです:
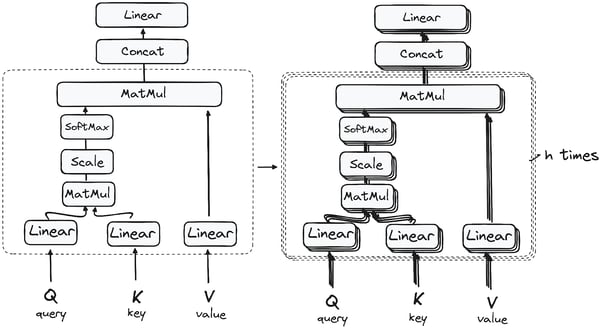
行列積(MatMul):クエリとキーの内積
クエリ、キー、バリューの各ベクトルを線形層に通した後、クエリとキーの間で内積の行列積を行い、スコア行列を作成します。
スコア行列は、各単語が他の単語にどの程度注目すべきかを示します。したがって、各単語には同一タイムステップ内の他の単語との相対スコアが割り当てられます。スコアが高いほど注目度が高いということです。
この過程は、クエリを対応するキーへ効果的にマッピングします。
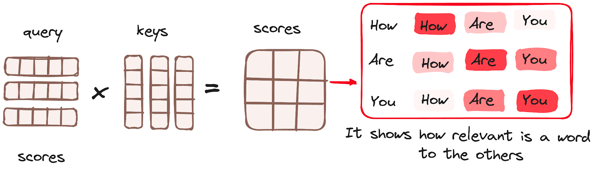
画像:筆者作成。エンコーダのワークフロー:注意機構 - 行列積
注意スコアのスケーリング(縮小)
次に、クエリとキーの次元の平方根でスコアを割ってスケーリングします。これは勾配を安定させるためで、値の乗算により効果が過大になるのを防ぎます。
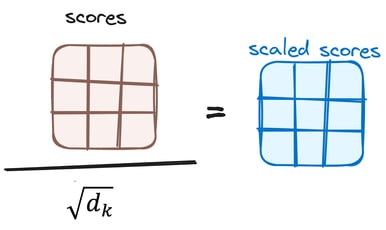
画像:筆者作成。エンコーダのワークフロー:注意スコアの縮小
スコアへのソフトマックス適用
調整後のスコアにソフトマックス関数を適用して注意重みを得ます。これにより0〜1の確率が得られます。ソフトマックスは高いスコアを強調し、低いスコアを抑えるため、どの単語により注目すべきかを効果的に判断できるようになります。
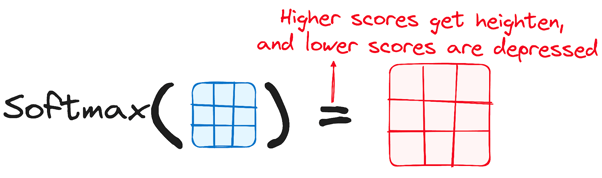
画像:筆者作成。エンコーダのワークフロー:ソフトマックスで調整したスコア
ソフトマックス結果とバリューベクトルの結合
次のステップでは、ソフトマックスで得た重みとバリューベクトルを掛け合わせ、出力ベクトルを得ます。
重みが高い単語が結果を支配し、0に近い重みの単語はほとんど寄与しません。最後に、この出力ベクトルを線形層に入力してさらに処理します。
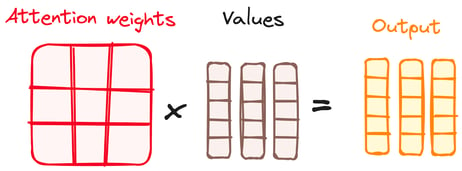
画像:筆者作成。エンコーダのワークフロー:ソフトマックス結果とバリューベクトルの結合
これで注意機構の出力が得られます!
「マルチヘッド」という名称は、この処理を並列に複数回実行することに由来します。注意を始める前に、クエリ・キー・バリューをh個の小さな集合(ヘッド)に分割し、各ヘッドが自分の分割に対して上述の手順を個別に実行します。
各ヘッドの出力を連結し、最終的な線形層を通します。各ヘッドが独自の射影を学習するため、ヘッドごとに異なる関係性(代名詞が指す名詞や、隣接単語など)を捉えられます。
注意機構のより深い理解には、トランスフォーマーのマルチヘッド注意のチュートリアルをご覧ください。
ステップ3.2:正規化と残差接続
各エンコーダ層の各サブ層の後には正規化が入ります。また、各サブ層の出力はその入力に加算されます(残差接続)。これは勾配消失を緩和し、より深いモデルを可能にします。この処理はフィードフォワードネットワークの後にも繰り返されます。
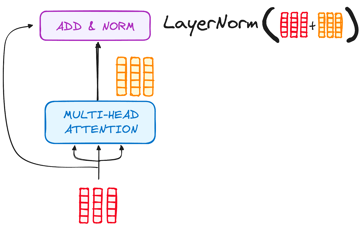
画像:筆者作成。エンコーダのワークフロー:マルチヘッド注意後の正規化と残差接続
ステップ3.3:フィードフォワードニューラルネットワーク
次に、出力は位置ごとのフィードフォワードネットワーク(2つの線形層の間にReLU活性化)を通過します。各トークンに独立に適用されます。元論文では内側の層は2,048次元で、モデル幅512の4倍でした。
注意と同様に、ネットワークの入力を出力に加算して(残差接続)、その結果を正規化します。
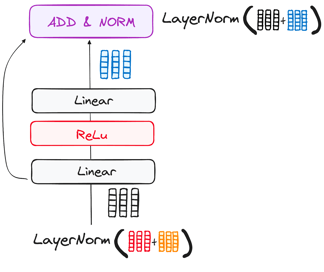
画像:筆者作成。エンコーダのワークフロー:フィードフォワードNNサブ層
ステップ4:エンコーダの出力
最終エンコーダ層の出力はベクトル群で、入力系列を豊かな文脈理解をもって表します。この出力がトランスフォーマーモデルのデコーダへの入力になります。
この丁寧な符号化がデコーダの道筋をつけ、復号時に入力のどの単語に注意を払うべきかを導きます。
エンコーダ層をN段重ねることで、各層が下位の表現を土台に構築できます。元のモデルはN=6、BERT-Baseは12、BERT-Largeは24です。
トランスフォーマーのデコーダはどう動く?
デコーダは出力系列を生成します。層構成はエンコーダをほぼ踏襲しつつ1点だけ追加があり、各層に自己注意の他にもう1つマルチヘッド注意(計2つ)があり、その後に位置ごとのフィードフォワードネットワークが続き、各サブ層の周囲は残差接続と層正規化で包まれます。
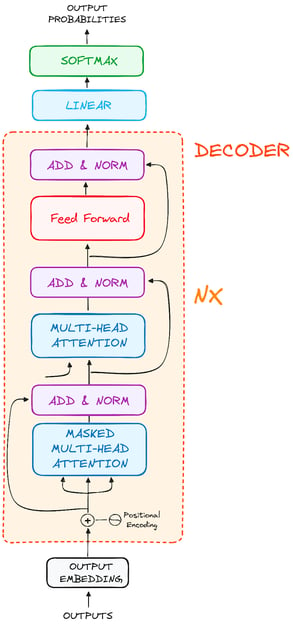
画像:筆者作成。デコーダの全体構造
これらの構成要素はエンコーダ層と似た動作をしますが、ひとひねりあります。デコーダの各マルチヘッド注意層には固有の役割があるのです。
デコーダの最終段では、分類器として機能する線形層を通し、ソフトマックスで単語の確率を計算します。
トランスフォーマーのデコーダは、符号化情報を段階的に復号して出力を生成するよう特別に設計されています。
デコーダは自己回帰的に動作します。開始トークンから始め、各ステップでこれまでに生成したトークン列とエンコーダの出力を入力として受け取ります。
終了トークンを生成したら停止します。
ステップ1:出力埋め込み
デコーダの入り口では、処理はエンコーダと同様です。まず入力は埋め込み層を通ります。
ステップ2:位置エンコーディング
埋め込みの後、エンコーダと同様に位置エンコーディング層を通過します。これにより位置埋め込みが生成されます。
この位置埋め込みがデコーダ最初のマルチヘッド注意層に入り、デコーダ自身の入力に対する注意スコアが計算されます。
ステップ3:デコーダ層のスタック
デコーダは同一の層を積み重ねたスタックで構成されます(元のモデルでは6層)。各層には3つの主なサブコンポーネントがあります:
ステップ3.1:マスク付き自己注意
これはエンコーダの自己注意と似ていますが、重要な違いがあります。未来の位置への注意を遮断する点です。つまり各単語は将来のトークンに影響されません。
たとえば“Cómo”の注意スコアを計算する際、“Cómo”が出力系列の後続語である“estás”を覗き見しないようにする必要があります。
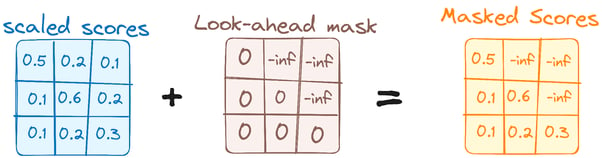
画像:筆者作成。デコーダのワークフロー:最初のマルチヘッド注意のマスク
このマスキングにより、ある位置の予測は、それ以前の既知の出力にのみ依存します。
ステップ3.2:エンコーダ・デコーダ注意(クロスアテンション)
2つ目の注意サブ層は、デコーダをエンコーダに接続します。ここでは、クエリはデコーダのマスク付き自己注意の出力から、キーとバリューはエンコーダの最終出力から来ます。
これにより、デコーダの各位置が入力文のすべての位置に注意を向けられます。したがって“estás”を生成する際、デコーダは“are you”に焦点を当てられます。その結果はフィードフォワードサブ層に送られます。
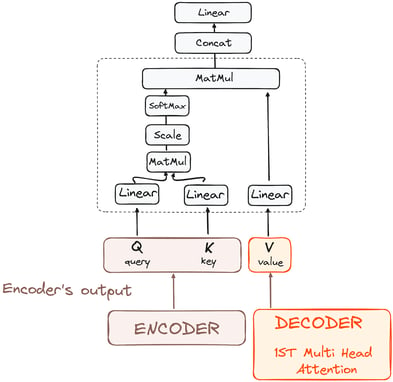
画像:筆者作成。デコーダのワークフロー:エンコーダ・デコーダ注意
ステップ3.3:フィードフォワードニューラルネットワーク
エンコーダと同様に、各デコーダ層には位置ごとに同一に適用される全結合のフィードフォワードネットワークがあります。
ステップ4:線形分類器とソフトマックス
モデル内を通ってきたデータは最後に線形層を通過し、分類器として機能します。
この分類器のサイズはクラス数(語彙に含まれる単語数)に対応します。たとえば1,000語の語彙なら、出力は1,000要素の配列です。
次にソフトマックス層に入力し、0〜1の確率に変換します。確率が最も高いトークンが次の単語の最有力候補です。貪欲デコードは常にそれを選びますが、多くのチャットモデルは分布からサンプリングし、温度設定でランダム性の度合いを制御します。
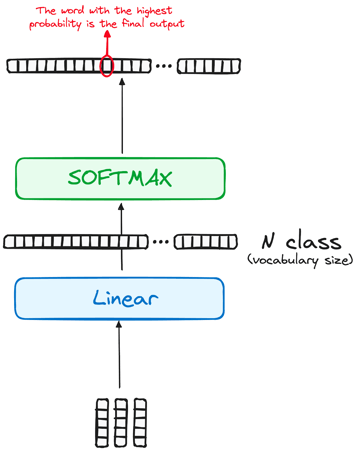
画像:筆者作成。デコーダのワークフロー:トランスフォーマーの最終出力
正規化と残差接続
各サブ層(マスク付き自己注意、エンコーダ・デコーダ注意、フィードフォワードネットワーク)の後に正規化が入り、各サブ層の周囲に残差接続があります。
デコーダの出力
最後の層の出力は、通常、線形層とソフトマックスを経て語彙上の確率に変換され、予測系列となります。
デコーダは運用フローの中で、新たに生成した出力を自らの入力列に付け加え、復号を進めます。特定の完了トークンを予測するまでこのサイクルを繰り返します。
エンコーダ同様、デコーダも同一のN層(元モデルでは6層)のスタックで、各層は直下の層の出力とエンコーダの出力を基に構築します。スタックが深いほど、層やヘッドごとに異なる注意パターンを捉えられます。
最終的なアーキテクチャは次の通りです(元論文より):
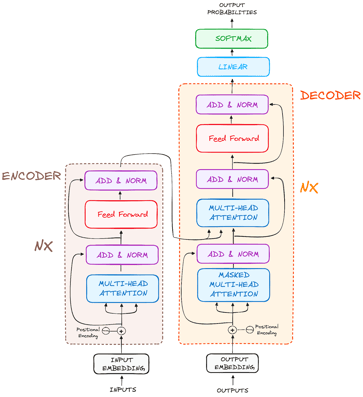
画像:筆者作成。トランスフォーマーの原型構造
このアーキテクチャをよりよく理解するには、PyTorchでTransformerを構築するチュートリアルに沿って、ゼロから実装してみることをおすすめします。
エンコーダのみ、デコーダのみ、エンコーダ・デコーダ型
トランスフォーマーモデルは、元のアーキテクチャのどの半分を残すかによって3つの系統に分かれます。選択は得意分野を決めます:エンコーダは読む、デコーダは書く、エンコーダ・デコーダは1つの系列を別の系列に写像します。
| 系統 | 保持する部分 | 注意 | 事前学習タスク | 典型的な用途 | 例 |
|---|---|---|---|---|---|
| エンコーダのみ | エンコーダのスタック | 双方向:すべてのトークンが互いを参照 | マスクされたトークンを補完 | 分類、検索用埋め込み、固有表現抽出 | BERT、RoBERTa |
| デコーダのみ | クロスアテンションなしのデコーダスタック | 因果的:各トークンはそれ以前のみを参照 | 次のトークンを予測 | チャット、コード生成、エージェント | GPT-3、Llama、Gemini |
| エンコーダ・デコーダ | 両スタック | 双方向エンコーダ、因果デコーダ、クロスアテンション付き | 入力系列を出力系列へ写像 | 翻訳、要約、音声認識 | 原型Transformer、T5、Whisper |
GPT-3以降に公開された多くのLLMはデコーダのみです。次トークン予測は生テキストであれば何にでも適用できるため学習データが豊富で、翻訳・要約・質問応答もテキスト継続として扱うことで1つのモデルで対応できます。
どのモデルがトランスフォーマーを採用している?
BERT
BERT(Bidirectional Encoder Representations from Transformers)は2018年にGoogleがオープンソースで公開したエンコーダのみのトランスフォーマーです。次単語の予測ではなく、両側の文脈を用いてマスクされた単語を補完するタスクで事前学習され、当時の左から右のモデルより理解系タスクに強みを示しました。
単語の両側から文脈を理解できるため、BERTは質疑応答や曖昧な言語の理解などのタスクで従来モデルを上回りました。中核にトランスフォーマーを採用し、各出力と入力要素を動的に結びつけます。
BERTは英語版WikipediaとBooksCorpusで事前学習され、Googleは2019年に検索へ導入して自然言語クエリの解釈を改善しました。これがより大きな事前学習言語モデル開発競争の引き金となりました。
BERTの詳細は、別記事のBERT入門をご覧ください。
LaMDA
LaMDA(Language Model for Dialogue Applications)はGoogleが開発したトランスフォーマー系の会話特化モデルで、2021年のGoogle I/Oで発表されました。より自然で文脈に適した応答を生成し、多様なアプリケーションでのユーザー体験を高めます。
LaMDAは幅広い話題とユーザー意図を理解・応答できる設計で、チャットボット、バーチャルアシスタントなど、動的な対話が鍵となるシステムに適しています。
その後、GoogleはBardの基盤をLaMDAからPaLM 2、さらにGeminiへと置き換えましたが、LaMDAは対話に特化して訓練された初期のトランスフォーマーモデルの一つでした。
LaMDAモデルについてさらに知りたい方は、LaMDAに関する記事をご覧ください。
GPTとChatGPT
OpenAIが開発したGPTとChatGPTは、首尾一貫し文脈に適したテキストを生成できる高度な生成モデルです。GPT-1は2018年6月に最初のモデルとして登場し、特に大きな影響を与えたGPT-3は2年後の2020年に発表されました。
これらのモデルは、コンテンツ生成、対話、翻訳など幅広いタスクが得意です。GPTのアーキテクチャにより、人間の文章に極めて近いテキストを生成でき、創作、カスタマーサポート、コーディング支援などで有用です。会話に最適化されたChatGPTは、人間らしい対話生成に優れ、チャットボットやバーチャルアシスタントで活躍します。
OpenAIはGPT-3以降(オープンウェイトのgpt-ossモデルを除き)アーキテクチャ詳細を公開していませんが、この系統は成長を続け、直近では2026年にGPT-6 Astraが登場しました。
Claude
Anthropicが開発したClaudeは、安全性と有用性に重点を置いたトランスフォーマー系AIアシスタントのファミリーです。ClaudeはConstitutional AI(CAI)という手法で、原則に基づいて有益・無害・誠実な応答を導くよう訓練されています。
Claude 3(2024年)はHaiku、Sonnet、Opusの3つのグレードを導入し、速度と能力のトレードオフを提供しました。微妙な推論、複雑な指示の遵守、長文脈(最大200Kトークン)でのコンテキスト維持に優れます。
それ以降、Anthropicは数カ月ごとに新世代を発表しています。現在のClaude 5系には、2026年リリースのClaude Fable 5.1とClaude Opus 5.5があり、OpenAI同様にアーキテクチャ詳細は公開していません。
その他のバリエーション
トランスフォーマーモデルの数は急速に増えています。Xavier Amatriainのモデルカタログは多数のモデルをアーキテクチャや学習目的で分類し、スタンフォードのHELMベンチマークは30の著名な言語モデルを横並びで評価しました。
Hugging Faceのモデルハブのようなプラットフォームを中心に、オープンソース化の流れも加速しています。多くのトランスフォーマーベースモデルが各種NLPタスクに特化して開発され、モデルの多用途性と効率性を示しています。
既存の基盤モデルについては、概要と主要モデルを解説した別記事をご覧ください。
2017年以降、トランスフォーマーはどう変わった?
2017年の原型以降、トランスフォーマーは制約の克服や新領域への拡張に向けて大きく進化しました。
現代のLLMは元祖トランスフォーマーとどう違うか
現在のオープンウェイトLLMはなお2017年の設計図に従いますが、ほぼすべての構成要素が、より安定に学習できる、またはより安価に動作する変種に置き換えられています。MetaはLLaMAやLlama 3の論文で多くの変更点を文書化しています:
| コンポーネント | 元祖トランスフォーマー(2017) | 今日の一般的なオープンウェイトLLM |
|---|---|---|
| アーキテクチャ | エンコーダ・デコーダ、6 + 6層 | デコーダのみ、32層(Llama 3 8B)〜126層(Llama 3 405B) |
| モデル幅 | 512 | 4,096(Llama 3 8B)〜16,384(Llama 3 405B) |
| 位置情報 | 埋め込みに加える固定の正弦・余弦エンコーディング | 注意内部で適用する回転位置埋め込み(RoPE) |
| 正規化 | 各サブ層の後にLayerNorm(ポストノーム) | 各サブ層の前にRMSNorm(プリノーム) |
| FF活性化 | ReLU | SwiGLU |
| 注意ヘッド | マルチヘッド注意、8ヘッド | グループ化クエリ注意:複数のクエリヘッドで1つのキー・バリューヘッドを共有(Llama 3ではKVヘッド8) |
| フィードフォワード層 | 密(Dense) | Dense、またはMixture of Experts(Llama 4、DeepSeek-V3) |
Vision Transformer(ViT)
Vision Transformerは、画像をパッチに分割して各パッチをトークンとして扱い、自己注意を画像に適用します。この手法は画像分類・物体検出・画像生成で高い効果を示し、大規模データセットでは従来のCNNを上回ることもあります。
マルチモーダルトランスフォーマー
GPT-5、Gemini 3、Llama 4のような最新モデルは、単一アーキテクチャでテキスト・画像・音声・動画など複数の入力タイプを処理します。これらのマルチモーダルTransformerは、統一された埋め込み空間とクロスアテンションを用いて、複数のモダリティを同時に推論します。
高効率トランスフォーマー
自己注意の二乗計算量は文脈長を制約します。これを解決する革新がいくつも登場しています:
- Flash Attention:GPUのオンチップ高速メモリに収まるタイルで厳密な注意を計算し、メモリ使用を系列長に対して線形に
- Rotary Position Embeddings(RoPE):回転行列で位置情報を符号化し、より長い系列への外挿性を改善
- 線形・疎注意:LinformerやPerformerは注意を近似し、Longformerは多くのトークンを局所ウィンドウに制限して、非常に長い文書で計算量をO(n)へ
- Mixture of Experts(MoE):トークンごとに一部のパラメータのみを活性化し、同程度の計算量でより大きなモデルを実現
トランスフォーマー vs. RNN/CNN
トランスフォーマーは、他の2つの代表的なNN構成要素、再帰層(RNN)と畳み込み層(CNN)とよく比較されます。各々、適したデータの種類が異なります。
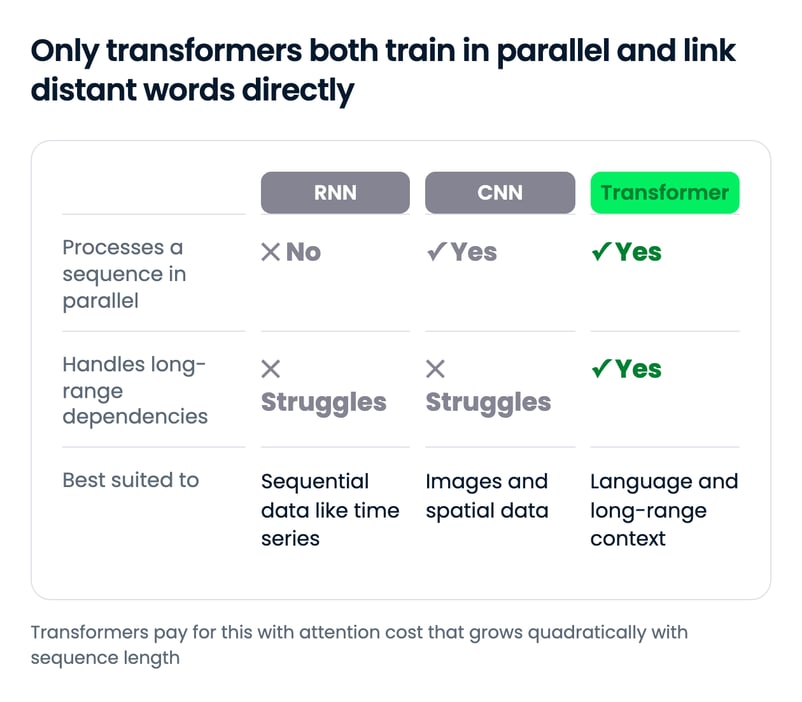
再帰層
再帰層はRNNの要で、逐次データの処理に優れます。逐次演算を行える点が強みで、言語処理や時系列分析などで重要です。再帰層では、前ステップの出力を次ステップの入力に戻すループ構造により、過去情報を記憶して文脈を理解します。
しかし前述の通り、逐次処理には2つの含意があります:
- 各ステップが前のステップに依存するため訓練時間が長くなり、並列化が難しい。
- 勾配消失の問題により長期依存の学習が苦手になりやすい。
トランスフォーマーモデルは再帰を持たない点で再帰層ベースのアーキテクチャと大きく異なります。先に見たように、トランスフォーマーの注意層は両方の問題に対処し、NLPにおけるRNNの自然な進化系となりました。
畳み込み層
一方、畳み込み層はCNNの構成要素で、画像のような空間データ処理に優れています。
カーネル(フィルタ)を入力上で走査して特徴を抽出します。カーネル幅を調整でき、小さな特徴から大きな特徴までタスクに応じて焦点を変えられます。
畳み込み層は空間的階層やパターンの捉え方に優れますが、長期依存には課題があります。系列の順序や文脈を本質的には扱わないため、順序理解が必要なタスクには向きません。
このため、CNNとトランスフォーマーは異なるデータ・タスクに最適化されています。CNNは空間情報の効率的処理でコンピュータビジョンを席巻し、トランスフォーマーは長距離依存の理解力により、特にNLPの複雑な逐次タスクで標準となりました。
トランスフォーマーの弱点と制約
成功の裏で、トランスフォーマーには注目すべき制約があります:
- 二乗計算量:自己注意は系列長に対してO(n²)でスケールし、非常に長いコンテキストウィンドウは計算資源的に高コスト
- メモリ要求:大規模モデルは大量のGPUメモリを要し、デプロイ選択肢を制限
- 学習データ要求:強い性能のためには巨大なデータセットが必要になりがち
- ハルシネーション:トランスフォーマーは最も尤もらしいトークンを予測するため、事実検索ではなく誤情報を自信満々に述べてしまうことがある。推論モデルで軽減はされるが、解消はされていない
- 位置エンコーディングの限界:標準的な位置表現は学習時に見ていない長さへの一般化が難しい
これらの制約に対して、Flash Attention、Mixture-of-Experts、RAG(検索拡張生成)など、アーキテクチャ面の革新が進んでいます。
まとめ
トランスフォーマーは、自己注意により各トークンが他のすべてのトークンを参照し、同一構造の層スタックで表現を洗練させることで動作します。この設計判断ひとつでGPUによる並列学習が可能になり、RNNを妨げていた長距離記憶の問題が解決しました。
驚くのは中核がほとんど変わっていないことです。2026年のLLMは位置エンコーディングや正規化、注意ヘッドをより安価な変種に入れ替えていますが、2017年の図をなお見て取れるでしょう。長文脈に対しては、状態空間モデルやハイブリッドが主流になるのか、それともFlashAttentionのようなカーネルが二乗コストを実質的に許容に留めるのかが今後の焦点です。
実践するには、ステップバイステップのPyTorchでTransformerを構築するチュートリアルを試すか、TransformersとHugging Face入門から既存モデルを使い始めてください。さらに学ぶなら、Transformer Models with PyTorchコースや、より体系的に学べるDeveloping Large Language Modelsトラックがおすすめです。
FAQs
トランスフォーマーのアーキテクチャはどう動作しますか?
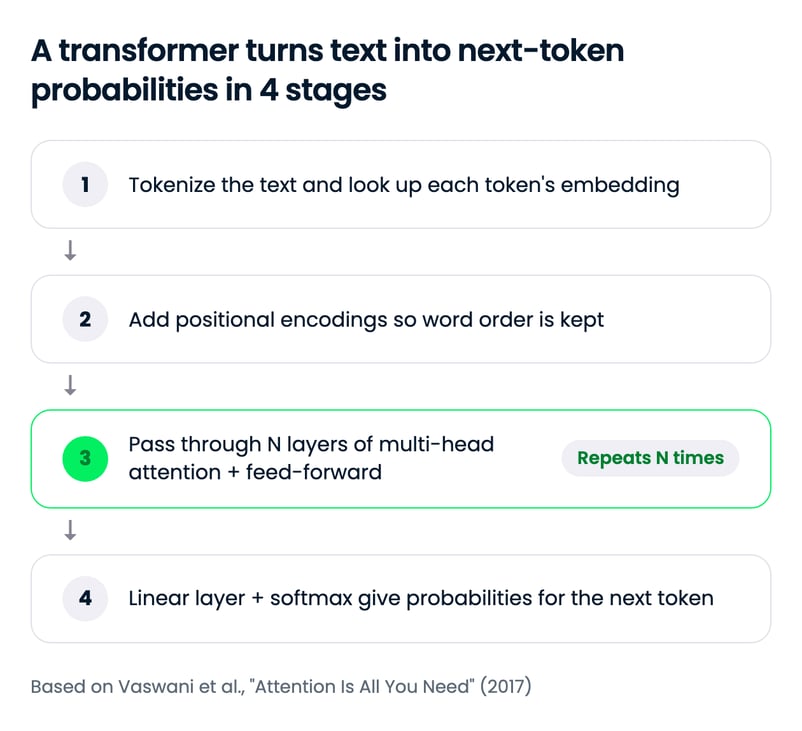
トランスフォーマーはテキストをトークンに分割し、各トークンを埋め込みに変換してから位置情報を付与します。次に、マルチヘッド自己注意とフィードフォワードネットワークからなる層スタックを適用し、各ステップの周囲は残差接続と正規化で包まれます。最後に線形層とソフトマックスで次のトークンの確率を出力します。
エンコーダのみ、デコーダのみ、エンコーダ・デコーダ型の違いは何ですか?
BERTのようなエンコーダのみモデルは入力全体を双方向に読み取り、分類や検索に向きます。GPTやLlamaのようなデコーダのみモデルは過去トークンのみを参照し、次トークン予測で学習されるため、チャットLLMの標準設計です。T5や元祖Transformerのようなエンコーダ・デコーダ型は、翻訳のように入力系列を出力系列へ写像します。
なぜトランスフォーマーはRNNやLSTMに置き換わったのですか?
RNNやLSTMはトークンを1つずつ処理するため、GPUでの学習が遅く、長い系列では情報が失われやすくなります。自己注意はすべてのトークン同士を直接結びつけ、系列全体を並列処理できるため、トランスフォーマーはより高速に学習でき、長距離依存をうまく扱えます。
ChatGPTはトランスフォーマーですか?
はい。GPTはGenerative Pre-trained Transformerの略で、ChatGPTの背後にあるGPTモデルは次トークンを予測するデコーダのみのトランスフォーマーです。OpenAIはGPT-3以降アーキテクチャ詳細を公開していませんが、すべてのGPTモデルはトランスフォーマーに基づいています。
トランスフォーマーの主な制約は何ですか?
自己注意のコストは系列長に対して二乗で増えるため、長いコンテキストは計算とメモリの両面で高コストです。また、大量の学習データが必要で、事実ではない内容を自信を持って述べる「ハルシネーション」も起こりえます。FlashAttention、グループ化クエリ注意、Mixture of Experts、状態空間モデルのハイブリッドなどは、これらのコスト低減を狙った手法です。
トランスフォーマーは、系列のすべてのトークンを一度に読み取り、自己注意を使って各トークンが他のトークンをどの程度参照すべきかを決めるニューラルネットワークです。Googleの研究者が2017年の論文“Attention Is All You Need”で提案し、現在ではGPTやLlamaからGeminiに至るほぼすべての大規模言語モデル(LLM)の基盤となっています。
このアーキテクチャは4段階で動作します。テキストをトークンに分割して埋め込みにマッピングし、位置情報を加え、層スタックでマルチヘッド自己注意とフィードフォワードネットワークを交互に適用(各サブ層は残差接続と正規化で包む)、最後に線形層とソフトマックスで最終ベクトルを語彙上の確率に変換します。元のモデルはエンコーダとデコーダの組み合わせでしたが、現在の多くのLLMはデコーダのみを残しています。
本チュートリアルでは、まず元のエンコーダ・デコーダ設計の各段階を説明し、その後でBERT、GPT、そして今日のLLMがどのように改良したかを紹介します。直感から掴みたい場合は、まず注意機構と自己注意の解説をご覧ください。
要点(TL;DR)