

Ce sunt transformerele?
Transformerele au fost dezvoltate inițial pentru a rezolva problema transducției de secvențe, sau traducerea automată neuronală, adică sunt menite să rezolve orice sarcină ce transformă o secvență de intrare într-o secvență de ieșire. De aici și numele „Transformers”.
Dar hai să începem cu începutul.
O definiție simplă
Un model transformer este o rețea neuronală care învață contextul datelor secvențiale și generează date noi pe baza acestuia.
Pe scurt:
Un transformer este un tip de model de inteligență artificială care învață să înțeleagă și să genereze text asemănător celui uman analizând tipare în cantități mari de date text.
Transformerele reprezintă starea de artă actuală în NLP și sunt considerate evoluția arhitecturii encoder-decoder. Totuși, în timp ce arhitectura encoder-decoder se bazează în principal pe Recurrent Neural Networks (RNN) pentru a extrage informația secvențială, transformerele nu au deloc recurență.
Deci, cum reușesc?
Sunt proiectate special să înțeleagă contextul și sensul analizând relațiile dintre diferite elemente și se bazează aproape în totalitate pe o tehnică matematică numită atenție pentru a face asta.
Imagine de autor.
Context istoric
Transformerele au fost introduse de cercetătorii Google în lucrarea din 2017 "Attention is All You Need". Codul a fost publicat în pachetul Tensor2Tensor al TensorFlow, iar grupul Harvard NLP a urmat cu un ghid adnotat al lucrării în PyTorch. Poți, de asemenea, să înveți cum să implementezi un Transformer de la zero în tutorialul nostru separat.
În decurs de un an, BERT de la Google și GPT-1 de la OpenAI au arătat că un transformer pre-antrenat pe text neetichetat poate fi ajustat pentru aproape orice sarcină de limbaj. GPT-3 a urmat în 2020, iar cercetătorii de la Stanford au inventat termenul „modele fundaționale” pentru această nouă clasă de modele.
De atunci, lucrurile s-au mișcat rapid: modele cu greutăți deschise precum Llama de la Meta (2023), modele multimodale precum GPT-4o (2024), modele de raționament precum o1 de la OpenAI și DeepSeek-R1 (sfârșit de 2024 – început de 2025) și modele agentice precum GPT-5 (2025) și GPT-6 Astra (2026). Modelele ale căror proiecte sunt publice sunt încă transformere. Pentru toată povestea, vezi istoria modelelor lingvistice mari.
Trecerea de la modelele RNN la transformere
Când a fost introdus Transformerul, rețelele neuronale recurente (RNN) și varianta lor long short-term memory (LSTM) erau modelele preferate pentru date secvențiale. Ele procesează intrarea câte un element pe rând, ceea ce provoacă două probleme principale:
- Antrenare lentă: fiecare pas așteaptă pe cel anterior, astfel că RNN-urile nu pot folosi calculul paralel pentru care sunt construite GPU-urile.
- Uitare pe distanțe lungi: informația este transmisă pas cu pas, iar cu cât lanțul e mai lung, cu atât e mai probabil să se piardă.
Transformerele au păstrat ideea encoder-decoder din RNN-uri, dar au înlocuit recurența cu atenția, ceea ce rezolvă ambele probleme: fiecare cuvânt poate acorda atenție direct oricărui alt cuvânt, indiferent cât de departe, iar întreaga secvență este procesată în paralel.
În continuare, să vedem cum funcționează transformerele.
Cum funcționează arhitectura Transformer?
Proiectate inițial pentru transducția de secvențe sau traducerea neuronală, transformerele excelează în conversia secvențelor de intrare în secvențe de ieșire. Este primul model de transducție care se bazează în întregime pe self-attention pentru a calcula reprezentări ale intrării și ieșirii, fără a folosi RNN-uri sau convoluții aliniate pe secvență. Caracteristica centrală a arhitecturii Transformer este că menține modelul encoder-decoder.
Dacă privim un Transformer pentru traducere de limbaj ca o simplă cutie neagră, acesta ar primi ca intrare o propoziție într-o limbă, de pildă engleză, și ar produce ca ieșire traducerea ei în spaniolă.
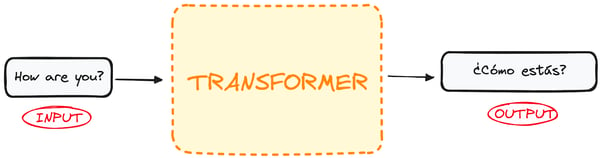
Imagine de autor.
Dacă intrăm puțin în detaliu, observăm că această cutie neagră este compusă din două părți principale:
- Encoderul primește intrarea și produce o reprezentare matricială a acesteia. De exemplu, propoziția în engleză „How are you?”
- Decoderul primește acea reprezentare encodată și generează iterativ o ieșire. În exemplul nostru, propoziția tradusă „¿Cómo estás?”
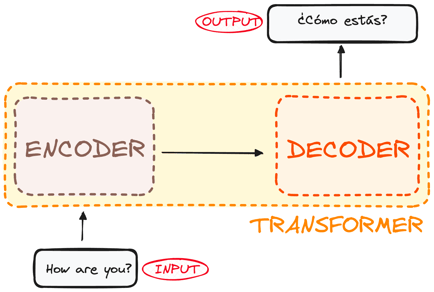
Imagine de autor. Structură globală Encoder-Decoder.
Totuși, atât encoderul, cât și decoderul sunt de fapt un teanc cu mai multe straturi (același număr pentru fiecare). Toți encoderii au aceeași structură, iar intrarea ajunge în fiecare dintre ei și este transmisă următorului. Toți decoderii au, de asemenea, aceeași structură și primesc intrarea de la ultimul encoder și decoderul anterior.
Arhitectura originală consta din 6 encodere și 6 decodere, dar putem replica câte straturi dorim. Așadar, să presupunem N straturi din fiecare.
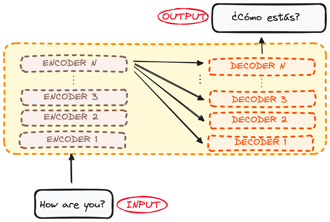
Imagine de autor. Structură globală Encoder-Decoder. Straturi multiple.
Acum că avem o idee generală despre arhitectura Transformer, să ne concentrăm pe Encodere și Decodere pentru a înțelege mai bine fluxul lor de lucru:
Cum funcționează encoderul Transformer?
Encoderul este o componentă fundamentală a arhitecturii Transformer. Funcția sa principală este să transforme tokenii de intrare în reprezentări contextualizate. Spre deosebire de modelele anterioare care procesau tokenii independent, encoderul Transformer surprinde contextul fiecărui token în raport cu întreaga secvență.
Structura sa este compusă astfel:
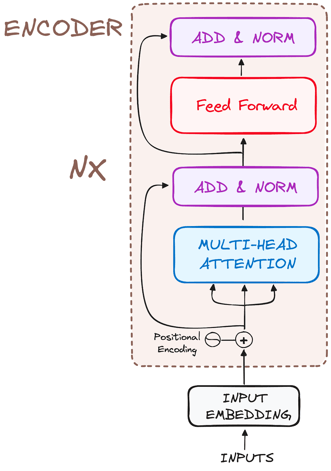
Imagine de autor. Structură globală a encoderelor.
Să descompunem fluxul său în pașii cei mai de bază:
Pasul 1: Embeddinguri de intrare
Embeddingul are loc doar în encoderul cel mai de jos. Mai întâi, un tokenizer împarte textul în tokeni, care sunt cuvinte sau fragmente de cuvinte, iar fiecare token este mapat la un vector învățat numit embedding. Tokenii cu sensuri înrudite ajung să aibă vectori similari.
Toți encoderii primesc o listă de vectori, fiecare cu 512 dimensiuni în lucrarea originală (dmodel = 512). În encoderul de jos, aceștia sunt embeddingurile de cuvinte, dar în ceilalți encodere, reprezintă ieșirea encoderului aflat direct dedesubt.
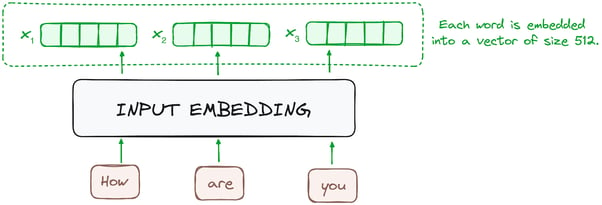
Imagine de autor. Fluxul encoderului. Embedding de intrare.
Pasul 2: Codificare pozițională
Deoarece Transformerele nu au un mecanism de recurență precum RNN-urile, folosesc codificări poziționale adăugate embeddingurilor de intrare pentru a oferi informații despre poziția fiecărui token în secvență. Acest lucru le permite să înțeleagă poziția fiecărui cuvânt în propoziție.
Pentru asta, cercetătorii au sugerat folosirea unei combinații de funcții sinus și cosinus pentru a crea vectori poziționali, permițând utilizarea acestui codificator pozițional pentru propoziții de orice lungime.
În această abordare, fiecare dimensiune este reprezentată prin frecvențe și deplasări ale undei unice, cu valori între -1 și 1, reprezentând eficient fiecare poziție.
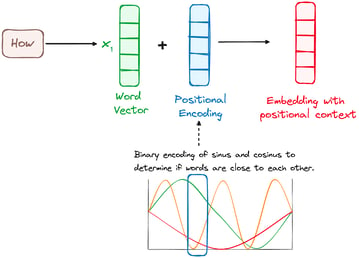
Imagine de autor. Fluxul encoderului. Codificare pozițională.
Pasul 3: Teanc de straturi de encoder
Encoderul Transformer constă într-un teanc de straturi identice (6 în modelul Transformer original).
Stratul de encoder are rolul de a transforma toate secvențele de intrare într-o reprezentare continuă, abstractă, care captează informațiile învățate din întreaga secvență. Acest strat cuprinde două submodule:
- Un mecanism de atenție multi-head.
- O rețea complet conectată.
În plus, încorporează conexiuni reziduale în jurul fiecărui sub-strat, urmate apoi de normalizare pe strat.
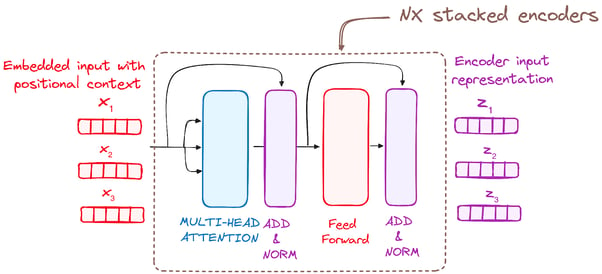
Imagine de autor. Fluxul encoderului. Teanc de straturi de encoder
Pasul 3.1: Mecanismul de self-attention multi-head
În encoder, atenția multi-head utilizează un mecanism special de atenție numit self-attention. Această abordare permite modelelor să relaționeze fiecare cuvânt din intrare cu alte cuvinte. De exemplu, într-un caz dat, modelul ar putea învăța să lege cuvântul „are” de „you”.
Acest mecanism permite encoderului să se concentreze pe părți diferite ale secvenței de intrare în timp ce procesează fiecare token. Calculează scoruri de atenție pe baza:
- Un query este un vector care reprezintă un cuvânt sau token specific din secvența de intrare în mecanismul de atenție.
- Un key este, de asemenea, un vector în mecanismul de atenție, corespunzând fiecărui cuvânt sau token din secvența de intrare.
- Fiecare value este asociat cu un key și este folosit pentru a construi ieșirea stratului de atenție. Când un query și un key se potrivesc bine, adică au un scor de atenție ridicat, value-ul corespunzător este accentuat în ieșire.
Acest prim modul de Self-Attention permite modelului să capteze informații contextuale din întreaga secvență. În loc să efectueze o singură funcție de atenție, query-urile, key-urile și value-urile sunt proiectate liniar de h ori. Pe fiecare dintre aceste versiuni proiectate ale query-urilor, key-urilor și value-urilor, mecanismul de atenție este rulat în paralel, fiecare producând o ieșire cu dv dimensiuni (64 în lucrarea originală, unde h = 8).
Arhitectura detaliată este următoarea:
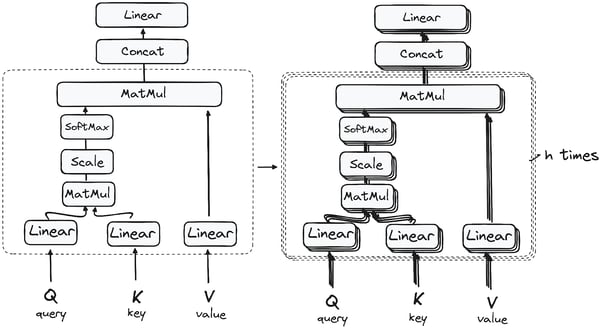
Înmulțire matricială (MatMul): produsul scalar dintre query și key
După ce vectorii query, key și value trec printr-un strat liniar, se efectuează o înmulțire matricială prin produs scalar între query-uri și key-uri, rezultând un matrix de scoruri.
Matricea de scoruri stabilește gradul de accent pe care ar trebui să-l pună fiecare cuvânt pe celelalte. Astfel, fiecărui cuvânt i se atribuie un scor în relație cu alte cuvinte în același pas temporal. Un scor mai mare indică o concentrare mai mare.
Acest proces mapează efectiv query-urile la key-urile corespunzătoare.
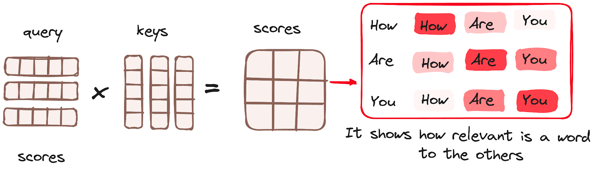
Imagine de autor. Fluxul encoderului. Mecanism de atenție - Înmulțire matricială.
Reducerea magnitudinii scorurilor de atenție
Scorurile sunt apoi scalate în jos împărțindu-le la rădăcina pătrată a dimensiunii vectorilor query și key. Acest pas este implementat pentru a asigura gradii mai stabili, deoarece înmulțirea valorilor poate duce la efecte excesiv de mari.
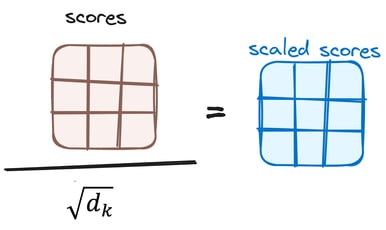
Imagine de autor. Fluxul encoderului. Reducerea scorurilor de atenție.
Aplicarea softmax pe scorurile ajustate
Ulterior, se aplică o funcție softmax pe scorurile ajustate pentru a obține ponderile de atenție. Rezultatul constă în valori de probabilitate între 0 și 1. Funcția softmax accentuează scorurile mai mari și le reduce pe cele mai mici, îmbunătățind astfel capacitatea modelului de a decide eficient care cuvinte merită mai multă atenție.
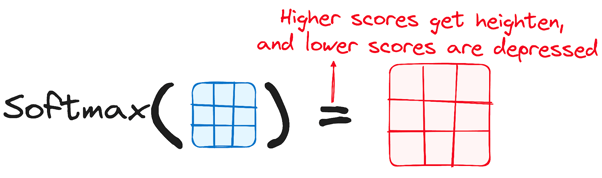
Imagine de autor. Fluxul encoderului. Softmax pe scoruri ajustate.
Combinarea rezultatelor softmax cu vectorul value
Următorul pas al mecanismului de atenție este că ponderile derivate din funcția softmax sunt înmulțite cu vectorul value, rezultând un vector de ieșire.
Cuvintele cu ponderi softmax mari domină rezultatul, în timp ce cuvintele cu ponderi aproape de 0 contribuie foarte puțin. În final, acest vector de ieșire este introdus într-un strat liniar pentru procesare ulterioară.
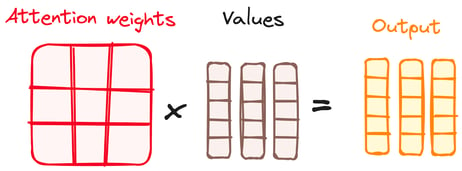
Imagine de autor. Fluxul encoderului. Combinarea rezultatelor Softmax cu vectorul value.
Și, în final, obținem ieșirea mecanismului de atenție!
Termenul „multi-head” vine din rularea acestui proces de mai multe ori în paralel. Înainte de a începe atenția, query-urile, key-urile și value-urile sunt împărțite în h seturi mai mici, numite capete (heads), iar fiecare cap execută pașii de mai sus pe propria porțiune.
Ieșirile capetelor sunt concatenate și trec printr-un strat liniar final. Deoarece fiecare cap învață propriile proiecții, capetele diferite pot surprinde relații diferite, cum ar fi la ce substantiv se referă un pronume sau ce cuvinte stau alături.
Pentru o înțelegere mai profundă a mecanismului de atenție, vezi tutorialul nostru despre atenția multi-head în transformere.
Pasul 3.2: Normalizare și conexiuni reziduale
Fiecare sub-strat într-un strat de encoder este urmat de un pas de normalizare. De asemenea, ieșirea fiecărui sub-strat este adăugată la intrarea sa (conexiune reziduală) pentru a atenua problema gradientului care dispare, permițând modele mai adânci. Acest proces va fi repetat și după rețeaua neuronală feed-forward.
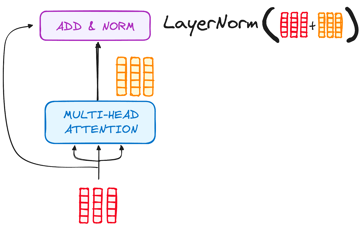
Imagine de autor. Fluxul encoderului. Normalizare și conexiune reziduală după Multi-Head Attention.
Pasul 3.3: Rețea neuronală feed-forward
În continuare, ieșirea trece printr-o rețea feed-forward pozițională: 2 straturi liniare cu o activare ReLU între ele, aplicată separat fiecărui token. În lucrarea originală, stratul intern are 2.048 de dimensiuni, de 4 ori lățimea modelului de 512.
Ca și în cazul atenției, intrarea rețelei este adăugată înapoi la ieșire (o conexiune reziduală), iar rezultatul este normalizat.
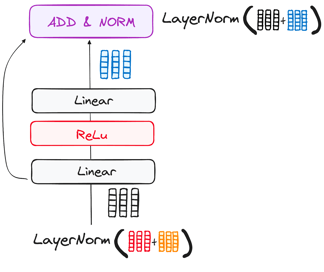
Imagine de autor. Fluxul encoderului. Sub-stratul Rețea Neuronală Feed-Forward.
Pasul 4: Ieșirea encoderului
Ieșirea ultimului strat de encoder este un set de vectori, fiecare reprezentând secvența de intrare cu o înțelegere contextuală bogată. Această ieșire este apoi folosită ca intrare pentru decoder într-un model Transformer.
Această codificare atentă pavează calea pentru decoder, ghidându-l să acorde atenție cuvintelor potrivite din intrare atunci când vine momentul decodării.
Stivuirea a N straturi de encoder permite fiecărui strat să se bazeze pe reprezentările celui de sub el. Modelul original a folosit N = 6; BERT-Base folosește 12, iar BERT-Large 24.
Cum funcționează decoderul Transformer?
Decoderul generează secvența de ieșire. Straturile sale oglindesc pe cele ale encoderului cu un adaos: fiecare strat are 2 sub-straturi de atenție multi-head în loc de 1, urmate de o rețea feed-forward pozițională, cu o conexiune reziduală și normalizare pe strat în jurul fiecărui sub-strat.
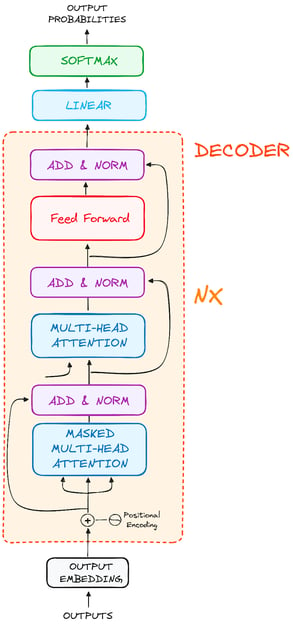
Imagine de autor. Structură globală a decodoarelor.
Aceste componente funcționează într-un mod similar straturilor encoderului, dar cu o nuanță: fiecare strat de atenție multi-head din decoder are o misiune proprie.
Etapa finală a procesului în decoder implică un strat liniar, care servește drept clasificator, urmat de o funcție softmax pentru a calcula probabilitățile diferitelor cuvinte.
Decoderul Transformer are o structură concepută special pentru a genera ieșirea, decodând informația encodată pas cu pas.
Decoderul funcționează autoregresiv: începe cu un token de start-de-secvență și, la fiecare pas, ia drept intrare tokenii generați până atunci, împreună cu ieșirea encoderului.
Se oprește când generează un token de sfârșit-de-secvență.
Pasul 1: Embeddinguri de ieșire
La linia de start a decoderului, procesul oglindește pe cel al encoderului. Aici, intrarea trece mai întâi printr-un strat de embedding.
Pasul 2: Codificare pozițională
După embedding, din nou ca în encoder, intrarea trece prin stratul de codificare pozițională. Această secvență este concepută pentru a produce embeddinguri poziționale.
Aceste embeddinguri poziționale intră apoi în primul strat de atenție multi-head al decoderului, unde se calculează scorurile de atenție pentru propria intrare a decoderului.
Pasul 3: Teanc de straturi de decoder
Decoderul constă într-un teanc de straturi identice (6 în modelul Transformer original). Fiecare strat are trei sub-componente principale:
Pasul 3.1: Mecanism de self-attention mascat
Este similar cu mecanismul de self-attention din encoder, dar cu o diferență crucială: împiedică pozițiile să acorde atenție pozițiilor ulterioare, ceea ce înseamnă că fiecare cuvânt din secvență nu este influențat de tokeni viitori.
De exemplu, când se calculează scorurile de atenție pentru cuvântul „Cómo”, este important ca „Cómo” să nu arunce o privire la „estás”, care este un cuvânt ulterior în secvența de ieșire.
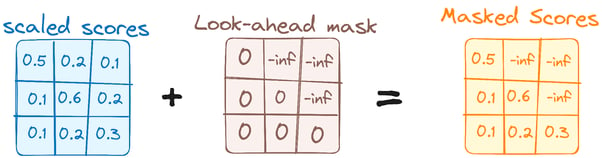
Imagine de autor. Fluxul decoderului. Prima mască de Multi-Head Attention.
Această mască asigură că predicțiile pentru o poziție pot depinde doar de ieșirile cunoscute de la pozițiile anterioare.
Pasul 3.2: Atenție encoder-decoder (cross-attention)
Al doilea sub-strat de atenție conectează decoderul la encoder. Aici, query-urile provin din ieșirea self-attention mascat a decoderului, în timp ce key-urile și value-urile provin din ieșirea finală a encoderului.
Acest lucru permite fiecărei poziții din decoder să acorde atenție tuturor pozițiilor din propoziția de intrare, astfel încât, când generează „estás”, decoderul se poate concentra pe „are you.” Rezultatul trece apoi prin sub-stratul feed-forward.
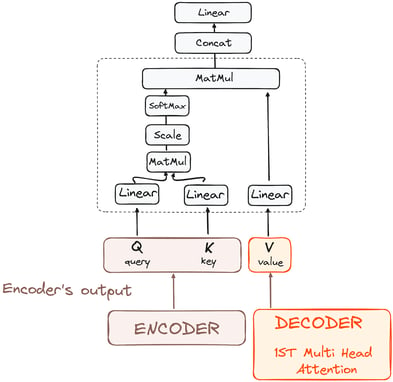
Imagine de autor. Fluxul decoderului. Atenție Encoder-Decoder.
Pasul 3.3: Rețea neuronală feed-forward
Similar encoderului, fiecare strat de decoder include o rețea feed-forward complet conectată, aplicată separat și identic fiecărei poziții.
Pasul 4: Clasificator liniar și softmax
Călătoria datelor prin modelul transformer culminează cu trecerea printr-un strat liniar final, care funcționează ca un clasificator.
Dimensiunea acestui clasificator corespunde numărului total de clase implicate (numărul de cuvinte din vocabular). De exemplu, într-un scenariu cu 1000 de clase distincte ce reprezintă 1000 de cuvinte diferite, ieșirea clasificatorului va fi un șir cu 1000 de elemente.
Această ieșire este apoi introdusă într-un strat softmax, care o transformă într-o gamă de scoruri de probabilitate între 0 și 1. Tokenul cu cea mai mare probabilitate este cea mai bună presupunere a modelului pentru următorul cuvânt. Decodarea greedy îl alege mereu; majoritatea modelelor de chat, în schimb, eșantionează din distribuție, cu o temperatură care controlează câtă aleatorietate este permisă.
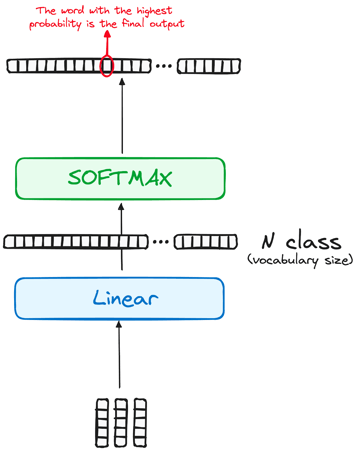
Imagine de autor. Fluxul decoderului. Ieșirea finală a Transformerului.
Normalizare și conexiuni reziduale
Fiecare sub-strat (self-attention mascat, atenție encoder-decoder, rețea feed-forward) este urmat de un pas de normalizare și include o conexiune reziduală în jurul său.
Ieșirea decoderului
Ieșirea ultimului strat este transformată într-o secvență prezisă, de obicei printr-un strat liniar urmat de un softmax pentru a genera probabilități peste vocabular.
Decoderul, în fluxul său operațional, încorporează ieșirea proaspăt generată în lista sa în creștere de intrări și apoi continuă procesul de decodare. Acest ciclu se repetă până când modelul prezice un token specific, semnalând finalizarea.
La fel ca encoderul, decoderul este un teanc de N straturi identice (6 în modelul original), fiecare construindu-se pe ieșirea stratului de dedesubt și pe ieșirea encoderului. Teancurile mai adânci permit straturilor și capetelor diferite să capteze tipare de atenție diferite.
Arhitectura finală arată astfel (din lucrarea originală):
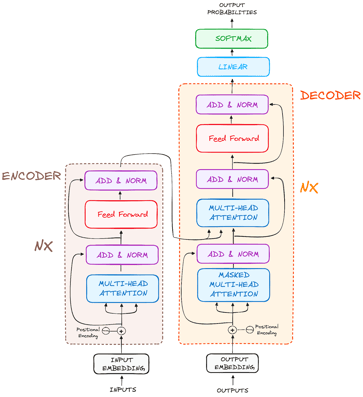
Imagine de autor. Structura originală a Transformerelor.
Pentru a înțelege mai bine această arhitectură, îți recomand să încerci să aplici un Transformer de la zero urmând acest tutorial pentru a construi un transformer cu PyTorch.
Transformere doar cu encoder, doar cu decoder și encoder-decoder
Modelele Transformer se împart în 3 familii, în funcție de ce jumătate a arhitecturii originale păstrează. Alegerea decide la ce se pricepe un model: encoderele citesc, decoderele scriu, iar encoder-decoder mapează o secvență pe alta.
| Familie | Ce păstrează | Atenție | Sarcină de pre-antrenare | Utilizări tipice | Exemple |
|---|---|---|---|---|---|
| Doar encoder | Teancul de encodere | Bidirecțională: fiecare token vede fiecare token | Completarea tokenilor mascați | Clasificare, embeddinguri pentru căutare, recunoașterea entităților numite | BERT, RoBERTa |
| Doar decoder | Teancul de decodere, fără cross-attention | Cauzală: fiecare token vede doar tokenii anteriori | Prezicerea următorului token | Chat, generare de cod, agenți | GPT-3, Llama, Gemini |
| Encoder-decoder | Ambele teancuri | Encoder bidirecțional, decoder cauzal, plus cross-attention | Maparea unei secvențe de intrare la o secvență de ieșire | Traducere, rezumare, recunoaștere a vorbirii | Transformerul original, T5, Whisper |
Majoritatea LLM-urilor lansate de la GPT-3 sunt doar cu decoder. Prezicerea următorului token funcționează pe orice text brut, deci datele de antrenare sunt abundente, iar un singur model poate gestiona traducerea, rezumarea și întrebările-răspuns tratând fiecare ca o continuare de text.
Ce modele folosesc arhitectura Transformer?
BERT
BERT (Bidirectional Encoder Representations from Transformers), lansat open source de Google în 2018, este un transformer doar cu encoder. În loc să prezică următorul cuvânt, a fost pre-antrenat să completeze cuvinte mascate folosind contextul din ambele părți, ceea ce l-a făcut mai puternic la sarcini de înțelegere decât modelele stânga-la-dreapta ale vremii.
Înțelegând contextul din toate părțile unui cuvânt, BERT a depășit modelele anterioare în sarcini precum întrebări-răspuns și înțelegerea limbajului ambiguu. Nucleul său folosește Transformere, conectând dinamic fiecare element de intrare și ieșire.
BERT a fost pre-antrenat pe Wikipedia în engleză și pe setul BooksCorpus, iar Google l-a adăugat în Search în 2019 pentru a interpreta mai bine interogările în limbaj natural. A declanșat o cursă pentru a construi modele lingvistice pre-antrenate mai mari.
Pentru a afla mai multe despre BERT, poți consulta articolul nostru separat care introduce modelul BERT.
LaMDA
LaMDA (Language Model for Dialogue Applications) este un model bazat pe Transformer dezvoltat de Google, proiectat special pentru sarcini conversaționale și lansat în cadrul keynote-ului Google I/O 2021. Sunt concepute să genereze răspunsuri mai naturale și mai relevante contextual, îmbunătățind interacțiunile utilizatorilor în diverse aplicații.
Designul LaMDA îi permite să înțeleagă și să răspundă la o gamă largă de subiecte și intenții ale utilizatorilor, făcându-l ideal pentru aplicații în chatboți, asistenți virtuali și alte sisteme AI interactive în care o conversație dinamică este esențială.
Google a înlocuit ulterior LaMDA în chatbotul Bard cu PaLM 2, apoi cu Gemini, dar LaMDA a fost printre primele modele transformer antrenate special pe dialog.
Dacă ești interesat să înțelegi mai bine modelele LaMDA, poți obține o perspectivă mai clară din articolul nostru despre LaMDA.
GPT și ChatGPT
GPT și ChatGPT, dezvoltate de OpenAI, sunt modele generative avansate cunoscute pentru abilitatea lor de a produce text coerent și relevant contextual. GPT-1 a fost primul model lansat în iunie 2018, iar GPT-3, unul dintre cele mai influente modele, a fost lansat doi ani mai târziu, în 2020.
Aceste modele se pricep la o gamă largă de sarcini, inclusiv creare de conținut, conversație, traducere de limbaj și altele. Arhitectura GPT îi permite să genereze text care seamănă mult cu scrisul uman, făcându-l util în aplicații precum scriere creativă, suport clienți și chiar asistență la programare. ChatGPT, o variantă optimizată pentru contexte conversaționale, excelează în generarea de dialoguri asemănătoare celor umane, sporindu-i aplicabilitatea în chatboți și asistenți virtuali.
OpenAI a încetat să publice detalii de arhitectură după GPT-3 (cu excepția modelelor lor cu greutăți deschise gpt-oss), dar familia a continuat să crească, cel mai recent cu GPT-6 Astra în 2026.
Claude
Claude, dezvoltat de Anthropic, este o familie de asistenți AI bazați pe Transformer, proiectați cu accent pe siguranță și utilitate. Claude folosește Constitutional AI (CAI), o abordare de antrenare în care modelul este ghidat de un set de principii pentru a produce răspunsuri utile, inofensive și oneste.
Claude 3 (lansat în 2024) a introdus trei niveluri de model, Haiku, Sonnet și Opus, oferind compromisuri diferite între viteză și capacitate. Modelele excelează la raționament nuanțat, urmarea instrucțiunilor complexe și menținerea contextului în conversații lungi (până la 200K tokeni).
Anthropic a lansat generații noi la fiecare câteva luni de atunci. Linia actuală Claude 5 include Claude Fable 5.1 și Claude Opus 5.5, ambele lansate în 2026. La fel ca OpenAI, Anthropic nu își publică detaliile de arhitectură.
Alte variații
Numărul modelelor transformer a crescut rapid. Catalogul de modele transformer al lui Xavier Amatriain clasifică zeci dintre ele după arhitectură și obiectiv de antrenare, iar benchmark-ul HELM al Stanford a evaluat 30 de modele lingvistice proeminente, cot la cot.
Există o tendință în creștere spre deschiderea acestor modele, cu platforme precum hub-ul de modele al Hugging Face în prim-plan. De asemenea, au fost dezvoltate numeroase modele bazate pe Transformer, fiecare specializat pentru sarcini NLP diferite, demonstrând versatilitatea și eficiența modelului în aplicații diverse.
Poți afla mai multe despre toate modelele fundaționale existente într-un articol separat, care explică ce sunt și care sunt cele mai folosite.
Cum s-au schimbat transformerele din 2017 până azi?
De la arhitectura originală din 2017, Transformerele au evoluat semnificativ pentru a aborda limitări și a se extinde în domenii noi.
Cum diferă LLM-urile moderne de Transformerul original
LLM-urile cu greutăți deschise de azi urmează încă planul din 2017, dar aproape fiecare componentă a fost înlocuită cu o variantă care se antrenează mai stabil sau rulează mai ieftin. Meta documentează majoritatea acestor schimbări în lucrările LLaMA și Llama 3:
| Componentă | Transformerul original (2017) | LLM tipic cu greutăți deschise azi |
|---|---|---|
| Arhitectură | Encoder-decoder, 6 + 6 straturi | Doar decoder, 32 straturi (Llama 3 8B) până la 126 straturi (Llama 3 405B) |
| Lățimea modelului | 512 | 4.096 (Llama 3 8B) până la 16.384 (Llama 3 405B) |
| Informație pozițională | Codificări sinus și cosinus fixe adăugate embeddingurilor | Embeddinguri poziționale rotative (RoPE) aplicate în interiorul atenției |
| Normalizare | LayerNorm după fiecare sub-strat (post-norm) | RMSNorm înaintea fiecărui sub-strat (pre-norm) |
| Activare feed-forward | ReLU | SwiGLU |
| Capete de atenție | Atenție multi-head, 8 capete | Grouped-query attention: mai multe capete de query împart 1 cap de key-value (8 capete key-value în Llama 3) |
| Strat feed-forward | Dense | Dense sau mixture of experts (Llama 4, DeepSeek-V3) |
Vision Transformers (ViT)
Vision Transformers aplică mecanismul de self-attention pe imagini împărțindu-le în patch-uri și tratând fiecare patch ca pe un token. Această abordare s-a dovedit foarte eficientă pentru clasificarea imaginilor, detecția obiectelor și generarea de imagini, depășind adesea CNN-urile tradiționale pe seturi mari de date.
Transformere multimodale
Modelele moderne precum GPT-5, Gemini 3 și Llama 4 procesează mai multe tipuri de intrări (text, imagini, audio, video) într-o singură arhitectură. Aceste Transformere multimodale folosesc spații de embedding unificate și mecanisme de cross-attention pentru a raționa simultan între diferite modalități.
Transformere eficiente
Complexitatea pătratică a self-attention limitează lungimea contextului. Mai multe inovații abordează asta:
- Flash Attention: Calculează atenția exactă în plăci care încap în memoria rapidă on-chip a GPU-ului, astfel încât utilizarea memoriei crește liniar cu lungimea secvenței, nu pătratic
- Rotary Position Embeddings (RoPE): Codifică informația de poziție prin matrice de rotație, permițând extrapolarea mai bună la secvențe mai lungi
- Atenție liniară și rară: Linformer și Performer aproximează atenția, iar Longformer limitează majoritatea tokenilor la o fereastră locală, reducând costul la O(n) pentru documente foarte lungi
- Mixture of Experts (MoE): Activează doar un subset de parametri per token, permițând modele mai mari cu costuri de calcul similare
Transformere vs. RNN și CNN
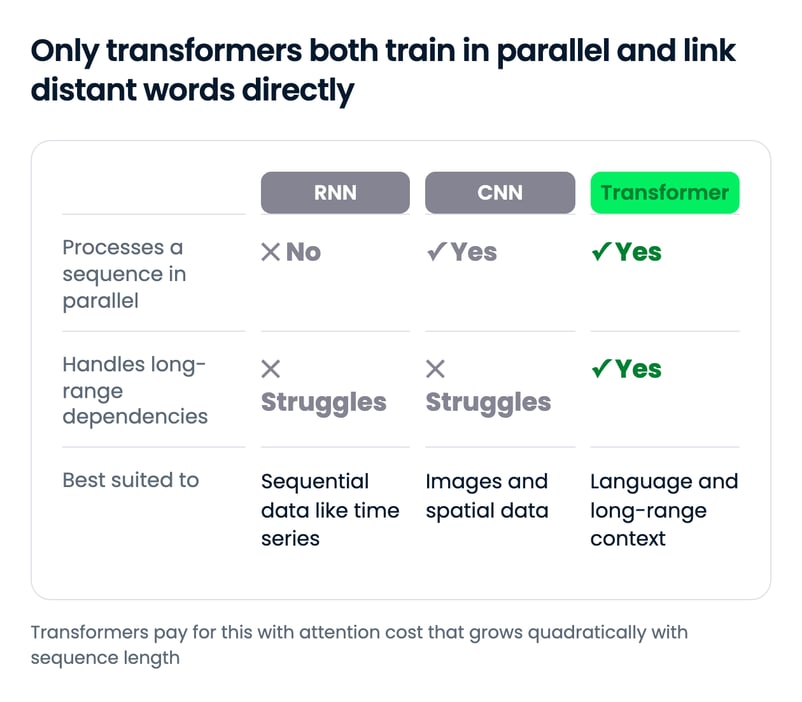
Transformerele sunt comparate de obicei cu alte 2 blocuri de construcție ale rețelelor neuronale: straturile recurente (RNN) și straturile convoluționale (CNN). Fiecare se potrivește unui tip diferit de date.
Straturi recurente
Straturile recurente, o piatră de temelie a Recurrent Neural Networks (RNN), excelează în gestionarea datelor secvențiale. Punctul forte al acestei arhitecturi constă în capacitatea de a efectua operații secvențiale, esențiale pentru sarcini precum procesarea limbajului sau analiza seriilor temporale. Într-un strat recurent, ieșirea unui pas anterior este alimentată înapoi în rețea ca intrare pentru pasul următor. Acest mecanism de buclă permite rețelei să-și amintească informații anterioare, vitale pentru înțelegerea contextului într-o secvență.
Totuși, după cum am discutat deja, această procesare secvențială are două implicații principale:
- Poate duce la timpi de antrenare mai lungi, deoarece fiecare pas depinde de cel anterior, îngreunând procesarea paralelă.
- Adesea se confruntă cu dependențe pe termen lung din cauza problemei gradientului care dispare, unde rețeaua devine mai puțin eficientă în a învăța din puncte de date aflate la distanță mare într-o secvență.
Modelele Transformer diferă semnificativ de arhitecturile cu straturi recurente, deoarece le lipsește recurența. După cum am văzut, stratul de Atenție al Transformerului abordează ambele probleme, făcându-le evoluția firească a RNN-urilor pentru aplicațiile NLP.
Straturi convoluționale
Pe de altă parte, straturile convoluționale, blocurile de bază ale Convolutional Neural Networks (CNN), sunt renumite pentru eficiența lor în procesarea datelor spațiale precum imaginile.
Aceste straturi folosesc nuclee (filtre) care scanează datele de intrare pentru a extrage caracteristici. Lățimea acestor nuclee poate fi ajustată, permițând rețelei să se concentreze pe caracteristici mici sau mari, în funcție de sarcina în cauză.
Deși straturile convoluționale sunt excepțional de bune la captarea ierarhiilor spațiale și a tiparelor din date, întâmpină dificultăți cu dependențele pe termen lung. Nu iau în mod inerent în calcul informația secvențială, făcându-le mai puțin potrivite pentru sarcini ce necesită înțelegerea ordinii sau contextului unei secvențe.
De aceea, CNN-urile și Transformerele sunt adaptate pentru tipuri de date și sarcini diferite. CNN-urile domină în domeniul viziunii computerizate datorită eficienței în procesarea informației spațiale, în timp ce Transformerele sunt alegerea de bază pentru sarcini secvențiale complexe, în special în NLP, datorită capacității lor de a înțelege dependențe pe distanțe lungi.
Puncte slabe și limitări ale Transformerelor
În ciuda succesului, Transformerele au limitări notabile:
- Complexitate pătratică: Self-attention se scalează O(n²) cu lungimea secvenței, făcând ferestrele de context foarte lungi costisitoare computațional
- Cerințe de memorie: Modelele mari necesită memorie GPU semnificativă, limitând opțiunile de implementare
- Cerințe de date pentru antrenare: Transformerele au nevoie de obicei de seturi de date masive pentru a atinge performanțe puternice
- Halucinație: Transformerele prezic tokeni probabili, nu caută fapte, așa că pot afirma informații false cu încredere. Modelele de raționament reduc acest fenomen, dar nu îl elimină
- Limitări ale codificării poziționale: Codificările poziționale standard au dificultăți în a generaliza la lungimi de secvență nevăzute în timpul antrenării
Cercetarea continuă să abordeze aceste limitări prin inovații de arhitectură precum Flash Attention, mixture-of-experts și generarea augmentată prin regăsire (RAG).
Gânduri finale
Un transformer funcționează permițând fiecărui token să se uite la fiecare alt token prin self-attention, apoi rafinând aceste reprezentări printr-un teanc de straturi identice. Acea singură alegere de design a făcut antrenarea paralelă pe GPU-uri și a rezolvat problema memoriei pe distanțe lungi care a ținut pe loc RNN-urile.
Ce mă uimește cel mai mult este cât de puțin s-a schimbat nucleul. Un LLM din 2026 înlocuiește codificarea pozițională, normalizarea și capetele de atenție cu variante mai ieftine, dar tot ai recunoaște diagrama din 2017 în el. Întrebarea deschisă este dacă modelele de spațiu de stare și hibridele vor prelua contexte lungi sau dacă nuclee precum FlashAttention vor păstra costul pătratic al atenției la un nivel accesibil.
Ca să pui asta în practică, construiește un Transformer cu PyTorch în tutorialul nostru pas cu pas sau pornește de la modele pre-antrenate în introducerea în Transformere și Hugging Face. Dacă vrei să înveți mai mult, îți recomand cursul Transformer Models with PyTorch sau traseul Developing Large Language Models pentru parcursul complet.
Întrebări frecvente
Cum funcționează arhitectura transformer?
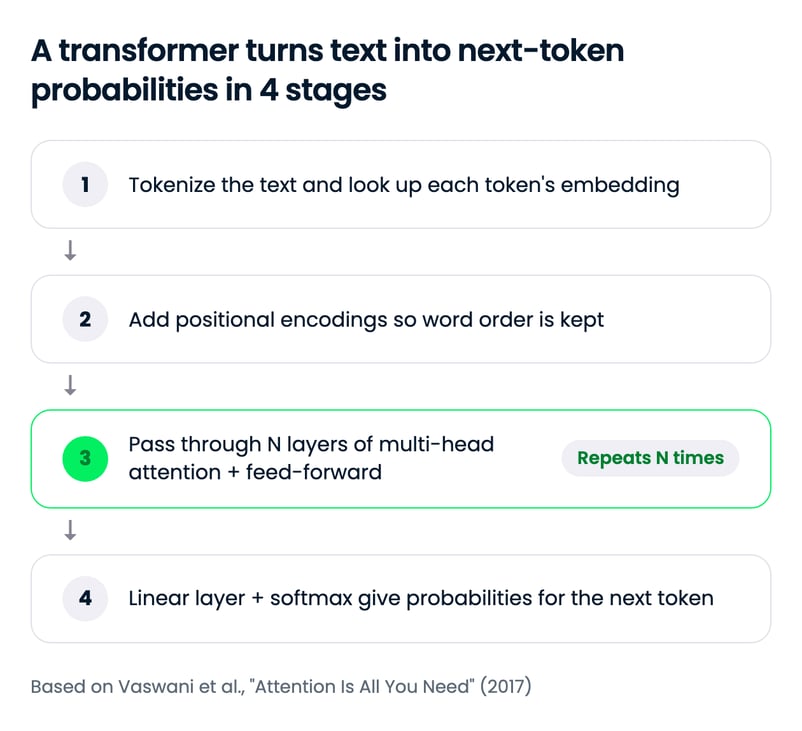
Un transformer împarte textul în tokeni, transformă fiecare token într-un embedding și adaugă informație pozițională. Un teanc de straturi aplică apoi self-attention multi-head, care permite fiecărui token să cântărească fiecare alt token, urmat de o rețea feed-forward, cu conexiuni reziduale și normalizare în jurul fiecărui pas. Un strat liniar final și softmax produc probabilități pentru următorul token.
Care este diferența dintre transformerele doar cu encoder, doar cu decoder și encoder-decoder?
Modelele doar cu encoder precum BERT citesc întreaga intrare bidirecțional și se potrivesc pentru clasificare și căutare. Modelele doar cu decoder precum GPT și Llama văd doar tokenii anteriori și sunt antrenate să prezică următorul, ceea ce le face designul standard pentru LLM-urile de chat. Modelele encoder-decoder precum T5 și Transformerul original mapează o secvență de intrare la o secvență de ieșire, ca în traducere.
De ce au înlocuit transformerele RNN-urile și LSTM-urile?
RNN-urile și LSTM-urile procesează tokenii pe rând, ceea ce încetinește antrenarea pe GPU-uri și lasă informația să se estompeze pe secvențe lungi. Self-attention conectează direct fiecare token la fiecare alt token și procesează întreaga secvență în paralel, astfel încât transformerele se antrenează mai rapid și gestionează mai bine dependențele pe distanțe mari.
Este ChatGPT un transformer?
Da. GPT înseamnă Generative Pre-trained Transformer, iar modelele GPT din spatele ChatGPT sunt transformere doar cu decoder antrenate să prezică următorul token. OpenAI nu a publicat detalii de arhitectură de la GPT-3 încoace, dar fiecare model GPT este construit pe designul transformer.
Care sunt principalele limitări ale transformerelor?
Costul self-attention crește pătratic cu lungimea secvenței, astfel că ferestrele de context lungi sunt costisitoare ca și calcul și memorie. Transformerele au nevoie, de asemenea, de seturi mari de date pentru antrenare și pot halucina, afirmând informații false cu încredere. Tehnici precum FlashAttention, grouped-query attention, mixture of experts și hibride cu modele de spațiu de stare vizează aceste costuri.
Un transformer este o rețea neuronală care citește toți tokenii unei secvențe simultan și folosește mecanismul de self-attention pentru a decide cât de mult ar trebui fiecare token să se bazeze pe toți ceilalți. Cercetătorii Google l-au introdus în lucrarea din 2017 „Attention Is All You Need”, iar astăzi stă la baza aproape fiecărui model lingvistic mare (LLM), de la GPT și Llama la Gemini.
Arhitectura funcționează în 4 etape. Textul este împărțit în tokeni și mapat la embeddinguri, se adaugă informație pozițională, un teanc de straturi alternează atenția multi-head cu rețele feed-forward (fiecare învelit într-o conexiune reziduală și normalizare), iar un strat liniar final cu softmax transformă ultimul vector în probabilități peste vocabular. Modelul original împerechea un encoder cu un decoder; majoritatea LLM-urilor de azi păstrează doar decoderul.
În acest tutorial, voi parcurge fiecare etapă a designului encoder-decoder original, apoi îți voi arăta cum l-au schimbat BERT, GPT și LLM-urile actuale. Dacă vrei mai întâi intuiția, citește explicațiile noastre despre mecanismul de atenție și self-attention.
Pe scurt