

Что такое трансформеры?
Трансформеры впервые разработали для решения задачи преобразования последовательностей — нейронного машинного перевода, то есть для любых задач, где входная последовательность преобразуется в выходную. Отсюда и название “Transformers”.
Но начнём с основ.
Простое определение
Модель-трансформер — это нейросеть, которая изучает контекст последовательных данных и на этой основе генерирует новые данные.
Проще говоря:
Трансформер — это вид модели искусственного интеллекта, который учится понимать и генерировать текст, похожий на человеческий, анализируя закономерности в больших массивах текстовых данных.
Трансформеры — текущий передовой стандарт в NLP и считаются развитием архитектуры «энкодер-декодер». Однако, в то время как эта архитектура опиралась в основном на рекуррентные нейронные сети (RNN) для извлечения последовательной информации, у трансформеров рекуррентности нет вовсе.
Как же они это делают?
Их специально спроектировали для понимания контекста и смысла через анализ взаимосвязей между элементами, и почти полностью они полагаются на математический приём под названием «внимание».
Изображение автора.
Исторический контекст
Трансформеры представили исследователи Google в статье 2017 года "Attention is All You Need". Код вышел в пакете TensorFlow Tensor2Tensor, а группа Harvard NLP опубликовала аннотированное руководство к статье на PyTorch. Вы также можете узнать, как реализовать трансформер с нуля в нашем отдельном руководстве.
Уже через год BERT от Google и GPT-1 от OpenAI показали, что трансформер, предобученный на неразмеченном тексте, можно дообучить для почти любой языковой задачи. В 2020 году вышел GPT-3, а исследователи Стэнфорда ввели термин “основополагающие модели” для этого нового класса.
С тех пор всё развивается быстро: модели с открытыми весами, такие как Llama от Meta (2023), мультимодальные модели вроде GPT-4o (2024), модели рассуждений — o1 от OpenAI и DeepSeek-R1 (конец 2024 — начало 2025), и агентные модели вроде GPT-5 (2025) и GPT-6 Astra (2026). Модели с публичным дизайном по-прежнему являются трансформерами. Полная история — в нашем материале об истории больших языковых моделей.
Переход от RNN к трансформерам
Когда представили трансформер, рекуррентные нейронные сети (RNN) и их вариант LSTM были основными моделями для последовательных данных. Они обрабатывают вход по одному элементу за раз, что создаёт две основные проблемы:
- Медленное обучение: каждый шаг ждёт предыдущий, поэтому RNN не могут задействовать параллельные вычисления, ради которых созданы GPU.
- Забывание на больших расстояниях: информация передаётся шаг за шагом, и чем длиннее цепочка, тем вероятнее потери.
Трансформеры сохранили идею «энкодер-декодер» из RNN, но заменили рекуррентность вниманием, что решило обе проблемы: каждое слово может напрямую учитывать любое другое, независимо от расстояния, а вся последовательность обрабатывается параллельно.
Далее посмотрим, как именно работают трансформеры.
Как работает архитектура трансформера?
Изначально созданные для преобразования последовательностей и машинного перевода, трансформеры превосходно преобразуют входные последовательности в выходные. Это первая модель трансдукции, полностью полагающаяся на самовнимание для вычисления представлений входа и выхода без выровненных по последовательности RNN или свёрток. Ключевая особенность архитектуры трансформеров — сохранение модели «энкодер-декодер».
Если рассматривать трансформер для перевода как «чёрный ящик», он принимает предложение на одном языке, например на английском, и выдаёт его перевод на испанский.
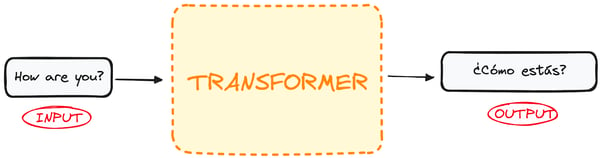
Изображение автора.
Если «заглянуть внутрь», этот чёрный ящик состоит из двух основных частей:
- Энкодер принимает вход и выводит матричное представление этого входа. Например, английское предложение «How are you?»
- Декодер принимает закодированное представление и итеративно генерирует выход. В нашем примере — переведённое предложение «¿Cómo estás?»
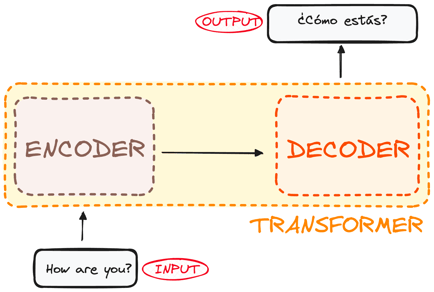
Изображение автора. Глобальная структура «энкодер-декодер».
Однако и энкодер, и декодер на самом деле представляют собой стек из нескольких слоёв (одинаковое число в каждом). Все энкодеры имеют одинаковую структуру, вход подаётся в каждый из них и передаётся выше. Все декодеры также одинаковы: они получают вход от последнего энкодера и предыдущего декодера.
Изначальная архитектура включала 6 энкодеров и 6 декодеров, но мы можем повторять столько слоёв, сколько нужно. Будем считать, что их по N каждого типа.
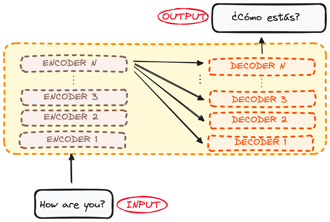
Изображение автора. Глобальная структура «энкодер-декодер». Несколько слоёв.
Теперь, когда у нас есть общее представление об архитектуре трансформера, сосредоточимся на энкодерах и декодерах и разберём их рабочий процесс.
Как работает энкодер трансформера?
Энкодер — ключевой компонент архитектуры трансформера. Его основная функция — преобразовать входные токены в контекстуализированные представления. В отличие от ранних моделей, которые обрабатывали токены независимо, энкодер трансформера захватывает контекст каждого токена относительно всей последовательности.
Его структура состоит из следующего:
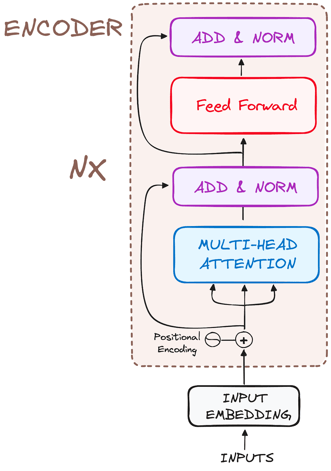
Изображение автора. Глобальная структура энкодеров.
Разобьём рабочий процесс на базовые шаги:
Шаг 1: Входные эмбеддинги
Эмбеддинг выполняется только в самом нижнем энкодере. Сначала токенизатор разбивает текст на токены — слова или их части — и каждый токен отображается в обучаемый вектор под названием эмбеддинг. Токены со схожим смыслом получают похожие векторы.
Все энкодеры получают список векторов, каждый из 512 измерений в оригинальной статье (dmodel = 512). В нижнем энкодере это словарные эмбеддинги, а в остальных — выход предыдущего энкодера.
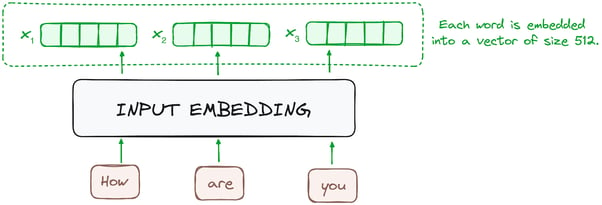
Изображение автора. Рабочий процесс энкодера. Входные эмбеддинги.
Шаг 2: Позиционное кодирование
Поскольку у трансформеров нет механизма рекуррентности, как у RNN, они используют позиционные кодировки, добавляемые к входным эмбеддингам, чтобы передать информацию о позиции каждого токена в последовательности. Это позволяет понимать расположение слов в предложении.
Для этого исследователи предложили использовать комбинации синусоид и косинусоид для создания позиционных векторов, благодаря чему этот механизм можно применять к предложениям любой длины.
В таком подходе каждое измерение представлено уникальными частотами и сдвигами волны, а значения варьируются от -1 до 1, эффективно кодируя каждую позицию.
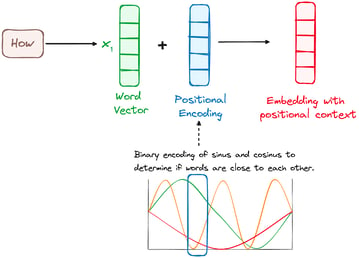
Изображение автора. Рабочий процесс энкодера. Позиционное кодирование.
Шаг 3: Стек слоёв энкодера
Энкодер трансформера состоит из стека идентичных слоёв (6 в оригинальной модели).
Слой энкодера преобразует все входные последовательности в непрерывное абстрактное представление, которое включает извлечённую из всей последовательности информацию. Этот слой содержит два подмодуля:
- Механизм многоголового внимания.
- Полносвязную сеть.
Дополнительно вокруг каждого подслоя добавляются резидуальные соединения, после чего следует нормализация по слою.
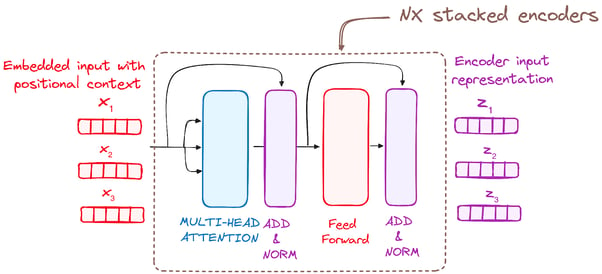
Изображение автора. Рабочий процесс энкодера. Стек слоёв энкодера
Шаг 3.1: Многоголовое самовнимание
В энкодере многоголовое внимание использует специальный механизм — самовнимание. Он позволяет моделям соотносить каждое слово входа с другими словами. Например, модель может связать слово «are» со словом «you».
Этот механизм даёт энкодеру возможность фокусироваться на разных частях входной последовательности при обработке каждого токена. Он вычисляет оценки внимания на основе:
- Запроса — вектора, который представляет конкретное слово или токен входной последовательности в механизме внимания.
- Ключа — также вектора в механизме внимания, соответствующего каждому слову или токену во входной последовательности.
- Значения, связанного с ключом и используемого для построения выхода слоя внимания. Когда запрос и ключ хорошо совпадают, то есть имеют высокую оценку внимания, соответствующее значение усиливается на выходе.
Этот первый модуль самовнимания позволяет модели захватывать контекстуальную информацию из всей последовательности. Вместо одного вычисления внимания запросы, ключи и значения линейно проецируются h раз. На каждой из таких проекций внимание вычисляется параллельно, формируя выход размерности dv (64 в оригинальной статье при h = 8).
Детальная архитектура такова:
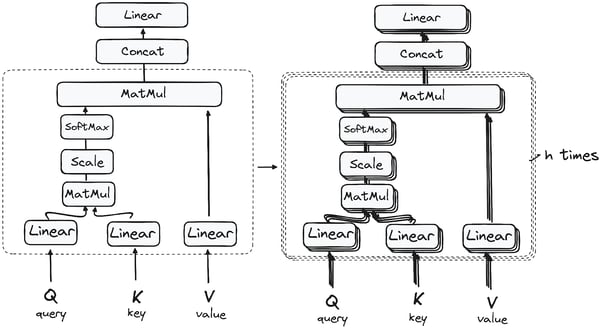
Матричное умножение (MatMul): скалярное произведение запроса и ключа
После прохождения векторов запроса, ключа и значения через линейный слой выполняется матричное умножение (скалярное произведение) между запросами и ключами, формируя матрицу оценок.
Матрица оценок задаёт степень внимания каждого слова к другим словам. То есть каждому слову назначается оценка относительно остальных слов на том же шаге. Чем выше оценка, тем больше фокус.
Этот процесс по сути сопоставляет запросы с соответствующими ключами.
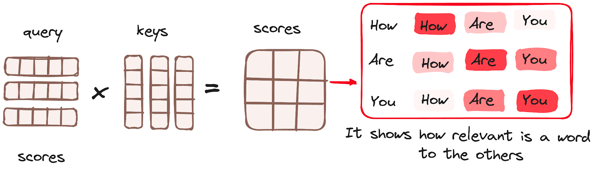
Изображение автора. Рабочий процесс энкодера. Механизм внимания — матричное умножение.
Снижение масштаба оценок внимания
Затем оценки масштабируются вниз делением на квадратный корень из размерности векторов запроса и ключа. Это обеспечивает более стабильные градиенты, поскольку произведения значений могут приводить к чрезмерно большим эффектам.
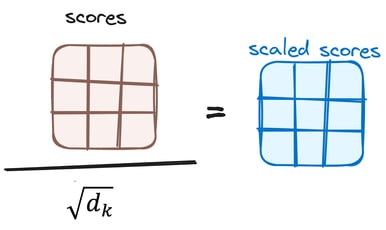
Изображение автора. Рабочий процесс энкодера. Снижение оценок внимания.
Применение softmax к скорректированным оценкам
Далее к скорректированным оценкам применяется функция softmax для получения весов внимания. Это даёт вероятности от 0 до 1. Softmax подчёркивает высокие оценки и подавляет низкие, помогая модели эффективнее определять, каким словам уделять больше внимания.
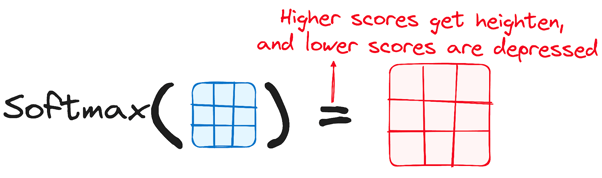
Изображение автора. Рабочий процесс энкодера. Softmax скорректированных оценок.
Комбинирование результатов softmax со вектором значений
Далее веса, полученные из softmax, умножаются на вектор значений, формируя выходной вектор.
Слова с высокими весами доминируют в результате, а слова с весами, близкими к 0, почти не влияют. Наконец, этот вектор подаётся в линейный слой для дальнейшей обработки.
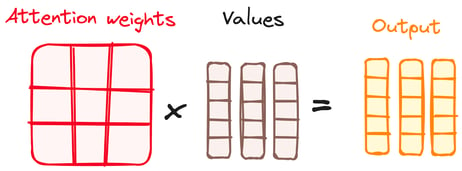
Изображение автора. Рабочий процесс энкодера. Комбинирование результатов Softmax со вектором значений.
И, наконец, мы получаем выход механизма внимания!
Термин «многоголовое» связан с параллельным многократным выполнением этого процесса. До начала внимания запросы, ключи и значения разбиваются на h меньших наборов — «голов», и каждая голова выполняет описанные шаги на своей части.
Выходы голов конкатенируются и проходят через финальный линейный слой. Поскольку каждая голова обучает свои проекции, разные головы могут улавливать разные зависимости — например, к какому существительному относится местоимение или какие слова стоят рядом.
Для более глубокого понимания механизма внимания см. наш туториал о многоголовом внимании в трансформерах.
Шаг 3.2: Нормализация и резидуальные соединения
Каждый подслой в слое энкодера сопровождается шагом нормализации. Также выход каждого подслоя складывается с его входом (резидуальное соединение), что помогает бороться с затуханием градиента и позволяет строить более глубокие модели. Этот процесс повторяется и после полносвязной сети.
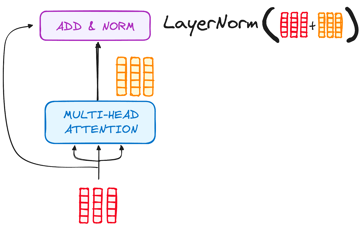
Изображение автора. Рабочий процесс энкодера. Нормализация и резидуальное соединение после многоголового внимания.
Шаг 3.3: Полносвязная нейронная сеть
Далее выход проходит через покомпонентную полносвязную сеть: 2 линейных слоя с активацией ReLU между ними, применяемые к каждому токену отдельно. В оригинальной статье внутренний слой имеет 2048 измерений — в 4 раза шире модели с 512.
Как и в блоке внимания, вход сети добавляется к её выходу (резидуальное соединение), а результат нормализуется.
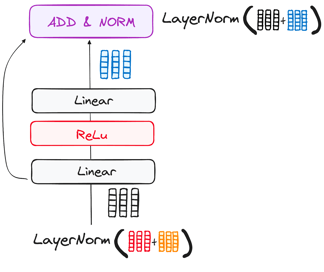
Изображение автора. Рабочий процесс энкодера. Подслой полносвязной нейронной сети.
Шаг 4: Выход энкодера
Выход финального слоя энкодера — набор векторов, каждый из которых представляет входную последовательность с богатым контекстом. Затем этот выход используется как вход для декодера в модели трансформера.
Такое аккуратное кодирование готовит почву для декодера, направляя его уделять внимание нужным словам во входе при декодировании.
Стекирование N слоёв энкодера позволяет каждому слою строить представления на основе нижележащего. В оригинальной модели N = 6; в BERT-Base — 12, в BERT-Large — 24.
Как работает декодер трансформера?
Декодер генерирует выходную последовательность. Его слои зеркалируют энкодер с одним отличием: в каждом слое 2 подслоя многоголового внимания вместо одного, затем покомпонентная полносвязная сеть; вокруг каждого подслоя — резидуальное соединение и нормализация.
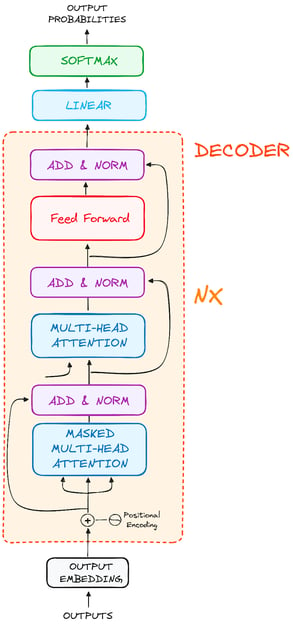
Изображение автора. Глобальная структура декодеров.
Эти компоненты работают схоже со слоями энкодера, но с нюансом: каждый слой многоголового внимания в декодере выполняет свою задачу.
Финальный этап процесса в декодере — линейный слой, выступающий классификатором, а затем softmax для расчёта вероятностей слов.
Структура декодера специально спроектирована для поэтапной генерации выхода путём декодирования закодированной информации.
Декодер работает автоагрессivamente: он начинается с токена начала последовательности и на каждом шаге принимает уже сгенерированные токены вместе с выходом энкодера.
Он останавливается, когда генерирует токен конца последовательности.
Шаг 1: Выходные эмбеддинги
В начале декодера процесс повторяет энкодер: вход сначала проходит через слой эмбеддингов.
Шаг 2: Позиционное кодирование
После эмбеддингов, как и в энкодере, вход проходит через слой позиционного кодирования. Так формируются позиционные эмбеддинги.
Эти позиционные эмбеддинги поступают в первый слой многоголового внимания декодера, где вычисляются оценки внимания для собственного входа декодера.
Шаг 3: Стек слоёв декодера
Декодер — это стек идентичных слоёв (6 в исходной модели). Каждый слой имеет три основных компонента:
Шаг 3.1: Маскированное самовнимание
Это похоже на самовнимание в энкодере, но с важным отличием: позиции не могут «смотреть» на последующие позиции, то есть каждое слово в последовательности не зависит от будущих токенов.
Например, при вычислении оценок внимания для слова «Cómo» важно, чтобы «Cómo» не «подсматривало» «estás», которое идёт позже в выходной последовательности.
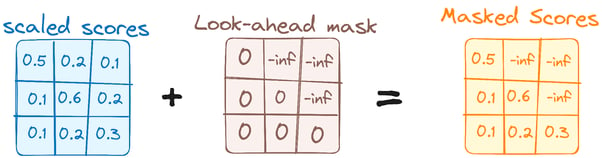
Изображение автора. Рабочий процесс декодера. Первая маска многоголового внимания.
Эта маска гарантирует, что предсказания для позиции зависят только от известных выходов на предыдущих позициях.
Шаг 3.2: Внимание «энкодер-декодер» (кросс-внимание)
Второй подслой внимания связывает декодер с энкодером. Здесь запросы приходят из маскированного самовнимания декодера, а ключи и значения — из финального выхода энкодера.
Это позволяет каждой позиции декодера учитывать все позиции во входном предложении, чтобы при генерации «estás» декодер мог сфокусироваться на «are you». Затем результат проходит через полносвязной подслой.
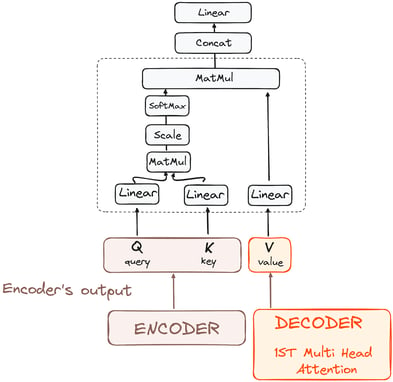
Изображение автора. Рабочий процесс декодера. Внимание «энкодер-декодер».
Шаг 3.3: Полносвязная нейронная сеть
Как и в энкодере, каждый слой декодера содержит полносвязную сеть, применяемую к каждой позиции отдельно и одинаково.
Шаг 4: Линейный классификатор и softmax
Путь данных через трансформер завершается прохождением через финальный линейный слой, который выполняет роль классификатора.
Размер этого классификатора соответствует количеству классов (числу слов словаря). Например, при 1000 классах, представляющих 1000 разных слов, выход классификатора будет массивом из 1000 элементов.
Этот выход затем поступает в слой softmax, который преобразует его в вероятности от 0 до 1. Токен с наибольшей вероятностью — лучшая догадка модели о следующем слове. Жадное декодирование всегда выбирает его; большинство чат-моделей вместо этого семплируют из распределения, а параметр температуры управляет допустимой долей случайности.
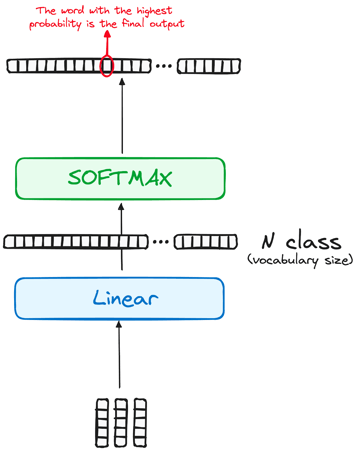
Изображение автора. Рабочий процесс декодера. Финальный выход трансформера.
Нормализация и резидуальные соединения
Каждый подслой (маскированное самовнимание, внимание «энкодер-декодер», полносвязная сеть) сопровождается нормализацией и содержит резидуальное соединение вокруг него.
Выход декодера
Выход финального слоя преобразуется в предсказанную последовательность, как правило через линейный слой и softmax для генерации вероятностей по словарю.
В процессе работы декодер добавляет только что сгенерированный выход к накапливаемому входу и продолжает декодирование. Цикл повторяется, пока модель не предскажет специальный токен завершения.
Как и энкодер, декодер — это стек из N идентичных слоёв (6 в оригинальной модели), где каждый строится на выходе нижележащего слоя и на выходе энкодера. Более глубокие стеки позволяют разным слоям и головам улавливать разные паттерны внимания.
Финальная архитектура выглядит так (из оригинальной статьи):
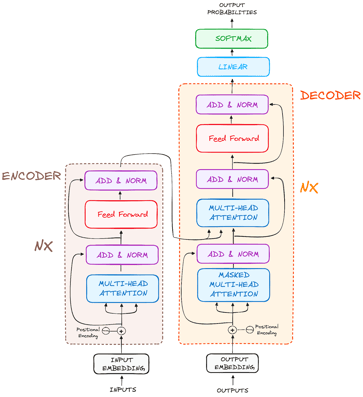
Изображение автора. Оригинальная структура трансформеров.
Чтобы лучше понять эту архитектуру, рекомендуем попробовать реализовать трансформер с нуля по туториалу по PyTorch.
Трансформеры типа «только энкодер», «только декодер» и «энкодер-декодер»
Модели-трансформеры делятся на 3 семейства в зависимости от того, какую часть исходной архитектуры они сохраняют. Этот выбор определяет сильные стороны модели: энкодеры «читают», декодеры «пишут», а связки «энкодер-декодер» отображают одну последовательность на другую.
| Семейство | Что сохраняет | Внимание | Задача предобучения | Типичные применения | Примеры |
|---|---|---|---|---|---|
| Только энкодер | Стек энкодера | Двунаправленное: каждый токен видит каждый токен | Заполнение замаскированных токенов | Классификация, эмбеддинги для поиска, распознавание сущностей | BERT, RoBERTa |
| Только декодер | Стек декодера без кросс-внимания | Причинное: каждый токен видит только предыдущие | Предсказание следующего токена | Чат, генерация кода, агенты | GPT-3, Llama, Gemini |
| Энкодер-декодер | Оба стека | Двунаправленный энкодер, причинный декодер плюс кросс-внимание | Отображение входной последовательности в выходную | Перевод, суммаризация, распознавание речи | Оригинальный трансформер, T5, Whisper |
Большинство LLM, выпущенных после GPT-3, — только декодер. Предсказание следующего токена работает на любом сыром тексте, данных для обучения много, а одна модель может решать перевод, суммаризацию и ответы на вопросы как продолжение текста.
Какие модели используют архитектуру трансформера?
BERT
BERT (Bidirectional Encoder Representations from Transformers), выпущенный Google с открытым исходным кодом в 2018 году, — трансформер «только энкодер». Вместо предсказания следующего слова его предобучали заполнять замаскированные слова, используя контекст с обеих сторон, что сделало его сильнее в задачах понимания по сравнению с тогдашними левонаправленными моделями.
Понимая контекст со всех сторон слова, BERT превзошёл предыдущие модели в задачах ответов на вопросы и понимания неоднозначного языка. В его основе — трансформеры, динамически связывающие каждый выходной и входной элемент.
BERT предобучали на англоязычной Википедии и датасете BooksCorpus; Google добавил его в Поиск в 2019 году для лучшей интерпретации запросов на естественном языке. Это запустило гонку по созданию более крупных предобученных языковых моделей.
Подробнее о BERT — в нашей отдельной статье, где представлена модель BERT.
LaMDA
LaMDA (Language Model for Dialogue Applications) — модель на базе трансформера от Google, разработанная специально для диалоговых задач и представленная на конференции Google I/O 2021. Модели создавались для более естественных и контекстно релевантных ответов, улучшая взаимодействие с пользователями в различных приложениях.
Дизайн LaMDA позволяет понимать и отвечать на широкий спектр тем и намерений, что делает её идеальной для чат-ботов, голосовых помощников и других интерактивных ИИ-систем, где важен динамичный диалог.
Позже Google заменил LaMDA в чат-боте Bard на PaLM 2, а затем на Gemini, но LaMDA была одной из первых трансформерных моделей, обученных специально на диалогах.
Если вы хотите глубже разобраться в моделях LaMDA, прочитайте наш материал о LaMDA.
GPT и ChatGPT
GPT и ChatGPT, разработанные OpenAI, — продвинутые генеративные модели, известные способностью создавать связный и контекстуально уместный текст. GPT-1 был запущен в июне 2018 года, а GPT-3, одна из самых влиятельных моделей, — в 2020 году.
Эти модели справляются с широким спектром задач: генерация контента, диалог, перевод и многое другое. Архитектура GPT позволяет генерировать текст, близкий к человеческому, что полезно в креативном письме, поддержке клиентов и даже помощи в программировании. ChatGPT — вариант, оптимизированный для диалогов, — отлично ведёт беседу, что делает его эффективным в чат-ботах и виртуальных ассистентах.
OpenAI перестала публиковать детали архитектуры после GPT-3 (кроме своих моделей с открытыми весами gpt-oss), но семейство продолжает расти, последнее — GPT-6 Astra в 2026 году.
Claude
Claude, разработанный Anthropic, — семейство ассистентов ИИ на базе трансформера с упором на безопасность и полезность. Claude использует Constitutional AI (CAI) — подход к обучению, при котором модель направляется набором принципов для выдачи полезных, безопасных и честных ответов.
Claude 3 (выпущенный в 2024) представил три уровня моделей — Haiku, Sonnet и Opus — с разными компромиссами между скоростью и возможностями. Модели сильны в тонких рассуждениях, следовании сложным инструкциям и удержании контекста в долгих беседах (до 200 тыс. токенов).
С тех пор Anthropic выпускает новые поколения каждые несколько месяцев. Текущая линейка Claude 5 включает Claude Fable 5.1 и Claude Opus 5.5, обе модели выпущены в 2026 году. Как и OpenAI, Anthropic не публикует детали архитектуры.
Другие вариации
Число трансформерных моделей быстро растёт. Каталог трансформеров Ксавье Аматриаина классифицирует десятки моделей по архитектуре и целям обучения, а бенчмарк HELM Стэнфорда сравнил бок о бок 30 известных языковых моделей.
Растёт тенденция к открытости: платформы вроде хаба моделей Hugging Face ведут за собой. Создано множество моделей на базе трансформеров, каждая специализирована под разные NLP-задачи, что демонстрирует универсальность и эффективность архитектуры.
Подробнее о всех существующих основополагающих моделях — в отдельной статье: что это такое и какие наиболее распространены.
Как трансформеры изменились с 2017 года?
С 2017 года трансформеры значительно эволюционировали, чтобы устранить ограничения и выйти в новые области.
Чем современные LLM отличаются от оригинального трансформера
Современные модели с открытыми весами всё ещё следуют чертежу 2017 года, но почти каждый компонент заменён вариантом, который обучается стабильнее или работает дешевле. Meta документирует большинство изменений в статьях о LLaMA и Llama 3:
| Компонент | Оригинальный трансформер (2017) | Типичная открытая LLM сегодня |
|---|---|---|
| Архитектура | Энкодер-декодер, 6 + 6 слоёв | Только декодер, от 32 слоёв (Llama 3 8B) до 126 слоёв (Llama 3 405B) |
| Ширина модели | 512 | От 4 096 (Llama 3 8B) до 16 384 (Llama 3 405B) |
| Позиционная информация | Фиксированные синусы и косинусы, добавляемые к эмбеддингам | Поворотные позиционные эмбеддинги (RoPE), применяемые внутри внимания |
| Нормализация | LayerNorm после каждого подслоя (post-norm) | RMSNorm перед каждым подслоем (pre-norm) |
| Активация в полносвязном слое | ReLU | SwiGLU |
| Головы внимания | Многоголовое внимание, 8 голов | Сгруппированное внимание по запросам: несколько голов запросов делят 1 KV-голову (8 KV-голов в Llama 3) |
| Полносвязный слой | Плотный | Плотный или «смесь экспертов» (Llama 4, DeepSeek-V3) |
Vision Transformers (ViT)
Vision Transformers применяют самовнимание к изображениям, деля их на патчи и рассматривая каждый патч как токен. Этот подход оказался очень эффективен для классификации изображений, детекции объектов и генерации изображений, часто превосходя традиционные CNN на больших датасетах.
Мультимодальные трансформеры
Современные модели, такие как GPT-5, Gemini 3 и Llama 4, обрабатывают несколько типов ввода (текст, изображения, аудио, видео) в единой архитектуре. Эти мультимодальные трансформеры используют унифицированные эмбеддинг-пространства и кросс-внимание, чтобы рассуждать одновременно между модальностями.
Эффективные трансформеры
Квадратичная сложность самовнимания ограничивает длину контекста. Несколько новшеств решают это:
- Flash Attention: Вычисляет точное внимание «плитками», которые помещаются в быструю встроенную память GPU, так что использование памяти растёт линейно по длине последовательности вместо квадратичного
- Rotary Position Embeddings (RoPE): Кодируют позицию через матрицы вращения, улучшая экстраполяцию на более длинные последовательности
- Линейное и разреженное внимание: Linformer и Performer аппроксимируют внимание, а Longformer ограничивает большинство токенов локальным окном, снижая стоимость до O(n) для очень длинных документов
- Mixture of Experts (MoE): Активирует только подмножество параметров на токен, позволяя увеличивать модель при сопоставимых затратах вычислений
Трансформеры vs. RNN и CNN
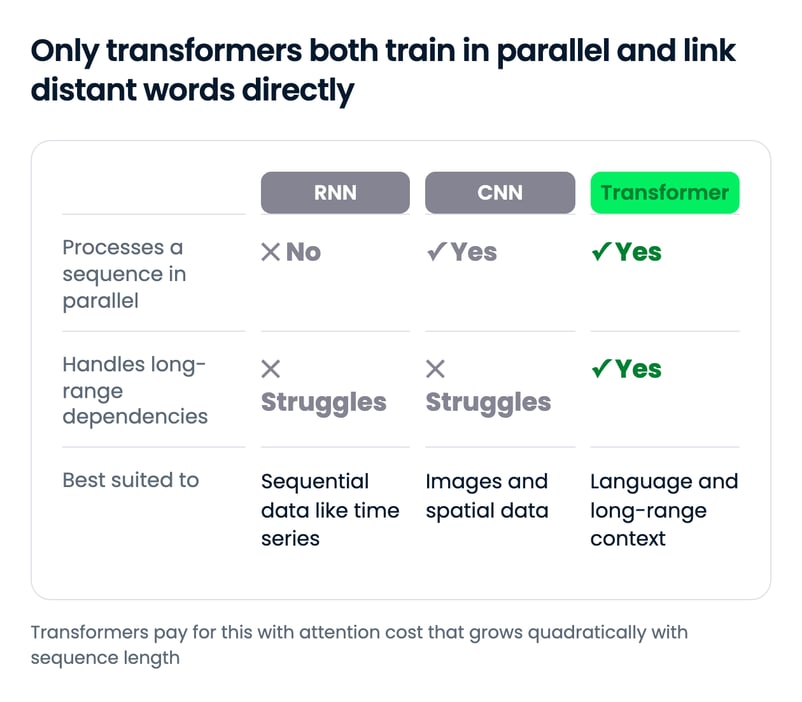
Трансформеры обычно сравнивают с двумя другими строительными блоками нейросетей: рекуррентными слоями (RNN) и свёрточными слоями (CNN). Каждый лучше подходит к своему типу данных.
Рекуррентные слои
Рекуррентные слои — основа рекуррентных нейронных сетей (RNN), отлично обрабатывают последовательные данные. Сила архитектуры — в умении выполнять последовательные операции, важные для обработки языка или временных рядов. В рекуррентном слое выход предыдущего шага подаётся на вход следующего. Эта петля позволяет сети «помнить» предыдущее, что критично для понимания контекста.
Однако, как уже обсуждалось, у такого подхода два последствия:
- Длительное обучение, так как каждый шаг зависит от предыдущего, а параллелизм затруднён.
- Сложности с долгими зависимостями из‑за затухания градиента, когда сеть хуже учится по удалённым точкам последовательности.
Модели-трансформеры существенно отличаются от архитектур с рекуррентными слоями — у них нет рекуррентности. Как мы видели, слой внимания решает обе проблемы, что делает трансформеры естественным развитием RNN для NLP.
Свёрточные слои
Свёрточные слои — строительные блоки свёрточных нейросетей (CNN) — известны эффективной обработкой пространственных данных, например изображений.
Эти слои используют ядра (фильтры), которые сканируют входные данные для извлечения признаков. Ширину ядер можно настраивать, позволяя сети фокусироваться на мелких или крупных признаках в зависимости от задачи.
Хотя свёрточные слои отлично захватывают пространственные иерархии и паттерны, им сложно с долгосрочными зависимостями. Они не учитывают последовательность по своей природе, что делает их менее подходящими там, где нужно понимать порядок или контекст.
Поэтому CNN и трансформеры заточены под разные типы данных и задач. CNN доминируют в компьютерном зрении благодаря эффективности на пространственной информации, а трансформеры — выбор для сложных последовательностей, особенно в NLP, благодаря пониманию дальних зависимостей.
Недостатки и ограничения трансформеров
Несмотря на успех, у трансформеров есть заметные ограничения:
- Квадратичная сложность: Самовнимание масштабируется как O(n²) по длине последовательности, что делает длинные окон контекста дорогими по вычислениям
- Требования к памяти: Крупным моделям нужна значительная память GPU, что ограничивает развёртывание
- Требования к данным: Обычно трансформерам нужны огромные датасеты для высокой точности
- Галлюцинации: Трансформеры предсказывают вероятные токены, а не «ищут факты», поэтому могут уверенно выдавать ложную информацию. Модели рассуждений снижают это, но не устраняют
- Ограничения позиционного кодирования: Стандартные кодировки хуже обобщают на длины, не встречавшиеся в обучении
Исследования продолжают решать эти ограничения архитектурными новшествами, такими как Flash Attention, смесь экспертов и RAG (генерация с расширением за счёт поиска).
Итоги
Трансформер работает, позволяя каждому токену «смотреть» на любой другой через самовнимание, а затем уточняя эти представления стеком одинаковых слоёв. Это решение обеспечило параллельное обучение на GPU и решило проблему дальней памяти, сдерживавшую RNN.
Больше всего поражает, как мало изменилось ядро. LLM образца 2026 года меняет позиционное кодирование, нормализацию и головы внимания на более дешёвые варианты, но вы всё ещё узнаете в нём диаграмму 2017 года. Открытый вопрос — займут ли SSM и гибриды место внимания на длинных контекстах, или такие ядра, как FlashAttention, сохранят квадратичную стоимость внимания приемлемой.
Чтобы перейти к практике, соберите трансформер на PyTorch по нашему пошаговому руководству или начните с предобученных моделей в введении в Transformers и Hugging Face. Если хотите узнать больше, рекомендуем курс Transformer Models with PyTorch или трек Developing Large Language Models для полного пути.
FAQs
Как работает архитектура трансформера?
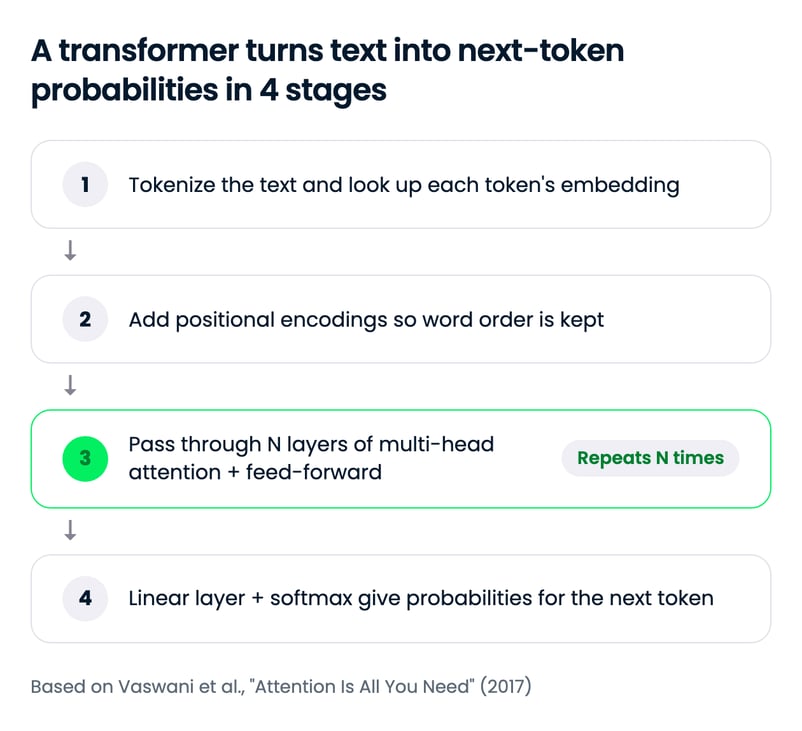
Трансформер разбивает текст на токены, превращает каждый токен в эмбеддинг и добавляет позиционную информацию. Затем стек слоёв применяет многоголовое самовнимание, позволяя каждому токену взвешивать влияние остальных, после чего следует полносвязная сеть; вокруг каждого шага — резидуальные соединения и нормализация. Финальный линейный слой и softmax дают вероятности для следующего токена.
В чём разница между трансформерами «только энкодер», «только декодер» и «энкодер-декодер»?
Модели «только энкодер», такие как BERT, читают весь вход двунаправленно и подходят для классификации и поиска. Модели «только декодер», такие как GPT и Llama, видят только предыдущие токены и обучаются предсказывать следующий — это стандарт для чатовых LLM. Модели «энкодер-декодер», такие как T5 и оригинальный трансформер, отображают входную последовательность в выходную, как при переводе.
Почему трансформеры вытеснили RNN и LSTM?
RNN и LSTM обрабатывают токены по одному, что замедляет обучение на GPU и приводит к потере информации на длинных последовательностях. Самовнимание напрямую связывает каждый токен с каждым и обрабатывает всю последовательность параллельно, поэтому трансформеры обучаются быстрее и лучше справляются с дальними зависимостями.
Является ли ChatGPT трансформером?
Да. GPT расшифровывается как Generative Pre-trained Transformer, а модели GPT, стоящие за ChatGPT, — это трансформеры «только декодер», обученные предсказывать следующий токен. OpenAI не публикует детали архитектуры с GPT-3, но каждая модель GPT построена на трансформере.
Каковы основные ограничения трансформеров?
Стоимость самовнимания растёт квадратично с длиной последовательности, поэтому длинные окна контекста дороги по вычислениям и памяти. Трансформерам также нужны большие обучающие датасеты, и они могут «галлюцинировать», уверенно выдавая неверные факты. Такие приёмы, как FlashAttention, сгруппированное внимание по запросам, смесь экспертов и гибриды со state space моделями, нацелены на снижение этих издержек.
Трансформер — это нейросеть, которая одновременно читает все токены последовательности и с помощью механизма самовнимания определяет, насколько каждый токен должен опираться на каждый другой. Исследователи Google представили его в статье 2017 года “Attention Is All You Need”, и сегодня он лежит в основе почти каждой большой языковой модели (LLM) — от GPT и Llama до Gemini.
Архитектура работает в 4 этапа. Текст разбивается на токены и отображается в эмбеддинги, добавляется позиционная информация, стек слоёв чередует многоголовое самовнимание и полносвязные сети (каждая часть обёрнута резидуальным соединением и нормализацией), а финальный линейный слой с softmax превращает последний вектор в вероятности по словарю. Изначальная модель сочетала энкодер с декодером; большинство современных LLM оставляют только декодер.
В этом руководстве пошагово рассмотрены все стадии исходного дизайна «энкодер-декодер», а затем показано, как его изменили BERT, GPT и современные LLM. Если хотите сначала интуитивное объяснение, прочитайте наши материалы о механизме внимания и самовнимании.
Кратко