

Vad är transformatorer?
Transformatorer utvecklades först för att lösa problemet med sekvenstransduktion, eller neurala maskinöversättningar, vilket betyder att de är avsedda att lösa alla uppgifter som transformerar en indata-sekvens till en utdata-sekvens. Det är därför de kallas “Transformers”.
Men låt oss börja från början.
En enkel definition
En transformermodell är ett neuralt nätverk som lär sig kontexten i sekventiell data och genererar ny data utifrån den.
Enkelt uttryckt:
En transformer är en typ av AI‑modell som lär sig att förstå och generera människolik text genom att analysera mönster i stora mängder textdata.
Transformers är ett modernt toppskikt inom NLP och ses som en vidareutveckling av encoder–decoder-arkitekturen. Men medan encoder–decoder-arkitekturen främst förlitar sig på rekurrenta neurala nätverk (RNN) för att extrahera sekventiell information, saknar Transformers helt denna rekurrens.
Så hur gör de då?
De är specifikt utformade för att förstå kontext och betydelse genom att analysera relationen mellan olika element och de förlitar sig nästan helt på en matematisk teknik som kallas attention för att göra det.
Bild av författaren.
Historisk kontext
Transformers introducerades av Google-forskare i 2017 års artikel "Attention is All You Need". Koden släpptes i TensorFlows Tensor2Tensor-paket och Harvard NLP-gruppen följde upp med en kommenterad guide till artikeln i PyTorch. Du kan också lära dig hur man implementerar en Transformer från grunden i vår separata handledning.
Inom ett år visade Googles BERT och OpenAI:s GPT‑1 att en transformer förtränad på oetiketterad text kunde finjusteras för nästan vilken språkuppgift som helst. GPT‑3 följde 2020, och forskare vid Stanford myntade termen “foundation models” för denna nya modellklass.
Sedan dess har det gått snabbt: open-weight-modeller som Metas Llama (2023), multimodala modeller som GPT‑4o (2024), resonemangsmodeller som OpenAI:s o1 och DeepSeek‑R1 (slutet av 2024 till början av 2025), och agentiska modeller som GPT‑5 (2025) och GPT‑6 Astra (2026). Modellerna vars design är offentlig är alla fortfarande transformers. För hela historien, se vår historia över stora språkmodeller.
Skiftet från RNN-modeller till Transformers
När Transformern introducerades var rekurrenta neurala nätverk (RNN) och deras variant long short-term memory (LSTM) förstahandsvalet för sekventiell data. De bearbetar indata ett element i taget, vilket orsakar två huvudproblem:
- Långsam träning: varje steg väntar på det föregående, så RNN:er kan inte använda den parallella beräkning som GPU:er är byggda för.
- Glömska över långa avstånd: information förs vidare steg för steg, och ju längre kedjan är, desto större risk att den går förlorad.
Transformers behöll encoder–decoder-idén från RNN:er men ersatte rekurrens med attention, vilket löser båda problemen: varje ord kan uppmärksamma vilket annat ord som helst, oavsett avstånd, och hela sekvensen bearbetas parallellt.
Nästa steg är att titta på hur transformers fungerar.
Hur fungerar transformerarkitekturen?
Ursprungligen utformad för sekvenstransduktion eller neurala maskinöversättningar, utmärker sig transformers i att konvertera insekvenser till utsekvenser. Det är den första transduktionsmodellen som helt förlitar sig på self-attention för att beräkna representationer av sina in- och utdata utan att använda sekvensjusterade RNN:er eller konvolution. Den centrala egenskapen hos Transformers-arkitekturen är att den behåller encoder–decoder-modellen.
Om vi börjar se en Transformer för språköversättning som en enkel svart låda, tar den en mening på ett språk, till exempel engelska, som indata och ger ut dess översättning till spanska.
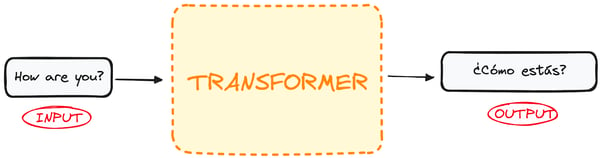
Bild av författaren.
Gräver vi lite ser vi att denna svarta låda består av två huvuddelar:
- Encodern tar in vår indata och ger en matrisrepresentation av den. Till exempel den engelska meningen “How are you?”
- Decodern tar in den encoderade representationen och genererar iterativt en utdata. I vårt exempel den översatta meningen “¿Cómo estás?”
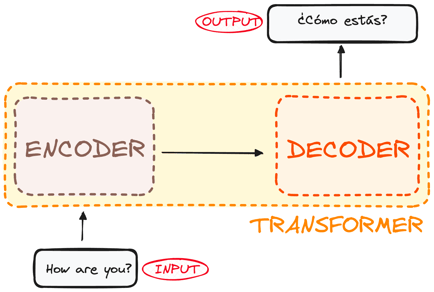
Bild av författaren. Global struktur för Encoder–Decoder.
Både encodern och decodern är dock i praktiken en stapel med flera lager (samma antal för vardera). Alla encoders har samma struktur och indata går in i var och en och förs vidare till nästa. Alla decoders har också samma struktur och får indata från den sista encodern och den föregående decodern.
Den ursprungliga arkitekturen bestod av 6 encoders och 6 decoders, men vi kan replikera så många lager vi vill. Låt oss alltså anta N lager av vardera.
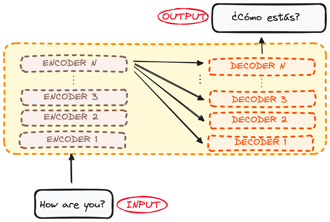
Bild av författaren. Global struktur för Encoder–Decoder. Flera lager.
Nu när vi har en generell bild av den övergripande Transformer-arkitekturen, låt oss fokusera på både Encoders och Decoders för att bättre förstå deras arbetsflöde:
Hur fungerar Transformer-encodern?
Encodern är en grundläggande komponent i Transformer-arkitekturen. Dess primära funktion är att omvandla indatatokens till kontextualiserade representationer. Till skillnad från tidigare modeller som bearbetade tokens oberoende fångar Transformer-encodern kontexten för varje token med avseende på hela sekvensen.
Dess struktur är sammansatt enligt följande:
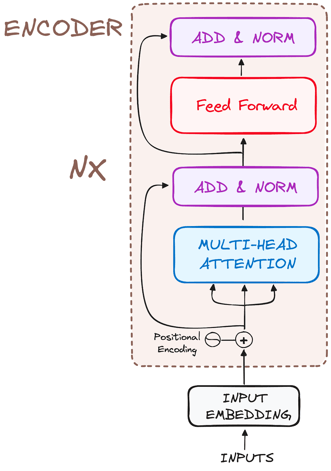
Bild av författaren. Global struktur för Encoders.
Låt oss bryta ned arbetsflödet i dess mest grundläggande steg:
Steg 1: Inbäddningar av indata
Inbäddningen sker bara i den nedersta encodern. Först delar en tokenizer upp texten i tokens, som är ord eller ordfragment, och varje token mappas till en inlärd vektor som kallas en inbäddning. Tokens med relaterade betydelser får liknande vektorer.
Alla encoders tar emot en lista med vektorer, var och en med 512 dimensioner i den ursprungliga artikeln (dmodel = 512). I den nedersta encodern är det ordinbäddningar, men i andra encoders är det utdata från encodern direkt under.
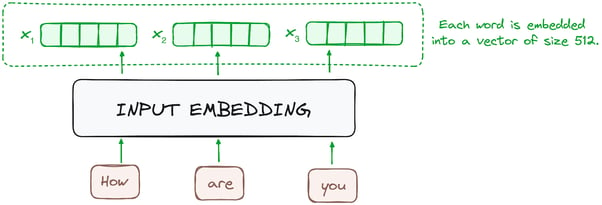
Bild av författaren. Encoderns arbetsflöde. Inbäddning av indata.
Steg 2: Positionskodning
Eftersom Transformers inte har en rekurrensmekanism som RNN:er använder de positionskodningar som adderas till inbäddningarna för att tillföra information om varje tokens position i sekvensen. Detta gör att de kan förstå varje ords position i meningen.
För att göra detta föreslog forskarna att använda en kombination av olika sinus- och cosinusfunktioner för att skapa positionsvektorer, vilket möjliggör användning av denna positionskodare för meningar av valfri längd.
I detta angreppssätt representeras varje dimension av unika frekvenser och förskjutningar i vågen, med värden från -1 till 1, vilket effektivt representerar varje position.
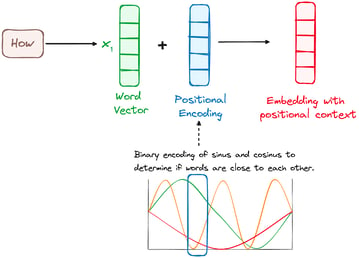
Bild av författaren. Encoderns arbetsflöde. Positionskodning.
Steg 3: Stapel av encoderlager
Transformer-encodern består av en stapel identiska lager (6 i den ursprungliga Transformer-modellen).
Encoderlagret tjänar till att omvandla alla insekvenser till en kontinuerlig, abstrakt representation som kapslar in den inlärda informationen från hela sekvensen. Detta lager består av två delmoduler:
- En multihead-attention-mekanism.
- Ett fullt kopplat nätverk.
Dessutom innehåller det residualförbindelser runt varje underlager, vilka sedan följs av lagernormalisering.
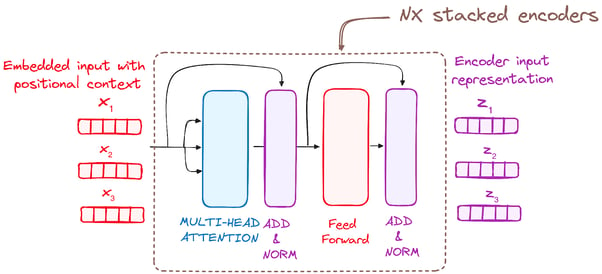
Bild av författaren. Encoderns arbetsflöde. Stapel av encoderlager
Steg 3.1: Multihead self-attention-mekanism
I encodern använder multihead-attention en specialiserad uppmärksamhetsmekanism som kallas self-attention. Detta förhållningssätt gör att modellerna kan relatera varje ord i indata till andra ord. I ett givet exempel kan modellen till exempel lära sig att koppla ordet “are” med “you”.
Denna mekanism gör att encodern kan fokusera på olika delar av insekvensen medan den bearbetar varje token. Den beräknar uppmärksamhetspoäng baserat på:
- En query är en vektor som representerar ett specifikt ord eller en token från insekvensen i uppmärksamhetsmekanismen.
- En key är också en vektor i uppmärksamhetsmekanismen och motsvarar varje ord eller token i insekvensen.
- Varje value är kopplad till en key och används för att konstruera utdata från uppmärksamhetslagret. När en query och en key matchar väl, vilket i praktiken betyder att de har en hög uppmärksamhetspoäng, betonas motsvarande value i utdata.
Denna första self-attention-modul gör att modellen kan fånga kontextuell information från hela sekvensen. I stället för att utföra en enda uppmärksamhetsfunktion projiceras queries, keys och values linjärt h gånger. På var och en av dessa projicerade versioner av queries, keys och values utförs uppmärksamhetsmekanismen parallellt, var och en producerar en utdata med dv-dimensioner (64 i den ursprungliga artikeln, där h = 8).
Den detaljerade arkitekturen ser ut som följer:
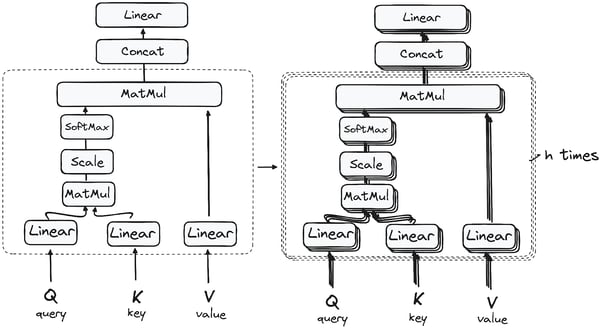
Matrismultiplikation (MatMul): skalärprodukt av query och key
När query-, key- och value-vektorerna har passerat genom ett linjärt lager utförs en matrismultiplikation (skalärprodukt) mellan queries och keys, vilket resulterar i en poängmatris.
Poängmatrisen fastställer i vilken grad varje ord ska lägga vikt vid andra ord. Varje ord tilldelas alltså en poäng i relation till andra ord inom samma tidssteg. En högre poäng indikerar större fokus.
Denna process mappar effektivt queries till deras motsvarande keys.
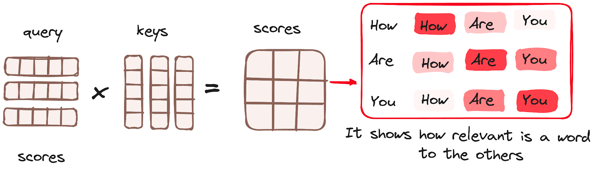
Bild av författaren. Encoderns arbetsflöde. Uppmärksamhetsmekanism – matrismultiplikation.
Reducerar storleken på uppmärksamhetspoängen
Poängen skalas sedan ned genom att divideras med kvadratroten av dimensionen för query- och key-vektorerna. Detta steg implementeras för att säkerställa mer stabila gradienter, eftersom multiplikation av värden kan ge alltför stora effekter.
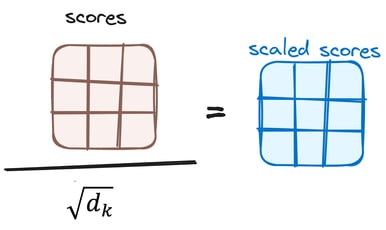
Bild av författaren. Encoderns arbetsflöde. Reducera uppmärksamhetspoäng.
Tillämpa softmax på de justerade poängen
Därefter tillämpas en softmax-funktion på de justerade poängen för att få uppmärksamhetsvikter. Detta ger sannolikhetsvärden mellan 0 och 1. Softmax-funktionen betonar högre poäng samtidigt som den minskar lägre poäng, vilket förbättrar modellens förmåga att effektivt avgöra vilka ord som ska få mer uppmärksamhet.
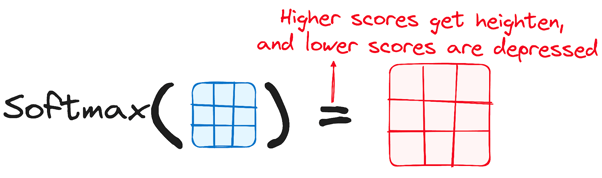
Bild av författaren. Encoderns arbetsflöde. Softmax-justerade poäng.
Kombinera softmax-resultat med value-vektorn
Nästa steg i uppmärksamhetsmekanismen är att vikter härledda från softmax-funktionen multipliceras med value-vektorn, vilket resulterar i en utdata-vektor.
Ord med höga softmax-vikter dominerar resultatet, medan ord med vikter nära 0 bidrar med nästan ingenting. Slutligen matas denna utdata-vektor in i ett linjärt lager för vidare bearbetning.
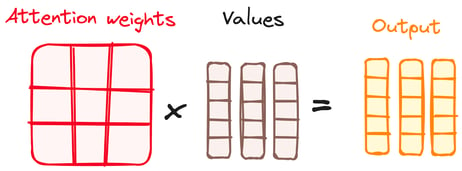
Bild av författaren. Encoderns arbetsflöde. Kombinera softmax-resultat med value-vektorn.
Och vi får till slut utdata från uppmärksamhetsmekanismen!
Ordet “multihead” kommer av att denna process körs flera gånger parallellt. Innan attention startar delas queries, keys och values upp i h mindre uppsättningar som kallas huvuden (heads), och varje huvud kör stegen ovan på sin egen delmängd.
Huvudenas utdata konkateneras och passerar genom ett sista linjärt lager. Eftersom varje huvud lär sig sina egna projektioner kan olika huvuden fånga olika relationer, såsom vilket substantiv ett pronomen syftar på eller vilka ord som sitter bredvid varandra.
För en djupare förståelse av uppmärksamhetsmekanismen, se vår handledning om multihead-attention i Transformers.
Steg 3.2: Normalisering och residualförbindelser
Varje underlager i ett encoderlager följs av ett normaliseringssteg. Dessutom adderas varje underlagers utdata till dess indata (residualförbindelse) för att hjälpa till att mildra problemet med försvinnande gradienter, vilket möjliggör djupare modeller. Denna process upprepas även efter det feed-forward-neuronala nätverket.
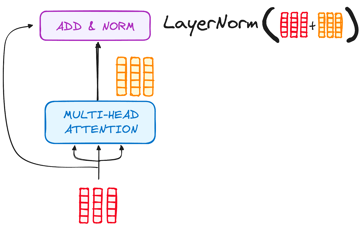
Bild av författaren. Encoderns arbetsflöde. Normalisering och residualförbindelse efter multihead-attention.
Steg 3.3: Feed-forward-neuronalt nätverk
Därefter passerar utdata genom ett positionsvis feed-forward-nätverk: två linjära lager med en ReLU-aktivering emellan, applicerat på varje token separat. I den ursprungliga artikeln har det inre lagret 2 048 dimensioner, fyra gånger modellbredden 512.
Liksom för attention adderas nätverkets indata tillbaka till dess utdata (en residualförbindelse), och resultatet normaliseras.
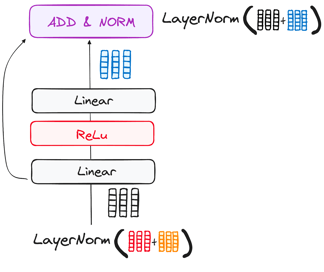
Bild av författaren. Encoderns arbetsflöde. Delager med feed-forward-neuronalt nätverk.
Steg 4: Encoderns utdata
Utdatat från det sista encoderlagret är en uppsättning vektorer, som var och en representerar insekvensen med en rik kontextuell förståelse. Detta utdata används sedan som indata till decodern i en Transformer-modell.
Denna noggranna kodning banar väg för decodern och vägleder den att uppmärksamma rätt ord i indata när det är dags att avkoda.
Att stapla N encoderlager låter varje lager bygga vidare på representationerna från lagret under. Originalmodellen använde N = 6; BERT‑Base använder 12 och BERT‑Large 24.
Hur fungerar Transformer-decodern?
Decodern genererar utsekvensen. Dess lager speglar encoderns med ett tillägg: varje lager har två sublager för multihead-attention i stället för ett, följt av ett positionsvis feed-forward-nätverk, med en residualförbindelse och lagernormalisering runt varje underlager.
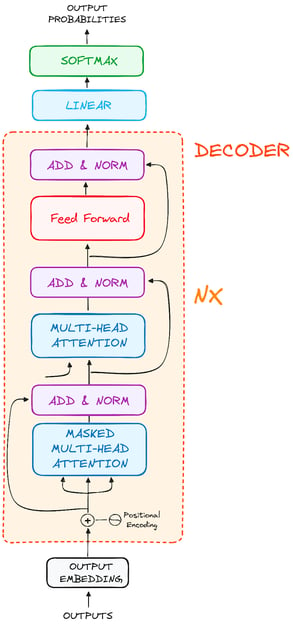
Bild av författaren. Global struktur för Decoders.
Dessa komponenter fungerar på ett liknande sätt som encoderns lager, men med en twist: varje multihead-attention-lager i decodern har sin unika uppgift.
Decoderns process avslutas med ett linjärt lager som fungerar som en klassificerare, toppat med en softmax-funktion för att beräkna sannolikheter för olika ord.
Transformer-decodern har en struktur specifikt utformad för att generera denna utdata genom att avkoda den encoderade informationen steg för steg.
Decodern arbetar autoregressivt: den börjar med en start-av-sekvens-token och tar vid varje steg de tokens den hittills har genererat som indata, tillsammans med encoderns utdata.
Den slutar när den genererar en slut-av-sekvens-token.
Steg 1: Inbäddningar av utdata
Vid decoderns start liknar processen den i encodern. Här passerar indata först genom ett inbäddningslager.
Steg 2: Positionskodning
Efter inbäddningen, precis som i encodern, passerar indata genom positionskodningslagret. Denna sekvens är utformad för att producera positionsinbäddningar.
Dessa positionsinbäddningar går sedan in i decoderns första multihead-attention-lager, där uppmärksamhetspoängen för decoderns egna indata beräknas.
Steg 3: Stapel av decoderlager
Decodern består av en stapel identiska lager (6 i den ursprungliga Transformer-modellen). Varje lager har tre huvudsakliga delkomponenter:
Steg 3.1: Maskerad self-attention-mekanism
Detta liknar self-attention-mekanismen i encodern men med en avgörande skillnad: den förhindrar positioner från att uppmärksamma efterföljande positioner, vilket innebär att varje ord i sekvensen inte påverkas av framtida tokens.
Till exempel, när uppmärksamhetspoängen för ordet “Cómo” beräknas, är det viktigt att “Cómo” inte får tjuvkika på “estás”, som är ett efterföljande ord i utsekvensen.
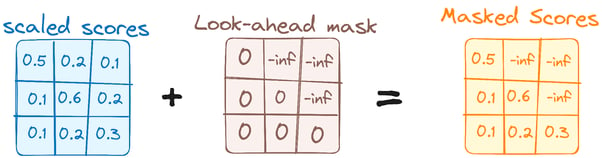
Bild av författaren. Decoderns arbetsflöde. Första multihead-attention-masken.
Denna maskning säkerställer att förutsägelserna för en viss position bara kan bero på kända utdata vid positioner före den.
Steg 3.2: Encoder–decoder-attention (cross-attention)
Det andra uppmärksamhetssublagret kopplar decodern till encodern. Här kommer queries från decoderns maskerande self-attention-utdata, medan keys och values kommer från encoderns slutliga utdata.
Detta gör att varje position i decodern kan uppmärksamma alla positioner i inmeningen, så när “estás” genereras kan decodern fokusera på “are you”. Resultatet går sedan genom feed-forward-sublagret.
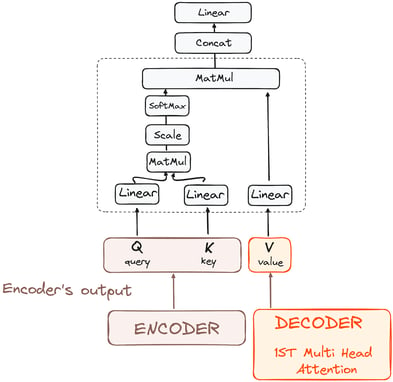
Bild av författaren. Decoderns arbetsflöde. Encoder–decoder-attention.
Steg 3.3: Feed-forward-neuronalt nätverk
Likt encodern innehåller varje decoderlager ett fullt kopplat feed-forward-nätverk, applicerat separat och identiskt på varje position.
Steg 4: Linjär klassificerare och softmax
Datans resa genom transformermodellen kulminerar i att den passerar genom ett sista linjärt lager, som fungerar som en klassificerare.
Storleken på denna klassificerare motsvarar det totala antalet klasser (antal ord i vokabulären). I ett scenario med 1 000 distinkta klasser som representerar 1 000 olika ord kommer till exempel klassificerarens utdata att vara en vektor med 1 000 element.
Detta utdata matas sedan in i ett softmax-lager, som omvandlar det till ett intervall av sannolikhetspoäng mellan 0 och 1. Token med högst sannolikhet är modellens bästa gissning för nästa ord. Girig avkodning väljer alltid den; de flesta chattmodeller samplar i stället från fördelningen, med en temperaturinställning som styr hur mycket slump som tillåts.
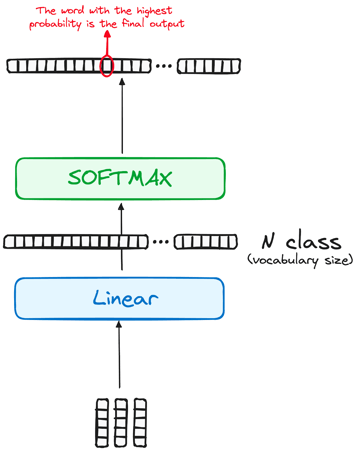
Bild av författaren. Decoderns arbetsflöde. Transformerns slutliga utdata.
Normalisering och residualförbindelser
Varje underlager (maskerad self-attention, encoder–decoder-attention, feed-forward-nätverk) följs av ett normaliseringssteg, och varje inkluderar också en residualförbindelse runt sig.
Decoderns utdata
Det sista lagrets utdata omvandlas till en förutsagd sekvens, vanligtvis via ett linjärt lager följt av en softmax för att generera sannolikheter över vokabulären.
Decodern, i sitt arbetsflöde, införlivar det nyskapade utdatat i sin växande lista av indata och fortsätter sedan avkodningsprocessen. Denna cykel upprepas tills modellen förutspår en specifik token som signalerar att det är klart.
Liksom encodern är decodern en stapel av N identiska lager (6 i originalmodellen), som var och en bygger på utdatat från lagret under och på encoderns utdata. Djupare staplar låter olika lager och huvuden fånga olika uppmärksamhetsmönster.
Den slutliga arkitekturen ser ut så här (från originalartikeln):
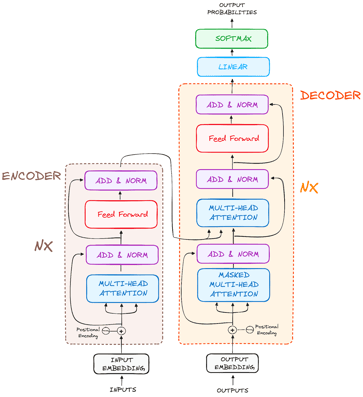
Bild av författaren. Originalstruktur för Transformers.
För att bättre förstå denna arkitektur rekommenderar jag att du försöker tillämpa en Transformer från grunden genom att följa denna handledning för att bygga en transformer med PyTorch.
Endast encoder, endast decoder och encoder–decoder-transformers
Transformermodeller faller i tre familjer, beroende på vilken halva av den ursprungliga arkitekturen de behåller. Valet avgör vad en modell är bra på: encoders läser, decoders skriver och encoder–decoders avbildar en sekvens på en annan.
| Familj | Vad den behåller | Attention | Förträningsuppgift | Typiska användningar | Exempel |
|---|---|---|---|---|---|
| Endast encoder | Encoderstapel | Bidirektionell: varje token ser varje token | Fyll i maskerande tokens | Klassificering, sökinbäddningar, namngiven entitetsigenkänning | BERT, RoBERTa |
| Endast decoder | Decoderstapel, utan cross-attention | Kausal: varje token ser bara tidigare tokens | Förutsäg nästa token | Chatt, kodgenerering, agenter | GPT‑3, Llama, Gemini |
| Encoder–decoder | Båda staplarna | Bidirektionell encoder, kausal decoder, plus cross-attention | Avbilda en insekvens till en utsekvens | Översättning, summering, taligenkänning | Ursprunglig Transformer, T5, Whisper |
De flesta LLM:er som släppts sedan GPT‑3 är endast decoders. Förutsägelse av nästa token fungerar på vilken råtext som helst, så träningsdata är riklig, och en modell kan hantera översättning, summering och frågesvar genom att behandla var och en som textfortsättning.
Vilka modeller använder transformerarkitekturen?
BERT
BERT (Bidirectional Encoder Representations from Transformers), släppt som öppen källkod av Google 2018, är en transformer som bara har encoder. I stället för att förutsäga nästa ord förtränades den att fylla i maskerande ord med hjälp av kontext på båda sidor, vilket gjorde den starkare på förståelseuppgifter än dåtidens vänster-till-höger-modeller.
Genom att förstå kontext från alla sidor av ett ord överträffade BERT tidigare modeller i uppgifter som frågesvar och förståelse av tvetydigt språk. Dess kärna använder Transformers och kopplar dynamiskt varje ut- och indatatum.
BERT förtränades på engelska Wikipedia och BooksCorpus-datasettet, och Google lade till den i Sök 2019 för att bättre tolka frågor i naturligt språk. Den startade en kapplöpning om att bygga större förtränade språkmodeller.
För att veta mer om BERT kan du läsa vår separata artikel som introducerar BERT-modellen.
LaMDA
LaMDA (Language Model for Dialogue Applications) är en Transformer-baserad modell utvecklad av Google, specifikt utformad för konversationsuppgifter, lanserad under Google I/O 2021. De är designade för att generera mer naturliga och kontextuellt relevanta svar, vilket förbättrar användarinteraktioner i olika applikationer.
LaMDA:s design gör att den kan förstå och svara på ett brett spektrum av ämnen och användaravsikter, vilket gör den idealisk för tillämpningar i chatbots, virtuella assistenter och andra interaktiva AI-system där en dynamisk konversation är nyckeln.
Google ersatte senare LaMDA i sin Bard‑chattbot med PaLM 2 och sedan Gemini, men LaMDA var en av de första transformermodellerna som tränades specifikt på dialog.
Om du är intresserad av att förstå LaMDA-modellerna bättre kan du få en djupare förståelse med vår artikel om LaMDA.
GPT och ChatGPT
GPT och ChatGPT, utvecklade av OpenAI, är avancerade generativa modeller kända för sin förmåga att producera sammanhängande och kontextuellt relevanta texter. GPT‑1 var den första modellen, lanserad i juni 2018, och GPT‑3, en av de mest inflytelserika modellerna, lanserades två år senare 2020.
Dessa modeller behärskar ett brett spektrum av uppgifter, inklusive innehållsskapande, konversation, språköversättning och mer. GPT:s arkitektur möjliggör textgenerering som nära liknar mänskligt skrivande, vilket gör den användbar i tillämpningar som kreativt skrivande, kundsupport och till och med kodningsassistans. ChatGPT, en variant optimerad för kontext i konversationer, utmärker sig i att generera människolik dialog, vilket stärker dess användning i chatbots och virtuella assistenter.
OpenAI slutade publicera arkitekturdetaljer efter GPT‑3 (förutom deras open-weight‑modeller gpt-oss), men familjen har fortsatt växa, senast med GPT‑6 Astra 2026.
Claude
Claude, utvecklad av Anthropic, är en familj av Transformer-baserade AI-assistenter utformade med fokus på säkerhet och hjälpsamhet. Claude använder Constitutional AI (CAI), ett träningsangreppssätt där modellen vägleds av en uppsättning principer för att producera hjälpsamma, ofarliga och ärliga svar.
Claude 3 (släppt 2024) introducerade tre modelltier, Haiku, Sonnet och Opus, som erbjuder olika avvägningar mellan hastighet och kapacitet. Modellerna utmärker sig i nyanserat resonemang, att följa komplexa instruktioner och att bibehålla kontext över långa konversationer (upp till 200 K tokens).
Anthropic har släppt nya generationer varannan till var tredje månad sedan dess. Den aktuella Claude 5-serien inkluderar Claude Fable 5.1 och Claude Opus 5.5, båda släppta 2026. Liksom OpenAI publicerar Anthropic inte arkitekturdetaljer.
Andra varianter
Antalet transformermodeller har vuxit snabbt. Xavier Amatriains katalog över transformermodeller klassificerar dussintals av dem efter arkitektur och träningsmål, och Stanfords HELM-benchmark utvärderade 30 framstående språkmodeller sida vid sida.
Det finns en ökande trend mot att göra dessa modeller öppna, med plattformar som Hugging Faces model hub i spetsen. Dessutom har många Transformer-baserade modeller utvecklats, var och en specialiserad för olika NLP-uppgifter, vilket visar modellens mångsidighet och effektivitet i olika tillämpningar.
Du kan lära dig mer om alla befintliga foundation-modeller i en separat artikel som beskriver vad de är och vilka som används mest.
Hur har Transformers förändrats sedan 2017?
Sedan den ursprungliga arkitekturen 2017 har Transformers utvecklats avsevärt för att åtgärda begränsningar och utökas till nya domäner.
Hur moderna LLM:er skiljer sig från original-Transformern
Dagens open-weight‑LLM:er följer fortfarande ritningen från 2017, men nästan varje komponent har bytts ut mot en variant som tränar stabilare eller kör billigare. Meta dokumenterar de flesta av dessa ändringar i sina LLaMA- och Llama 3-artiklar:
| Komponent | Original-Transformer (2017) | Typisk open-weight‑LLM i dag |
|---|---|---|
| Arkitektur | Encoder–decoder, 6 + 6 lager | Endast decoder, 32 lager (Llama 3 8B) till 126 lager (Llama 3 405B) |
| Modellbredd | 512 | 4 096 (Llama 3 8B) till 16 384 (Llama 3 405B) |
| Positionsinformation | Fasta sinus- och cosinuskodningar adderade till inbäddningarna | Rotary position embeddings (RoPE) applicerade inne i attention |
| Normalisering | LayerNorm efter varje underlager (post-norm) | RMSNorm före varje underlager (pre-norm) |
| Feed-forward‑aktivering | ReLU | SwiGLU |
| Attention-huvuden | Multihead-attention, 8 huvuden | Grouped-query attention: flera query-huvuden delar 1 key–value-huvud (8 key–value-huvuden i Llama 3) |
| Feed-forward‑lager | Dens | Dens, eller mixture of experts (Llama 4, DeepSeek‑V3) |
Vision Transformers (ViT)
Vision Transformers tillämpar self-attention på bilder genom att dela upp dem i patchar och behandla varje patch som en token. Detta angreppssätt har visat sig mycket effektivt för bildklassificering, objektdetektering och bildgenerering och överträffar ofta traditionella CNN:er på stora dataset.
Multimodala Transformers
Moderna modeller som GPT‑5, Gemini 3 och Llama 4 bearbetar flera indatatyper (text, bilder, ljud, video) inom en enda arkitektur. Dessa multimodala Transformers använder enade inbäddningsutrymmen och cross-attention‑mekanismer för att resonera över olika modaliteter samtidigt.
Effektiva Transformers
Den kvadratiska komplexiteten hos self-attention begränsar kontextlängden. Flera innovationer adresserar detta:
- Flash Attention: Beräknar exakt attention i kakor som får plats i GPU:ns snabba on-chip‑minne, så minnesanvändningen växer linjärt med sekvenslängden i stället för kvadratiskt
- Rotary Position Embeddings (RoPE): Kodar positionsinformation genom rotationsmatriser, vilket möjliggör bättre extrapolering till längre sekvenser
- Linjära och glesa attention-varianter: Linformer och Performer approximerar attention, och Longformer begränsar de flesta tokens till ett lokalt fönster, vilket sänker kostnaden till O(n) för mycket långa dokument
- Mixture of Experts (MoE): Aktiverar bara en delmängd parametrar per token, vilket möjliggör större modeller med liknande beräkningskostnad
Transformers vs. RNN:er och CNN:er
Transformers jämförs vanligtvis med två andra byggblock i neurala nätverk: rekurrenta lager (RNN:er) och konvolutionella lager (CNN:er). Var och en passar olika typer av data.
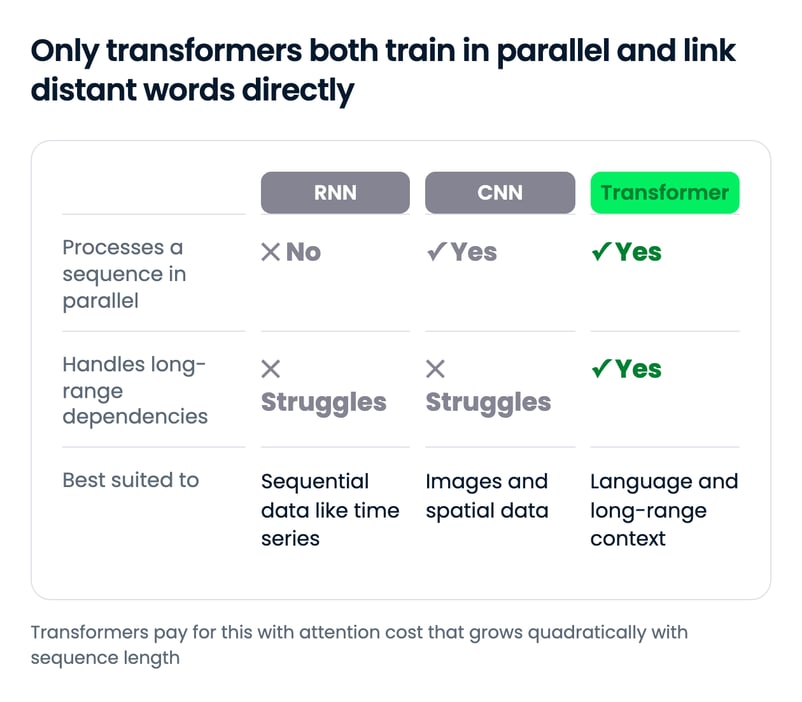
Rekurrenta lager
Rekurrenta lager, en hörnsten i rekurrenta neurala nätverk (RNN), utmärker sig i hantering av sekventiell data. Denna arkitekturs styrka ligger i dess förmåga att utföra sekventiella operationer, avgörande för uppgifter som språkbehandling eller tidsserier. I ett rekurrent lager matas utdatat från ett föregående steg tillbaka som indata till nästa steg. Denna loopmekanism gör att nätverket kan minnas tidigare information, vilket är viktigt för att förstå kontext i en sekvens.
Men som vi redan har diskuterat har denna sekventiella bearbetning två huvudsakliga konsekvenser:
- Det kan leda till längre träningstider eftersom varje steg beror på det föregående, vilket gör parallell bearbetning utmanande.
- De har ofta svårt med långsiktiga beroenden på grund av problemet med försvinnande gradienter, där nätverket blir mindre effektivt på att lära av datapunkter som ligger långt ifrån varandra i en sekvens.
Transformermodeller skiljer sig avsevärt från arkitekturer som använder rekurrenta lager eftersom de saknar rekurrens. Som vi sett adresserar Transformerns attention-lager båda problemen, vilket gör dem till den naturliga vidareutvecklingen av RNN:er för NLP‑tillämpningar.
Konvolutionella lager
Å andra sidan är konvolutionella lager, byggstenarna i konvolutionella neurala nätverk (CNN), kända för sin effektivitet i att bearbeta spatial data som bilder.
Dessa lager använder kärnor (filter) som skannar över indata för att extrahera funktioner. Bredden på dessa kärnor kan justeras, så att nätverket kan fokusera på små eller stora funktioner beroende på uppgiften.
Även om konvolutionella lager är mycket bra på att fånga spatiala hierarkier och mönster i data har de utmaningar med långsiktiga beroenden. De beaktar inte i sig själva sekventiell information, vilket gör dem mindre lämpliga för uppgifter som kräver förståelse för ordning eller kontext i en sekvens.
Det är därför CNN:er och Transformers är anpassade för olika typer av data och uppgifter. CNN:er dominerar inom datorseende tack vare sin effektivitet i att bearbeta spatial information, medan Transformers är det självklara valet för komplexa sekventiella uppgifter, särskilt inom NLP, tack vare sin förmåga att förstå långväga beroenden.
Transformers nackdelar och begränsningar
Trots sina framgångar har Transformers märkbara begränsningar:
- Kvadratisk komplexitet: Self-attention skalar som O(n²) med sekvenslängden, vilket gör mycket långa kontextfönster beräkningsmässigt dyra
- Minneskrav: Stora modeller kräver betydande GPU‑minne, vilket begränsar distributionsalternativ
- Krav på träningsdata: Transformers behöver typiskt massiva dataset för att nå stark prestanda
- Hallucination: Transformers förutspår sannolika tokens i stället för att slå upp fakta, så de kan framföra falsk information med självförtroende. Resonemangsmodeller minskar detta men tar inte bort det
- Begränsningar i positionskodning: Standardpositionskodningar har svårt att generalisera till sekvenslängder som inte setts under träning
Forskning fortsätter att adressera dessa begränsningar genom arkitektoniska innovationer som Flash Attention, mixture-of-experts och retrieval-augmented generation (RAG).
Avslutande tankar
En transformer fungerar genom att låta varje token titta på varje annan token via self-attention och sedan förädla dessa representationer genom en stapel identiska lager. Det valet gjorde träning parallell på GPU:er och löste långminnesproblemet som höll tillbaka RNN:er.
Det som slår mig mest är hur lite kärnan har ändrats. En LLM från 2026 byter ut positionskodning, normalisering och attention-huvuden mot billigare varianter, men du skulle fortfarande känna igen 2017 års diagram i den. Den öppna frågan är om state space‑modeller och hybrider kommer att ta över långa kontexter, eller om kärnor som FlashAttention håller attentions kvadratiska kostnad hanterbar.
För att omsätta detta i praktik, bygg en Transformer med PyTorch i vår steg‑för‑steg‑handledning, eller börja med förtränade modeller i vår introduktion till Transformers och Hugging Face. Om du vill lära dig mer rekommenderar jag kursen Transformer Models with PyTorch, eller spåret Developing Large Language Models för hela vägen.
FAQs
Hur fungerar transformerarkitekturen?
En transformer delar upp text i tokens, gör om varje token till en inbäddning och lägger till positionsinformation. En stapel av lager tillämpar sedan multihead self-attention, som låter varje token väga varje annan token, följt av ett feed-forward-nätverk, med residualförbindelser och normalisering runt varje steg. Ett sista linjärt lager och softmax producerar sannolikheter för nästa token.
Vad är skillnaden mellan endast-encoder, endast-decoder och encoder–decoder-transformers?
Endast-encoder-modeller som BERT läser hela indata bidirektionellt och passar för klassificering och sökning. Endast-decoder-modeller som GPT och Llama ser bara tidigare tokens och tränas att förutsäga nästa, vilket gör dem till standarddesignen för chatt‑LLM:er. Encoder–decoder-modeller som T5 och den ursprungliga Transformern avbildar en insekvens till en utsekvens, som vid översättning.
Varför ersatte transformers RNN:er och LSTM:er?
RNN:er och LSTM:er bearbetar tokens en i taget, vilket gör träning långsam på GPU:er och gör att information bleknar över långa sekvenser. Self-attention kopplar varje token direkt till varje annan och bearbetar hela sekvensen parallellt, så transformers tränar snabbare och hanterar långväga beroenden bättre.
Är ChatGPT en transformer?
Ja. GPT står för Generative Pre-trained Transformer, och GPT-modellerna bakom ChatGPT är endast-decoder-transformers tränade att förutsäga nästa token. OpenAI har inte publicerat arkitekturdetaljer sedan GPT‑3, men varje GPT‑modell bygger på transformerdesignen.
Vilka är de främsta begränsningarna hos transformers?
Kostnaden för self-attention växer kvadratiskt med sekvenslängden, så långa kontextfönster är dyra i beräkning och minne. Transformers behöver också stora träningsdataset och kan hallucinerar, det vill säga framföra falsk information självsäkert. Tekniker som FlashAttention, grouped-query attention, mixture of experts och hybrider med state space‑modeller siktar på dessa kostnader.
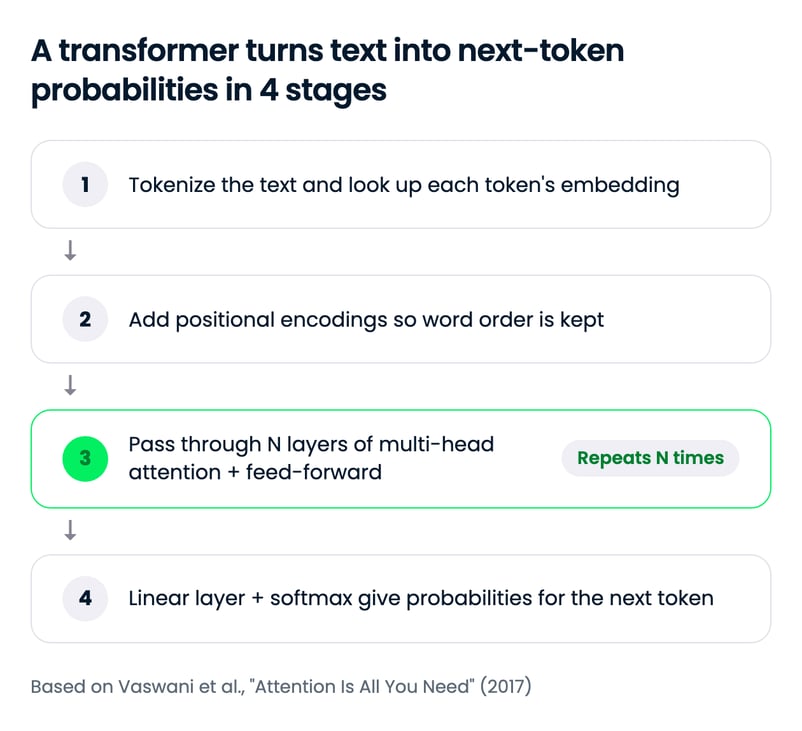
En transformer är ett neuralt nätverk som läser varje token i en sekvens på en gång och använder self-attention för att avgöra hur mycket varje token ska hämta från varje annan token. Google-forskare introducerade den i 2017 års artikel “Attention Is All You Need”, och den ligger nu till grund för nästan alla stora språkmodeller (LLM), från GPT och Llama till Gemini.
Arkitekturen fungerar i fyra steg. Text delas upp i tokens och mappas till inbäddningar, positionsinformation läggs till, en stapel av lager växlar mellan multihead self-attention och feed-forward-nätverk (varje inneslutet i en residualförbindelse och normalisering), och ett sista linjärt lager med softmax gör om den sista vektorn till sannolikheter över vokabulären. Den ursprungliga modellen parade en encoder med en decoder; de flesta LLM:er i dag behåller bara decodern.
I den här genomgången går jag igenom varje steg i den ursprungliga encoder–decoder-designen och visar sedan hur BERT, GPT och dagens LLM:er har ändrat den. Om du vill ha intuitionen först, läs våra förklaringar av uppmärksamhetsmekanismen och self-attention.
TL;DR