

ทรานส์ฟอร์เมอร์คืออะไร?
ทรานส์ฟอร์เมอร์ถูกพัฒนาขึ้นครั้งแรกเพื่อแก้ปัญหา sequence transduction หรือการแปลภาษาด้วยโครงข่ายประสาท (neural machine translation) กล่าวคือ ถูกออกแบบให้แก้โจทย์ที่แปลงลำดับอินพุตไปเป็นลำดับเอาต์พุตทุกรูปแบบ นี่จึงเป็นเหตุผลที่เรียกว่า “Transformers”
แต่เริ่มจากพื้นฐานกันก่อน
คำนิยามแบบง่าย
โมเดลทรานส์ฟอร์เมอร์คือโครงข่ายประสาทที่เรียนรู้บริบทของข้อมูลเชิงลำดับ และสร้างข้อมูลใหม่จากสิ่งนั้น
พูดให้เข้าใจง่าย:
ทรานส์ฟอร์เมอร์เป็นโมเดลปัญญาประดิษฐ์ประเภทหนึ่งที่เรียนรู้การทำความเข้าใจและสร้างข้อความคล้ายมนุษย์ โดยวิเคราะห์รูปแบบจากข้อมูลข้อความจำนวนมาก
ทรานส์ฟอร์เมอร์เป็นโมเดล NLP ระดับแนวหน้าปัจจุบัน และถือเป็นวิวัฒนาการของสถาปัตยกรรมตัวเข้ารหัส–ตัวถอดรหัส อย่างไรก็ดี ในขณะที่สถาปัตยกรรมตัวเข้ารหัส–ตัวถอดรหัสเดิมพึ่งพาโครงข่ายประสาทแบบวนซ้ำ (RNN) ในการดึงข้อมูลลำดับ ทรานส์ฟอร์เมอร์กลับตัดการวนซ้ำออกโดยสิ้นเชิง
แล้วทำอย่างไร?
โมเดลนี้ถูกออกแบบมาเพื่อเข้าใจบริบทและความหมาย โดยวิเคราะห์ความสัมพันธ์ระหว่างองค์ประกอบต่างๆ และแทบทั้งหมดอาศัยเทคนิคเชิงคณิตศาสตร์ที่เรียกว่า attention
ภาพโดยผู้เขียน
บริบททางประวัติศาสตร์
ทรานส์ฟอร์เมอร์ถูกแนะนำโดยนักวิจัยของ Google ในงานวิจัยปี 2017 "Attention is All You Need" โค้ดถูกปล่อยในแพ็กเกจ Tensor2Tensor ของ TensorFlow และกลุ่ม Harvard NLP ตามมาด้วยคู่มือประกอบคำอธิบายงานวิจัยใน PyTorch นอกจากนี้ยังเรียนรู้ได้ว่าจะสร้าง Transformer ตั้งแต่ศูนย์อย่างไรในบทเรียนแยกของเรา
ภายในหนึ่งปี BERT ของ Google และ GPT-1 ของ OpenAI แสดงให้เห็นว่าโมเดลทรานส์ฟอร์เมอร์ที่พรีเทรนบนข้อความที่ไม่มีป้ายกำกับสามารถฟाइनจูนให้ทำงานภาษาเกือบทุกงานได้ GPT-3 ตามมาในปี 2020 และนักวิจัยจากสแตนฟอร์ดบัญญัติคำว่า “foundation models” ให้กับคลาสโมเดลใหม่นี้
หลังจากนั้นทุกอย่างพัฒนาเร็ว: โมเดลเปิดน้ำหนักอย่าง Llama ของ Meta (2023), โมเดลมัลติโหมดอย่าง GPT-4o (2024), โมเดลให้เหตุผลอย่าง o1 ของ OpenAI และ DeepSeek-R1 (ปลาย 2024 ถึงต้น 2025), และโมเดลเชิงตัวแทนอย่าง GPT-5 (2025) และ GPT-6 Astra (2026) โมเดลที่เปิดเผยดีไซน์ล้วนยังคงเป็นทรานส์ฟอร์เมอร์ ทั้งเรื่องราวติดตามได้ใน ประวัติศาสตร์ของโมเดลภาษาขนาดใหญ่ของเรา
การเปลี่ยนจาก RNN สู่ทรานส์ฟอร์เมอร์
เมื่อทรานส์ฟอร์เมอร์ถูกนำเสนอ โครงข่ายประสาทแบบวนซ้ำ (RNN) และตัวแปร long short-term memory (LSTM) เป็นโมเดลหลักสำหรับข้อมูลเชิงลำดับ พวกมันประมวลผลอินพุตทีละองค์ประกอบ ซึ่งทำให้เกิดปัญหาใหญ่สองข้อ:
- ฝึกช้า: แต่ละก้าวต้องรอขั้นก่อนหน้า ทำให้ RNN ใช้งานการคำนวณแบบขนานบน GPU ได้ไม่เต็มที่
- ลืมเมื่อระยะไกล: ข้อมูลถูกส่งต่อทีละก้าว ยิ่งโซ่ยาวเท่าไร โอกาสสูญหายยิ่งสูง
ทรานส์ฟอร์เมอร์เก็บแนวคิดตัวเข้ารหัส–ตัวถอดรหัสจาก RNN แต่แทนที่การวนซ้ำด้วย attention ซึ่งแก้ทั้งสองปัญหา: ทุกคำสามารถ “มอง” คำอื่นได้โดยตรงไม่ว่าห่างกันแค่ไหน และทั้งลำดับถูกประมวลผลแบบขนาน
ต่อไป มาดูการทำงานของทรานส์ฟอร์เมอร์
สถาปัตยกรรม Transformer ทำงานอย่างไร?
เดิมถูกออกแบบมาสำหรับ sequence transduction หรือการแปลภาษาด้วยโครงข่ายประสาท ทรานส์ฟอร์เมอร์โดดเด่นในการแปลงลำดับอินพุตเป็นลำดับเอาต์พุต เป็นโมเดล transduction แรกที่พึ่งพา self-attention อย่างเต็มรูปแบบเพื่อคำนวณตัวแทนของอินพุตและเอาต์พุต โดยไม่ใช้ RNN แบบเรียงลำดับหรือคอนโวลูชัน แกนหลักของสถาปัตยกรรมทรานส์ฟอร์เมอร์คือยังคงรูปแบบตัวเข้ารหัส–ตัวถอดรหัส
หากมอง Transformer สำหรับการแปลภาษาเป็นกล่องดำง่ายๆ มันจะรับประโยคภาษาอังกฤษเป็นอินพุต และส่งออกคำแปลเป็นภาษาสเปน
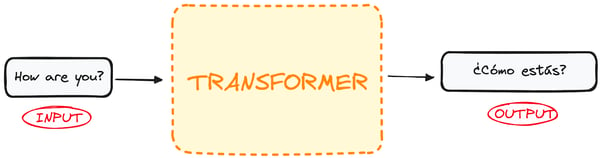
ภาพโดยผู้เขียน
หากเจาะลึกลงไป จะเห็นว่ากล่องดำนี้ประกอบด้วยสองส่วนหลัก:
- ตัวเข้ารหัสรับอินพุตและส่งออกตัวแทนแบบเมทริกซ์ของอินพุตนั้น เช่น ประโยคภาษาอังกฤษ “How are you?”
- ตัวถอดรหัสรับตัวแทนที่ถูกเข้ารหัสนั้นและสร้างเอาต์พุตแบบวนซ้ำ ทีละขั้น ในตัวอย่างคือประโยคแปล “¿Cómo estás?”
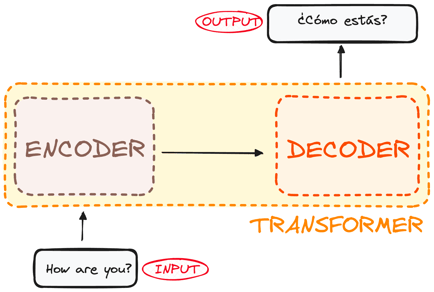
ภาพโดยผู้เขียน โครงสร้างภาพรวมของตัวเข้ารหัส–ตัวถอดรหัส
อย่างไรก็ตาม ทั้งตัวเข้ารหัสและตัวถอดรหัสจริงๆ แล้วเป็นสแต็กหลายเลเยอร์ (จำนวนเท่ากัน) ตัวเข้ารหัสทั้งหมดมีโครงสร้างเดียวกัน อินพุตไหลผ่านแต่ละตัวและส่งต่อไปยังตัวถัดไป ตัวถอดรหัสทั้งหมดก็มีโครงสร้างเดียวกัน โดยรับอินพุตจากตัวเข้ารหัสสุดท้ายและตัวถอดรหัสก่อนหน้า
สถาปัตยกรรมดั้งเดิมประกอบด้วยตัวเข้ารหัส 6 ตัวและตัวถอดรหัส 6 ตัว แต่สามารถทำซ้ำเป็นหลายเลเยอร์ได้ตามต้องการ ดังนั้นสมมติว่ามี N เลเยอร์ของแต่ละฝั่ง
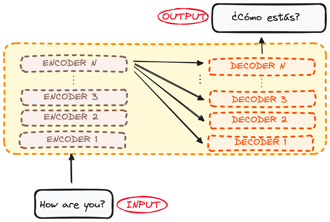
ภาพโดยผู้เขียน โครงสร้างภาพรวมของตัวเข้ารหัส–ตัวถอดรหัส หลายเลเยอร์
เมื่อมีภาพรวมของสถาปัตยกรรม Transformer แล้ว มาจดจ่อกับตัวเข้ารหัสและตัวถอดรหัสเพื่อเข้าใจลำดับการทำงานให้ชัดขึ้น:
ตัวเข้ารหัสของ Transformer ทำงานอย่างไร?
ตัวเข้ารหัสเป็นองค์ประกอบพื้นฐานของสถาปัตยกรรม Transformer หน้าที่หลักของตัวเข้ารหัสคือแปลงโทเคนอินพุตให้เป็นตัวแทนที่มีบริบท แตกต่างจากโมเดลยุคก่อนที่ประมวลผลโทเคนอย่างอิสระ ตัวเข้ารหัสของ Transformer จับบริบทของแต่ละโทเคนเทียบกับลำดับทั้งหมด
โครงสร้างประกอบดังนี้:
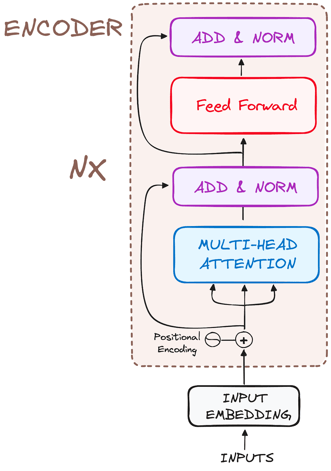
ภาพโดยผู้เขียน โครงสร้างภาพรวมของตัวเข้ารหัส
มาแยกลำดับงานเป็นขั้นพื้นฐานที่สุด:
ขั้นที่ 1: เอ็มเบดดิ้งของอินพุต
การทำเอ็มเบดดิ้งเกิดขึ้นเฉพาะในตัวเข้ารหัสล่างสุด ขั้นแรก ตัวตัดคำจะแยกข้อความเป็น โทเคน ซึ่งเป็นคำหรือส่วนของคำ และแต่ละโทเคนถูกแมปเป็นเวกเตอร์ที่เรียนรู้ได้ เรียกว่าเอ็มเบดดิ้ง โทเคนที่มีความหมายเกี่ยวข้องกันจะได้เวกเตอร์คล้ายกัน
ตัวเข้ารหัสทั้งหมดรับรายชื่อเวกเตอร์ที่แต่ละตัวมีมิติ 512 ตามงานต้นฉบับ (dmodel = 512) ในตัวเข้ารหัสล่างสุดจะเป็นเวกเตอร์คำ แต่ในตัวเข้ารหัสอื่นๆ จะเป็นเอาต์พุตของตัวเข้ารหัสที่อยู่ถัดลงมา
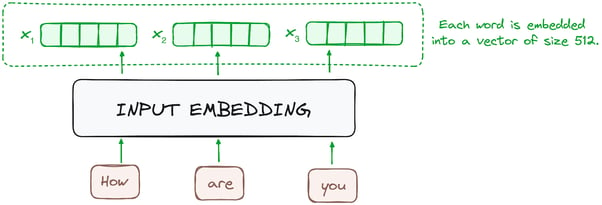
ภาพโดยผู้เขียน ลำดับงานของตัวเข้ารหัส: Input embedding
ขั้นที่ 2: การเข้ารหัสตำแหน่ง
เนื่องจากทรานส์ฟอร์เมอร์ไม่มีกลไกการวนซ้ำแบบ RNN จึงใช้positional encodings ที่บวกเข้ากับ embeddings ของอินพุตเพื่อบอกตำแหน่งของแต่ละโทเคนในลำดับ ช่วยให้เข้าใจตำแหน่งของคำภายในประโยค
นักวิจัยเสนอให้ใช้ส่วนผสมของฟังก์ชันไซน์และโคไซน์หลายความถี่เพื่อสร้างเวกเตอร์ตำแหน่ง ทำให้ใช้ positional encoder กับประโยคที่ยาวเท่าใดก็ได้
ในแนวทางนี้ แต่ละมิติมีความถี่และระยะเลื่อนของคลื่นเฉพาะ ค่าจะอยู่ระหว่าง -1 ถึง 1 เป็นตัวแทนของแต่ละตำแหน่งได้อย่างมีประสิทธิภาพ
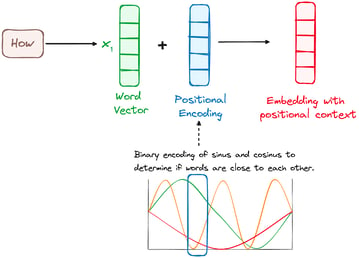
ภาพโดยผู้เขียน ลำดับงานของตัวเข้ารหัส: Positional encoding
ขั้นที่ 3: สแต็กของเลเยอร์ตัวเข้ารหัส
ตัวเข้ารหัสของ Transformer ประกอบด้วยสแต็กของเลเยอร์ที่เหมือนกัน (6 เลเยอร์ในโมเดลต้นฉบับ)
เลเยอร์ของตัวเข้ารหัสทำหน้าที่แปลงลำดับอินพุตทั้งหมดเป็นตัวแทนแบบต่อเนื่องเชิงนามธรรมที่สรุปความรู้จากทั้งลำดับ เลเยอร์นี้ประกอบด้วยสองซับโมดูล:
- กลไก attention แบบหลายหัว (multi-head)
- เครือข่ายเชื่อมต่อเต็ม (fully connected)
นอกจากนี้ยังมีการทำ residual connections รอบแต่ละซับเลเยอร์ ตามด้วยการปรับให้เป็นปกติของเลเยอร์
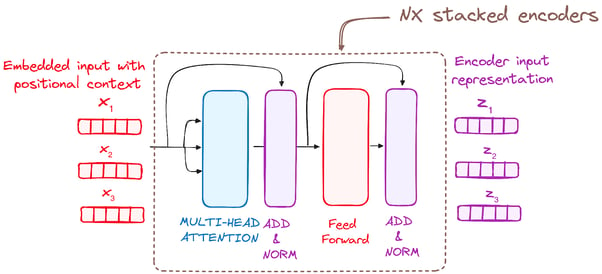
ภาพโดยผู้เขียน ลำดับงานของตัวเข้ารหัส: สแต็กของเลเยอร์ตัวเข้ารหัส
ขั้นที่ 3.1: กลไก multi-head self-attention
ในตัวเข้ารหัส multi-head attention ใช้กลไก attention แบบเฉพาะที่เรียกว่า self-attention วิธีนี้ช่วยให้โมเดลเชื่อมโยงคำแต่ละคำในอินพุตเข้าหากัน ตัวอย่างเช่น โมเดลอาจเรียนรู้การเชื่อมคำ “are” กับ “you”
กลไกนี้ช่วยให้ตัวเข้ารหัสโฟกัสส่วนต่างๆ ของลำดับอินพุตขณะประมวลผลแต่ละโทเคน โดยคำนวณคะแนน attention จาก:
- Query คือเวกเตอร์ที่แทนคำหรือโทเคนเฉพาะจากลำดับอินพุตในกลไก attention
- Key ก็เป็นเวกเตอร์ในกลไก attention เช่นกัน สัมพันธ์กับแต่ละคำหรือโทเคนในลำดับอินพุต
- Value แต่ละตัวเชื่อมกับ key และใช้สร้างเอาต์พุตของเลเยอร์ attention เมื่อ query และ key เข้าคู่กันได้ดี (มีคะแนน attention สูง) value ที่สอดคล้องกันจะถูกเน้นในเอาต์พุต
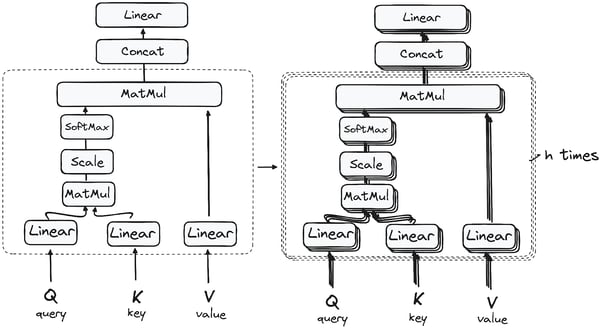
โมดูล Self-Attention แรกนี้ช่วยให้โมเดลจับข้อมูลบริบทจากทั้งลำดับ แทนที่จะทำ attention ครั้งเดียว queries, keys และ values จะถูกฉายเชิงเส้น (linear projection) เป็น h ครั้ง บนแต่ละเวอร์ชันที่ฉายแล้วนี้ จะทำ attention แบบขนาน โดยแต่ละครั้งให้เอาต์พุตมิติ dv (64 ในงานต้นฉบับที่ h = 8)
สถาปัตยกรรมโดยละเอียดเป็นดังนี้:
การคูณเมทริกซ์ (MatMul): ดอทโปรดักต์ของ query และ key
เมื่อเวกเตอร์ query, key และ value ผ่านเลเยอร์เชิงเส้นแล้ว จะทำการคูณเมทริกซ์แบบดอทโปรดักต์ระหว่าง queries และ keys ทำให้ได้เมทริกซ์คะแนน (score matrix)
เมทริกซ์คะแนนกำหนดระดับการเน้นที่แต่ละคำควรให้กับคำอื่นๆ คำแต่ละคำจึงได้รับคะแนนสัมพันธ์กับคำอื่นๆ ในขั้นเวลาเดียวกัน คะแนนสูงหมายถึงให้ความสนใจมาก
กระบวนการนี้เป็นการแมป queries เข้ากับ keys ที่สอดคล้องกันโดยมีประสิทธิผล
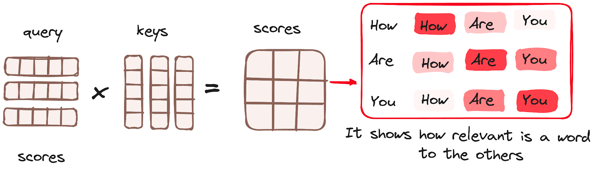
ภาพโดยผู้เขียน ลำดับงานของตัวเข้ารหัส: กลไก Attention - การคูณเมทริกซ์
ลดขนาดของคะแนน attention
จากนั้นนำคะแนนมาหารด้วยรากที่สองของมิติของเวกเตอร์ query และ key เพื่อลดสเกล ขั้นตอนนี้ช่วยให้กราดิเอนต์เสถียรมากขึ้น เพราะการคูณค่าต่างๆ อาจทำให้ผลกระทบใหญ่เกินไป
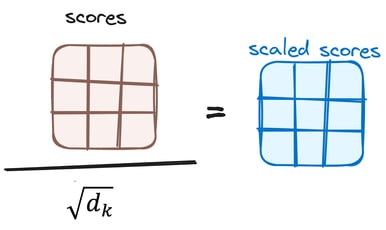
ภาพโดยผู้เขียน ลำดับงานของตัวเข้ารหัส: ลดคะแนน attention
ใช้ softmax กับคะแนนที่ปรับแล้ว
ต่อจากนั้นใช้ฟังก์ชัน softmax กับคะแนนที่ปรับแล้วเพื่อได้ค่าน้ำหนัก attention เป็นความน่าจะเป็นตั้งแต่ 0 ถึง 1 softmax จะเน้นคะแนนสูงและลดคะแนนต่ำ ช่วยให้โมเดลตัดสินได้ดีขึ้นว่าคำใดควรได้รับความสนใจมากกว่า
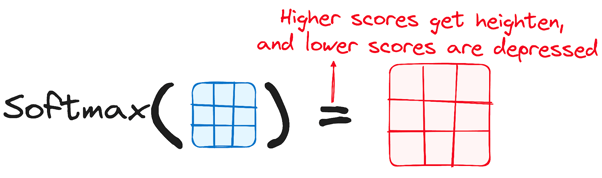
ภาพโดยผู้เขียน ลำดับงานของตัวเข้ารหัส: Softmax กับคะแนนที่ปรับแล้ว
ผสานผลลัพธ์ softmax กับเวกเตอร์ value
ขั้นต่อไปของกลไก attention คือค่าน้ำหนักที่ได้จาก softmax คูณกับเวกเตอร์ value ให้ได้เวกเตอร์เอาต์พุต
คำที่มีน้ำหนัก softmax สูงจะครอบงำผลลัพธ์ ขณะที่ค่าน้ำหนักใกล้ 0 แทบไม่มีผล สุดท้ายเวกเตอร์เอาต์พุตนี้จะถูกป้อนเข้าเลเยอร์เชิงเส้นเพื่อประมวลผลต่อ
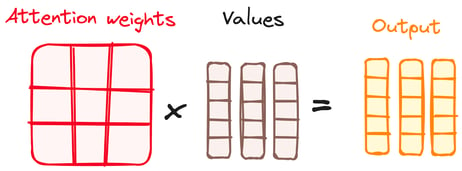
ภาพโดยผู้เขียน ลำดับงานของตัวเข้ารหัส: ผสานผลลัพธ์ Softmax กับเวกเตอร์ value
และในที่สุดเราก็ได้เอาต์พุตของกลไก Attention!
คำว่า “multi-head” มาจากการรันกระบวนการนี้หลายครั้งแบบขนาน ก่อนเริ่ม attention queries, keys และ values จะถูกแบ่งเป็นชุดย่อยที่เล็กลง h ชุด เรียกว่า head และแต่ละ head จะรันขั้นตอนข้างต้นบนส่วนของตนเอง
เอาต์พุตของแต่ละ head จะถูกต่อกันแล้วผ่านเลเยอร์เชิงเส้นสุดท้าย เนื่องจากแต่ละ head เรียนรู้การฉายของตัวเอง หัวต่างๆ จึงหยิบความสัมพันธ์ต่างกันได้ เช่น คำนามที่สรรพนามอ้างถึง หรือคำที่อยู่ติดกัน
หากต้องการเข้าใจกลไก attention ลึกขึ้น ดูบทเรียนของเราเรื่อง multi-head attention ใน Transformers
ขั้นที่ 3.2: การปรับให้เป็นปกติและ residual connections
แต่ละซับเลเยอร์ในเลเยอร์ตัวเข้ารหัสจะตามด้วยขั้นตอนการปรับให้เป็นปกติ (normalization) และยังมีการบวกเอาต์พุตของซับเลเยอร์เข้ากับอินพุตของมันเอง (residual connection) เพื่อช่วยบรรเทาปัญหา vanishing gradient ทำให้สร้างโมเดลลึกได้ กระบวนการนี้จะทำซ้ำหลังเครือข่ายฟีดฟอร์เวิร์ดด้วย
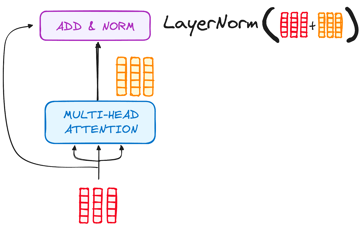
ภาพโดยผู้เขียน ลำดับงานของตัวเข้ารหัส: Normalization และ residual connection หลัง Multi-Head Attention
ขั้นที่ 3.3: เครือข่ายประสาทฟีดฟอร์เวิร์ด
ต่อมาเอาต์พุตจะผ่านเครือข่ายฟีดฟอร์เวิร์ดแบบ position-wise: เลเยอร์เชิงเส้น 2 ชั้น คั่นด้วยแอกทิเวชัน ReLU และประยุกต์แยกกับแต่ละโทเคน ในงานต้นฉบับ เลเยอร์ด้านในมีมิติ 2,048 ซึ่งเป็น 4 เท่าของความกว้างโมเดล 512
เช่นเดียวกับ attention อินพุตของเครือข่ายจะถูกบวกกลับเข้ากับเอาต์พุต (residual connection) แล้วค่อยปรับให้เป็นปกติ
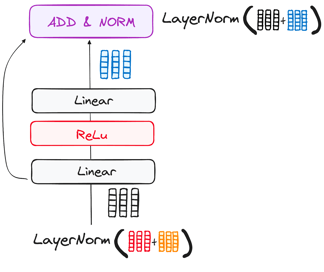
ภาพโดยผู้เขียน ลำดับงานของตัวเข้ารหัส: ซับเลเยอร์เครือข่ายฟีดฟอร์เวิร์ด
ขั้นที่ 4: เอาต์พุตของตัวเข้ารหัส
เอาต์พุตของเลเยอร์ตัวเข้ารหัสสุดท้ายคือชุดเวกเตอร์ที่แทนลำดับอินพุตพร้อมความเข้าใจเชิงบริบทที่เข้มข้น เอาต์พุตนี้จะถูกใช้เป็นอินพุตให้ตัวถอดรหัสในโมเดล Transformer
การเข้ารหัสอย่างรอบคอบนี้ปูทางให้ตัวถอดรหัส ชี้นำให้โฟกัสคำที่ถูกต้องในอินพุตเมื่อถึงเวลาถอดรหัส
การซ้อนเลเยอร์ตัวเข้ารหัส N ชั้นทำให้แต่ละชั้นสร้างต่อยอดจากตัวแทนของชั้นที่อยู่ต่ำกว่า โมเดลต้นฉบับใช้ N = 6; BERT-Base ใช้ 12 และ BERT-Large ใช้ 24
ตัวถอดรหัสของ Transformer ทำงานอย่างไร?
ตัวถอดรหัสสร้างลำดับเอาต์พุต เลเยอร์ของมันสะท้อนเลเยอร์ของตัวเข้ารหัสพร้อมส่วนเพิ่ม: แต่ละเลเยอร์มีซับเลเยอร์ multi-head attention จำนวน 2 ตัวแทนที่จะเป็น 1 ตามด้วยเครือข่ายฟีดฟอร์เวิร์ดแบบ position-wise โดยมี residual connection และ layer normalization รอบซับเลเยอร์ทุกตัว
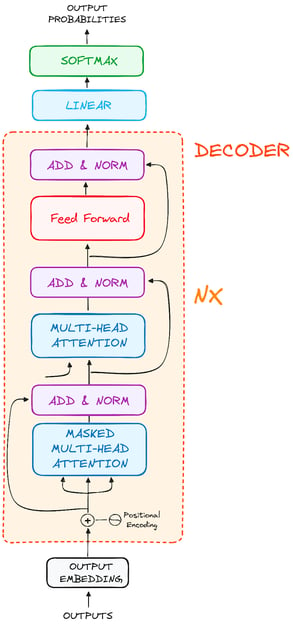
ภาพโดยผู้เขียน โครงสร้างภาพรวมของตัวถอดรหัส
องค์ประกอบเหล่านี้ทำงานคล้ายกับเลเยอร์ของตัวเข้ารหัส แต่มีลูกเล่น: multi-head attention แต่ละตัวในตัวถอดรหัสมีภารกิจเฉพาะของตน
ส่วนท้ายของกระบวนการในตัวถอดรหัสคือเลเยอร์เชิงเส้น ทำหน้าที่เป็นตัวจัดประเภท ตามด้วยฟังก์ชัน softmax เพื่อคำนวณความน่าจะเป็นของคำต่างๆ
ตัวถอดรหัสของ Transformer ถูกออกแบบมาเฉพาะเพื่อสร้างเอาต์พุตนี้ โดยถอดรหัสข้อมูลที่ถูกเข้ารหัสทีละขั้น
ตัวถอดรหัสทำงานแบบ autoregressive: เริ่มจากโทเคนเริ่มลำดับ และในทุกขั้นจะนำโทเคนที่สร้างมาแล้วเป็นอินพุตร่วมกับเอาต์พุตของตัวเข้ารหัส
จะหยุดเมื่อสร้างโทเคนสิ้นสุดลำดับ
ขั้นที่ 1: เอ็มเบดดิ้งของเอาต์พุต
ที่จุดเริ่มของตัวถอดรหัส กระบวนการสะท้อนตัวเข้ารหัส อินพุตจะผ่านเลเยอร์เอ็มเบดดิ้งก่อน
ขั้นที่ 2: การเข้ารหัสตำแหน่ง
ถัดจากเอ็มเบดดิ้ง เช่นเดียวกับตัวเข้ารหัส อินพุตจะผ่านเลเยอร์ positional encoding เพื่อสร้าง positional embeddings
จากนั้น positional embeddings จะเข้าสู่ multi-head attention ตัวแรกของตัวถอดรหัส ซึ่งคำนวณคะแนน attention สำหรับอินพุตของตัวถอดรหัสเอง
ขั้นที่ 3: สแต็กของเลเยอร์ตัวถอดรหัส
ตัวถอดรหัสประกอบด้วยสแต็กของเลเยอร์ที่เหมือนกัน (6 เลเยอร์ในโมเดลต้นฉบับ) แต่ละเลเยอร์มีสามองค์ประกอบหลัก:
ขั้นที่ 3.1: กลไก masked self-attention
คล้ายกับ self-attention ในตัวเข้ารหัส แต่ต่างสำคัญคือห้ามตำแหน่งหนึ่งๆ มองไปยังตำแหน่งถัดไป กล่าวคือ แต่ละคำจะไม่ถูกอิทธิพลจากโทเคนอนาคต
ตัวอย่างเช่น เมื่อคำนวณคะแนน attention ของคำ “Cómo” สำคัญที่ “Cómo” ต้องไม่แอบเห็น “estás” ซึ่งเป็นคำถัดไปในลำดับเอาต์พุต
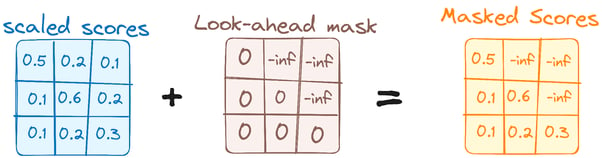
ภาพโดยผู้เขียน ลำดับงานของตัวถอดรหัส: หน้ากากของ Multi-Head Attention ตัวแรก
การมาสก์นี้รับประกันว่าการทำนายของตำแหน่งหนึ่งจะขึ้นกับเอาต์พุตที่ทราบแล้วจากตำแหน่งก่อนหน้าเท่านั้น
ขั้นที่ 3.2: Encoder-decoder attention (cross-attention)
ซับเลเยอร์ attention ตัวที่สองเชื่อมตัวถอดรหัสกับตัวเข้ารหัส ที่นี่ queries มาจากผลลัพธ์ masked self-attention ของตัวถอดรหัส ส่วน keys และ values มาจากเอาต์พุตสุดท้ายของตัวเข้ารหัส
วิธีนี้ทำให้ทุกตำแหน่งในตัวถอดรหัสมองทุกตำแหน่งในประโยคอินพุตได้ เมื่อสร้าง “estás” ตัวถอดรหัสจึงโฟกัส “are you” ได้ จากนั้นผลลัพธ์จะผ่านซับเลเยอร์ฟีดฟอร์เวิร์ด
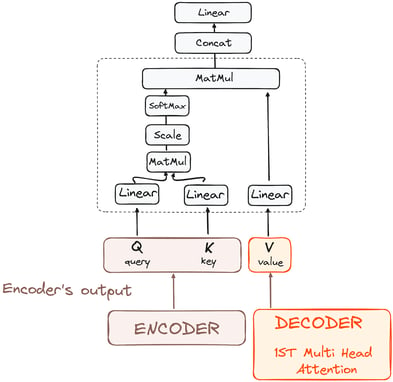
ภาพโดยผู้เขียน ลำดับงานของตัวถอดรหัส: Encoder-Decoder Attention
ขั้นที่ 3.3: เครือข่ายประสาทฟีดฟอร์เวิร์ด
เช่นเดียวกับตัวเข้ารหัส แต่ละเลเยอร์ของตัวถอดรหัสมีเครือข่ายฟีดฟอร์เวิร์ดเชื่อมต่อเต็ม ประยุกต์แยกกันและเหมือนกันในทุกตำแหน่ง
ขั้นที่ 4: ตัวจัดประเภทเชิงเส้นและ softmax
การเดินทางของข้อมูลผ่านโมเดลทรานส์ฟอร์เมอร์สิ้นสุดที่เลเยอร์เชิงเส้นสุดท้าย ทำหน้าที่เป็นตัวจัดประเภท
ขนาดของตัวจัดประเภทนี้สอดคล้องกับจำนวนคลาสทั้งหมด (จำนวนคำในคลังคำ) เช่น หากมี 1000 คลาสแทน 1000 คำ เอาต์พุตของตัวจัดประเภทจะเป็นอาเรย์ 1000 องค์ประกอบ
จากนั้นเอาต์พุตนี้จะเข้าสู่เลเยอร์ softmax ซึ่งแปลงเป็นคะแนนความน่าจะเป็นระหว่าง 0 ถึง 1 โทเคนที่มีความน่าจะเป็นสูงสุดคือคำทำนายที่ดีที่สุดสำหรับคำถัดไป การถอดรหัสแบบ greedy จะเลือกมันเสมอ; โมเดลแชตส่วนใหญ่จะสุ่มตัวอย่างจากการแจกแจงแทน โดยใช้พารามิเตอร์อุณหภูมิ (temperature) ควบคุมความสุ่ม
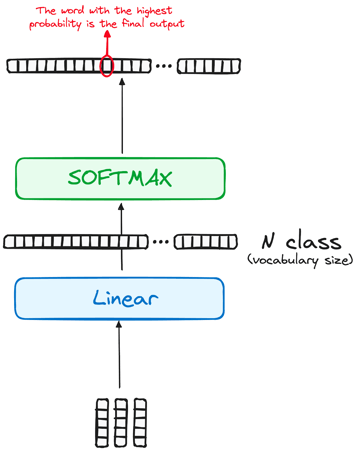
ภาพโดยผู้เขียน ลำดับงานของตัวถอดรหัส: เอาต์พุตสุดท้ายของ Transformer
การปรับให้เป็นปกติและ residual connections
ซับเลเยอร์แต่ละตัว (masked self-attention, encoder-decoder attention, ฟีดฟอร์เวิร์ด) จะตามด้วยการปรับให้เป็นปกติ และมี residual connection รอบตัวมัน
เอาต์พุตของตัวถอดรหัส
เอาต์พุตของเลเยอร์สุดท้ายถูกแปลงเป็นลำดับที่ทำนาย โดยทั่วไปผ่านเลเยอร์เชิงเส้นตามด้วย softmax เพื่อสร้างความน่าจะเป็นเหนือคลังคำ
ในขั้นตอนทำงาน ตัวถอดรหัสจะนำเอาต์พุตที่เพิ่งสร้างไปรวมกับรายชื่ออินพุตที่เติบโตขึ้น แล้วทำการถอดรหัสต่อ วงจรนี้ทำซ้ำจนโมเดลทำนายโทเคนเฉพาะที่บอกว่าสิ้นสุด
เช่นเดียวกับตัวเข้ารหัส ตัวถอดรหัสเป็นสแต็กของเลเยอร์ N ชั้นที่เหมือนกัน (6 ในโมเดลต้นฉบับ) สร้างต่อยอดจากเอาต์พุตของเลเยอร์ด้านล่างและเอาต์พุตของตัวเข้ารหัส การซ้อนที่ลึกขึ้นช่วยให้เลเยอร์และหัวต่างๆ จับรูปแบบ attention ที่ต่างกัน
สถาปัตยกรรมสุดท้ายเป็นดังนี้ (จากงานต้นฉบับ):
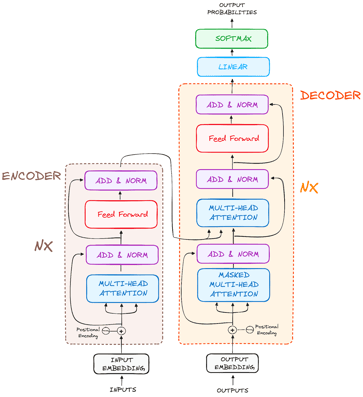
ภาพโดยผู้เขียน โครงสร้างดั้งเดิมของ Transformers
เพื่อเข้าใจสถาปัตยกรรมนี้ให้ดีขึ้น แนะนำให้ลองลงมือสร้าง Transformer ตั้งแต่ศูนย์โดยทำตาม บทเรียนการสร้างทรานส์ฟอร์เมอร์ด้วย PyTorch
ทรานส์ฟอร์เมอร์แบบตัวเข้ารหัสเท่านั้น ตัวถอดรหัสเท่านั้น และแบบตัวเข้ารหัส–ตัวถอดรหัส
โมเดล Transformer แบ่งเป็น 3 ตระกูล ขึ้นกับว่ารักษาครึ่งใดของสถาปัตยกรรมดั้งเดิมไว้ การเลือกนี้กำหนดจุดแข็งของโมเดล: ตัวเข้ารหัสถนัดการอ่าน ตัวถอดรหัสถนัดการเขียน และแบบตัวเข้ารหัส–ตัวถอดรหัสถนัดการแมปลำดับหนึ่งไปสู่อีกลำดับหนึ่ง
| ตระกูล | ส่วนที่เก็บไว้ | Attention | งานพรีเทรน | การใช้งานทั่วไป | ตัวอย่าง |
|---|---|---|---|---|---|
| ตัวเข้ารหัสเท่านั้น | สแต็กตัวเข้ารหัส | สองทิศทาง: ทุกโทเคนมองเห็นทุกโทเคน | เติมโทเคนที่ถูกปิดบัง | การจัดประเภท เอ็มเบดดิ้งสำหรับค้นหา การจดจำหน่วยเชิงนาม | BERT, RoBERTa |
| ตัวถอดรหัสเท่านั้น | สแต็กตัวถอดรหัส ไม่มี cross-attention | เชิงเหตุ: แต่ละโทเคนเห็นเฉพาะโทเคนก่อนหน้า | ทำนายโทเคนถัดไป | แชต สร้างโค้ด เอเจนต์ | GPT-3, Llama, Gemini |
| ตัวเข้ารหัส–ตัวถอดรหัส | ทั้งสองสแต็ก | ตัวเข้ารหัสสองทิศทาง ตัวถอดรหัสเชิงเหตุ พร้อม cross-attention | แมปลำดับอินพุตไปเป็นลำดับเอาต์พุต | แปลภาษา สรุปความ รู้จำคำพูด | Transformer ดั้งเดิม, T5, Whisper |
LLM ส่วนใหญ่ที่เปิดตัวตั้งแต่ GPT-3 เป็นแบบตัวถอดรหัสเท่านั้น การทำนายโทเคนถัดไปใช้ได้กับข้อความดิบทุกแบบ จึงมีข้อมูลฝึกมาก และโมเดลเดียวสามารถทำแปล สรุป และตอบคำถามได้ โดยมองแต่ละงานเป็นการต่อความข้อความ
โมเดลใดใช้สถาปัตยกรรม Transformer บ้าง?
BERT
BERT (Bidirectional Encoder Representations from Transformers) ที่ Google เปิดซอร์สในปี 2018 เป็นทรานส์ฟอร์เมอร์แบบตัวเข้ารหัสเท่านั้น แทนที่จะทำนายคำถัดไป มันถูกพรีเทรนให้เติมคำที่ถูกปิดบังโดยใช้บริบททั้งสองด้าน ทำให้แข็งแกร่งกว่าโมเดลซ้ายไปขวาในเวลานั้นสำหรับงานทำความเข้าใจ
ด้วยความสามารถในการเข้าใจบริบทจากทุกด้านของคำ BERT ทำผลงานเหนือกว่าโมเดลก่อนหน้าในงานอย่างตอบคำถามและทำความเข้าใจภาษาคลุมเครือ แกนของมันใช้ Transformers เชื่อมเอาต์พุตและอินพุตแต่ละองค์ประกอบแบบไดนามิก
BERT ถูกพรีเทรนบนวิกิพีเดียภาษาอังกฤษและชุดข้อมูล BooksCorpus และ Google นำไปใช้กับ Search ในปี 2019 เพื่อทำความเข้าใจคิวรีภาษาธรรมชาติให้ดีขึ้น มันจุดชนวนการแข่งขันสร้างโมเดลภาษาพรีเทรนที่ใหญ่ขึ้น
หากอยากรู้จัก BERT มากขึ้น ดูบทความแยกที่แนะนำโมเดล BERTได้
LaMDA
LaMDA (Language Model for Dialogue Applications) เป็นโมเดลฐาน Transformer ที่พัฒนาโดย Google ออกแบบมาเฉพาะสำหรับงานสนทนา เปิดตัวในงาน Google I/O ปี 2021 มุ่งสร้างคำตอบที่เป็นธรรมชาติและสอดคล้องบริบทมากขึ้น เพิ่มคุณภาพปฏิสัมพันธ์ของผู้ใช้ในแอปพลิเคชันต่างๆ
ดีไซน์ของ LaMDA ทำให้เข้าใจและตอบสนองหัวข้อและเจตนาของผู้ใช้ที่หลากหลาย เหมาะกับแชตบอต ผู้ช่วยเสมือน และระบบ AI เชิงโต้ตอบที่ต้องการบทสนทนาแบบไดนามิก
ต่อมา Google แทนที่ LaMDA ในแชตบอต Bard ด้วย PaLM 2 และจากนั้น Gemini แต่ LaMDA เป็นหนึ่งในโมเดลทรานส์ฟอร์เมอร์รุ่นแรกๆ ที่ฝึกบนบทสนทนาโดยเฉพาะ
หากสนใจทำความเข้าใจ LaMDA เพิ่มเติม อ่านบทความเกี่ยวกับ LaMDAได้
GPT และ ChatGPT
GPT และ ChatGPT พัฒนาโดย OpenAI เป็นโมเดลกำเนิดข้อความขั้นสูงที่สามารถสร้างข้อความที่สอดคล้องและเข้ากับบริบทได้ GPT-1 เปิดตัวครั้งแรกในมิถุนายน 2018 และ GPT-3 ซึ่งทรงอิทธิพลมาก เปิดตัวในปี 2020
โมเดลเหล่านี้ถนัดงานหลากหลาย ทั้งสร้างคอนเทนต์ สนทนา แปลภาษา และอื่นๆ สถาปัตยกรรมของ GPT ทำให้สร้างข้อความคล้ายงานเขียนของมนุษย์ เหมาะกับงานอย่างงานเขียนเชิงสร้างสรรค์ การสนับสนุนลูกค้า และแม้แต่ช่วยเขียนโค้ด ChatGPT ซึ่งเป็นเวอร์ชันที่ปรับให้เหมาะกับบริบทการสนทนา โดดเด่นในการสร้างบทสนทนาคล้ายมนุษย์ เหมาะกับแชตบอตและผู้ช่วยเสมือน
OpenAI หยุดเผยรายละเอียดสถาปัตยกรรมหลัง GPT-3 (ยกเว้นโมเดลเปิดน้ำหนัก gpt-oss) แต่ตระกูลนี้ยังเติบโตต่อเนื่อง ล่าสุดคือ GPT-6 Astra ในปี 2026
Claude
Claude พัฒนาโดย Anthropic เป็นตระกูลผู้ช่วย AI บน Transformer ที่ให้ความสำคัญกับความปลอดภัยและความเป็นประโยชน์ Claude ใช้ Constitutional AI (CAI) แนวทางการฝึกที่ให้โมเดลยึดหลักการชุดหนึ่งเพื่อให้ผลลัพธ์ที่เป็นประโยชน์ ไม่เป็นอันตราย และซื่อสัตย์
Claude 3 (เปิดตัวปี 2024) แนะนำสามระดับโมเดล Haiku, Sonnet และ Opus ให้สมดุลความเร็วกับความสามารถ โมเดลเด่นด้านการให้เหตุผลอย่างละเอียด ทำตามคำสั่งซับซ้อนได้ดี และคงบริบทในการสนทนายาวๆ (ได้ถึง 200K โทเคน)
Anthropic ออกรุ่นใหม่ทุกไม่กี่เดือนนับแต่นั้น ไลน์อัป Claude 5 ปัจจุบันมี Claude Fable 5.1 และ Claude Opus 5.5 ทั้งคู่เปิดตัวในปี 2026 เช่นเดียวกับ OpenAI, Anthropic ไม่เผยรายละเอียดสถาปัตยกรรม
ความหลากหลายอื่นๆ
จำนวนโมเดลทรานส์ฟอร์เมอร์เติบโตอย่างรวดเร็ว แคตตาล็อกของ Xavier Amatriain รวบรวมโมเดลทรานส์ฟอร์เมอร์หลายสิบตัวตามสถาปัตยกรรมและวัตถุประสงค์การฝึก และ เกณฑ์ HELM ของสแตนฟอร์ดได้ประเมินโมเดลภาษาชั้นนำ 30 ตัวเคียงข้างกัน
แนวโน้มเปิดซอร์สเพิ่มขึ้นเรื่อยๆ โดยแพลตฟอร์มอย่าง model hub ของ Hugging Face เป็นหัวหอก นอกจากนี้ยังมีโมเดลบน Transformer อีกมากมายที่พัฒนามาเฉพาะงาน NLP ต่างๆ แสดงให้เห็นความยืดหยุ่นและประสิทธิภาพของโมเดลในงานที่หลากหลาย
สามารถเรียนรู้เพิ่มเติมเกี่ยวกับ Foundation Models ทั้งหลายได้ในบทความแยก ซึ่งอธิบายว่าคืออะไรและตัวใดใช้งานมากที่สุด
ทรานส์ฟอร์เมอร์ตั้งแต่ปี 2017 เปลี่ยนไปอย่างไร?
ตั้งแต่สถาปัตยกรรมดั้งเดิมปี 2017 ทรานส์ฟอร์เมอร์วิวัฒน์อย่างมากเพื่อแก้ข้อจำกัดและขยายสู่โดเมนใหม่
ความต่างระหว่าง LLM สมัยใหม่กับ Transformer ดั้งเดิม
LLM เปิดน้ำหนักในปัจจุบันยังคงเดินตามพิมพ์เขียวปี 2017 แต่แทบทุกองค์ประกอบถูกสลับเป็นตัวแปรที่ฝึกได้เสถียรกว่า หรือรันได้ถูกกว่า Meta บันทึกการเปลี่ยนแปลงเหล่านี้ไว้มากในงาน LLaMA และ Llama 3:
| องค์ประกอบ | Transformer ดั้งเดิม (2017) | LLM เปิดน้ำหนักทั่วไปวันนี้ |
|---|---|---|
| สถาปัตยกรรม | ตัวเข้ารหัส–ตัวถอดรหัส, 6 + 6 เลเยอร์ | ตัวถอดรหัสเท่านั้น, 32 เลเยอร์ (Llama 3 8B) ถึง 126 เลเยอร์ (Llama 3 405B) |
| ความกว้างโมเดล | 512 | 4,096 (Llama 3 8B) ถึง 16,384 (Llama 3 405B) |
| ข้อมูลตำแหน่ง | เข้ารหัสไซน์และโคไซน์แบบคงที่ บวกเข้ากับ embeddings | Rotary position embeddings (RoPE) ใช้ภายใน attention |
| การปรับให้เป็นปกติ | LayerNorm หลังแต่ละซับเลเยอร์ (post-norm) | RMSNorm ก่อนแต่ละซับเลเยอร์ (pre-norm) |
| แอกทิเวชันฟีดฟอร์เวิร์ด | ReLU | SwiGLU |
| หัว attention | Multi-head attention, 8 หัว | Grouped-query attention: หลาย query head แชร์ 1 key-value head (มี 8 key-value heads ใน Llama 3) |
| เลเยอร์ฟีดฟอร์เวิร์ด | หนาแน่น (dense) | หนาแน่น หรือ mixture of experts (Llama 4, DeepSeek-V3) |
Vision Transformers (ViT)
Vision Transformers นำกลไก self-attention ไปใช้กับภาพ โดยแบ่งภาพเป็นแพตช์และถือแต่ละแพตช์เป็นโทเคน วิธีนี้ได้ผลมากสำหรับการจัดประเภทภาพ การตรวจจับวัตถุ และการสร้างภาพ โดยมักทำได้ดีกว่า CNN แบบดั้งเดิมเมื่อมีชุดข้อมูลใหญ่
ทรานส์ฟอร์เมอร์แบบมัลติโหมด
โมเดลสมัยใหม่อย่าง GPT-5, Gemini 3 และ Llama 4 ประมวลผลอินพุตหลายประเภท (ข้อความ ภาพ เสียง วิดีโอ) ในสถาปัตยกรรมเดียว ทรานส์ฟอร์เมอร์มัลติโหมดใช้พื้นที่เอ็มเบดดิ้งแบบรวมและกลไก cross-attention เพื่อให้เหตุผลข้ามโมดาลิตี้ไปพร้อมกัน
ทรานส์ฟอร์เมอร์ประสิทธิภาพสูง
ความซับซ้อนกำลังสองของ self-attention เป็นข้อจำกัดความยาวบริบท มีนวัตกรรมหลายอย่างที่แก้ปัญหานี้:
- Flash Attention: คำนวณ attention แบบแม่นยำด้วยการแบ่งไทล์ให้พอดีกับหน่วยความจำบนชิปที่เร็วของ GPU ทำให้การใช้หน่วยความจำเติบโตเชิงเส้นตามความยาวลำดับแทนที่จะเป็นกำลังสอง
- Rotary Position Embeddings (RoPE): เข้ารหัสข้อมูลตำแหน่งด้วยเมทริกซ์การหมุน ช่วยให้ประมาณขยายไปยังลำดับที่ยาวขึ้นได้ดีขึ้น
- Attention เชิงเส้นและแบบเบาบาง: Linformer และ Performer ประมาณค่า attention และ Longformer จำกัดโทเคนส่วนใหญ่ให้อยู่ในหน้าต่างเฉพาะที่ ลดต้นทุนลงสู่ O(n) สำหรับเอกสารยาวมาก
- Mixture of Experts (MoE): เปิดใช้งานเฉพาะพารามิเตอร์ย่อยต่อโทเคน ทำให้โมเดลใหญ่ขึ้นได้ด้วยต้นทุนคำนวณใกล้เคียงเดิม
ทรานส์ฟอร์เมอร์ เทียบกับ RNN และ CNN
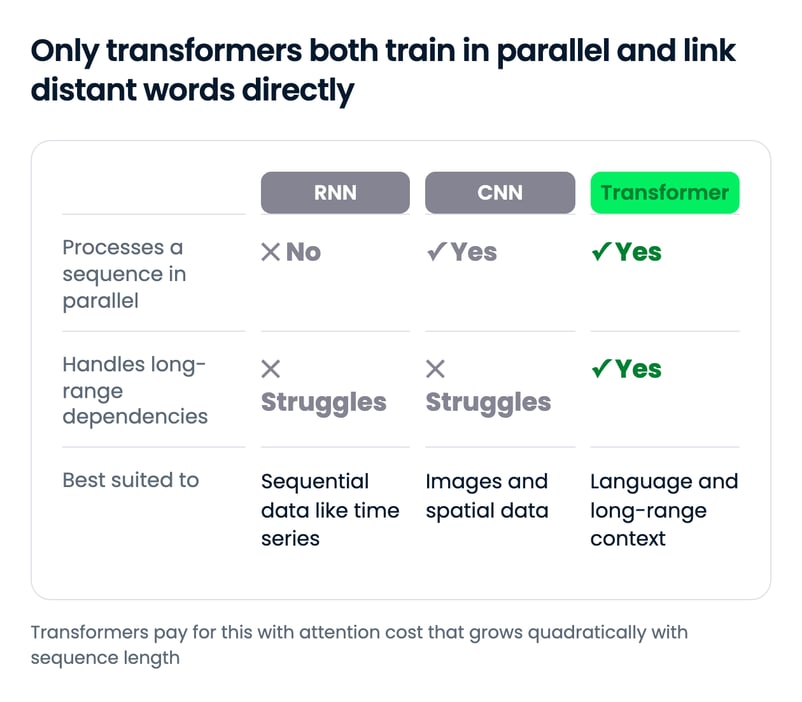
ทรานส์ฟอร์เมอร์มักถูกเทียบกับบล็อกโครงข่ายประสาทอีก 2 แบบ: เลเยอร์วนซ้ำ (RNN) และเลเยอร์คอนโวลูชัน (CNN) ซึ่งแต่ละแบบเหมาะกับข้อมูลคนละชนิด
เลเยอร์วนซ้ำ
เลเยอร์วนซ้ำ ซึ่งเป็นแกนของโครงข่ายประสาทแบบวนซ้ำ (RNN) เด่นในการจัดการข้อมูลลำดับ จุดแข็งคือความสามารถในการดำเนินการตามลำดับ ซึ่งสำคัญกับงานประมวลผลภาษาและอนุกรมเวลา ในเลเยอร์วนซ้ำ เอาต์พุตจากขั้นก่อนหน้าจะถูกป้อนกลับเป็นอินพุตของขั้นถัดไป วงจรนี้ทำให้เครือข่าย “จำ” ข้อมูลก่อนหน้าได้ ซึ่งสำคัญต่อการเข้าใจบริบทในลำดับ
อย่างไรก็ตาม ตามที่กล่าวไปแล้ว การประมวลผลตามลำดับมีผลกระทบหลักสองอย่าง:
- ทำให้เวลาฝึกยาวขึ้น เพราะแต่ละขั้นขึ้นกับขั้นก่อนหน้า จึงยากต่อการประมวลผลแบบขนาน
- มักลำบากกับการพึ่งพาระยะยาว เนื่องจากปัญหา vanishing gradient ทำให้เรียนรู้จากจุดข้อมูลที่ห่างกันมากในลำดับได้ยาก
โมเดล Transformer แตกต่างจากสถาปัตยกรรมที่ใช้เลเยอร์วนซ้ำอย่างมาก เพราะไม่มีการวนซ้ำ และตามที่เห็น เลเยอร์ Attention ของ Transformer แก้ทั้งสองปัญหา ทำให้เป็นวิวัฒนาการธรรมชาติของ RNN สำหรับงาน NLP
เลเยอร์คอนโวลูชัน
อีกด้าน เลเยอร์คอนโวลูชัน ซึ่งเป็นบล็อกของโครงข่ายประสาทแบบคอนโวลูชัน (CNN) มีชื่อเสียงในด้านประสิทธิภาพการประมวลผลข้อมูลเชิงพื้นที่อย่างภาพ
เลเยอร์เหล่านี้ใช้เคอร์เนล (ฟิลเตอร์) สแกนอินพุตเพื่อดึงคุณลักษณะ ความกว้างของเคอร์เนลปรับได้ ทำให้โฟกัสคุณลักษณะเล็กหรือใหญ่ตามภารกิจ
แม้เลเยอร์คอนโวลูชันจะเก่งมากในการจับลำดับชั้นเชิงพื้นที่และรูปแบบของข้อมูล แต่มักมีปัญหากับการพึ่งพาระยะยาว เพราะไม่ได้คำนึงถึงข้อมูลตามลำดับโดยกำเนิด จึงไม่เหมาะเท่าไรกับงานที่ต้องเข้าใจลำดับหรือบริบทของชุดข้อมูล
จึงไม่น่าแปลกใจที่ CNN และ Transformer เหมาะกับข้อมูลและงานคนละแบบ CNN ครองงานคอมพิวเตอร์วิทัศน์เพราะประสิทธิภาพในการประมวลผลข้อมูลเชิงพื้นที่ ขณะที่ Transformer เป็นตัวเลือกหลักสำหรับงานลำดับที่ซับซ้อน โดยเฉพาะใน NLP ด้วยความสามารถในการเข้าใจการพึ่งพาระยะไกล
ข้อเสียและข้อจำกัดของ Transformer
แม้จะประสบความสำเร็จ ทรานส์ฟอร์เมอร์ก็มีข้อจำกัดสำคัญ:
- ความซับซ้อนกำลังสอง: Self-attention สเกลเป็น O(n²) ตามความยาวลำดับ ทำให้ หน้าต่างบริบท ที่ยาวมากมีต้นทุนคำนวณสูง
- ต้องใช้หน่วยความจำมาก: โมเดลขนาดใหญ่ต้องใช้หน่วยความจำ GPU มาก จำกัดตัวเลือกการปรับใช้
- ต้องการข้อมูลฝึกมาก: โดยทั่วไปต้องใช้ชุดข้อมูลมหาศาลเพื่อให้ได้ประสิทธิภาพสูง
- หลอนข้อเท็จจริง (hallucination): ทรานส์ฟอร์เมอร์ทำนายโทเคนที่มีแนวโน้มมากกว่าการค้นหาความจริง จึงอาจกล่าวข้อมูลเท็จอย่างมั่นใจ โมเดลให้เหตุผลช่วยลดลงแต่ยังไม่หมด
- ข้อจำกัดของการเข้ารหัสตำแหน่ง: การเข้ารหัสตำแหน่งมาตรฐานลำบากในการทั่วไปไปยังความยาวลำดับที่ไม่เคยเห็นตอนฝึก
งานวิจัยยังคงแก้ข้อจำกัดเหล่านี้ผ่านนวัตกรรมสถาปัตยกรรมอย่าง Flash Attention, mixture-of-experts และ retrieval-augmented generation (RAG)
ข้อคิดส่งท้าย
ทรานส์ฟอร์เมอร์ทำงานโดยเปิดให้ทุกโทเคน “มอง” ทุกโทเคนอื่นผ่าน self-attention แล้วขัดเกลาตัวแทนเหล่านั้นผ่านสแต็กของเลเยอร์ที่เหมือนกัน การตัดสินใจออกแบบเพียงข้อนี้ทำให้ฝึกแบบขนานบน GPU ได้ และแก้ปัญหาหน่วยความจำระยะไกลที่ถ่วง RNN
สิ่งที่น่าประทับใจคือแกนกลางแทบไม่เปลี่ยน LLM ในปี 2026 สลับการเข้ารหัสตำแหน่ง การปรับให้เป็นปกติ และหัว attention ให้ถูกลง แต่คุณยังคงจำแผนภาพปี 2017 ได้ คำถามเปิดคือโมเดล state space และไฮบริดจะครองงานบริบทยาวหรือไม่ หรือเคอร์เนลอย่าง FlashAttention จะทำให้ต้นทุนกำลังสองของ attention ยังคงคุ้มค่าได้
เพื่อนำไปปฏิบัติจริง ลองสร้าง Transformer ด้วย PyTorch ตามบทเรียนทีละขั้นตอนของเรา หรือเริ่มจากโมเดลพรีเทรนในบทนำสู่ Transformers และ Hugging Face หากอยากเรียนรู้ต่อ แนะนำคอร์ส Transformer Models with PyTorch หรือเส้นทาง Developing Large Language Models เพื่อครบเครื่อง
FAQs
สถาปัตยกรรมทรานส์ฟอร์เมอร์ทำงานอย่างไร?
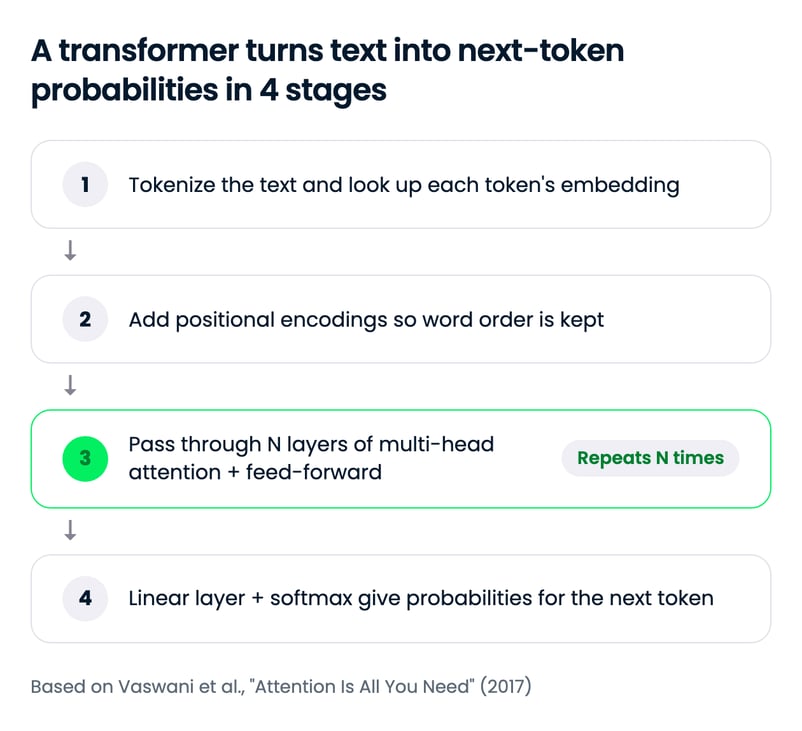
ทรานส์ฟอร์เมอร์จะแยกข้อความเป็นโทเคน แปลงแต่ละโทเคนเป็นเอ็มเบดดิ้ง และเพิ่มข้อมูลตำแหน่ง จากนั้นสแต็กของเลเยอร์จะทำ multi-head self-attention ซึ่งทำให้ทุกโทเคนถ่วงน้ำหนักโทเคนอื่นๆ ต่อด้วยเครือข่ายฟีดฟอร์เวิร์ด โดยมี residual connections และการปรับให้เป็นปกติในแต่ละขั้น สุดท้ายเลเยอร์เชิงเส้นและ softmax จะสร้างความน่าจะเป็นสำหรับโทเคนถัดไป
ความแตกต่างระหว่างทรานส์ฟอร์เมอร์แบบตัวเข้ารหัสเท่านั้น ตัวถอดรหัสเท่านั้น และตัวเข้ารหัส–ตัวถอดรหัสคืออะไร?
โมเดลแบบตัวเข้ารหัสเท่านั้น เช่น BERT อ่านอินพุตทั้งหมดแบบสองทิศ เหมาะกับงานจัดประเภทและค้นหา โมเดลแบบตัวถอดรหัสเท่านั้น เช่น GPT และ Llama มองเห็นเฉพาะโทเคนก่อนหน้าและถูกฝึกให้ทำนายโทเคนถัดไป จึงเป็นดีไซน์มาตรฐานของ LLM สำหรับแชต โมเดลแบบตัวเข้ารหัส–ตัวถอดรหัส เช่น T5 และ Transformer ดั้งเดิม แมปลำดับอินพุตเป็นลำดับเอาต์พุต เช่น งานแปลภาษา
ทำไมทรานส์ฟอร์เมอร์จึงมาแทน RNN และ LSTM?
RNN และ LSTM ประมวลผลโทเคนทีละตัว ทำให้ฝึกช้าบน GPU และทำให้ข้อมูลเลือนเมื่อความยาวลำดับมากขึ้น Self-attention เชื่อมทุกโทเคนเข้าหากันโดยตรงและประมวลผลทั้งลำดับแบบขนาน จึงฝึกได้เร็วกว่าและจัดการการพึ่งพาระยะไกลได้ดีกว่า
ChatGPT เป็นทรานส์ฟอร์เมอร์หรือไม่?
ใช่ GPT ย่อมาจาก Generative Pre-trained Transformer และโมเดล GPT ที่อยู่เบื้องหลัง ChatGPT เป็นทรานส์ฟอร์เมอร์แบบตัวถอดรหัสเท่านั้นที่ถูกฝึกเพื่อทำนายโทเคนถัดไป OpenAI ไม่ได้เผยรายละเอียดสถาปัตยากรหลัง GPT-3 แต่ทุกโมเดล GPT ถูกสร้างบนดีไซน์ของทรานส์ฟอร์เมอร์
ข้อจำกัดหลักของทรานส์ฟอร์เมอร์มีอะไรบ้าง?
ต้นทุนของ self-attention เติบโตเป็นกำลังสองตามความยาวลำดับ ดังนั้นหน้าต่างบริบทที่ยาวจึงมีต้นทุนคำนวณและหน่วยความจำสูง ทรานส์ฟอร์เมอร์ยังต้องการชุดข้อมูลฝึกขนาดใหญ่และอาจเกิดการ "หลอน" ให้ข้อมูลเท็จอย่างมั่นใจ เทคนิคอย่าง FlashAttention, grouped-query attention, mixture of experts และไฮบริด state space model มุ่งลดต้นทุนเหล่านี้
ทรานส์ฟอร์เมอร์คือโครงข่ายประสาทเทียมที่อ่านทุกโทเคนของลำดับพร้อมกัน และใช้กลไก self-attention เพื่อตัดสินว่าแต่ละโทเคนควรอ้างอิงโทเคนอื่นมากน้อยเพียงใด นักวิจัยของ Google แนะนำโมเดลนี้ครั้งแรกในงานวิจัยปี 2017 “Attention Is All You Need” และปัจจุบันเป็นฐานของโมเดลภาษาขนาดใหญ่ (LLM) เกือบทั้งหมด ตั้งแต่ GPT และ Llama ไปจนถึง Gemini
สถาปัตยกรรมทำงานเป็น 4 ช่วงขั้นตอน ข้อความถูกแยกเป็นโทเคนและแมปเป็นเอ็มเบดดิ้ง เพิ่มข้อมูลเชิงตำแหน่ง ต่อด้วยสแต็กของเลเยอร์ที่สลับระหว่าง multi-head self-attention กับเครือข่ายฟีดฟอร์เวิร์ด (แต่ละส่วนหุ้มด้วย residual connection และการปรับให้เป็นปกติ) และเลเยอร์เชิงเส้นสุดท้ายพร้อม softmax จะแป向เวกเตอร์สุดท้ายเป็นความน่าจะเป็นเหนือคลังคำ รุ่นดั้งเดิมจับคู่ตัวเข้ารหัส (encoder) กับตัวถอดรหัส (decoder); LLM ส่วนใหญ่ปัจจุบันเก็บเฉพาะตัวถอดรหัส
ในบทเรียนนี้ จะพาไล่ดูแต่ละช่วงของดีไซน์แบบตัวเข้ารหัส–ตัวถอดรหัสดั้งเดิม แล้วแสดงให้เห็นว่า BERT, GPT และ LLM สมัยใหม่ปรับเปลี่ยนอย่างไร หากอยากเข้าใจเชิงสัญชาตญาณก่อน อ่านบทความอธิบายของเราเกี่ยวกับ กลไก attention และ self-attention ได้
สรุปสั้นๆ