Alibaba heeft zojuist Qwen2.5-Max uitgebracht, het meest geavanceerde AI-model tot nu toe. Dit is geen redeneermodel zoals DeepSeek R1 of OpenAI’s o1, wat betekent dat je het denkproces niet kunt zien.
Het is beter om Qwen2.5-Max te zien als een generalistisch model en een concurrent van GPT-4o, Claude 3.5 Sonnet of DeepSeek V3.
In deze blog leg ik uit wat Qwen2.5-Max is, hoe het ontwikkeld is, hoe het zich verhoudt tot de concurrentie en hoe je er toegang toe krijgt.
We houden onze lezers op de hoogte van het laatste AI-nieuws met The Median, onze gratis vrijdagse nieuwsbrief die de belangrijkste verhalen van de week samenvat. Abonneer je en blijf scherp in een paar minuten per week:
Wat is Qwen2.5-Max?
Qwen2.5-Max is Alibaba’s krachtigste AI-model tot nu toe, ontworpen om te concurreren met topmodellen zoals GPT-4o, Claude 3.5 Sonnet en DeepSeek V3.
Alibaba, een van China’s grootste technologiebedrijven, staat vooral bekend om zijn e-commerceplatforms, maar heeft ook een sterke positie opgebouwd in cloud computing en kunstmatige intelligentie. De Qwen-reeks maakt deel uit van dit bredere AI-ecosysteem, variërend van kleinere open-weight modellen tot grootschalige propriëtaire systemen.
In tegenstelling tot sommige eerdere Qwen-modellen is Qwen2.5-Max niet open-source; de gewichten zijn niet openbaar beschikbaar.
Qwen2.5-Max is getraind op 20 biljoen tokens en heeft daardoor een enorme kennisbasis en sterke algemene AI-capaciteiten. Het is echter geen redeneermodel zoals DeepSeek R1 of OpenAI’s o1, wat betekent dat het zijn denkproces niet expliciet toont. Gezien Alibaba’s voortdurende AI-uitbreiding zien we mogelijk in de toekomst een speciaal redeneermodel—mogelijk met Qwen 3.
Hoe werkt Qwen2.5-Max?
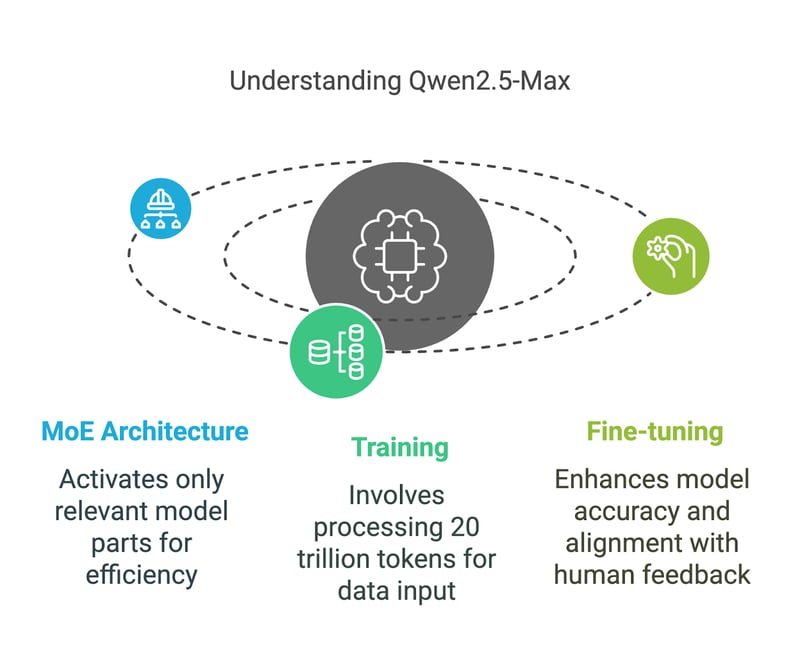
Qwen2.5-Max gebruikt een Mixture-of-Experts (MoE)-architectuur, een techniek die ook wordt gebruikt door DeepSeek V3. Deze aanpak laat het model opschalen terwijl de rekenkosten beheersbaar blijven. Laten we de belangrijkste onderdelen op een begrijpelijke manier doornemen.
Mixture-of-Experts (MoE)-architectuur
In tegenstelling tot traditionele AI-modellen die al hun parameters voor elke taak gebruiken, activeren MoE-modellen zoals Qwen2.5-Max en DeepSeek V3 op elk moment alleen de meest relevante delen van het model.
Je kunt het zien als een team van specialisten: stel je een complexe vraag over natuurkunde, dan reageren alleen de natuurkundigen, terwijl de rest van het team inactief blijft. Door die selectieve activatie kan het model grootschalige verwerking efficiënter aan zonder extreem veel rekenkracht te vereisen.
Deze methode maakt Qwen2.5-Max zowel krachtig als schaalbaar, zodat het kan concurreren met dichte modellen zoals GPT-4o en Claude 3.5 Sonnet, terwijl het zuiniger is met resources—een dicht model is er één waarbij alle parameters voor elke input worden geactiveerd.
Training en fine-tuning
Qwen2.5-Max is getraind op 20 biljoen tokens, met een enorme spreiding aan onderwerpen, talen en contexten.
Om 20 biljoen tokens in perspectief te plaatsen: dat zijn ruwweg 15 biljoen woorden—zoveel dat het nauwelijks te bevatten is. Ter vergelijking: George Orwells 1984 telt ongeveer 89.000 woorden, wat betekent dat Qwen2.5-Max is getraind op het equivalent van 168 miljoen exemplaren van 1984.
Alleen ruwe trainingsdata garanderen echter geen AI van hoge kwaliteit, dus Alibaba heeft het verder verfijnd met:
Qwen2.5-Max-benchmarks
Qwen2.5-Max is getest tegenover andere toonaangevende AI-modellen om de prestaties op uiteenlopende taken te meten. Deze benchmarks evalueren zowel instructmodellen (fijn-afgesteld voor taken zoals chat en coderen) als basismodellen (de ruwe basis vóór fine-tuning). Dat onderscheid helpt om de cijfers in de juiste context te plaatsen.
Benchmarks voor instructmodellen
Instructmodellen zijn fijn-afgesteld voor toepassingen in de praktijk, zoals conversatie, coderen en algemene kennistaken. Qwen2.5-Max wordt hier vergeleken met modellen als GPT-4o, Claude 3.5 Sonnet, Llama 3.1 405B en DeepSeek V3.
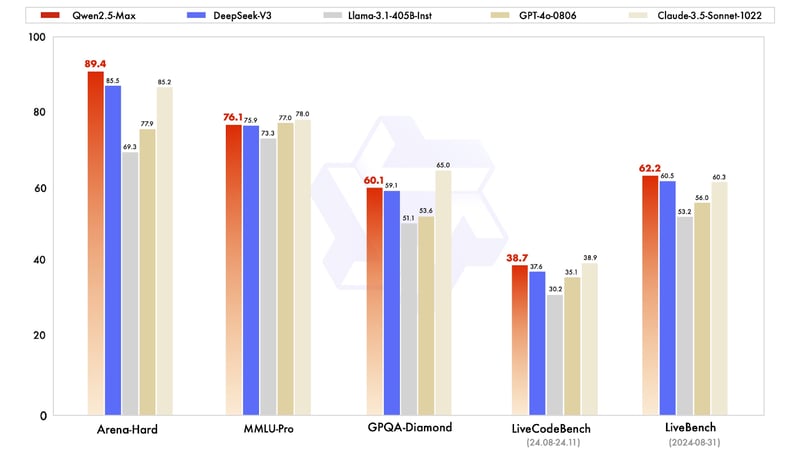
Vergelijking van de instructmodellen. Bron: QwenLM
Laten we de resultaten kort doornemen:
- Arena-Hard (voorkeurbenchmark): Qwen2.5-Max scoort 89,4 en loopt voor op DeepSeek V3 (85,5) en Claude 3.5 Sonnet (85,2). Deze benchmark benadert menselijke voorkeur bij AI-antwoorden.
- MMLU-Pro (kennis en redeneren): Qwen2.5-Max scoort 76,1, net boven DeepSeek V3 (75,9) maar iets achter koploper Claude 3.5 Sonnet (78,0) en nummer twee GPT-4o (77,0).
- GPQA-Diamond (algemene-kennis-QA): Met 60,1 zit Qwen2.5-Max net boven DeepSeek V3 (59,1), terwijl Claude 3.5 Sonnet leidt met 65,0.
- LiveCodeBench (codeervaardigheid): Met 38,7 is Qwen2.5-Max vergelijkbaar met DeepSeek V3 (37,6) maar achter Claude 3.5 Sonnet (38,9).
- LiveBench (algemene capaciteiten): Qwen2.5-Max leidt met 62,2 en overtreft DeepSeek V3 (60,5) en Claude 3.5 Sonnet (60,3), wat wijst op brede competentie in praktische AI-taken.
Al met al blijkt Qwen2.5-Max een veelzijdig AI-model dat uitblinkt in voorkeurstaken en algemene AI-capaciteiten, terwijl het concurrerend blijft op kennis en coderen.
Benchmarks voor basismodellen
Omdat GPT-4o en Claude 3.5 Sonnet propriëtaire modellen zijn zonder publiek beschikbare basisversies, is de vergelijking beperkt tot open-weight modellen zoals Qwen2.5-Max, DeepSeek V3, LLaMA 3.1-405B en Qwen 2.5-72B. Dat geeft een duidelijker beeld van hoe Qwen2.5-Max zich verhoudt tot toonaangevende grootschalige open modellen.
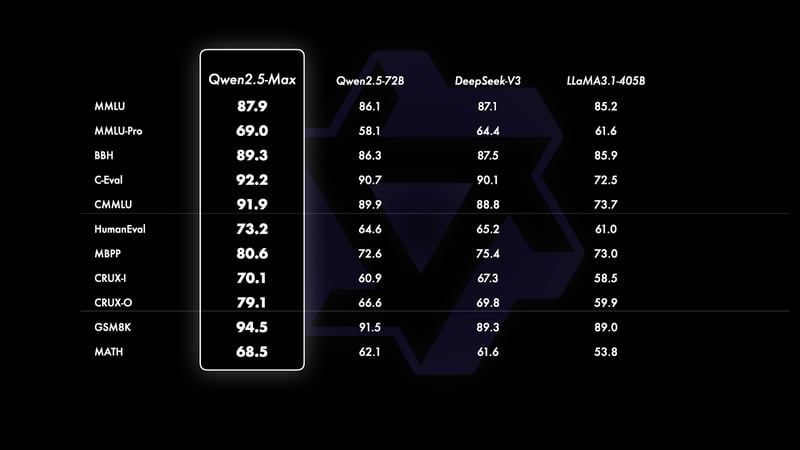
Vergelijking van de basismodellen. Bron: QwenLM
Als je goed naar de bovenstaande grafiek kijkt, zie je dat die in drie secties is verdeeld op basis van het type benchmarks dat wordt geëvalueerd:
- Algemene kennis en taalbegrip (MMLU, MMLU-Pro, BBH, C-Eval, CMMU): Qwen2.5-Max leidt op alle benchmarks in deze categorie, met 87,9 op MMLU en 92,2 op C-Eval, en presteert beter dan DeepSeek V3 en Llama 3.1-405B. Deze benchmarks richten zich op de breedte en diepte van kennis en het vermogen om die kennis in een redeneercontext toe te passen.
- Coderen en probleemoplossing (HumanEval, MBPP, CRUX-I, CRUX-O): Qwen2.5-Max leidt ook op alle benchmarks en presteert sterk bij codeertaken, met 73,2 op HumanEval en 80,6 op MBPP, net boven DeepSeek V3 en duidelijk boven Llama 3.1-405B. Deze benchmarks meten codeervaardigheden, probleemoplossend vermogen en het vermogen om instructies te volgen of zelfstandig oplossingen te genereren.
- Wiskundige probleemoplossing (GSM8K, MATH): Wiskundig redeneren is een van de sterkste punten van Qwen2.5-Max, met 94,5 op GSM8K, ruim boven DeepSeek V3 (89,3) en Llama 3.1-405B (89,0). Op MATH, dat draait om complexere problemen, scoort Qwen2.5-Max echter 68,5: iets beter dan de concurrentie, maar met ruimte voor verbetering.
Hoe krijg je toegang tot Qwen2.5-Max
Toegang krijgen tot Qwen2.5-Max is eenvoudig, en je kunt het gratis uitproberen zonder ingewikkelde setup.
Qwen Chat
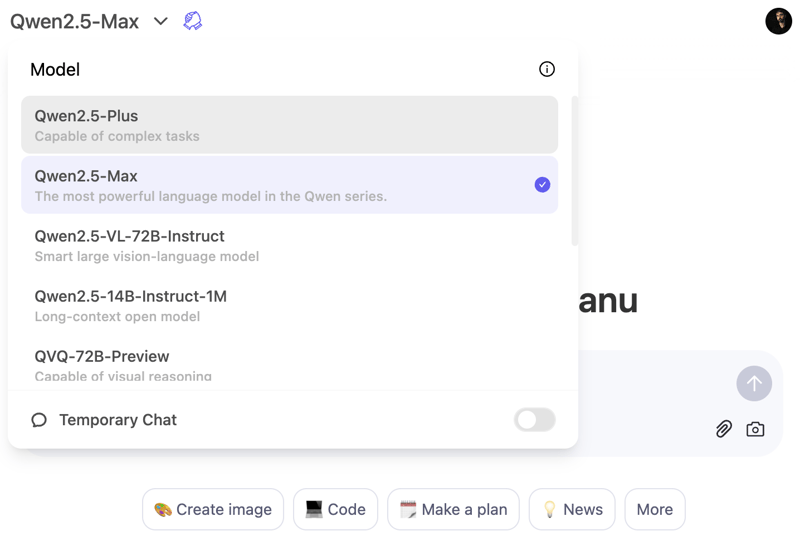
De snelste manier om Qwen2.5-Max te ervaren is via het Qwen Chat-platform. Dit is een webinterface waarmee je rechtstreeks in je browser met het model kunt praten—net zoals je ChatGPT in je browser gebruikt.
Om het Qwen2.5-Max-model te gebruiken, klik je op het modelkeuzemenu en selecteer je Qwen2.5-Max:
API-toegang via Alibaba Cloud
Voor ontwikkelaars is Qwen2.5-Max beschikbaar via de Alibaba Cloud Model Studio API. Om het te gebruiken heb je een Alibaba Cloud-account nodig, moet je de Model Studio-service activeren en een API-sleutel genereren.
Omdat de API het OpenAI-formaat volgt, zou integratie eenvoudig moeten zijn als je al met OpenAI-modellen werkt. Voor gedetailleerde installatie-instructies, ga naar de officiële Qwen2.5-Max-blog.
Conclusie
Qwen2.5-Max is Alibaba’s meest capabele AI-model tot nu toe, gebouwd om te concurreren met topmodellen zoals GPT-4o, Claude 3.5 Sonnet en DeepSeek V3.
In tegenstelling tot sommige eerdere Qwen-modellen is Qwen2.5-Max niet open-source, maar je kunt het testen via Qwen Chat of via API-toegang op Alibaba Cloud.
Gezien Alibaba’s aanhoudende investeringen in AI is het niet verrassend als er in de toekomst een redeneergericht model komt—mogelijk met Qwen 3.
Als je meer AI-nieuws wilt lezen, raad ik deze artikelen aan:



Alibaba heeft zojuist Qwen2.5-Max uitgebracht, het meest geavanceerde AI-model tot nu toe. Dit is geen redeneermodel zoals DeepSeek R1 of OpenAI’s o1, wat betekent dat je het denkproces niet kunt zien.
Het is beter om Qwen2.5-Max te zien als een generalistisch model en een concurrent van GPT-4o, Claude 3.5 Sonnet of DeepSeek V3.
In deze blog leg ik uit wat Qwen2.5-Max is, hoe het ontwikkeld is, hoe het zich verhoudt tot de concurrentie en hoe je er toegang toe krijgt.
We houden onze lezers op de hoogte van het laatste AI-nieuws met The Median, onze gratis vrijdagse nieuwsbrief die de belangrijkste verhalen van de week samenvat. Abonneer je en blijf scherp in een paar minuten per week:
Wat is Qwen2.5-Max?
Qwen2.5-Max is Alibaba’s krachtigste AI-model tot nu toe, ontworpen om te concurreren met topmodellen zoals GPT-4o, Claude 3.5 Sonnet en DeepSeek V3.
Alibaba, een van China’s grootste technologiebedrijven, staat vooral bekend om zijn e-commerceplatforms, maar heeft ook een sterke positie opgebouwd in cloud computing en kunstmatige intelligentie. De Qwen-reeks maakt deel uit van dit bredere AI-ecosysteem, variërend van kleinere open-weight modellen tot grootschalige propriëtaire systemen.
In tegenstelling tot sommige eerdere Qwen-modellen is Qwen2.5-Max niet open-source; de gewichten zijn niet openbaar beschikbaar.
Qwen2.5-Max is getraind op 20 biljoen tokens en heeft daardoor een enorme kennisbasis en sterke algemene AI-capaciteiten. Het is echter geen redeneermodel zoals DeepSeek R1 of OpenAI’s o1, wat betekent dat het zijn denkproces niet expliciet toont. Gezien Alibaba’s voortdurende AI-uitbreiding zien we mogelijk in de toekomst een speciaal redeneermodel—mogelijk met Qwen 3.
Hoe werkt Qwen2.5-Max?
Qwen2.5-Max gebruikt een Mixture-of-Experts (MoE)-architectuur, een techniek die ook wordt gebruikt door DeepSeek V3. Deze aanpak laat het model opschalen terwijl de rekenkosten beheersbaar blijven. Laten we de belangrijkste onderdelen op een begrijpelijke manier doornemen.
Mixture-of-Experts (MoE)-architectuur
In tegenstelling tot traditionele AI-modellen die al hun parameters voor elke taak gebruiken, activeren MoE-modellen zoals Qwen2.5-Max en DeepSeek V3 op elk moment alleen de meest relevante delen van het model.
Je kunt het zien als een team van specialisten: stel je een complexe vraag over natuurkunde, dan reageren alleen de natuurkundigen, terwijl de rest van het team inactief blijft. Door die selectieve activatie kan het model grootschalige verwerking efficiënter aan zonder extreem veel rekenkracht te vereisen.
Deze methode maakt Qwen2.5-Max zowel krachtig als schaalbaar, zodat het kan concurreren met dichte modellen zoals GPT-4o en Claude 3.5 Sonnet, terwijl het zuiniger is met resources—een dicht model is er één waarbij alle parameters voor elke input worden geactiveerd.
Training en fine-tuning
Qwen2.5-Max is getraind op 20 biljoen tokens, met een enorme spreiding aan onderwerpen, talen en contexten.
Om 20 biljoen tokens in perspectief te plaatsen: dat zijn ruwweg 15 biljoen woorden—zoveel dat het nauwelijks te bevatten is. Ter vergelijking: George Orwells 1984 telt ongeveer 89.000 woorden, wat betekent dat Qwen2.5-Max is getraind op het equivalent van 168 miljoen exemplaren van 1984.
Alleen ruwe trainingsdata garanderen echter geen AI van hoge kwaliteit, dus Alibaba heeft het verder verfijnd met:
Qwen2.5-Max-benchmarks
Qwen2.5-Max is getest tegenover andere toonaangevende AI-modellen om de prestaties op uiteenlopende taken te meten. Deze benchmarks evalueren zowel instructmodellen (fijn-afgesteld voor taken zoals chat en coderen) als basismodellen (de ruwe basis vóór fine-tuning). Dat onderscheid helpt om de cijfers in de juiste context te plaatsen.
Benchmarks voor instructmodellen
Instructmodellen zijn fijn-afgesteld voor toepassingen in de praktijk, zoals conversatie, coderen en algemene kennistaken. Qwen2.5-Max wordt hier vergeleken met modellen als GPT-4o, Claude 3.5 Sonnet, Llama 3.1 405B en DeepSeek V3.
Vergelijking van de instructmodellen. Bron: QwenLM
Laten we de resultaten kort doornemen:
Al met al blijkt Qwen2.5-Max een veelzijdig AI-model dat uitblinkt in voorkeurstaken en algemene AI-capaciteiten, terwijl het concurrerend blijft op kennis en coderen.
Benchmarks voor basismodellen
Omdat GPT-4o en Claude 3.5 Sonnet propriëtaire modellen zijn zonder publiek beschikbare basisversies, is de vergelijking beperkt tot open-weight modellen zoals Qwen2.5-Max, DeepSeek V3, LLaMA 3.1-405B en Qwen 2.5-72B. Dat geeft een duidelijker beeld van hoe Qwen2.5-Max zich verhoudt tot toonaangevende grootschalige open modellen.
Vergelijking van de basismodellen. Bron: QwenLM
Als je goed naar de bovenstaande grafiek kijkt, zie je dat die in drie secties is verdeeld op basis van het type benchmarks dat wordt geëvalueerd:
Hoe krijg je toegang tot Qwen2.5-Max
Toegang krijgen tot Qwen2.5-Max is eenvoudig, en je kunt het gratis uitproberen zonder ingewikkelde setup.
Qwen Chat
De snelste manier om Qwen2.5-Max te ervaren is via het Qwen Chat-platform. Dit is een webinterface waarmee je rechtstreeks in je browser met het model kunt praten—net zoals je ChatGPT in je browser gebruikt.
Om het Qwen2.5-Max-model te gebruiken, klik je op het modelkeuzemenu en selecteer je Qwen2.5-Max:
API-toegang via Alibaba Cloud
Voor ontwikkelaars is Qwen2.5-Max beschikbaar via de Alibaba Cloud Model Studio API. Om het te gebruiken heb je een Alibaba Cloud-account nodig, moet je de Model Studio-service activeren en een API-sleutel genereren.
Omdat de API het OpenAI-formaat volgt, zou integratie eenvoudig moeten zijn als je al met OpenAI-modellen werkt. Voor gedetailleerde installatie-instructies, ga naar de officiële Qwen2.5-Max-blog.
Conclusie
Qwen2.5-Max is Alibaba’s meest capabele AI-model tot nu toe, gebouwd om te concurreren met topmodellen zoals GPT-4o, Claude 3.5 Sonnet en DeepSeek V3.
In tegenstelling tot sommige eerdere Qwen-modellen is Qwen2.5-Max niet open-source, maar je kunt het testen via Qwen Chat of via API-toegang op Alibaba Cloud.
Gezien Alibaba’s aanhoudende investeringen in AI is het niet verrassend als er in de toekomst een redeneergericht model komt—mogelijk met Qwen 3.
Als je meer AI-nieuws wilt lezen, raad ik deze artikelen aan: