阿里巴巴刚刚发布了Qwen2.5-Max,这是其迄今为止最先进的 AI 模型。它并不是像DeepSeek R1或 OpenAI 的 o1 那样的推理模型,这意味着您看不到它的思考过程。
更合适的定位是将 Qwen2.5-Max 视为一款通用模型,竞争对手包括 GPT-4o、Claude 3.5 Sonnet,或DeepSeek V3。
在这篇博客中,我将介绍 Qwen2.5-Max 是什么、它是如何开发的、与竞品相比表现如何,以及如何访问它。
我们通过每周五发送的免费通讯 The Median,为读者带来 AI 最新动态,解析本周重点新闻。订阅即可每周用几分钟保持敏锐:
什么是 Qwen2.5-Max?
Qwen2.5-Max 是阿里巴巴迄今最强大的 AI 模型,旨在与 GPT-4o、Claude 3.5 Sonnet 和 DeepSeek V3 等顶级模型竞争。
阿里巴巴是中国最大的科技公司之一,最为人知的是其电商平台,但在云计算和人工智能方面也有深厚布局。Qwen 系列是其更广泛 AI 生态的一部分,涵盖从较小的开源权重模型到大规模的专有系统。
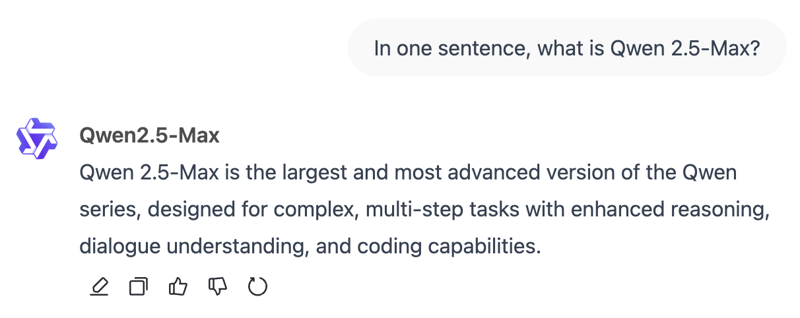
与一些早期的 Qwen 模型不同,Qwen2.5-Max 并非开源,其权重未公开提供。
Qwen2.5-Max 以 20 万亿个 token 进行训练,拥有广博的知识库和强大的通用 AI 能力。不过,它并不是像 DeepSeek R1 或 OpenAI 的 o1 那样的推理模型,不会明确展示其思考过程。不过,鉴于阿里巴巴在 AI 领域的持续扩张,未来我们可能会看到一款专注推理的模型——也许会在 Qwen 3 中出现。
Qwen2.5-Max 如何工作?
Qwen2.5-Max 采用专家混合(MoE,Mixture-of-Experts)架构,DeepSeek V3也采用了这一技术。该方法使模型在扩展规模的同时保持可控的计算成本。下面用更易理解的方式拆解其关键组件。
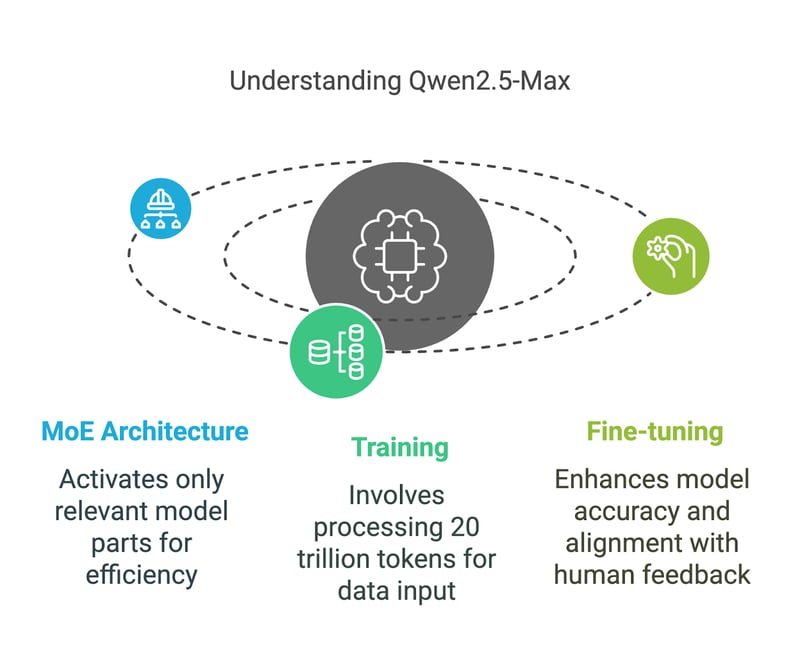
专家混合(MoE)架构
与每个任务都动用全部参数的传统 AI 模型不同,像 Qwen2.5-Max 和 DeepSeek V3 这样的 MoE 模型会在任意时刻仅激活与任务最相关的部分。
可以把它想象成一个专家团队:如果您提出一个复杂的物理问题,只有物理方面的专家会响应,其余成员保持不活动。通过这种选择性激活,模型能够更高效地处理大规模计算,而无需极端的算力。
这种方法让 Qwen2.5-Max 既强大又可扩展,使其能够与致密模型(如 GPT-4o 和 Claude 3.5 Sonnet)竞争,同时更节省资源——致密模型指的是每次输入都会激活全部参数的模型。
训练与微调
Qwen2.5-Max 使用 20 万亿个 token 进行训练,覆盖广泛的主题、语言和语境。
为了帮助理解 20 万亿个 token 的规模,这大约相当于 15 万亿个词——庞大到几乎难以想象。作一比较,乔治·奥威尔的《1984》约有 8.9 万词,这意味着 Qwen2.5-Max 的训练量相当于 1.68 亿本《1984》。
然而,仅有原始训练数据并不能保证高质量的 AI 模型,因此阿里巴巴还通过以下方式进一步优化:
Qwen2.5-Max 基准测试
Qwen2.5-Max 与其他领先 AI 模型进行了对比测试,以评估其在各类任务中的能力。这些基准既评估经过任务微调(用于聊天和编码等任务)的 instruct 模型,也评估作为微调前基础的 base 模型。理解二者差异有助于正确解读这些数据。
Instruct 模型基准
Instruct 模型面向实际应用进行微调,包括对话、编码和通用知识任务。此处将 Qwen2.5-Max 与 GPT-4o、Claude 3.5 Sonnet、Llama 3.1 405B和 DeepSeek V3 等模型进行比较。
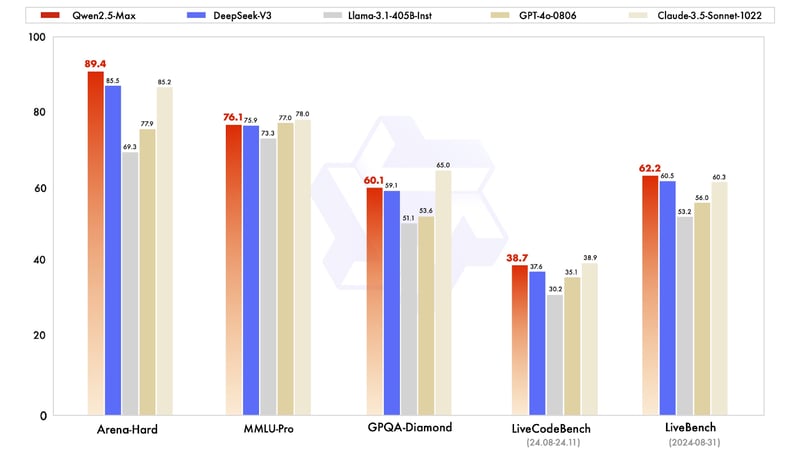
Instruct 模型对比。来源:QwenLM
下面快速解读结果:
- Arena-Hard(偏好基准):Qwen2.5-Max 得分 89.4,领先于 DeepSeek V3(85.5)和 Claude 3.5 Sonnet(85.2)。该基准近似衡量人类对 AI 回答的偏好。
- MMLU-Pro(知识与推理):Qwen2.5-Max 得分 76.1,略高于 DeepSeek V3(75.9),但稍低于领先者 Claude 3.5 Sonnet(78.0)和亚军 GPT-4o(77.0)。
- GPQA-Diamond(通识问答):Qwen2.5-Max 得分 60.1,略胜 DeepSeek V3(59.1),而 Claude 3.5 Sonnet 以 65.0 领跑。
- LiveCodeBench(编码能力):Qwen2.5-Max 得分 38.7,大致与 DeepSeek V3(37.6)相当,但低于 Claude 3.5 Sonnet(38.9)。
- LiveBench(综合能力):Qwen2.5-Max 以 62.2 领先,超过 DeepSeek V3(60.5)和 Claude 3.5 Sonnet(60.3),表明其在真实世界 AI 任务中具备广泛能力。
总体而言,Qwen2.5-Max 展现出均衡的能力,在基于偏好的任务和通用 AI 能力方面表现突出,同时在知识和编码能力上保持竞争力。
Base 模型基准
由于GPT-4o和Claude 3.5 Sonnet是专有模型,未公开基础版本,因此对比仅限于 Qwen2.5-Max、DeepSeek V3、LLaMA 3.1-405B 和 Qwen 2.5-72B 等开源权重模型。这能更清晰地展现 Qwen2.5-Max 与领先的大规模开源模型相比的实力。
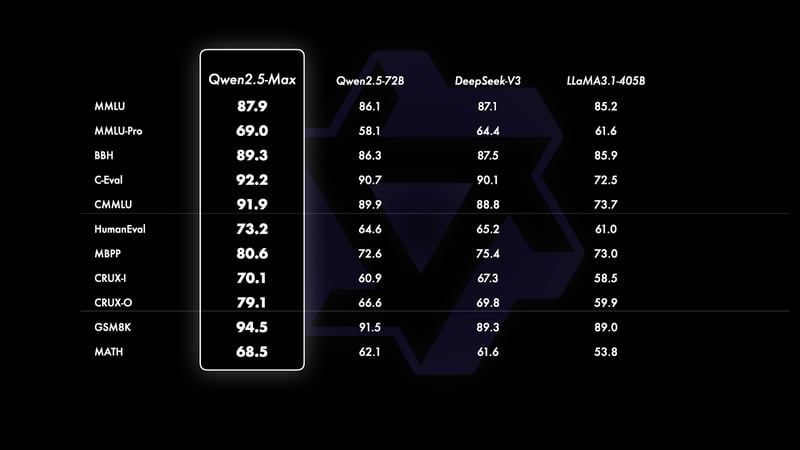
Base 模型对比。来源:QwenLM
仔细观察上图,会发现其按评估基准类型分为三个部分:
- 通用知识与语言理解(MMLU、MMLU-Pro、BBH、C-Eval、CMMU):Qwen2.5-Max 在该类别的所有基准中领先,MMLU 得分 87.9,C-Eval 得分 92.2,表现优于 DeepSeek V3 和 Llama 3.1-405B。这些基准侧重于知识的广度与深度,以及在推理情境中应用知识的能力。
- 编码与问题求解(HumanEval、MBPP、CRUX-I、CRUX-O):Qwen2.5-Max 在所有基准中同样领先,并在与编码相关的任务上表现出色,HumanEval 得分 73.2,MBPP 得分 80.6,略高于 DeepSeek V3,且明显领先于 Llama 3.1-405B。这些基准衡量编码技能、问题求解能力,以及遵循指令或独立生成方案的能力。
- 数学问题求解(GSM8K、MATH):数学推理是 Qwen2.5-Max 的强项之一,在 GSM8K 上取得 94.5,远高于 DeepSeek V3(89.3)和 Llama 3.1-405B(89.0)。不过在更侧重复杂问题求解的 MATH 上,Qwen2.5-Max 得分 68.5,虽略胜竞争对手,但仍有提升空间。
如何访问 Qwen2.5-Max
访问 Qwen2.5-Max 十分便捷,您可以免费试用,无需复杂配置。
Qwen Chat
体验 Qwen2.5-Max 的最快方式是通过Qwen Chat 平台。这是一个基于 Web 的界面,您可以像在浏览器中使用 ChatGPT 一样,直接与模型交互。
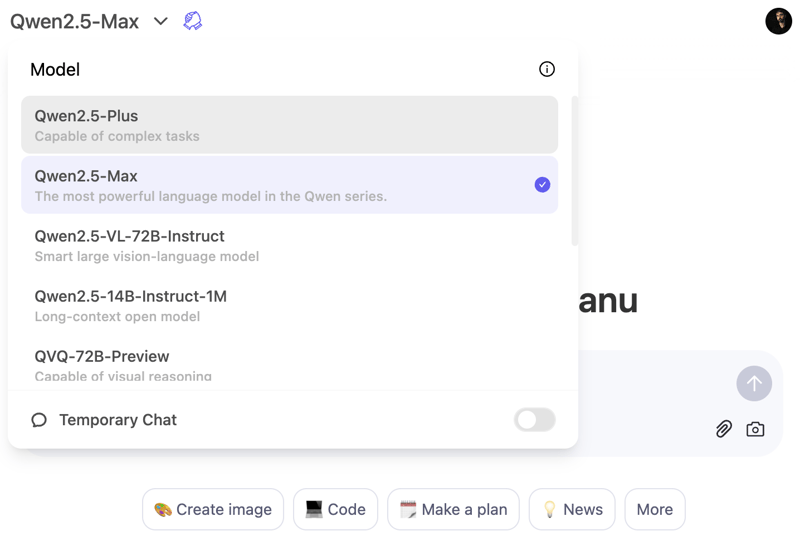
要使用 Qwen2.5-Max 模型,点击模型下拉菜单并选择 Qwen2.5-Max:
通过阿里云的 API 访问
对于开发者,Qwen2.5-Max 可通过阿里云 Model Studio API 使用。为此,您需要注册阿里云账户,开通 Model Studio 服务,并生成 API 密钥。
由于该 API 遵循 OpenAI 的格式,如果您已经熟悉 OpenAI 模型,集成应该相对简单。有关详细设置说明,请访问官方Qwen2.5-Max 博客。
结论
Qwen2.5-Max 是阿里巴巴迄今最强的 AI 模型,旨在与 GPT-4o、Claude 3.5 Sonnet 和 DeepSeek V3 等顶级模型一较高下。
不同于部分早期 Qwen 模型,Qwen2.5-Max 并非开源,但您可以通过 Qwen Chat 或在阿里云上通过 API 进行测试。
鉴于阿里巴巴在 AI 方面的持续投入,未来推出一款以推理为核心的模型并不令人意外——也许会出现在 Qwen 3 中。
如果您想阅读更多 AI 新闻,推荐以下文章:


阿里巴巴刚刚发布了Qwen2.5-Max,这是其迄今为止最先进的 AI 模型。它并不是像DeepSeek R1或 OpenAI 的 o1 那样的推理模型,这意味着您看不到它的思考过程。
更合适的定位是将 Qwen2.5-Max 视为一款通用模型,竞争对手包括 GPT-4o、Claude 3.5 Sonnet,或DeepSeek V3。
在这篇博客中,我将介绍 Qwen2.5-Max 是什么、它是如何开发的、与竞品相比表现如何,以及如何访问它。
我们通过每周五发送的免费通讯 The Median,为读者带来 AI 最新动态,解析本周重点新闻。订阅即可每周用几分钟保持敏锐:
什么是 Qwen2.5-Max?
Qwen2.5-Max 是阿里巴巴迄今最强大的 AI 模型,旨在与 GPT-4o、Claude 3.5 Sonnet 和 DeepSeek V3 等顶级模型竞争。
阿里巴巴是中国最大的科技公司之一,最为人知的是其电商平台,但在云计算和人工智能方面也有深厚布局。Qwen 系列是其更广泛 AI 生态的一部分,涵盖从较小的开源权重模型到大规模的专有系统。
与一些早期的 Qwen 模型不同,Qwen2.5-Max 并非开源,其权重未公开提供。
Qwen2.5-Max 以 20 万亿个 token 进行训练,拥有广博的知识库和强大的通用 AI 能力。不过,它并不是像 DeepSeek R1 或 OpenAI 的 o1 那样的推理模型,不会明确展示其思考过程。不过,鉴于阿里巴巴在 AI 领域的持续扩张,未来我们可能会看到一款专注推理的模型——也许会在 Qwen 3 中出现。
Qwen2.5-Max 如何工作?
Qwen2.5-Max 采用专家混合(MoE,Mixture-of-Experts)架构,DeepSeek V3也采用了这一技术。该方法使模型在扩展规模的同时保持可控的计算成本。下面用更易理解的方式拆解其关键组件。
专家混合(MoE)架构
与每个任务都动用全部参数的传统 AI 模型不同,像 Qwen2.5-Max 和 DeepSeek V3 这样的 MoE 模型会在任意时刻仅激活与任务最相关的部分。
可以把它想象成一个专家团队:如果您提出一个复杂的物理问题,只有物理方面的专家会响应,其余成员保持不活动。通过这种选择性激活,模型能够更高效地处理大规模计算,而无需极端的算力。
这种方法让 Qwen2.5-Max 既强大又可扩展,使其能够与致密模型(如 GPT-4o 和 Claude 3.5 Sonnet)竞争,同时更节省资源——致密模型指的是每次输入都会激活全部参数的模型。
训练与微调
Qwen2.5-Max 使用 20 万亿个 token 进行训练,覆盖广泛的主题、语言和语境。
为了帮助理解 20 万亿个 token 的规模,这大约相当于 15 万亿个词——庞大到几乎难以想象。作一比较,乔治·奥威尔的《1984》约有 8.9 万词,这意味着 Qwen2.5-Max 的训练量相当于 1.68 亿本《1984》。
然而,仅有原始训练数据并不能保证高质量的 AI 模型,因此阿里巴巴还通过以下方式进一步优化:
Qwen2.5-Max 基准测试
Qwen2.5-Max 与其他领先 AI 模型进行了对比测试,以评估其在各类任务中的能力。这些基准既评估经过任务微调(用于聊天和编码等任务)的 instruct 模型,也评估作为微调前基础的 base 模型。理解二者差异有助于正确解读这些数据。
Instruct 模型基准
Instruct 模型面向实际应用进行微调,包括对话、编码和通用知识任务。此处将 Qwen2.5-Max 与 GPT-4o、Claude 3.5 Sonnet、Llama 3.1 405B和 DeepSeek V3 等模型进行比较。
Instruct 模型对比。来源:QwenLM
下面快速解读结果:
总体而言,Qwen2.5-Max 展现出均衡的能力,在基于偏好的任务和通用 AI 能力方面表现突出,同时在知识和编码能力上保持竞争力。
Base 模型基准
由于GPT-4o和Claude 3.5 Sonnet是专有模型,未公开基础版本,因此对比仅限于 Qwen2.5-Max、DeepSeek V3、LLaMA 3.1-405B 和 Qwen 2.5-72B 等开源权重模型。这能更清晰地展现 Qwen2.5-Max 与领先的大规模开源模型相比的实力。
Base 模型对比。来源:QwenLM
仔细观察上图,会发现其按评估基准类型分为三个部分:
如何访问 Qwen2.5-Max
访问 Qwen2.5-Max 十分便捷,您可以免费试用,无需复杂配置。
Qwen Chat
体验 Qwen2.5-Max 的最快方式是通过Qwen Chat 平台。这是一个基于 Web 的界面,您可以像在浏览器中使用 ChatGPT 一样,直接与模型交互。
要使用 Qwen2.5-Max 模型,点击模型下拉菜单并选择 Qwen2.5-Max:
通过阿里云的 API 访问
对于开发者,Qwen2.5-Max 可通过阿里云 Model Studio API 使用。为此,您需要注册阿里云账户,开通 Model Studio 服务,并生成 API 密钥。
由于该 API 遵循 OpenAI 的格式,如果您已经熟悉 OpenAI 模型,集成应该相对简单。有关详细设置说明,请访问官方Qwen2.5-Max 博客。
结论
Qwen2.5-Max 是阿里巴巴迄今最强的 AI 模型,旨在与 GPT-4o、Claude 3.5 Sonnet 和 DeepSeek V3 等顶级模型一较高下。
不同于部分早期 Qwen 模型,Qwen2.5-Max 并非开源,但您可以通过 Qwen Chat 或在阿里云上通过 API 进行测试。
鉴于阿里巴巴在 AI 方面的持续投入,未来推出一款以推理为核心的模型并不令人意外——也许会出现在 Qwen 3 中。
如果您想阅读更多 AI 新闻,推荐以下文章: