

Program
Dasar-Dasar Kecerdasan Buatan
10 jam
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleAlibaba baru saja merilis Qwen2.5-Max, model AI tercanggih mereka hingga saat ini. Ini bukan model penalaran seperti DeepSeek R1 atau o1 milik OpenAI, artinya Anda tidak dapat melihat proses berpikirnya.
Lebih tepat menganggap Qwen2.5-Max sebagai model serba bisa dan pesaing GPT-4o, Claude 3.5 Sonnet, atau DeepSeek V3.
Di blog ini, saya akan membahas apa itu Qwen2.5-Max, bagaimana pengembangannya, bagaimana perbandingannya dengan para pesaing, dan cara mengaksesnya.
Kami terus memberi kabar terbaru tentang AI kepada pembaca melalui The Median, buletin gratis setiap Jumat yang mengulas kisah-kisah penting pekan ini. Berlangganan dan tetap terinformasi hanya dalam beberapa menit per minggu:
Qwen2.5-Max adalah model AI terkuat Alibaba sejauh ini, yang dirancang untuk bersaing dengan model papan atas seperti GPT-4o, Claude 3.5 Sonnet, dan DeepSeek V3.
Alibaba, salah satu perusahaan teknologi terbesar di Tiongkok, dikenal lewat platform e-commerce, namun juga membangun kehadiran kuat di bidang komputasi awan dan kecerdasan buatan. Seri Qwen merupakan bagian dari ekosistem AI yang lebih luas, mulai dari model open-weight yang lebih kecil hingga sistem kepemilikan skala besar.
Berbeda dengan beberapa model Qwen sebelumnya, Qwen2.5-Max bukan open-source, artinya bobot modelnya tidak tersedia untuk publik.
Dilatih pada 20 triliun token, Qwen2.5-Max memiliki basis pengetahuan yang sangat luas dan kapabilitas AI umum yang kuat. Namun, ini bukan model penalaran seperti DeepSeek R1 atau o1 milik OpenAI, sehingga tidak secara eksplisit menampilkan proses berpikirnya. Meski begitu, mengingat ekspansi AI Alibaba yang berkelanjutan, bukan tidak mungkin kita akan melihat model khusus penalaran di masa depan—mungkin dengan Qwen 3.
Qwen2.5-Max menggunakan arsitektur Mixture-of-Experts (MoE), teknik yang juga digunakan oleh DeepSeek V3. Pendekatan ini memungkinkan model untuk diskalakan sambil menjaga biaya komputasi tetap terkendali. Mari kita uraikan komponen utamanya dengan cara yang mudah dipahami.
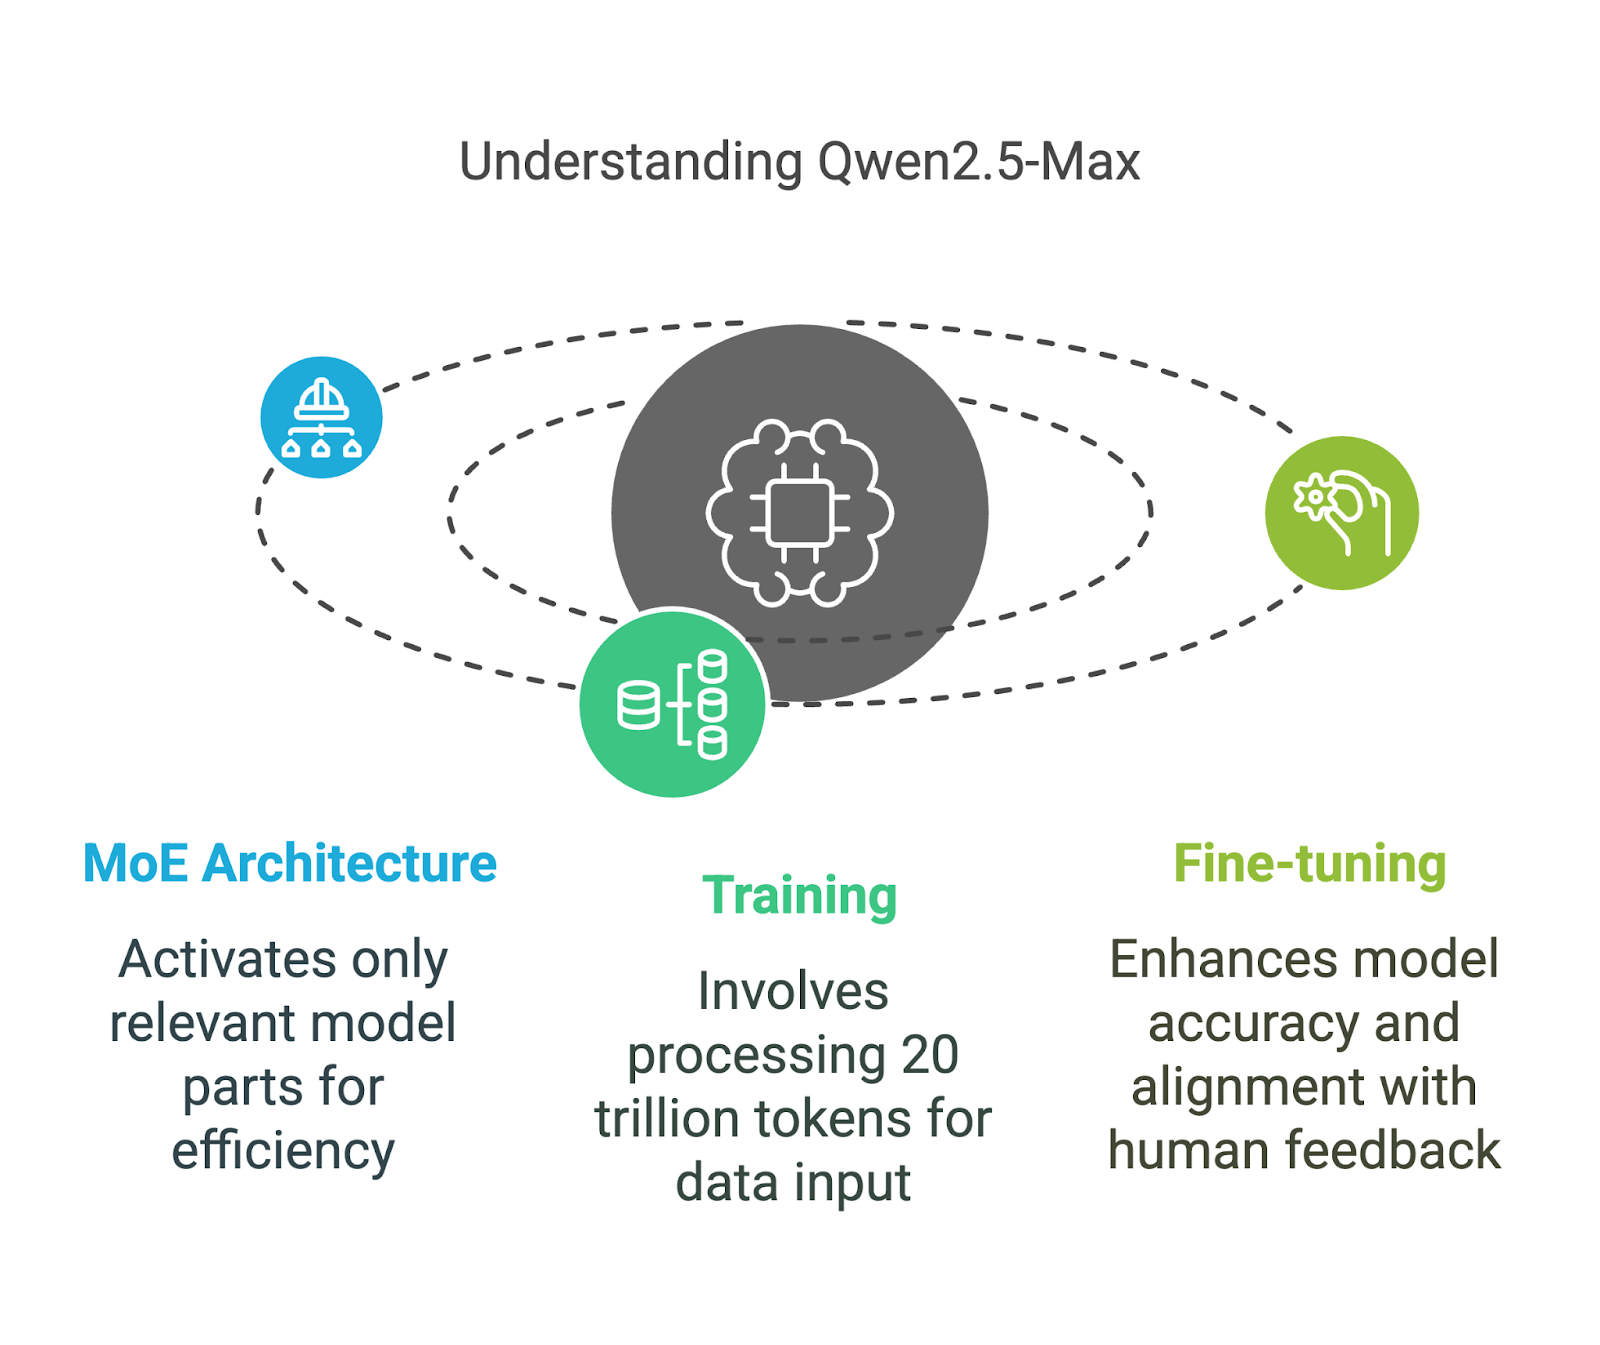
Tidak seperti model AI tradisional yang menggunakan seluruh parameternya untuk setiap tugas, model MoE seperti Qwen2.5-Max dan DeepSeek V3 hanya mengaktifkan bagian model yang paling relevan pada saat tertentu.
Bayangkan seperti tim para spesialis: jika Anda menanyakan pertanyaan kompleks tentang fisika, hanya pakar fisika yang merespons, sementara yang lain tetap tidak aktif. Aktivasi selektif ini membuat model dapat menangani pemrosesan berskala besar secara lebih efisien tanpa memerlukan daya komputasi yang ekstrem.
Metode ini membuat Qwen2.5-Max sekaligus bertenaga dan dapat diskalakan, memungkinkannya bersaing dengan model padat seperti GPT-4o dan Claude 3.5 Sonnet sambil lebih hemat sumber daya—model padat adalah model di mana semua parameter diaktifkan untuk setiap masukan.
Qwen2.5-Max dilatih pada 20 triliun token, mencakup beragam topik, bahasa, dan konteks.
Untuk memberi gambaran tentang 20 triliun token, itu kira-kira setara dengan 15 triliun kata—jumlah yang begitu besar hingga sulit dibayangkan. Sebagai perbandingan, 1984 karya George Orwell berisi sekitar 89.000 kata, yang berarti Qwen2.5-Max telah dilatih pada setara dengan 168 juta salinan 1984.
Namun, data pelatihan mentah saja tidak menjamin kualitas model AI yang tinggi, sehingga Alibaba memolesnya lebih lanjut dengan:
Qwen2.5-Max telah diuji terhadap model AI terkemuka lainnya untuk mengukur kemampuannya di berbagai tugas. Benchmark ini mengevaluasi baik model instruct (yang di-fine-tune untuk tugas seperti chat dan pemrograman) maupun model base (yang menjadi fondasi mentah sebelum fine-tuning). Memahami perbedaan ini membantu memperjelas makna angka-angka tersebut.
Model instruct di-fine-tune untuk aplikasi dunia nyata, termasuk percakapan, pemrograman, dan tugas pengetahuan umum. Qwen2.5-Max dibandingkan di sini dengan model seperti GPT-4o, Claude 3.5 Sonnet, Llama 3.1 405B, dan DeepSeek V3.
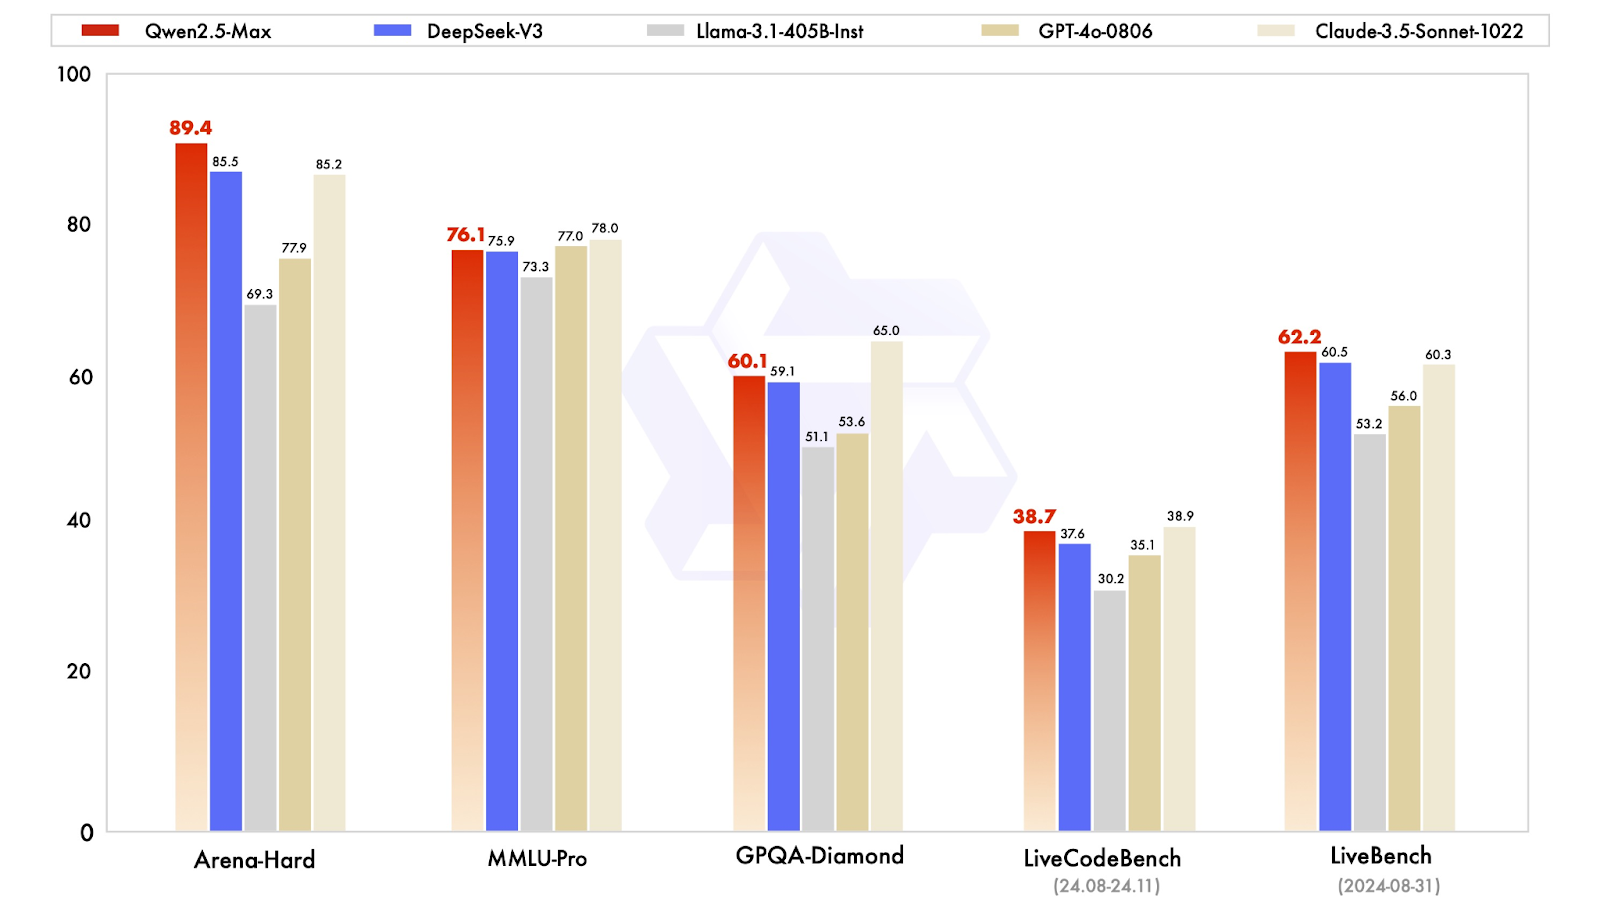
Perbandingan model instruct. Sumber: QwenLM
Mari kita ringkas hasilnya dengan cepat:
Secara keseluruhan, Qwen2.5-Max terbukti sebagai model AI serba bisa, unggul dalam tugas berbasis preferensi dan kapabilitas AI umum sambil tetap kompetitif dalam pengetahuan dan kemampuan pemrograman.
Karena GPT-4o dan Claude 3.5 Sonnet adalah model kepemilikan tanpa versi base yang tersedia untuk publik, perbandingan dibatasi pada model open-weight seperti Qwen2.5-Max, DeepSeek V3, LLaMA 3.1-405B, dan Qwen 2.5-72B. Ini memberikan gambaran yang lebih jelas tentang posisi Qwen2.5-Max dibandingkan model open skala besar terkemuka.
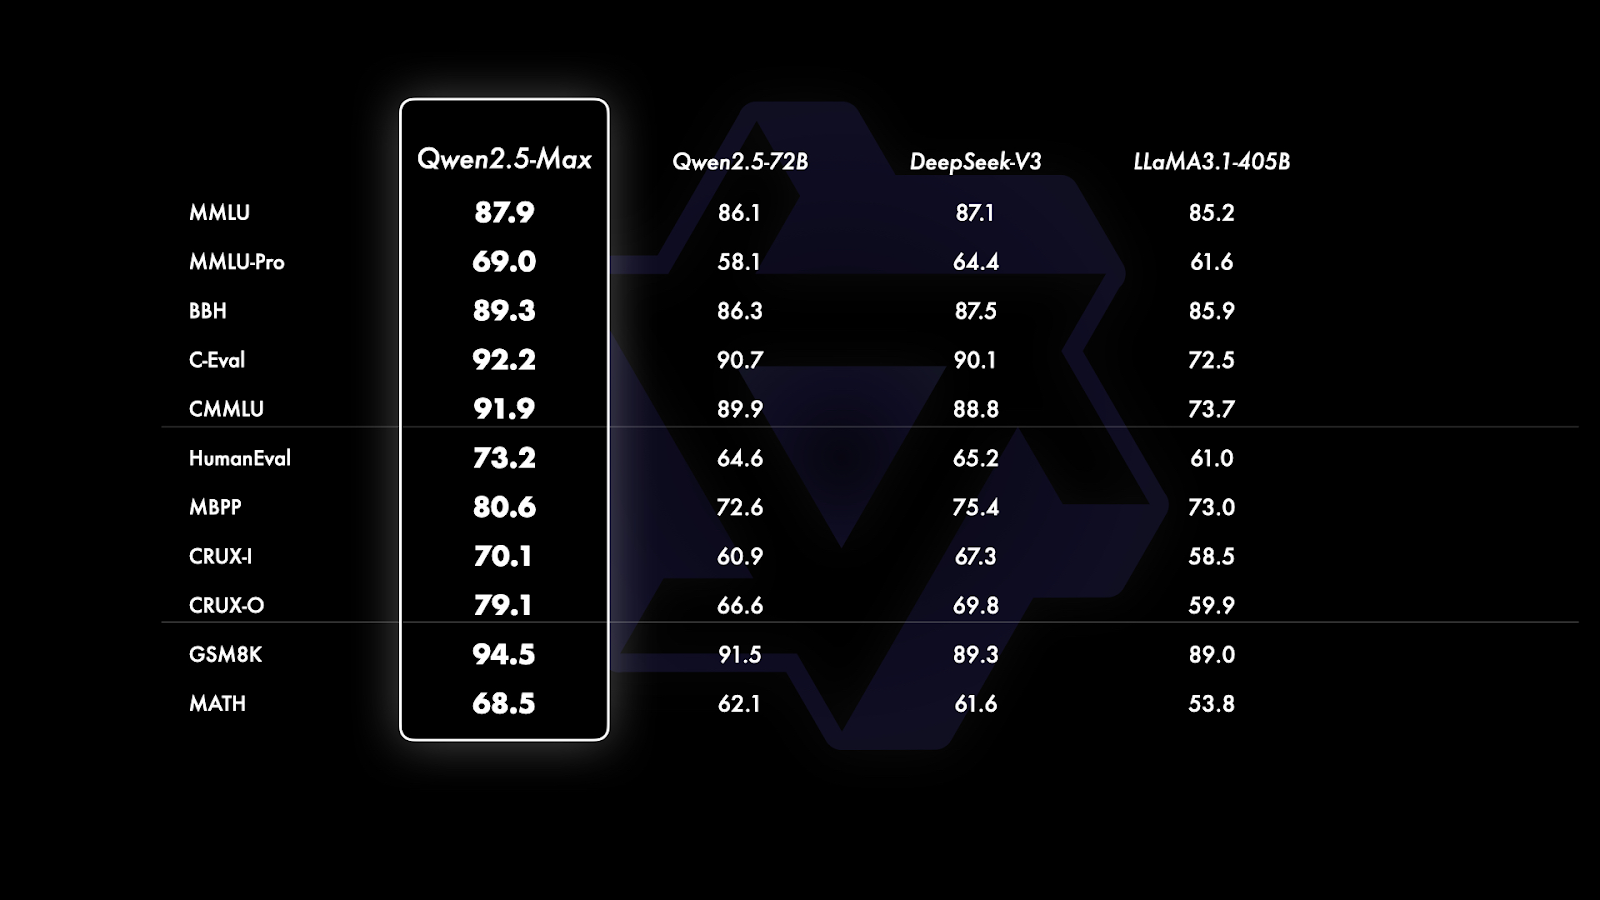
Perbandingan model base. Sumber: QwenLM
Jika Anda memperhatikan grafik di atas, grafik tersebut dibagi menjadi tiga bagian berdasarkan jenis benchmark yang dievaluasi:
Mengakses Qwen2.5-Max cukup mudah, dan Anda dapat mencobanya gratis tanpa pengaturan yang rumit.
Cara tercepat untuk menjajal Qwen2.5-Max adalah melalui platform Qwen Chat. Ini adalah antarmuka berbasis web yang memungkinkan Anda berinteraksi langsung dengan model di peramban—seperti saat Anda menggunakan ChatGPT di peramban.
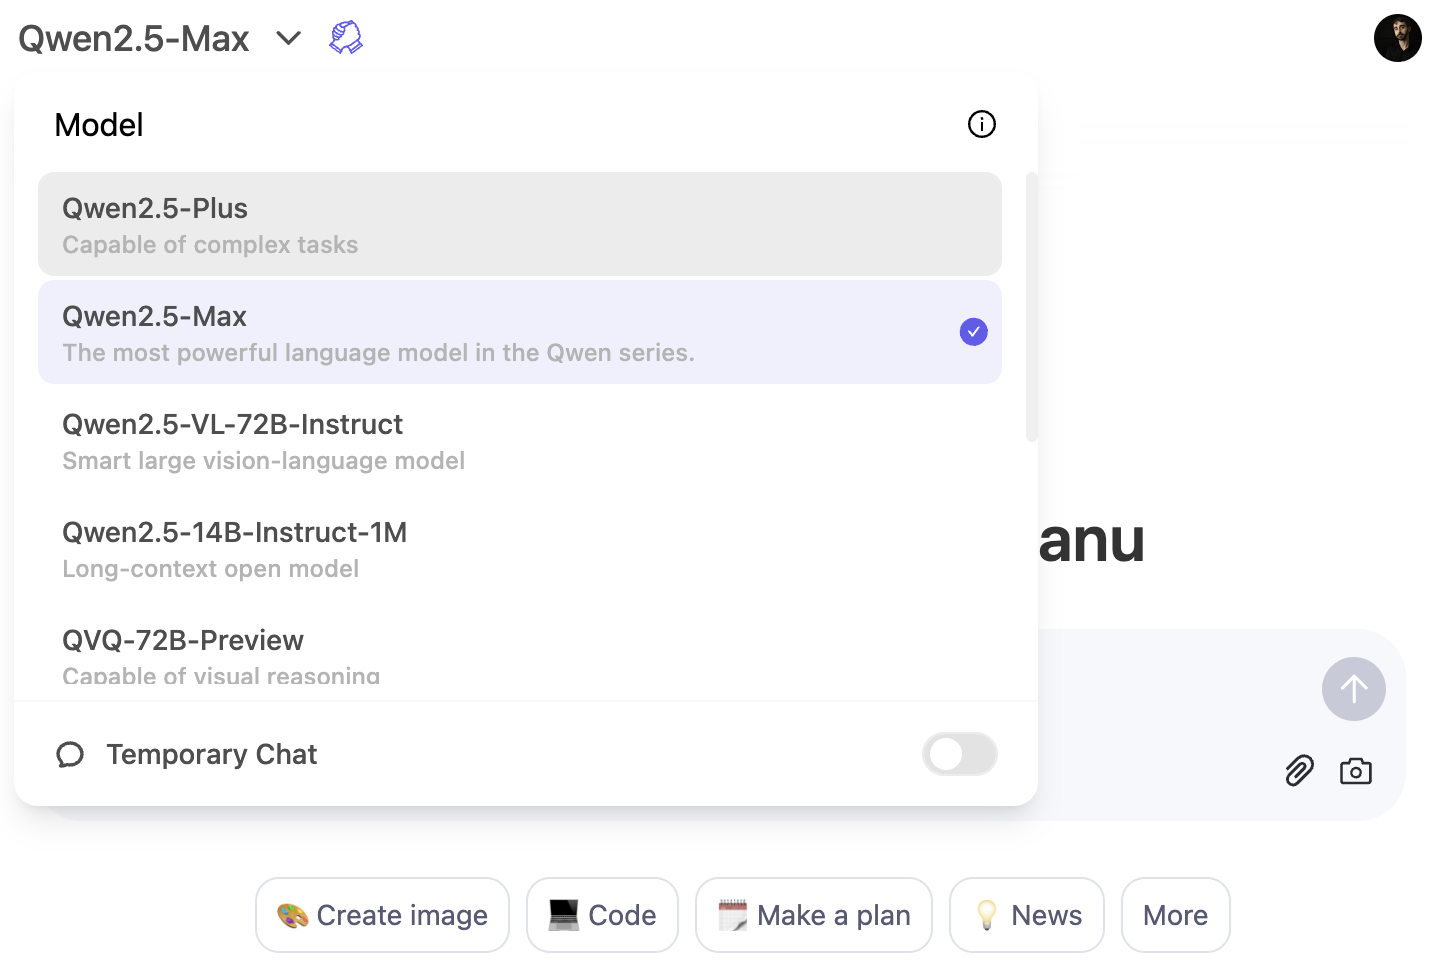
Untuk menggunakan model Qwen2.5-Max, klik menu dropdown model dan pilih Qwen2.5-Max:
Bagi developer, Qwen2.5-Max tersedia melalui Alibaba Cloud Model Studio API. Untuk menggunakannya, Anda perlu mendaftar akun Alibaba Cloud, mengaktifkan layanan Model Studio, dan membuat kunci API.
Karena API mengikuti format OpenAI, integrasi seharusnya mudah jika Anda sudah familier dengan model OpenAI. Untuk petunjuk penyiapan secara rinci, kunjungi blog Qwen2.5-Max resmi.
Qwen2.5-Max adalah model AI paling mumpuni milik Alibaba sejauh ini, dibangun untuk bersaing dengan model papan atas seperti GPT-4o, Claude 3.5 Sonnet, dan DeepSeek V3.
Berbeda dengan beberapa model Qwen sebelumnya, Qwen2.5-Max bukan open-source, tetapi tersedia untuk diuji melalui Qwen Chat atau melalui akses API di Alibaba Cloud.
Mengingat investasi Alibaba yang berkelanjutan di bidang AI, bukan hal mengejutkan jika kita melihat model berfokus penalaran di masa depan—mungkin dengan Qwen 3.
Jika Anda ingin membaca lebih banyak kabar AI, saya merekomendasikan artikel berikut:
Pelajari AI dengan kursus-kursus ini!
Program
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt



