

Program
AI Temelleri
10 sa
Alıştırma and program your progress.
Google Ile Devam EdinAlibaba, şimdiye kadarki en gelişmiş yapay zeka modeli olan Qwen2.5-Max'i duyurdu. Bu, DeepSeek R1 veya OpenAI’nin o1 modeli gibi bir muhakeme modeli değil; yani düşünme sürecini göremezsiniz.
Qwen2.5-Max’i, GPT-4o, Claude 3.5 Sonnet veya DeepSeek V3 ile rekabet eden genel amaçlı bir model olarak düşünmek daha doğru olur.
Bu yazıda Qwen2.5-Max’in ne olduğunu, nasıl geliştirildiğini, rakiplerle nasıl karşılaştırıldığını ve nasıl erişebileceğinizi ele alacağım.
Okurlarımızı en güncel yapay zeka gelişmelerinden haberdar etmek için her Cuma haftanın öne çıkan haberlerini derleyen ücretsiz bültenimiz The Median’ı gönderiyoruz. Abone olun, haftada sadece birkaç dakikada güncel kalın:
Qwen2.5-Max, Alibaba’nın bugüne kadarki en güçlü yapay zeka modeli olup GPT-4o, Claude 3.5 Sonnet ve DeepSeek V3 gibi üst düzey modellerle rekabet etmek üzere tasarlanmıştır.
Çin’in en büyük teknoloji şirketlerinden biri olan Alibaba, e-ticaret platformlarıyla tanınsa da bulut bilişim ve yapay zeka alanlarında da güçlü bir varlık gösteriyor. Qwen serisi, küçük açık ağırlıklı modellerden büyük ölçekli tescilli sistemlere kadar uzanan daha geniş bir yapay zeka ekosisteminin parçasıdır.
Önceki bazı Qwen modellerinin aksine, Qwen2.5-Max açık kaynak değildir; yani ağırlıkları kamuya açık değildir.
20 trilyon belirteç üzerinde eğitilen Qwen2.5-Max, çok geniş bir bilgi tabanına ve güçlü genel yapay zeka yeteneklerine sahiptir. Ancak DeepSeek R1 veya OpenAI’nin o1 modeli gibi bir muhakeme modeli değildir; yani düşünce sürecini açıkça göstermez. Bununla birlikte, Alibaba’nın yapay zekaya yönelik devam eden yatırımları göz önüne alındığında, gelecekte muhtemelen Qwen 3 ile birlikte özel bir muhakeme modelini görebiliriz.
Qwen2.5-Max, Uzman Karışımı (MoE) mimarisini kullanır; bu teknik aynı zamanda DeepSeek V3 tarafından da kullanılıyor. Bu yaklaşım, hesaplama maliyetlerini yönetilebilir tutarken modelin ölçeklenmesine olanak tanır. Hadi, başlıca bileşenlerini anlaşılır şekilde inceleyelim.
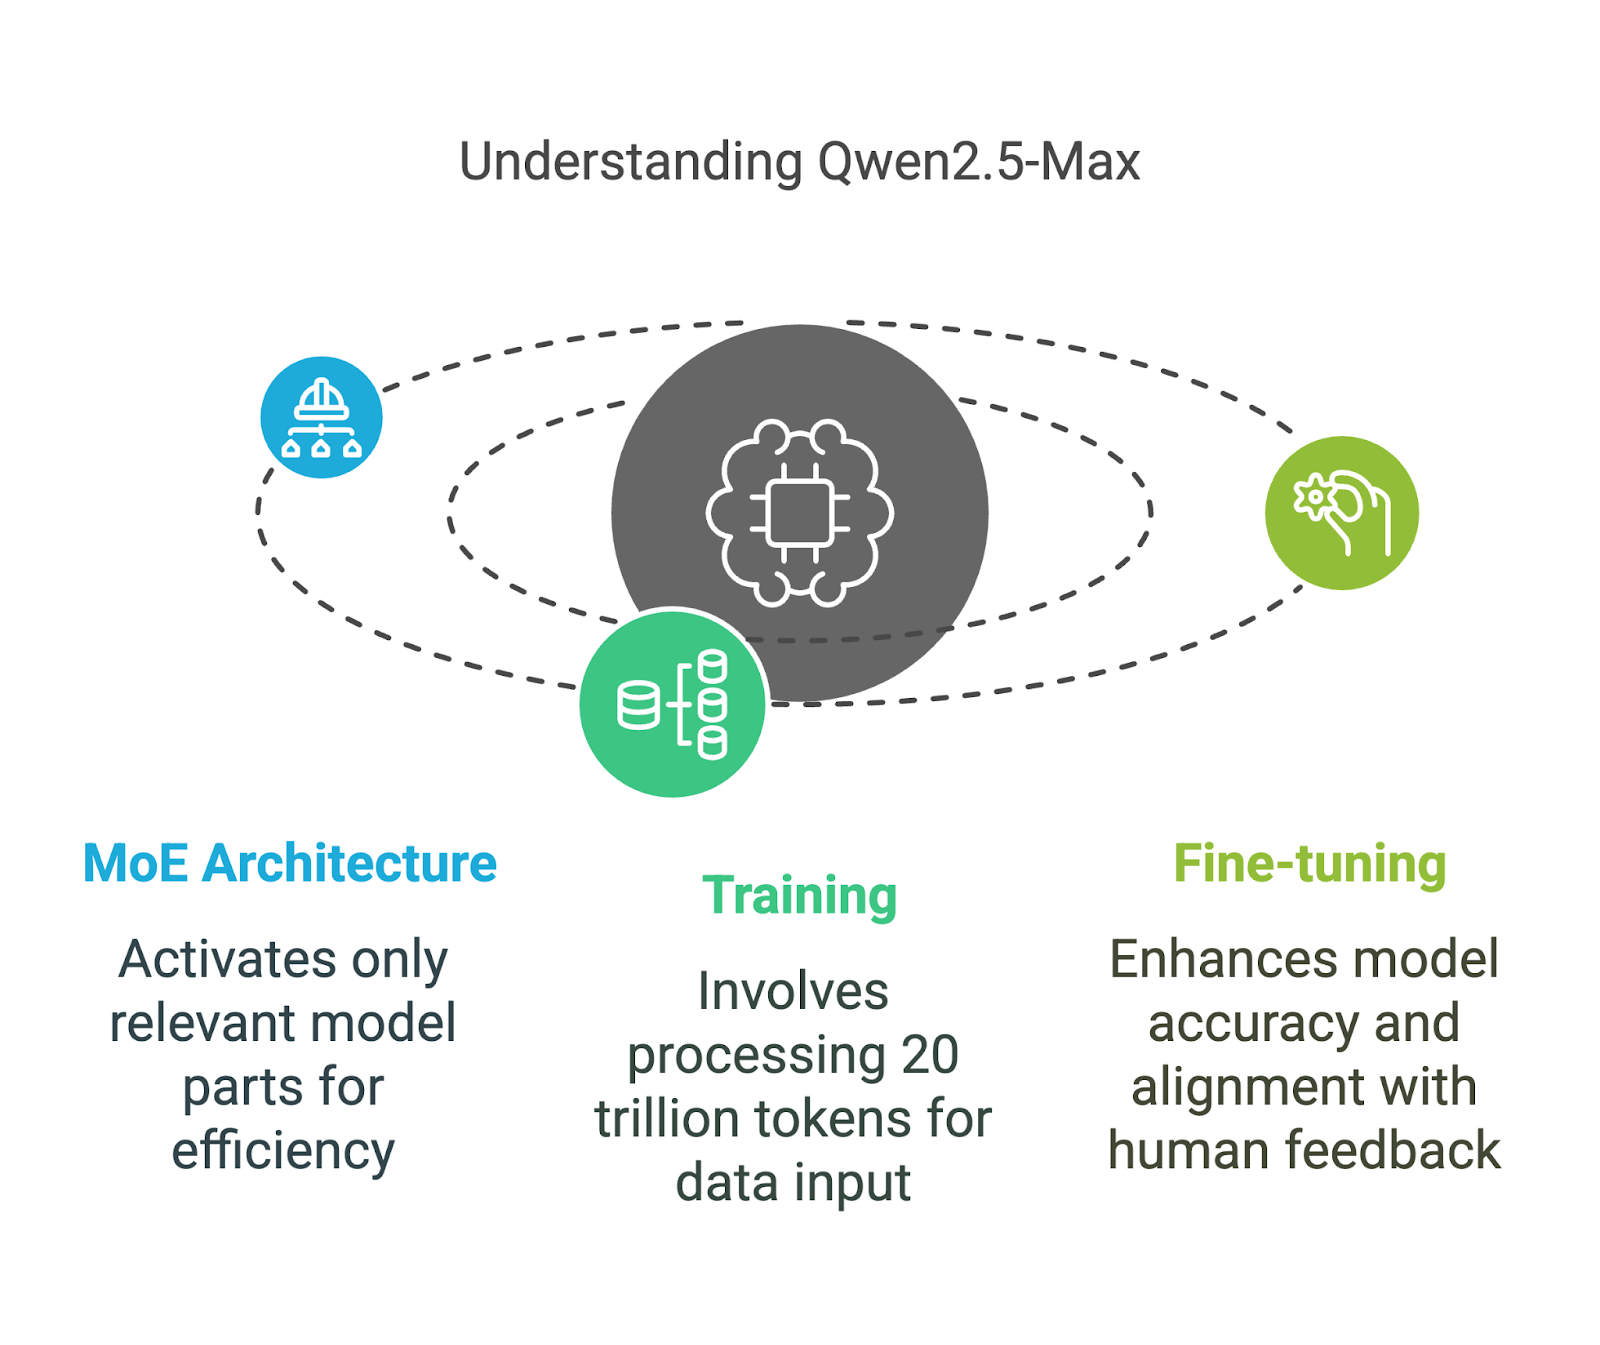
Her görev için tüm parametrelerini kullanan geleneksel yapay zeka modellerinden farklı olarak, Qwen2.5-Max ve DeepSeek V3 gibi MoE modelleri, herhangi bir anda yalnızca en ilgili bölümleri etkinleştirir.
Bunu, uzmanlardan oluşan bir ekip gibi düşünebilirsiniz: Fizikle ilgili karmaşık bir soru sorarsanız, yalnızca fizik uzmanları yanıt verir; ekibin geri kalanı pasif kalır. Bu seçici etkinleştirme, modelin aşırı miktarda hesaplama gücü gerektirmeden büyük ölçekli işlemleri daha verimli yönetmesini sağlar.
Bu yöntem, Qwen2.5-Max’i hem güçlü hem de ölçeklenebilir kılar; yoğun modeller olan GPT-4o ve Claude 3.5 Sonnet ile rekabet etmesine olanak tanırken kaynak kullanımını daha verimli hale getirir—yoğun model, her girdi için tüm parametrelerin etkinleştirildiği modeldir.
Qwen2.5-Max, çok geniş konu, dil ve bağlam yelpazesini kapsayan 20 trilyon belirteç üzerinde eğitildi.
20 trilyon belirteci gözünüzde canlandırmak için: bu yaklaşık 15 trilyon kelimeye denk gelir—kavraması güç bir büyüklük. Karşılaştırma için, George Orwell’in 1984 adlı kitabı yaklaşık 89.000 kelime içerir; bu da Qwen2.5-Max’in 1984’ün 168 milyon kopyasına eşdeğer veride eğitildiği anlamına gelir.
Ancak ham eğitim verisi tek başına yüksek kaliteli bir yapay zeka modeli garanti etmez; bu nedenle Alibaba aşağıdakilerle modeli daha da iyileştirdi:
Qwen2.5-Max, yeteneklerini çeşitli görevlerde ölçmek için diğer önde gelen yapay zeka modellerine karşı test edildi. Bu kıyaslamalar, hem sohbet ve kodlama gibi görevlere ince ayarlı talimat (instruct) modellerini hem de ince ayar öncesi ham temel işlevi gören temel (base) modellerini değerlendirir. Bu ayrımı anlamak, sayıların gerçekte ne ifade ettiğini netleştirir.
Instruct modelleri; sohbet, kodlama ve genel bilgi görevleri dahil olmak üzere gerçek dünya uygulamaları için ince ayarlanmıştır. Qwen2.5-Max burada GPT-4o, Claude 3.5 Sonnet, Llama 3.1 405B ve DeepSeek V3 gibi modellerle karşılaştırılıyor.
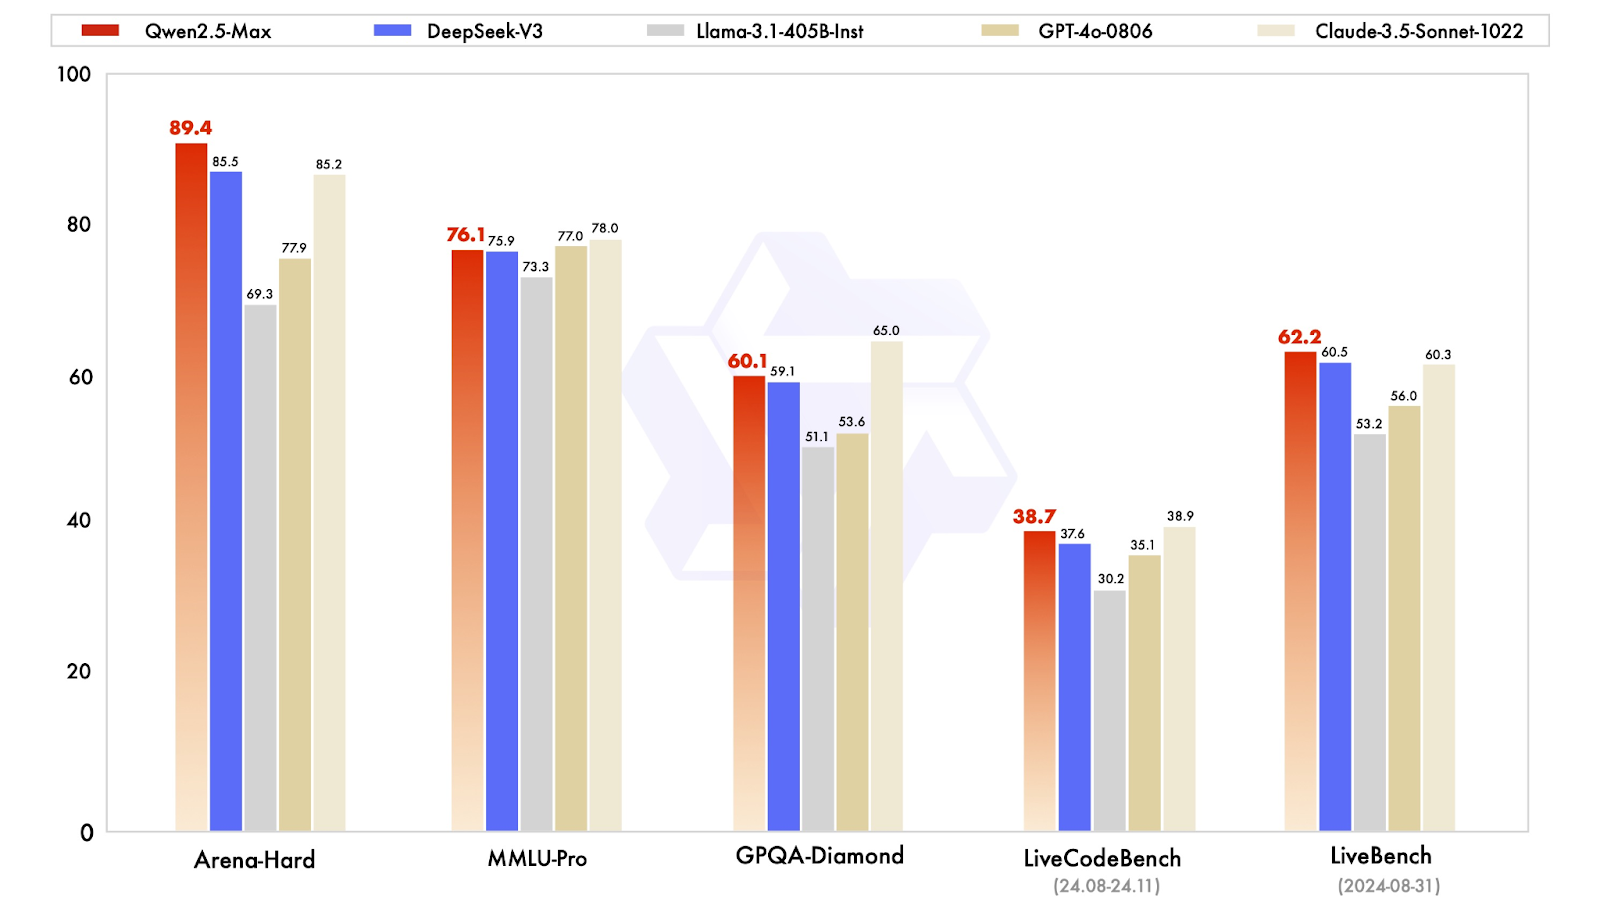
Instruct modellerinin karşılaştırması. Kaynak: QwenLM
Sonuçları kısaca özetleyelim:
Genel olarak Qwen2.5-Max, tercih temelli görevlerde ve genel yapay zeka yeteneklerinde öne çıkan, bilgi ve kodlama becerilerinde rekabetçi kalmayı başaran, dengeli bir model olduğunu kanıtlıyor.
GPT-4o ve Claude 3.5 Sonnet gibi modellerin kamuya açık base sürümleri bulunmadığından, karşılaştırma Qwen2.5-Max, DeepSeek V3, LLaMA 3.1-405B ve Qwen 2.5-72B gibi açık ağırlıklı modellerle sınırlıdır. Bu da Qwen2.5-Max’in önde gelen büyük ölçekli açık modeller karşısındaki yerini daha net ortaya koyar.
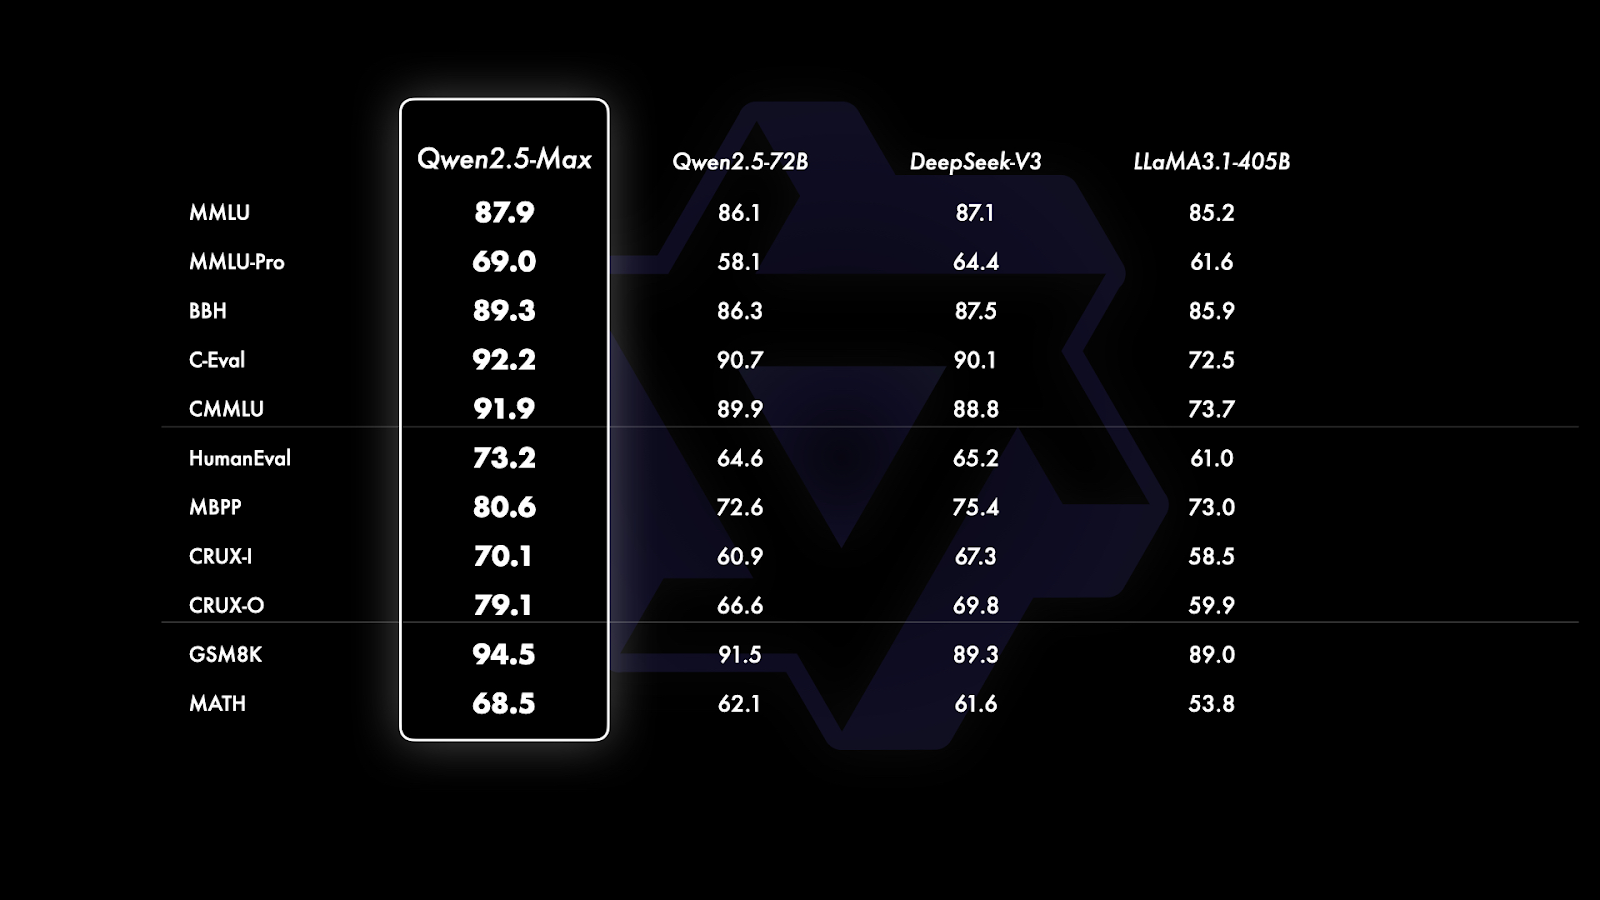
Base modellerin karşılaştırması. Kaynak: QwenLM
Yukarıdaki grafiğe yakından bakarsanız, değerlendirilen kıyaslama türlerine göre üç bölüme ayrıldığını görürsünüz:
Qwen2.5-Max’e erişmek oldukça kolay; herhangi bir karmaşık kurulum olmadan ücretsiz deneyebilirsiniz.
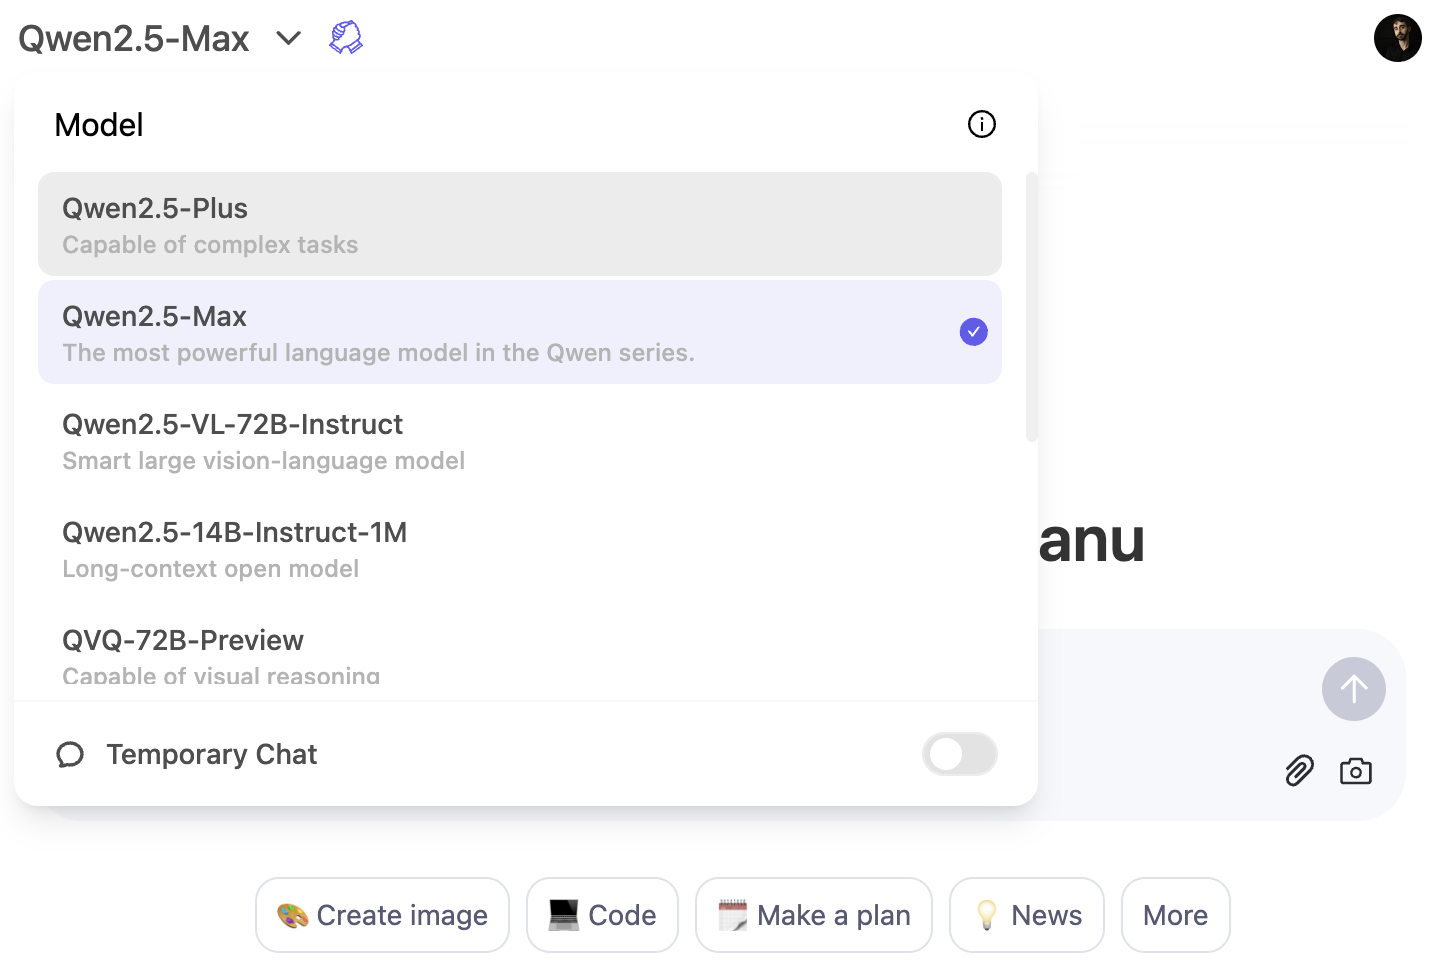
Qwen2.5-Max’i deneyimlemenin en hızlı yolu Qwen Chat platformudur. Bu, modeli doğrudan tarayıcınızda kullanmanıza olanak tanıyan web tabanlı bir arayüzdür—tıpkı tarayıcıda ChatGPT kullanır gibi.
Qwen2.5-Max modelini kullanmak için model açılır menüsüne tıklayın ve Qwen2.5-Max’i seçin:
Geliştiriciler için Qwen2.5-Max, Alibaba Cloud Model Studio API aracılığıyla kullanılabilir. Kullanmak için bir Alibaba Cloud hesabı açmanız, Model Studio hizmetini etkinleştirmeniz ve bir API anahtarı oluşturmanız gerekir.
API, OpenAI biçimini izlediği için OpenAI modellerine aşinaysanız entegrasyon oldukça kolay olmalıdır. Ayrıntılı kurulum talimatları için resmi Qwen2.5-Max blogunu ziyaret edin.
Qwen2.5-Max, Alibaba’nın şimdiye kadarki en yetenekli yapay zeka modeli olup GPT-4o, Claude 3.5 Sonnet ve DeepSeek V3 gibi üst düzey modellerle rekabet etmek üzere geliştirildi.
Önceki bazı Qwen modellerinin aksine Qwen2.5-Max açık kaynak değildir; ancak Qwen Chat üzerinden veya Alibaba Cloud’da API erişimiyle test edilebilir.
Alibaba’nın yapay zekaya süregelen yatırımları göz önünde bulundurulduğunda, gelecekte—muhtemelen Qwen 3 ile—muhakemeye odaklanan bir model görmemiz şaşırtıcı olmayacaktır.
Daha fazla yapay zeka haberi okumak isterseniz şu yazıları öneririm:
Bu kurslarla yapay zekayı öğrenin!
Program
Kurs
Alıştırma and program your progress.
Google Ile Devam Edinblog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



