

Programma
Nozioni di base sull'intelligenza artificiale
10 ore
Pratica and corso your progress.
Continua Con GoogleAlibaba ha appena rilasciato Qwen2.5-Max, il suo modello di IA più avanzato finora. Non è un modello di ragionamento come DeepSeek R1 o l’o1 di OpenAI, il che significa che non puoi vedere il suo processo di pensiero.
È meglio considerare Qwen2.5-Max come un modello generalista e un concorrente di GPT-4o, Claude 3.5 Sonnet o DeepSeek V3.
In questo blog, vedremo cos’è Qwen2.5-Max, come è stato sviluppato, come si confronta con la concorrenza e come puoi accedervi.
Teniamo aggiornatə i lettori sulle ultime novità dell’IA inviando The Median, la nostra newsletter gratuita del venerdì che spiega le notizie chiave della settimana. Iscriviti e resta sul pezzo in pochi minuti a settimana:
Qwen2.5-Max è il modello di IA più potente di Alibaba fino a oggi, progettato per competere con modelli di fascia alta come GPT-4o, Claude 3.5 Sonnet e DeepSeek V3.
Alibaba, una delle più grandi aziende tech della Cina, è nota soprattutto per le sue piattaforme di e-commerce, ma ha costruito anche una solida presenza nel cloud computing e nell’intelligenza artificiale. La serie Qwen fa parte di un ecosistema di IA più ampio, che va da modelli open-weight più piccoli a sistemi proprietari su larga scala.
A differenza di alcuni modelli Qwen precedenti, Qwen2.5-Max non è open-source, quindi i suoi pesi non sono disponibili pubblicamente.
Addestrato su 20.000 miliardi di token, Qwen2.5-Max dispone di una base di conoscenze vastissima e di forti capacità generali di IA. Tuttavia, non è un modello di ragionamento come DeepSeek R1 o l’o1 di OpenAI, quindi non mostra esplicitamente il proprio processo di pensiero. Detto questo, dato l’espansione continua di Alibaba nell’IA, potremmo vedere un modello dedicato al ragionamento in futuro—forse con Qwen 3.
Qwen2.5-Max utilizza un’architettura Mixture-of-Experts (MoE), una tecnica usata anche da DeepSeek V3. Questo approccio permette al modello di scalare mantenendo sotto controllo i costi computazionali. Vediamo i componenti chiave in modo semplice.
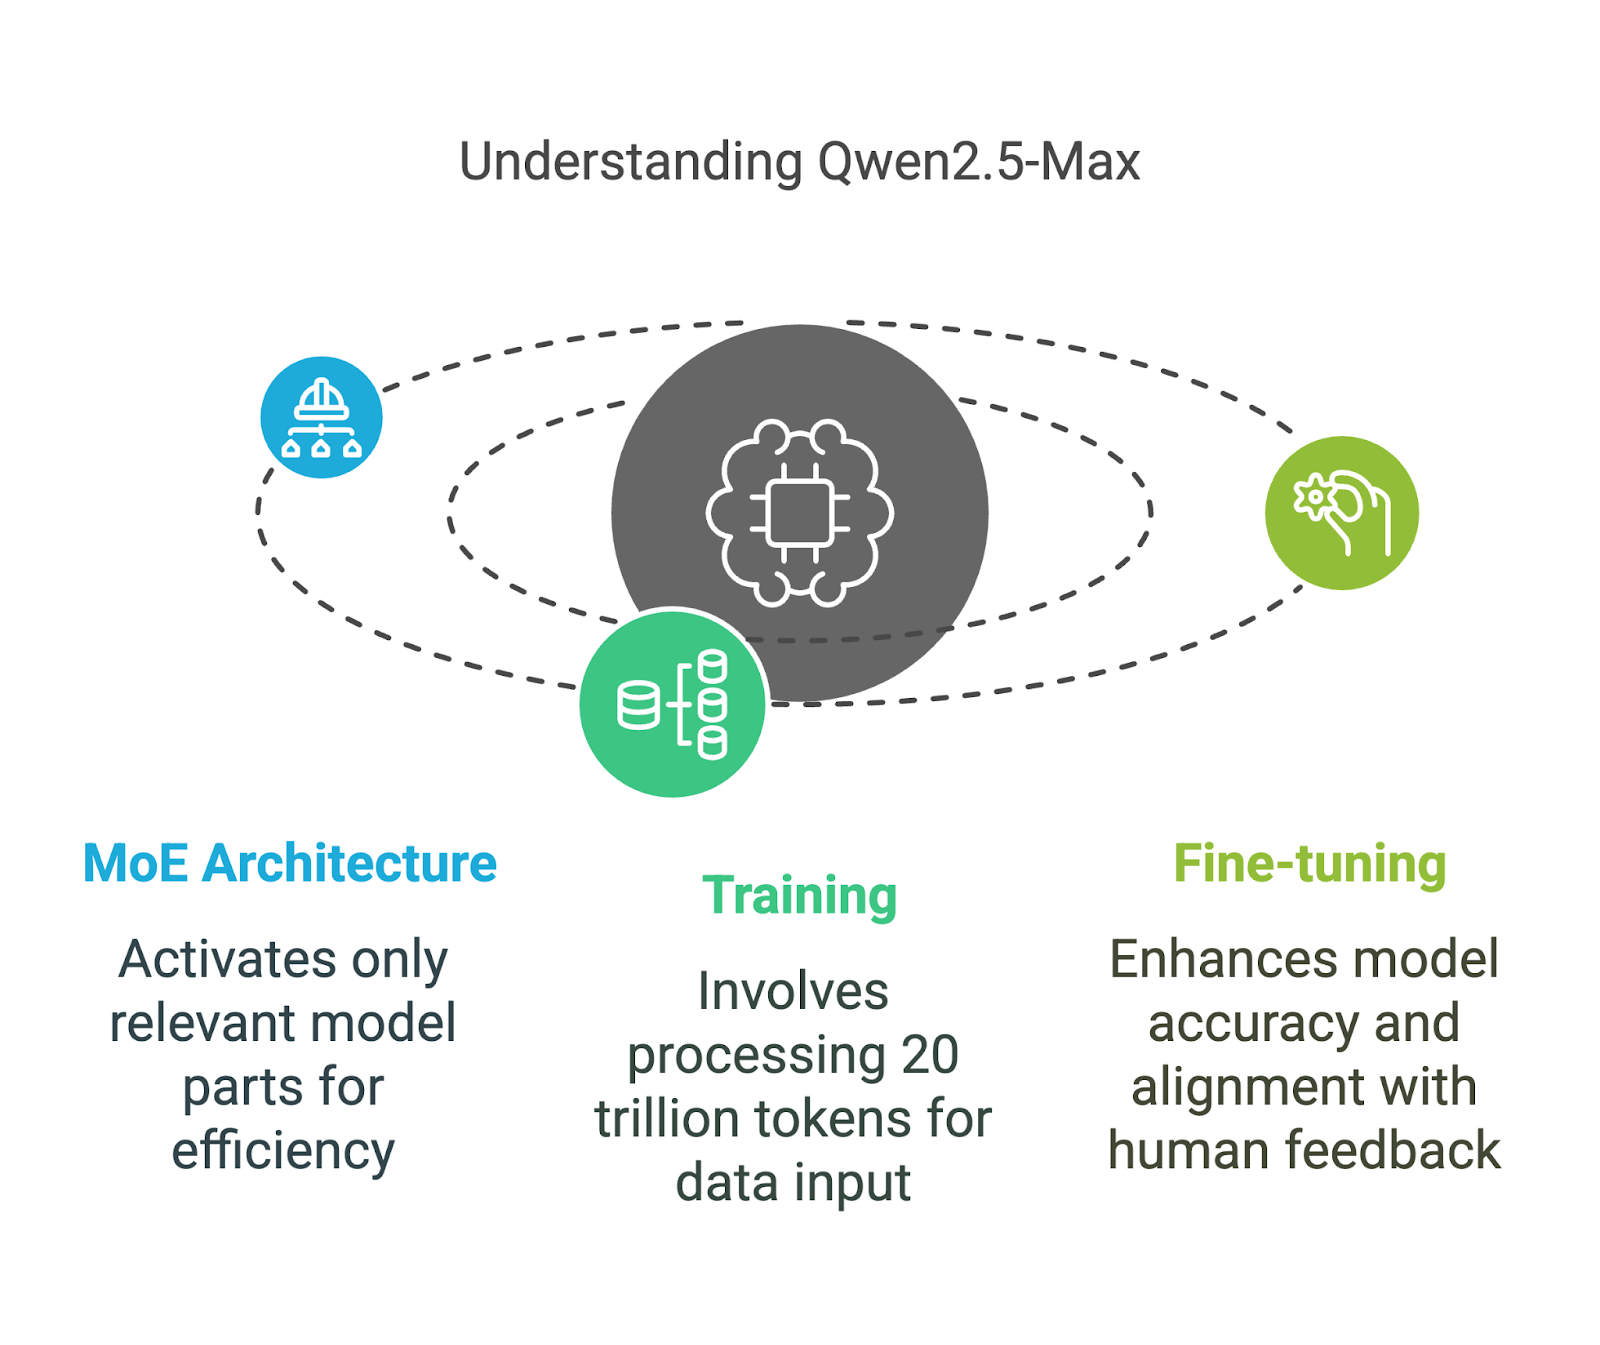
A differenza dei modelli di IA tradizionali che usano tutti i propri parametri per ogni compito, i modelli MoE come Qwen2.5-Max e DeepSeek V3 attivano solo le parti più rilevanti del modello in un dato momento.
Puoi immaginarlo come una squadra di specialisti: se fai una domanda complessa di fisica, rispondono solo gli esperti di fisica, mentre il resto della squadra rimane inattivo. Questa attivazione selettiva consente di gestire l’elaborazione su larga scala in modo più efficiente senza richiedere quantità estreme di potenza di calcolo.
Questo metodo rende Qwen2.5-Max sia potente che scalabile, permettendogli di competere con i modelli densi come GPT-4o e Claude 3.5 Sonnet pur essendo più efficiente in termini di risorse—un modello denso è quello in cui tutti i parametri sono attivati per ogni input.
Qwen2.5-Max è stato addestrato su 20.000 miliardi di token, coprendo un’ampia gamma di argomenti, lingue e contesti.
Per dare un’idea di cosa significhi 20.000 miliardi di token, sono circa 15.000 miliardi di parole—una quantità talmente vasta da essere difficile da concepire. Per confronto, 1984 di George Orwell contiene circa 89.000 parole, il che significa che Qwen2.5-Max è stato addestrato sull’equivalente di 168 milioni di copie di 1984.
Tuttavia, i soli dati grezzi di addestramento non garantiscono un modello di IA di alta qualità, quindi Alibaba lo ha ulteriormente perfezionato con:
Qwen2.5-Max è stato testato rispetto ad altri modelli di IA leader per misurarne le capacità su vari compiti. Questi benchmark valutano sia i modelli instruct (ottimizzati per compiti come chat e coding) sia i modelli base (la base grezza prima del fine-tuning). Capire questa distinzione aiuta a chiarire il reale significato dei numeri.
I modelli instruct sono ottimizzati per applicazioni reali, tra cui conversazione, coding e compiti di conoscenza generale. Qui Qwen2.5-Max è confrontato con modelli come GPT-4o, Claude 3.5 Sonnet, Llama 3.1 405B e DeepSeek V3.
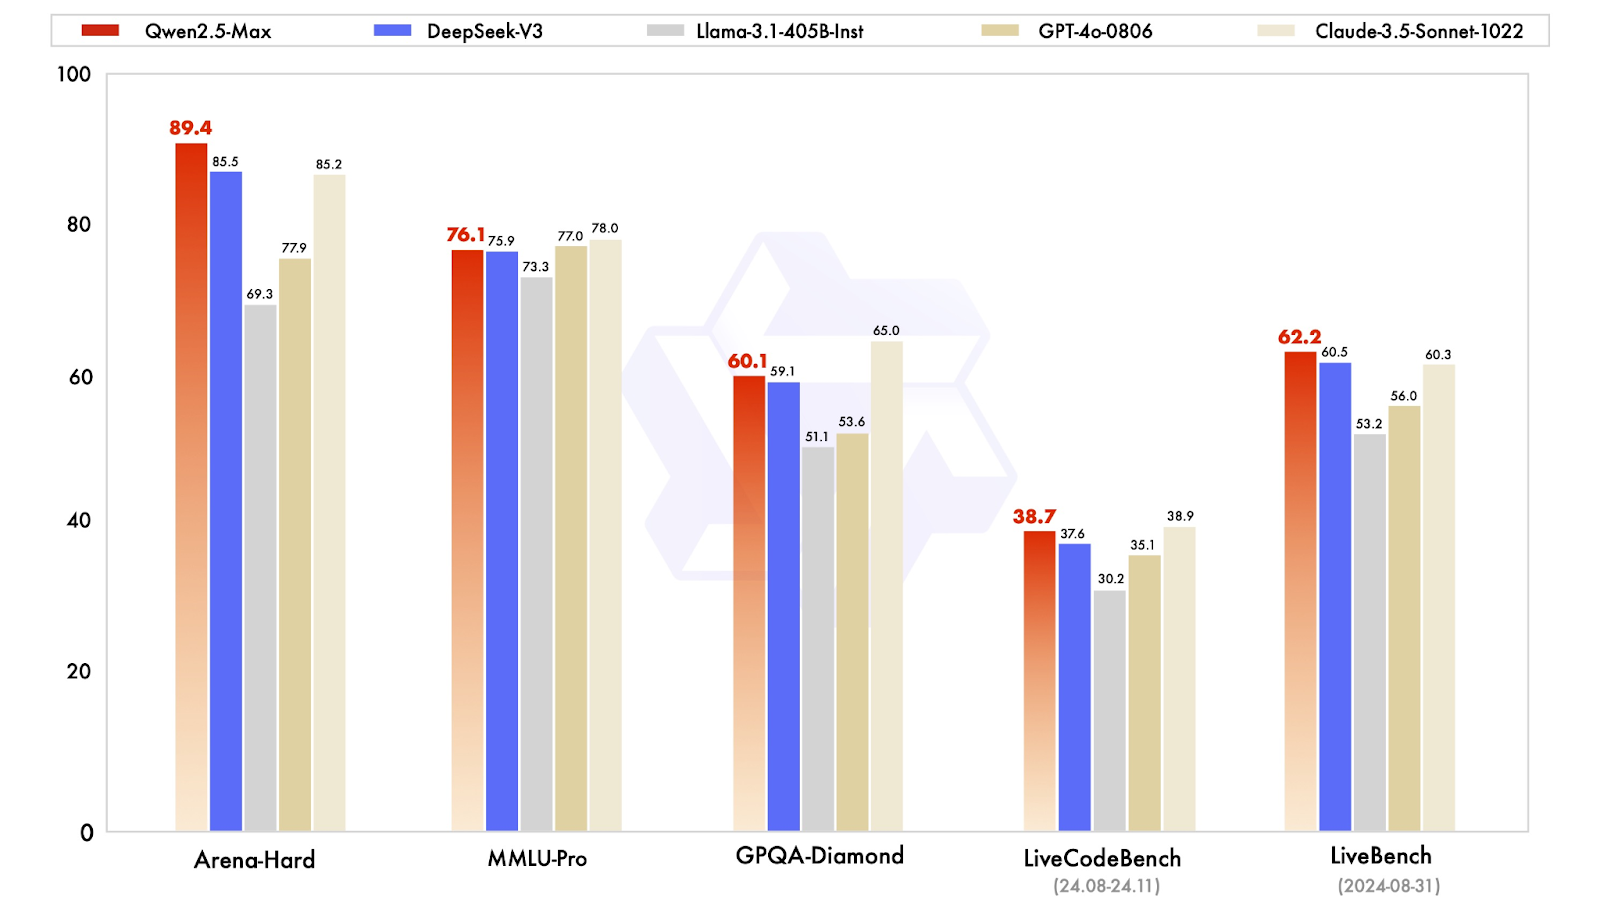
Confronto dei modelli instruct. Fonte: QwenLM
Ecco un rapido riepilogo dei risultati:
Nel complesso, Qwen2.5-Max si dimostra un modello di IA completo, eccellendo nei compiti basati sulle preferenze e nelle capacità generali, mantenendo al contempo conoscenze e abilità di coding competitive.
Poiché GPT-4o e Claude 3.5 Sonnet sono modelli proprietari senza versioni base pubbliche, il confronto è limitato a modelli open-weight come Qwen2.5-Max, DeepSeek V3, LLaMA 3.1-405B e Qwen 2.5-72B. Questo offre un quadro più chiaro di come Qwen2.5-Max si posizioni rispetto ai principali modelli open su larga scala.
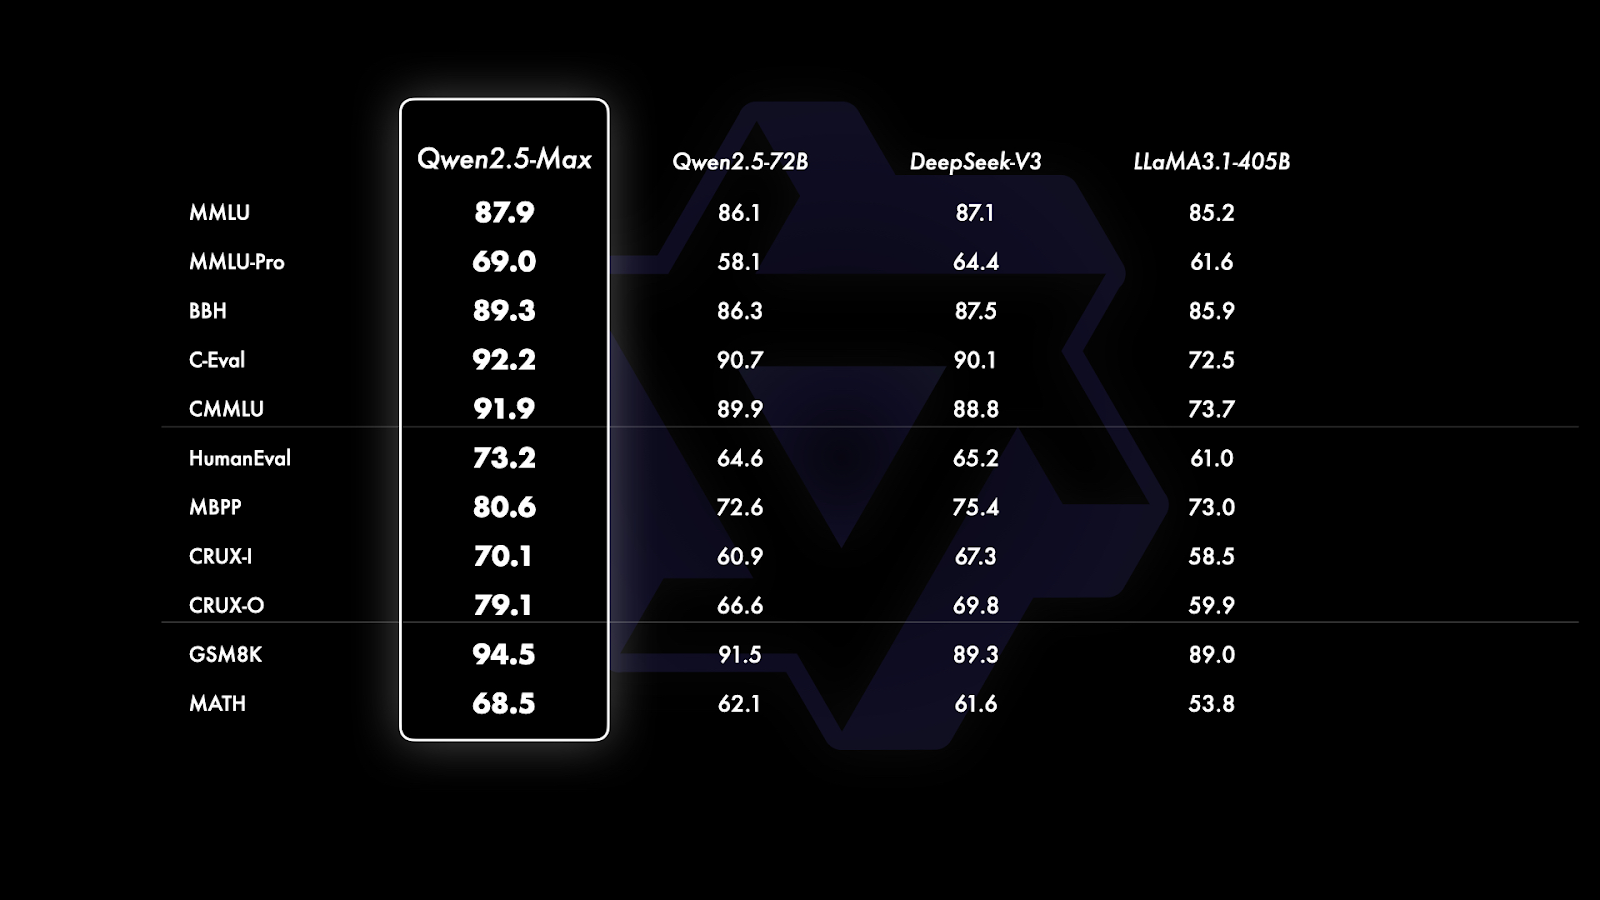
Confronto dei modelli base. Fonte: QwenLM
Osservando da vicino il grafico sopra, è suddiviso in tre sezioni in base al tipo di benchmark valutati:
Accedere a Qwen2.5-Max è semplice e puoi provarlo gratis senza configurazioni complicate.
Il modo più rapido per provare Qwen2.5-Max è tramite la piattaforma Qwen Chat. Si tratta di un’interfaccia web che ti permette di interagire con il modello direttamente dal browser—proprio come useresti ChatGPT nel browser.
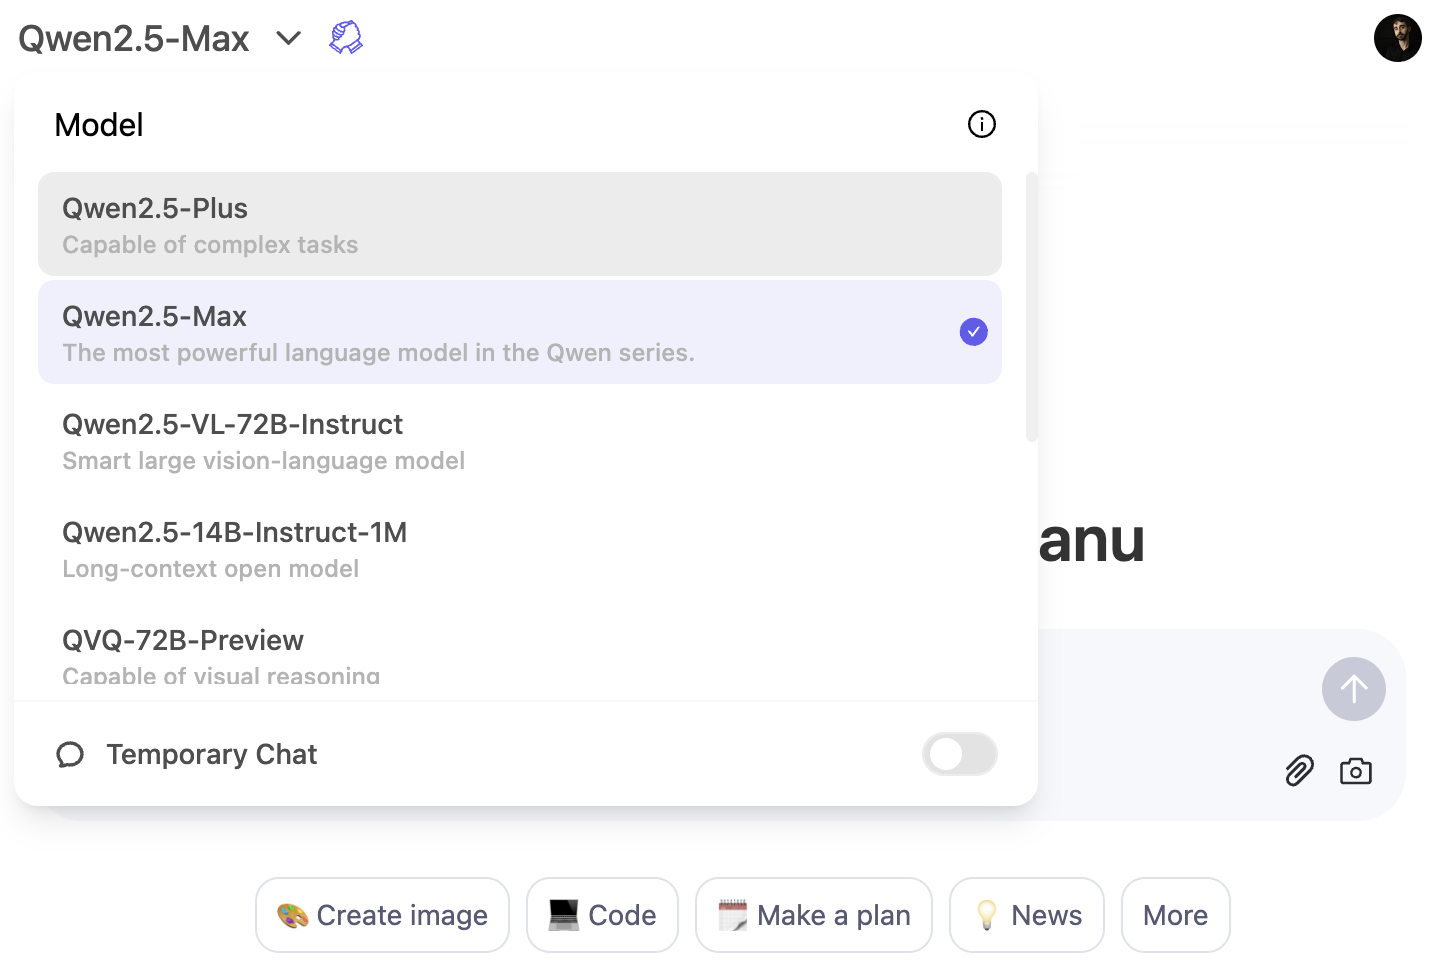
Per usare il modello Qwen2.5-Max, apri il menu a tendina dei modelli e seleziona Qwen2.5-Max:
Per gli sviluppatori, Qwen2.5-Max è disponibile tramite l’API di Model Studio su Alibaba Cloud. Per usarla, devi registrarti a un account Alibaba Cloud, attivare il servizio Model Studio e generare una chiave API.
Poiché l’API segue il formato di OpenAI, l’integrazione dovrebbe essere semplice se hai già familiarità con i modelli OpenAI. Per istruzioni di configurazione dettagliate, visita il blog di Qwen2.5-Max ufficiale.
Qwen2.5-Max è il modello di IA più capace di Alibaba finora, costruito per competere con modelli di punta come GPT-4o, Claude 3.5 Sonnet e DeepSeek V3.
A differenza di alcuni modelli Qwen precedenti, Qwen2.5-Max non è open-source, ma è disponibile per i test tramite Qwen Chat o via API su Alibaba Cloud.
Dato l’investimento continuo di Alibaba nell’IA, non sarebbe sorprendente vedere in futuro un modello incentrato sul ragionamento—forse con Qwen 3.
Se vuoi leggere altre notizie sull’IA, ti consiglio questi articoli:
Impara l'IA con questi corsi!
Programma
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



