अलीबाबा ने अभी-अभी Qwen2.5-Max जारी किया है, जो अब तक का उसका सबसे उन्नत AI मॉडल है। यह DeepSeek R1 या OpenAI के o1 जैसा रीजनिंग मॉडल नहीं है, यानी आप इसका सोचने की प्रक्रिया नहीं देख सकते।
Qwen2.5-Max को एक जनरलिस्ट मॉडल और GPT-4o, Claude 3.5 Sonnet या DeepSeek V3 के प्रतिद्वंद्वी के रूप में देखना बेहतर है।
इस ब्लॉग में, मैं बताऊंगा कि Qwen2.5-Max क्या है, इसे कैसे विकसित किया गया, यह प्रतिस्पर्धा के मुकाबले कैसा है, और आप इसे कैसे एक्सेस कर सकते हैं।
हम अपने पाठकों को AI की ताज़ा खबरों से अपडेट रखते हैं The Median के ज़रिए—हमारा मुफ्त शुक्रवार न्यूज़लेटर, जो हफ्ते की प्रमुख कहानियों को सरलता से समझाता है। सब्सक्राइब करें और हर हफ्ते चंद मिनटों में अपडेटेड रहें:
Qwen2.5-Max क्या है?
Qwen2.5-Max अब तक का अलीबाबा का सबसे शक्तिशाली AI मॉडल है, जिसे GPT-4o, Claude 3.5 Sonnet और DeepSeek V3 जैसे टॉप-टियर मॉडलों से प्रतिस्पर्धा के लिए बनाया गया है।
अलीबाबा, जो चीन की सबसे बड़ी टेक कंपनियों में से एक है, अपनी ई-कॉमर्स प्लेटफ़ॉर्म्स के लिए तो जानी जाती है, साथ ही उसने क्लाउड कंप्यूटिंग और कृत्रिम बुद्धिमत्ता में भी मज़बूत उपस्थिति बनाई है। Qwen श्रृंखला उसके व्यापक AI इकोसिस्टम का हिस्सा है, जिसमें छोटे ओपन-वेट मॉडलों से लेकर बड़े स्वामित्व वाले सिस्टम तक शामिल हैं।
कुछ पिछले Qwen मॉडलों के विपरीत, Qwen2.5-Max ओपन-सोर्स नहीं है, यानी इसके वेट्स सार्वजनिक रूप से उपलब्ध नहीं हैं।
20 ट्रिलियन टोकन्स पर प्रशिक्षित, Qwen2.5-Max के पास व्यापक नॉलेज बेस और मज़बूत सामान्य AI क्षमताएँ हैं। हालांकि, यह DeepSeek R1 या OpenAI के o1 जैसा रीजनिंग मॉडल नहीं है, यानी यह अपनी सोच की प्रक्रिया स्पष्ट रूप से नहीं दिखाता। फिर भी, अलीबाबा के लगातार AI विस्तार को देखते हुए, हमें भविष्य में—संभवतः Qwen 3 के साथ—एक समर्पित रीजनिंग मॉडल देखने को मिल सकता है।
Qwen2.5-Max कैसे काम करता है?
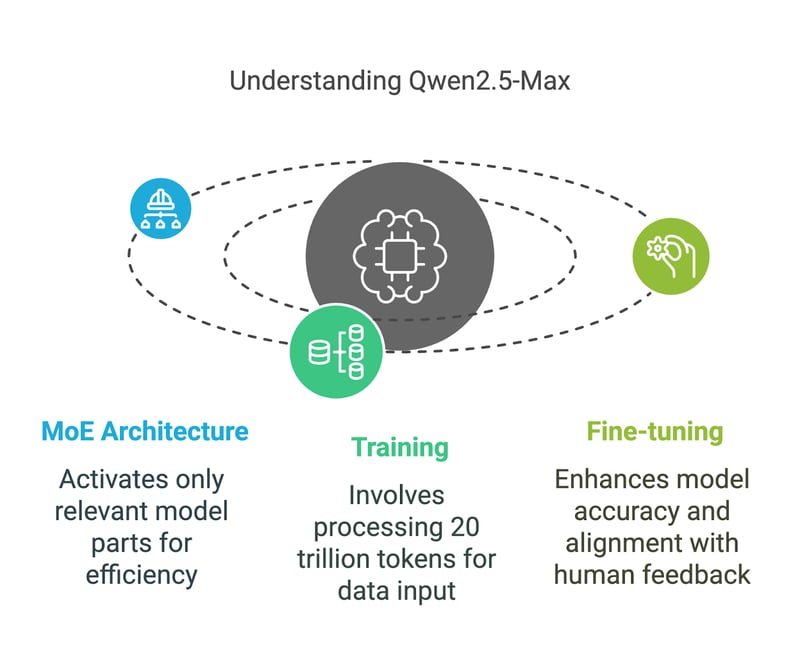
Qwen2.5-Max Mixture-of-Experts (MoE) आर्किटेक्चर का उपयोग करता है, वही तकनीक जिसे DeepSeek V3 भी अपनाता है। यह तरीका मॉडल को स्केल करने में मदद करता है, जबकि कम्प्यूटेशनल लागत काबू में रहती है। आइए इसके मुख्य घटकों को आसान भाषा में समझते हैं।
Mixture-of-Experts (MoE) आर्किटेक्चर
पारंपरिक AI मॉडल हर कार्य के लिए अपने सभी पैरामीटर्स का उपयोग करते हैं, जबकि Qwen2.5-Max और DeepSeek V3 जैसे MoE मॉडल किसी भी समय केवल सबसे प्रासंगिक हिस्सों को सक्रिय करते हैं।
इसे विशेषज्ञों की टीम की तरह समझें: यदि आप भौतिकी पर कोई जटिल सवाल पूछते हैं, तो केवल भौतिकी के विशेषज्ञ ही सक्रिय होते हैं, जबकि बाकी टीम निष्क्रिय रहती है। यह चयनात्मक सक्रियण मॉडल को बड़े पैमाने की प्रोसेसिंग अधिक कुशलता से करने देता है, बिना अत्यधिक कंप्यूटिंग पावर की आवश्यकता के।
यह तरीका Qwen2.5-Max को शक्तिशाली और स्केलेबल दोनों बनाता है, जिससे यह डेंस मॉडल्स जैसे GPT-4o और Claude 3.5 Sonnet से टक्कर ले सके, और संसाधनों का अधिक कुशल उपयोग कर सके—डेंस मॉडल वह होता है जिसमें हर इनपुट के लिए सभी पैरामीटर्स सक्रिय होते हैं।
ट्रेनिंग और फाइन-ट्यूनिंग
Qwen2.5-Max को 20 ट्रिलियन टोकन्स पर प्रशिक्षित किया गया, जो विषयों, भाषाओं और संदर्भों की एक बहुत व्यापक रेंज को कवर करता है।
20 ट्रिलियन टोकन्स को समझने के लिए, यह लगभग 15 ट्रिलियन शब्दों के बराबर है—इतना विशाल कि इसे पकड़ पाना कठिन है। तुलना के लिए, जॉर्ज ऑरवेल की 1984 में लगभग 89,000 शब्द हैं, यानी Qwen2.5-Max को 1984 की 16.8 करोड़ प्रतियों के बराबर टेक्स्ट पर प्रशिक्षित किया गया है।
हालांकि, केवल कच्चा ट्रेनिंग डेटा एक उच्च-गुणवत्ता वाला AI मॉडल सुनिश्चित नहीं करता, इसलिए अलीबाबा ने इसे आगे इन तरीकों से परिष्कृत किया:
Qwen2.5-Max बेंचमार्क्स
Qwen2.5-Max को विभिन्न कार्यों में अपनी क्षमताओं को मापने के लिए अन्य अग्रणी AI मॉडलों के खिलाफ परखा गया है। ये बेंचमार्क्स इंस्ट्रक्ट मॉडलों (जो चैट और कोडिंग जैसे कार्यों के लिए फाइन-ट्यून किए जाते हैं) और बेस मॉडलों (जो फाइन-ट्यूनिंग से पहले का आधार होते हैं) दोनों का आकलन करते हैं। इस अंतर को समझना संख्याओं के सही मायने स्पष्ट करता है।
इंस्ट्रक्ट मॉडलों के बेंचमार्क
इंस्ट्रक्ट मॉडल वास्तविक-जीवन अनुप्रयोगों, जैसे बातचीत, कोडिंग और सामान्य ज्ञान कार्यों के लिए फाइन-ट्यून होते हैं। यहाँ Qwen2.5-Max की तुलना GPT-4o, Claude 3.5 Sonnet, Llama 3.1 405B और DeepSeek V3 जैसे मॉडलों से की गई है।
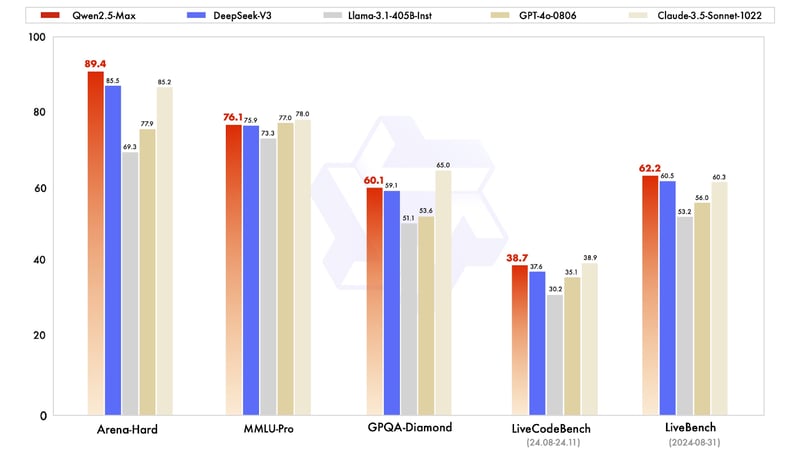
इंस्ट्रक्ट मॉडलों की तुलना। स्रोत: QwenLM
आइए परिणामों को जल्दी से समझते हैं:
- Arena-Hard (पसंद-आधारित बेंचमार्क): Qwen2.5-Max ने 89.4 स्कोर किया, DeepSeek V3 (85.5) और Claude 3.5 Sonnet (85.2) पर बढ़त लेते हुए। यह बेंचमार्क AI-जनित प्रतिक्रियाओं में मानव वरीयताओं का अनुमान लगाता है।
- MMLU-Pro (ज्ञान और तर्क): Qwen2.5-Max ने 76.1 स्कोर किया, DeepSeek V3 (75.9) से थोड़ा आगे, लेकिन लीडर Claude 3.5 Sonnet (78.0) और रनर-अप GPT-4o (77.0) से थोड़ा पीछे।
- GPQA-Diamond (सामान्य ज्ञान प्रश्नोत्तर): 60.1 के स्कोर के साथ, Qwen2.5-Max ने DeepSeek V3 (59.1) को पीछे छोड़ा, जबकि Claude 3.5 Sonnet 65.0 पर आगे रहा।
- LiveCodeBench (कोडिंग क्षमता): 38.7 पर, Qwen2.5-Max लगभग DeepSeek V3 (37.6) के बराबर है, लेकिन Claude 3.5 Sonnet (38.9) से पीछे।
- LiveBench (समग्र क्षमताएँ): 62.2 के स्कोर के साथ Qwen2.5-Max ने DeepSeek V3 (60.5) और Claude 3.5 Sonnet (60.3) को पीछे छोड़ा, जो वास्तविक-जीवन AI कार्यों में व्यापक दक्षता दर्शाता है।
कुल मिलाकर, Qwen2.5-Max एक संतुलित AI मॉडल साबित होता है, जो पसंद-आधारित कार्यों और सामान्य AI क्षमताओं में उत्कृष्ट है, जबकि ज्ञान और कोडिंग क्षमताओं में भी प्रतिस्पर्धी बना रहता है।
बेस मॉडलों के बेंचमार्क
चूँकि GPT-4o और Claude 3.5 Sonnet स्वामित्व वाले मॉडल हैं जिनके बेस संस्करण सार्वजनिक नहीं हैं, इसलिए तुलना Qwen2.5-Max, DeepSeek V3, LLaMA 3.1-405B और Qwen 2.5-72B जैसे ओपन-वेट मॉडलों तक सीमित है। इससे यह स्पष्ट तस्वीर मिलती है कि बड़े ओपन मॉडलों में Qwen2.5-Max कहाँ खड़ा है।
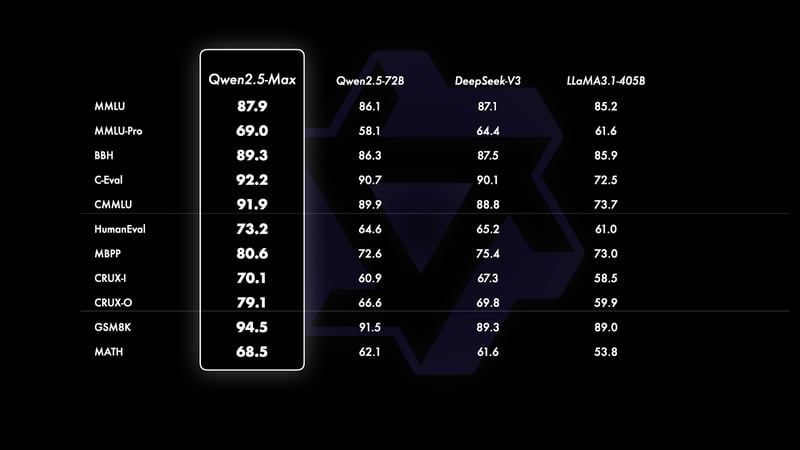
बेस मॉडलों की तुलना। स्रोत: QwenLM
यदि आप ऊपर दिए गए ग्राफ़ को ध्यान से देखें, तो यह मूल्यांकित बेंचमार्क्स के प्रकार के आधार पर तीन खंडों में बँटा है:
- सामान्य ज्ञान और भाषा की समझ (MMLU, MMLU-Pro, BBH, C-Eval, CMMU): इस श्रेणी के सभी बेंचमार्क्स में Qwen2.5-Max आगे है—MMLU पर 87.9 और C-Eval पर 92.2 स्कोर करते हुए—और DeepSeek V3 तथा Llama 3.1-405B को पीछे छोड़ते हुए। ये बेंचमार्क्स ज्ञान की व्यापकता-गहराई और तर्क-संदर्भ में उसके उपयोग की क्षमता पर केंद्रित हैं।
- कोडिंग और समस्या-समाधान (HumanEval, MBPP, CRUX-I, CRUX-O): Qwen2.5-Max यहाँ भी सभी बेंचमार्क्स में आगे है और कोडिंग-संबंधी कार्यों में अच्छा प्रदर्शन करता है—HumanEval पर 73.2 और MBPP पर 80.6—DeepSeek V3 से थोड़ा आगे और Llama 3.1-405B से काफ़ी आगे। ये बेंचमार्क्स कोडिंग कौशल, समस्या-समाधान और निर्देशों का पालन करने या स्वतंत्र रूप से समाधान उत्पन्न करने की क्षमता मापते हैं।
- गणितीय समस्या-समाधान (GSM8K, MATH): गणितीय तर्क Qwen2.5-Max की सबसे मज़बूत क्षेत्रों में से एक है—GSM8K पर 94.5, जो DeepSeek V3 (89.3) और Llama 3.1-405B (89.0) से काफ़ी आगे है। वहीं MATH पर, जो अधिक जटिल समस्याओं पर केंद्रित है, Qwen2.5-Max ने 68.5 स्कोर किया—प्रतिद्वंद्वियों से थोड़ा बेहतर, पर सुधार की गुंजाइश बाकी है।
Qwen2.5-Max तक कैसे पहुँचें
Qwen2.5-Max तक पहुँचना सरल है, और आप बिना किसी जटिल सेटअप के इसे मुफ्त में आज़मा सकते हैं।
Qwen Chat
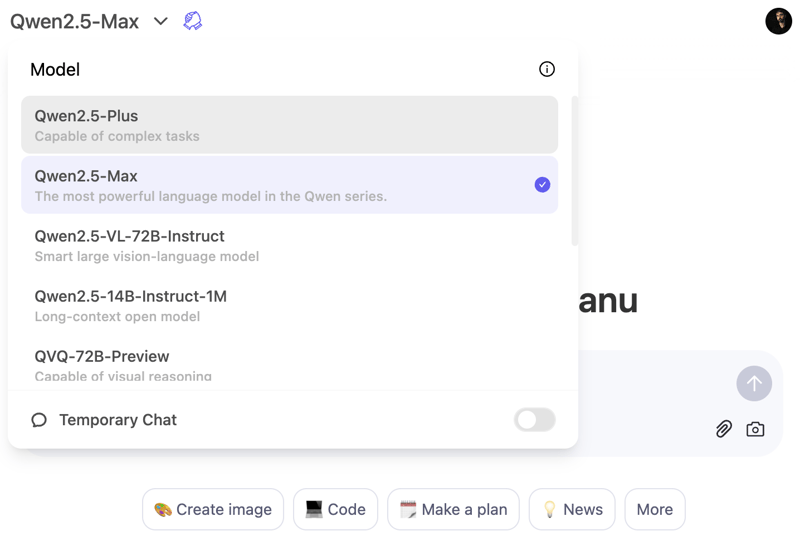
Qwen2.5-Max का अनुभव लेने का सबसे तेज़ तरीका है Qwen Chat प्लेटफ़ॉर्म के माध्यम से। यह एक वेब-आधारित इंटरफ़ेस है जो आपको सीधे अपने ब्राउज़र में मॉडल से इंटरैक्ट करने देता है—ठीक वैसे ही जैसे आप अपने ब्राउज़र में ChatGPT का उपयोग करते हैं।
Qwen2.5-Max मॉडल का उपयोग करने के लिए, मॉडल ड्रॉपडाउन मेनू पर क्लिक करें और Qwen2.5-Max चुनें:
Alibaba Cloud के जरिए API एक्सेस
डेवलपर्स के लिए, Qwen2.5-Max Alibaba Cloud Model Studio API के माध्यम से उपलब्ध है। इसका उपयोग करने के लिए, आपको Alibaba Cloud अकाउंट बनाना होगा, Model Studio सर्विस को सक्रिय करना होगा और API की जनरेट करनी होगी।
चूँकि API OpenAI के फ़ॉर्मेट का पालन करता है, यदि आप पहले से OpenAI मॉडलों से परिचित हैं तो इंटीग्रेशन सीधा होना चाहिए। विस्तृत सेटअप निर्देशों के लिए आधिकारिक Qwen2.5-Max ब्लॉग देखें।
निष्कर्ष
Qwen2.5-Max अलीबाबा का अब तक का सबसे सक्षम AI मॉडल है, जिसे GPT-4o, Claude 3.5 Sonnet और DeepSeek V3 जैसे टॉप-टियर मॉडलों से प्रतिस्पर्धा के लिए बनाया गया है।
कुछ पिछले Qwen मॉडलों के विपरीत, Qwen2.5-Max ओपन-सोर्स नहीं है, लेकिन इसे Qwen Chat के ज़रिए या Alibaba Cloud पर API एक्सेस के माध्यम से आज़माया जा सकता है।
अलीबाबा के AI में लगातार निवेश को देखते हुए, भविष्य में—संभवतः Qwen 3 के साथ—रीजनिंग-केंद्रित मॉडल आना आश्चर्यजनक नहीं होगा।
यदि आप AI समाचार पर और पढ़ना चाहते हैं, तो मैं ये लेख सुझाता हूँ:


अलीबाबा ने अभी-अभी Qwen2.5-Max जारी किया है, जो अब तक का उसका सबसे उन्नत AI मॉडल है। यह DeepSeek R1 या OpenAI के o1 जैसा रीजनिंग मॉडल नहीं है, यानी आप इसका सोचने की प्रक्रिया नहीं देख सकते।
Qwen2.5-Max को एक जनरलिस्ट मॉडल और GPT-4o, Claude 3.5 Sonnet या DeepSeek V3 के प्रतिद्वंद्वी के रूप में देखना बेहतर है।
इस ब्लॉग में, मैं बताऊंगा कि Qwen2.5-Max क्या है, इसे कैसे विकसित किया गया, यह प्रतिस्पर्धा के मुकाबले कैसा है, और आप इसे कैसे एक्सेस कर सकते हैं।
हम अपने पाठकों को AI की ताज़ा खबरों से अपडेट रखते हैं The Median के ज़रिए—हमारा मुफ्त शुक्रवार न्यूज़लेटर, जो हफ्ते की प्रमुख कहानियों को सरलता से समझाता है। सब्सक्राइब करें और हर हफ्ते चंद मिनटों में अपडेटेड रहें:
Qwen2.5-Max क्या है?
Qwen2.5-Max अब तक का अलीबाबा का सबसे शक्तिशाली AI मॉडल है, जिसे GPT-4o, Claude 3.5 Sonnet और DeepSeek V3 जैसे टॉप-टियर मॉडलों से प्रतिस्पर्धा के लिए बनाया गया है।
अलीबाबा, जो चीन की सबसे बड़ी टेक कंपनियों में से एक है, अपनी ई-कॉमर्स प्लेटफ़ॉर्म्स के लिए तो जानी जाती है, साथ ही उसने क्लाउड कंप्यूटिंग और कृत्रिम बुद्धिमत्ता में भी मज़बूत उपस्थिति बनाई है। Qwen श्रृंखला उसके व्यापक AI इकोसिस्टम का हिस्सा है, जिसमें छोटे ओपन-वेट मॉडलों से लेकर बड़े स्वामित्व वाले सिस्टम तक शामिल हैं।
कुछ पिछले Qwen मॉडलों के विपरीत, Qwen2.5-Max ओपन-सोर्स नहीं है, यानी इसके वेट्स सार्वजनिक रूप से उपलब्ध नहीं हैं।
20 ट्रिलियन टोकन्स पर प्रशिक्षित, Qwen2.5-Max के पास व्यापक नॉलेज बेस और मज़बूत सामान्य AI क्षमताएँ हैं। हालांकि, यह DeepSeek R1 या OpenAI के o1 जैसा रीजनिंग मॉडल नहीं है, यानी यह अपनी सोच की प्रक्रिया स्पष्ट रूप से नहीं दिखाता। फिर भी, अलीबाबा के लगातार AI विस्तार को देखते हुए, हमें भविष्य में—संभवतः Qwen 3 के साथ—एक समर्पित रीजनिंग मॉडल देखने को मिल सकता है।
Qwen2.5-Max कैसे काम करता है?
Qwen2.5-Max Mixture-of-Experts (MoE) आर्किटेक्चर का उपयोग करता है, वही तकनीक जिसे DeepSeek V3 भी अपनाता है। यह तरीका मॉडल को स्केल करने में मदद करता है, जबकि कम्प्यूटेशनल लागत काबू में रहती है। आइए इसके मुख्य घटकों को आसान भाषा में समझते हैं।
Mixture-of-Experts (MoE) आर्किटेक्चर
पारंपरिक AI मॉडल हर कार्य के लिए अपने सभी पैरामीटर्स का उपयोग करते हैं, जबकि Qwen2.5-Max और DeepSeek V3 जैसे MoE मॉडल किसी भी समय केवल सबसे प्रासंगिक हिस्सों को सक्रिय करते हैं।
इसे विशेषज्ञों की टीम की तरह समझें: यदि आप भौतिकी पर कोई जटिल सवाल पूछते हैं, तो केवल भौतिकी के विशेषज्ञ ही सक्रिय होते हैं, जबकि बाकी टीम निष्क्रिय रहती है। यह चयनात्मक सक्रियण मॉडल को बड़े पैमाने की प्रोसेसिंग अधिक कुशलता से करने देता है, बिना अत्यधिक कंप्यूटिंग पावर की आवश्यकता के।
यह तरीका Qwen2.5-Max को शक्तिशाली और स्केलेबल दोनों बनाता है, जिससे यह डेंस मॉडल्स जैसे GPT-4o और Claude 3.5 Sonnet से टक्कर ले सके, और संसाधनों का अधिक कुशल उपयोग कर सके—डेंस मॉडल वह होता है जिसमें हर इनपुट के लिए सभी पैरामीटर्स सक्रिय होते हैं।
ट्रेनिंग और फाइन-ट्यूनिंग
Qwen2.5-Max को 20 ट्रिलियन टोकन्स पर प्रशिक्षित किया गया, जो विषयों, भाषाओं और संदर्भों की एक बहुत व्यापक रेंज को कवर करता है।
20 ट्रिलियन टोकन्स को समझने के लिए, यह लगभग 15 ट्रिलियन शब्दों के बराबर है—इतना विशाल कि इसे पकड़ पाना कठिन है। तुलना के लिए, जॉर्ज ऑरवेल की 1984 में लगभग 89,000 शब्द हैं, यानी Qwen2.5-Max को 1984 की 16.8 करोड़ प्रतियों के बराबर टेक्स्ट पर प्रशिक्षित किया गया है।
हालांकि, केवल कच्चा ट्रेनिंग डेटा एक उच्च-गुणवत्ता वाला AI मॉडल सुनिश्चित नहीं करता, इसलिए अलीबाबा ने इसे आगे इन तरीकों से परिष्कृत किया:
Qwen2.5-Max बेंचमार्क्स
Qwen2.5-Max को विभिन्न कार्यों में अपनी क्षमताओं को मापने के लिए अन्य अग्रणी AI मॉडलों के खिलाफ परखा गया है। ये बेंचमार्क्स इंस्ट्रक्ट मॉडलों (जो चैट और कोडिंग जैसे कार्यों के लिए फाइन-ट्यून किए जाते हैं) और बेस मॉडलों (जो फाइन-ट्यूनिंग से पहले का आधार होते हैं) दोनों का आकलन करते हैं। इस अंतर को समझना संख्याओं के सही मायने स्पष्ट करता है।
इंस्ट्रक्ट मॉडलों के बेंचमार्क
इंस्ट्रक्ट मॉडल वास्तविक-जीवन अनुप्रयोगों, जैसे बातचीत, कोडिंग और सामान्य ज्ञान कार्यों के लिए फाइन-ट्यून होते हैं। यहाँ Qwen2.5-Max की तुलना GPT-4o, Claude 3.5 Sonnet, Llama 3.1 405B और DeepSeek V3 जैसे मॉडलों से की गई है।
इंस्ट्रक्ट मॉडलों की तुलना। स्रोत: QwenLM
आइए परिणामों को जल्दी से समझते हैं:
कुल मिलाकर, Qwen2.5-Max एक संतुलित AI मॉडल साबित होता है, जो पसंद-आधारित कार्यों और सामान्य AI क्षमताओं में उत्कृष्ट है, जबकि ज्ञान और कोडिंग क्षमताओं में भी प्रतिस्पर्धी बना रहता है।
बेस मॉडलों के बेंचमार्क
चूँकि GPT-4o और Claude 3.5 Sonnet स्वामित्व वाले मॉडल हैं जिनके बेस संस्करण सार्वजनिक नहीं हैं, इसलिए तुलना Qwen2.5-Max, DeepSeek V3, LLaMA 3.1-405B और Qwen 2.5-72B जैसे ओपन-वेट मॉडलों तक सीमित है। इससे यह स्पष्ट तस्वीर मिलती है कि बड़े ओपन मॉडलों में Qwen2.5-Max कहाँ खड़ा है।
बेस मॉडलों की तुलना। स्रोत: QwenLM
यदि आप ऊपर दिए गए ग्राफ़ को ध्यान से देखें, तो यह मूल्यांकित बेंचमार्क्स के प्रकार के आधार पर तीन खंडों में बँटा है:
Qwen2.5-Max तक कैसे पहुँचें
Qwen2.5-Max तक पहुँचना सरल है, और आप बिना किसी जटिल सेटअप के इसे मुफ्त में आज़मा सकते हैं।
Qwen Chat
Qwen2.5-Max का अनुभव लेने का सबसे तेज़ तरीका है Qwen Chat प्लेटफ़ॉर्म के माध्यम से। यह एक वेब-आधारित इंटरफ़ेस है जो आपको सीधे अपने ब्राउज़र में मॉडल से इंटरैक्ट करने देता है—ठीक वैसे ही जैसे आप अपने ब्राउज़र में ChatGPT का उपयोग करते हैं।
Qwen2.5-Max मॉडल का उपयोग करने के लिए, मॉडल ड्रॉपडाउन मेनू पर क्लिक करें और Qwen2.5-Max चुनें:
Alibaba Cloud के जरिए API एक्सेस
डेवलपर्स के लिए, Qwen2.5-Max Alibaba Cloud Model Studio API के माध्यम से उपलब्ध है। इसका उपयोग करने के लिए, आपको Alibaba Cloud अकाउंट बनाना होगा, Model Studio सर्विस को सक्रिय करना होगा और API की जनरेट करनी होगी।
चूँकि API OpenAI के फ़ॉर्मेट का पालन करता है, यदि आप पहले से OpenAI मॉडलों से परिचित हैं तो इंटीग्रेशन सीधा होना चाहिए। विस्तृत सेटअप निर्देशों के लिए आधिकारिक Qwen2.5-Max ब्लॉग देखें।
निष्कर्ष
Qwen2.5-Max अलीबाबा का अब तक का सबसे सक्षम AI मॉडल है, जिसे GPT-4o, Claude 3.5 Sonnet और DeepSeek V3 जैसे टॉप-टियर मॉडलों से प्रतिस्पर्धा के लिए बनाया गया है।
कुछ पिछले Qwen मॉडलों के विपरीत, Qwen2.5-Max ओपन-सोर्स नहीं है, लेकिन इसे Qwen Chat के ज़रिए या Alibaba Cloud पर API एक्सेस के माध्यम से आज़माया जा सकता है।
अलीबाबा के AI में लगातार निवेश को देखते हुए, भविष्य में—संभवतः Qwen 3 के साथ—रीजनिंग-केंद्रित मॉडल आना आश्चर्यजनक नहीं होगा।
यदि आप AI समाचार पर और पढ़ना चाहते हैं, तो मैं ये लेख सुझाता हूँ: