
Cursus
Concepten van Large Language Models (LLMs)
2 uur
111.7K
Het attention-mechanisme staat centraal in transformermodellen. Alle populaire modelarchitecturen, zoals GPT, LLaMA en Mixture of Experts (MoE), leunen erop om tokens te verbinden en betekenis op te bouwen.
Maar attention is duur. De berekening omvat grote matrixvermenigvuldigingen en, belangrijker nog, enorme gegevensverplaatsingen tussen GPU-geheugen en rekenunits. Naarmate sequentielengtes groeien, wordt geheugenbandbreedte de echte bottleneck.
Het optimaliseren van attention heeft daarom een buitenproportioneel effect op de prestaties van LLM’s, en precies daar komt Flash Attention om de hoek kijken. In dit artikel neem ik je mee door wat Flash Attention is, hoe het werkt en hoe je het gebruikt met PyTorch en Hugging Face Transformers.
Als je een start wilt maken met LLM’s, raad ik onze introductiecursus over LLM-concepten aan.
Flash Attention is een geoptimaliseerd transformer-attention-mechanisme dat het op GPU’s drastisch sneller en geheugenefficiënter maakt.
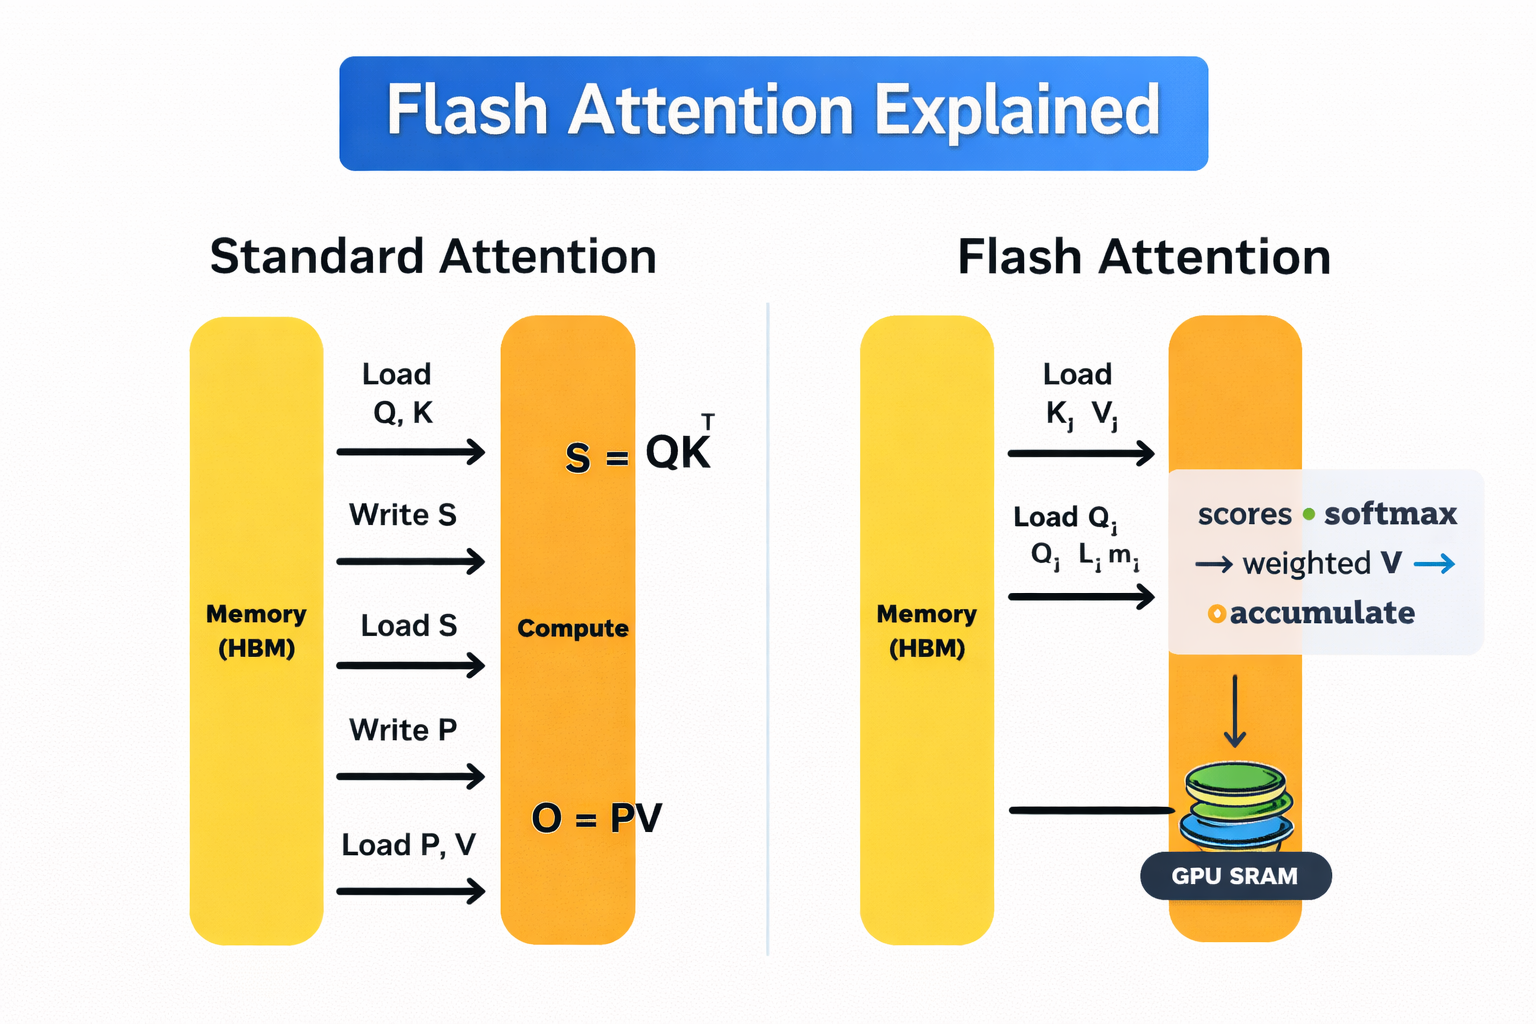
Standaard attention vs Flash attention
GPU’s hebben twee hoofdgeheugentypen. High-bandwidth memory (HBM) is groot maar relatief traag. On-chip SRAM is extreem snel maar zeer beperkt in omvang.
Standaard self-attention pendelt constant data heen en weer tussen deze twee. Dat op-en-neer gaan is duur en wordt een aanzienlijke kostenpost naarmate de sequentielengte toeneemt.
Flash Attention voorkomt dit door attention te berekenen in kleine tegels die volledig in de snelle SRAM passen. Elke tegel wordt end-to-end verwerkt, met softmax dat incrementeel wordt toegepast, zodat tussentijdse resultaten niet hoeven te worden weggeschreven naar HBM. De volledige attention-matrix wordt dus nooit in het geheugen opgeslagen.
In tegenstelling tot sparse of lineaire attention-methoden is Flash Attention geen benadering. Het produceert exact dezelfde wiskundige output als standaard self-attention, alleen uitgevoerd op een geheugenefficiëntere manier.
Flash Attention bereikt zijn efficiëntie door te herontwerpen hoe het attention op de GPU berekent. Het volgt een eenvoudig principe: doe zo veel mogelijk werk in snel on-chip geheugen en vermijd onnodige verplaatsingen naar traag geheugen.
Een behulpzame manier om hierover na te denken is een keukenanalogie. De on-chip SRAM van de GPU is als een klein, snel aanrecht. Daar bereid en kook je echt. Het GPU-high-bandwidth-geheugen (HBM) is als een grote supermarkt verderop in de straat. Het kan alles opslaan wat je nodig hebt, maar heen en weer gaan kost tijd.
Kort gezegd: standaard attention blijft na elke stap naar de supermarkt rennen. Flash Attention daarentegen plant het koken zo dat alles op het aanrecht past terwijl je kookt. Laten we dit in meer detail begrijpen:
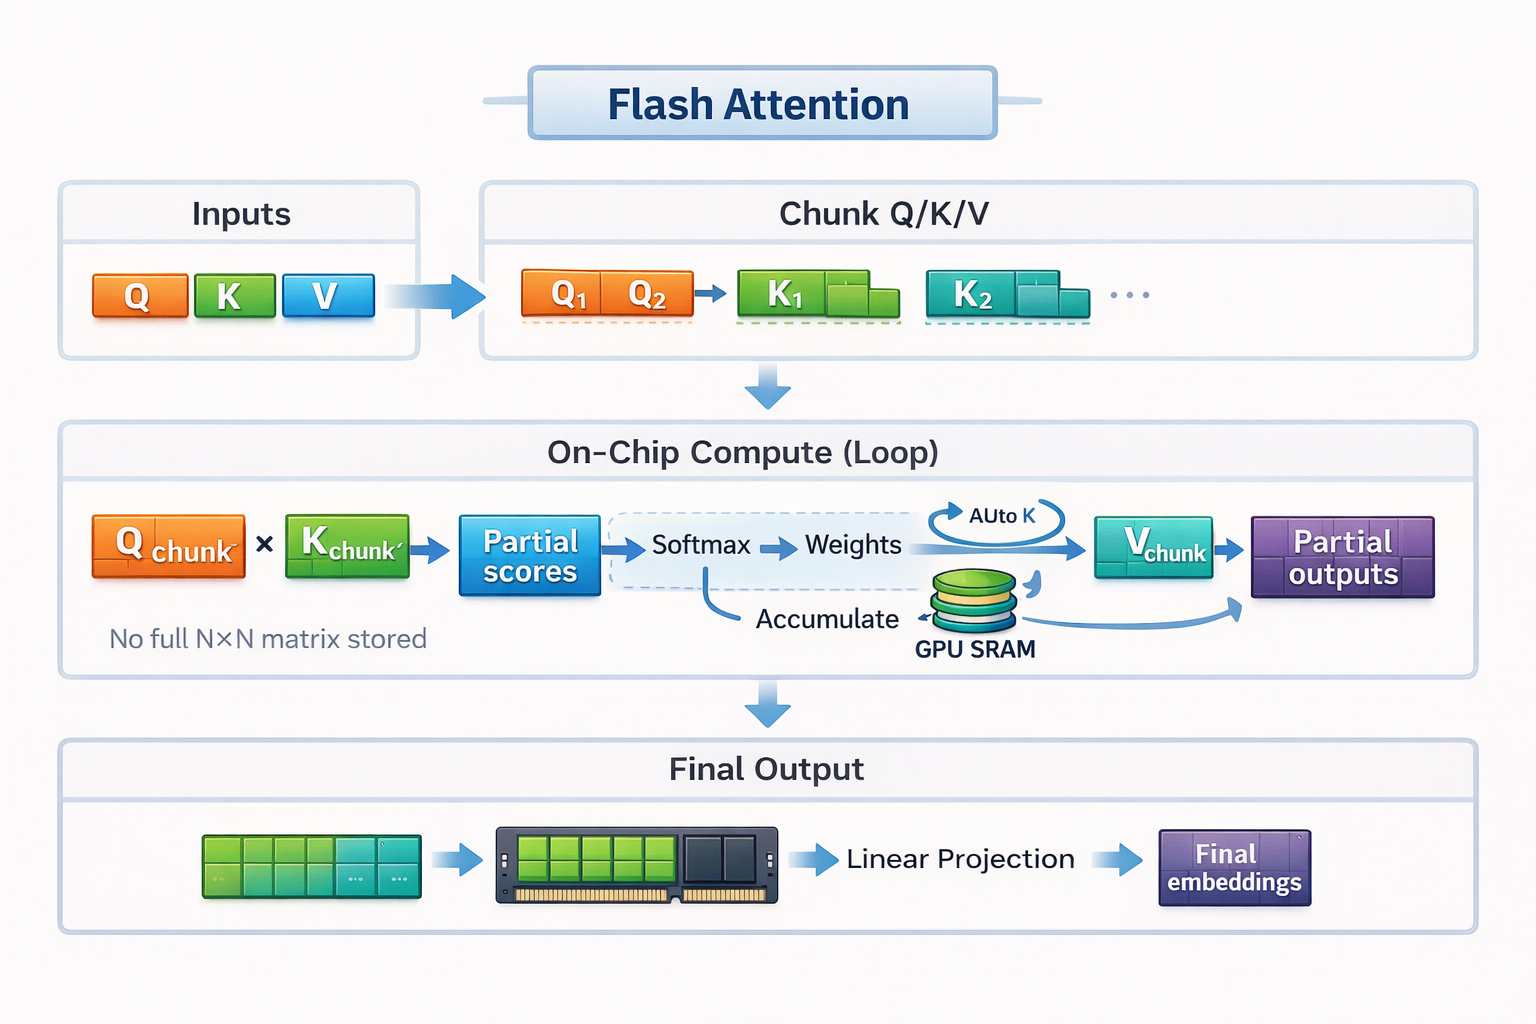
Werkingsmechanisme van Flash Attention
Flash Attention steunt op twee kernideeën: tiling en recomputation.
Om bij ons kookvoorbeeld te blijven: tiling is hoe Flash Attention de attention-berekening op het kleine aanrecht laat passen.
In plaats van de volledige sequentie te laden en een complete attention-matrix op te bouwen, splitst Flash Attention de input in kleine blokken, of tegels. Elke tegel past volledig in de snelle SRAM van de GPU. Flash Attention berekent attention tegel voor tegel, van begin tot eind, voordat het naar de volgende tegel gaat.
Volgens de keukenanalogie kun je voor een compleet banket niet alle ingrediënten op een klein aanrecht kwijt. Dus bereid en kook je in kleine batches. Je snijdt wat groenten, kookt ze, maakt ruimte en gaat dan door met de volgende batch. Door zo te werken voorkom je dat je voortdurend heen en weer naar de supermarkt moet.
Deze blok-voor-blok-uitvoering stelt Flash Attention in staat data lokaal, snel en efficiënt te houden, zonder ooit de volledige attention-matrix in traag geheugen te materialiseren.
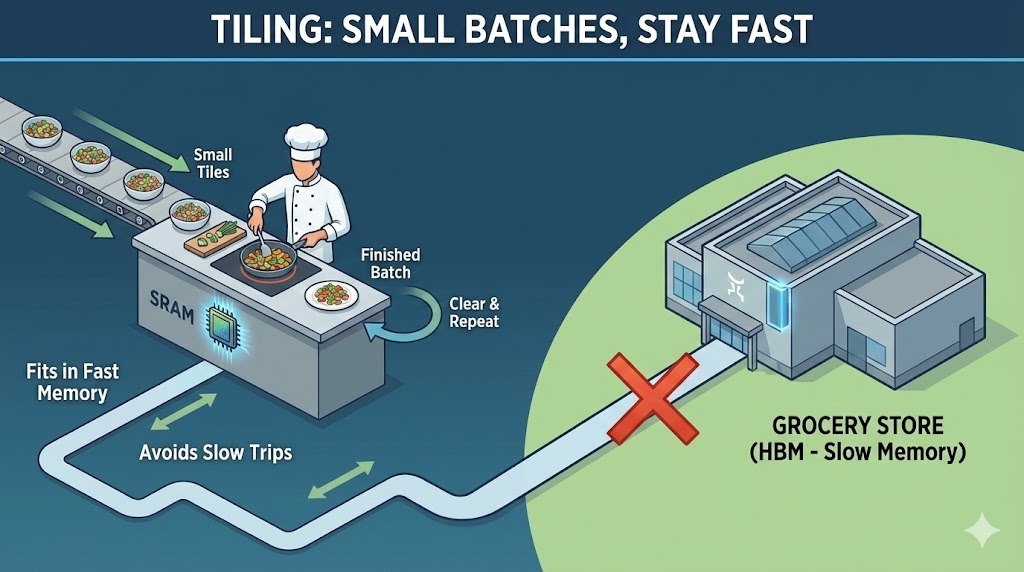
Tiling in Flash Attention
Tijdens het trainen slaat standaard attention grote tussentijdse resultaten op zodat die tijdens de backward pass opnieuw kunnen worden gebruikt. Die opslag kost veel geheugen. Flash Attention kiest een andere aanpak. In plaats van deze intermediates op te slaan, herberekent het kleine delen van de attention-scores wanneer ze nodig zijn.
Terug naar de keuken: dit is als uien snijden. Je zou naar de supermarkt kunnen lopen om je gesneden uien te bewaren en later terug te lopen om ze op te halen. Of je gooit ze weg en snijdt gewoon opnieuw een verse ui wanneer het tijd is om te koken. Verrassend genoeg is de tweede optie sneller, omdat je frequente/langere verplaatsingen vermijdt.
Op moderne GPU’s volgt recomputation dezelfde logica, omdat extra berekening goedkoop is vergeleken met geheugentransfers. Door kleine waarden te herberekenen in plaats van ze op te slaan en te laden, vermindert Flash Attention het geheugenverkeer aanzienlijk terwijl de training efficiënt blijft.
Samen stellen tiling en recomputation Flash Attention in staat om de attention-berekening op het aanrecht te houden, trips naar de supermarkt te minimaliseren en de sterke punten van moderne GPU-hardware volledig te benutten.
Flash Attention 2 (FA2), uitgebracht in 2023, is een grote upgrade ten opzichte van de eerste generatie. Het behoudt hetzelfde kernidee van IO-bewuste, exacte attention, maar verbetert de efficiëntie op verschillende vlakken die ertoe doen in workloads uit de praktijk.
De eerste versie van Flash Attention paralleliseerde de berekening over de batchgrootte en attention-heads. Dat werkte goed voor trainingsopstellingen met grote batches. Maar voor inferentie, waar batchgroottes vaak klein zijn en sequenties lang, was het minder ideaal.
FA2 voegt parallelisme toe over de sequentielengtedimensie zelf. Hierdoor kunnen meer delen van de attention-berekening gelijktijdig draaien, zelfs wanneer de batchgrootte klein is. Door werk over tokens in de sequentie te verdelen, houdt v2 meer rekenunits van de GPU tegelijkertijd bezig.
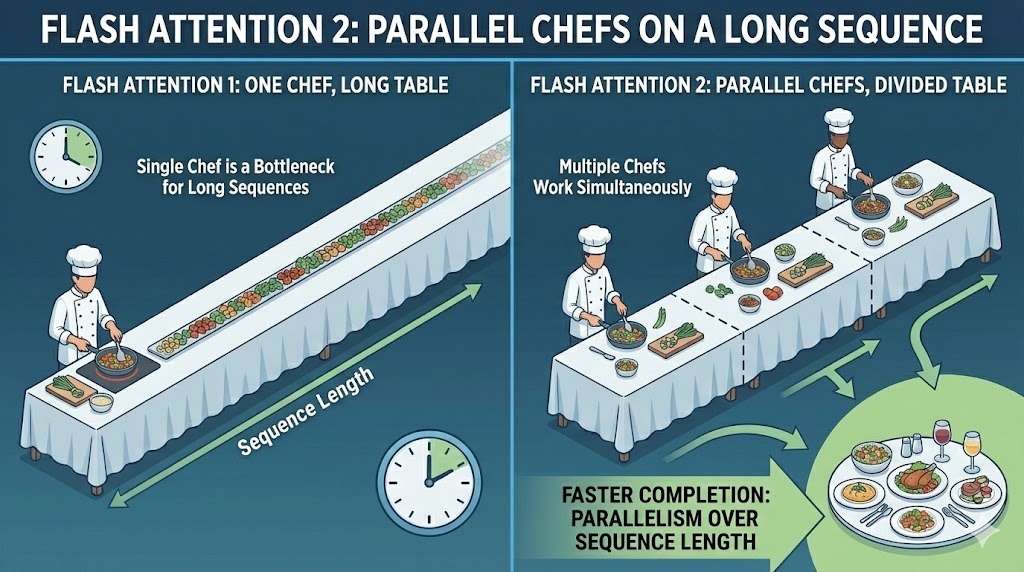
Parallelisme over batches in Flash Attention 2
Het praktische voordeel is een hogere doorvoer en betere hardwarebenutting in veelvoorkomende inferentiescenario’s, waar lange prompts en kleine batches de norm zijn.
GPU’s zijn extreem goed in matrixvermenigvuldiging. Gespecialiseerde hardware, Tensor Cores genoemd, kan algemene matrixvermenigvuldiging (GEMM) met zeer hoge snelheid uitvoeren.
Het probleem is dat attention niet alleen matrixvermenigvuldiging is: het omvat bewerkingen zoals schalen, maskeren en softmax, die op standaard GPU-cores draaien en verhoudingsgewijs veel trager zijn.
FA2 verminderde deze disbalans. Het herstructureert de berekening om niet-matrix floatingpoint-bewerkingen te minimaliseren, vooral die bij het herschalen van attention-scores. Het grootste deel van de looptijd wordt besteed aan grote, efficiënte matrixbewerkingen die Tensor Cores kunnen versnellen.
Flash Attention v1 was geoptimaliseerd rond headdimensies van 64 of 128, passend bij modellen als BERT en GPT-3. Naarmate modelarchitecturen evolueerden, werden headdimensies groter om grotere embeddinggroottes en hogere modelcapaciteit te ondersteunen.
FA2 breidde de ondersteuning uit tot headdimensies tot 256. Dit maakte het compatibel met nieuwere architecturen die vertrouwen op bredere attention-heads.
Flash Attention 3 (FA3) is de huidige industriestandaard achter toonaangevende modellen zoals GPT-5.2. Het bouwt voort op dezelfde IO-bewuste, exacte attention-basis als eerdere versies, maar is specifiek ontworpen voor NVIDIA H100 (Hopper) GPU’s.
De belangrijkste verandering is dat FA3 is ontworpen om de nieuwe asynchrone hardwarefuncties van Hopper te benutten, waardoor geheugenverplaatsing en berekening veel agressiever dan voorheen kunnen overlappen.
In eerdere versies volgden alle GPU-threads, ook wel warps genoemd, hetzelfde uitvoeringspad. FA3 verandert dit model via warp-specialisatie. Het kent elke warp een van twee verschillende rollen toe:
Deze scheiding maakt het mogelijk om datatransfer en berekening tegelijkertijd te laten plaatsvinden. Terwijl producer-warps de volgende tegels data ophalen, blijven consumer-warps bezig met rekenen op de huidige tegels, wat de latentie aanzienlijk verbetert
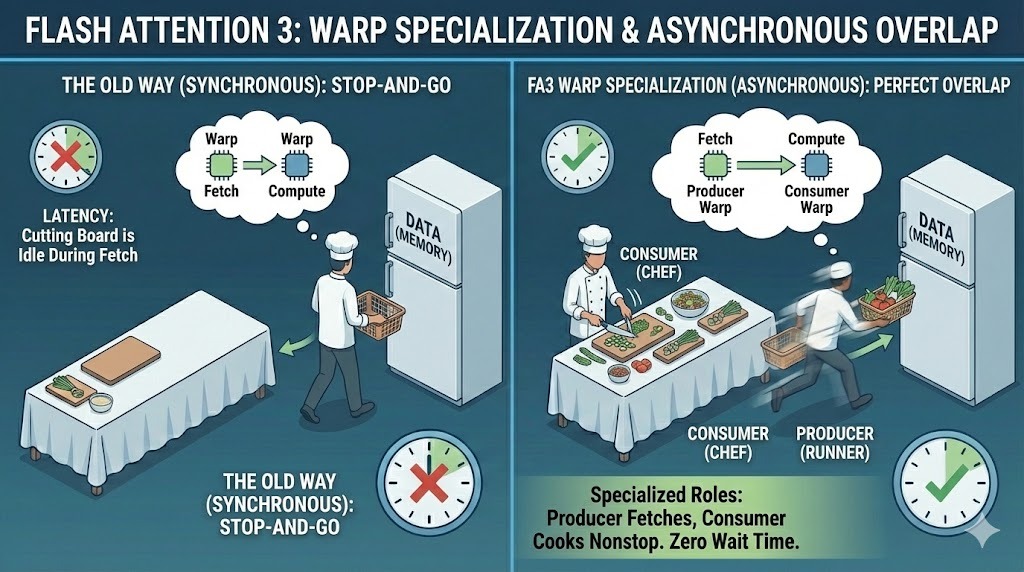
Warp-specialisatie in Flash Attention 3
Flash Attention 3 introduceert ook native ondersteuning voor FP8, oftewel 8-bit drijvende-kommaprecisie. Eerdere versies vertrouwden vooral op FP16 of BF16, wat het geheugengebruik al verminderde ten opzichte van FP32, maar nog steeds aanzienlijke bandbreedte vergde.
FP8 halveert de geheugenvoetafdruk grofweg nog eens. Deze vermindering vertaalt zich direct in hogere doorvoer en lagere geheugenbelasting. Op Hopper-GPU’s is FP8 hardwareversneld, wat betekent dat FA3 meer attention-bewerkingen per seconde kan verwerken zonder in te leveren op nauwkeurigheid op modelniveau.
Deze mogelijkheid is een belangrijke reden waarom grote modellen zoals Gemini 3 enorme contextvensters aankunnen terwijl ze miljoenen gebruikers efficiënt bedienen.
Een laatste onderdeel van het FA3-ontwerp is het gebruik van de Tensor Memory Accelerator (TMA) van de H100. De TMA is gespecialiseerde hardware die geheugenkopieën asynchroon afhandelt, zonder de hoofdrekenkernen te bezetten.
Flash Attention 3 gebruikt TMA om tegels met data op de achtergrond te verplaatsen terwijl de berekening ononderbroken doorgaat. Door geheugenverplaatsing strak te laten overlappen met rekenwerk kan FA3 dicht bij 75 procent van de theoretische piekprestaties van de hardware uitkomen.
Flash Attention 4 (FA4) vertegenwoordigt de volgende experimentele stap in attention-optimalisatie. Het is ontworpen voor NVIDIA’s aankomende Blackwell B200 GPU’s en verkent wat mogelijk wordt wanneer attention-kernels voor een geheel nieuwe klasse hardware worden gebouwd.
Omdat modelgroottes blijven groeien en trainingsruns naar het triljoen-parameterbereik opschuiven, zal zelfs Flash Attention 3 uiteindelijk grenzen bereiken. FA4 is een vroege poging om die grenzen weg te nemen door de hardwarebenutting verder op te voeren dan welke eerdere attention-kernel ook.
In dit stadium is Flash Attention 4 een onderzoeks- en preproductietechnologie. Het toont veelbelovende resultaten, maar wordt nog niet gebruikt in uitgerolde of productierijpe modellen.
Een van de grote mijlpalen van Flash Attention 4 is performance. Het is de eerste attention-kernel die is ontworpen om meer dan 1 PFLOPS, ofwel één biljard drijvende-kommabewerkingen per seconde, op een enkele GPU te overschrijden.
Het richt zich op een toekomst waarin het trainen van triljoen-parameter-modellen onpraktisch veel tijd zou kosten om te voltooien. Op die schaal stapelen zelfs kleine inefficiënties zich op tot enorme vertragingen. FA4 wil die toekomstige trainingsruns haalbaar maken door extreme prestaties uit één chip te halen.
Om die performance te halen, duwt FA4 asynchronie veel verder dan eerdere versies. Het breidt het producer-consumer-model uit tot zeer complexe, meerfasige pijplijnen waarin databeweging, berekening en synchronisatie allemaal onafhankelijk opereren.
In plaats van een relatief simpele overlap tussen laden en rekenen, beheert FA4 diep asynchrone uitvoering over meerdere fasen. Verschillende delen van de kernel vorderen met verschillende snelheden, gecoördineerd door scheduling op hardwareniveau in plaats van één gesynchroniseerde stroom.
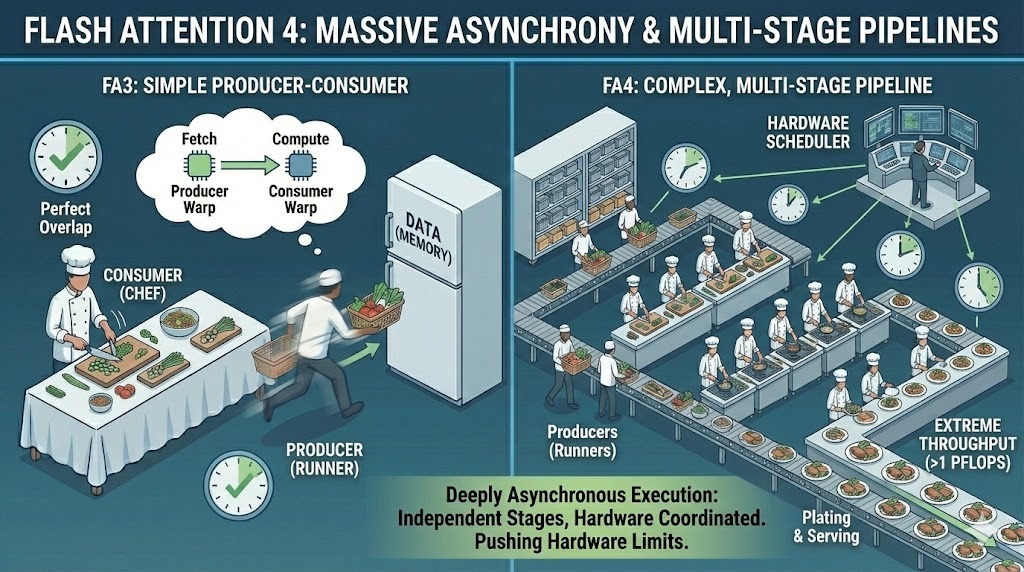
Massale asynchronie in Flash Attention 4
Deze complexiteit is ook waarom FA4 experimenteel blijft. Nauwkeurigheid, stabiliteit en integratie op dit niveau beheren is uitdagend. De community heeft nog meer werk te doen voordat teams het betrouwbaar binnen grote productiemodellen kunnen gebruiken.
Laten we kijken hoe Flash Attention zich verhoudt tot het standaard attention-mechanisme op een paar belangrijke punten.
Benchmarks laten consequent zien dat alle Flash Attention-versies standaard self-attention overtreffen, met grotere winst naarmate de sequentielengte toeneemt.
Het oorspronkelijke Flash Attention-paper rapporteert ruwweg 2 tot 4× snelheidswinst ten opzichte van geoptimaliseerde standaard attention. Flash Attention 2 bouwt hier verder op door het parallelisme te vergroten en de GPU beter te verzadigen, wat in de praktijk vaak nog eens ~2× verbetering oplevert.
Flash Attention 3 stuwt de prestaties nog verder op Hopper-GPU’s, vooral met FP8, en bereikt veel hogere hardwarebenutting dan standaard attention kan halen.
Standaard attention materialiseert expliciet de volledige N × N attention-matrix, wat leidt tot kwadratische geheugengroei ten opzichte van de sequentielengte. Naarmate N groeit, explodeert het geheugengebruik en raakt het GPU-geheugen snel overbelast. Flash Attention slaat deze matrix geheel over.
Door attention in tegels te berekenen en tussentijdse resultaten in snel on-chip geheugen te houden, reduceert het geheugengebruik tot lineair met de sequentielengte bij vaste headdimensies. Deze verschuiving van kwadratische naar lineaire geheugenschaal haalt de grootste structurele bottleneck uit standaard attention weg.
Die geheugenreductie maakt langere contextvensters direct mogelijk. Met standaard attention lopen modellen vaak tegen out-of-memory-fouten aan zodra sequenties enkele duizenden tokens bereiken.
Flash Attention maakt 4k- en 8k-tokencontexten praktisch op één GPU, en ontgrendelt zelfs veel langere vensters, zoals 16k of 32k tokens, op datzelfde apparaat in combinatie met andere geheugenbesparende technieken.
Raak hier niet in de war: de enorme vensters van miljoenen tokens in sommige huidige frontrunnermodellen zoals Gemini 3 worden bereikt door de sequentie over grote GPU-clusters te verdelen, omdat ze de geheugencapaciteit van elk enkel apparaat ver overstijgen.
Flash Attention gebruiken is tegenwoordig veel eenvoudiger dan vroeger. In de meeste gevallen hoef je geen aangepaste CUDA-kernels te schrijven of je modelarchitectuur te wijzigen. De ondersteuning zit al in de populaire tools van nu.
Sinds PyTorch 2.0 is Flash Attention direct beschikbaar via torch.nn.functional.scaled_dot_product_attention. Wanneer je deze functie aanroept, kiest PyTorch automatisch de snelste beschikbare attention-backend voor jouw hardware.
Op ondersteunde GPU’s is die backend Flash Attention. Voor de gebruiker lijkt het vaak op standaard attention-code, maar onder de motorkap roept PyTorch een geoptimaliseerde Flash Attention-kernel aan.
Als je Hugging Face Transformers gebruikt, is Flash Attention inschakelen meestal een aanpassing van één regel. Door attn_implementation="flash_attention_2" in de modelconfiguratie te zetten, geef je de bibliotheek de opdracht om waar mogelijk Flash Attention 2 te gebruiken.
Voor veel transformermodellen is dit genoeg om zowel snelheids- als geheugenwinsten te behalen zonder de rest van de trainings- of inferentiecode aan te raken.
Flash Attention 2 richt zich op moderne NVIDIA-GPU’s en draait het best op Ampere-, Ada- en Hopper-architecturen, waaronder de A100, RTX 3090, RTX 4090 en H100. Deze GPU’s bieden de geheugenbandbreedte en architecturale functies die nodig zijn om volledig te profiteren van de tiling en het parallelisme in FA2.
Het is ook goed om te weten dat de oorspronkelijke Flash Attention v1 oudere GPU’s ondersteunt. Kaarten op basis van Turing, zoals de T4 en RTX 2080, kunnen nog steeds Flash Attention v1 gebruiken, al vereisen de nieuwere versies recentere hardware om hun volledige prestatiewinst te ontsluiten.
In de praktijk is Flash Attention vaak slechts een configuratieschakelaar verwijderd als je al PyTorch 2.x of Hugging Face Transformers op een moderne NVIDIA-GPU gebruikt.
Standaard attention liep tegen een harde muur aan, omdat kwadratische geheugengroei lange sequenties traag, duur of simpelweg onmogelijk maakte door out-of-memory-fouten. Flash Attention veranderde dat door te herontwerpen hoe attention wordt uitgevoerd.
Door het geheugengebruik van kwadratisch naar lineair terug te brengen ten opzichte van sequentielengte, maakt Flash Attention modellering met lange contexten praktisch. Contextvensters die GPU’s voorheen al bij enkele duizenden tokens overweldigden, schalen nu naar 4k, 8k en zelfs 32k-plus tokens op dezelfde hardware.
Als je op schaal met transformers werkt en geen Flash Attention gebruikt, laat je vrijwel zeker performance liggen.
Zin om je eigen modellen te bouwen die Flash Attention kunnen gebruiken? Volg onze cursus over transformermodellen met PyTorch!
AI-cursussen
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min

