
Last chance! 50% off DataCamp Premium
Sale ends in
अंकगणितीय माध्य, जिसे आमतौर पर "औसत" कहा जाता है, अक्सर वर्णनात्मक सांख्यिकी में शुरुआती बिंदु होता है। यह केंद्रीय प्रवृत्ति का एक त्वरित और सहज माप प्रदान करता है, जो किसी भी क्षेत्र में डेटा की व्याख्या करने का आवश्यक हिस्सा है। यद्यपि अवधारणा सीधी लग सकती है, अंकगणितीय माध्य की बारीकियों को समझना जटिल डेटा रुझानों और पैटर्नों में वास्तविक अंतर्दृष्टि प्रकट कर सकता है।
यह लेख अंकगणितीय माध्य का एक अवलोकन प्रस्तुत करता है, जिसमें इसका सूत्र, अनुप्रयोग, और अन्य प्रकार के माध्यों से तुलना शामिल है। हम देखेंगे कि अर्थशास्त्र, डेटा विज्ञान, और अन्य क्षेत्रों में यह अक्सर क्यों प्रयोग किया जाता है, और साथ ही वे परिस्थितियाँ भी चर्चा करेंगे जहाँ वैकल्पिक माप अधिक उपयुक्त हो सकते हैं।
जो लोग सांख्यिकी में नए हैं या अपनी समझ पुख्ता करना चाहते हैं, उनके लिए हमारा Introduction to Statistics पाठ्यक्रम एक उत्कृष्ट आधार प्रदान करता है। हमारा Descriptive Statistics Cheat Sheet भी इस विषय से संबंधित शब्दावलियों का सहायक शब्दकोश प्रदान करता है।
अंकगणितीय माध्य किसी डेटासेट के सभी संख्याओं का योग होता है, जिसे उन संख्याओं की गिनती से भाग दिया जाता है। यह सीधी गणना इसे केंद्रीय प्रवृत्ति के सबसे सहज और व्यापक रूप से प्रयुक्त मापों में से एक बनाती है।
उदाहरण के लिए, मान लीजिए हमारे पास तीन संख्याएँ हैं: 5, 10, और 15। इनका अंकगणितीय माध्य निकालने के लिए:
अतः, 5, 10, और 15 का अंकगणितीय माध्य 10 है।
अंकगणितीय माध्य में कई महत्वपूर्ण गुण होते हैं जो गहराई से देखने पर और भी रोचक हो जाते हैं।
अंकगणितीय माध्य का एक मौलिक गुण यह है कि उससे विचलनों (deviations) का कुल योग सदैव शून्य होता है। अर्थात, यदि आप प्रत्येक डेटा बिंदु से माध्य घटाएँ और इन अंतरों का योग करें, तो परिणाम शून्य होगा। गणितीय रूप से, इसे इस प्रकार व्यक्त किया जा सकता है:
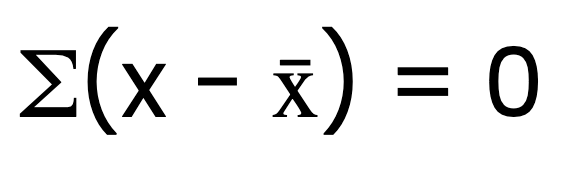
जहाँ x डेटासेट के प्रत्येक मान का प्रतिनिधित्व करता है, और x̄ अंकगणितीय माध्य है।
अत्यधिक मानों वाले डेटासेट में, अंकगणितीय माध्य इन अपवादात्मक मानों (outliers) की ओर काफी खिंच सकता है, जिससे विशेषकर तिरछे (skewed) वितरणों में भ्रामक व्याख्याएँ हो सकती हैं। उदाहरण के लिए, एक छोटे कंपनी के वेतन डेटासेट पर विचार करें: {$30,000, $35,000, $40,000, $45,000, $1,000,000}। अंकगणितीय माध्य ($230,000) अधिकांश वेतनों से काफी अधिक है क्योंकि $1,000,000 का अपवादात्मक मान मौजूद है।
यह संवेदनशीलता, अपवादात्मक मानों की उपस्थिति में या तिरछे वितरणों के लिए, माध्य को माध्यिका जैसे मापों की तुलना में कम सुदृढ़ बनाती है। हालांकि, यह माध्य को अपवादात्मक मानों की उपस्थिति का पता लगाने या डेटासेट पर अत्यधिक मानों के प्रभाव को समझने में उपयोगी भी बना सकती है।
अंकगणितीय माध्य डेटासेट में परिवर्तनों पर पूर्वानुमेय ढंग से प्रतिक्रिया करता है, जो विभिन्न विश्लेषणात्मक परिदृश्यों में उपयोगी हो सकता है:
ये गुण उन परिस्थितियों में अंकगणितीय माध्य को विशेष रूप से उपयोगी बनाते हैं जहाँ पूरे डेटासेट में एक समान परिवर्तन हो, जैसे आर्थिक डेटा में मुद्रास्फीति के समायोजन या वैज्ञानिक प्रयोगों में मापों का स्केलिंग।
अंकगणितीय माध्य एक बहुउपयोगी सांख्यिकीय उपकरण है, पर यह खास परिस्थितियों में विशेष रूप से प्रभावी है। पहले यह कहना उचित होगा कि अंकगणितीय माध्य योगात्मक प्रक्रियाओं वाले डेटासेट के लिए विशेष रूप से उपयोगी है। उदाहरण के लिए, यदि आप औसत दैनिक तापमान, किसी कंपनी में औसत वेतन, या औसत परीक्षा अंक की गणना कर रहे हैं, तो अंकगणितीय माध्य केंद्रीय मान का सार्थक निरूपण प्रदान करता है।
साथ ही, यह भी कहना चाहिए कि अंकगणितीय माध्य तब सबसे विश्वसनीय होता है जब डेटा बिंदु समान रूप से वितरित हों और कोई चरम अपवाद न हों। आइए कुछ उद्योग-विशिष्ट उदाहरण देखें:
यद्यपि हमने मूल अवधारणा को कवर कर लिया है, आइए देखें कि बड़े डेटासेट के लिए व्यावहारिक रूप से आवश्यक R, Python, और Excel जैसे उपकरणों का उपयोग करके अंकगणितीय माध्य कैसे निकाला जाए।
अंकगणितीय माध्य का सूत्र है:
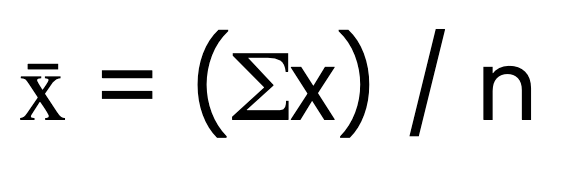
जहाँ x̄ अंकगणितीय माध्य है, Σx सभी मानों का योग है, और n मानों की संख्या है।
बड़े डेटासेट के लिए, सॉफ्टवेयर टूल गणना को काफी आसान बना देते हैं। यहाँ बताया गया है कि Excel, Python, और R में अंकगणितीय माध्य कैसे निकाला जाए।
Excel में आप AVERAGE() फ़ंक्शन का उपयोग कर सकते हैं:
अपना डेटा किसी कॉलम या पंक्ति में दर्ज करें।
एक नई सेल में =AVERAGE() टाइप करें।
अपने डेटा वाली सेल्स की रेंज चुनें।
कोष्ठक बंद करें और Enter दबाएँ।
उदाहरण के लिए, यदि आपका डेटा A1:A10 सेल्स में है, तो आप उपयोग करेंगे: =AVERAGE(A1:A10)।
Python के statistics मॉड्यूल में mean() फ़ंक्शन उपलब्ध है:
from statistics import mean

data = [5, 10, 15, 20, 25]

result = mean(data)
print(result)  # Output: 15
बड़े डेटासेट के लिए, आप NumPy के अधिक कुशल mean() फ़ंक्शन को पसंद कर सकते हैं:
import numpy as np

data = np.array([5, 10, 15])

result = np.mean(data)
print(result)  # Output: 10.0
R में, आप base R के बिल्ट-इन mean() फ़ंक्शन का उपयोग कर सकते हैं:
data <- c(5, 10, 15)

result <- mean(data)
print(result)  # Output: [1] 10
ये टूल किसी भी आकार के डेटासेट के लिए अंकगणितीय माध्य की गणना की प्रक्रिया को सरल बनाते हैं, जिससे आप मैनुअल गणना के बजाय डेटा की व्याख्या पर ध्यान केंद्रित कर सकें।
डेटा साइंस और मशीन लर्निंग में अंकगणितीय माध्य के अनुप्रयोग डेटा पूर्वप्रक्रिया से लेकर मॉडल मूल्यांकन तक फैले हुए हैं। आइए कुछ प्रमुख क्षेत्रों का पता लगाएँ जहाँ अंकगणितीय माध्य विशेष रूप से महत्वपूर्ण है।
डेटा पूर्वप्रक्रिया में अंकगणितीय माध्य का सबसे सामान्य उपयोग फीचर स्केलिंग में होता है, विशेषकर मीन सेंटरिंग में:
मीन सेंटरिंग: इस प्रक्रिया में किसी फीचर के प्रत्येक डेटा बिंदु से अंकगणितीय माध्य घटाया जाता है। परिणामस्वरूप केंद्रित डेटासेट मिलता है जहाँ प्रत्येक फीचर का माध्य शून्य होता है। इसे इस प्रकार दर्शाया जा सकता है: x_centered = x - x̄ जहाँ x मूल मान है और x̄ उस फीचर का अंकगणितीय माध्य है।
मानकीकरण: अक्सर मीन सेंटरिंग के साथ उपयोग किया जाता है; इसमें माध्य घटाने के बाद मानक विचलन से भाग दिया जाता है: x_standardized = (x - x̄) / σ, जहाँ σ फीचर का मानक विचलन है।
ये तकनीकें फीचर्स के स्केल को सामान्यीकृत करने में मदद करती हैं, जो कई मशीन लर्निंग एल्गोरिदम के लिए विशेष रूप से महत्वपूर्ण है। यदि आप Normalization और Standardization के अंतर के बारे में अधिक जानना चाहते हैं, तो आप विस्तृत ट्यूटोरियल देख सकते हैं।
अंकगणितीय माध्य विभिन्न मॉडल मूल्यांकन मीट्रिक में बुनियादी भूमिका निभाता है:
सांख्यिकीय विश्लेषण में, अंकगणितीय माध्य का अक्सर परिकल्पना परीक्षण में उपयोग होता है। उदाहरण के लिए:
जैसा कि आप देख रहे होंगे, अंकगणितीय माध्य डेटा के आउटपुट की व्याख्या के लिए महत्वपूर्ण है और अक्सर पूर्वप्रक्रिया के रूप में भी आवश्यक होता है जो मॉडल के इष्टतम प्रदर्शन के लिए जरूरी है। इन अवधारणाओं और उनके व्यावहारिक अनुप्रयोगों की समझ गहरी करने के लिए, हमारा Machine Learning Scientist in Python करियर ट्रैक लें, जो इन विषयों को और विस्तार से कवर करता है।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स
