Curso
Introdução ao Apache Airflow em Python
4 h
64.6K
Se você vive gerenciando tarefas recorrentes manualmente, sabe que além de cansativo, isso é a receita para perder prazos e ter pipelines de dados inconsistentes.
Cron jobs são a solução clássica para automatizar tarefas repetitivas em sistemas baseados em Unix. Eles permitem agendar comandos ou scripts para rodar em intervalos específicos. Ao aproveitar a simplicidade e flexibilidade do agendamento do cron, você consegue automatizar desde coletas básicas de dados até workflows complexos de ETL que, de outra forma, exigiriam intervenção manual constante. Configurar esses processos automatizados elimina erros humanos e garante que seus pipelines rodem de forma consistente e confiável.
Dominar cron jobs é essencial para qualquer profissional de engenharia de dados que trabalha em ambientes Unix. A capacidade de agendar e gerenciar tarefas automáticas melhora muito seu fluxo de trabalho e reduz a sobrecarga de manutenção.
Neste guia completo, vou te mostrar tudo o que você precisa saber sobre cron jobs para engenharia de dados — do setup básico a casos de uso avançados e boas práticas.
>Está começando em engenharia de dados? Nosso curso desmistifica os termos e explica os conceitos.
Um cron job é um agendador baseado em tempo nos sistemas Unix que permite executar comandos automaticamente em horários, datas ou intervalos fixos.
Pense no cron como seu assistente pessoal que executa tarefas exatamente quando você quer, sem intervenção manual. Para engenheiros de dados, isso significa automatizar backups de banco, transferências de dados, geração de relatórios e muito mais.
Os cron jobs ficam em um arquivo de texto simples chamado "crontab" (tabela do cron). Cada linha nesse arquivo representa uma tarefa agendada e segue um formato específico com seis componentes:
* * * * * command-to-execute
│ │ │ │ │
│ │ │ │ └─── Day of week (0-6, where 0 is Sunday)
│ │ │ └───── Month (1-12)
│ │ └─────── Day of month (1-31)
│ └───────── Hour (0-23)
└─────────── Minute (0-59)
Os cinco primeiros campos dizem ao cron exatamente quando rodar seu comando. Você pode usar valores específicos, intervalos (como 1-5), listas (como 1, 3, 5) ou asteriscos (*) que significam "todas" as unidades de tempo. O sexto componente é o comando que você quer executar.
Por exemplo, se você quiser rodar um script em Python para extrair dados de uma API todos os dias à meia-noite, seu cron job seria assim:
0 0 * * * /usr/bin/python3 /home/username/scripts/extract_data.pyIsso diz ao cron para rodar seu script no minuto 0, hora 0 (meia-noite), todos os dias do mês, todos os meses e todos os dias da semana. O caminho absoluto tanto do interpretador Python quanto do seu script garante que o job rode corretamente, independentemente do ambiente.
Você também pode criar agendamentos mais complexos. Digamos que você queira rodar uma limpeza no banco toda segunda, quarta e sexta às 15h30. Sua expressão do cron seria:
30 15 * * 1,3,5 /path/to/cleanup_script.shCada asterisco funciona como curinga e permite criar horários flexíveis conforme sua necessidade. Você também pode usar atalhos como @daily, @weekly ou @monthly para tornar padrões comuns mais legíveis.
Pronto, esses são os fundamentos. A seguir, vou mostrar na prática como trabalhar com cron jobs em tarefas de engenharia de dados.
Agora que você entendeu o que são cron jobs, vamos configurar sua primeira tarefa automatizada. O processo é simples e exige apenas alguns comandos para começar.
Para criar ou alterar cron jobs, você precisa acessar seu arquivo crontab. Faça isso com o comando crontab -e:
crontab -e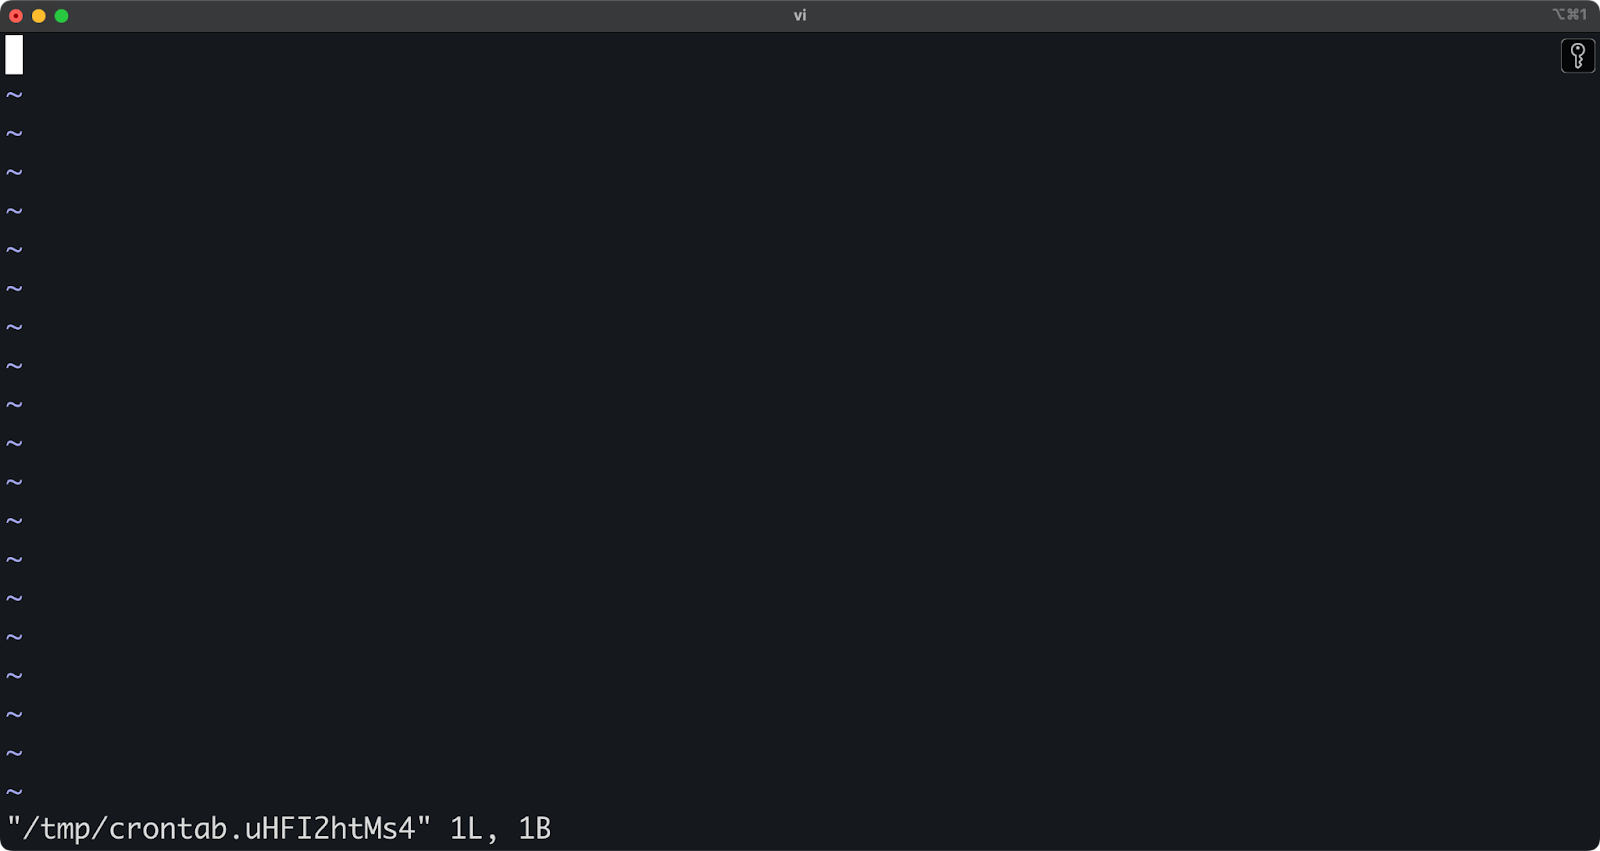
Imagem 1 - Editando um arquivo crontab
O comando acima abre o editor de texto vi, no qual você pode adicionar, editar ou remover tarefas agendadas.
Seu arquivo crontab pode estar vazio se você nunca o usou. Para adicionar um novo cron job, basta inserir uma linha seguindo a sintaxe do cron que expliquei. Cada linha deve incluir o agendamento e o comando a ser executado.
Por exemplo, para rodar um script todos os dias às 3h, adicione esta linha:
0 3 * * * /path/to/your/commandSalve o arquivo e saia do editor. O cron instalará automaticamente seu novo crontab e começará a executar os jobs nos horários definidos.
Vamos a um exemplo prático: agendar um script em Python para buscar dados de uma API a cada minuto. Aqui está um script completo em Python que conecta ao endpoint REST, busca dados de objetos e salva em um arquivo CSV — apenas garanta que seu Python tenha os pacotes requests e pandas instalados:
# fetch_api_data.py

import requests
import pandas as pd
import os
from datetime import datetime

# Create a timestamp for the filename
timestamp = datetime.now().strftime("%Y%m%d_%H%M%S")

# Set file paths - CHANGE THIS
data_dir = "/Users/dradecic/Desktop/cron/data"
output_file = f"{data_dir}/objects_{timestamp}.csv"

# Make sure the data directory exists
os.makedirs(data_dir, exist_ok=True)

# Fetch data from the API
try:
    response = requests.get("https://jsonplaceholder.typicode.com/posts")
    if response.status_code == 200:
        data = response.json()

        # Check if we have data
        if data:
            df = pd.DataFrame([
                {
                    "id": row.get("id", ""),
                    "user_id": row.get("userId", ""),
                    "title": row.get("title", ""),
                    "body": row.get("body", "")
                } for row in data
            ])

            df.to_csv(output_file, index=False)

            print(f"Data successfully saved to {output_file}")
        else:
            print("API returned empty data")
    else:
        print(f"API request failed with status code: {response.status_code}")
except Exception as e:
    print(f"Error occurred: {str(e)}")
Agora, para agendar esse script com o cron para rodar todos os dias às 2h:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py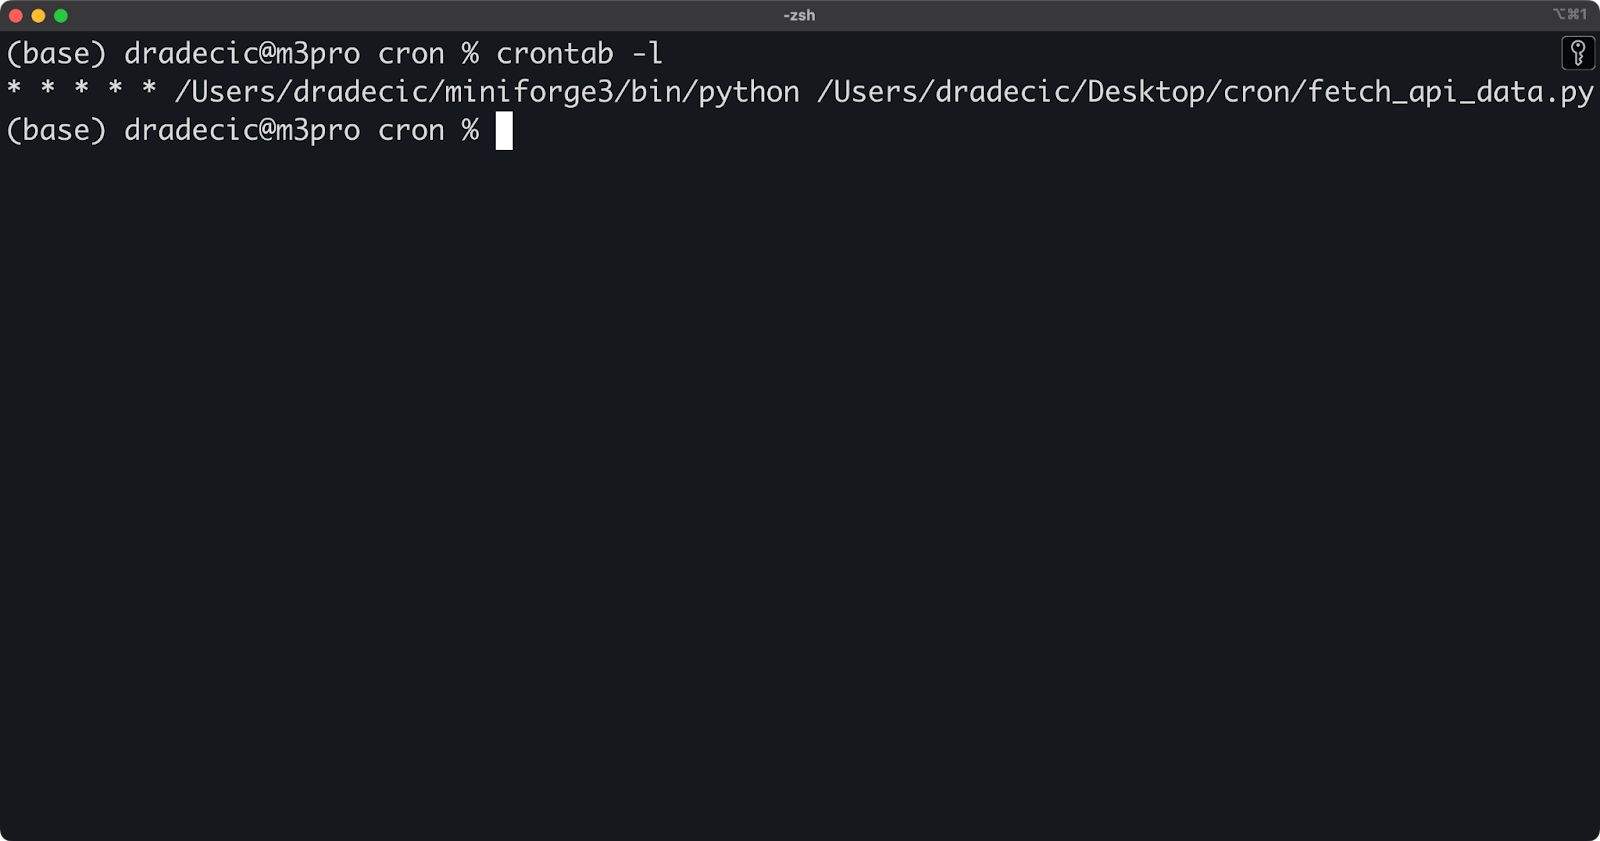
Imagem 2 - Listando crontabs ativos
Essa linha instrui o cron a executar seu script Python a cada minuto de todos os dias. Use caminhos absolutos tanto para o interpretador Python (/Users/dradecic/miniforge3/bin/python no meu caso) quanto para o script (/Users/dradecic/Desktop/cron/fetch_api_data.py no meu caso).
Por que caminhos absolutos? O cron roda com um ambiente limitado, então ele não conhece a variável PATH do seu shell nem seu diretório atual. Sem caminhos absolutos, o job pode falhar porque o cron não encontra os comandos ou arquivos necessários.
Enquanto você lia isto, alguns arquivos CSV foram salvos na minha pasta data, indicando que o cron job está funcionando como esperado:
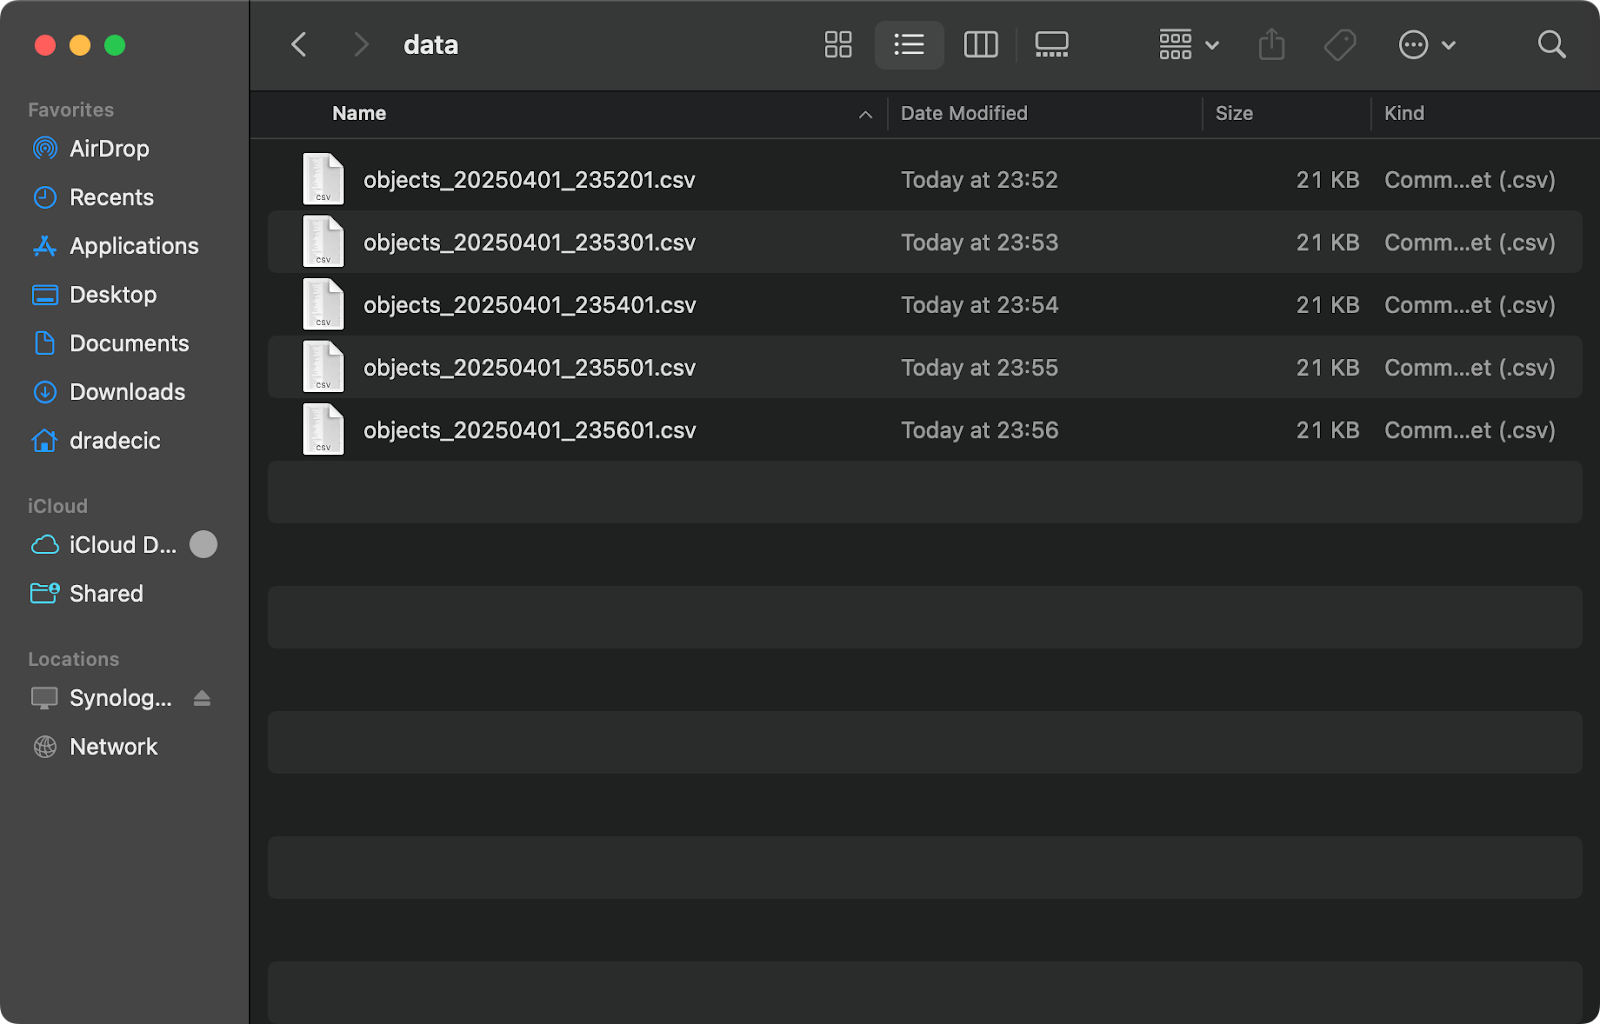
Imagem 3 - Arquivos CSV salvos
Para workflows mais complexos de engenharia de dados como ETL (Extract, Transform, Load), você pode usar o cron para agendar processos em múltiplas etapas. Uma abordagem comum é criar um shell script com todas as etapas do ETL e então agendar esse script no cron.
Para simplificar, o código do script .sh abaixo é apenas teórico e não se conecta a fontes de dados:
#!/bin/bash
# etl_pipeline.sh

# Extract data from source
/usr/bin/psql -U username -d source_db -c "COPY (SELECT * FROM source_table) TO '/tmp/extracted_data.csv' WITH CSV HEADER;"

# Transform data
/usr/bin/python3 /home/username/scripts/transform_data.py

# Load data into target
/usr/bin/psql -U username -d target_db -c "\COPY target_table FROM '/tmp/transformed_data.csv' WITH CSV HEADER;"

# Log completion
echo "ETL job completed at $(date)" >> /home/username/logs/etl_job.log
Feito isso, torne seu shell script executável:
chmod +x /home/username/scripts/etl_pipeline.shPor fim, agende-o no cron para rodar, por exemplo, em dias úteis à 1h:
0 1 * * 1-5 /home/username/scripts/etl_pipeline.shSe você é engenheiro de dados, agendar tarefas de ETL com o cron traz estas vantagens:
Para processos de ETL maiores, vale a pena adicionar tratamento de erros aos seus scripts:
#!/bin/bash
# etl_pipeline.sh

# Set error handling
set -e  # Exit immediately if any command fails

# Execute ETL steps
# ...

# If we get here, all steps succeeded
echo "ETL job completed successfully at $(date)" >> /home/username/logs/etl_job.log
E pronto! Sua pipeline de ETL vai rodar automaticamente nos horários definidos, processando seus dados e registrando o status para monitoramento.
Depois de configurar seus cron jobs, você precisa gerenciá-los e monitorá-los para garantir que rodem como esperado.
Isso inclui verificar quais jobs estão agendados, remover jobs desatualizados e acompanhar sua execução. Nesta seção, você verá comandos e técnicas essenciais para manter seus cron jobs sem dor de cabeça.
Para ver todos os cron jobs atualmente agendados, use o comando crontab -l:
crontab -lO comando acima exibe o conteúdo do seu crontab atual, mostrando todos os jobs, com horários e comandos. É um jeito rápido de verificar o que está ativo sem entrar no modo de edição.
Seu output deve ficar parecido com isto se você seguiu a seção anterior:
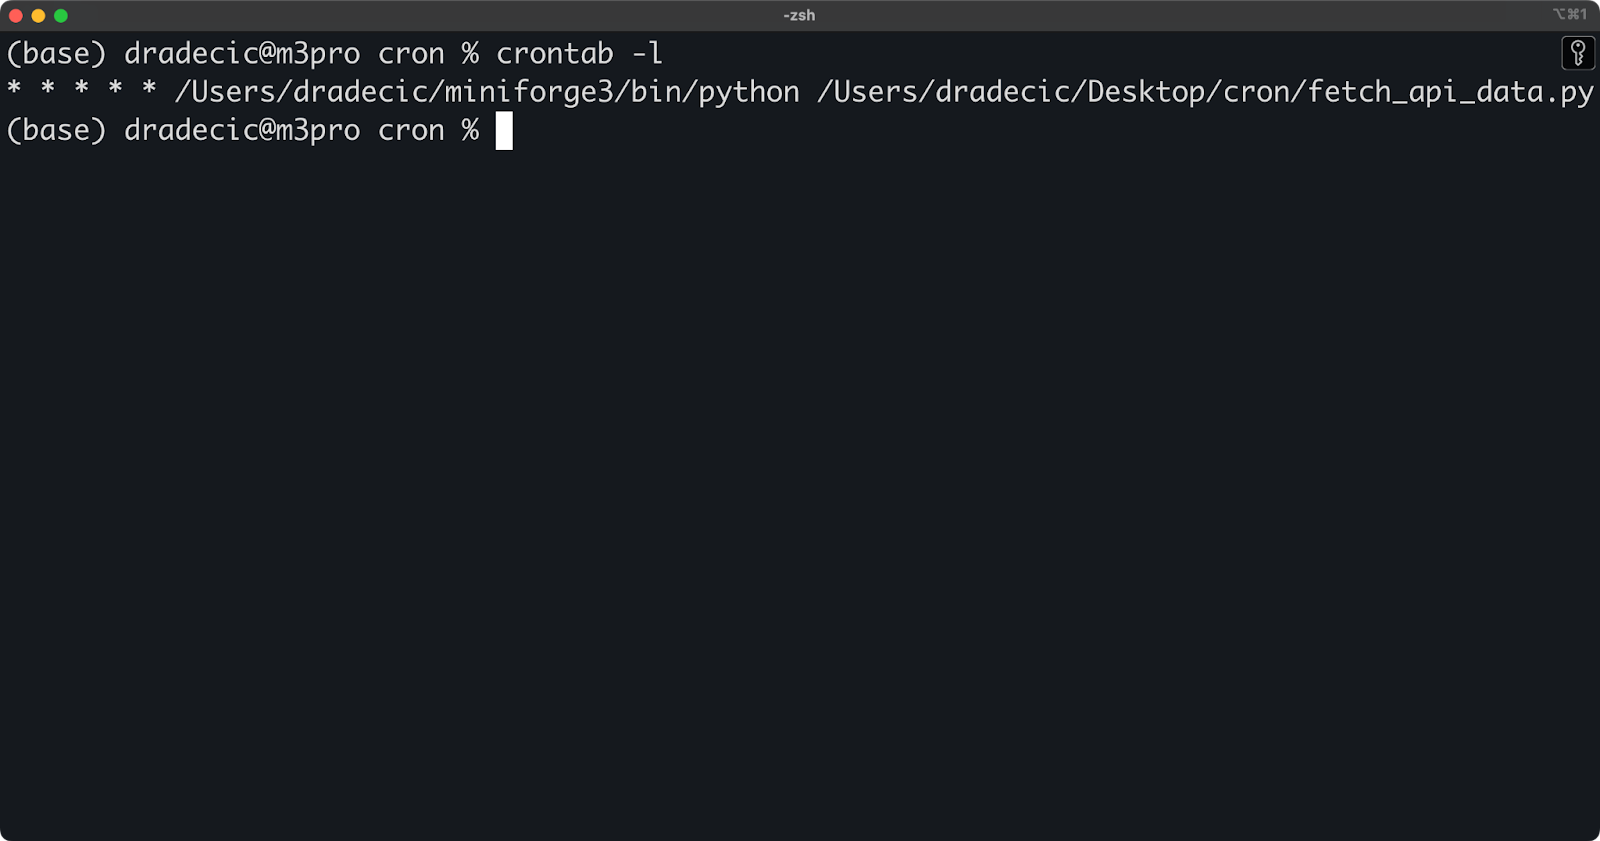
Imagem 4 - Cron jobs ativos
Se você precisar verificar os cron jobs de outro usuário (requer acesso root), rode este comando:
sudo crontab -u username -lHá várias formas de remover ou desativar cron jobs quando não forem mais necessários. Para remover um job específico, abra seu crontab no modo de edição e apague a linha correspondente:
crontab -ePara desativar temporariamente um job sem apagá-lo, comente a linha adicionando um # no início:
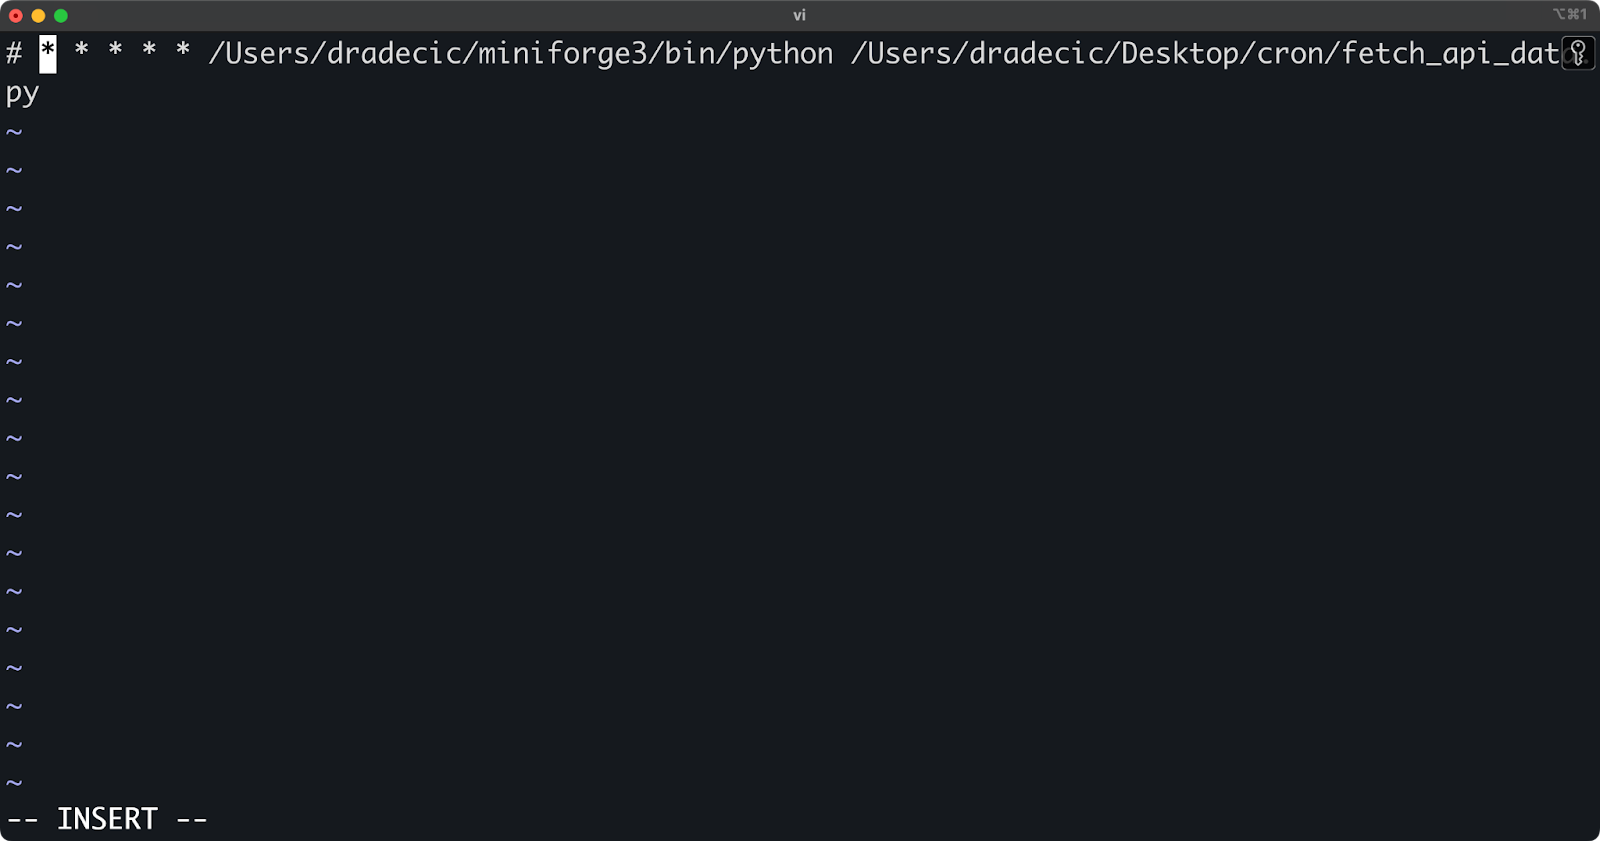
Imagem 5 - Desativando temporariamente um cron job
O job comentado permanece no seu crontab para referência futura, mas não será executado no horário definido.
Se quiser remover todo o seu crontab (todos os jobs), use a opção -r:
crontab -r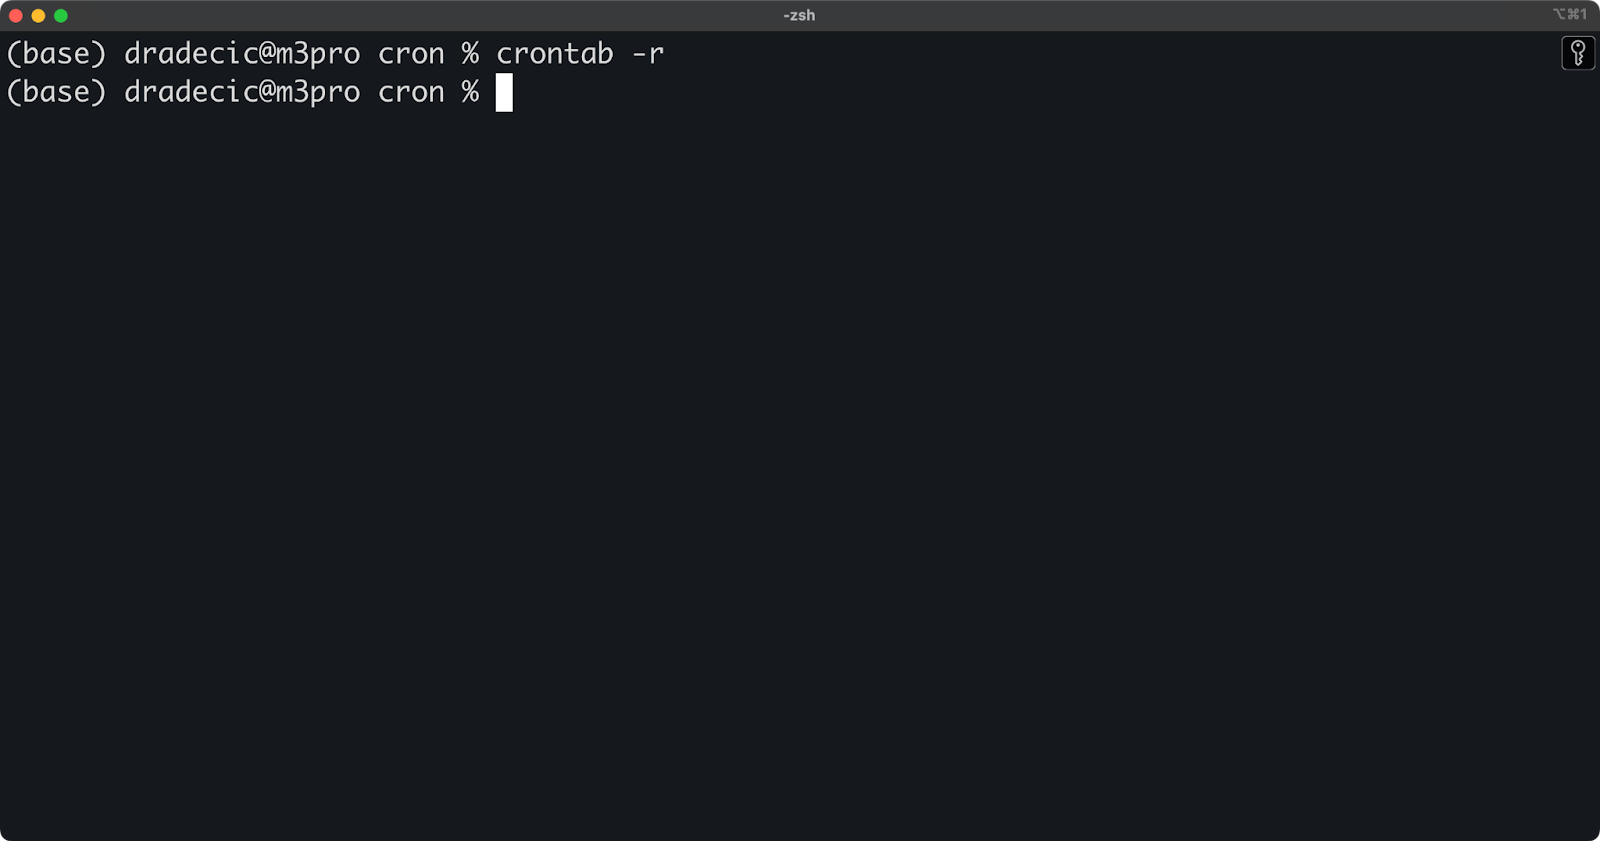
Imagem 6 - Excluindo o crontab inteiro
Cuidado com esse comando — ele remove todos os seus jobs sem pedir confirmação. Para evitar exclusões acidentais, faça backup do seu crontab antes:
crontab -l > my_crontab_backupIsso salva seu crontab atual em um arquivo que você pode usar para restaurar seus jobs se necessário:
crontab my_crontab_backup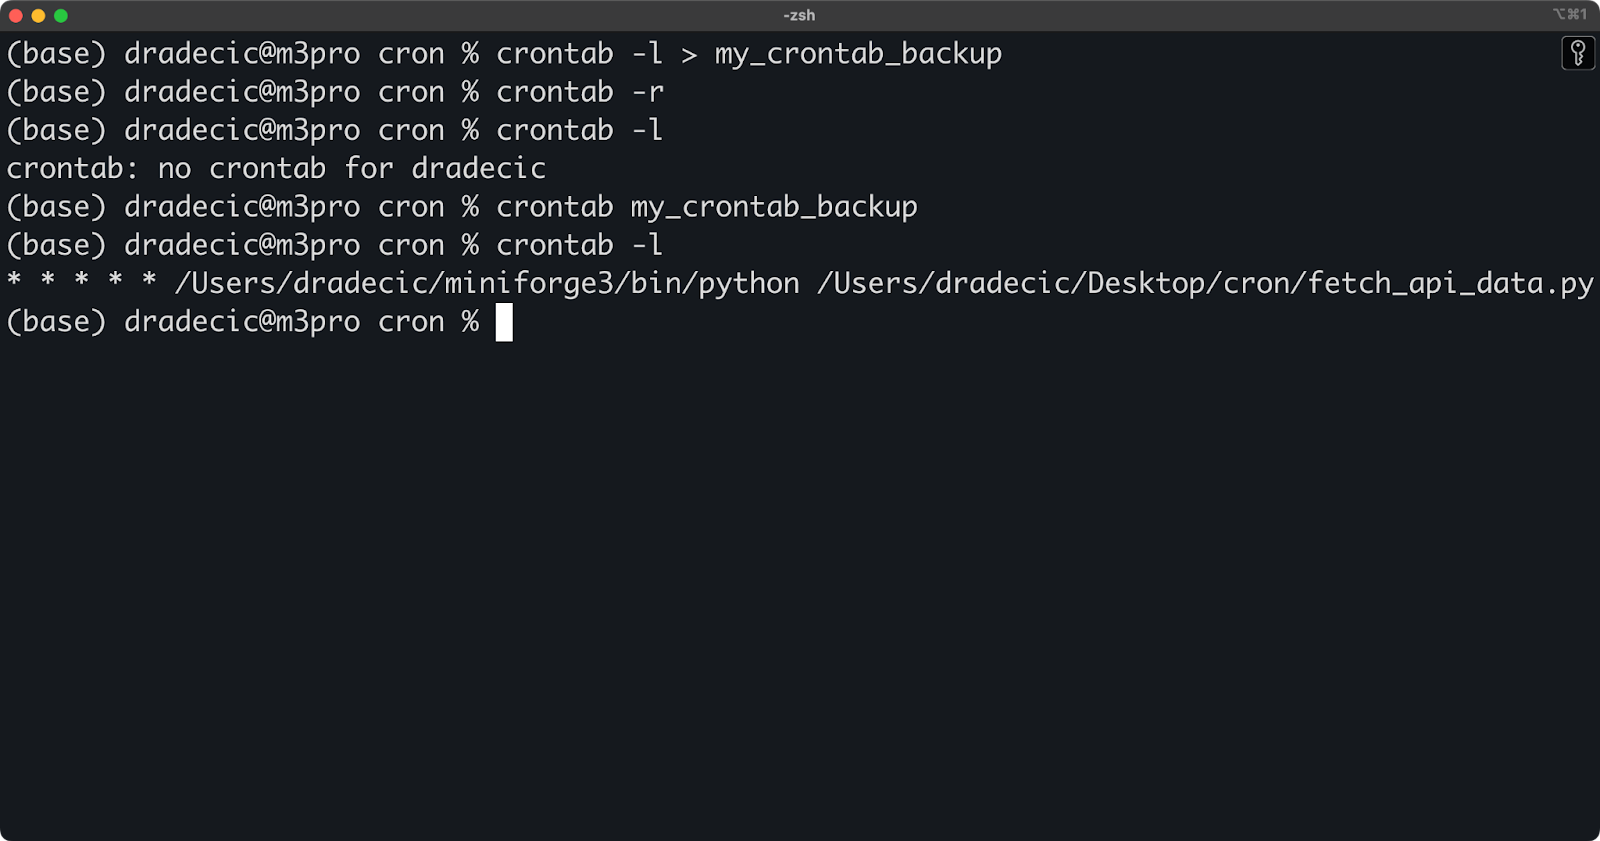
Imagem 7 - Restaurando um crontab a partir de backup
Por padrão, o cron tenta enviar por e-mail a saída dos jobs para o usuário dono do crontab. Porém, isso exige um sistema de e-mails configurado, o que nem sempre está disponível. Em vez disso, você pode redirecionar a saída para arquivos de log, facilitando o acompanhamento e o troubleshooting.
Para capturar tanto a saída padrão quanto as mensagens de erro, use esta sintaxe de redirecionamento:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1Esse redirecionamento pode parecer complicado no começo, então vamos destrinchar:
>> acrescenta a saída ao arquivo especificado.2>&1 redireciona o stderr (erros) para o mesmo lugar do stdout (saída padrão).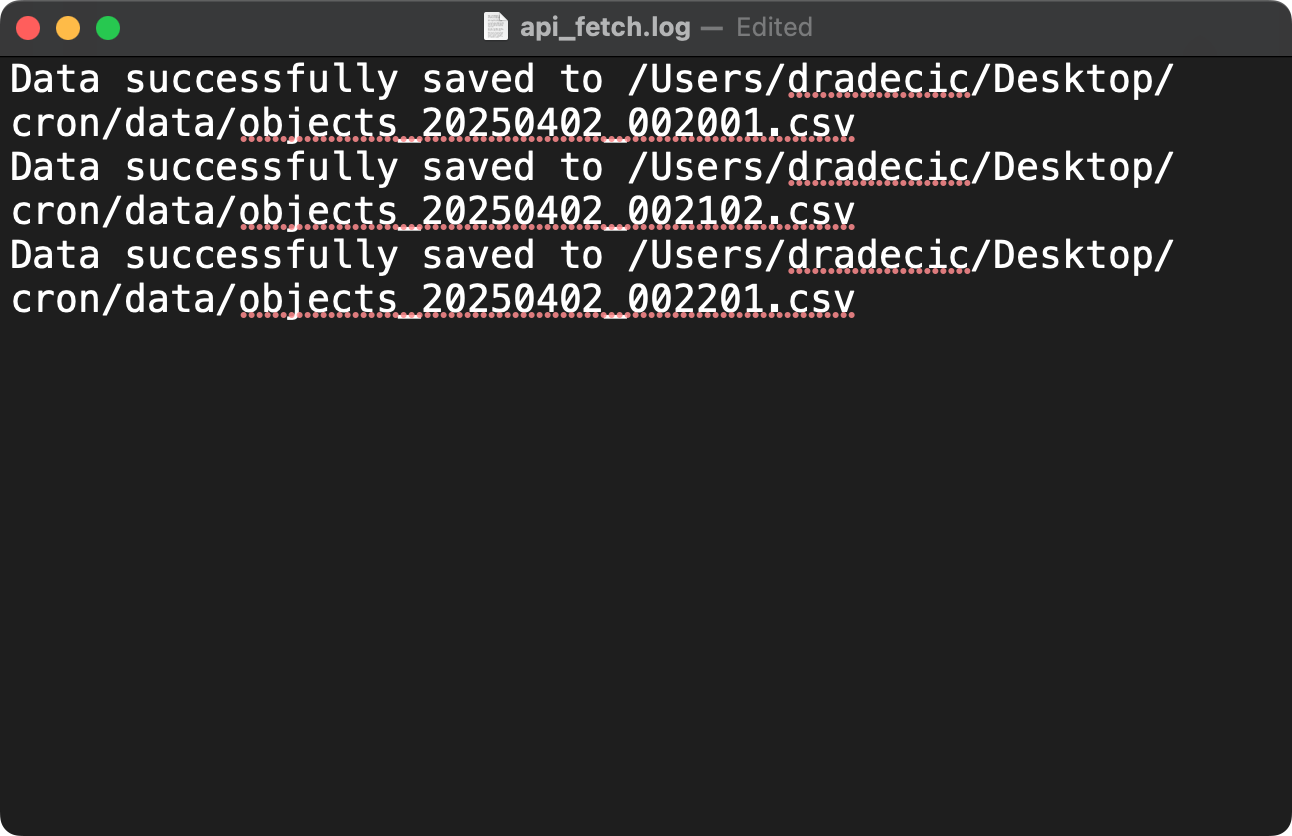
Imagem 8 - Capturando logs de cron jobs
Para gerenciar melhor os logs, você pode adicionar carimbo de data às entradas:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1 && echo "Job completed at $(date)" >> /Users/dradecic/Desktop/cron/logs/api_fetch.log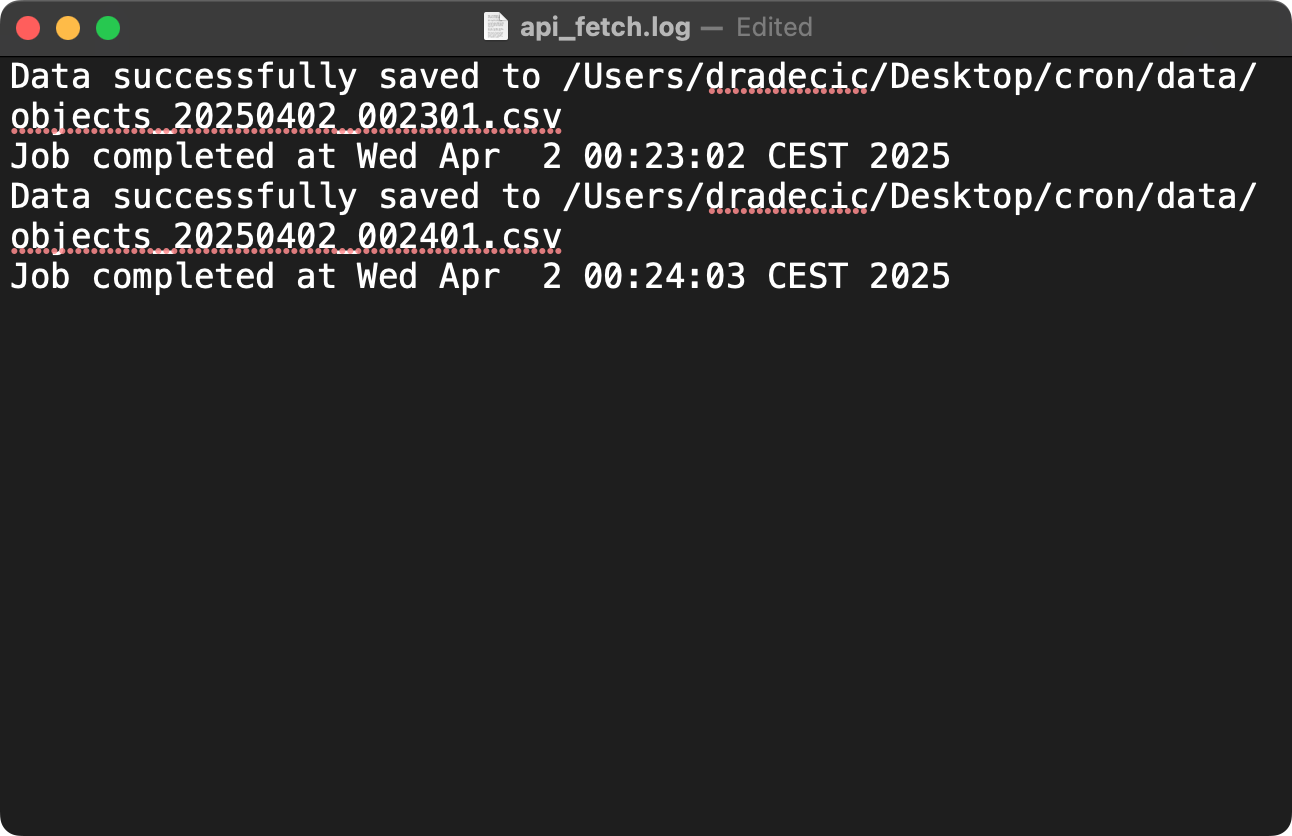
Imagem 9 - Logs de cron com timestamps
Se você quiser separar arquivos de log para saída normal e erros, use:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>> /Users/dradecic/Desktop/cron/logs/api_fetch_errors.log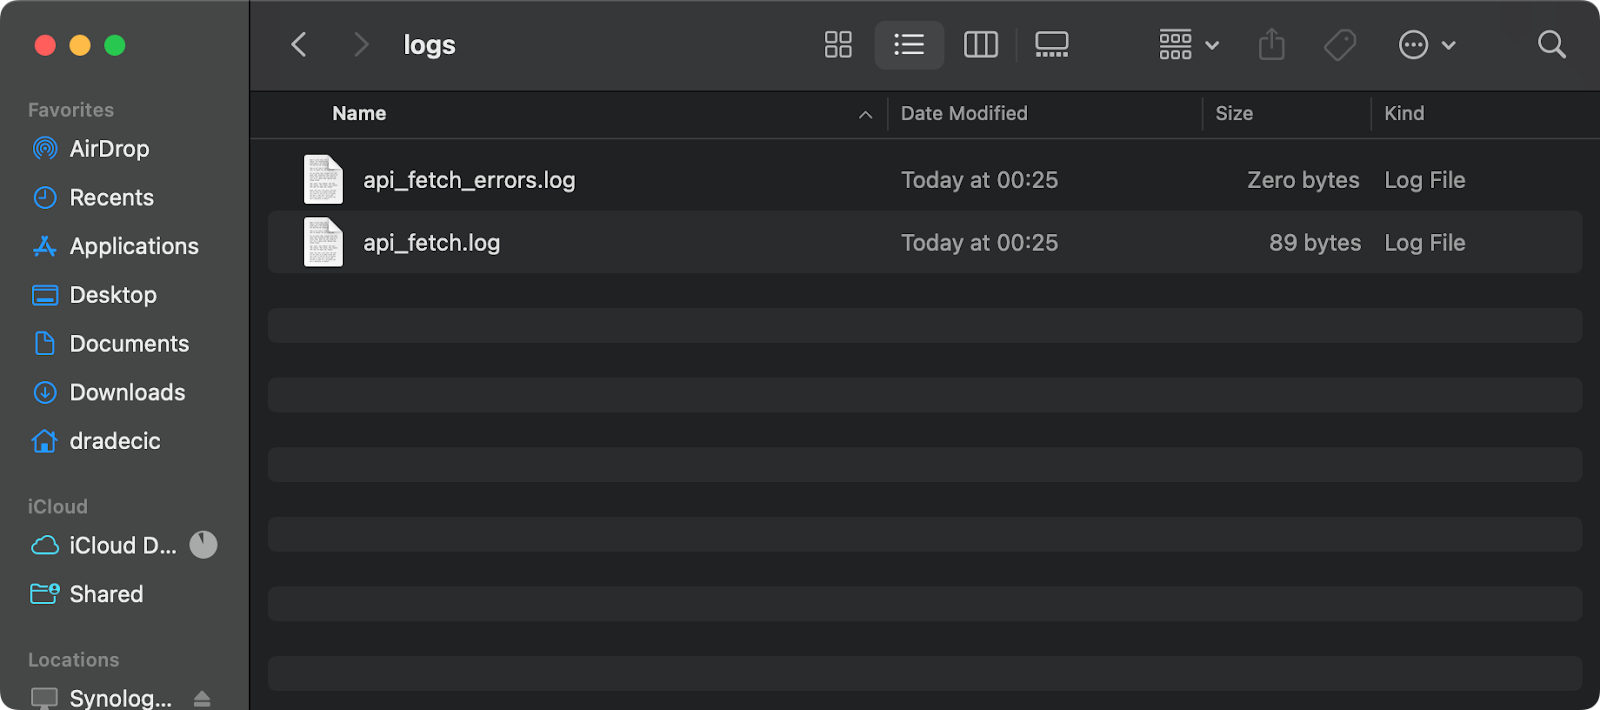
Imagem 10 - Arquivos de log e de erro do cron job
Para jobs críticos que exigem notificação em caso de falha, você pode configurar alertas por e-mail. Supondo que seu sistema tenha um agente de envio de e-mails instalado (como postfix ou sendmail), você pode modificar seu cron job para enviar e-mail apenas se o job falhar:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1 || echo "API fetch failed on $(date)" | mail -s "Cron Job Failed" your-email@example.comIsso usa o operador ||, que significa "rode o comando de e-mail apenas se o comando anterior falhar".
Para notificações de “sucesso”, use:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1 && echo "API fetch completed successfully on $(date)" | mail -s "Cron Job Succeeded" your-email@example.comVocê também pode usar ferramentas de monitoramento mais avançadas como Prometheus com Node Exporter ou serviços dedicados de monitoramento de cron, mas essas técnicas simples de logging e e-mail já atendem bem a maioria das necessidades de engenharia de dados.
Até aqui, você viu os comandos básicos do cron e padrões para capturar logs e erros. É um ótimo começo, mas para produção vale explorar comandos mais avançados e integrações com containers.
Nesta seção, você verá como elevar o nível da implementação de cron jobs para workflows mais sofisticados de engenharia de dados.
Você pode encadear vários comandos em um único cron job para criar workflows complexos sem precisar de scripts separados.
Há diversas formas de combinar comandos.
Você pode usar ponto e vírgula para rodar comandos em sequência independentemente de sucesso dos anteriores:
* * * * * cd /path/to/data && python3 extract.py; python3 transform.py; python3 load.pyOu usar && para rodar o próximo comando apenas se o anterior tiver sucesso (para na primeira falha):
* * * * * cd /path/to/data && python3 extract.py && python3 transform.py && python3 load.py >> /path/to/logs/etl.log 2>&1Alternativamente, opte por || para rodar um comando apenas se o anterior falhar (tratamento de erros):
* * * * * python3 /path/to/critical_job.py || python3 /path/to/send_alert.py "Critical job failed"Para um encadeamento de comandos mais complexo, use parênteses para agrupar:
* * * * * (cd /path/to/data && python3 extract.py && echo "Extraction complete") && (python3 transform.py && echo "Transform complete") >> /path/to/logs/etl.log 2>&1Essa abordagem funciona bem para workflows de poucas etapas. Para pipelines muito complexas, com várias etapas, lógica condicional e tratamento de erros, ainda é melhor usar um shell script dedicado.
Containers Docker se tornaram essenciais nas stacks modernas de engenharia de dados. Você pode integrar o cron ao Docker de formas poderosas para garantir que as tarefas agendadas rodem em ambientes consistentes e isolados.
Para demonstrar, vou ajustar levemente o script fetch_api_data.py para ter diretórios dedicados para dados e logs e alterar os caminhos para funcionar em um container:
# fetch_api_data.py

import requests
import pandas as pd
import os
import uuid
from datetime import datetime

# Set file paths
data_dir = "/app/data"
log_dir = "/app/logs"
output_file = f"{data_dir}/objects_{str(uuid.uuid4())}.csv"

# Make sure the data directory exists
os.makedirs(data_dir, exist_ok=True)
os.makedirs(log_dir, exist_ok=True)


def log_message(message):
    print(f"{datetime.now().isoformat()}: {message}")


# Fetch data from the API
try:
    log_message("Starting API data fetch")
    response = requests.get("https://jsonplaceholder.typicode.com/posts")
    if response.status_code == 200:
        data = response.json()

        # Check if we have data
        if data:
            df = pd.DataFrame(
                [
                    {
                        "id": row.get("id", ""),
                        "user_id": row.get("userId", ""),
                        "title": row.get("title", ""),
                        "body": row.get("body", ""),
                    }
                    for row in data
                ]
            )

            df.to_csv(output_file, index=False)

            log_message(f"Data successfully saved to {output_file}")
        else:
            log_message("API returned empty data")
    else:
        log_message(f"API request failed with status code: {response.status_code}")
except Exception as e:
    log_message(f"Error occurred: {str(e)}")
Assim, tanto os dados buscados quanto os logs serão salvos na pasta /app/runs.
O próximo passo é criar um Dockerfile — um arquivo único que instrui o Docker como construir e rodar o container:
FROM python:3.12-slim

# Install cron and required packages
RUN apt-get update && apt-get -y install cron \
    && pip install requests pandas \
    && rm -rf /var/lib/apt/lists/*

# Set up directories
WORKDIR /app
RUN mkdir -p /app/runs/data /app/runs/logs

# Copy our script
COPY fetch_api_data.py /app/

# Make the script executable
RUN chmod +x /app/fetch_api_data.py

# Create the crontab file
RUN echo "* * * * * root /usr/local/bin/python /app/fetch_api_data.py >> /app/runs/logs/api_fetch.log 2>&1" | tee /etc/cron.d/api-cron
RUN chmod 0644 /etc/cron.d/api-cron

# Create a startup script
RUN echo '#!/bin/sh' > /app/start.sh && \
    echo 'mkdir -p /app/runs/logs' >> /app/start.sh && \
    echo 'touch /app/runs/logs/api_fetch.log' >> /app/start.sh && \
    echo 'tail -f /app/runs/logs/api_fetch.log &' >> /app/start.sh && \
    echo 'cron -f' >> /app/start.sh
RUN chmod +x /app/start.sh

# Set entry point
CMD ["/app/start.sh"]
Quase lá. Agora rode o comando abaixo para criar a imagem e executar o container Docker
docker build --no-cache -t api-cron-job . && \
docker run --rm --name api-fetcher api-cron-job
Se você se conectar ao container, verá que o script em Python está sendo executado a cada minuto:
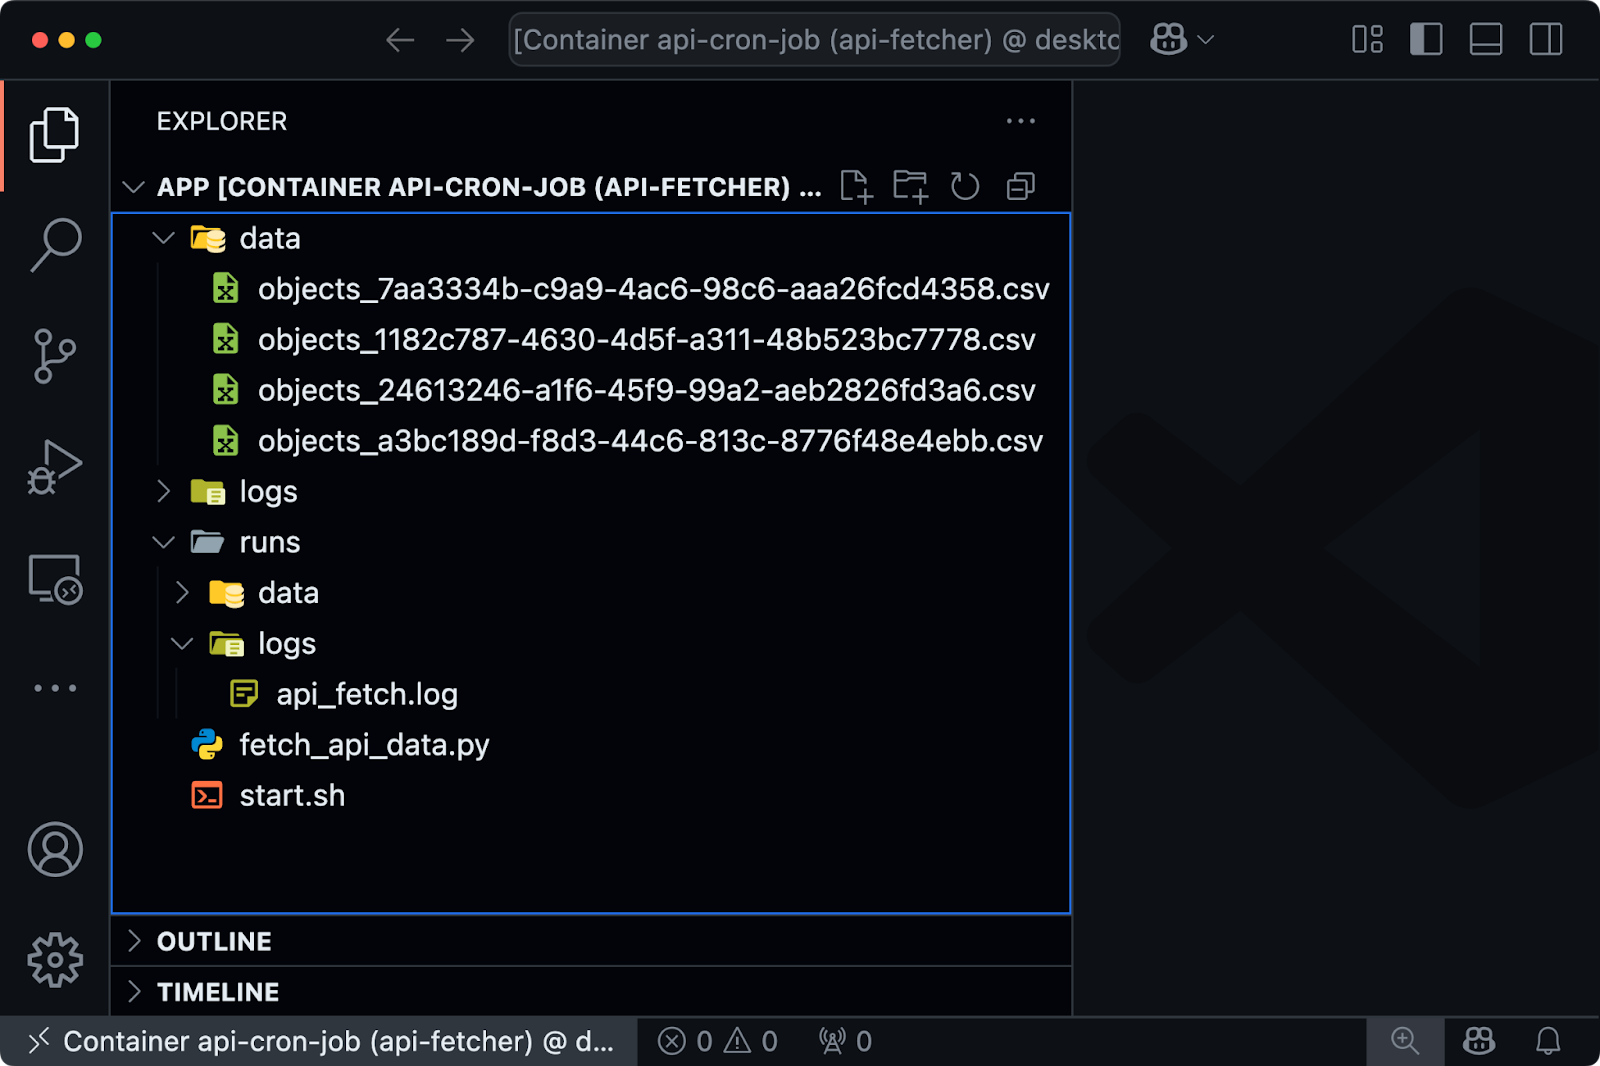
Imagem 11 - Cron job rodando em container Docker
Por outro lado, se você quer rodar uma pipeline de engenharia de dados em um container Docker seguindo um agendamento do cron, mantenha o fetch_api_data.py inalterado, mas modifique o Dockerfile:
# Use Python 3.12 slim as base image
FROM python:3.12-slim

# Install required Python packages
RUN pip install --no-cache-dir requests pandas

# Set working directory
WORKDIR /app

# Copy the script into the container
COPY fetch_api_data.py /app/

# Set execution permissions
RUN chmod +x /app/fetch_api_data.py

# Run the script
CMD ["/usr/local/bin/python", "/app/fetch_api_data.py"]
Depois, adicione isto ao crontab do seu sistema:
*/2 * * * * cd /path/to/root/project/folder && docker build --no-cache -t api-cron-job . && docker run --rm --name api-fetcher api-cron-jobIsso vai disparar a build e rodar o container a cada 2 minutos.
Em workflows distribuídos de engenharia de dados, muitas vezes você precisa executar processos em servidores remotos. Cron jobs podem acionar essas operações via SSH.
Por exemplo, você pode rodar um comando como este para executar um cron job em um servidor remoto:
0 5 * * * ssh username@remote-server 'python3 /path/to/remote_job.py' >> /path/to/logs/remote_job.log 2>&1Para isso funcionar sem pedir senha, você precisa configurar autenticação por chave SSH entre os servidores.
Para transferir dados entre servidores em um agendamento, use o cron job a seguir:
0 6 * * * scp /path/to/local/data.csv username@remote-server:/path/to/destination/ >> /path/to/logs/data_transfer.log 2>&1Para operações remotas mais complexas, combine SSH com shell scripts:
#!/bin/bash
# remote_etl.sh

# Run extraction on the data source server
ssh username@source-server 'python3 /path/to/extract.py'

# Transfer the extracted data to the processing server
scp username@source-server:/path/to/extracted_data.csv /local/temp/

# Run transformation locally
python3 /path/to/transform.py

# Transfer the transformed data to the warehouse server
scp /local/temp/transformed_data.csv username@warehouse-server:/path/to/data/

# Trigger the load process on the warehouse server
ssh username@warehouse-server 'python3 /path/to/load.py'
Em seguida, agende-o no cron:
0 7 * * * /path/to/remote_etl.sh >> /path/to/logs/remote_etl.log 2>&1Essa abordagem permite orquestrar pipelines de dados multi-servidor diretamente pelos cron jobs. Funciona, mas para workflows distribuídos muito complexos vale considerar ferramentas de orquestração como Apache Airflow ou Prefect para fluxos altamente complexos.
Mesmo cron jobs bem projetados podem falhar ou causar problemas se não forem implementados com boas práticas operacionais.
Como engenheiro de dados, você precisa garantir que as tarefas agendadas rodem com confiabilidade, falhem de forma controlada e ofereçam visibilidade suficiente para troubleshooting. É isso que veremos agora.
Logging é crucial em processos automáticos que rodam sem supervisão direta. Sem logs, diagnosticar problemas em cron jobs se torna praticamente impossível.
Para configurar logs básicos, redirecione a saída padrão e os erros para arquivos de log:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/script.log 2>&1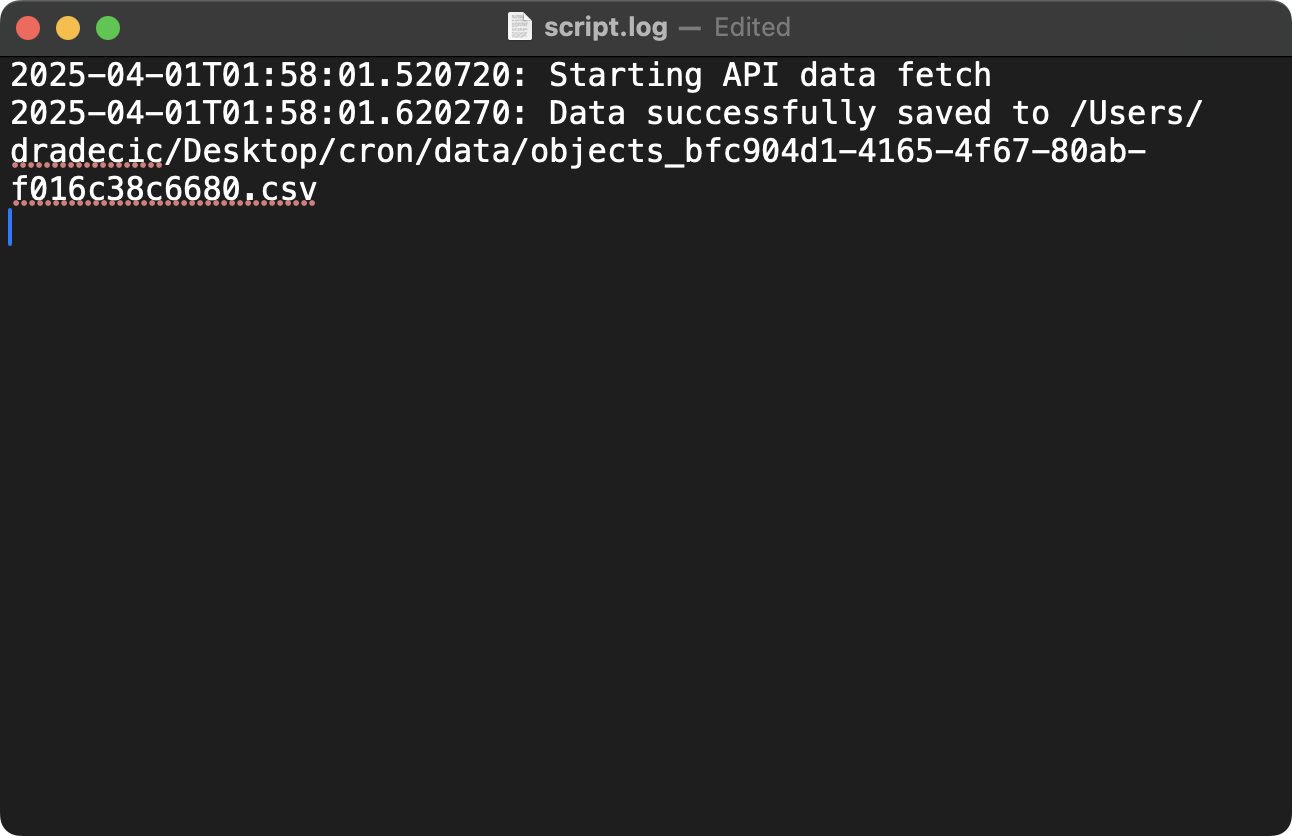
Imagem 12 - Configuração de logs de cron job (1)
Esse comando roda seu script a cada minuto e acrescenta toda a saída em um arquivo de log. O operador >> acrescenta em vez de sobrescrever, enquanto 2>&1 redireciona erros (descritor 2) e saída padrão (descritor 1) para o mesmo arquivo.
Para logs mais estruturados, adicione timestamps e identificadores do job:
* * * * * (echo "=== Job started at $(date) ==="; /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py; echo "=== Job finished at $(date) with exit code $? ===") >> /Users/dradecic/Desktop/cron/logs/script.log 2>&1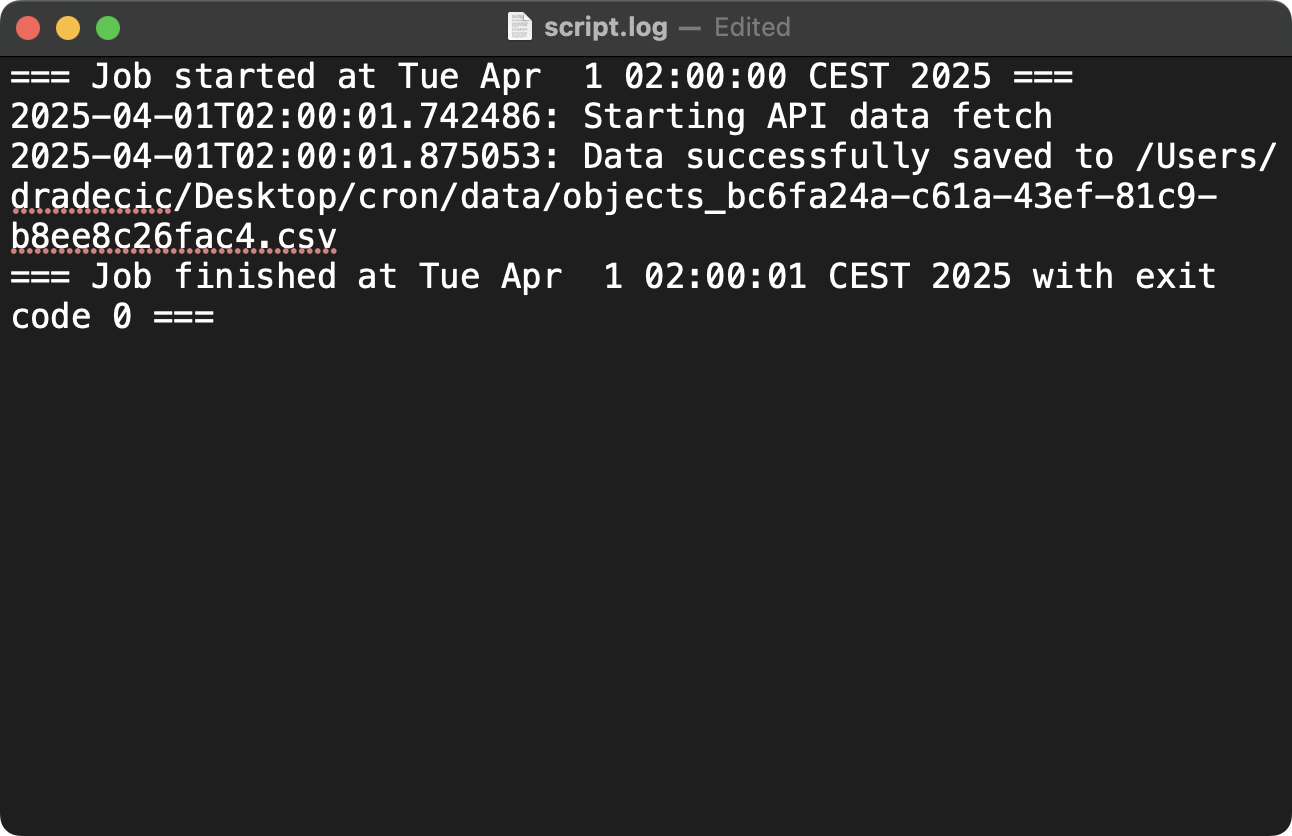
Imagem 13 - Configuração de logs de cron job (2)
Esse comando aprimorado adiciona um marcador claro de início com timestamp, executa seu script e adiciona um marcador de término com timestamp e código de saída. Os parênteses agrupam tudo para redirecionar a saída ao mesmo arquivo. A variável $? contém o código de saída do último comando, útil para saber se o script teve sucesso (0) ou falhou (não zero).
Para evitar que os logs consumam muito espaço em disco, implemente rotação de logs. Use o utilitário logrotate, disponível na maioria das distros Linux:
Crie um arquivo de configuração em /etc/logrotate.d/cron-jobs:
/path/to/logs/*.log {
    daily
    missingok
    rotate 14
    compress
    delaycompress
    notifempty
    create 0640 username groupname
}
Essa configuração instrui o sistema a:
daily)missingok)rotate 14)compress)delaycompress)notifempty)create 0640 username groupname)O serviço logrotate aplica essas regras automaticamente, geralmente uma vez por dia. Quando roda, ele renomeia o log atual (adicionando sufixo de data), comprime logs mais antigos, exclui os com mais de 14 dias e cria um novo arquivo para as próximas entradas.
Workflows robustos de engenharia de dados precisam de estratégias para lidar com falhas. Você pode embutir lógica de retry nos scripts ou cron jobs, ou integrar seus jobs a sistemas de monitoramento.
A seguir, mostro como implementar essas opções.
Lógica de retry embutida pode ser implementada diretamente em seus scripts Python, como neste exemplo:
import time
import random

def fetch_data_with_retry(max_attempts=3, backoff_factor=1.5):
    attempt = 1
    while attempt <= max_attempts:
        try:
            # Try to fetch data
            return fetch_data()
        except Exception as e:
            print(f"Attempt {attempt} failed: {str(e)}")
            # Calculate backoff time with jitter
            backoff_time = backoff_factor ** (attempt - 1) * (random.uniform(0.8, 1.2))
            if attempt < max_attempts:
                print(f"Retrying in {backoff_time:.2f} seconds...")
                time.sleep(backoff_time)
            else:
                print("Max retry attempts reached. Giving up.")
                raise
        attempt += 1
Essa função implementa backoff exponencial com jitter. Em resumo:
max_attempts vezes (padrão 3).Esse padrão é ideal para falhas transitórias como problemas de rede ou limites de taxa de APIs. O aumento exponencial dá tempo para o sistema externo se recuperar e o jitter evita o efeito manada.
Retentativas via cron também são viáveis. Você pode tentar novamente jobs que falharam agendando-os com mais frequência do que o necessário.
Aqui vai um exemplo com dois cron jobs:
success_flag que impede a reexecução nos próximos 10 minutos.*/10 * * * * [ ! -f /path/to/success_flag ] && python /path/to/script.py && touch /path/to/success_flag
0 0 * * * rm -f /path/to/success_flag Pode parecer confuso, então recapitulando:
[ ! -f /path/to/success_flag ])/path/to/script.py)touch /path/to/success_flag)0 0 * * *) e remove o arquivo de sucesso, permitindo que o processo volte a rodar no dia seguinte.Essa técnica é útil para tarefas que precisam ser concluídas uma vez por dia, mas podem falhar temporariamente. O job tenta ao longo do dia até ter sucesso uma vez.
Integração com monitoramento permite conectar seus cron jobs a sistemas como Prometheus. É um tema à parte, então segue um panorama geral.
O script abaixo é um wrapper do seu job real que coleta e reporta métricas ao Prometheus. Ele faz o seguinte:
#!/bin/bash
# monitored_job.sh

# Define pushgateway URL
PUSHGATEWAY="http://prometheus-pushgateway:9091"

# Start time in seconds
START_TIME=$(date +%s)

# Run the actual job
/path/to/actual_job.sh
EXIT_CODE=$?

# End time in seconds
END_TIME=$(date +%s)
DURATION=$((END_TIME - START_TIME))

# Push metrics to Prometheus
cat <<EOF | curl --data-binary @- ${PUSHGATEWAY}/metrics/job/cron_job/instance/$(hostname)
# HELP cron_job_duration_seconds How long the cron job took to execute
# TYPE cron_job_duration_seconds gauge
cron_job_duration_seconds{name="data_extraction"} ${DURATION}

# HELP cron_job_exit_code Exit code of the cron job
# TYPE cron_job_exit_code gauge
cron_job_exit_code{name="data_extraction"} ${EXIT_CODE}

# HELP cron_job_last_run_timestamp Timestamp of last job run
# TYPE cron_job_last_run_timestamp gauge
cron_job_last_run_timestamp{name="data_extraction"} ${END_TIME}
EOF

exit ${EXIT_CODE}
Essas métricas permitem:
O Pushgateway atua como intermediário, permitindo que o cron job (de curta duração) envie métricas ao Prometheus, que então as armazena para alertas e visualização.
Fusos horários são um desafio comum em engenharia de dados, especialmente com fontes globais ou sistemas distribuídos.
Como era de se esperar, cron jobs são sensíveis às configurações de fuso horário.
Por padrão, o cron usa o fuso horário local do sistema. Você pode checar isso com o comando no Linux:
timedatectlO comando acima exibe a hora atual do sistema e a configuração de fuso. Se seu servidor estiver em um fuso local, como America/New_York, todos os agendamentos do cron serão interpretados nesse fuso.
Para garantir consistência, independentemente da localização do servidor ou do horário de verão, use UTC nos seus cron jobs:
# Set the CRON_TZ environment variable at the top of your crontab
CRON_TZ=UTC

# Now all job schedules will use UTC
0 0 * * * /path/to/daily_job.sh
Ao adicionar CRON_TZ=UTC no topo do seu crontab, você instrui o cron a interpretar todos os horários em UTC, não no fuso local.
Isso significa que o job vai rodar à meia-noite UTC todos os dias, independentemente do fuso do servidor ou de mudanças de horário de verão. O UTC não muda, servindo como referência consistente em qualquer lugar.
Se você é engenheiro de dados, cron jobs são ferramentas valiosíssimas.
Eles ajudam a automatizar tarefas repetitivas e a construir pipelines confiáveis. Oferecem uma forma consistente e poderosa de agendar scripts e orquestrar processos de ETL em múltiplas etapas. A sintaxe exige um pouco de prática, mas em poucos dias vira rotina.
Ao implementar cron jobs no seu trabalho, lembre-se de seguir as boas práticas de logging, tratamento de erros e gestão de fuso horário. Logs bem feitos dão visibilidade e facilitam o diagnóstico. Técnicas de tratamento de erro com retentativas garantem a recuperação de falhas temporárias. E o cuidado com fuso horário mantém seus agendamentos consistentes, especialmente com fontes globais ou times distribuídos.
>Quer ser contratado como Data Engineer em 2025? Estas são 5 habilidades essenciais que você precisa ter.
Ferramentas especializadas de orquestração de workflows como Apache Airflow ou Prefect oferecem recursos avançados para pipelines complexas, mas o cron continua muito relevante para diversas tarefas de engenharia de dados. É simples, confiável e leve — combinação perfeita para automação.
Para aprofundar em engenharia de dados, confira estes cursos da DataCamp:
Nossos programas de certificação ajudam você a se destacar e a provar que suas habilidades estão prontas para o trabalho para possíveis empregadores.

Aprenda mais sobre engenharia de dados com estes cursos!
Curso
Curso
Curso
blog
Joleen Bothma
11 min
blog
Javier Canales Luna
15 min
blog
Joleen Bothma
9 min
blog
Artur Sannikov
12 min
Tutorial
Karlijn Willems
15 min
Tutorial
Kurtis Pykes
5 min