Curso
Introducción a Apache Airflow en Python
4 h
64.6K
Si a menudo te ves gestionando a mano tareas recurrentes, sabrás que no solo es tedioso: es la receta perfecta para incumplir plazos y tener canalizaciones de datos inconsistentes.
Los cron jobs son la solución de referencia para automatizar tareas repetitivas en sistemas basados en Unix. Te permiten programar comandos o scripts para que se ejecuten a intervalos concretos. Aprovechando el sistema de programación simple y flexible de cron, puedes automatizar desde la recogida básica de datos hasta flujos ETL complejos que, de otro modo, requerirían intervención manual constante. Configurar estos procesos automatizados elimina el error humano y garantiza que tus canalizaciones de datos se ejecuten de forma consistente y fiable.
Dominar los cron jobs es esencial para cualquier profesional de ingeniería de datos que trabaje en entornos Unix. La mera capacidad de programar y gestionar tareas automatizadas mejorará tu flujo de trabajo de forma notable y reducirá la carga de mantenimiento.
En esta guía completa, te llevaré paso a paso por todo lo que necesitas saber sobre cron jobs para ingeniería de datos: desde la configuración básica hasta casos de uso avanzados y buenas prácticas.
>¿Acabas de aterrizar en Data Engineering? Nuestro curso despeja la jerga y explica los conceptos clave.
Un cron job es un planificador basado en tiempo en sistemas operativos Unix que te permite ejecutar comandos automáticamente a horas, fechas o intervalos fijos.
Piensa en cron como tu asistente personal que ejecuta tareas exactamente cuando tú quieres sin intervención manual. Para quienes se dedican a datos, esto significa que puedes automatizar copias de seguridad de bases de datos, transferencias de datos, generación de informes y mucho más.
Los cron jobs viven en un archivo de texto sencillo llamado "crontab" (cron table). Cada línea de este archivo representa una tarea programada y sigue un formato específico con seis componentes:
* * * * * command-to-execute
│ │ │ │ │
│ │ │ │ └─── Day of week (0-6, where 0 is Sunday)
│ │ │ └───── Month (1-12)
│ │ └─────── Day of month (1-31)
│ └───────── Hour (0-23)
└─────────── Minute (0-59)
Los cinco primeros campos le indican a cron cuándo ejecutar tu comando. Puedes usar valores específicos, rangos (como 1-5), listas (como 1, 3, 5) o asteriscos (*) que significan "cada" unidad de tiempo. El sexto componente es el comando que quieres ejecutar.
Por ejemplo, si quieres ejecutar un script de Python para extraer datos de una API todos los días a medianoche, tu cron job se vería así:
0 0 * * * /usr/bin/python3 /home/username/scripts/extract_data.pyEsto le dice a cron que ejecute tu script en el minuto 0, hora 0 (medianoche), todos los días del mes, todos los meses y todos los días de la semana. La ruta absoluta tanto del intérprete de Python como de tu script garantiza que el job se ejecute correctamente independientemente del entorno.
También puedes crear programaciones más complejas. Digamos que quieres ejecutar una limpieza de base de datos los lunes, miércoles y viernes a las 15:30; tu expresión cron sería:
30 15 * * 1,3,5 /path/to/cleanup_script.shCada asterisco actúa como comodín y te permite crear horarios flexibles que se ajustan a tus necesidades. Incluso puedes usar atajos como @daily, @weekly o @monthly para que los patrones habituales sean más legibles.
Hasta aquí lo básico. A continuación, verás de forma práctica cómo trabajar con cron jobs para tareas de ingeniería de datos.
Ahora que ya sabes qué son los cron jobs, vamos a configurar tu primera tarea automatizada. El proceso es directo y solo requiere un par de comandos para empezar.
Para crear o modificar cron jobs, necesitas acceder a tu archivo crontab. Puedes hacerlo con el comando crontab -e:
crontab -e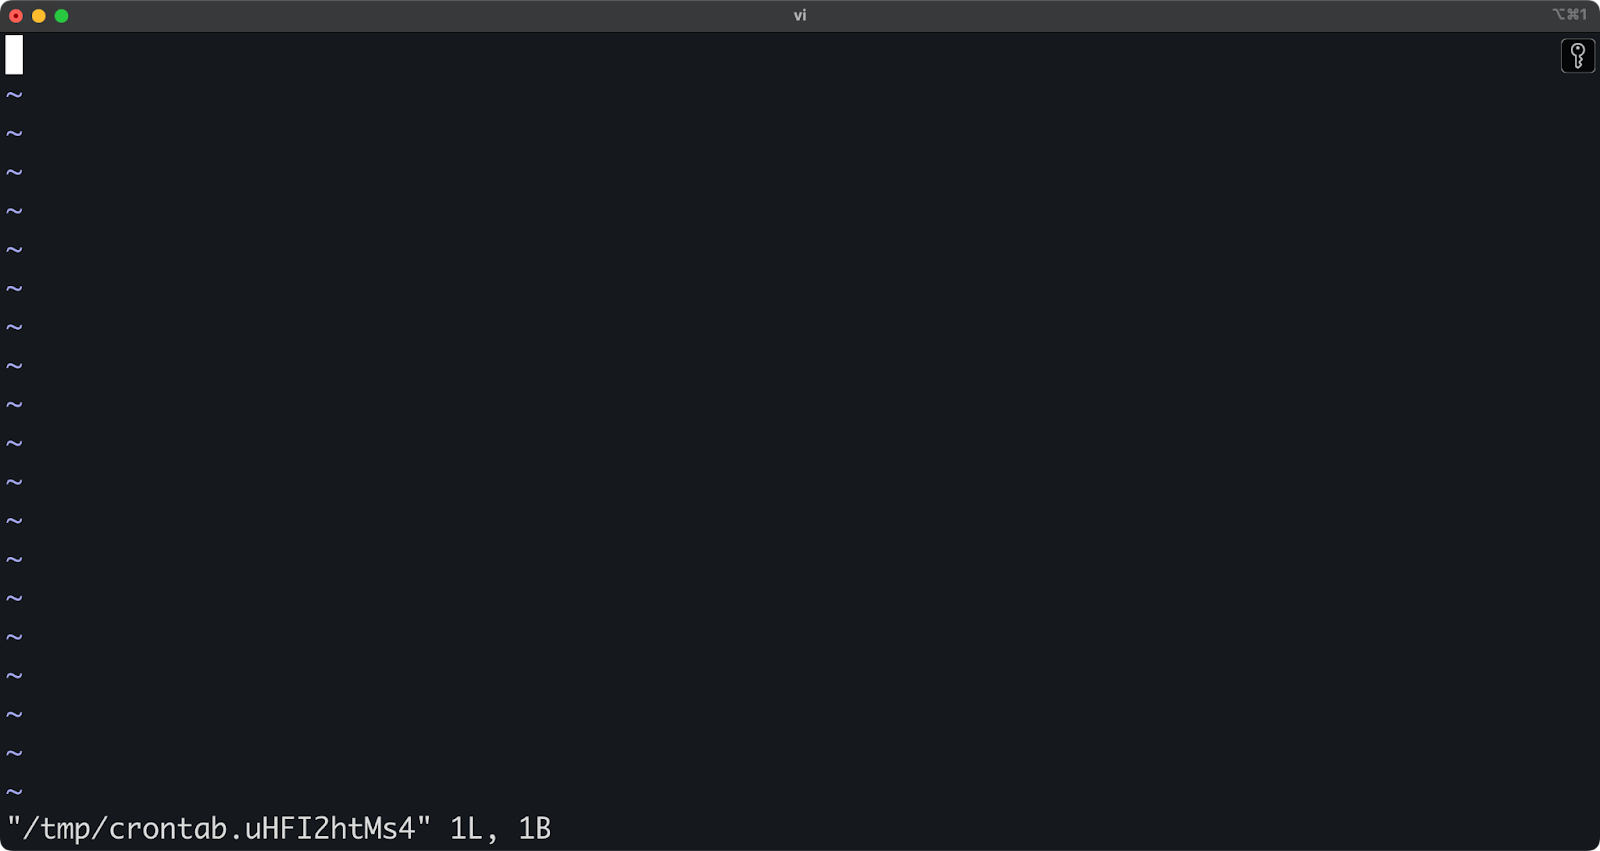
Imagen 1 - Editar un archivo crontab
El comando anterior abre el editor de texto vi, en el que puedes añadir, editar o eliminar tareas programadas.
Tu archivo crontab puede estar vacío si nunca lo has usado. Para añadir un nuevo cron job, basta con añadir una línea siguiendo la sintaxis de cron que te expliqué antes. Cada línea debe incluir tanto la programación como el comando a ejecutar.
Por ejemplo, para ejecutar un script todos los días a las 3 a. m., añade esta línea:
0 3 * * * /path/to/your/commandGuarda el archivo y sal del editor. Cron instalará automáticamente tu nuevo crontab y empezará a ejecutar tus jobs en los horarios indicados.
Empecemos con un ejemplo práctico: programar un script en Python para obtener datos de una API cada minuto. Aquí tienes un script completo en Python que se conecta al endpoint de una API REST, obtiene objetos y los guarda en un archivo CSV; asegúrate de que tu intérprete de Python tiene instalados los paquetes requests y pandas:
# fetch_api_data.py

import requests
import pandas as pd
import os
from datetime import datetime

# Create a timestamp for the filename
timestamp = datetime.now().strftime("%Y%m%d_%H%M%S")

# Set file paths - CHANGE THIS
data_dir = "/Users/dradecic/Desktop/cron/data"
output_file = f"{data_dir}/objects_{timestamp}.csv"

# Make sure the data directory exists
os.makedirs(data_dir, exist_ok=True)

# Fetch data from the API
try:
    response = requests.get("https://jsonplaceholder.typicode.com/posts")
    if response.status_code == 200:
        data = response.json()

        # Check if we have data
        if data:
            df = pd.DataFrame([
                {
                    "id": row.get("id", ""),
                    "user_id": row.get("userId", ""),
                    "title": row.get("title", ""),
                    "body": row.get("body", "")
                } for row in data
            ])

            df.to_csv(output_file, index=False)

            print(f"Data successfully saved to {output_file}")
        else:
            print("API returned empty data")
    else:
        print(f"API request failed with status code: {response.status_code}")
except Exception as e:
    print(f"Error occurred: {str(e)}")
Ahora, para programar este script con cron para que se ejecute todos los días a las 2 a. m.:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py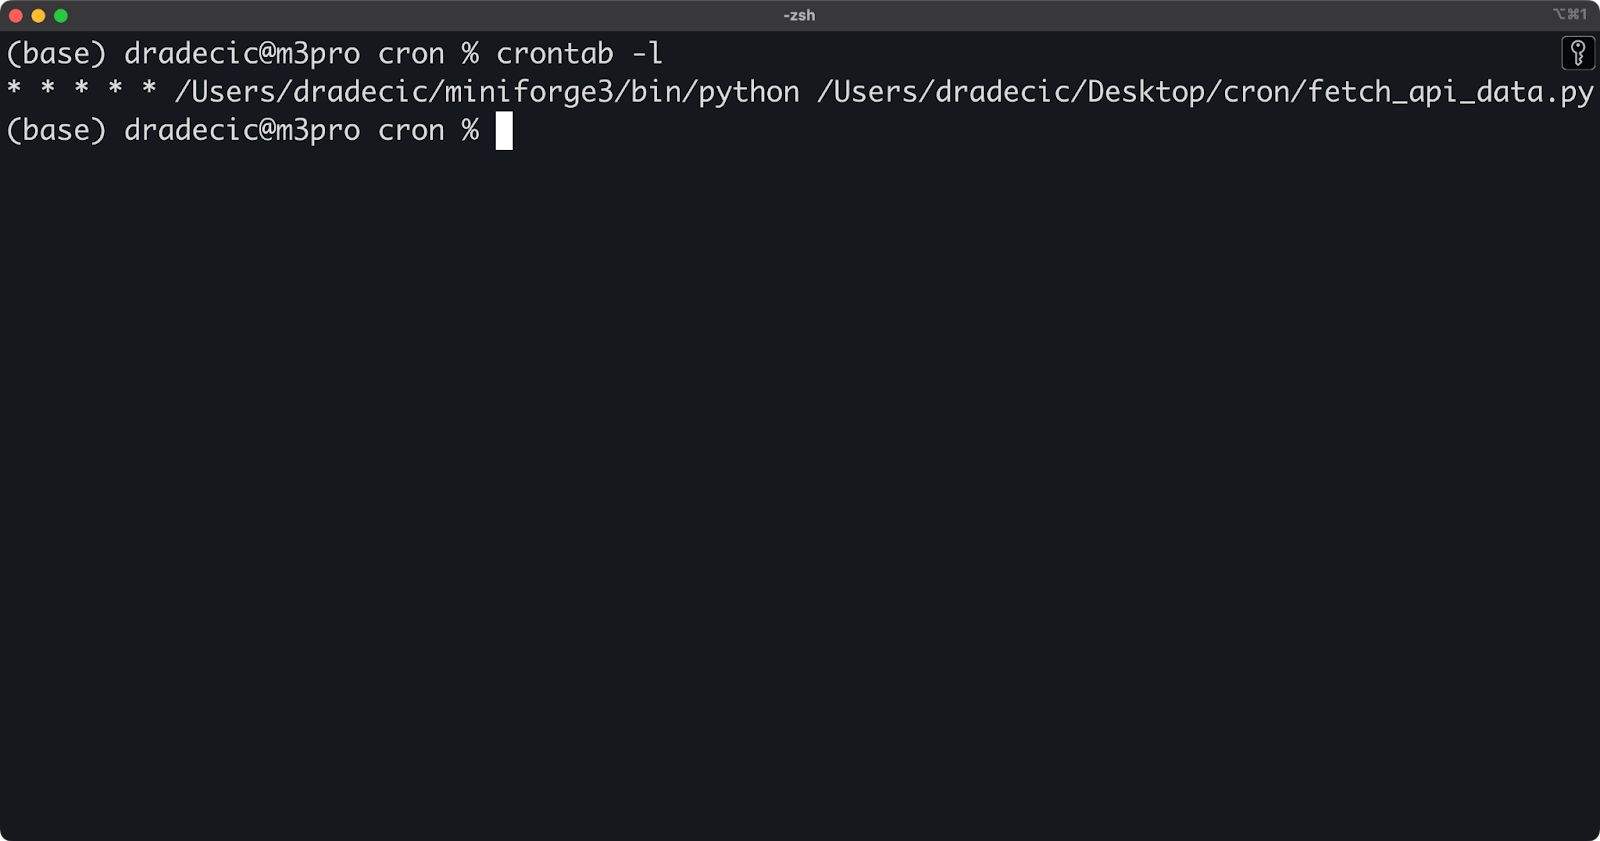
Imagen 2 - Listar crontabs activos
Esta línea le dice a cron que ejecute tu script de Python cada minuto de cada día. Asegúrate de usar rutas absolutas tanto para el intérprete de Python (/Users/dradecic/miniforge3/bin/python en mi caso) como para tu script (/Users/dradecic/Desktop/cron/fetch_api_data.py en mi caso).
¿Por qué rutas absolutas? Cron se ejecuta con un entorno limitado, así que no conoce la variable PATH de tu shell ni tu directorio actual. Tu job puede fallar sin rutas absolutas porque cron no encuentra los comandos o archivos que quieres usar.
Mientras leías esto, se han guardado un par de archivos CSV en mi carpeta data, lo que indica que este cron job funciona como se esperaba:
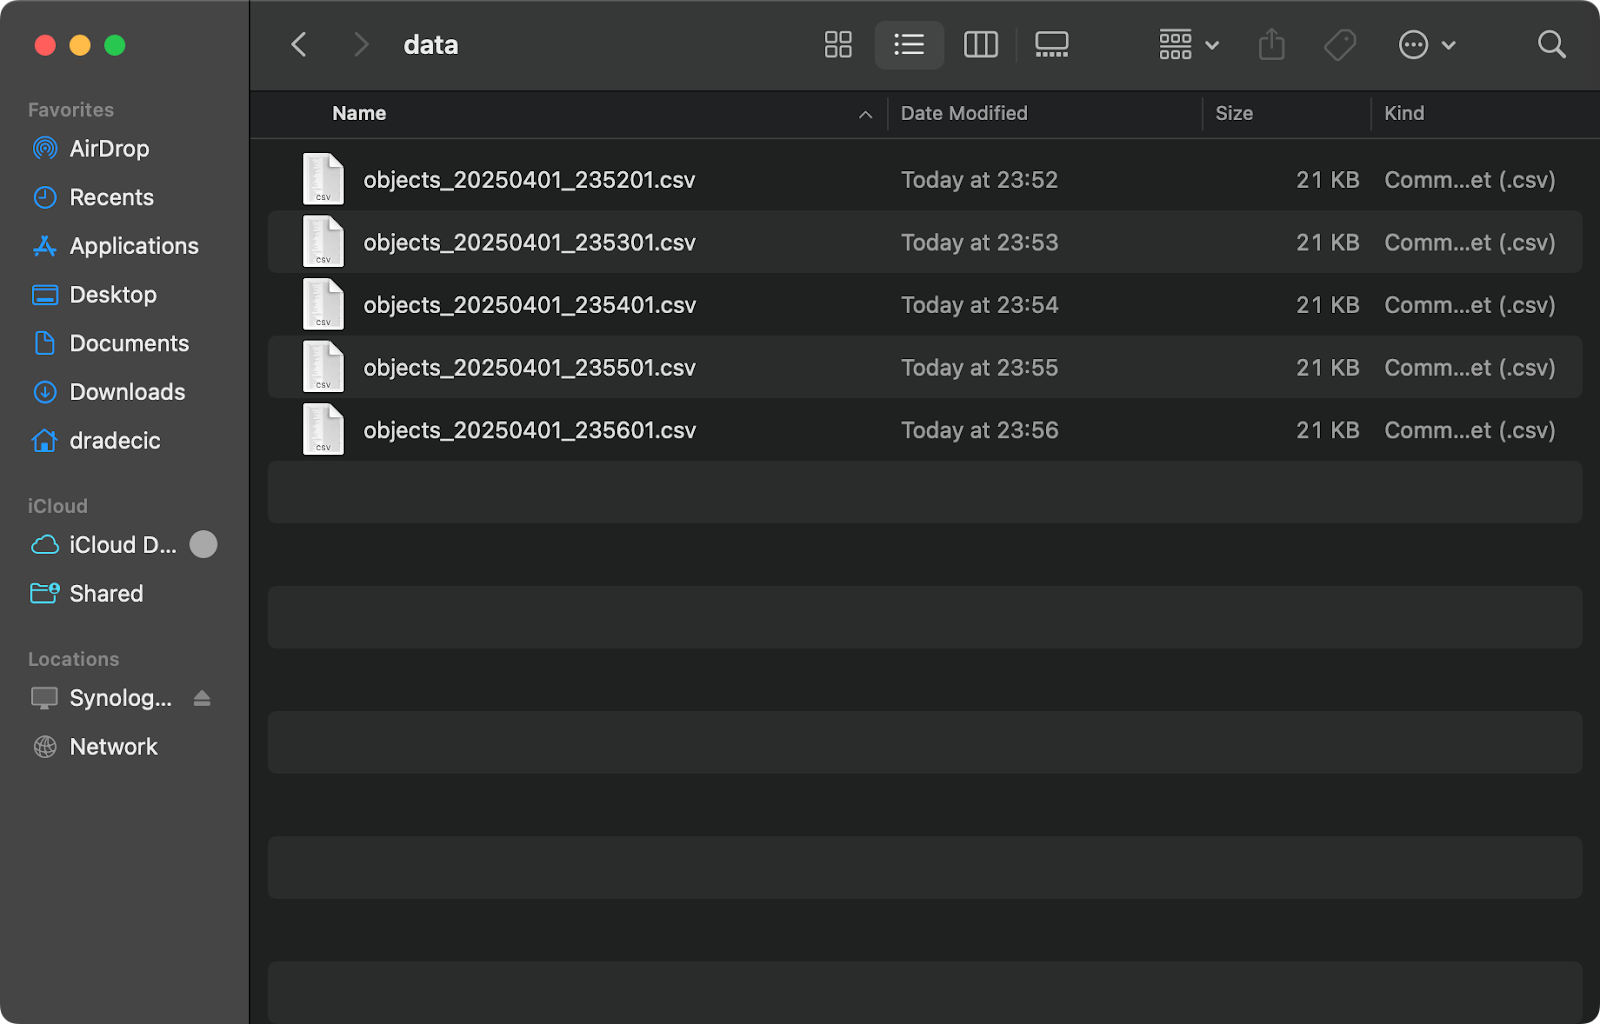
Imagen 3 - Archivos CSV guardados
Para flujos de trabajo de ingeniería de datos más complejos, como ETL (Extract, Transform, Load), puedes usar cron para programar procesos de varios pasos. Un enfoque común es crear un script de shell que contenga todos tus pasos de ETL y luego programarlo con cron.
Por simplicidad, el código que verás en el siguiente script .sh es solo teórico y no se conecta a ninguna fuente de datos:
#!/bin/bash
# etl_pipeline.sh

# Extract data from source
/usr/bin/psql -U username -d source_db -c "COPY (SELECT * FROM source_table) TO '/tmp/extracted_data.csv' WITH CSV HEADER;"

# Transform data
/usr/bin/python3 /home/username/scripts/transform_data.py

# Load data into target
/usr/bin/psql -U username -d target_db -c "\COPY target_table FROM '/tmp/transformed_data.csv' WITH CSV HEADER;"

# Log completion
echo "ETL job completed at $(date)" >> /home/username/logs/etl_job.log
Una vez hecho esto, querrás dar permisos de ejecución a tu script:
chmod +x /home/username/scripts/etl_pipeline.shPor último, prográmalo con cron para que se ejecute, por ejemplo, de lunes a viernes a la 1 a. m.:
0 1 * * 1-5 /home/username/scripts/etl_pipeline.shSi te dedicas a la ingeniería de datos, programar tareas ETL con cron ofrece estas ventajas:
Para procesos ETL más grandes, quizá te interese añadir gestión de errores a tus scripts:
#!/bin/bash
# etl_pipeline.sh

# Set error handling
set -e  # Exit immediately if any command fails

# Execute ETL steps
# ...

# If we get here, all steps succeeded
echo "ETL job completed successfully at $(date)" >> /home/username/logs/etl_job.log
¡Y listo! Tu canalización ETL se ejecutará automáticamente en los horarios programados, procesará tus datos y registrará su estado para facilitar el seguimiento.
Una vez que configures tus cron jobs, necesitas gestionarlos y monitorizarlos para asegurarte de que se ejecutan como esperas.
Con esto me refiero a comprobar qué jobs están programados, eliminar los que ya no hacen falta y monitorizar su ejecución. En esta sección verás comandos y técnicas esenciales para mantener tus cron jobs sin complicaciones.
Para ver todos tus cron jobs programados actualmente, usa el comando crontab -l:
crontab -lEl comando anterior muestra el contenido de tu crontab actual, con todos los jobs programados, sus horarios y comandos. Es una forma rápida de verificar qué jobs están activos sin entrar en modo edición.
Así es como se verá la salida si has seguido la sección anterior:
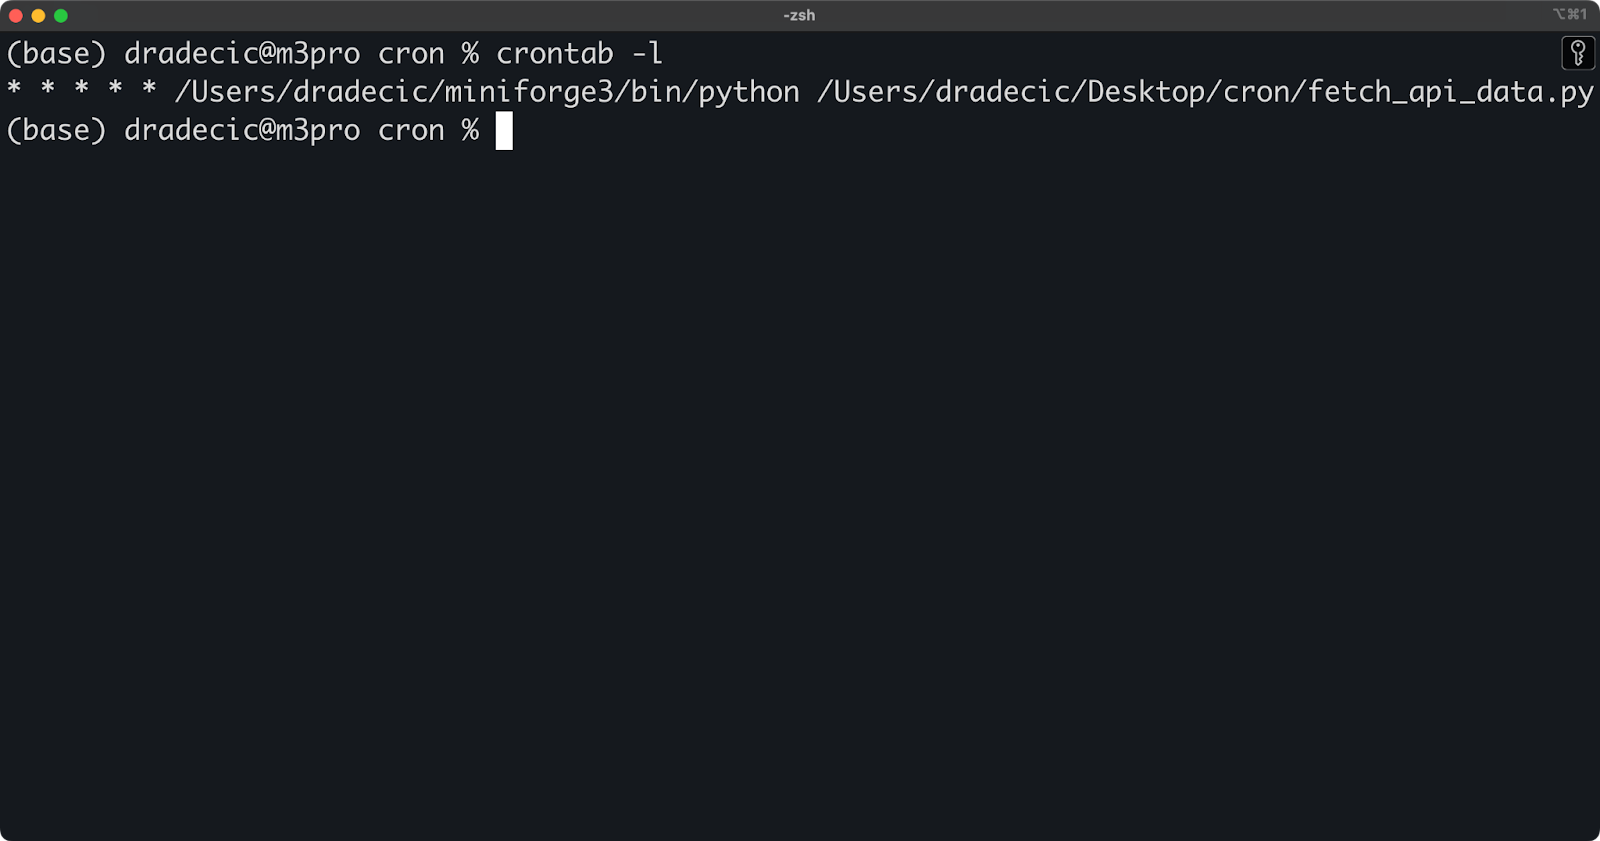
Imagen 4 - Cron jobs activos
Si necesitas comprobar los cron jobs de otro usuario (requiere acceso root), ejecuta este comando:
sudo crontab -u username -lHay varias formas de eliminar o desactivar cron jobs cuando ya no se necesitan. Para eliminar un job concreto, abre tu crontab en modo edición y borra la línea correspondiente:
crontab -ePara desactivar temporalmente un job sin borrarlo, comenta la línea añadiendo un # al inicio:
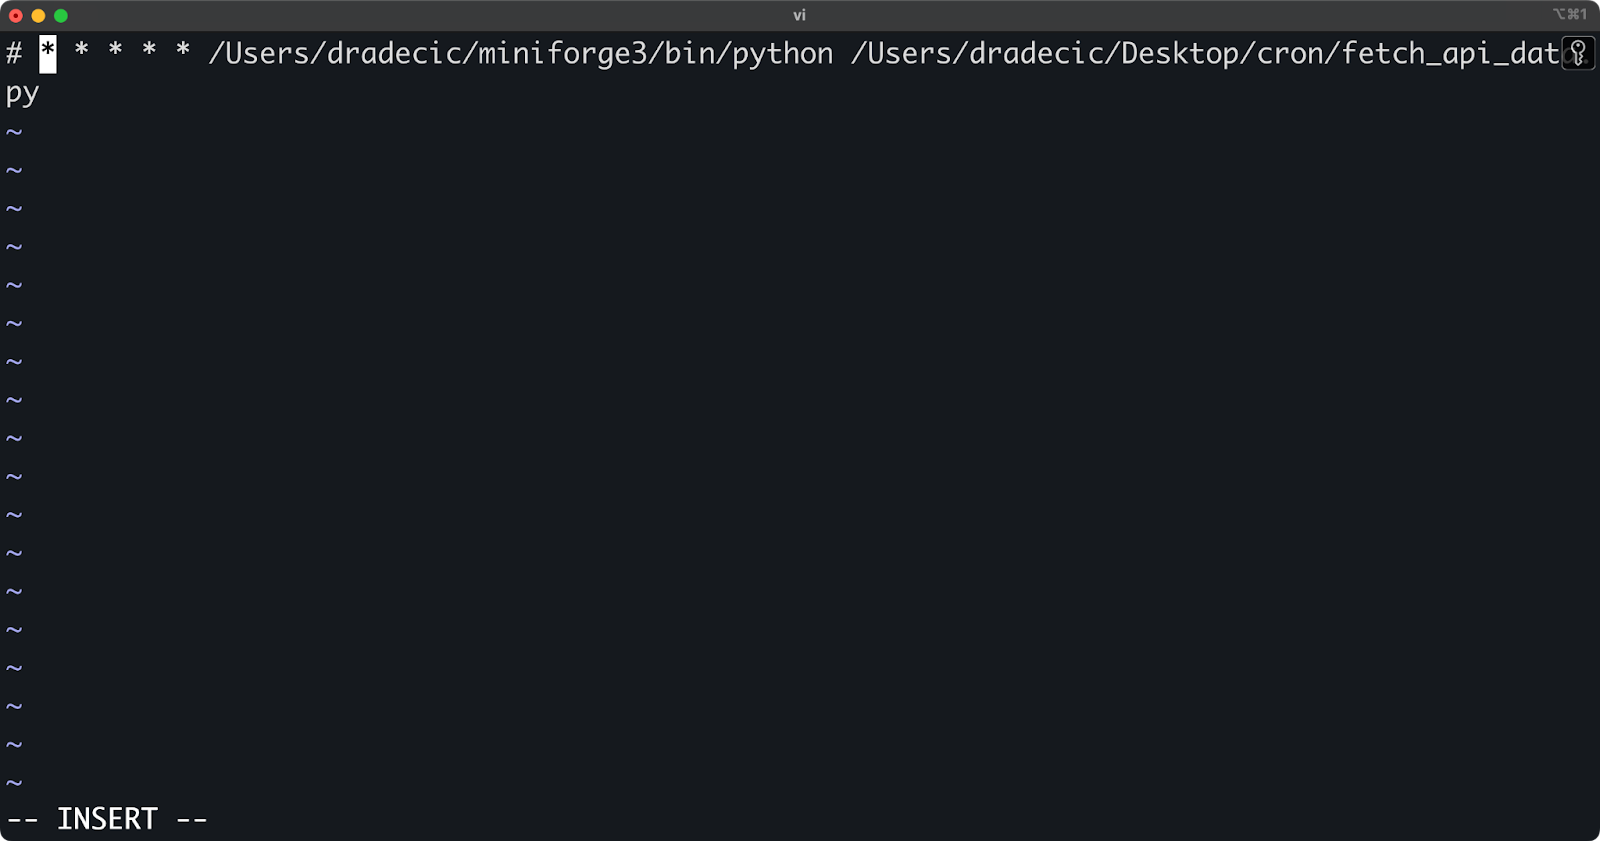
Imagen 5 - Desactivar temporalmente un cron job
El job comentado permanece en tu crontab como referencia, pero no se ejecutará según la programación definida.
Si quieres eliminar todo tu crontab (todos los jobs), usa la opción -r:
crontab -r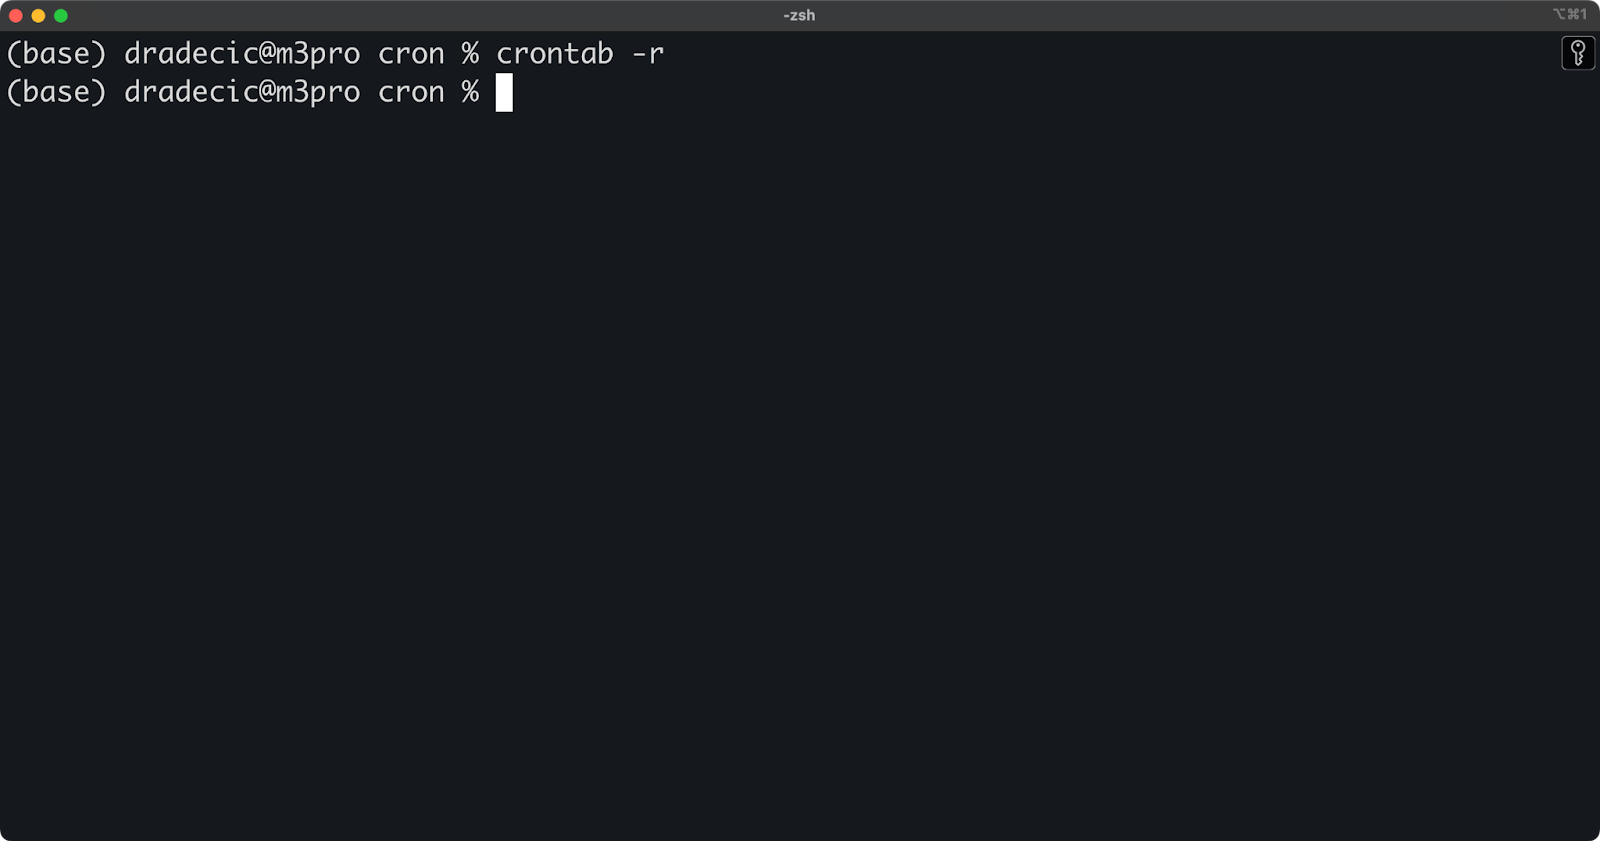
Imagen 6 - Eliminar el crontab completo
Ten cuidado con este comando: elimina todos tus jobs programados sin pedir confirmación. Para evitar borrados accidentales, puedes hacer una copia de seguridad de tu crontab antes:
crontab -l > my_crontab_backupEsto guarda tu crontab actual en un archivo que podrás usar para restaurar tus jobs si hace falta:
crontab my_crontab_backup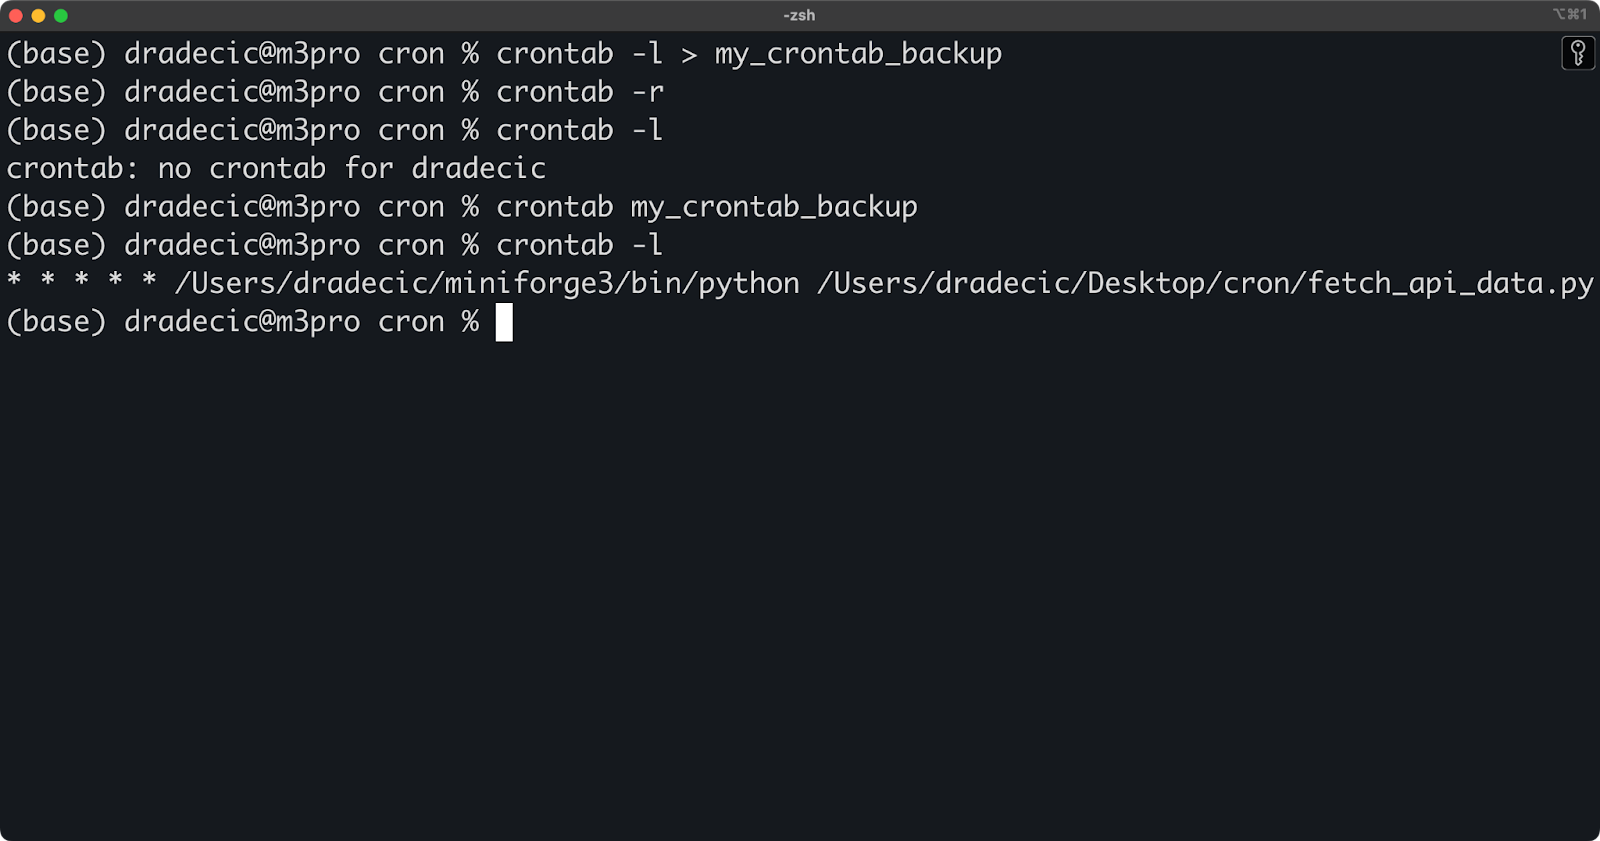
Imagen 7 - Restaurar un crontab desde una copia de seguridad
Por defecto, cron intenta enviar por email la salida de los jobs al usuario propietario del crontab. Sin embargo, esto requiere un sistema de correo correctamente configurado, lo que no siempre está disponible. En su lugar, puedes redirigir la salida a archivos de log para facilitar el seguimiento y la resolución de problemas.
Para capturar tanto la salida estándar como los mensajes de error, usa esta sintaxis de redirección:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1Esta redirección puede imponer al principio, así que te la explico:
>> añade la salida al archivo indicado.2>&1 redirige stderr (errores) al mismo lugar que stdout (salida estándar).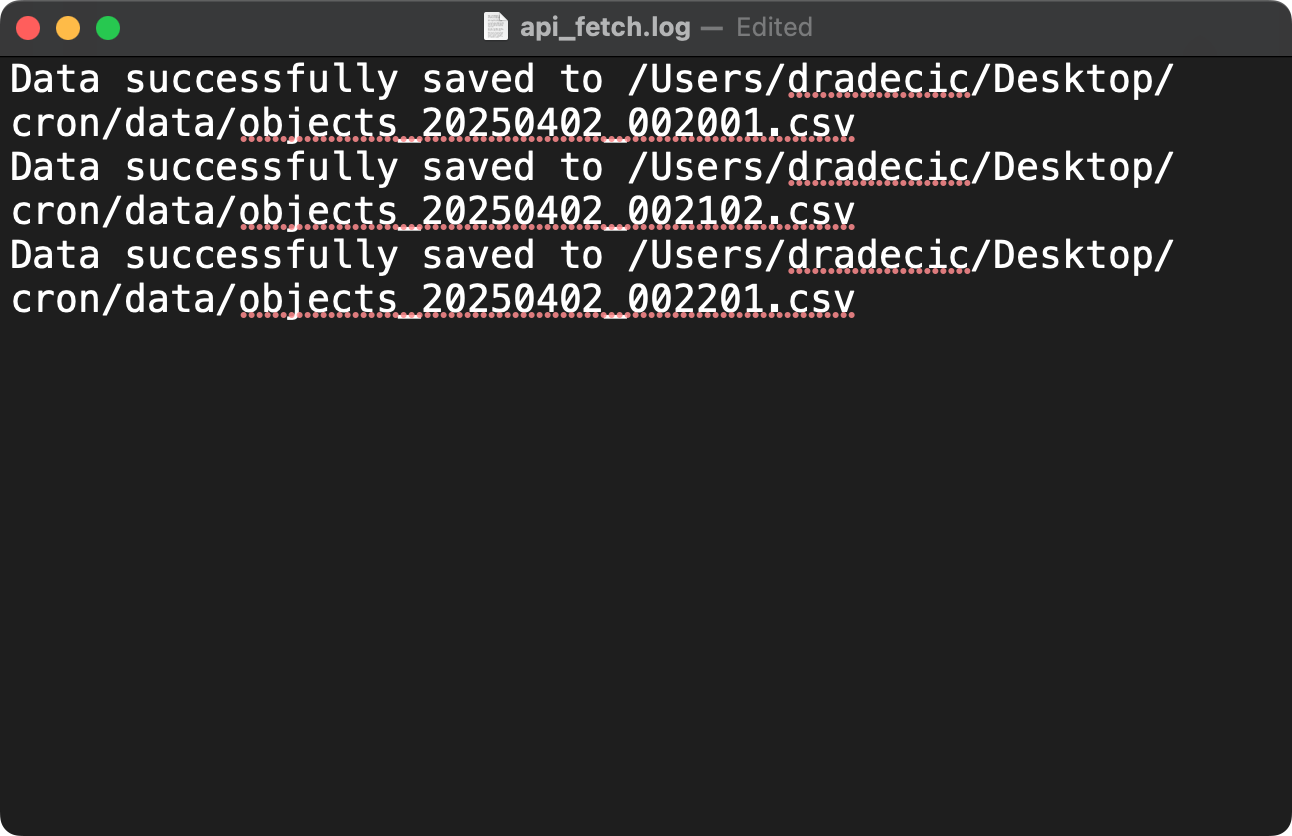
Imagen 8 - Capturar logs de cron jobs
Para una mejor gestión de logs, puedes añadir marcas de tiempo a tus entradas:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1 && echo "Job completed at $(date)" >> /Users/dradecic/Desktop/cron/logs/api_fetch.log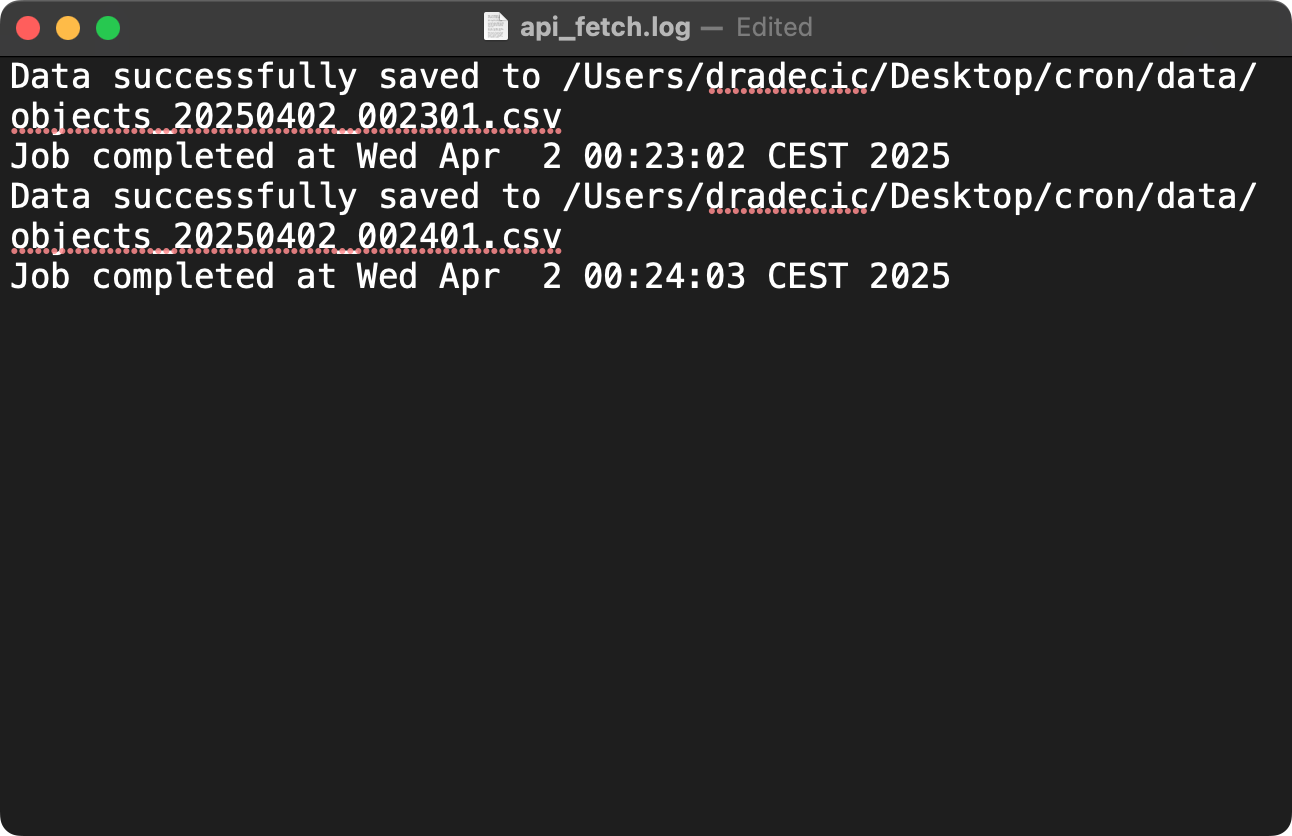
Imagen 9 - Capturar logs de cron con marcas de tiempo
Si quieres archivos de log separados para salida normal y errores, usa:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>> /Users/dradecic/Desktop/cron/logs/api_fetch_errors.log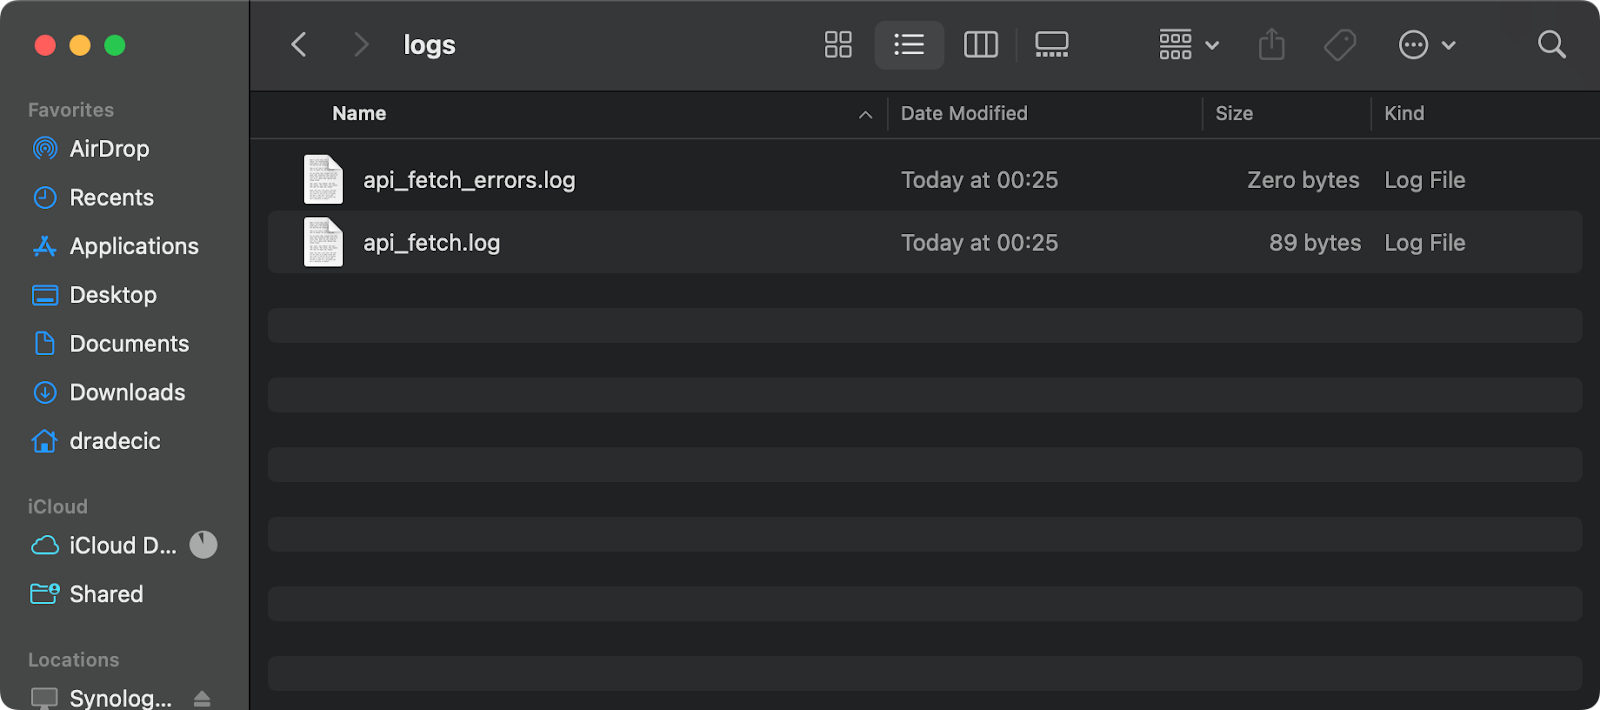
Imagen 10 - Archivos de log y de error de un cron job
Para jobs críticos que requieren avisos en caso de fallo, puedes configurar alertas por email. Suponiendo que tu sistema tiene un agente de correo instalado (como postfix o sendmail), puedes modificar tu cron job para enviar un correo solo si el job falla:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1 || echo "API fetch failed on $(date)" | mail -s "Cron Job Failed" your-email@example.comEsto utiliza el operador ||, que significa "ejecuta el comando mail solo si el comando anterior falla".
Para notificaciones por email de "éxito", usa:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1 && echo "API fetch completed successfully on $(date)" | mail -s "Cron Job Succeeded" your-email@example.comTambién puedes usar herramientas de monitorización más avanzadas como Prometheus con Node Exporter o servicios dedicados de monitorización de cron, pero estas técnicas sencillas de logging y email son efectivas para la mayoría de necesidades de ingeniería de datos.
Hasta ahora has visto los comandos básicos de cron y patrones para capturar logs y errores. Son un buen punto de partida, pero para entornos de producción conviene explorar comandos más avanzados y la integración con tecnologías de contenedores.
En esta sección verás cómo llevar tu implementación de cron a otro nivel para flujos de trabajo más sofisticados.
Puedes encadenar varios comandos en un único cron job para crear flujos complejos sin necesidad de scripts de shell aparte.
Hay varias formas de combinarlos.
Puedes usar puntos y coma para ejecutar comandos en secuencia independientemente de si los anteriores tienen éxito:
* * * * * cd /path/to/data && python3 extract.py; python3 transform.py; python3 load.pyO usar && para ejecutar comandos solo si el anterior tuvo éxito (se detiene en el primer fallo):
* * * * * cd /path/to/data && python3 extract.py && python3 transform.py && python3 load.py >> /path/to/logs/etl.log 2>&1Alternativamente, opta por || para ejecutar un comando solo si el anterior falla (gestión de errores):
* * * * * python3 /path/to/critical_job.py || python3 /path/to/send_alert.py "Critical job failed"Para un encadenado de comandos más complejo, puedes usar paréntesis para agrupar:
* * * * * (cd /path/to/data && python3 extract.py && echo "Extraction complete") && (python3 transform.py && echo "Transform complete") >> /path/to/logs/etl.log 2>&1Este enfoque funciona bien para flujos multi‑paso más sencillos. Sin embargo, para canalizaciones muy complejas con muchas etapas, lógica condicional o gestión de errores, sigue siendo mejor opción un script de shell dedicado.
Los contenedores Docker se han vuelto esenciales en los stacks modernos de ingeniería de datos. Puedes integrar cron con Docker de varias formas potentes para asegurar que tus tareas programadas se ejecuten en entornos consistentes y aislados.
Para demostrarlo, cambiaré ligeramente el script fetch_api_data.py para tener directorios dedicados para datos y logs y ajustar las rutas para que funcione en un contenedor:
# fetch_api_data.py

import requests
import pandas as pd
import os
import uuid
from datetime import datetime

# Set file paths
data_dir = "/app/data"
log_dir = "/app/logs"
output_file = f"{data_dir}/objects_{str(uuid.uuid4())}.csv"

# Make sure the data directory exists
os.makedirs(data_dir, exist_ok=True)
os.makedirs(log_dir, exist_ok=True)


def log_message(message):
    print(f"{datetime.now().isoformat()}: {message}")


# Fetch data from the API
try:
    log_message("Starting API data fetch")
    response = requests.get("https://jsonplaceholder.typicode.com/posts")
    if response.status_code == 200:
        data = response.json()

        # Check if we have data
        if data:
            df = pd.DataFrame(
                [
                    {
                        "id": row.get("id", ""),
                        "user_id": row.get("userId", ""),
                        "title": row.get("title", ""),
                        "body": row.get("body", ""),
                    }
                    for row in data
                ]
            )

            df.to_csv(output_file, index=False)

            log_message(f"Data successfully saved to {output_file}")
        else:
            log_message("API returned empty data")
    else:
        log_message(f"API request failed with status code: {response.status_code}")
except Exception as e:
    log_message(f"Error occurred: {str(e)}")
Así, tanto los datos obtenidos como los logs se guardarán en la carpeta /app/runs.
El siguiente paso es crear un Dockerfile, un archivo que le indica a Docker cómo construir y ejecutar el contenedor:
FROM python:3.12-slim

# Install cron and required packages
RUN apt-get update && apt-get -y install cron \
    && pip install requests pandas \
    && rm -rf /var/lib/apt/lists/*

# Set up directories
WORKDIR /app
RUN mkdir -p /app/runs/data /app/runs/logs

# Copy our script
COPY fetch_api_data.py /app/

# Make the script executable
RUN chmod +x /app/fetch_api_data.py

# Create the crontab file
RUN echo "* * * * * root /usr/local/bin/python /app/fetch_api_data.py >> /app/runs/logs/api_fetch.log 2>&1" | tee /etc/cron.d/api-cron
RUN chmod 0644 /etc/cron.d/api-cron

# Create a startup script
RUN echo '#!/bin/sh' > /app/start.sh && \
    echo 'mkdir -p /app/runs/logs' >> /app/start.sh && \
    echo 'touch /app/runs/logs/api_fetch.log' >> /app/start.sh && \
    echo 'tail -f /app/runs/logs/api_fetch.log &' >> /app/start.sh && \
    echo 'cron -f' >> /app/start.sh
RUN chmod +x /app/start.sh

# Set entry point
CMD ["/app/start.sh"]
Casi lo tenemos. Ahora puedes ejecutar el siguiente comando para construir la imagen y lanzar el contenedor de Docker
docker build --no-cache -t api-cron-job . && \
docker run --rm --name api-fetcher api-cron-job
Si te conectas al contenedor, verás que el script de Python se está ejecutando cada minuto:
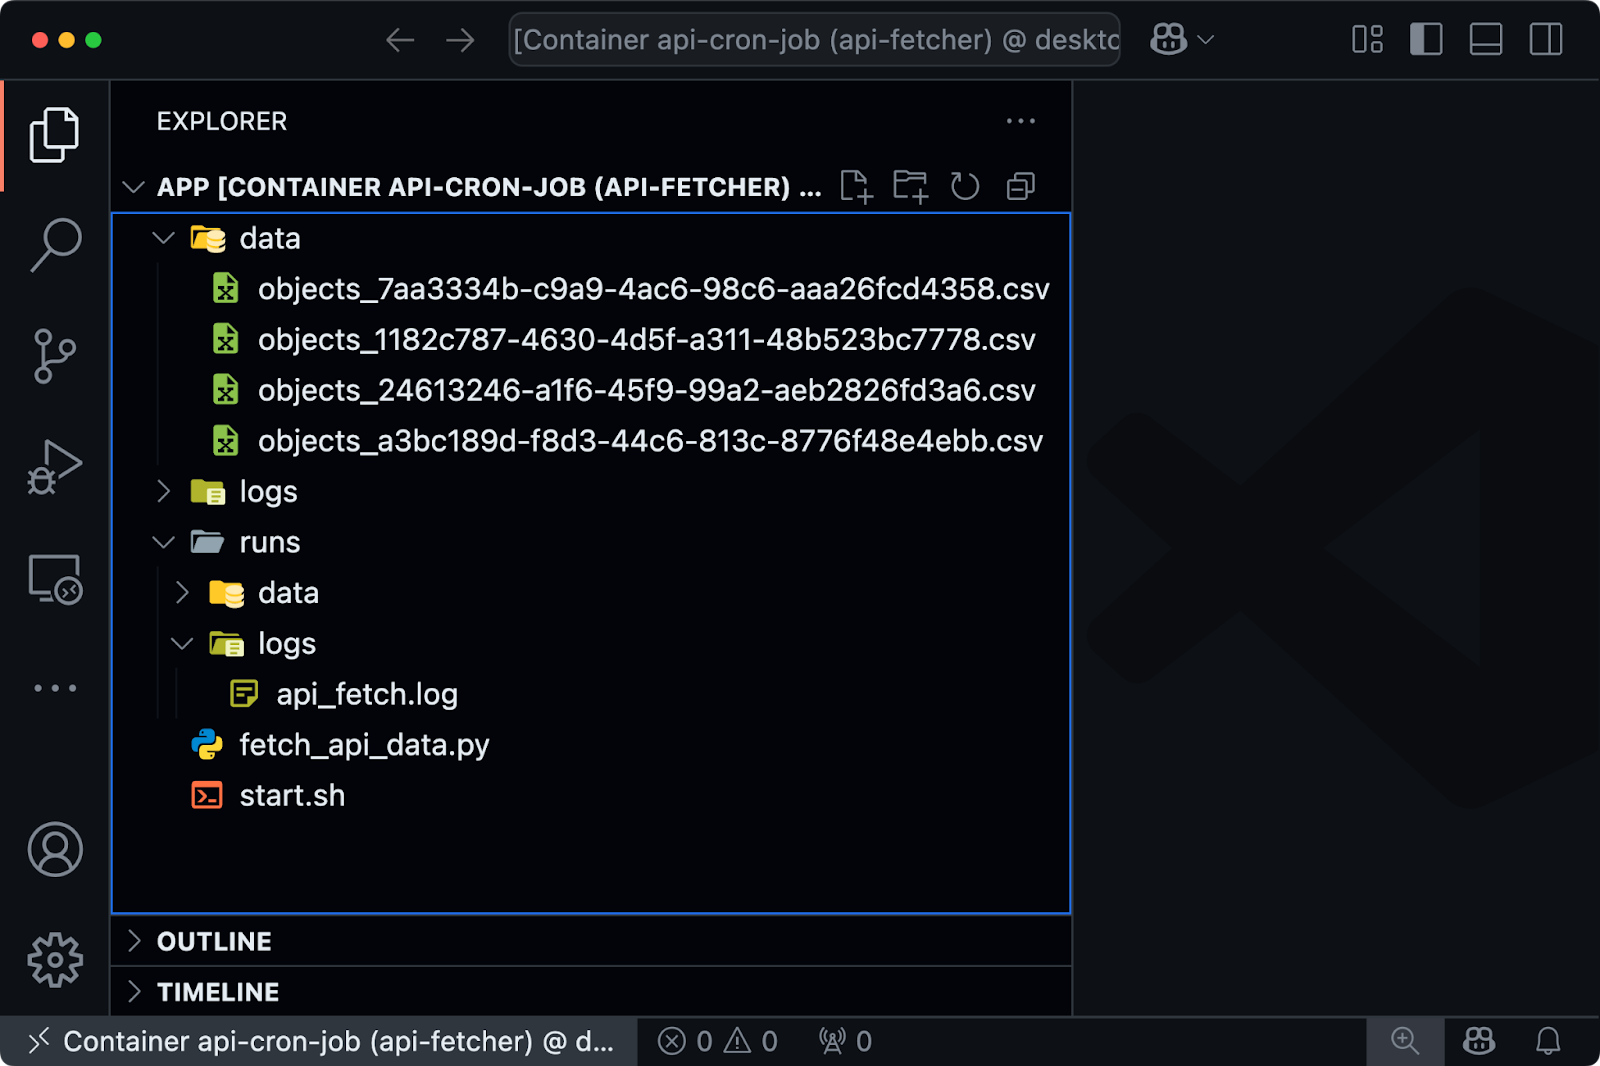
Imagen 11 - Cron job ejecutándose en un contenedor Docker
Por otro lado, si buscas una forma de ejecutar una canalización de ingeniería de datos en un contenedor Docker con una programación de cron, deja el script fetch_api_data.py sin cambios, pero modifica el Dockerfile:
# Use Python 3.12 slim as base image
FROM python:3.12-slim

# Install required Python packages
RUN pip install --no-cache-dir requests pandas

# Set working directory
WORKDIR /app

# Copy the script into the container
COPY fetch_api_data.py /app/

# Set execution permissions
RUN chmod +x /app/fetch_api_data.py

# Run the script
CMD ["/usr/local/bin/python", "/app/fetch_api_data.py"]
Luego añade lo siguiente al archivo crontab de tu sistema:
*/2 * * * * cd /path/to/root/project/folder && docker build --no-cache -t api-cron-job . && docker run --rm --name api-fetcher api-cron-jobEsto lanzará la construcción y ejecutará el contenedor cada 2 minutos.
Para flujos distribuidos de ingeniería de datos, a menudo necesitas ejecutar procesos en servidores remotos. Los cron jobs pueden activar estas operaciones remotas usando SSH.
Por ejemplo, puedes ejecutar un comando como este para lanzar un cron job en un servidor remoto:
0 5 * * * ssh username@remote-server 'python3 /path/to/remote_job.py' >> /path/to/logs/remote_job.log 2>&1Para que esto funcione sin pedir contraseña, debes configurar autenticación SSH con claves entre servidores.
Para transferir datos entre servidores de forma programada, usa este cron job:
0 6 * * * scp /path/to/local/data.csv username@remote-server:/path/to/destination/ >> /path/to/logs/data_transfer.log 2>&1Para operaciones remotas más complejas, puedes combinar SSH con scripts de shell:
#!/bin/bash
# remote_etl.sh

# Run extraction on the data source server
ssh username@source-server 'python3 /path/to/extract.py'

# Transfer the extracted data to the processing server
scp username@source-server:/path/to/extracted_data.csv /local/temp/

# Run transformation locally
python3 /path/to/transform.py

# Transfer the transformed data to the warehouse server
scp /local/temp/transformed_data.csv username@warehouse-server:/path/to/data/

# Trigger the load process on the warehouse server
ssh username@warehouse-server 'python3 /path/to/load.py'
Y después prográmalo con cron:
0 7 * * * /path/to/remote_etl.sh >> /path/to/logs/remote_etl.log 2>&1Este enfoque te permite orquestar canalizaciones de datos multi‑servidor directamente desde cron. Funciona, pero quizá te interese considerar herramientas especializadas de orquestación como Apache Airflow o Prefect para flujos distribuidos muy complejos.
Incluso los cron jobs mejor diseñados pueden fallar o causar problemas si no se implementan con buenas prácticas operativas.
Como ingeniero o ingeniera de datos, debes asegurarte de que tus tareas programadas se ejecuten con fiabilidad, fallen de forma controlada y ofrezcan suficiente visibilidad para depurar. En esta sección te explico cómo hacerlo.
El registro de logs es crucial para procesos automatizados que se ejecutan sin supervisión directa. Sin ellos, diagnosticar problemas con cron jobs es casi imposible.
Para configurar logs básicos, puedes redirigir tanto la salida estándar como los errores a archivos de log:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/script.log 2>&1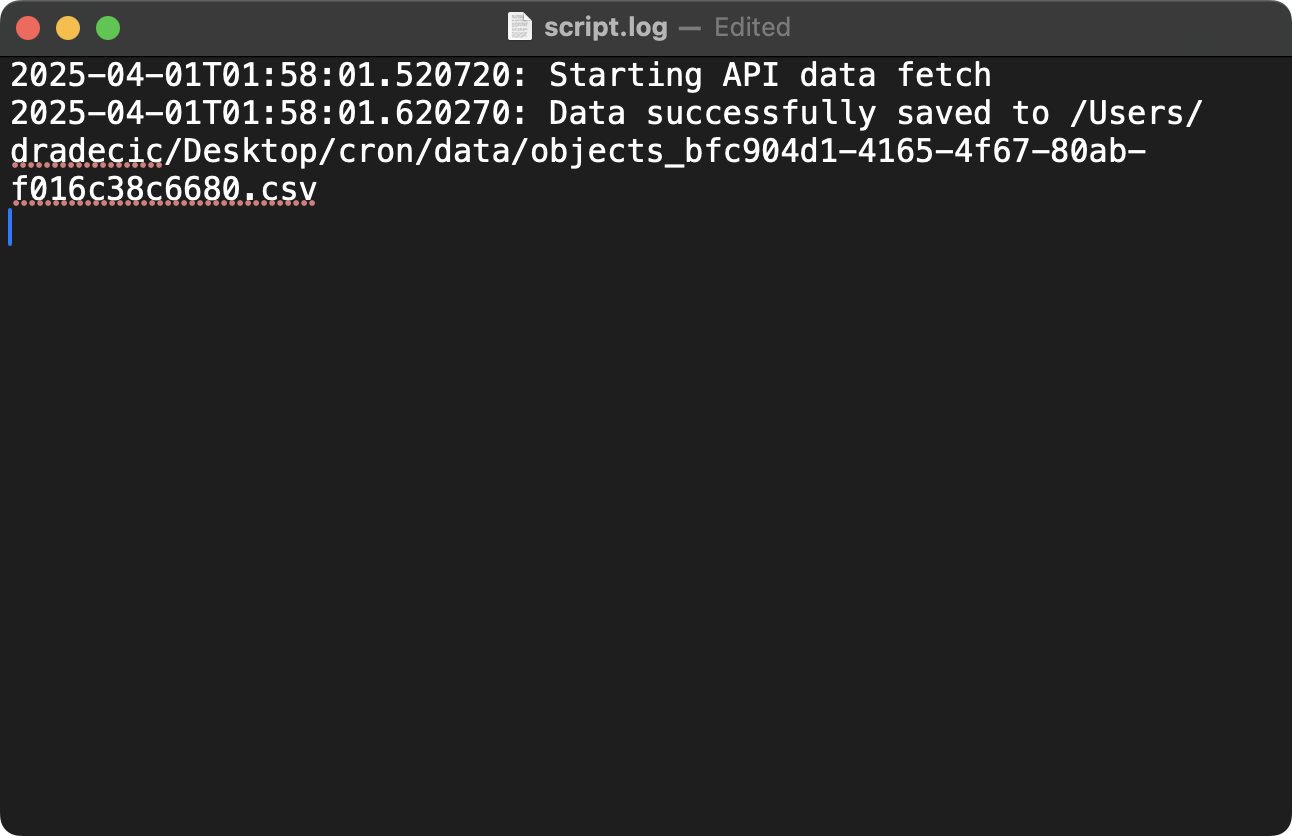
Imagen 12 - Configuración de logs de un cron job (1)
Este comando ejecuta tu script cada minuto y añade toda la salida a un archivo de log. El operador >> añade en lugar de sobrescribir, mientras que 2>&1 redirige tanto errores (descriptor 2) como salida estándar (descriptor 1) al mismo archivo.
Para un logging más estructurado, puedes añadir marcas de tiempo e identificadores de job:
* * * * * (echo "=== Job started at $(date) ==="; /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py; echo "=== Job finished at $(date) with exit code $? ===") >> /Users/dradecic/Desktop/cron/logs/script.log 2>&1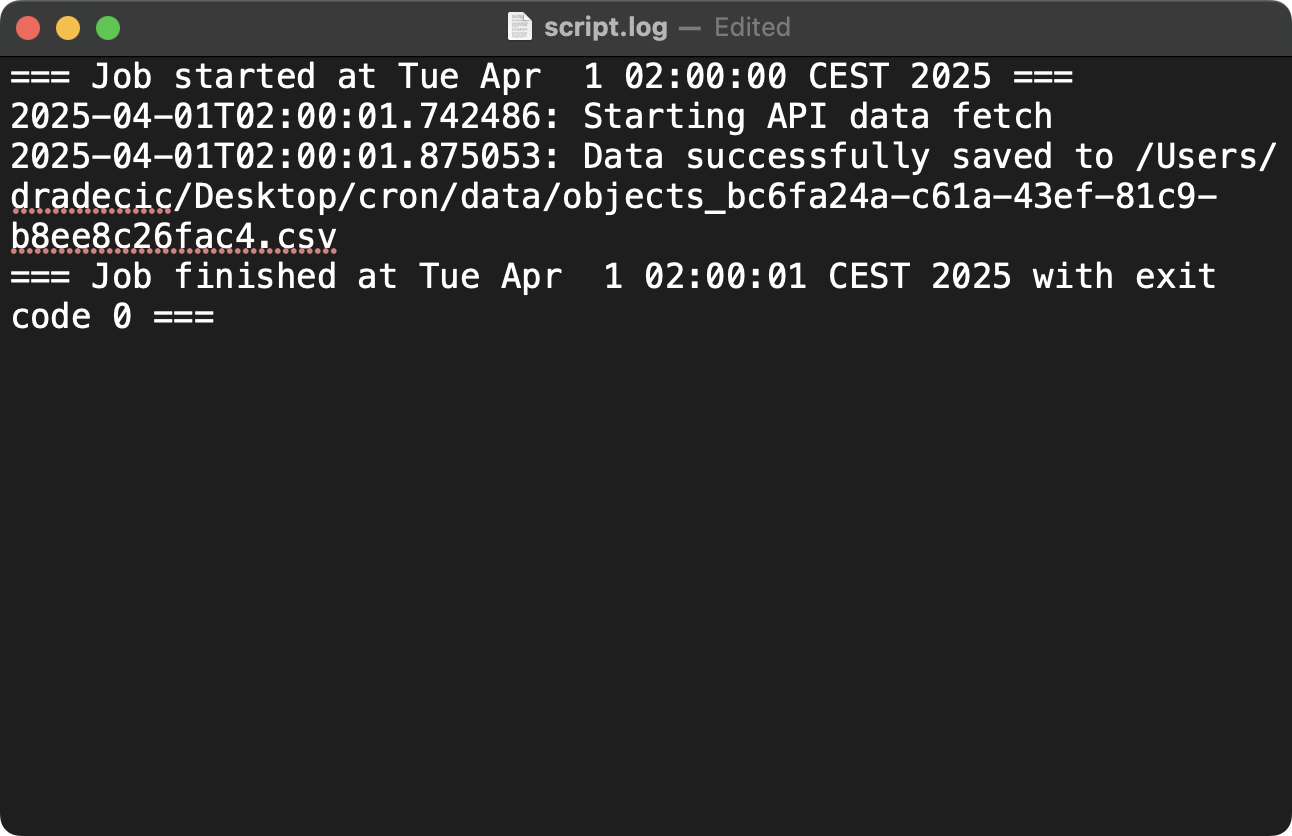
Imagen 13 - Configuración de logs de un cron job (2)
Este comando mejorado añade un marcador claro de inicio con marca de tiempo antes de ejecutar tu script y otro de fin con marca de tiempo y código de salida tras completarse. Los paréntesis agrupan los comandos para que toda su salida se redirija al archivo de log. La variable $? contiene el código de salida del último comando ejecutado, lo que te ayuda a saber si el script tuvo éxito (0) o falló (no cero).
Para evitar que los logs consuman demasiado espacio, puedes implementar rotación de logs. Usa la utilidad logrotate, disponible en la mayoría de distribuciones Linux:
Crea un archivo de configuración en /etc/logrotate.d/cron-jobs:
/path/to/logs/*.log {
    daily
    missingok
    rotate 14
    compress
    delaycompress
    notifempty
    create 0640 username groupname
}
Esta configuración indica al sistema que:
daily)missingok)rotate 14)compress)delaycompress)notifempty)create 0640 username groupname)El servicio logrotate del sistema aplica automáticamente estos ajustes, normalmente una vez al día. Cuando se ejecuta, renombra tu log actual (añadiendo un sufijo de fecha), comprime los antiguos, elimina los de más de 14 días y crea un archivo nuevo para las entradas siguientes.
Los flujos robustos de ingeniería de datos necesitan estrategias para tratar fallos. Puedes integrar lógica de reintentos en tus scripts o cron jobs, o conectar tus cron jobs a sistemas de monitorización.
A continuación te muestro cómo implementar todas estas opciones.
Lógica de reintentos incorporada se puede implementar directamente en tus scripts de Python, como en este ejemplo:
import time
import random

def fetch_data_with_retry(max_attempts=3, backoff_factor=1.5):
    attempt = 1
    while attempt <= max_attempts:
        try:
            # Try to fetch data
            return fetch_data()
        except Exception as e:
            print(f"Attempt {attempt} failed: {str(e)}")
            # Calculate backoff time with jitter
            backoff_time = backoff_factor ** (attempt - 1) * (random.uniform(0.8, 1.2))
            if attempt < max_attempts:
                print(f"Retrying in {backoff_time:.2f} seconds...")
                time.sleep(backoff_time)
            else:
                print("Max retry attempts reached. Giving up.")
                raise
        attempt += 1
Esta función de Python implementa una estrategia de reintentos con backoff exponencial y jitter. Así funciona:
max_attempts veces (por defecto 3).Este patrón es ideal para fallos transitorios como problemas de red o límites de tasa de APIs. El incremento exponencial da tiempo al sistema externo a recuperarse, mientras que el jitter previene el "efecto estampida".
Reintentos basados en cron también son una opción válida. Puedes reintentar jobs fallidos programándolos más a menudo de lo necesario.
Aquí tienes un ejemplo con dos cron jobs:
success_flag que evita que el script vuelva a ejecutarse en los 10 minutos siguientes.*/10 * * * * [ ! -f /path/to/success_flag ] && python /path/to/script.py && touch /path/to/success_flag
0 0 * * * rm -f /path/to/success_flag La configuración anterior puede resultar confusa, así que te la resumo de nuevo:
[ ! -f /path/to/success_flag ])/path/to/script.py)touch /path/to/success_flag)0 0 * * *) y elimina la marca, permitiendo que el proceso vuelva a ejecutarse al día siguiente.Esta técnica es útil para tareas que deben completarse una vez al día pero pueden fallar temporalmente. El job lo intentará durante todo el día hasta que lo consiga una vez.
Integración con monitorización te permite conectar tus cron jobs a sistemas como Prometheus. Es un tema en sí mismo, así que aquí va una visión de alto nivel.
El script que verás a continuación envuelve tu job real y recopila y envía métricas a Prometheus. Estos son los pasos que realiza:
#!/bin/bash
# monitored_job.sh

# Define pushgateway URL
PUSHGATEWAY="http://prometheus-pushgateway:9091"

# Start time in seconds
START_TIME=$(date +%s)

# Run the actual job
/path/to/actual_job.sh
EXIT_CODE=$?

# End time in seconds
END_TIME=$(date +%s)
DURATION=$((END_TIME - START_TIME))

# Push metrics to Prometheus
cat <<EOF | curl --data-binary @- ${PUSHGATEWAY}/metrics/job/cron_job/instance/$(hostname)
# HELP cron_job_duration_seconds How long the cron job took to execute
# TYPE cron_job_duration_seconds gauge
cron_job_duration_seconds{name="data_extraction"} ${DURATION}

# HELP cron_job_exit_code Exit code of the cron job
# TYPE cron_job_exit_code gauge
cron_job_exit_code{name="data_extraction"} ${EXIT_CODE}

# HELP cron_job_last_run_timestamp Timestamp of last job run
# TYPE cron_job_last_run_timestamp gauge
cron_job_last_run_timestamp{name="data_extraction"} ${END_TIME}
EOF

exit ${EXIT_CODE}
Estas métricas te permiten:
Pushgateway actúa como intermediario, permitiendo que el cron job (de vida corta) envíe sus métricas a Prometheus, que luego las almacena para alertas y visualización.
Los problemas con zonas horarias son habituales en ingeniería de datos, especialmente cuando trabajas con fuentes globales o sistemas distribuidos.
Como cabría esperar, los cron jobs son sensibles a la configuración de zona horaria.
Por defecto, cron usa la zona horaria local del sistema. Puedes comprobarla en Linux con este comando:
timedatectlEl comando muestra la hora actual del sistema y la configuración de zona. Si tu servidor está en una zona local como America/New_York, todas las programaciones de cron se interpretarán en esa zona.
Para garantizar programaciones consistentes independientemente de la ubicación del servidor o los cambios de horario de verano, usa UTC para tus cron jobs:
# Set the CRON_TZ environment variable at the top of your crontab
CRON_TZ=UTC

# Now all job schedules will use UTC
0 0 * * * /path/to/daily_job.sh
Añadiendo la línea CRON_TZ=UTC al principio del crontab, le dices a cron que interprete todos los horarios en UTC en lugar de hora local.
Esto significa que el job se ejecutará a medianoche UTC cada día, sin verse afectado por la zona local o los cambios de horario de verano. UTC (Tiempo Universal Coordinado) no cambia con el horario de verano y es una referencia consistente en cualquier ubicación.
Si trabajas en ingeniería de datos, los cron jobs son una herramienta muy valiosa.
Te ayudan a automatizar tareas repetitivas y a construir canalizaciones fiables. Ofrecen una forma consistente y potente de programar scripts y orquestar procesos ETL de varios pasos. La sintaxis requiere algo de práctica, pero te será natural en un par de días.
Cuando implementes cron jobs en tu trabajo, recuerda seguir las mejores prácticas en logging, gestión de errores y zonas horarias. Un buen sistema de logs te da visibilidad y facilita la resolución de problemas. Las técnicas de manejo de errores con mecanismos de reintento aseguran que tus canalizaciones se recuperen de fallos transitorios. Y una gestión cuidadosa de zonas horarias mantiene tus horarios consistentes, sobre todo cuando trabajas con fuentes globales o equipos distribuidos.
>¿Quieres conseguir un puesto de Data Engineer en 2025? Estas son las 5 habilidades esenciales que debes tener.
Es cierto, las herramientas especializadas de orquestación como Apache Airflow o Prefect ofrecen funciones avanzadas para canalizaciones complejas, pero cron sigue siendo relevante para muchas tareas de ingeniería de datos. Es simple, fiable y de bajo coste operativo, lo que lo hace perfecto para necesidades de automatización.
Para aprender más sobre ingeniería de datos, apúntate a estos cursos de DataCamp:
Nuestros programas de certificación te ayudan a destacar y a demostrar que tus aptitudes están preparadas para el trabajo a posibles empleadores.

¡Aprende más sobre ingeniería de datos con estos cursos!
Curso
Curso
Curso
blog
Javier Canales Luna
15 min
blog
Matt Crabtree
7 min
blog
Mike Shakhomirov
11 min
blog
Joleen Bothma
11 min
blog
Abid Ali Awan
15 min
Tutorial
Kurtis Pykes
5 min