

कोर्स
Python में Apache Airflow परिचय
4 घंटा
65.3K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंयदि आप अक्सर दोहराने वाले कार्यों को मैन्युअल रूप से संभालते हैं, तो आप जानते हैं कि यह न केवल थकाऊ है—यह डेडलाइन छूटने और असंगत डेटा पाइपलाइनों का नुस्खा भी है।
Cron jobs Unix-आधारित सिस्टम पर दोहरावदार कार्यों को ऑटोमेट करने का पसंदीदा समाधान हैं। ये आपको कमांड या स्क्रिप्ट को निश्चित अंतराल पर चलाने के लिए शेड्यूल करने देते हैं। Cron के सरल और लचीले शेड्यूलिंग सिस्टम का लाभ उठाकर, आप बेसिक डेटा कलेक्शन से लेकर जटिल ETL वर्कफ़्लोज़ तक सबकुछ ऑटोमेट कर सकते हैं, जिनके लिए अन्यथा निरंतर मैन्युअल हस्तक्षेप की ज़रूरत पड़ती। इन स्वचालित प्रक्रियाओं की सेटअप मानव त्रुटि को खत्म करती है और आपकी डेटा पाइपलाइनों को लगातार और विश्वसनीय रूप से चलना सुनिश्चित करती है।
Unix परिवेश में काम करने वाले किसी भी डेटा इंजीनियरिंग प्रोफेशनल के लिए cron jobs में महारत हासिल करना अनिवार्य है। स्वचालित कार्यों को शेड्यूल और मैनेज करने की क्षमता आपके वर्कफ़्लो को कई गुना बेहतर बनाती है और रखरखाव का बोझ घटाती है।
इस संपूर्ण गाइड में, मैं आपको डेटा इंजीनियरिंग के लिए cron jobs के बारे में सब कुछ बताऊंगा—बेसिक सेटअप से लेकर उन्नत उपयोग परिदृश्यों और बेहतरीन प्रथाओं तक।
>डेटा इंजीनियरिंग में बिलकुल नए हैं? हमारा कोर्स चर्चा में रहने वाले शब्दों को सरलता से समझाता है और अवधारणाएं स्पष्ट करता है।
Cron job Unix ऑपरेटिंग सिस्टम में एक समय-आधारित शेड्यूलर है जो आपको तय समय, तारीख, या अंतराल पर कमांड अपने-आप चलाने देता है.
Cron को अपने निजी सहायक की तरह समझें जो बिना किसी मैन्युअल दखल के ठीक उसी समय कार्य निष्पादित करता है जब आप चाहते हैं। डेटा इंजीनियरों के लिए, इसका मतलब है कि आप डेटाबेस बैकअप, डेटा ट्रांसफ़र, रिपोर्ट जेनरेशन आदि ऑटोमेट कर सकते हैं।
Cron jobs एक साधारण टेक्स्ट फ़ाइल में रहते हैं जिसे "crontab" (cron table) कहा जाता है। इस फ़ाइल की हर पंक्ति एक शेड्यूल्ड टास्क को दर्शाती है और छह घटकों वाले एक निश्चित फ़ॉर्मैट का पालन करती है:
* * * * * command-to-execute
│ │ │ │ │
│ │ │ │ └─── Day of week (0-6, where 0 is Sunday)
│ │ │ └───── Month (1-12)
│ │ └─────── Day of month (1-31)
│ └───────── Hour (0-23)
└─────────── Minute (0-59)
पहले पाँच फ़ील्ड cron को ठीक-ठीक बताते हैं कि आपकी कमांड कब चलनी है। आप विशिष्ट मान, रेंज (जैसे 1-5), सूचियाँ (जैसे 1, 3, 5), या तारांकन (*) का उपयोग कर सकते हैं, जिसका अर्थ है समय की हर इकाई। छठा घटक वह वास्तविक कमांड जिसे आप चलाना चाहते हैं।
उदाहरण के लिए, अगर आप हर दिन आधी रात को API से डेटा निकालने के लिए एक Python स्क्रिप्ट चलाना चाहते हैं, तो आपका cron job इस तरह दिखेगा:
0 0 * * * /usr/bin/python3 /home/username/scripts/extract_data.pyयह cron को बताता है कि आपकी स्क्रिप्ट 0 मिनट, 0 घंटे (आधी रात) पर, हर दिन, हर महीने और हफ्ते के हर दिन चले। Python इंटरप्रेटर और आपकी स्क्रिप्ट—दोनों के लिए एब्सोल्यूट पाथ देने से यह सुनिश्चित होता है कि जॉब किसी भी वातावरण में सही तरह से चले।
आप और भी जटिल शेड्यूल बना सकते हैं। मान लें कि आप हर सोमवार, बुधवार और शुक्रवार को 3:30 बजे अपराह्न डेटाबेस क्लीनअप चलाना चाहते हैं, तो आपका cron एक्सप्रेशन यह होगा:
30 15 * * 1,3,5 /path/to/cleanup_script.shहर तारांकन एक वाइल्डकार्ड की तरह काम करता है और आपको अपनी ज़रूरत के अनुसार लचीले शेड्यूल बनाने देता है। आप @daily, @weekly, या @monthly जैसे विशेष शॉर्टकट का भी उपयोग कर सकते हैं ताकि सामान्य शेड्यूलिंग पैटर्न अधिक पठनीय हो जाएँ।
बुनियादी बातें इतनी ही हैं। आगे, मैं आपको डेटा इंजीनियरिंग कार्यों के लिए cron jobs के साथ हाथ-से-हाथ काम करना दिखाऊंगा।
अब जब आप समझ गए हैं कि cron jobs क्या हैं, तो अपना पहला स्वचालित कार्य सेट अप करते हैं। प्रक्रिया सीधी है और शुरू करने के लिए केवल कुछ कमांड की ज़रूरत है।
Cron jobs बनाने या संशोधित करने के लिए, आपको अपनी crontab फ़ाइल तक पहुँचना होगा। आप crontab -e कमांड से ऐसा कर सकते हैं:
crontab -e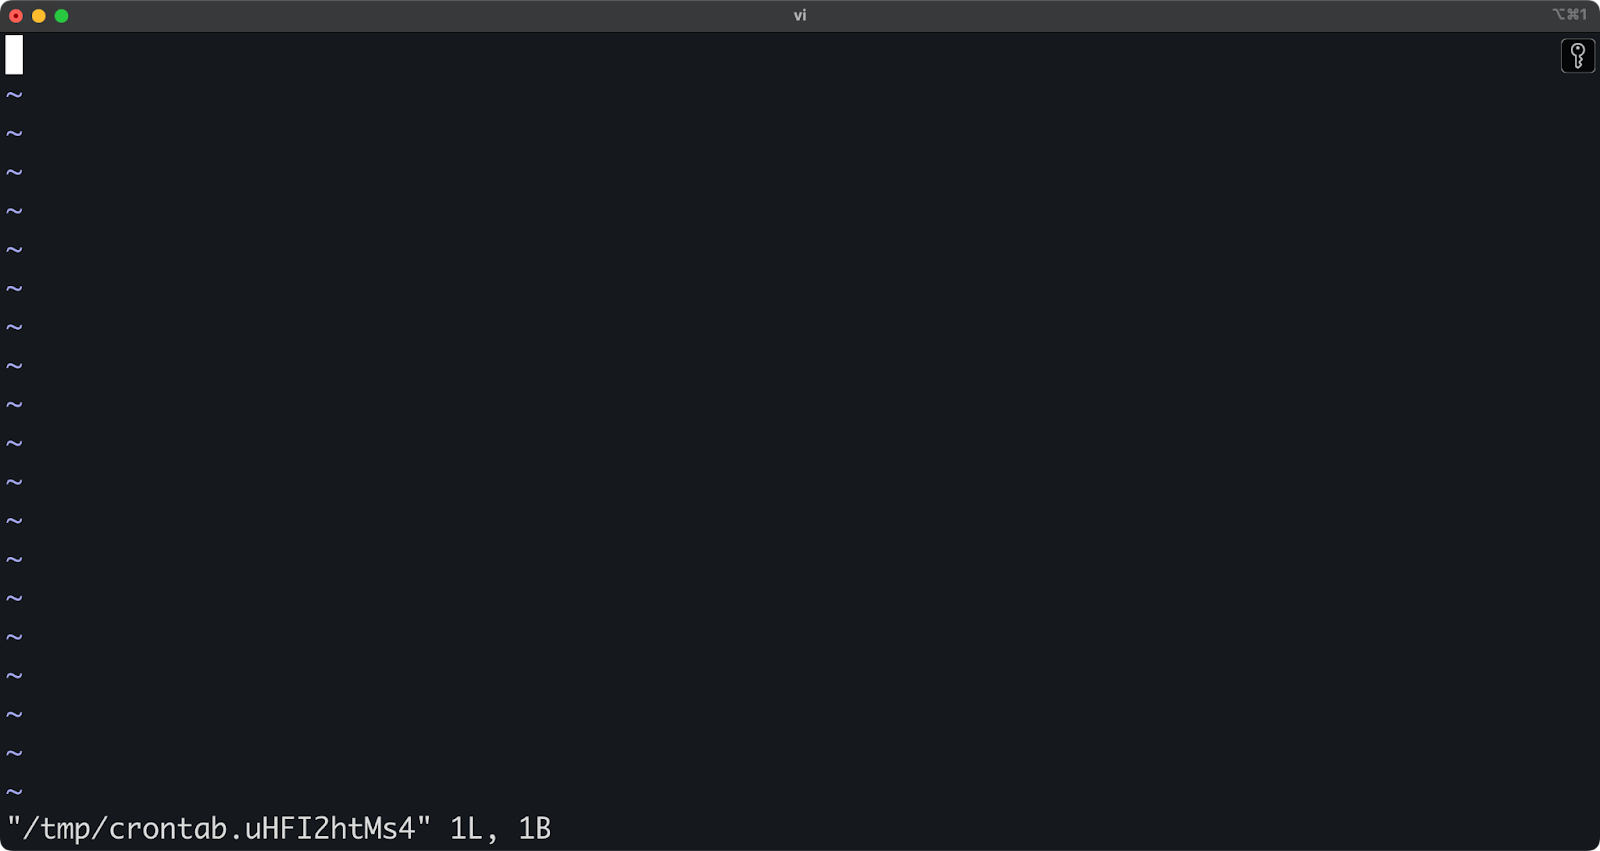
छवि 1 - crontab फ़ाइल संपादित करना
उपरोक्त कमांड एक vi टेक्स्ट संपादक खोलती है, जिसमें आप शेड्यूल्ड कार्य जोड़, संपादित या हटा सकते हैं।
यदि आपने इसे पहले कभी उपयोग नहीं किया है, तो आपकी crontab फ़ाइल खाली हो सकती है। नया cron job जोड़ने के लिए, बस पहले बताए गए cron सिंटैक्स का पालन करते हुए एक नई पंक्ति जोड़ें। हर पंक्ति में टाइमिंग शेड्यूल और चलने वाली कमांड—दोनों शामिल होने चाहिए।
उदाहरण के लिए, किसी स्क्रिप्ट को हर दिन सुबह 3 बजे चलाने के लिए यह पंक्ति जोड़ें:
0 3 * * * /path/to/your/commandफ़ाइल को सहेजें और संपादक से बाहर निकलें। Cron स्वचालित रूप से आपकी नई crontab इंस्टॉल कर देगा और निर्धारित समय पर आपके जॉब चलाएगा।
आइए एक व्यावहारिक उदाहरण से शुरू करें: एक Python स्क्रिप्ट को API से डेटा निकालने के लिए हर मिनट चलाना। यहाँ एक संपूर्ण Python स्क्रिप्ट है जो REST API एंडपॉइंट से कनेक्ट होती है, ऑब्जेक्ट डेटा लाती है, और उसे CSV फ़ाइल में सहेजती है—बस सुनिश्चित करें कि आपके Python इंटरप्रेटर में requests और pandas पैकेज इंस्टॉल हों:
# fetch_api_data.py

import requests
import pandas as pd
import os
from datetime import datetime

# Create a timestamp for the filename
timestamp = datetime.now().strftime("%Y%m%d_%H%M%S")

# Set file paths - CHANGE THIS
data_dir = "/Users/dradecic/Desktop/cron/data"
output_file = f"{data_dir}/objects_{timestamp}.csv"

# Make sure the data directory exists
os.makedirs(data_dir, exist_ok=True)

# Fetch data from the API
try:
    response = requests.get("https://jsonplaceholder.typicode.com/posts")
    if response.status_code == 200:
        data = response.json()

        # Check if we have data
        if data:
            df = pd.DataFrame([
                {
                    "id": row.get("id", ""),
                    "user_id": row.get("userId", ""),
                    "title": row.get("title", ""),
                    "body": row.get("body", "")
                } for row in data
            ])

            df.to_csv(output_file, index=False)

            print(f"Data successfully saved to {output_file}")
        else:
            print("API returned empty data")
    else:
        print(f"API request failed with status code: {response.status_code}")
except Exception as e:
    print(f"Error occurred: {str(e)}")
अब, इस स्क्रिप्ट को cron से हर दिन सुबह 2 बजे चलाने के लिए शेड्यूल करें:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py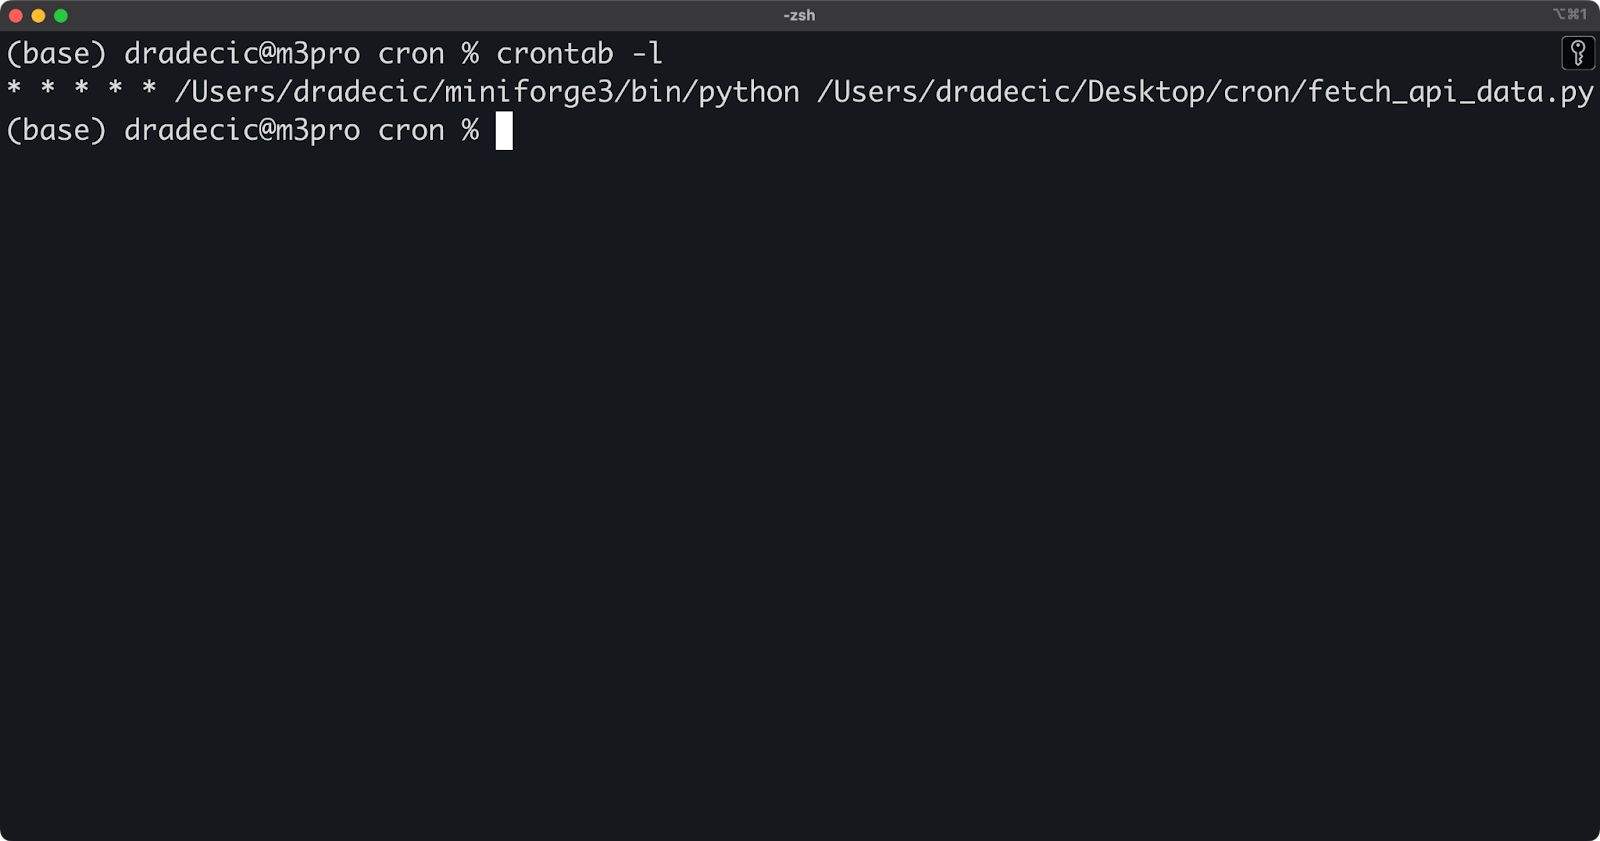
छवि 2 - सक्रिय crontabs की सूची
यह पंक्ति cron को आपकी Python स्क्रिप्ट हर दिन के हर मिनट चलाने के लिए कहती है। सुनिश्चित करें कि Python इंटरप्रेटर (/Users/dradecic/miniforge3/bin/python मेरे मामले में) और आपकी स्क्रिप्ट (/Users/dradecic/Desktop/cron/fetch_api_data.py मेरे मामले में)—दोनों के लिए एब्सोल्यूट पाथ का उपयोग करें।
एब्सोल्यूट पाथ क्यों? Cron सीमित एनवायरनमेंट में चलता है, इसलिए इसे आपके शेल के PATH वेरिएबल या मौजूदा डायरेक्टरी के बारे में पता नहीं होता। बिना एब्सोल्यूट पाथ के आपका जॉब असफल हो सकता है क्योंकि cron उन कमांड या फ़ाइलों को ढूंढ नहीं पाएगा जिनका आप उपयोग करना चाहते हैं।
जब आप यह पढ़ रहे थे, तब मेरे data फ़ोल्डर में कुछ CSV फ़ाइलें सहेजी गईं, जो दर्शाता है कि यह cron job अपेक्षित रूप से काम कर रहा है:
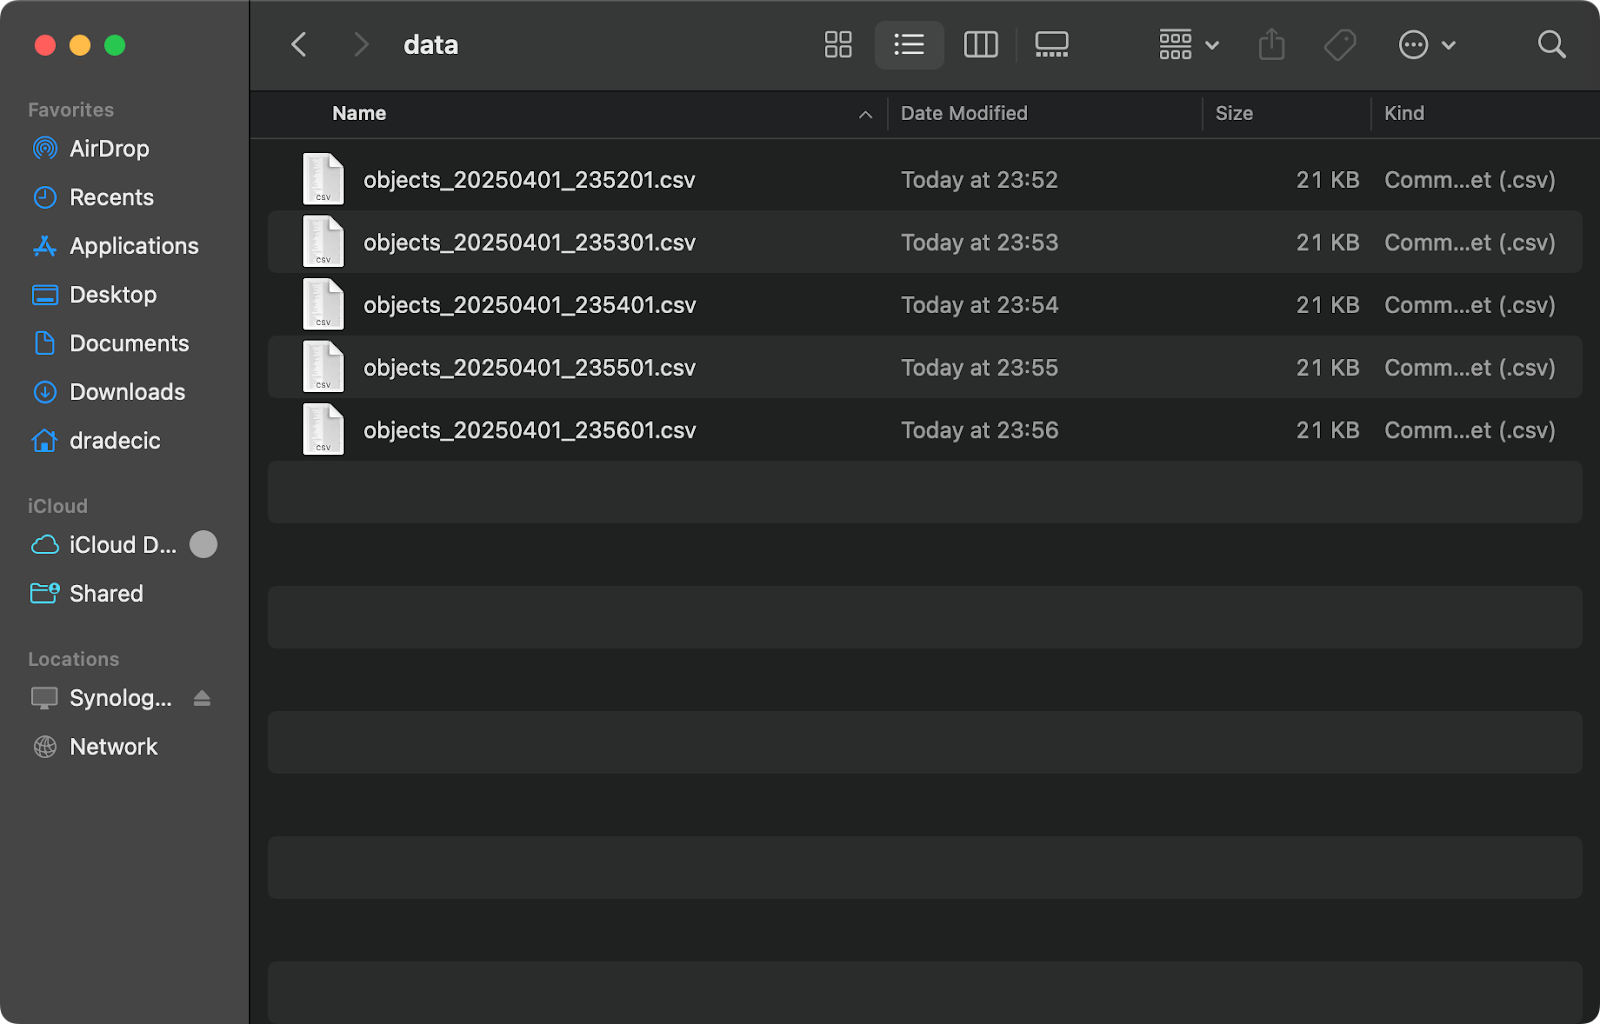
छवि 3 - सहेजी गई CSV फ़ाइलें
और जटिल डेटा इंजीनियरिंग वर्कफ़्लोज़ के लिए जैसे ETL (Extract, Transform, Load) जॉब्स, आप cron का उपयोग बहु-चरण प्रक्रियाओं को शेड्यूल करने के लिए कर सकते हैं। एक प्रचलित तरीका यह है कि आप एक शेल स्क्रिप्ट बनाएँ जिसमें आपके सभी ETL चरण हों, फिर उस स्क्रिप्ट को cron से शेड्यूल करें।
सरलता के लिए, नीचे दी गई .sh स्क्रिप्ट में जो कोड आप देखेंगे वह केवल सैद्धांतिक है और किसी डेटा स्रोत से नहीं जुड़ता:
#!/bin/bash
# etl_pipeline.sh

# Extract data from source
/usr/bin/psql -U username -d source_db -c "COPY (SELECT * FROM source_table) TO '/tmp/extracted_data.csv' WITH CSV HEADER;"

# Transform data
/usr/bin/python3 /home/username/scripts/transform_data.py

# Load data into target
/usr/bin/psql -U username -d target_db -c "\COPY target_table FROM '/tmp/transformed_data.csv' WITH CSV HEADER;"

# Log completion
echo "ETL job completed at $(date)" >> /home/username/logs/etl_job.log
यह करने के बाद, आप अपनी शेल स्क्रिप्ट को executable बनाना चाहेंगे:
chmod +x /home/username/scripts/etl_pipeline.shअंत में, इसे cron से शेड्यूल करें ताकि यह, मान लें, हर कार्यदिवस सुबह 1 बजे चले:
0 1 * * 1-5 /home/username/scripts/etl_pipeline.shयदि आप डेटा इंजीनियर हैं, तो cron से ETL कार्यों को शेड्यूल करने के ये फायदे हैं:
बड़े ETL प्रोसेस के लिए, आप अपनी स्क्रिप्ट में एरर हैंडलिंग जोड़ना चाहेंगे:
#!/bin/bash
# etl_pipeline.sh

# Set error handling
set -e  # Exit immediately if any command fails

# Execute ETL steps
# ...

# If we get here, all steps succeeded
echo "ETL job completed successfully at $(date)" >> /home/username/logs/etl_job.log
और बस! आपका ETL पाइपलाइन निर्धारित समय पर अपने-आप चलेगा, आपका डेटा प्रोसेस करेगा, और मॉनिटरिंग के लिए अपनी स्थिति लॉग करेगा।
Cron jobs सेटअप करने के बाद, आपको उन्हें मैनेज और मॉनिटर करना होगा ताकि वे अपेक्षा के अनुसार चलें.
इससे मेरा मतलब है कि वर्तमान में कौन से जॉब शेड्यूल हैं, पुराने जॉब हटाना, और उनके निष्पादन की मॉनिटरिंग करना। यह अनुभाग आपको cron jobs को बिना परेशानी के बनाए रखने के लिए आवश्यक कमांड और तकनीकें दिखाएगा।
अपने सभी वर्तमान में शेड्यूल्ड cron jobs देखने के लिए, crontab -l कमांड का उपयोग करें:
crontab -lउपरोक्त कमांड आपकी मौजूदा crontab फ़ाइल की सामग्री दिखाती है, जिसमें सभी शेड्यूल्ड जॉब, उनके टाइमिंग और कमांड शामिल होते हैं। यह एडिट मोड में गए बिना सक्रिय जॉब्स को वेरिफाई करने का तेज़ तरीका है।
यदि आपने पिछले अनुभाग का अनुसरण किया है, तो आपका आउटपुट कुछ ऐसा दिखेगा:
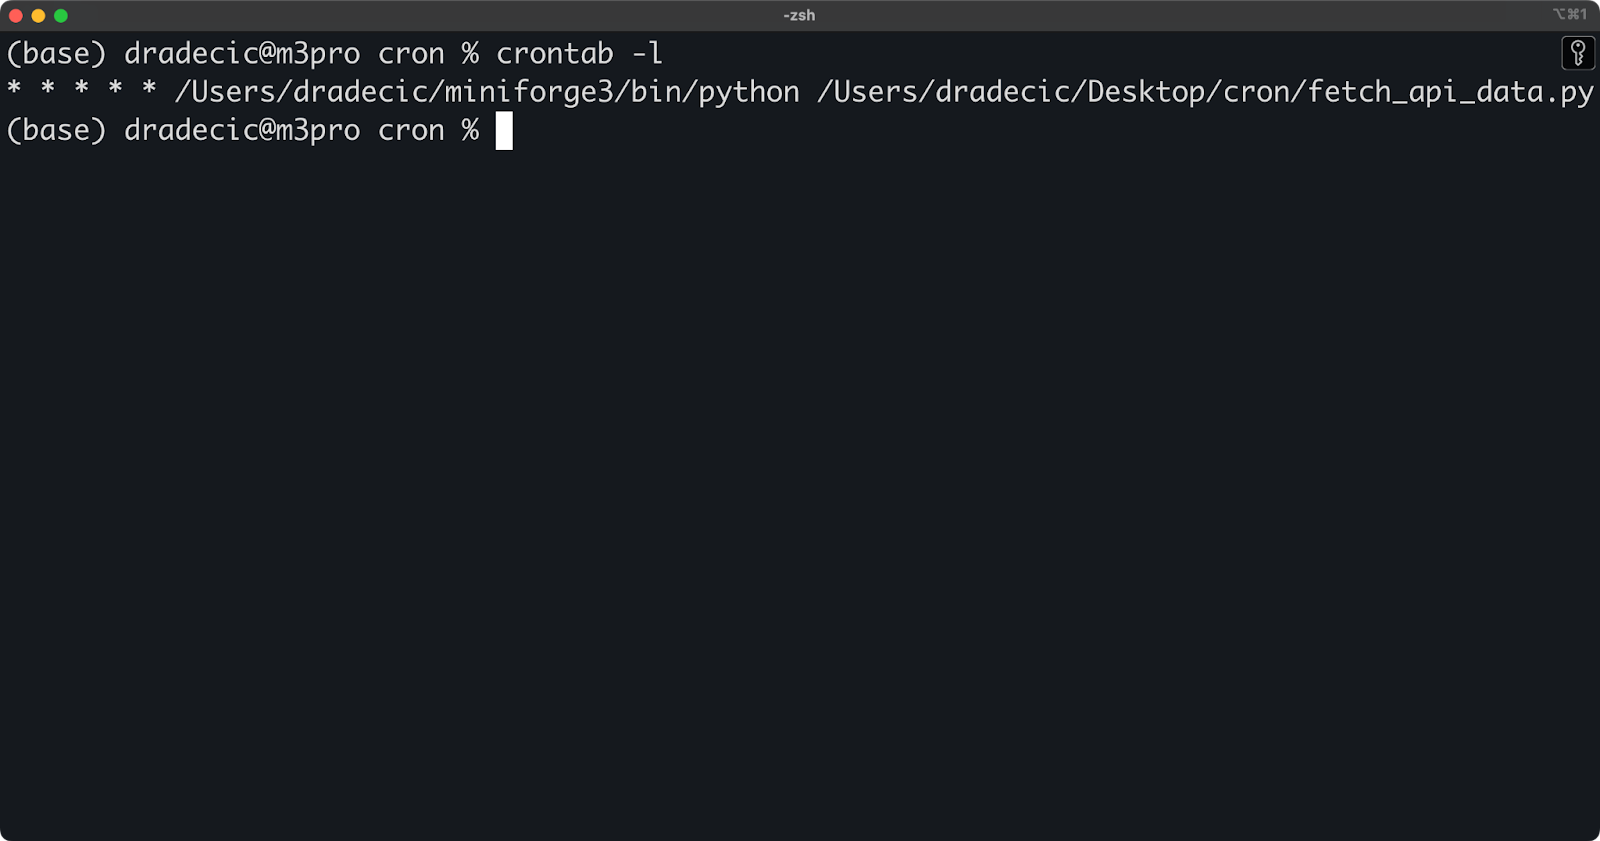
छवि 4 - सक्रिय cron jobs
यदि आपको किसी अन्य उपयोगकर्ता के cron jobs जांचने हैं (root एक्सेस आवश्यक), तो इसके बजाय यह कमांड चलाएँ:
sudo crontab -u username -lजब cron jobs की ज़रूरत नहीं रहे तो उन्हें हटाने या निष्क्रिय करने के कई तरीके हैं। किसी विशिष्ट जॉब को हटाने के लिए, अपनी crontab को एडिट मोड में खोलें और संबंधित पंक्ति हटा दें:
crontab -eकिसी जॉब को अस्थायी रूप से बिना हटाए निष्क्रिय करने के लिए, पंक्ति की शुरुआत में # जोड़कर उसे कमेंट कर दें:
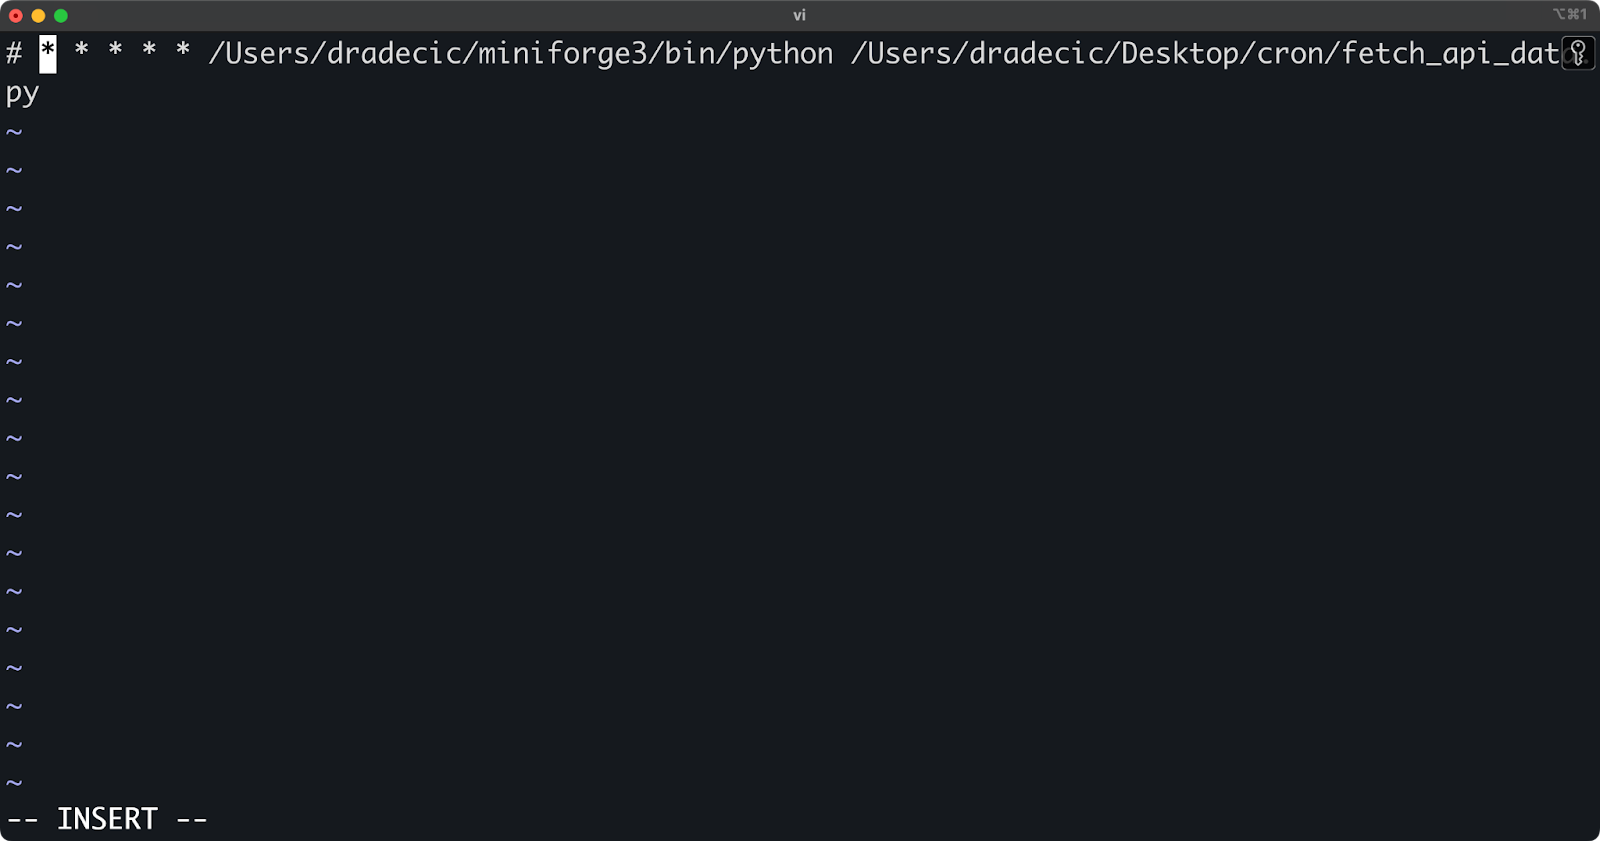
छवि 5 - Cron job को अस्थायी रूप से निष्क्रिय करना
कमेंट किया गया जॉब आपकी crontab में भविष्य के संदर्भ के लिए बना रहता है, लेकिन तय शेड्यूल पर निष्पादित नहीं होगा।
यदि आप अपनी पूरी crontab (सभी जॉब) हटाना चाहते हैं, तो -r विकल्प का उपयोग करें:
crontab -r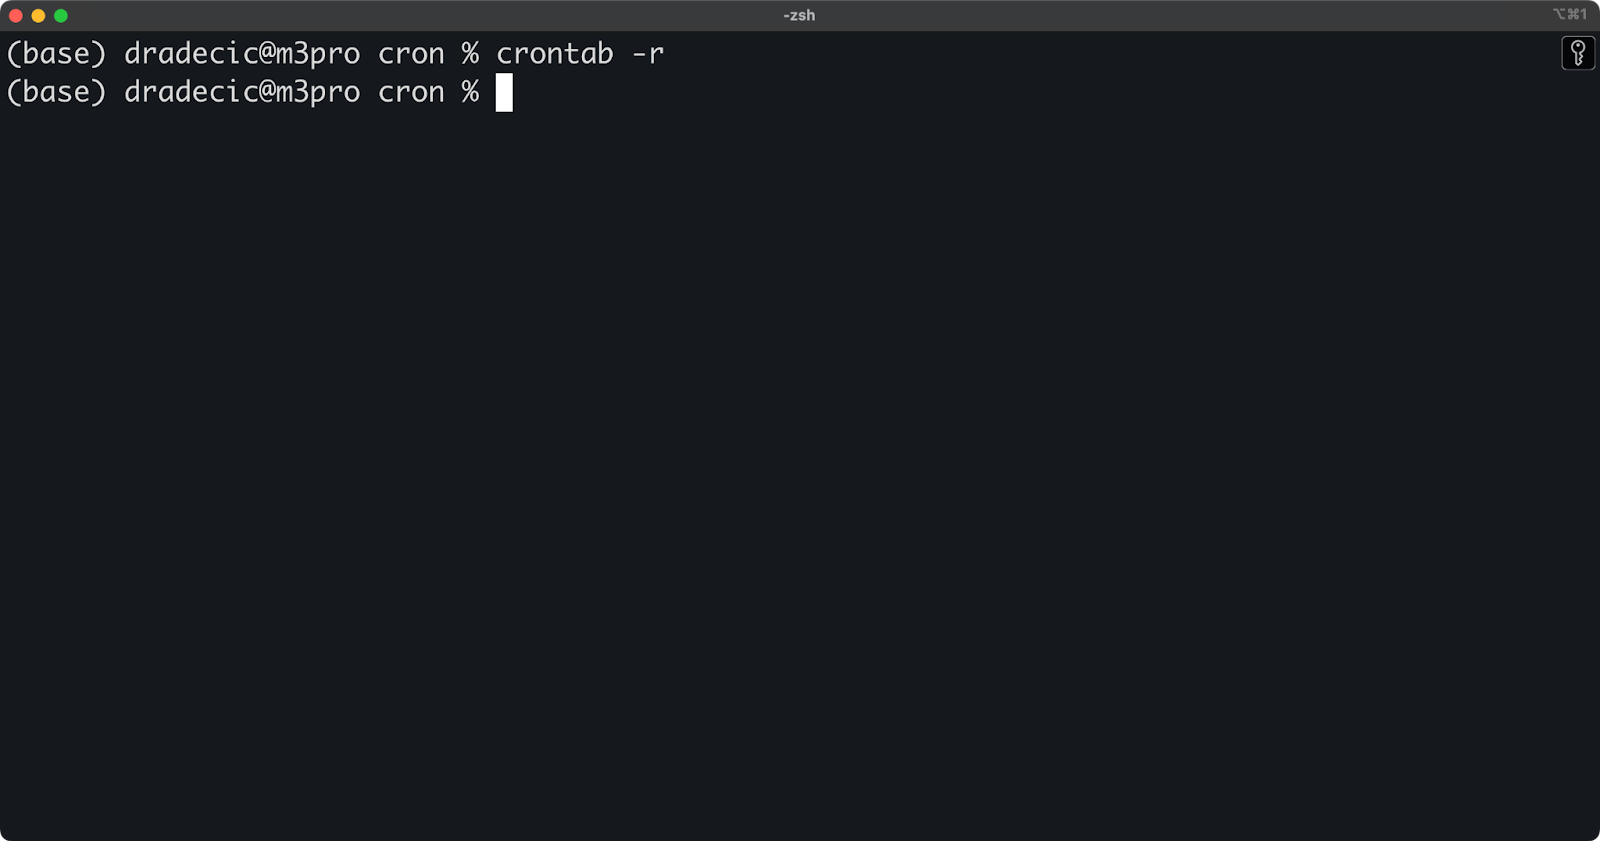
छवि 6 - पूरी crontab हटाना
इस कमांड के साथ सावधानी बरतें—यह बिना पुष्टि मांगे आपके सभी शेड्यूल्ड जॉब हटा देता है। आकस्मिक डिलीशन से बचने के लिए, आप पहले अपनी crontab का बैकअप ले सकते हैं:
crontab -l > my_crontab_backupयह आपकी मौजूदा crontab को एक फ़ाइल में सहेज देता है, जिसका उपयोग आप जरूरत पड़ने पर अपने जॉब को बहाल करने के लिए कर सकते हैं:
crontab my_crontab_backup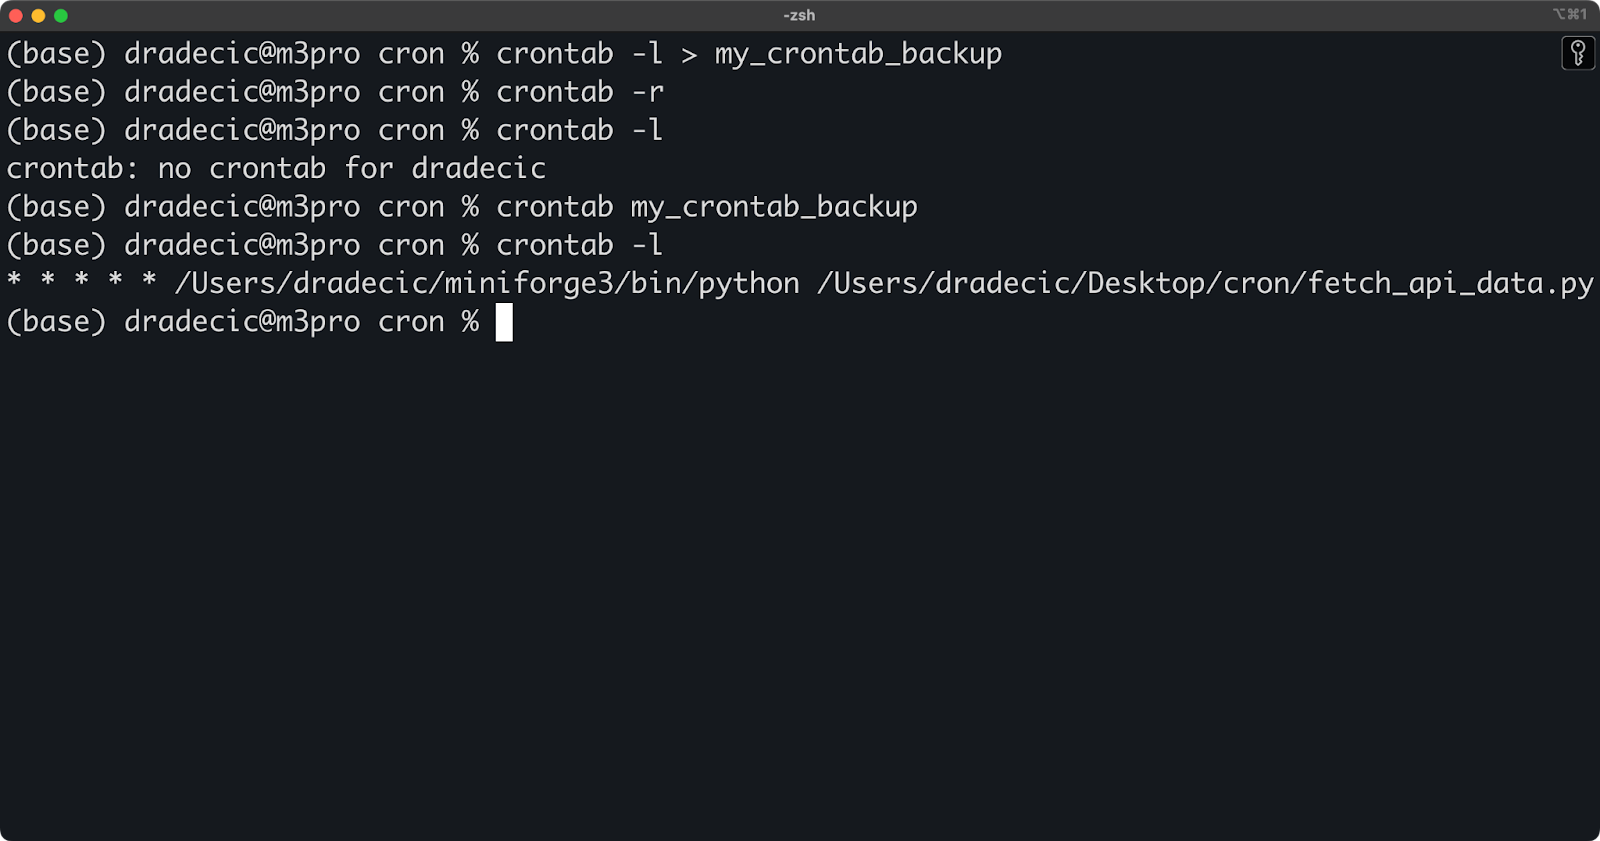
छवि 7 - बैकअप से crontab बहाल करना
डिफ़ॉल्ट रूप से, cron जॉब के आउटपुट को उस उपयोगकर्ता को ईमेल करने का प्रयास करता है जो crontab का मालिक है। हालांकि, इसके लिए सही तरह से कॉन्फ़िगर की गई मेल प्रणाली की आवश्यकता होती है, जो हमेशा उपलब्ध नहीं होती। इसके बजाय, आप आउटपुट को लॉग फ़ाइलों में रीडायरेक्ट कर सकते हैं ताकि ट्रैकिंग और ट्रबलशूटिंग आसान हो सके।
स्टैंडर्ड आउटपुट और एरर संदेश—दोनों कैप्चर करने के लिए, यह रीडायरेक्शन सिंटैक्स उपयोग करें:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1यह रीडायरेक्शन शुरू में डरावना लग सकता है, तो इसे तोड़कर समझते हैं:
>> आउटपुट को निर्दिष्ट फ़ाइल में जोड़ता है।2>&1 stderr (एरर संदेश) को stdout (स्टैंडर्ड आउटपुट) के समान स्थान पर भेजता है।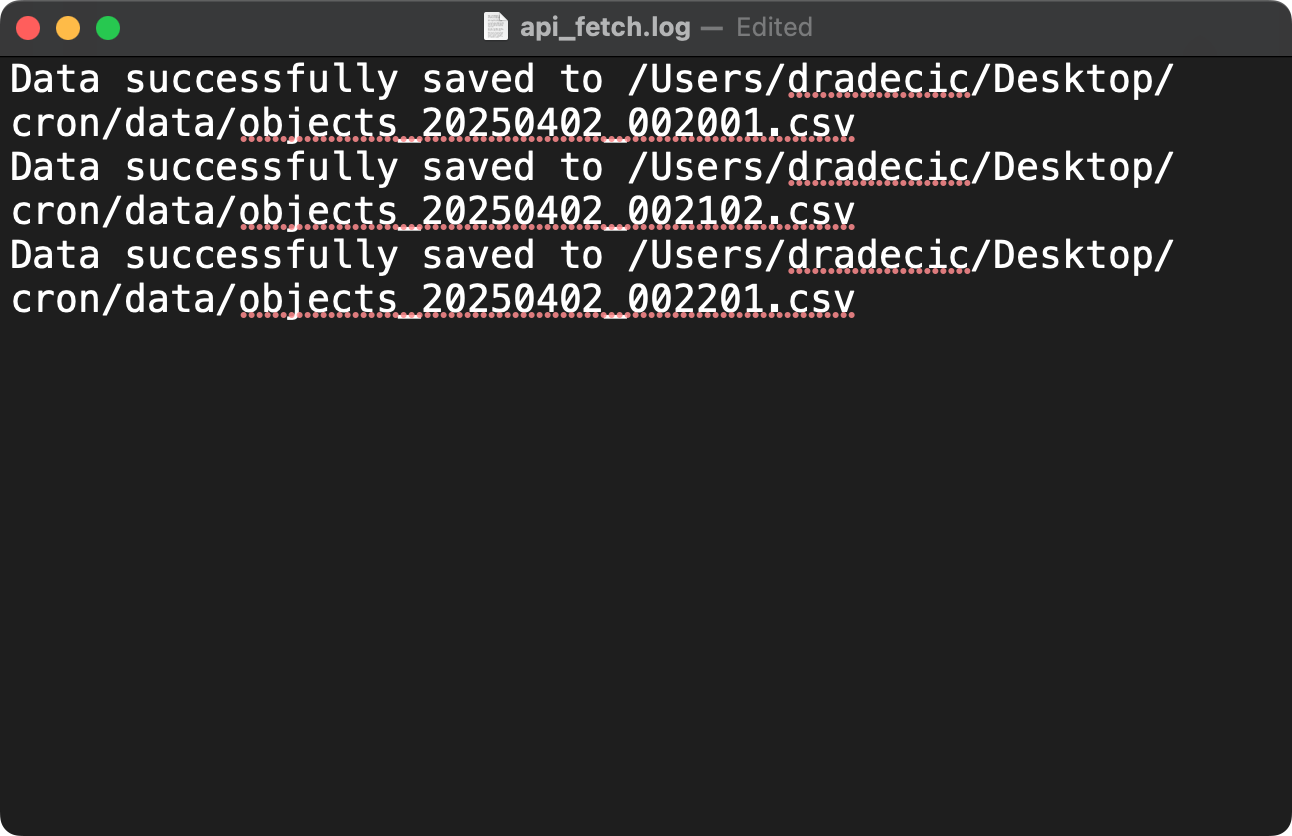
छवि 8 - Cron job लॉग्स कैप्चर करना
बेहतर लॉग प्रबंधन के लिए, आप टाइमस्टैम्प जोड़ सकते हैं:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1 && echo "Job completed at $(date)" >> /Users/dradecic/Desktop/cron/logs/api_fetch.log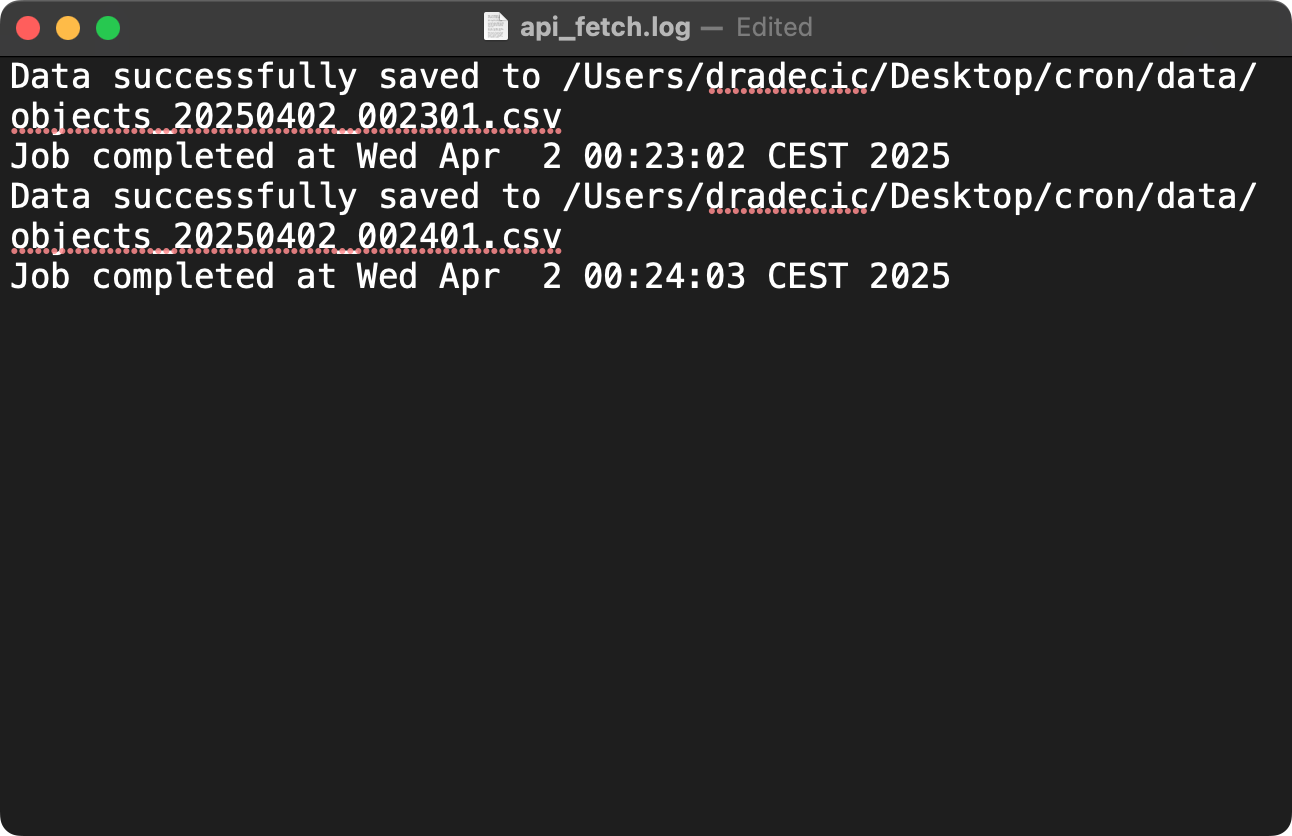
छवि 9 - टाइमस्टैम्प के साथ cron job लॉग कैप्चर करना
यदि आप सामान्य आउटपुट और एरर के लिए अलग-अलग लॉग फ़ाइलें चाहते हैं, तो यह उपयोग करें:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>> /Users/dradecic/Desktop/cron/logs/api_fetch_errors.log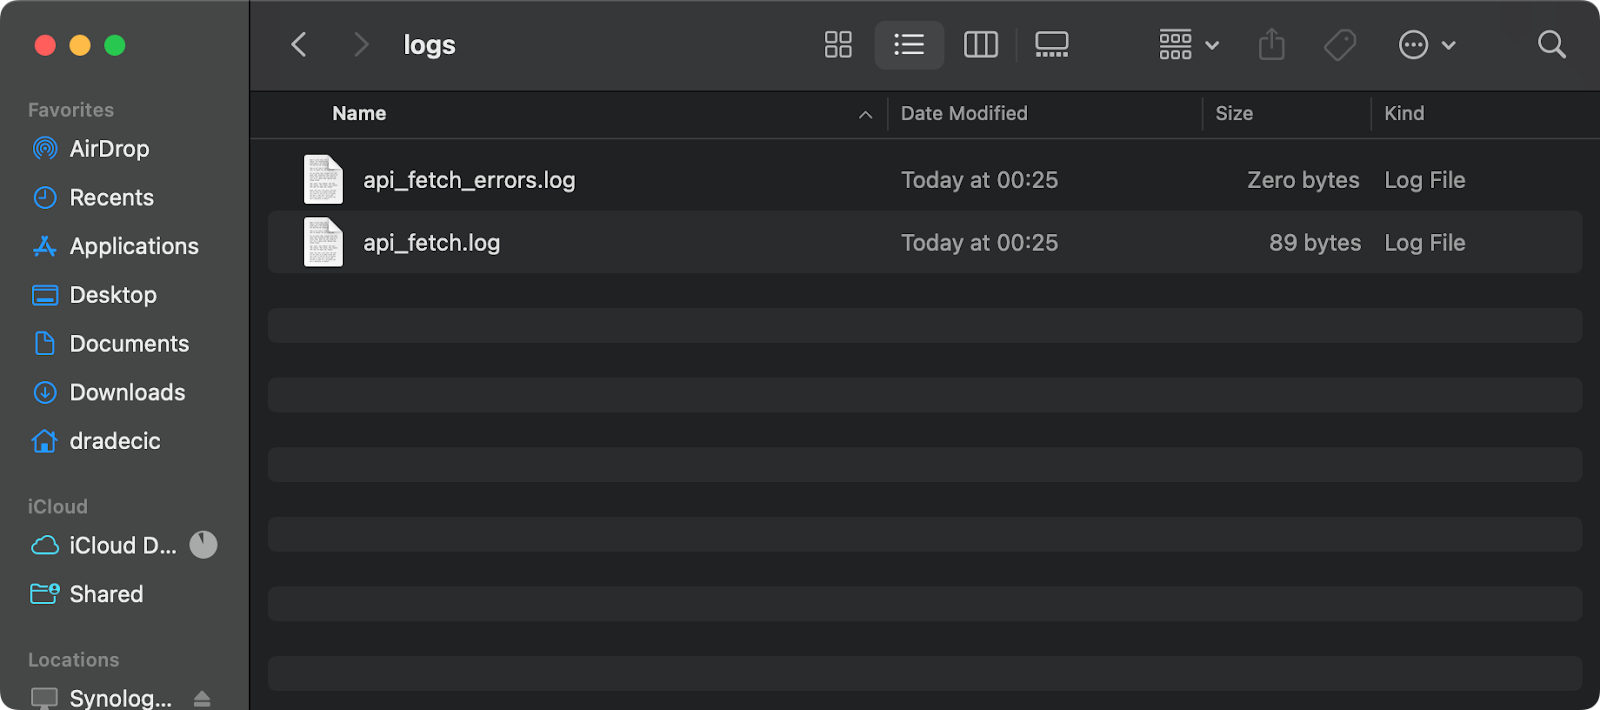
छवि 10 - Cron job लॉग और एरर फ़ाइलें
क्रिटिकल जॉब्स जिनमें असफलता पर सूचना आवश्यक है, उनके लिए आप ईमेल अलर्ट सेट कर सकते हैं। मान लेते हैं कि आपके सिस्टम में कोई मेल ट्रांसफ़र एजेंट (जैसे postfix या sendmail) इंस्टॉल है, तो आप अपना cron job इस तरह संशोधित कर सकते हैं कि केवल जॉब असफल होने पर ईमेल भेजा जाए:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1 || echo "API fetch failed on $(date)" | mail -s "Cron Job Failed" your-email@example.comयह || ऑपरेटर का उपयोग करता है, जिसका अर्थ है "मेल कमांड केवल तब चलाएँ जब पिछला कमांड असफल हो।"
“सफलता” ईमेल सूचनाओं के लिए, यह उपयोग करें:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1 && echo "API fetch completed successfully on $(date)" | mail -s "Cron Job Succeeded" your-email@example.comआप और उन्नत मॉनिटरिंग टूलs जैसे Prometheus with Node Exporter या समर्पित cron मॉनिटरिंग सेवाओं का उपयोग भी कर सकते हैं, लेकिन ये सरल लॉगिंग और ईमेल तकनीकें अधिकांश डेटा इंजीनियरिंग जरूरतों के लिए प्रभावी मॉनिटरिंग प्रदान करती हैं।
अब तक, आपने बेसिक cron कमांड और लॉग व एरर कैप्चर करने के पैटर्न सीख लिए हैं। शुरुआत के लिए ये अच्छे हैं, लेकिन प्रोडक्शन उपयोग मामलों के लिए आप और उन्नत कमांड तथा कंटेनर तकनीकों के साथ इंटीग्रेशन देखना चाहेंगे।
इस अनुभाग में, आप अधिक परिष्कृत डेटा इंजीनियरिंग वर्कफ़्लो के लिए अपने cron job इम्प्लीमेंटेशन को कैसे स्तर बढ़ाएँ, यह देखेंगे।
आप एक ही cron job में कई कमांड्स को चेन कर सकते हैं ताकि बिना अलग शेल स्क्रिप्ट के जटिल वर्कफ़्लोज़ बनाए जा सकें.
कमांड्स को संयोजित करने के कई तरीके हैं।
आप सेमीकोलन का उपयोग करके कमांड्स को क्रमवार चला सकते हैं—चाहे पिछले कमांड सफल हों या नहीं:
* * * * * cd /path/to/data && python3 extract.py; python3 transform.py; python3 load.pyया आप && का उपयोग कर सकते हैं ताकि कमांड केवल तभी चलें जब पिछला कमांड सफल हो (पहली असफलता पर रुक जाता है):
* * * * * cd /path/to/data && python3 extract.py && python3 transform.py && python3 load.py >> /path/to/logs/etl.log 2>&1वैकल्पिक रूप से, || चुनें ताकि केवल तब कोई कमांड चले जब पिछला कमांड विफल हो (एरर हैंडलिंग):
* * * * * python3 /path/to/critical_job.py || python3 /path/to/send_alert.py "Critical job failed"और अधिक जटिल कमांड चेनिंग के लिए, आप कमांड्स को समूहित करने हेतु कोष्ठक का उपयोग कर सकते हैं:
* * * * * (cd /path/to/data && python3 extract.py && echo "Extraction complete") && (python3 transform.py && echo "Transform complete") >> /path/to/logs/etl.log 2>&1यह तरीका सरल बहु-चरण वर्कफ़्लोज़ के लिए अच्छा काम करता है। हालांकि, बहुत जटिल पाइपलाइनों—जिनमें कई चरण, कंडीशनल लॉजिक, या एरर हैंडलिंग हो—के लिए एक समर्पित शेल स्क्रिप्ट अब भी बेहतर विकल्प है।
Docker कंटेनर आधुनिक डेटा इंजीनियरिंग स्टैक का अनिवार्य हिस्सा बन चुके हैं। आप अपने शेड्यूल्ड टास्क को सुसंगत, पृथक परिवेश में चलाने के लिए Docker के साथ cron को कई शक्तिशाली तरीकों से एकीकृत कर सकते हैं।
दिखाने के लिए, मैं fetch_api_data.py स्क्रिप्ट में थोड़ा बदलाव करूँगा ताकि डेटा और लॉग्स के लिए समर्पित डायरेक्टरी हों और पाथ ऐसे हों कि स्क्रिप्ट कंटेनर एनवायरनमेंट में काम कर सके:
# fetch_api_data.py

import requests
import pandas as pd
import os
import uuid
from datetime import datetime

# Set file paths
data_dir = "/app/data"
log_dir = "/app/logs"
output_file = f"{data_dir}/objects_{str(uuid.uuid4())}.csv"

# Make sure the data directory exists
os.makedirs(data_dir, exist_ok=True)
os.makedirs(log_dir, exist_ok=True)


def log_message(message):
    print(f"{datetime.now().isoformat()}: {message}")


# Fetch data from the API
try:
    log_message("Starting API data fetch")
    response = requests.get("https://jsonplaceholder.typicode.com/posts")
    if response.status_code == 200:
        data = response.json()

        # Check if we have data
        if data:
            df = pd.DataFrame(
                [
                    {
                        "id": row.get("id", ""),
                        "user_id": row.get("userId", ""),
                        "title": row.get("title", ""),
                        "body": row.get("body", ""),
                    }
                    for row in data
                ]
            )

            df.to_csv(output_file, index=False)

            log_message(f"Data successfully saved to {output_file}")
        else:
            log_message("API returned empty data")
    else:
        log_message(f"API request failed with status code: {response.status_code}")
except Exception as e:
    log_message(f"Error occurred: {str(e)}")
तो, दोनों—फेच किया गया डेटा और लॉग्स—/app/runs फ़ोल्डर में सहेजे जाएँगे।
अगला चरण है Dockerfile बनाना—एकल फ़ाइल जो Docker को बताती है कि कंटेनर कैसे बनाना और चलाना है:
FROM python:3.12-slim

# Install cron and required packages
RUN apt-get update && apt-get -y install cron \
    && pip install requests pandas \
    && rm -rf /var/lib/apt/lists/*

# Set up directories
WORKDIR /app
RUN mkdir -p /app/runs/data /app/runs/logs

# Copy our script
COPY fetch_api_data.py /app/

# Make the script executable
RUN chmod +x /app/fetch_api_data.py

# Create the crontab file
RUN echo "* * * * * root /usr/local/bin/python /app/fetch_api_data.py >> /app/runs/logs/api_fetch.log 2>&1" | tee /etc/cron.d/api-cron
RUN chmod 0644 /etc/cron.d/api-cron

# Create a startup script
RUN echo '#!/bin/sh' > /app/start.sh && \
    echo 'mkdir -p /app/runs/logs' >> /app/start.sh && \
    echo 'touch /app/runs/logs/api_fetch.log' >> /app/start.sh && \
    echo 'tail -f /app/runs/logs/api_fetch.log &' >> /app/start.sh && \
    echo 'cron -f' >> /app/start.sh
RUN chmod +x /app/start.sh

# Set entry point
CMD ["/app/start.sh"]
लगभग हो गया। अब आप निम्न कमांड चलाकर इमेज बना सकते हैं और Docker कंटेनर चला सकते हैं
docker build --no-cache -t api-cron-job . && \
docker run --rm --name api-fetcher api-cron-job
यदि आप कंटेनर से कनेक्ट करते हैं, तो आप देखेंगे कि Python स्क्रिप्ट हर मिनट निष्पादित हो रही है:
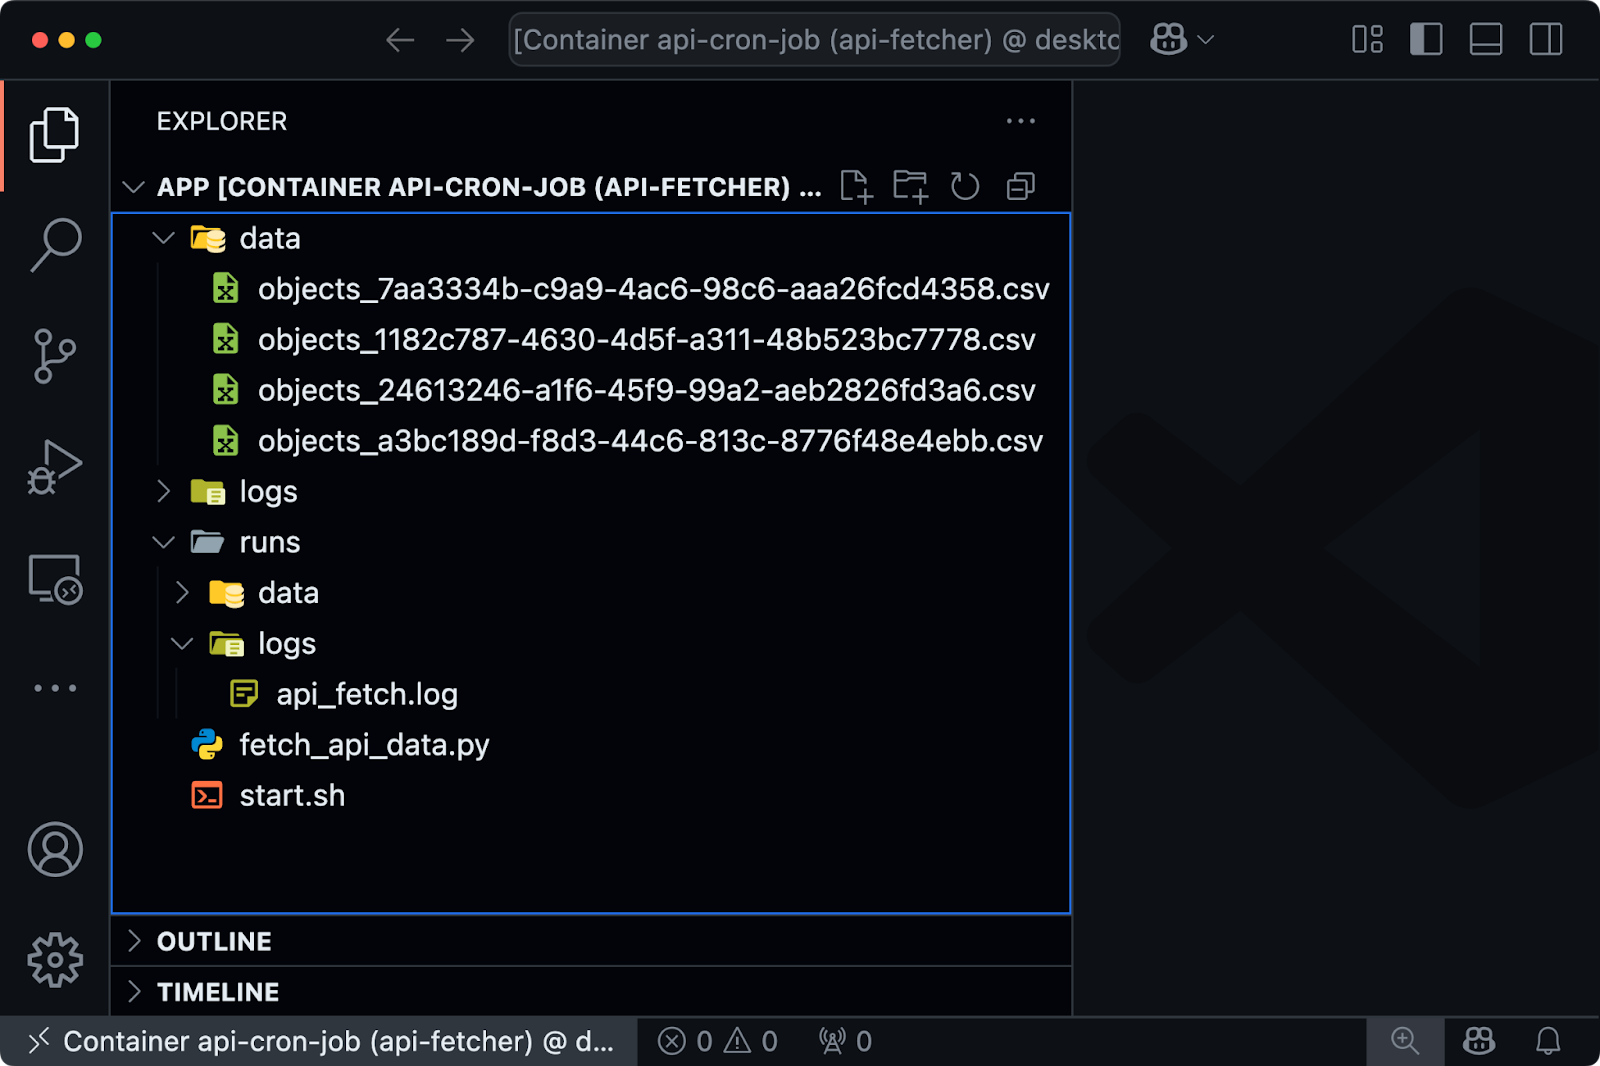
छवि 11 - Docker कंटेनर में चल रहा cron job
दूसरी ओर, यदि आप Docker कंटेनर में cron शेड्यूल पर डेटा इंजीनियरिंग पाइपलाइन चलाने का तरीका ढूँढ रहे हैं, तो fetch_api_data.py स्क्रिप्ट को यथावत रखें, लेकिन Dockerfile संशोधित करें:
# Use Python 3.12 slim as base image
FROM python:3.12-slim

# Install required Python packages
RUN pip install --no-cache-dir requests pandas

# Set working directory
WORKDIR /app

# Copy the script into the container
COPY fetch_api_data.py /app/

# Set execution permissions
RUN chmod +x /app/fetch_api_data.py

# Run the script
CMD ["/usr/local/bin/python", "/app/fetch_api_data.py"]
फिर अपनी सिस्टम crontab फ़ाइल में निम्न जोड़ें:
*/2 * * * * cd /path/to/root/project/folder && docker build --no-cache -t api-cron-job . && docker run --rm --name api-fetcher api-cron-jobयह हर 2 मिनट पर बिल्ड ट्रिगर करेगा और कंटेनर चलाएगा।
वितरित डेटा इंजीनियरिंग वर्कफ़्लो में, आपको अक्सर रिमोट सर्वरों पर प्रक्रियाएँ चलाने की आवश्यकता होती है। Cron jobs SSH का उपयोग कर इन रिमोट ऑपरेशनों को ट्रिगर कर सकते हैं।
उदाहरण के लिए, आप रिमोट सर्वर पर cron job चलाने के लिए ऐसा कमांड चला सकते हैं:
0 5 * * * ssh username@remote-server 'python3 /path/to/remote_job.py' >> /path/to/logs/remote_job.log 2>&1यह पासवर्ड प्रॉम्प्ट्स के बिना काम करे, इसके लिए आपको सर्वरों के बीच SSH की-आधारित प्रमाणीकरण सेट करना होगा।
सर्वरों के बीच शेड्यूल पर डेटा ट्रांसफ़र करने के लिए, निम्न cron job का उपयोग करें:
0 6 * * * scp /path/to/local/data.csv username@remote-server:/path/to/destination/ >> /path/to/logs/data_transfer.log 2>&1और जटिल रिमोट ऑपरेशनों के लिए, आप SSH को शेल स्क्रिप्ट्स के साथ संयोजित कर सकते हैं:
#!/bin/bash
# remote_etl.sh

# Run extraction on the data source server
ssh username@source-server 'python3 /path/to/extract.py'

# Transfer the extracted data to the processing server
scp username@source-server:/path/to/extracted_data.csv /local/temp/

# Run transformation locally
python3 /path/to/transform.py

# Transfer the transformed data to the warehouse server
scp /local/temp/transformed_data.csv username@warehouse-server:/path/to/data/

# Trigger the load process on the warehouse server
ssh username@warehouse-server 'python3 /path/to/load.py'
और फिर बस इसे cron से शेड्यूल कर दें:
0 7 * * * /path/to/remote_etl.sh >> /path/to/logs/remote_etl.log 2>&1यह तरीका आपको सीधे cron jobs से मल्टी-सर्वर डेटा पाइपलाइनों का ऑर्केस्ट्रेशन करने देता है। यह काम करता है, लेकिन बहुत जटिल वितरित वर्कफ़्लोज़ के लिए आप विशेष ऑर्केस्ट्रेशन टूल जैसे Apache Airflow या Prefect पर भी विचार कर सकते हैं।
सबसे अच्छी तरह से डिज़ाइन किए गए cron jobs भी यदि उचित ऑपरेशनल प्रथाओं के साथ लागू न हों, तो असफल हो सकते हैं या समस्याएँ पैदा कर सकते हैं.
एक डेटा इंजीनियर के रूप में, आपको सुनिश्चित करना चाहिए कि आपके शेड्यूल्ड टास्क विश्वसनीय रूप से चलें, असफल होने पर सहजता से संभलें, और ट्रबलशूटिंग के लिए पर्याप्त दृश्यता प्रदान करें। इस अनुभाग में, मैं आपको बताऊंगा कि ऐसा कैसे करें।
लॉगिंग उन स्वचालित प्रक्रियाओं के लिए अत्यंत महत्वपूर्ण है जो बिना प्रत्यक्ष निगरानी के चलती हैं। इनके बिना, cron jobs की समस्याओं का निदान करना लगभग असंभव हो जाता है।
बेसिक लॉगिंग सेट करने के लिए, आप स्टैंडर्ड आउटपुट और एरर संदेश दोनों को लॉग फ़ाइलों में रीडायरेक्ट कर सकते हैं:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/script.log 2>&1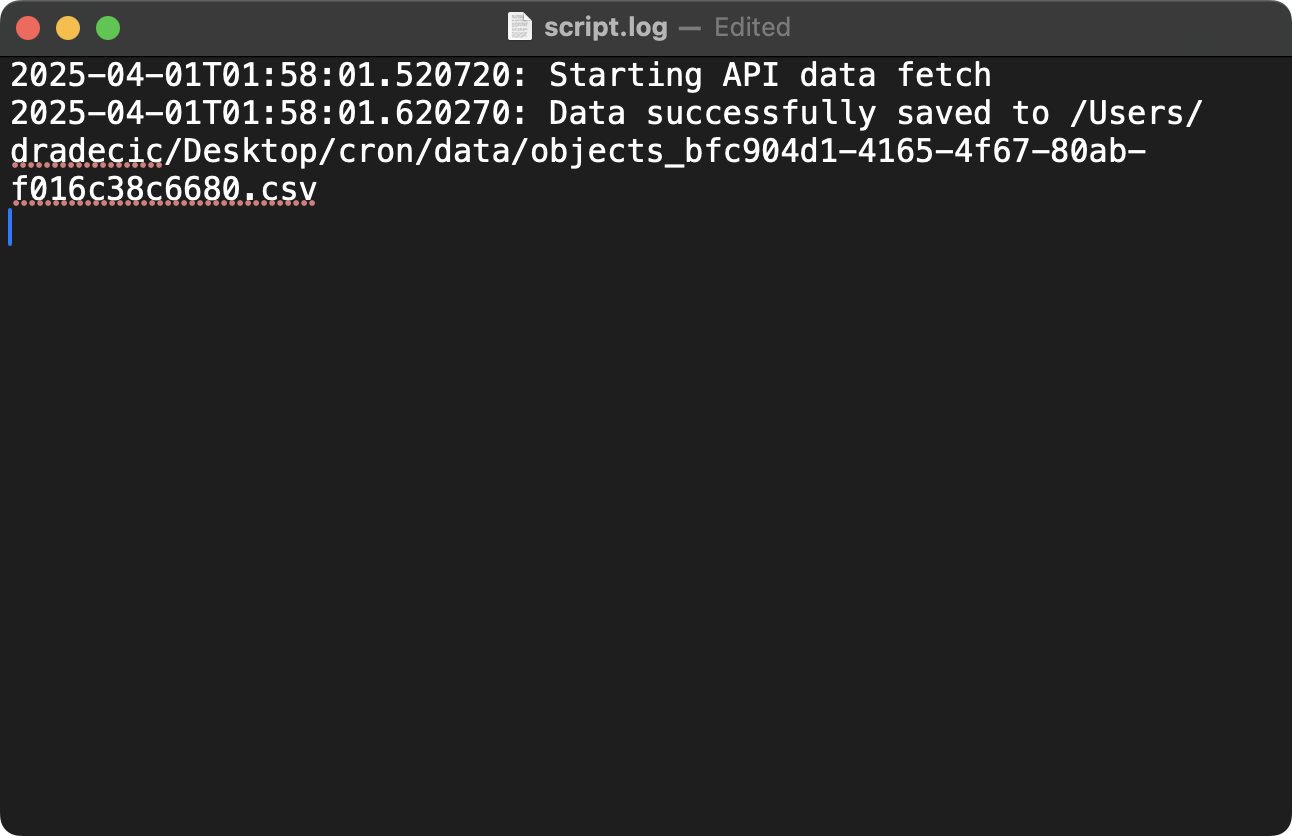
छवि 12 - Cron job लॉगिंग कॉन्फ़िगरेशन (1)
यह कमांड आपकी स्क्रिप्ट को हर मिनट चलाता है और सभी आउटपुट को लॉग फ़ाइल में जोड़ता है। >> ऑपरेटर आउटपुट को ओवरराइट करने के बजाय जोड़ता है, जबकि 2>&1 स्टैंडर्ड एरर (फ़ाइल डिस्क्रिप्टर 2) और स्टैंडर्ड आउटपुट (फ़ाइल डिस्क्रिप्टर 1) दोनों को एक ही लॉग फ़ाइल में रीडायरेक्ट करता है।
अधिक संरचित लॉगिंग के लिए, आप टाइमस्टैम्प और जॉब आइडेंटिफ़ायर जोड़ सकते हैं:
* * * * * (echo "=== Job started at $(date) ==="; /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py; echo "=== Job finished at $(date) with exit code $? ===") >> /Users/dradecic/Desktop/cron/logs/script.log 2>&1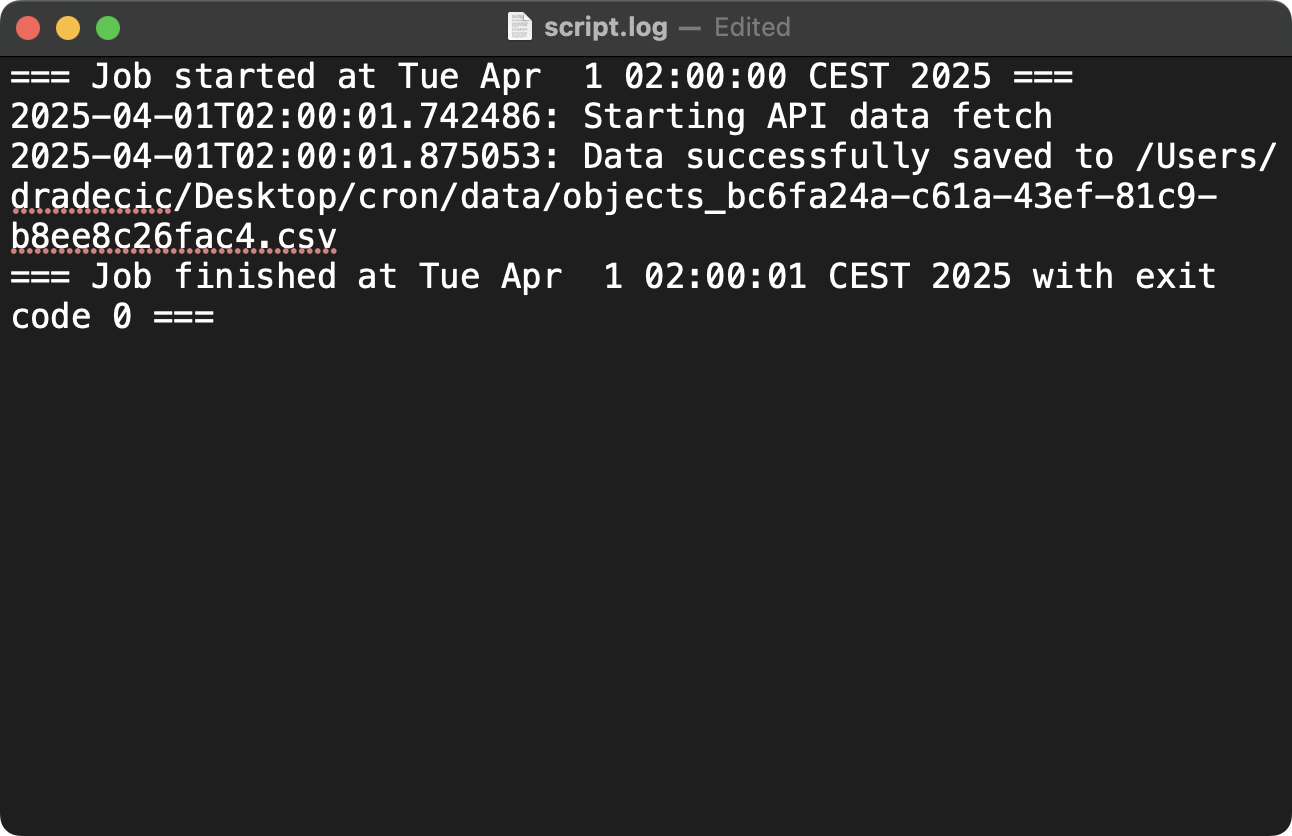
छवि 13 - Cron job लॉगिंग कॉन्फ़िगरेशन (2)
यह उन्नत कमांड आपकी स्क्रिप्ट चलाने से पहले टाइमस्टैम्प सहित एक स्पष्ट प्रारंभ मार्कर जोड़ता है और पूर्ण होने के बाद टाइमस्टैम्प व एग्ज़िट कोड दोनों के साथ एक अंत मार्कर जोड़ता है। कोष्ठक इन कमांड्स को समूहित करते हैं ताकि इनका सारा आउटपुट लॉग फ़ाइल में रीडायरेक्ट हो जाए। $? वेरिएबल हाल ही में निष्पादित कमांड का एग्ज़िट कोड रखता है, जो यह निर्धारित करने में मदद करता है कि स्क्रिप्ट सफल रही (एग्ज़िट कोड 0) या विफल (नॉन-ज़ीरो एग्ज़िट कोड)।
लॉग्स को अत्यधिक डिस्क स्पेस लेने से रोकने के लिए, आप लॉग रोटेशन लागू कर सकते हैं। अधिकांश Linux डिस्ट्रीब्यूशंस में उपलब्ध logrotate यूटिलिटी का उपयोग करें:
/etc/logrotate.d/cron-jobs पर एक कॉन्फ़िगरेशन फ़ाइल बनाएँ:
/path/to/logs/*.log {
    daily
    missingok
    rotate 14
    compress
    delaycompress
    notifempty
    create 0640 username groupname
}
यह कॉन्फ़िगरेशन सिस्टम को निम्न करने के लिए कहता है:
daily)missingok)rotate 14)compress)delaycompress)notifempty)create 0640 username groupname)सिस्टम की logrotate सेवा अपने आप इन सेटिंग्स को लागू करती है, जो आमतौर पर दिन में एक बार चलती है। जब यह चलती है, तो यह आपकी वर्तमान लॉग फ़ाइल का नाम बदल देती है (डेट वाला प्रत्यय जोड़कर), पुराने लॉग को कंप्रेस करती है, 14 दिन से पुराने लॉग हटाती है, और नई एंट्रियों के लिए एक ताज़ा लॉग फ़ाइल बनाती है।
मजबूत डेटा इंजीनियरिंग वर्कफ़्लो को विफलताओं को संभालने की रणनीतियों की ज़रूरत होती है। आप अपने स्क्रिप्ट्स या क्रॉन जॉब्स में रिट्राई लॉजिक जोड़ सकते हैं, या अपने क्रॉन जॉब्स को मॉनिटरिंग सिस्टम्स से जोड़ सकते हैं।
मैं इस सेक्शन में आपको इन सभी विकल्पों को लागू करना दिखाऊँगा।
बिल्ट-इन रिट्राई लॉजिक सीधे आपके Python स्क्रिप्ट्स में लागू किया जा सकता है, जैसे यह:
import time
import random

def fetch_data_with_retry(max_attempts=3, backoff_factor=1.5):
    attempt = 1
    while attempt <= max_attempts:
        try:
            # Try to fetch data
            return fetch_data()
        except Exception as e:
            print(f"Attempt {attempt} failed: {str(e)}")
            # Calculate backoff time with jitter
            backoff_time = backoff_factor ** (attempt - 1) * (random.uniform(0.8, 1.2))
            if attempt < max_attempts:
                print(f"Retrying in {backoff_time:.2f} seconds...")
                time.sleep(backoff_time)
            else:
                print("Max retry attempts reached. Giving up.")
                raise
        attempt += 1
यह Python फ़ंक्शन जिटर के साथ एक्सपोनेंशियल बैकऑफ़ स्ट्रेटेजी लागू करता है। यह ऐसे काम करता है:
max_attempts बार तक (डिफ़ॉल्ट 3) डेटा फ़ेच ऑपरेशन चलाने की कोशिश करता है।यह पैटर्न अस्थायी विफलताओं जैसे नेटवर्क समस्याओं या API रेट लिमिट्स को संभालने के लिए आदर्श है। प्रतीक्षा समय में एक्सपोनेंशियल बढ़ोतरी बाहरी सिस्टम को उबरने का समय देती है, जबकि जिटर "थंडरिंग हर्ड" समस्याओं को रोकता है।
क्रॉन-आधारित रिट्राई भी एक व्यावहारिक विकल्प है। आप आवश्यकतानुसार उससे अधिक आवृत्ति पर शेड्यूलिंग करके विफल जॉब्स को दोबारा आजमा सकते हैं।
यहाँ एक उदाहरण है जिसमें मैंने दो क्रॉन जॉब सेटअप किए हैं:
success_flag फ़ाइल बनाई जाती है, जो 10 मिनट में स्क्रिप्ट के दोबारा चलने से रोकती है।*/10 * * * * [ ! -f /path/to/success_flag ] && python /path/to/script.py && touch /path/to/success_flag
0 0 * * * rm -f /path/to/success_flag उपरोक्त सेटअप समझने में कठिन लग सकता है, तो आइए एक बार फिर चरण-दर-चरण देखते हैं:
[ ! -f /path/to/success_flag ])/path/to/script.py)touch /path/to/success_flag)0 0 * * *) और success flag हटा देता है, जिससे प्रक्रिया अगले दिन फिर से चल सके।यह तकनीक उन कार्यों के लिए उपयोगी है जिन्हें दिन में एक बार पूरा होना चाहिए लेकिन अस्थायी रूप से असफल हो सकते हैं। जॉब दिन भर कोशिश करता रहता है जब तक कि वह एक बार सफल न हो जाए।
मॉनिटरिंग इंटीग्रेशन आपको अपने क्रॉन जॉब्स को Prometheus जैसे मॉनिटरिंग सिस्टम्स से जोड़ने देता है। यह स्वयं में एक विषय है, इसलिए मैं यहाँ केवल उच्च-स्तरीय अवलोकन दूँगा।
नीचे दिखाया गया स्क्रिप्ट आपके वास्तविक जॉब के चारों ओर एक रैपर है जो मेट्रिक्स इकट्ठा करता है और Prometheus को रिपोर्ट करता है। स्क्रिप्ट निम्न चरण करता है:
#!/bin/bash
# monitored_job.sh

# Define pushgateway URL
PUSHGATEWAY="http://prometheus-pushgateway:9091"

# Start time in seconds
START_TIME=$(date +%s)

# Run the actual job
/path/to/actual_job.sh
EXIT_CODE=$?

# End time in seconds
END_TIME=$(date +%s)
DURATION=$((END_TIME - START_TIME))

# Push metrics to Prometheus
cat <<EOF | curl --data-binary @- ${PUSHGATEWAY}/metrics/job/cron_job/instance/$(hostname)
# HELP cron_job_duration_seconds How long the cron job took to execute
# TYPE cron_job_duration_seconds gauge
cron_job_duration_seconds{name="data_extraction"} ${DURATION}

# HELP cron_job_exit_code Exit code of the cron job
# TYPE cron_job_exit_code gauge
cron_job_exit_code{name="data_extraction"} ${EXIT_CODE}

# HELP cron_job_last_run_timestamp Timestamp of last job run
# TYPE cron_job_last_run_timestamp gauge
cron_job_last_run_timestamp{name="data_extraction"} ${END_TIME}
EOF

exit ${EXIT_CODE}
ये मेट्रिक्स आपको सक्षम बनाते हैं:
Pushgateway मध्यस्थ के रूप में काम करता है, जिससे अल्पकालिक क्रॉन जॉब अपने मेट्रिक्स Prometheus को पुश कर सकता है, जो बाद में उन्हें अलर्टिंग और विज़ुअलाइज़ेशन के लिए संग्रहीत करता है।
टाइम ज़ोन से जुड़ी समस्याएँ डेटा इंजीनियरिंग में आम चुनौतियाँ हैं, खासकर जब वैश्विक डेटा स्रोतों या वितरित सिस्टम्स से निपटते हैं।
जैसा आप अपेक्षा करेंगे, क्रॉन जॉब्स टाइम ज़ोन सेटिंग्स के प्रति संवेदनशील होते हैं।
डिफ़ॉल्ट रूप से, क्रॉन सिस्टम के लोकल टाइम ज़ोन का उपयोग करता है। आप इस Linux कमांड से अपने सिस्टम का टाइम ज़ोन जाँच सकते हैं:
timedatectlऊपर दिया कमांड आपके सिस्टम का वर्तमान समय और टाइम ज़ोन कॉन्फ़िगरेशन दिखाता है। यदि आपका सर्वर America/New_York जैसे किसी लोकल टाइम ज़ोन का उपयोग करने के लिए कॉन्फ़िगर है, तो सभी क्रॉन शेड्यूल उसी टाइम ज़ोन में इंटरप्रेट होंगे।
सर्वर लोकेशन या डे-लाइट सेविंग में बदलावों से बेपरवाह होकर सुसंगत शेड्यूलिंग सुनिश्चित करने के लिए, अपने क्रॉन जॉब्स में UTC का उपयोग करें:
# Set the CRON_TZ environment variable at the top of your crontab
CRON_TZ=UTC

# Now all job schedules will use UTC
0 0 * * * /path/to/daily_job.sh
अपनी crontab फ़ाइल के शीर्ष पर CRON_TZ=UTC लाइन जोड़कर, आप क्रॉन को लोकल समय के बजाय सभी समय विनिर्देशों को UTC में इंटरप्रेट करने के लिए बताते हैं।
इसका अर्थ है कि जॉब हर दिन आधी रात UTC पर चलेगा, चाहे सर्वर का लोकल टाइम ज़ोन या डे-लाइट सेविंग में बदलाव कुछ भी हों। UTC (Coordinated Universal Time) डे-लाइट सेविंग के लिए कभी नहीं बदलता, जो सभी स्थानों पर एक सुसंगत संदर्भ बिंदु प्रदान करता है।
यदि आप डेटा इंजीनियर हैं, तो क्रॉन जॉब्स एक अमूल्य उपकरण हैं।
वे दोहराए जाने वाले कार्यों को स्वचालित करने और भरोसेमंद डेटा पाइपलाइंस बनाने में आपकी मदद कर सकते हैं। वे स्क्रिप्ट्स को शेड्यूल करने और बहु-चरणीय ETL प्रक्रियाओं के जटिल ऑर्केस्ट्रेशन को करने का एक सुसंगत और शक्तिशाली तरीका प्रदान करते हैं। सिंटैक्स की आदत डालने में थोड़ा समय लगेगा, लेकिन कुछ दिनों बाद यह स्वाभाविक लगने लगेगा।
जब आप अपने डेटा इंजीनियरिंग कार्य में क्रॉन जॉब्स लागू करें, तो लॉगिंग, त्रुटि प्रबंधन, और टाइम ज़ोन मैनेजमेंट से संबंधित सर्वोत्तम प्रथाओं का पालन करना याद रखें। उपयुक्त लॉगिंग आपको जॉब निष्पादन में विज़िबिलिटी देती है और ट्रबलशूटिंग को सरल बनाती है। रिट्राई मैकेनिज़्म के साथ अच्छी त्रुटि हैंडलिंग तकनीकें सुनिश्चित करती हैं कि आपकी पाइपलाइंस अस्थायी विफलताओं से उबर सकें। सावधानीपूर्वक टाइम ज़ोन मैनेजमेंट आपके शेड्यूल को सुसंगत रखता है, खासकर जब आप वैश्विक डेटा स्रोतों या वितरित टीमों के साथ काम कर रहे हों।
>क्या आप 2025 में एक डेटा इंजीनियर के रूप में नौकरी पाना चाहते हैं क्या? ये 5 आवश्यक कौशल आपके पास होने चाहिए।
सही है, विशेषीकृत वर्कफ़्लो ऑर्केस्ट्रेशन टूल जैसे Apache Airflow या Prefect जटिल डेटा पाइपलाइंस के लिए अधिक उन्नत फीचर्स देते हैं, लेकिन कई डेटा इंजीनियरिंग कार्यों के लिए क्रॉन अब भी प्रासंगिक है। यह उपयोग में सरल, भरोसेमंद और कम ओवरहेड वाला है—जो इसे ऑटोमेशन जरूरतों के लिए उपयुक्त बनाता है।
डेटा इंजीनियरिंग के बारे में और जानने के लिए, DataCamp के इन पाठ्यक्रमों में नामांकन करें:
इन पाठ्यक्रमों के साथ डेटा इंजीनियरिंग के बारे में और जानें!
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें