
Corso
Introduzione ad Apache Airflow in Python
4 ore
65K
Se ti ritrovi spesso a gestire manualmente attività ricorrenti, sai che non è solo noioso: è una ricetta per scadenze mancate e pipeline di dati incoerenti.
I cron job sono la soluzione di riferimento per automatizzare compiti ripetitivi sui sistemi basati su Unix. Ti permettono di pianificare l’esecuzione di comandi o script a intervalli specifici. Sfruttando il sistema di pianificazione semplice e flessibile di cron, puoi automatizzare tutto, dalla raccolta dati di base a complessi workflow ETL che altrimenti richiederebbero interventi manuali continui. Configurare questi processi automatici elimina l’errore umano e fa sì che le tue pipeline di dati girino in modo costante e affidabile.
Padroneggiare i cron job è essenziale per chiunque faccia data engineering in ambienti Unix. La semplice capacità di pianificare e gestire attività automatiche migliorerà il tuo workflow di un ordine di grandezza e ridurrà i costi di manutenzione.
In questa guida completa ti mostrerò tutto ciò che devi sapere sui cron job per il data engineering: dalla configurazione di base ai casi d’uso avanzati e alle best practice.
>Sei completamente nuovo al Data Engineering? Il nostro corso fa chiarezza sui buzzword e spiega i concetti.
Un cron job è un pianificatore basato sul tempo nei sistemi operativi Unix che ti consente di eseguire automaticamente comandi a orari, date o intervalli fissi.
Pensa a cron come al tuo assistente personale che esegue i task esattamente quando vuoi, senza intervento manuale. Per i data engineer, significa poter automatizzare backup di database, trasferimenti di dati, generazione di report e molto altro.
I cron job vivono in un semplice file di testo chiamato "crontab" (cron table). Ogni riga di questo file rappresenta un’attività pianificata e segue un formato specifico con sei componenti:
* * * * * command-to-execute
│ │ │ │ │
│ │ │ │ └─── Day of week (0-6, where 0 is Sunday)
│ │ │ └───── Month (1-12)
│ │ └─────── Day of month (1-31)
│ └───────── Hour (0-23)
└─────────── Minute (0-59)
I primi cinque campi dicono a cron esattamente quando eseguire il comando. Puoi usare valori specifici, intervalli (come 1-5), liste (come 1, 3, 5) o asterischi (*) che significano "ogni" unità di tempo. Il sesto componente è il comando che vuoi eseguire.
Per esempio, se vuoi eseguire ogni giorno a mezzanotte uno script Python per estrarre dati da un’API, il tuo cron job sarà così:
0 0 * * * /usr/bin/python3 /home/username/scripts/extract_data.pyQuesto dice a cron di eseguire lo script al minuto 0, ora 0 (mezzanotte), ogni giorno del mese, ogni mese e ogni giorno della settimana. Il percorso assoluto sia per l’interprete Python sia per lo script fa sì che il job giri correttamente a prescindere dall’ambiente.
Puoi creare anche pianificazioni più complesse. Diciamo che vuoi eseguire una pulizia del database ogni lunedì, mercoledì e venerdì alle 15:30; l’espressione cron sarà:
30 15 * * 1,3,5 /path/to/cleanup_script.shOgni asterisco agisce come un jolly e ti consente di creare pianificazioni flessibili in base alle tue esigenze. Puoi anche usare scorciatoie come @daily, @weekly o @monthly per rendere più leggibili i pattern comuni.
Questo è tutto per le basi. Subito dopo, ti mostrerò in pratica come lavorare con i cron job per i task di data engineering.
Ora che sai cos’è un cron job, configuriamo il tuo primo task automatico. Il processo è lineare e richiede solo pochi comandi per iniziare.
Per creare o modificare cron job, devi accedere al tuo file crontab. Puoi farlo con il comando crontab -e:
crontab -e
Immagine 1 - Modifica di un file crontab
Il comando precedente apre l’editor di testo vi, nel quale puoi aggiungere, modificare o rimuovere task pianificati.
Il tuo file crontab potrebbe essere vuoto se non lo hai mai usato. Per aggiungere un nuovo cron job, inserisci semplicemente una nuova riga seguendo la sintassi di cron che ho spiegato prima. Ogni riga deve includere sia la pianificazione temporale sia il comando da eseguire.
Per esempio, per eseguire uno script ogni giorno alle 3:00, aggiungi questa riga:
0 3 * * * /path/to/your/commandSalva il file ed esci dall’editor. Cron installerà automaticamente il nuovo crontab e inizierà a eseguire i job agli orari specificati.
Partiamo da un esempio pratico: pianificare uno script Python che recupera dati da un’API ogni minuto. Ecco uno script Python completo che si connette a un endpoint REST API, recupera dati di oggetti e li salva in un file CSV — assicurati solo che l’interprete Python abbia i pacchetti requests e pandas installati:
# fetch_api_data.py

import requests
import pandas as pd
import os
from datetime import datetime

# Create a timestamp for the filename
timestamp = datetime.now().strftime("%Y%m%d_%H%M%S")

# Set file paths - CHANGE THIS
data_dir = "/Users/dradecic/Desktop/cron/data"
output_file = f"{data_dir}/objects_{timestamp}.csv"

# Make sure the data directory exists
os.makedirs(data_dir, exist_ok=True)

# Fetch data from the API
try:
    response = requests.get("https://jsonplaceholder.typicode.com/posts")
    if response.status_code == 200:
        data = response.json()

        # Check if we have data
        if data:
            df = pd.DataFrame([
                {
                    "id": row.get("id", ""),
                    "user_id": row.get("userId", ""),
                    "title": row.get("title", ""),
                    "body": row.get("body", "")
                } for row in data
            ])

            df.to_csv(output_file, index=False)

            print(f"Data successfully saved to {output_file}")
        else:
            print("API returned empty data")
    else:
        print(f"API request failed with status code: {response.status_code}")
except Exception as e:
    print(f"Error occurred: {str(e)}")
Ora, per pianificare questo script con cron in modo che giri ogni giorno alle 2:00:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py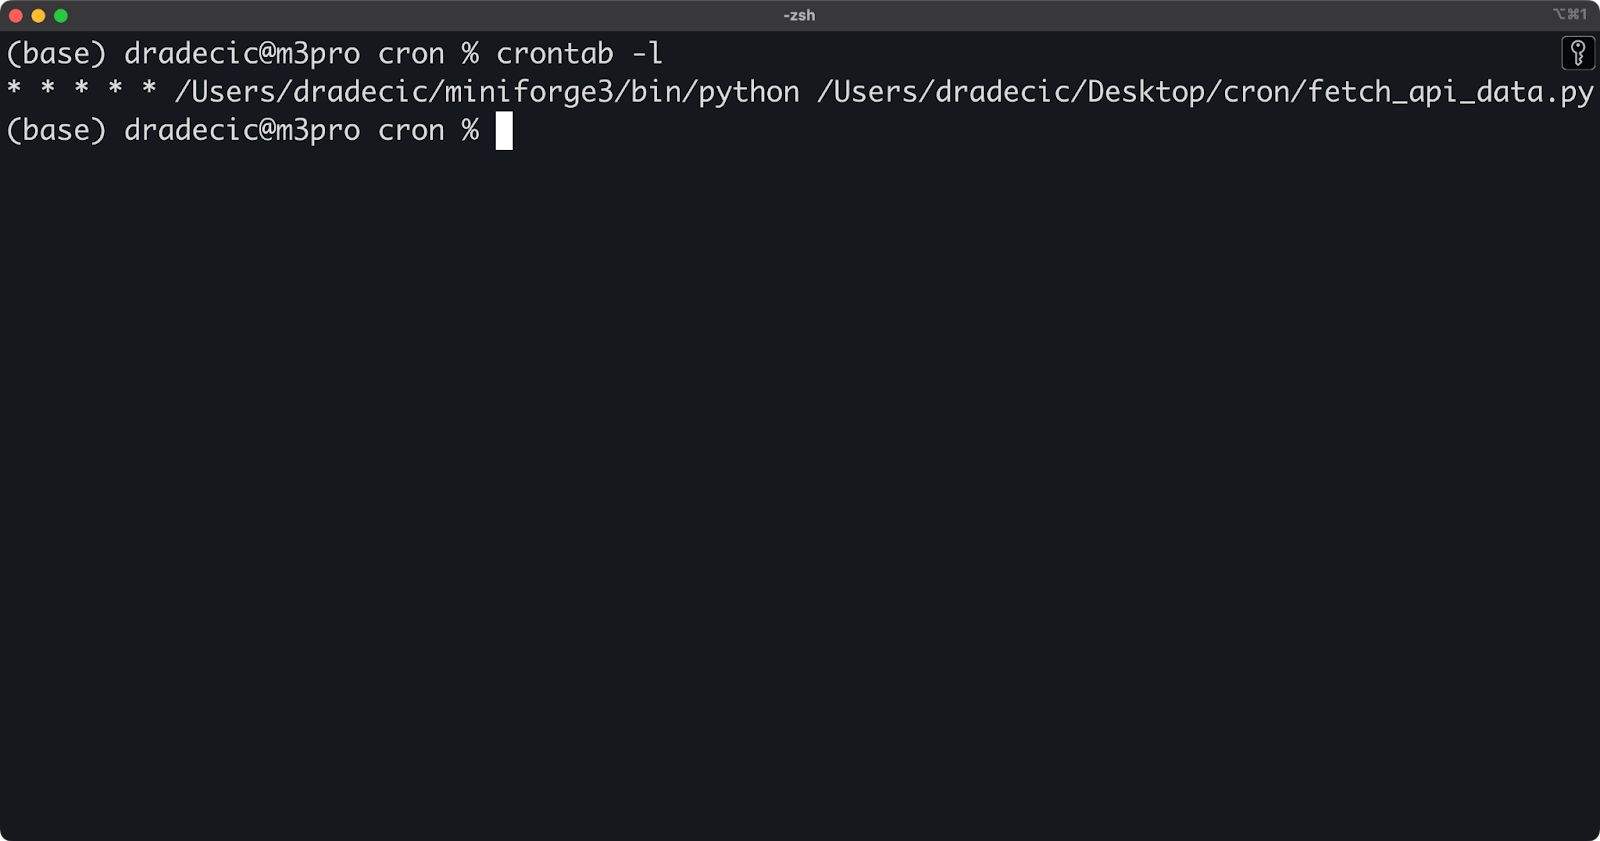
Immagine 2 - Elenco dei crontab attivi
Questa riga dice a cron di eseguire lo script Python ogni minuto di ogni giorno. Assicurati di usare percorsi assoluti sia per l’interprete Python (/Users/dradecic/miniforge3/bin/python nel mio caso) sia per il tuo script (/Users/dradecic/Desktop/cron/fetch_api_data.py nel mio caso).
Perché i percorsi assoluti? Cron gira con un ambiente limitato, quindi non conosce la variabile PATH della tua shell o la directory corrente. Il job potrebbe fallire senza percorsi assoluti perché cron non trova i comandi o i file che vuoi usare.
Mentre leggevi, un paio di file CSV sono stati salvati nella mia cartella data, il che indica che questo cron job funziona come promesso:
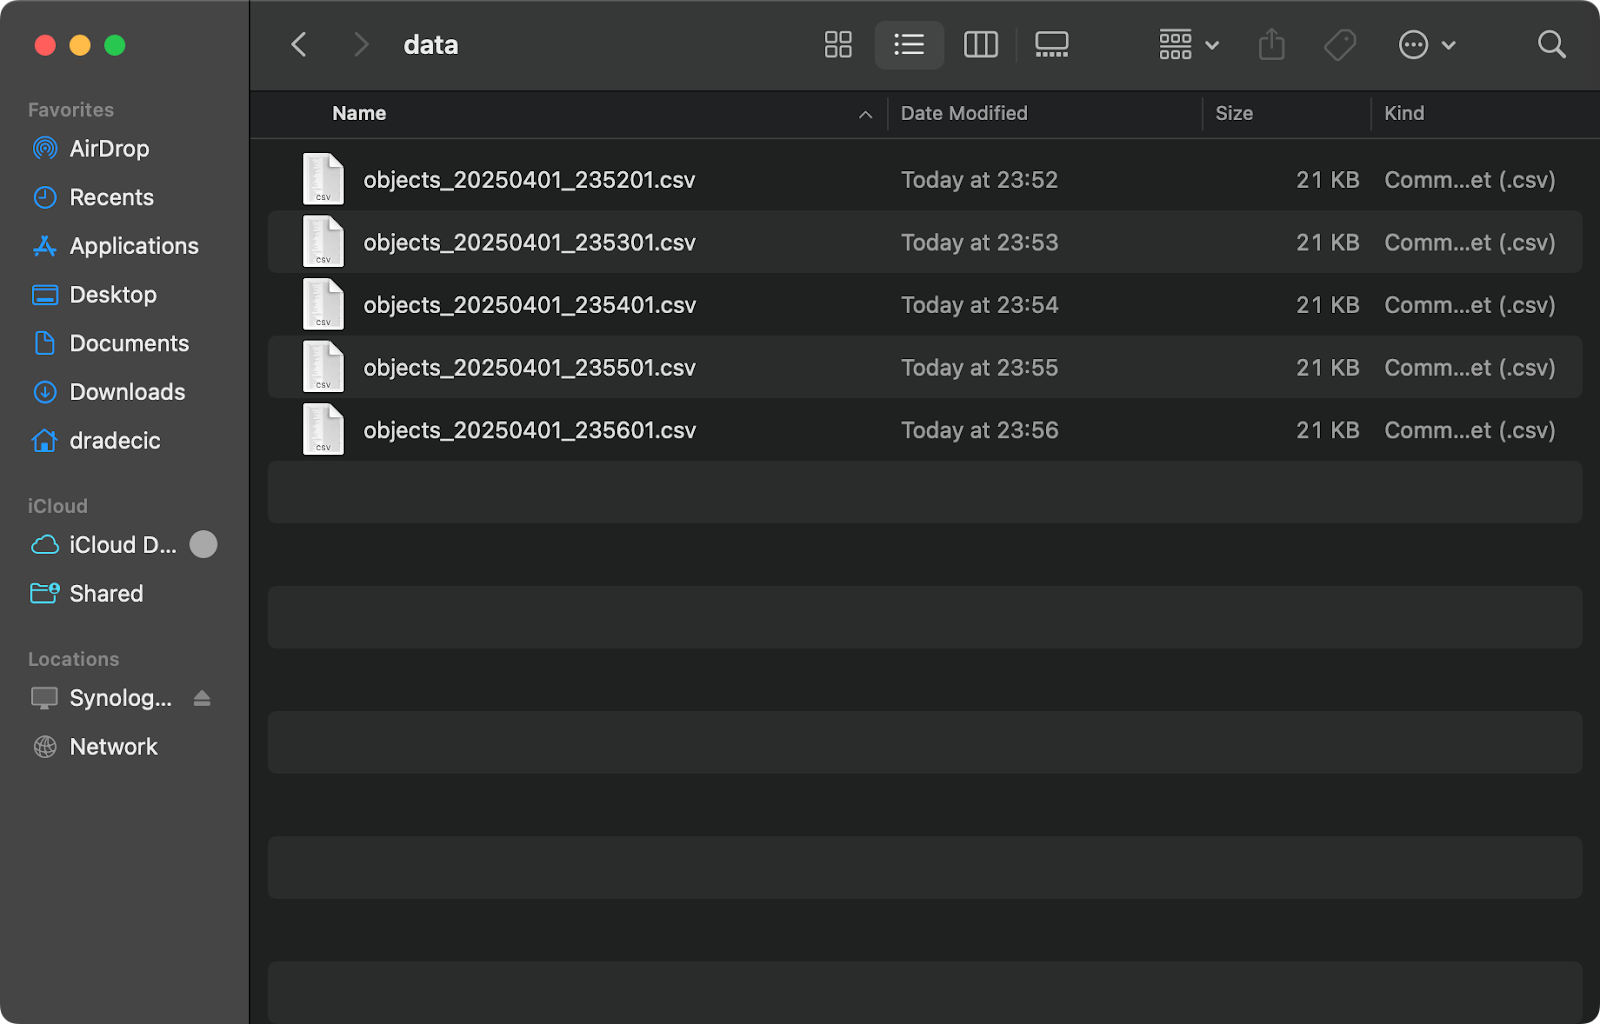
Immagine 3 - File CSV salvati
Per workflow di data engineering più complessi come ETL (Extract, Transform, Load), puoi usare cron per pianificare processi multi-step. Un approccio comune è creare uno script shell che contenga tutti i passaggi ETL, quindi pianificare quello script con cron.
Per semplicità, il codice che vedrai nello script .sh sottostante è solo teorico e non si collega a sorgenti dati reali:
#!/bin/bash
# etl_pipeline.sh

# Extract data from source
/usr/bin/psql -U username -d source_db -c "COPY (SELECT * FROM source_table) TO '/tmp/extracted_data.csv' WITH CSV HEADER;"

# Transform data
/usr/bin/python3 /home/username/scripts/transform_data.py

# Load data into target
/usr/bin/psql -U username -d target_db -c "\COPY target_table FROM '/tmp/transformed_data.csv' WITH CSV HEADER;"

# Log completion
echo "ETL job completed at $(date)" >> /home/username/logs/etl_job.log
Fatto ciò, vorrai rendere eseguibile lo script shell:
chmod +x /home/username/scripts/etl_pipeline.shInfine, pianificalo con cron per eseguirlo, diciamo, ogni giorno feriale all’1:00:
0 1 * * 1-5 /home/username/scripts/etl_pipeline.shSe sei un data engineer, pianificare task ETL con cron offre questi vantaggi:
Per processi ETL più grandi, potresti voler aggiungere gestione degli errori ai tuoi script:
#!/bin/bash
# etl_pipeline.sh

# Set error handling
set -e  # Exit immediately if any command fails

# Execute ETL steps
# ...

# If we get here, all steps succeeded
echo "ETL job completed successfully at $(date)" >> /home/username/logs/etl_job.log
E questo è tutto! La tua pipeline ETL girerà automaticamente agli orari pianificati, elaborerà i dati e registrerà lo stato per il monitoraggio.
Una volta impostati i cron job, devi gestirli e monitorarli per assicurarti che girino come previsto.
Per questo intendo controllare quali job sono attualmente pianificati, rimuovere quelli obsoleti e monitorarne l’esecuzione. Questa sezione ti mostrerà comandi e tecniche essenziali per mantenere i cron job senza stress.
Per vedere tutti i cron job attualmente pianificati, usa il comando crontab -l:
crontab -lIl comando sopra mostra il contenuto del tuo file crontab corrente, con tutti i job pianificati, inclusi tempi e comandi. È un modo rapido per verificare quali job sono attivi senza entrare in modalità modifica.
Questo è l’aspetto dell’output se hai seguito la sezione precedente dell’articolo:
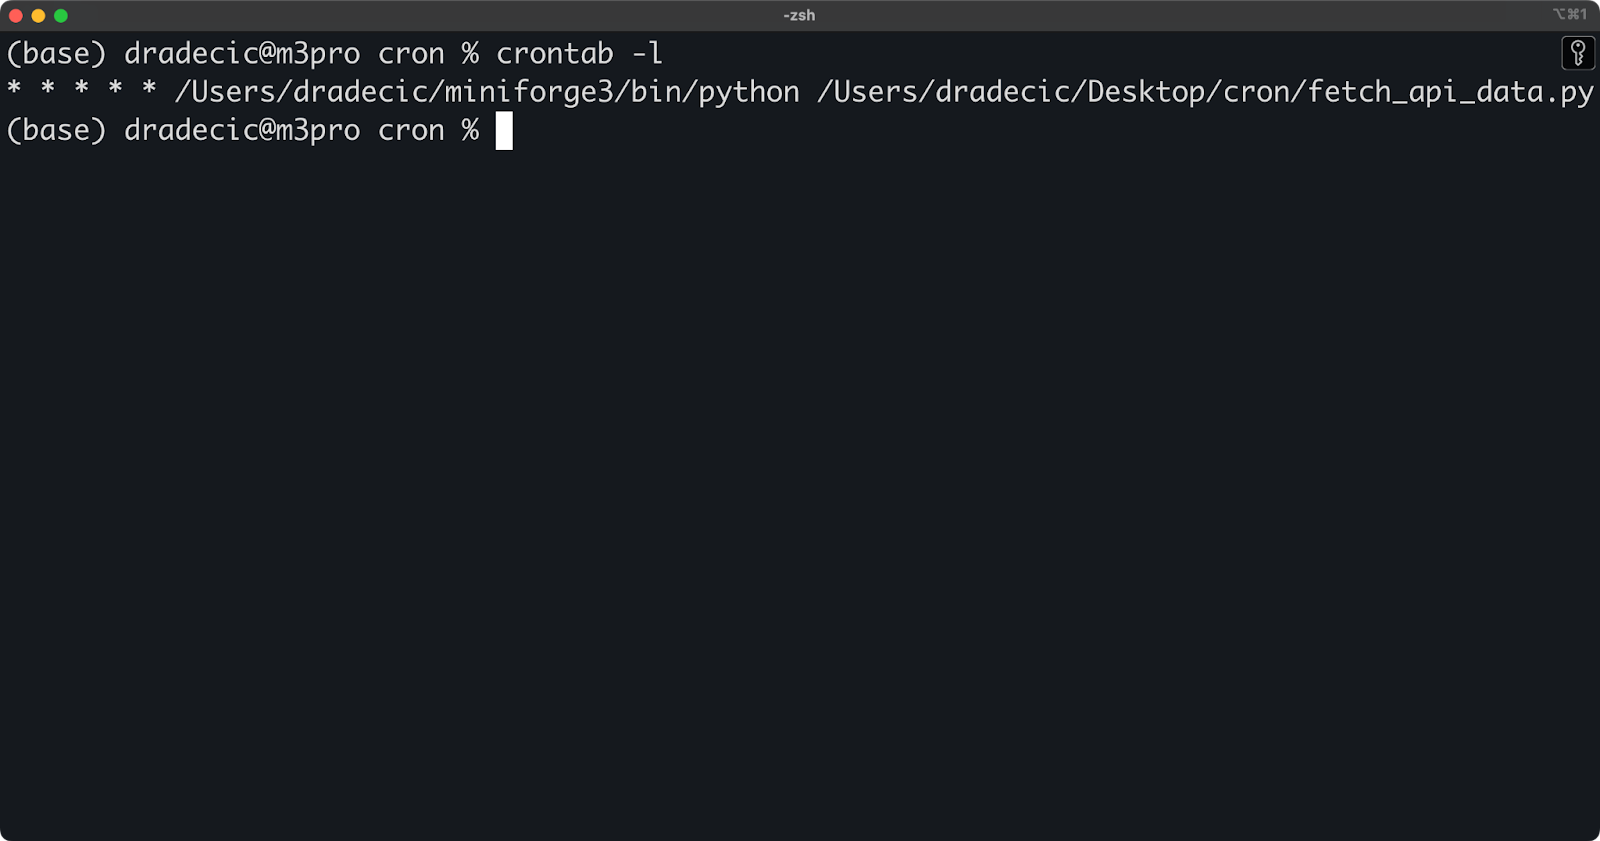
Immagine 4 - Cron job attivi
Se devi controllare i cron job di un altro utente (richiede accesso root), esegui invece questo comando:
sudo crontab -u username -lCi sono vari modi per rimuovere o disabilitare i cron job quando non servono più. Per rimuovere un job specifico, apri il tuo crontab in modalità modifica ed elimina la riga corrispondente:
crontab -ePer disabilitare temporaneamente un job senza eliminarlo, commenta la riga aggiungendo un # all’inizio:
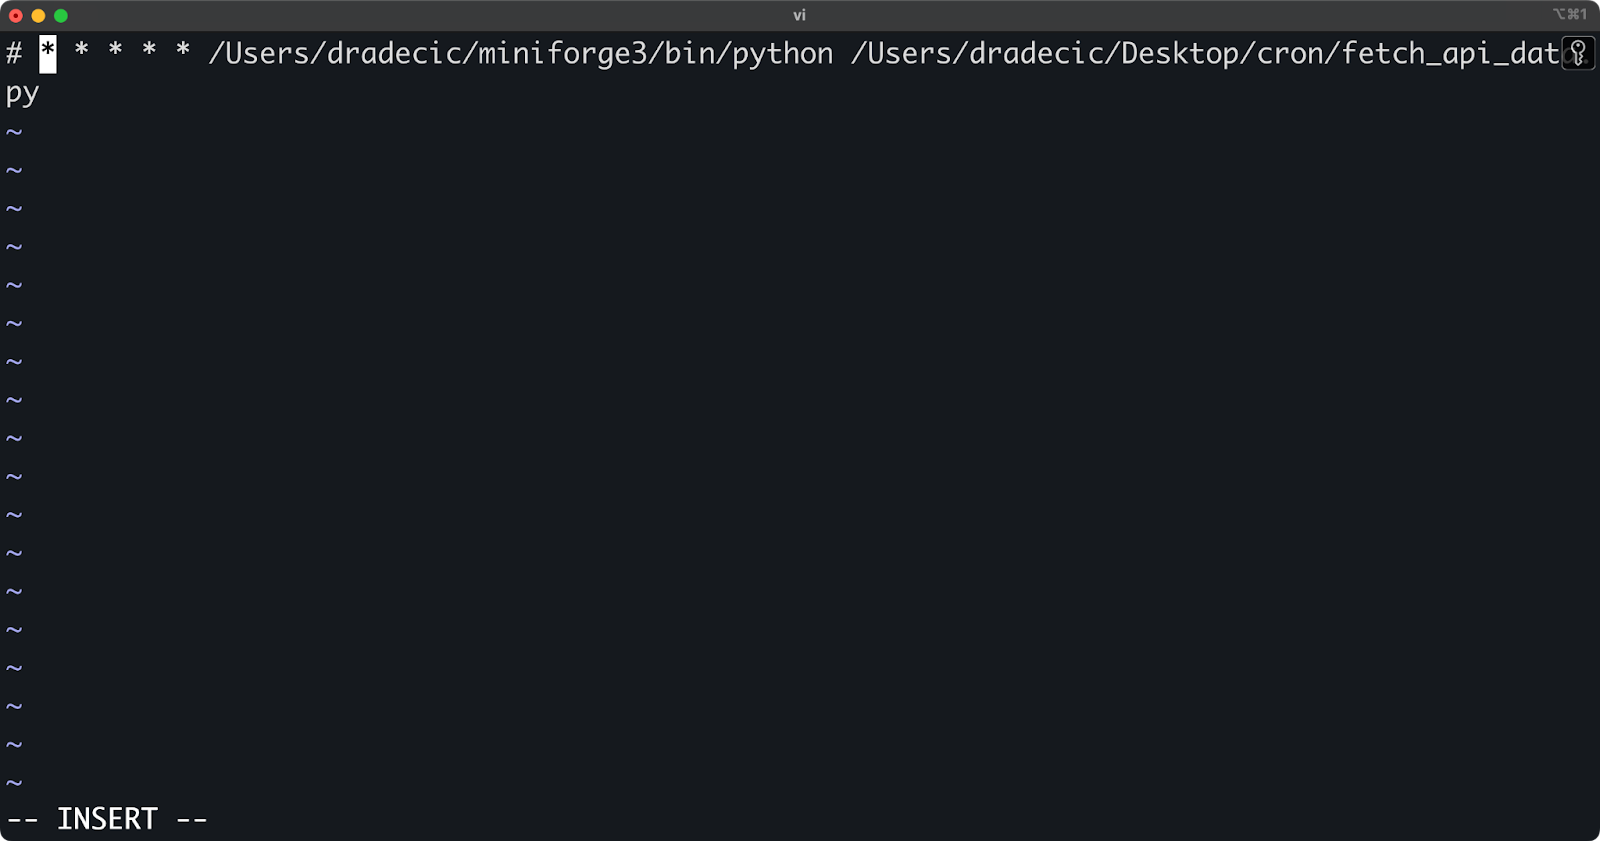
Immagine 5 - Disabilitare temporaneamente un cron job
Il job commentato rimane nel tuo crontab per riferimento futuro ma non verrà eseguito secondo la pianificazione definita.
Se vuoi rimuovere l’intero crontab (tutti i job), usa l’opzione -r:
crontab -r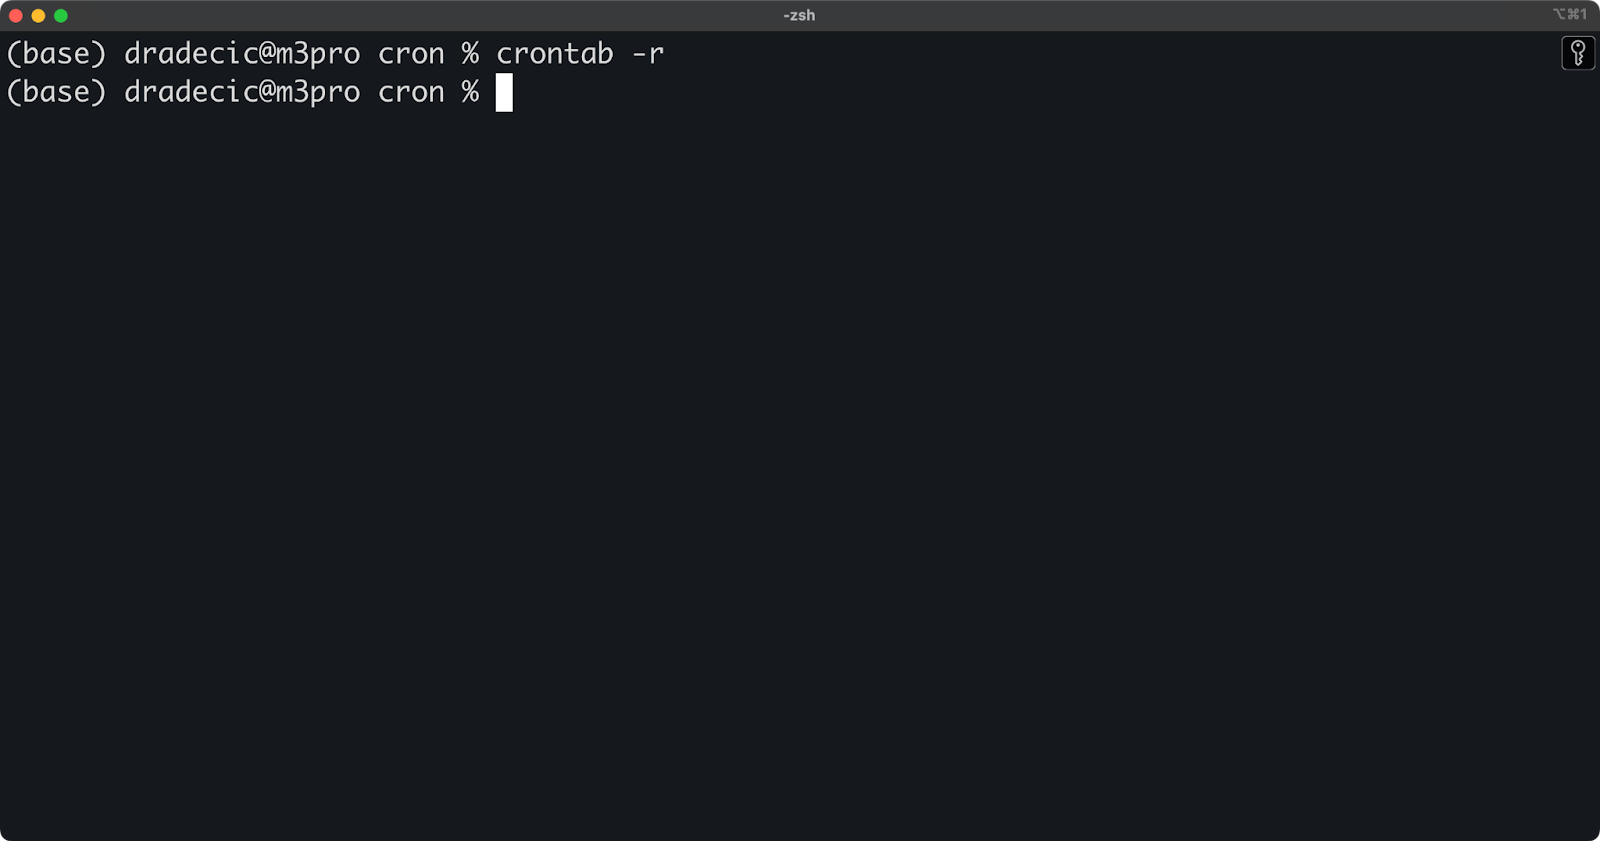
Immagine 6 - Eliminazione dell’intero crontab
Fai attenzione con questo comando: rimuove tutti i job pianificati senza conferma. Per evitare eliminazioni accidentali, puoi prima fare un backup del tuo crontab:
crontab -l > my_crontab_backupQuesto salva il crontab corrente in un file che puoi usare per ripristinare i job se necessario:
crontab my_crontab_backup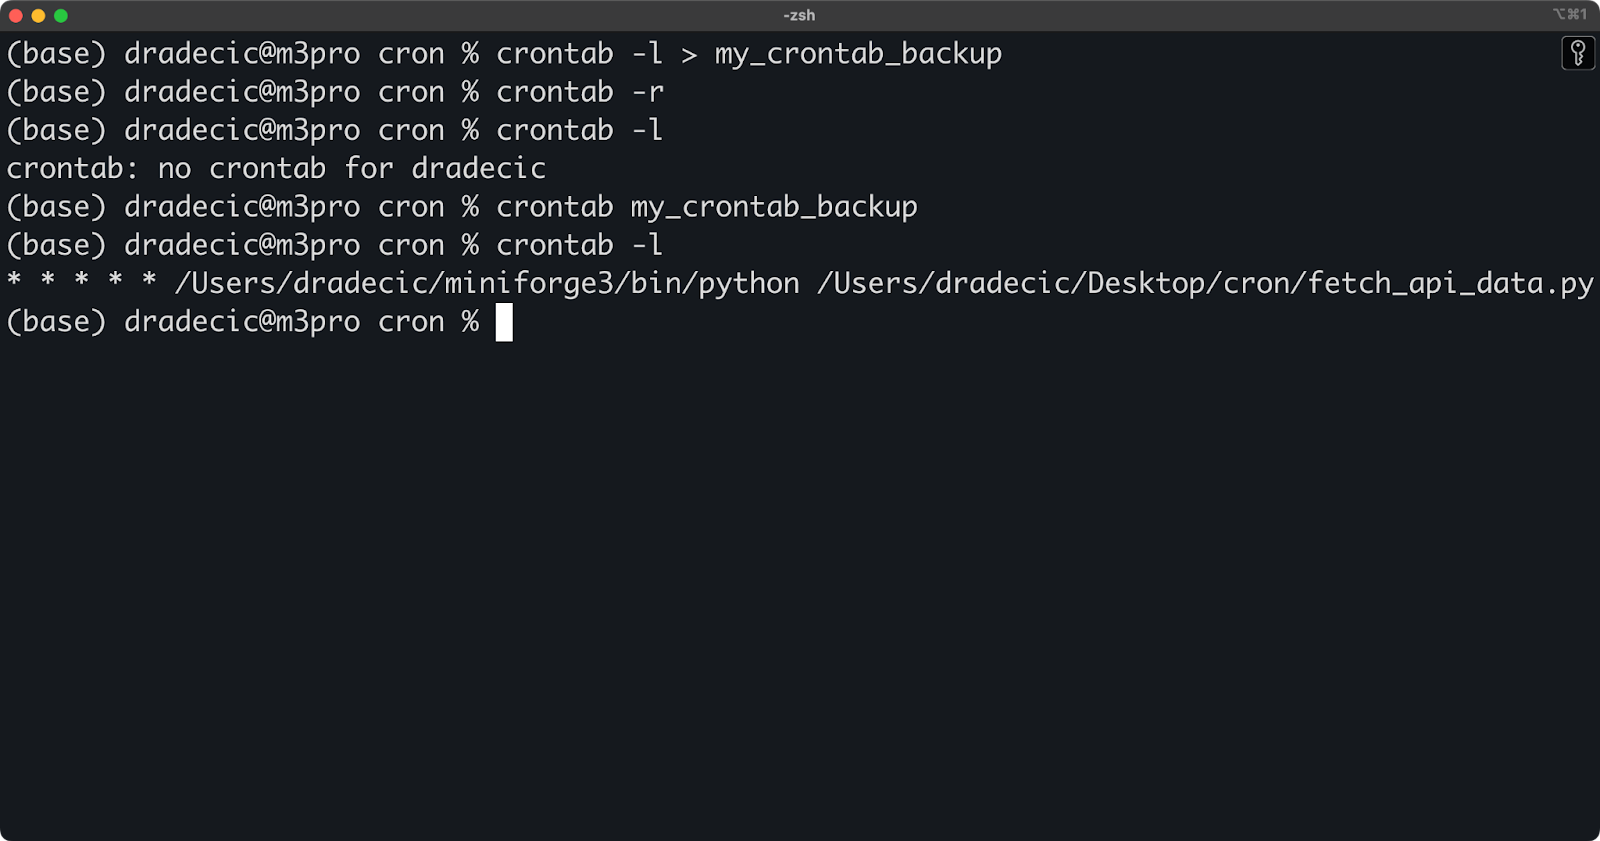
Immagine 7 - Ripristino di un crontab da backup
Per impostazione predefinita, cron tenta di inviare via email l’output dei job all’utente proprietario del crontab. Tuttavia, ciò richiede un sistema di posta correttamente configurato, che non sempre è disponibile. In alternativa, puoi reindirizzare l’output su file di log per un tracciamento e un troubleshooting più semplici.
Per catturare sia l’output standard sia i messaggi di errore, usa questa sintassi di redirezione:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1Questa redirezione può sembrare intimidatoria all’inizio, quindi te la spiego:
>> aggiunge l’output alla fine del file specificato.2>&1 reindirizza stderr (messaggi di errore) nella stessa posizione di stdout (output standard).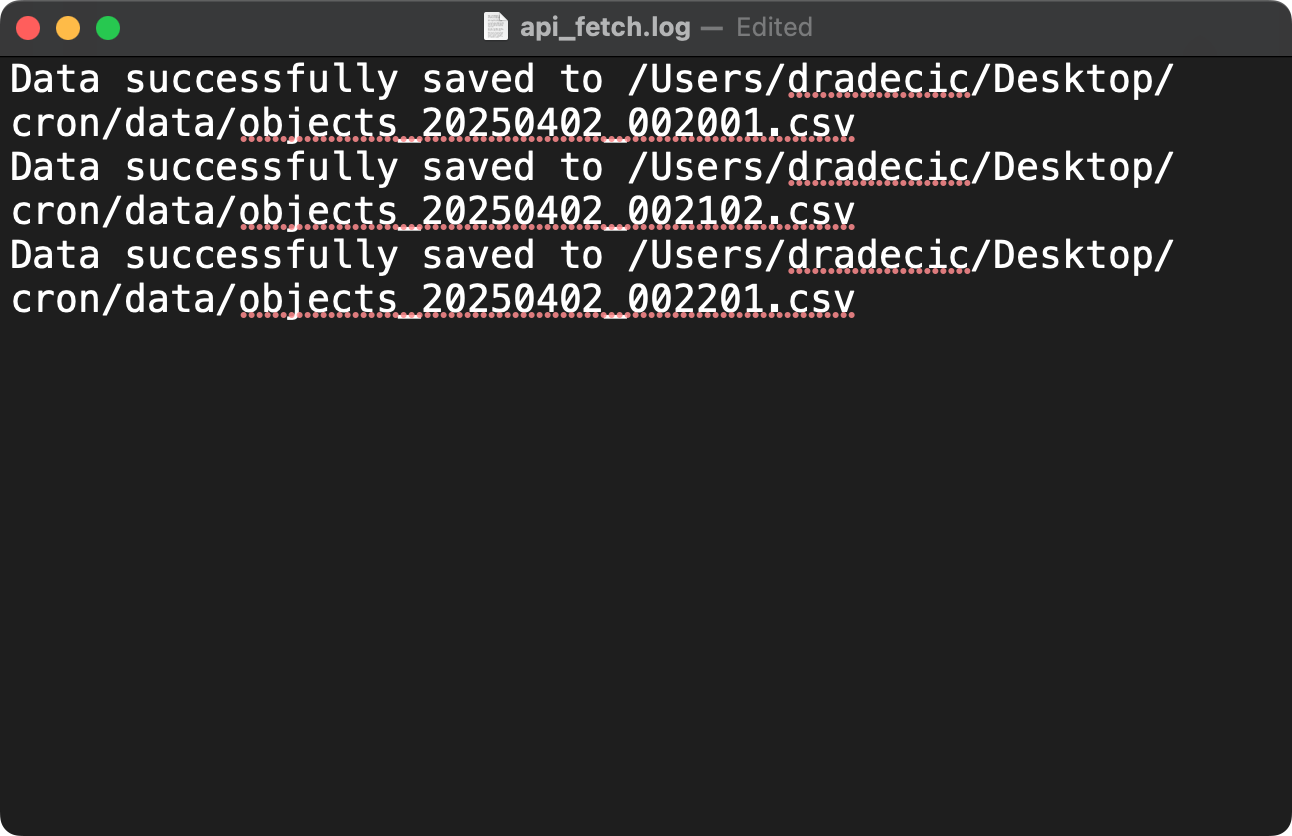
Immagine 8 - Cattura dei log dei cron job
Per una migliore gestione dei log, puoi aggiungere timestamp alle voci di log:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1 && echo "Job completed at $(date)" >> /Users/dradecic/Desktop/cron/logs/api_fetch.log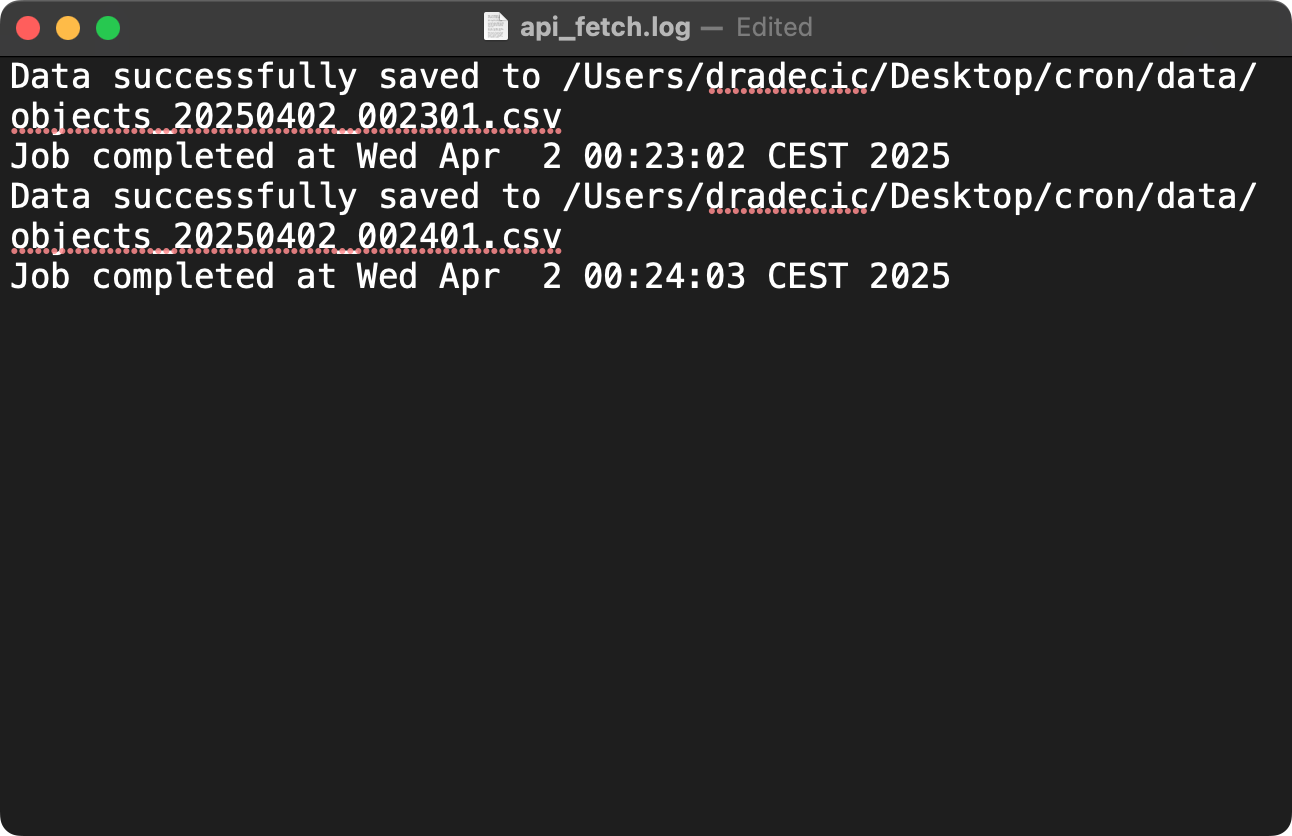
Immagine 9 - Cattura dei log dei cron job con timestamp
Se vuoi file di log separati per output normale ed errori, usa:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>> /Users/dradecic/Desktop/cron/logs/api_fetch_errors.log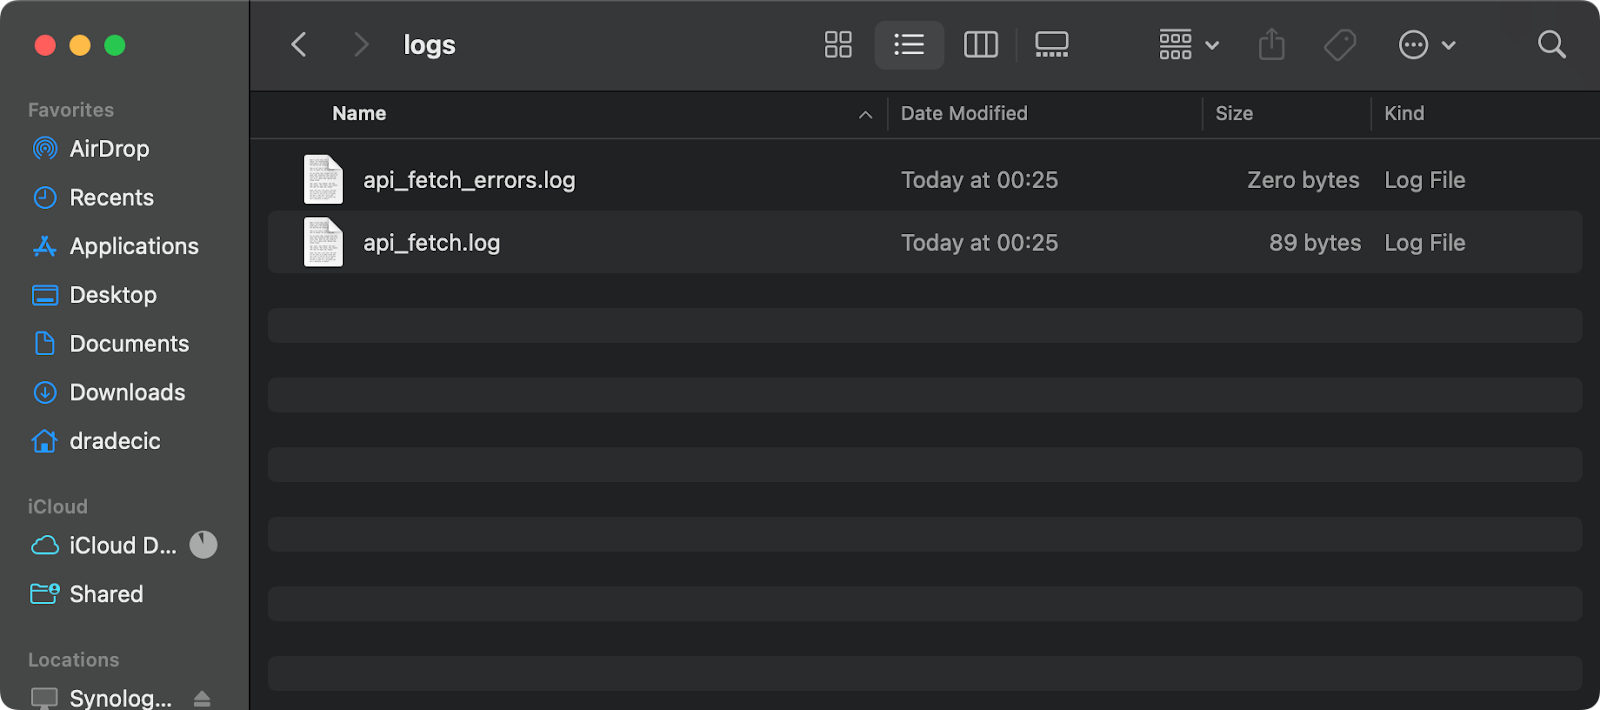
Immagine 10 - File di log e di errore del cron job
Per job critici che richiedono notifiche in caso di fallimento, puoi configurare avvisi email. Supponendo che il tuo sistema abbia un mail transfer agent installato (come postfix o sendmail), puoi modificare il cron job per inviare un’email solo se il job fallisce:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1 || echo "API fetch failed on $(date)" | mail -s "Cron Job Failed" your-email@example.comQui si usa l’operatore ||, che significa "esegui il comando mail solo se il comando precedente fallisce".
Per notifiche email di “successo”, usa:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1 && echo "API fetch completed successfully on $(date)" | mail -s "Cron Job Succeeded" your-email@example.comPuoi anche usare strumenti di monitoraggio più avanzatis come Prometheus con Node Exporter o servizi dedicati al monitoraggio dei cron, ma queste semplici tecniche di logging ed email offrono un monitoraggio efficace per la maggior parte delle esigenze di data engineering.
Finora hai visto i comandi base di cron e i pattern per catturare log ed errori. Sono un buon punto di partenza, ma per l’uso in produzione vorrai esplorare comandi più avanzati e l’integrazione con tecnologie container.
In questa sezione vedrai come fare un salto di qualità nell’implementazione dei cron job per workflow di data engineering più sofisticati.
Puoi concatenare più comandi in un singolo cron job per creare workflow complessi senza dover ricorrere a script shell separati.
Ci sono diversi modi per combinare comandi.
Puoi usare i punti e virgola per eseguire i comandi in sequenza indipendentemente dal successo di quelli precedenti:
* * * * * cd /path/to/data && python3 extract.py; python3 transform.py; python3 load.pyOppure puoi usare && per eseguire i comandi solo se quello precedente ha avuto successo (si ferma al primo errore):
* * * * * cd /path/to/data && python3 extract.py && python3 transform.py && python3 load.py >> /path/to/logs/etl.log 2>&1In alternativa, usa || per eseguire un comando solo se quello precedente fallisce (gestione errori):
* * * * * python3 /path/to/critical_job.py || python3 /path/to/send_alert.py "Critical job failed"Per concatenazioni di comandi più complesse, puoi usare le parentesi per raggruppare i comandi:
* * * * * (cd /path/to/data && python3 extract.py && echo "Extraction complete") && (python3 transform.py && echo "Transform complete") >> /path/to/logs/etl.log 2>&1Questo approccio funziona bene per workflow multi-step più semplici. Tuttavia, uno script shell dedicato resta l’opzione migliore per pipeline molto complesse con molti passaggi, logica condizionale o gestione degli errori.
I container Docker sono diventati essenziali negli stack moderni di data engineering. Puoi integrare cron con Docker in diversi modi potenti per garantire che i task pianificati girino in ambienti coerenti e isolati.
Per la dimostrazione, modificherò leggermente lo script fetch_api_data.py per avere directory dedicate per dati e log e cambierò i percorsi in modo che lo script funzioni in un ambiente containerizzato:
# fetch_api_data.py

import requests
import pandas as pd
import os
import uuid
from datetime import datetime

# Set file paths
data_dir = "/app/data"
log_dir = "/app/logs"
output_file = f"{data_dir}/objects_{str(uuid.uuid4())}.csv"

# Make sure the data directory exists
os.makedirs(data_dir, exist_ok=True)
os.makedirs(log_dir, exist_ok=True)


def log_message(message):
    print(f"{datetime.now().isoformat()}: {message}")


# Fetch data from the API
try:
    log_message("Starting API data fetch")
    response = requests.get("https://jsonplaceholder.typicode.com/posts")
    if response.status_code == 200:
        data = response.json()

        # Check if we have data
        if data:
            df = pd.DataFrame(
                [
                    {
                        "id": row.get("id", ""),
                        "user_id": row.get("userId", ""),
                        "title": row.get("title", ""),
                        "body": row.get("body", ""),
                    }
                    for row in data
                ]
            )

            df.to_csv(output_file, index=False)

            log_message(f"Data successfully saved to {output_file}")
        else:
            log_message("API returned empty data")
    else:
        log_message(f"API request failed with status code: {response.status_code}")
except Exception as e:
    log_message(f"Error occurred: {str(e)}")
Quindi, sia i dati recuperati sia i log verranno salvati nella cartella /app/runs.
Il passo successivo è creare un Dockerfile — un singolo file che indica a Docker come costruire ed eseguire il container:
FROM python:3.12-slim

# Install cron and required packages
RUN apt-get update && apt-get -y install cron \
    && pip install requests pandas \
    && rm -rf /var/lib/apt/lists/*

# Set up directories
WORKDIR /app
RUN mkdir -p /app/runs/data /app/runs/logs

# Copy our script
COPY fetch_api_data.py /app/

# Make the script executable
RUN chmod +x /app/fetch_api_data.py

# Create the crontab file
RUN echo "* * * * * root /usr/local/bin/python /app/fetch_api_data.py >> /app/runs/logs/api_fetch.log 2>&1" | tee /etc/cron.d/api-cron
RUN chmod 0644 /etc/cron.d/api-cron

# Create a startup script
RUN echo '#!/bin/sh' > /app/start.sh && \
    echo 'mkdir -p /app/runs/logs' >> /app/start.sh && \
    echo 'touch /app/runs/logs/api_fetch.log' >> /app/start.sh && \
    echo 'tail -f /app/runs/logs/api_fetch.log &' >> /app/start.sh && \
    echo 'cron -f' >> /app/start.sh
RUN chmod +x /app/start.sh

# Set entry point
CMD ["/app/start.sh"]
Ci siamo quasi. Ora puoi eseguire il seguente comando per buildare l’immagine ed eseguire il container Docker
docker build --no-cache -t api-cron-job . && \
docker run --rm --name api-fetcher api-cron-job
Se ti connetti al container, vedrai che lo script Python viene eseguito ogni minuto:
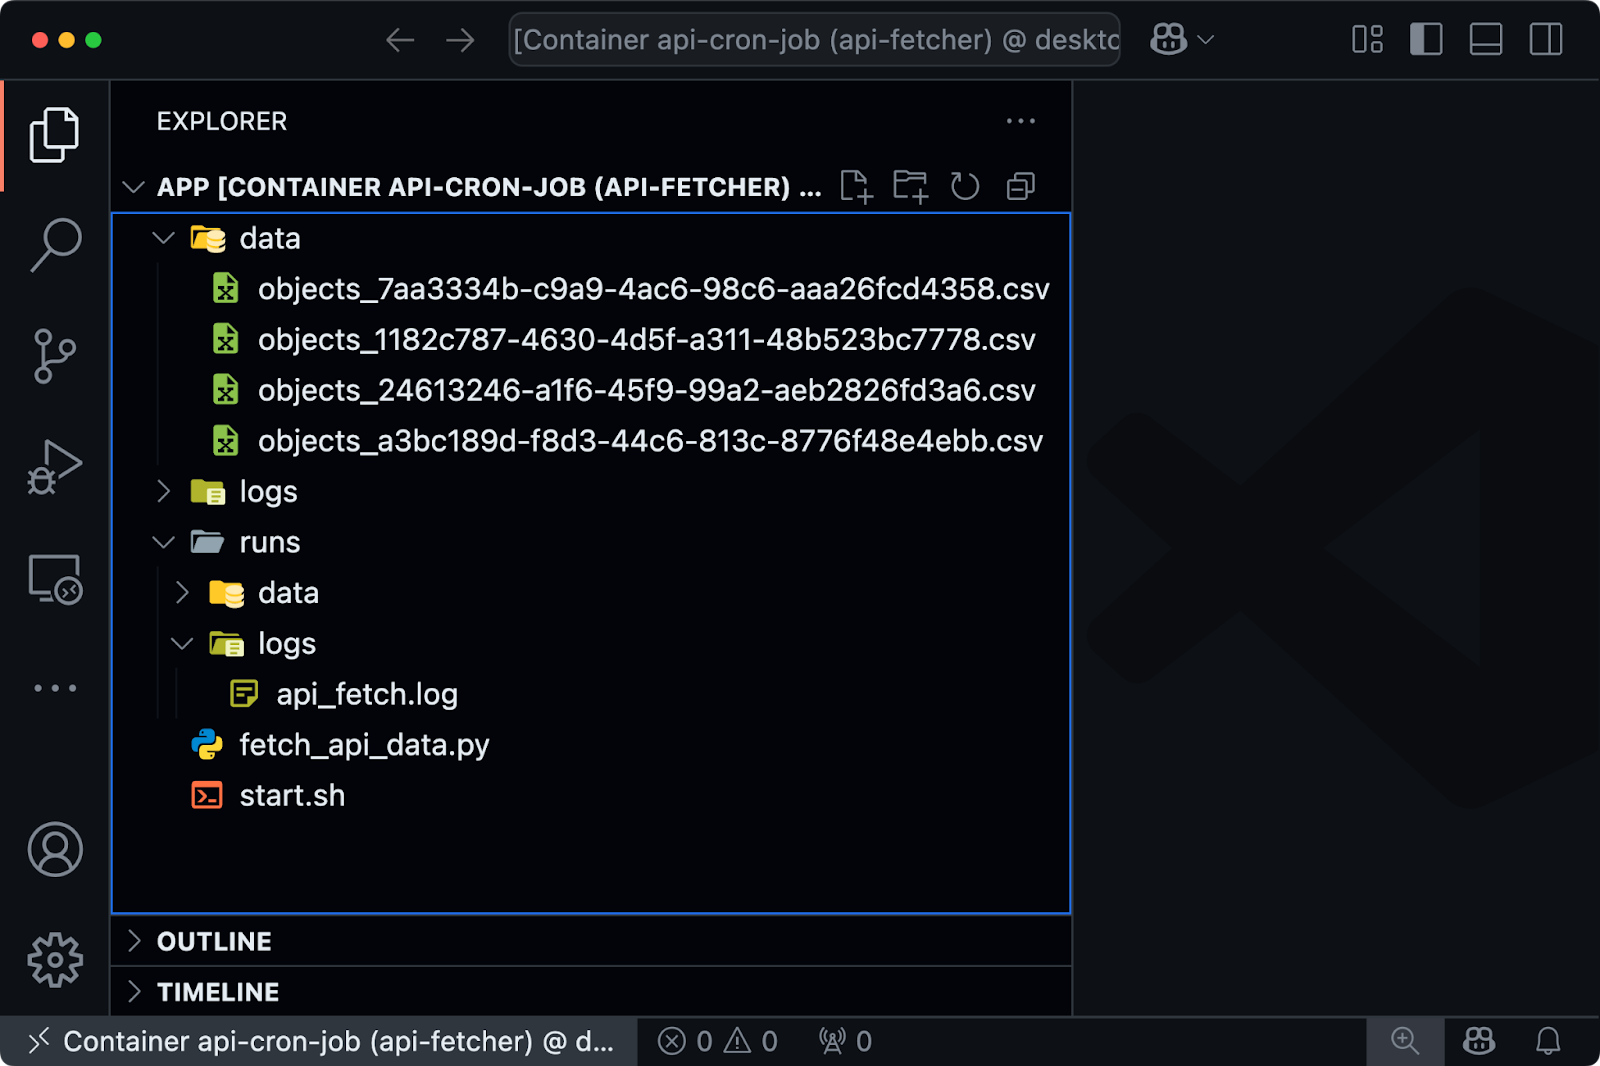
Immagine 11 - Cron job in esecuzione in un container Docker
D’altra parte, se cerchi un modo per eseguire una pipeline di data engineering in un container Docker su una pianificazione cron, lascia invariato lo script fetch_api_data.py, ma modifica il Dockerfile:
# Use Python 3.12 slim as base image
FROM python:3.12-slim

# Install required Python packages
RUN pip install --no-cache-dir requests pandas

# Set working directory
WORKDIR /app

# Copy the script into the container
COPY fetch_api_data.py /app/

# Set execution permissions
RUN chmod +x /app/fetch_api_data.py

# Run the script
CMD ["/usr/local/bin/python", "/app/fetch_api_data.py"]
Poi aggiungi quanto segue al file crontab sul tuo sistema:
*/2 * * * * cd /path/to/root/project/folder && docker build --no-cache -t api-cron-job . && docker run --rm --name api-fetcher api-cron-jobQuesto attiverà la build ed eseguirà il container ogni 2 minuti.
Per workflow distribuiti di data engineering, spesso devi eseguire processi su server remoti. I cron job possono innescare queste operazioni remote usando SSH.
Per esempio, puoi eseguire un comando come questo per far partire un cron job su un server remoto:
0 5 * * * ssh username@remote-server 'python3 /path/to/remote_job.py' >> /path/to/logs/remote_job.log 2>&1Perché questo funzioni senza prompt della password, devi configurare l’autenticazione SSH basata su chiavi tra i server.
Per trasferire dati tra server a orari pianificati, usa il seguente cron job:
0 6 * * * scp /path/to/local/data.csv username@remote-server:/path/to/destination/ >> /path/to/logs/data_transfer.log 2>&1Per operazioni remote più complesse, puoi combinare SSH con script shell:
#!/bin/bash
# remote_etl.sh

# Run extraction on the data source server
ssh username@source-server 'python3 /path/to/extract.py'

# Transfer the extracted data to the processing server
scp username@source-server:/path/to/extracted_data.csv /local/temp/

# Run transformation locally
python3 /path/to/transform.py

# Transfer the transformed data to the warehouse server
scp /local/temp/transformed_data.csv username@warehouse-server:/path/to/data/

# Trigger the load process on the warehouse server
ssh username@warehouse-server 'python3 /path/to/load.py'
E poi pianificalo semplicemente con cron:
0 7 * * * /path/to/remote_etl.sh >> /path/to/logs/remote_etl.log 2>&1Questo approccio ti consente di orchestrare pipeline di dati multi-server direttamente dai cron job. Funziona, ma per workflow distribuiti molto complessi potresti considerare strumenti di orchestrazione come Apache Airflow o Prefect per workflow distribuiti molto complessi.
Anche i cron job meglio progettati possono fallire o causare problemi se non implementati con buone pratiche operative.
Come data engineer, devi assicurarti che i task pianificati girino in modo affidabile, falliscano con grazia e forniscano sufficiente visibilità per il troubleshooting. In questa sezione ti mostro come fare.
Il logging è fondamentale per i processi automatici che girano senza supervisione diretta. Senza, diagnosticare i problemi dei cron job diventa quasi impossibile.
Per impostare un logging di base, puoi reindirizzare output standard e messaggi di errore verso file di log:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/script.log 2>&1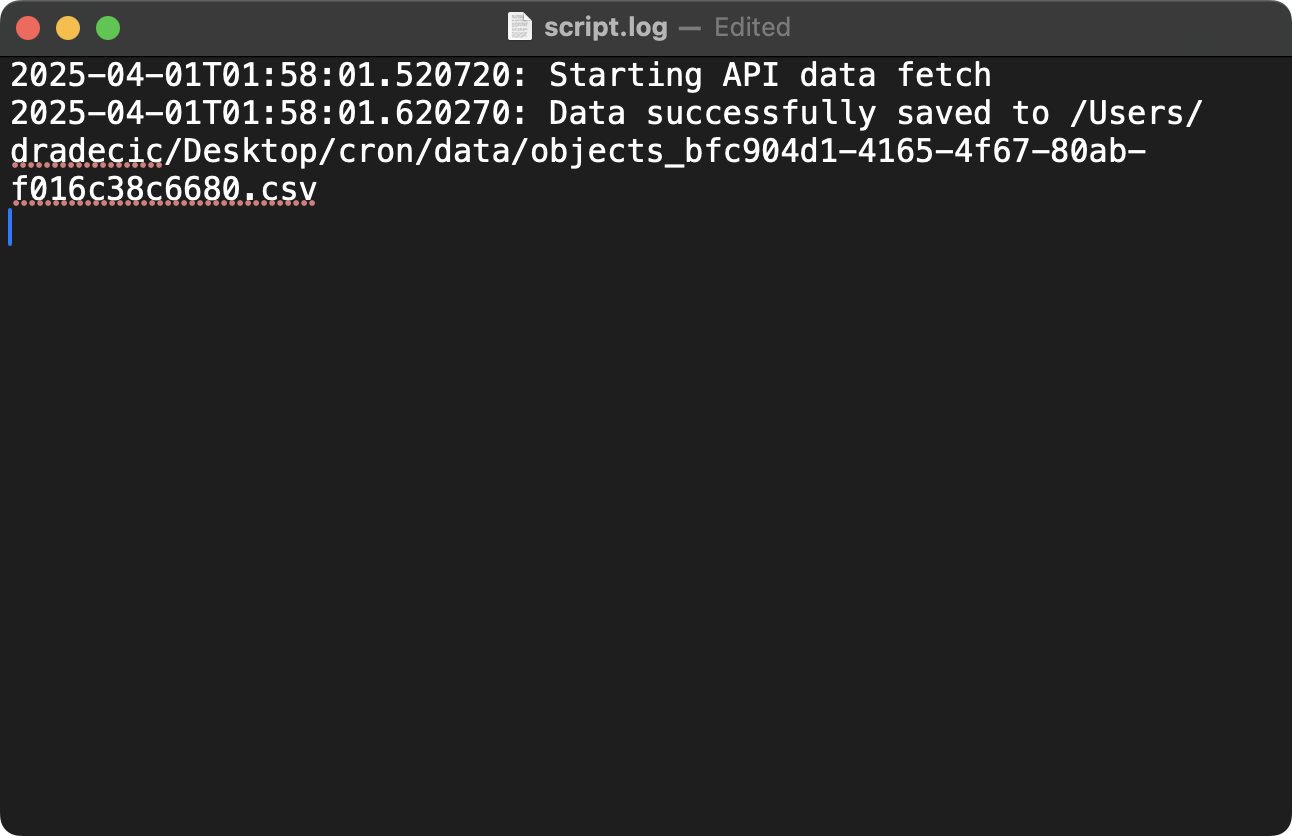
Immagine 12 - Configurazione del logging dei cron job (1)
Questo comando esegue lo script ogni minuto e aggiunge tutto l’output a un file di log. L’operatore >> aggiunge l’output invece di sovrascriverlo, mentre 2>&1 reindirizza sia lo standard error (file descriptor 2) sia lo standard output (file descriptor 1) allo stesso file di log.
Per un logging più strutturato, puoi aggiungere timestamp e identificatori del job:
* * * * * (echo "=== Job started at $(date) ==="; /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py; echo "=== Job finished at $(date) with exit code $? ===") >> /Users/dradecic/Desktop/cron/logs/script.log 2>&1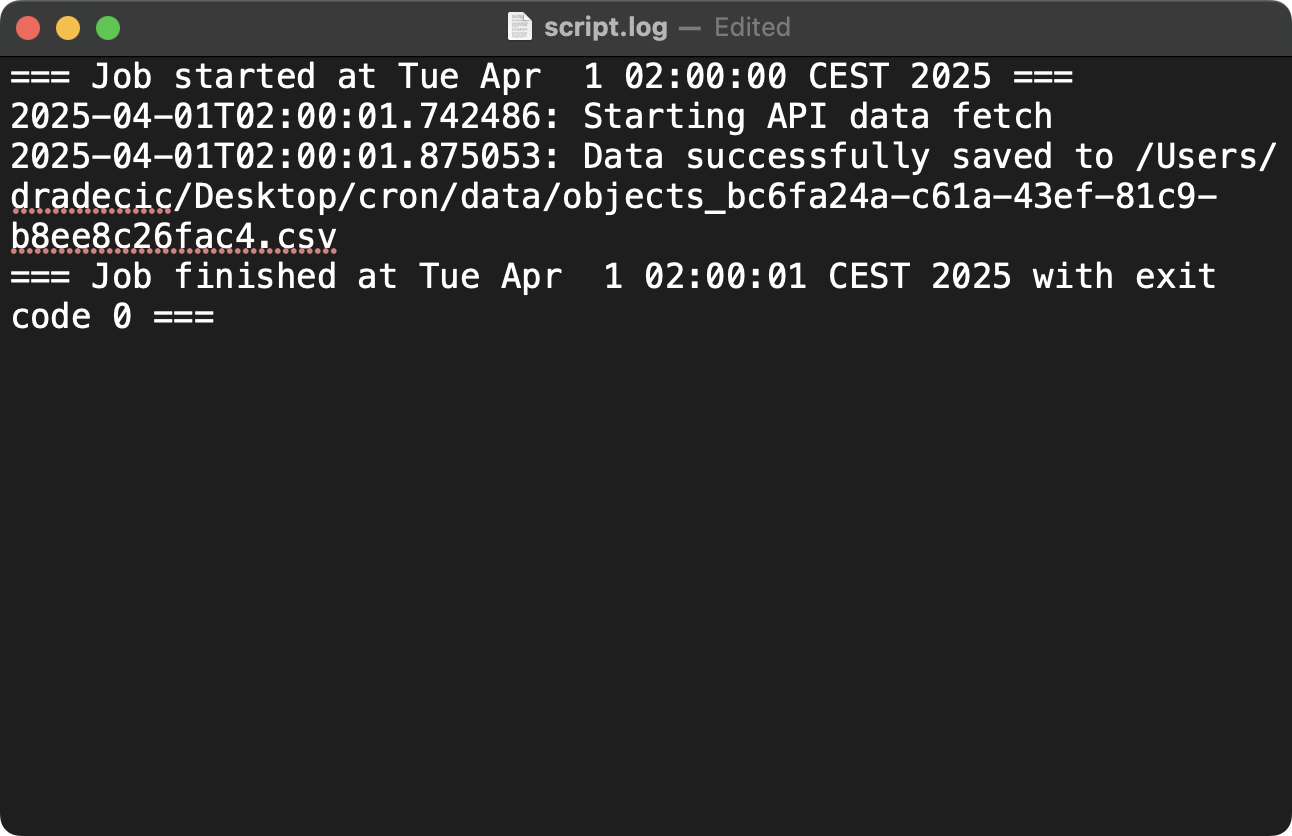
Immagine 13 - Configurazione del logging dei cron job (2)
Questo comando migliorato aggiunge un chiaro marcatore di inizio con timestamp prima di eseguire lo script e un marcatore di fine con timestamp e codice di uscita dopo il completamento. Le parentesi raggruppano questi comandi in modo che tutto l’output venga reindirizzato al file di log. La variabile $? contiene il codice di uscita del comando eseguito più di recente, utile per capire se lo script è andato a buon fine (codice 0) o è fallito (codice diverso da 0).
Per evitare che i log consumino troppo spazio su disco, puoi implementare la rotazione dei log. Usa l’utilità logrotate, disponibile sulla maggior parte delle distribuzioni Linux:
Crea un file di configurazione in /etc/logrotate.d/cron-jobs:
/path/to/logs/*.log {
    daily
    missingok
    rotate 14
    compress
    delaycompress
    notifempty
    create 0640 username groupname
}
Questa configurazione indica al sistema di:
daily)missingok)rotate 14)compress)delaycompress)notifempty)create 0640 username groupname)Il servizio logrotate del sistema applica automaticamente queste impostazioni, tipicamente una volta al giorno. Quando gira, rinomina il file di log corrente (aggiungendo un suffisso con la data), comprime i log più vecchi, elimina quelli oltre i 14 giorni e crea un nuovo file di log per le nuove scritture.
Workflow di data engineering robusti necessitano di strategie per gestire i fallimenti. Puoi integrare logiche di retry nei tuoi script o cron job, o collegare i cron job a sistemi di monitoraggio.
In questa sezione ti mostro come implementare tutte queste opzioni.
Retry incorporati possono essere implementati direttamente nei tuoi script Python, come in questo esempio:
import time
import random

def fetch_data_with_retry(max_attempts=3, backoff_factor=1.5):
    attempt = 1
    while attempt <= max_attempts:
        try:
            # Try to fetch data
            return fetch_data()
        except Exception as e:
            print(f"Attempt {attempt} failed: {str(e)}")
            # Calculate backoff time with jitter
            backoff_time = backoff_factor ** (attempt - 1) * (random.uniform(0.8, 1.2))
            if attempt < max_attempts:
                print(f"Retrying in {backoff_time:.2f} seconds...")
                time.sleep(backoff_time)
            else:
                print("Max retry attempts reached. Giving up.")
                raise
        attempt += 1
Questa funzione Python implementa un backoff esponenziale con jitter. Ecco come funziona:
max_attempts volte (predefinito 3).Questo pattern è ideale per gestire fallimenti transitori come problemi di rete o limiti di rate delle API. L’aumento esponenziale del tempo di attesa dà al sistema esterno il tempo di riprendersi, mentre il jitter previene il problema della “mandria” che si accalca contemporaneamente.
Retry basati su cron sono anch’essi un’opzione valida. Puoi ritentare i job falliti pianificandoli più frequentemente del necessario.
Ecco un esempio in cui ho impostato due cron job:
success_flag che impedisce allo script di girare di nuovo nei 10 minuti successivi.*/10 * * * * [ ! -f /path/to/success_flag ] && python /path/to/script.py && touch /path/to/success_flag
0 0 * * * rm -f /path/to/success_flag La configurazione sopra può risultare difficile da capire, quindi ricapitoliamo i passaggi:
[ ! -f /path/to/success_flag ])/path/to/script.py)touch /path/to/success_flag)0 0 * * *) e rimuove il flag di successo, permettendo al processo di girare di nuovo il giorno seguente.Questa tecnica è utile per task che devono essere completati una volta al giorno ma possono fallire temporaneamente. Il job continua a ritentare durante la giornata finché non ha successo una volta.
Integrazione con il monitoraggio ti consente di collegare i cron job a sistemi di monitoraggio, come Prometheus. È un argomento a sé, quindi qui fornisco solo una panoramica ad alto livello.
Lo script che vedrai sotto è un wrapper attorno al tuo job reale che raccoglie e invia metriche a Prometheus. Ecco i passaggi che compie:
#!/bin/bash
# monitored_job.sh

# Define pushgateway URL
PUSHGATEWAY="http://prometheus-pushgateway:9091"

# Start time in seconds
START_TIME=$(date +%s)

# Run the actual job
/path/to/actual_job.sh
EXIT_CODE=$?

# End time in seconds
END_TIME=$(date +%s)
DURATION=$((END_TIME - START_TIME))

# Push metrics to Prometheus
cat <<EOF | curl --data-binary @- ${PUSHGATEWAY}/metrics/job/cron_job/instance/$(hostname)
# HELP cron_job_duration_seconds How long the cron job took to execute
# TYPE cron_job_duration_seconds gauge
cron_job_duration_seconds{name="data_extraction"} ${DURATION}

# HELP cron_job_exit_code Exit code of the cron job
# TYPE cron_job_exit_code gauge
cron_job_exit_code{name="data_extraction"} ${EXIT_CODE}

# HELP cron_job_last_run_timestamp Timestamp of last job run
# TYPE cron_job_last_run_timestamp gauge
cron_job_last_run_timestamp{name="data_extraction"} ${END_TIME}
EOF

exit ${EXIT_CODE}
Queste metriche ti permettono di:
Il Pushgateway funge da intermediario, consentendo al cron job, che è di breve durata, di inviare le proprie metriche a Prometheus, che poi le memorizza per alerting e visualizzazione.
I problemi di fuso orario sono sfide comuni nel data engineering, soprattutto quando si lavora con fonti dati globali o sistemi distribuiti.
Come prevedibile, i cron job sono sensibili alle impostazioni del fuso orario.
Per impostazione predefinita, cron usa il fuso orario locale del sistema. Puoi controllare il fuso orario del sistema con questo comando Linux:
timedatectlIl comando precedente mostra l’ora corrente del sistema e la configurazione del fuso orario. Se il server è configurato su un fuso orario locale come America/New_York, tutte le pianificazioni cron verranno interpretate in quel fuso orario.
Per garantire pianificazioni coerenti a prescindere dalla posizione del server o dai cambi di ora legale, usa l’UTC per i cron job:
# Set the CRON_TZ environment variable at the top of your crontab
CRON_TZ=UTC

# Now all job schedules will use UTC
0 0 * * * /path/to/daily_job.sh
Aggiungendo la riga CRON_TZ=UTC in cima al file crontab, dici a cron di interpretare tutte le specifiche temporali in UTC invece che nell’ora locale.
Questo significa che il job girerà ogni giorno a mezzanotte UTC, indipendentemente dal fuso orario locale del server o dai cambi dell’ora legale. L’UTC (Tempo Coordinato Universale) non cambia con l’ora legale, fornendo un riferimento coerente ovunque.
Se sei un data engineer, i cron job sono uno strumento preziosissimo.
Ti aiutano ad automatizzare task ripetitivi e a costruire pipeline di dati affidabili. Offrono un modo coerente e potente per pianificare script e orchestrare processi ETL multi-step complessi. La sintassi richiede un po’ di pratica, ma diventerà naturale dopo qualche giorno.
Quando implementi cron job nel tuo lavoro di data engineering, ricorda di seguire le best practice per logging, gestione degli errori e fusi orari. Un logging adeguato ti dà visibilità sull’esecuzione dei job e semplifica il troubleshooting. Buone tecniche di gestione degli errori con meccanismi di retry assicurano che le pipeline possano riprendersi da fallimenti transitori. Una gestione attenta dei fusi orari mantiene le pianificazioni coerenti, soprattutto quando lavori con fonti dati globali o team distribuiti.
>Vuoi farti assumere come Data Engineer nel 2025? Queste sono le 5 competenze essenziali che devi avere.
Certo, strumenti specializzati di orchestrazione dei workflow come Apache Airflow o Prefect offrono funzionalità più avanzate per pipeline complesse, ma cron resta comunque rilevante per molti task di data engineering. È semplice da usare, affidabile e con un overhead minimo — il che lo rende perfetto per le esigenze di automazione.
Per approfondire il data engineering, iscriviti a questi corsi di DataCamp:
Approfondisci il data engineering con questi corsi!
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min



