Cours
Introduction à Apache Airflow en Python
4 h
64.6K
Si vous gérez souvent à la main des tâches récurrentes, vous savez combien c’est fastidieux — et surtout propice aux retards et aux pipelines de données incohérents.
Les cron jobs sont une solution incontournable pour automatiser les tâches répétitives sur les systèmes Unix. Ils vous permettent de planifier l’exécution de commandes ou de scripts à des intervalles précis. En tirant parti de la planification simple et flexible de cron, vous pouvez automatiser aussi bien une collecte de données basique que des workflows ETL complexes qui exigeraient autrement une intervention humaine permanente. Mettre en place ces processus automatisés élimine les erreurs humaines et garantit des pipelines qui tournent de manière régulière et fiable.
Maîtriser les cron jobs est essentiel pour tout·e professionnel·le du data engineering en environnement Unix. La simple capacité à planifier et gérer des tâches automatisées va fluidifier radicalement votre flux de travail et réduire la charge de maintenance.
Dans ce guide complet, je vous expliquerai tout ce qu’il faut savoir sur les cron jobs en data engineering — de la configuration de base aux cas d’usage avancés et aux bonnes pratiques.
>Vous débutez totalement en Data Engineering ? Notre cours clarifie le jargon et explique les concepts.
Un cron job est un planificateur basé sur le temps dans les systèmes d’exploitation Unix qui exécute automatiquement des commandes à des heures, des dates ou des intervalles définis.
Voyez cron comme un assistant qui lance vos tâches exactement quand vous le décidez, sans intervention manuelle. Pour les data engineers, cela signifie automatiser des sauvegardes de bases de données, des transferts de données, la génération de rapports, et bien plus.
Les cron jobs sont définis dans un simple fichier texte appelé « crontab » (cron table). Chaque ligne représente une tâche planifiée et suit un format précis à six composantes :
* * * * * command-to-execute
│ │ │ │ │
│ │ │ │ └─── Day of week (0-6, where 0 is Sunday)
│ │ │ └───── Month (1-12)
│ │ └─────── Day of month (1-31)
│ └───────── Hour (0-23)
└─────────── Minute (0-59)
Les cinq premiers champs indiquent à cron quand exécuter la commande. Vous pouvez utiliser des valeurs précises, des plages (comme 1-5), des listes (comme 1, 3, 5), ou des astérisques (*) qui signifient « chaque » unité de temps. La sixième composante est la commande à exécuter.
Par exemple, pour lancer chaque jour à minuit un script Python qui extrait des données depuis une API :
0 0 * * * /usr/bin/python3 /home/username/scripts/extract_data.pyCela indique à cron d’exécuter le script à 0 minute, 0 heure (minuit), chaque jour du mois, chaque mois et chaque jour de la semaine. Les chemins absolus vers l’interpréteur Python et le script garantissent que la tâche s’exécute correctement quel que soit l’environnement.
Vous pouvez aussi définir des plannings plus complexes. Par exemple, pour lancer un nettoyage de base de données chaque lundi, mercredi et vendredi à 15 h 30 :
30 15 * * 1,3,5 /path/to/cleanup_script.shChaque astérisque agit comme un joker et vous permet de créer des plannings souples adaptés à vos besoins. Vous pouvez même utiliser des raccourcis comme @daily, @weekly ou @monthly pour des modèles courants plus lisibles.
Voilà pour les bases. Dans la suite, je vous montre, pas à pas, comment utiliser les cron jobs pour des tâches de data engineering.
Maintenant que vous savez ce qu’est un cron job, passons à la mise en place de votre première tâche automatisée. La procédure est simple et ne demande que quelques commandes pour démarrer.
Pour créer ou modifier des cron jobs, vous devez accéder à votre fichier crontab. Utilisez la commande crontab -e :
crontab -e
Image 1 - Édition d’un fichier crontab
La commande ci-dessus ouvre l’éditeur de texte vi, dans lequel vous pouvez ajouter, modifier ou supprimer des tâches planifiées.
Votre crontab peut être vide si vous ne l’avez jamais utilisée. Pour ajouter un cron job, insérez une nouvelle ligne en respectant la syntaxe vue plus haut. Chaque ligne doit contenir à la fois la planification et la commande à exécuter.
Par exemple, pour lancer un script chaque jour à 3 h :
0 3 * * * /path/to/your/commandEnregistrez et quittez l’éditeur. Cron installera automatiquement votre nouvelle crontab et exécutera vos jobs aux heures indiquées.
Commençons par un exemple concret : planifier un script Python qui interroge une API chaque minute. Voici un script Python complet qui se connecte à un endpoint REST, récupère des objets et les enregistre en CSV — assurez-vous que votre interpréteur Python dispose des packages requests et pandas :
# fetch_api_data.py

import requests
import pandas as pd
import os
from datetime import datetime

# Create a timestamp for the filename
timestamp = datetime.now().strftime("%Y%m%d_%H%M%S")

# Set file paths - CHANGE THIS
data_dir = "/Users/dradecic/Desktop/cron/data"
output_file = f"{data_dir}/objects_{timestamp}.csv"

# Make sure the data directory exists
os.makedirs(data_dir, exist_ok=True)

# Fetch data from the API
try:
    response = requests.get("https://jsonplaceholder.typicode.com/posts")
    if response.status_code == 200:
        data = response.json()

        # Check if we have data
        if data:
            df = pd.DataFrame([
                {
                    "id": row.get("id", ""),
                    "user_id": row.get("userId", ""),
                    "title": row.get("title", ""),
                    "body": row.get("body", "")
                } for row in data
            ])

            df.to_csv(output_file, index=False)

            print(f"Data successfully saved to {output_file}")
        else:
            print("API returned empty data")
    else:
        print(f"API request failed with status code: {response.status_code}")
except Exception as e:
    print(f"Error occurred: {str(e)}")
Pour planifier ce script avec cron afin qu’il s’exécute chaque jour à 2 h :
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py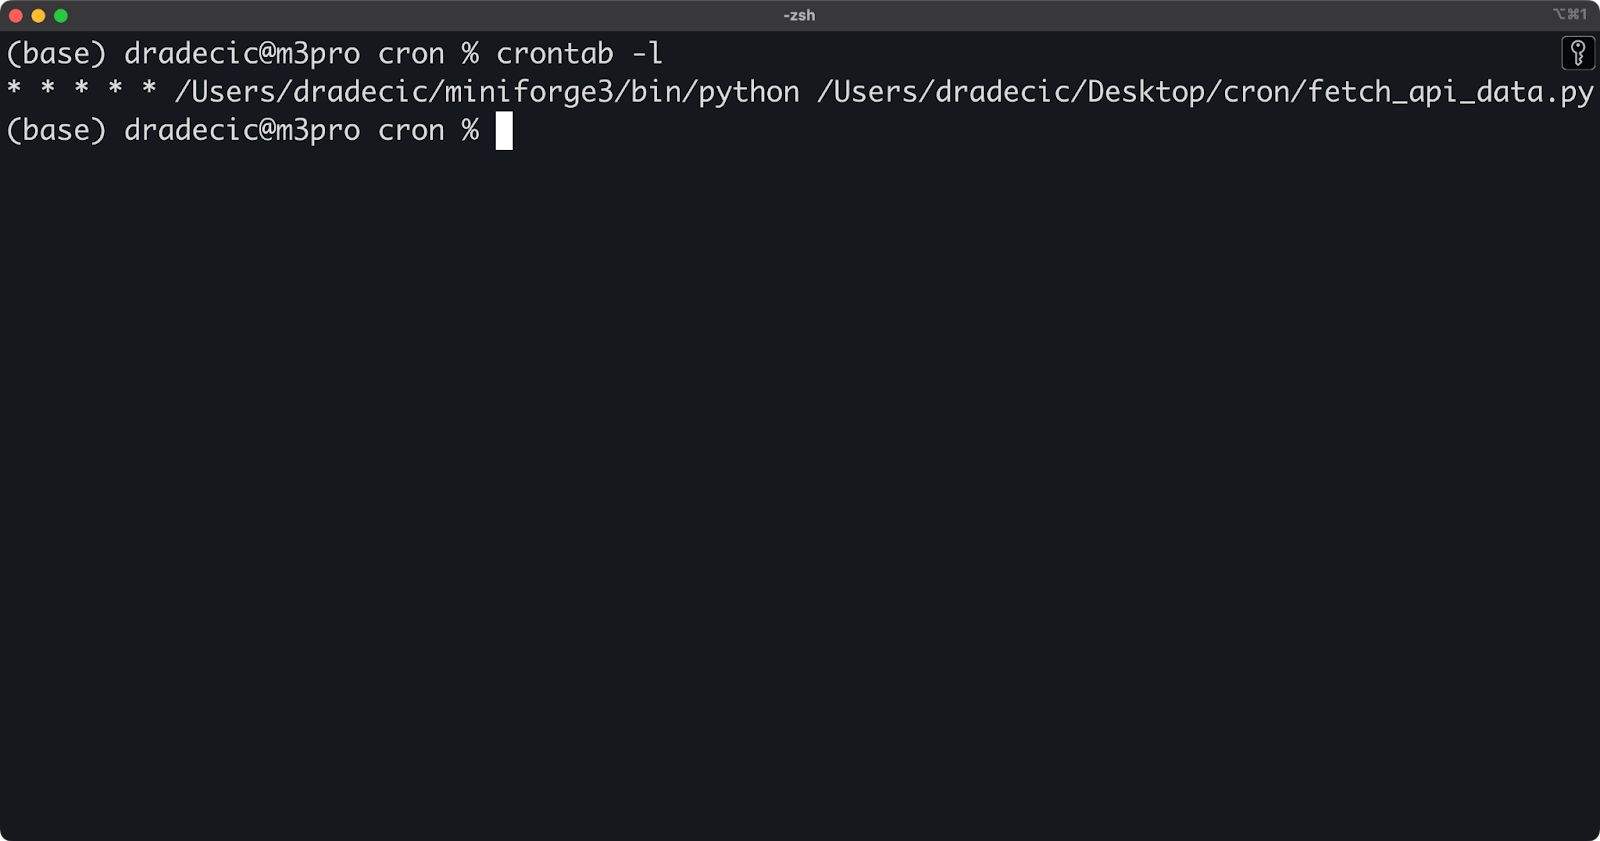
Image 2 - Liste des crontabs actives
Cette ligne indique à cron d’exécuter votre script Python chaque minute de chaque jour. Utilisez des chemins absolus pour l’interpréteur Python (/Users/dradecic/miniforge3/bin/python ici) et pour votre script (/Users/dradecic/Desktop/cron/fetch_api_data.py ici).
Pourquoi des chemins absolus ? Cron tourne dans un environnement limité : il ne connaît pas la variable PATH de votre shell ni votre répertoire courant. Sans chemins absolus, votre job peut échouer car cron ne trouve pas les commandes ou fichiers attendus.
Le temps de lire ces lignes, plusieurs fichiers CSV ont été enregistrés dans mon dossier data, preuve que le cron job fonctionne comme prévu :
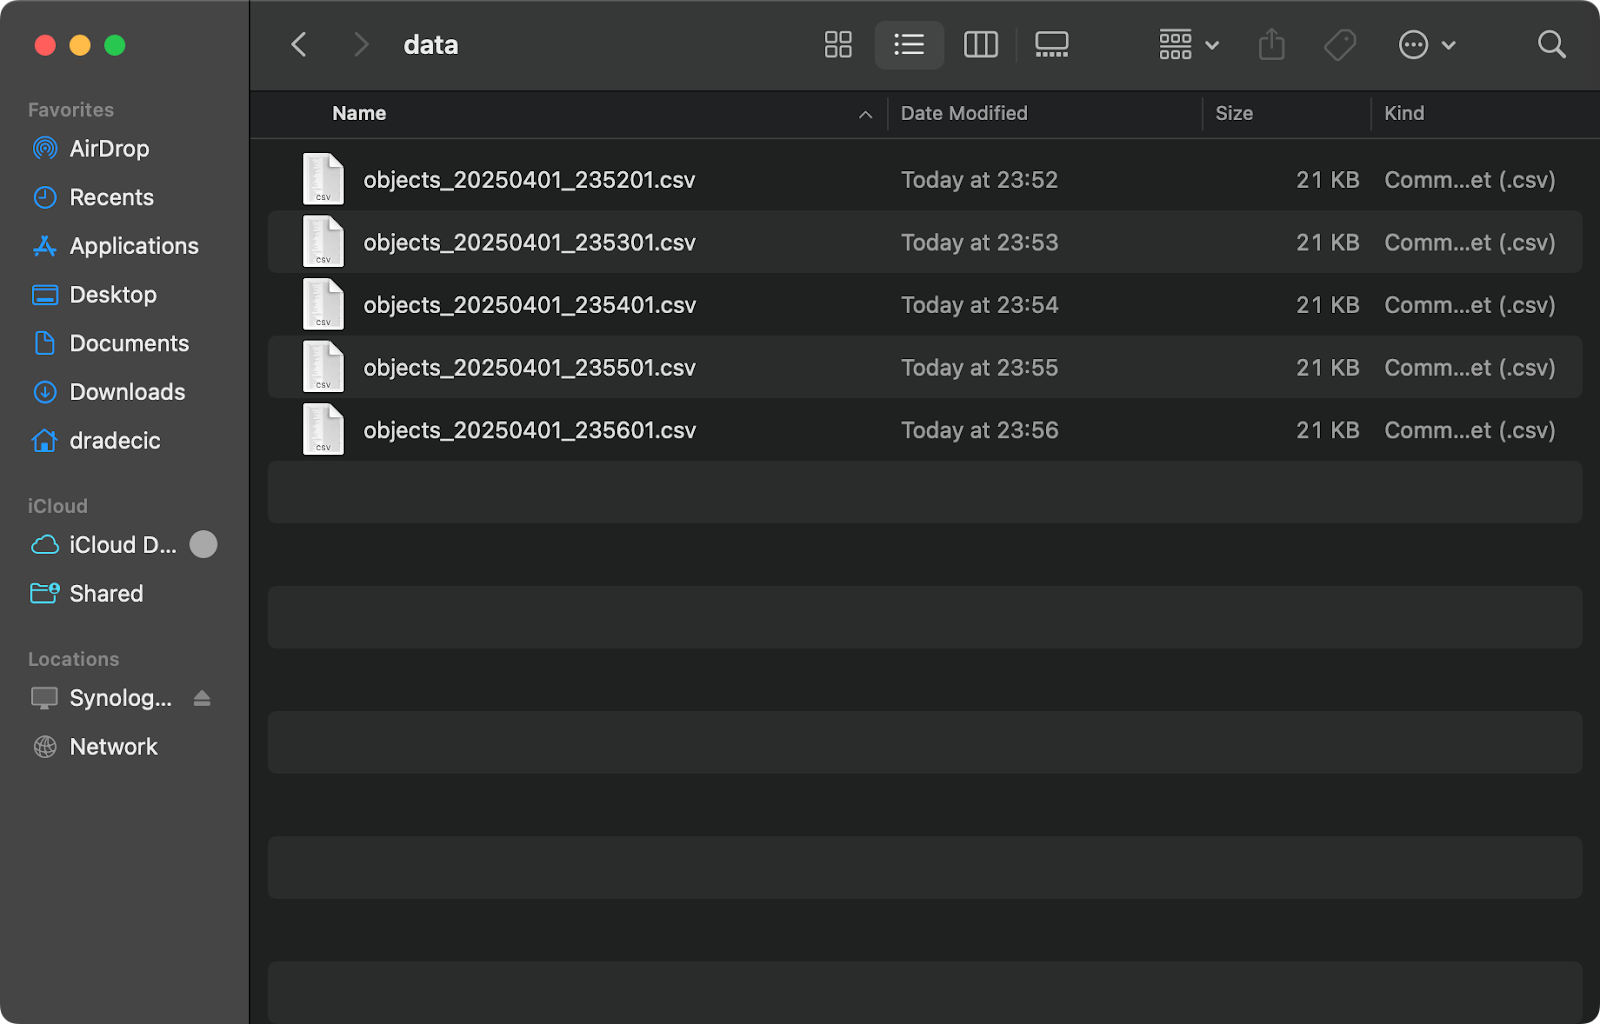
Image 3 - Fichiers CSV enregistrés
Pour des workflows de data engineering plus complexes comme les ETL (Extract, Transform, Load), vous pouvez utiliser cron pour enchaîner plusieurs étapes. Une approche courante consiste à écrire un script shell qui contient toutes les étapes ETL, puis à planifier ce script avec cron.
Pour rester simple, le code du script .sh ci-dessous est théorique et ne se connecte à aucune source :
#!/bin/bash
# etl_pipeline.sh

# Extract data from source
/usr/bin/psql -U username -d source_db -c "COPY (SELECT * FROM source_table) TO '/tmp/extracted_data.csv' WITH CSV HEADER;"

# Transform data
/usr/bin/python3 /home/username/scripts/transform_data.py

# Load data into target
/usr/bin/psql -U username -d target_db -c "\COPY target_table FROM '/tmp/transformed_data.csv' WITH CSV HEADER;"

# Log completion
echo "ETL job completed at $(date)" >> /home/username/logs/etl_job.log
Ensuite, rendez votre script exécutable :
chmod +x /home/username/scripts/etl_pipeline.shEnfin, planifiez-le avec cron pour qu’il tourne, par exemple, chaque jour ouvré à 1 h :
0 1 * * 1-5 /home/username/scripts/etl_pipeline.shEn tant que data engineer, planifier des tâches ETL avec cron présente plusieurs avantages :
Pour des processus ETL plus lourds, pensez à ajouter de la gestion d’erreurs à vos scripts :
#!/bin/bash
# etl_pipeline.sh

# Set error handling
set -e  # Exit immediately if any command fails

# Execute ETL steps
# ...

# If we get here, all steps succeeded
echo "ETL job completed successfully at $(date)" >> /home/username/logs/etl_job.log
Et voilà ! Votre pipeline ETL s’exécutera automatiquement aux heures prévues, traitera vos données et consignera son statut pour le suivi.
Une fois vos cron jobs en place, vous devez les gérer et les superviser pour vous assurer qu’ils tournent comme prévu.
Autrement dit : vérifier les jobs planifiés, retirer ceux qui sont obsolètes et suivre leurs exécutions. Cette section couvre les commandes et techniques essentielles pour maintenir vos cron jobs sans prise de tête.
Pour voir tous vos cron jobs planifiés, utilisez la commande crontab -l :
crontab -lCette commande affiche le contenu de votre crontab, avec chaque job planifié, sa fréquence et la commande associée. C’est un moyen rapide de vérifier les jobs actifs sans passer en mode édition.
Voici à quoi peut ressembler la sortie si vous avez suivi la section précédente :
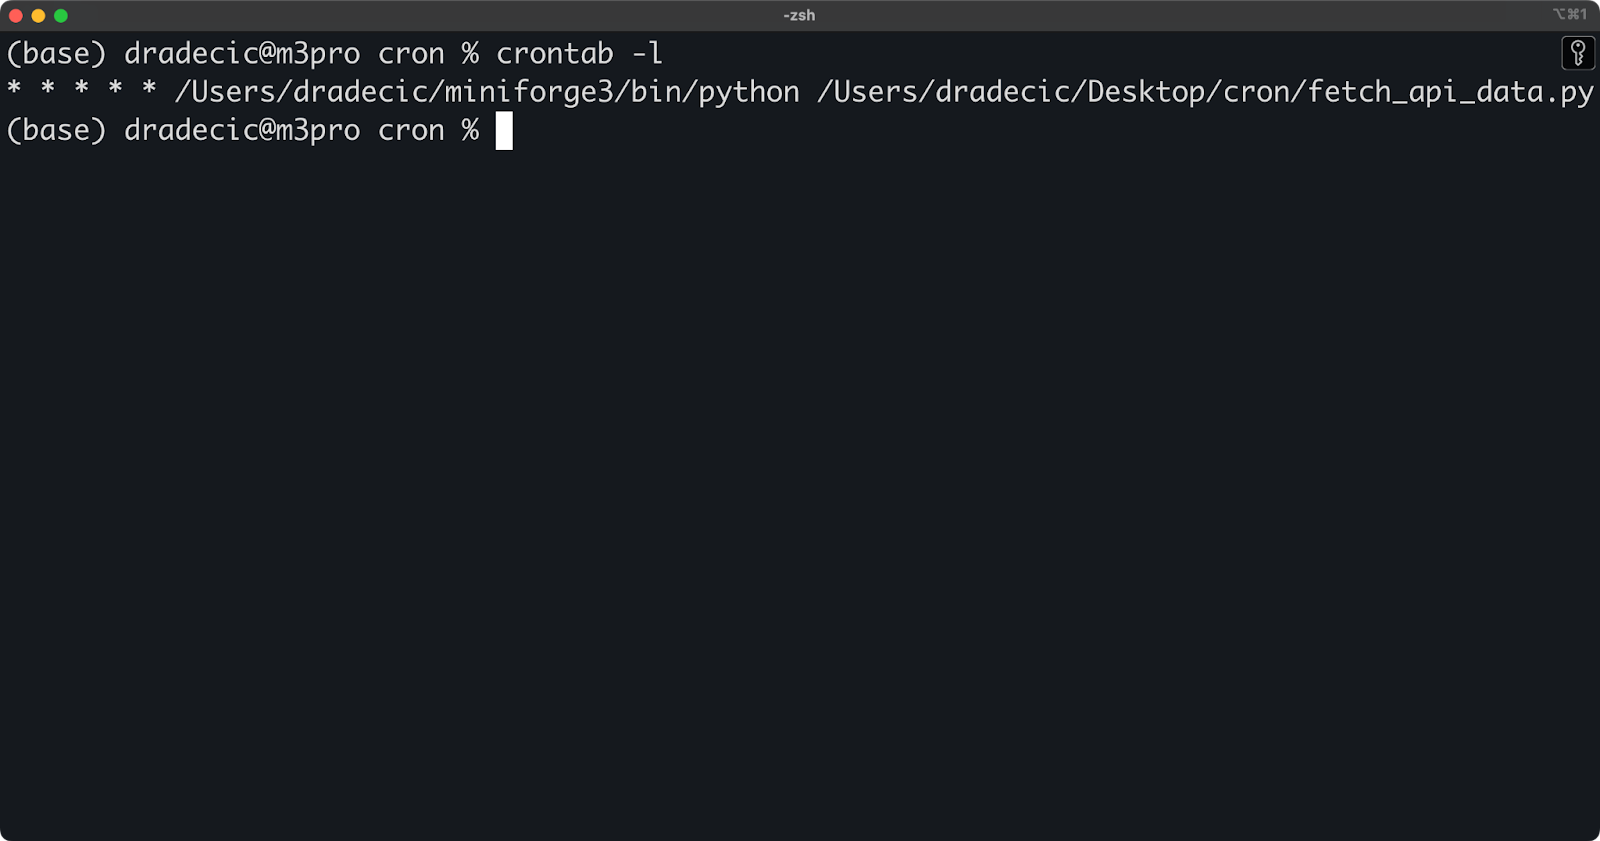
Image 4 - Cron jobs actifs
Pour consulter les cron jobs d’un autre utilisateur (accès root requis), exécutez :
sudo crontab -u username -lIl existe plusieurs façons de supprimer ou désactiver des cron jobs devenus inutiles. Pour retirer un job spécifique, ouvrez votre crontab en mode édition et supprimez la ligne correspondante :
crontab -ePour désactiver temporairement un job sans le supprimer, commentez la ligne en ajoutant un # au début :
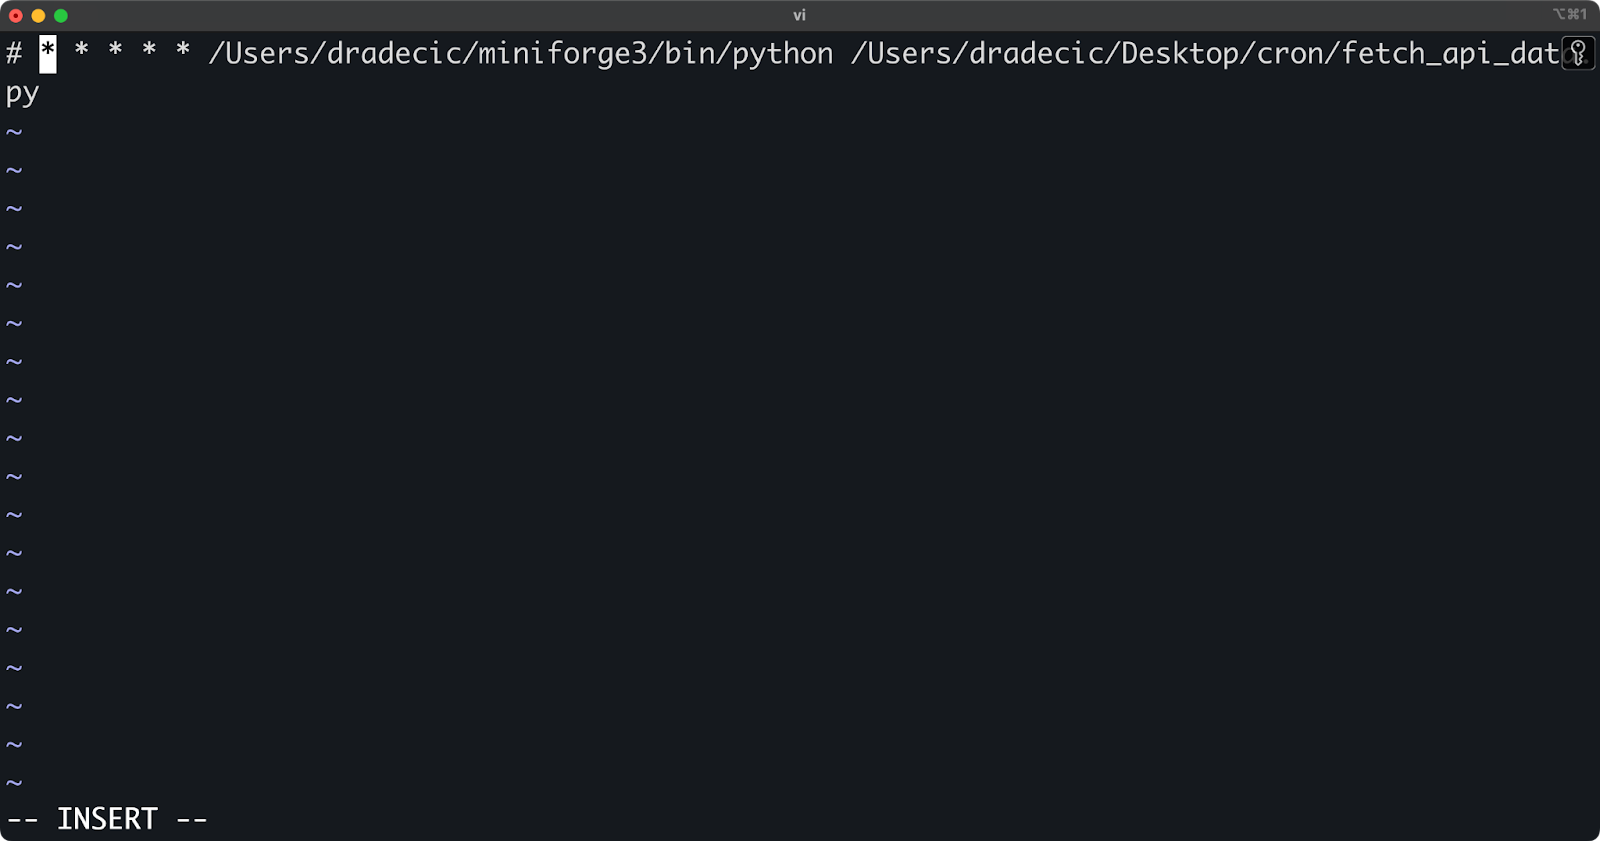
Image 5 - Désactivation temporaire d’un cron job
Le job commenté reste dans votre crontab pour référence mais ne s’exécutera plus selon la planification définie.
Si vous souhaitez supprimer toute votre crontab (tous les jobs), utilisez l’option -r :
crontab -r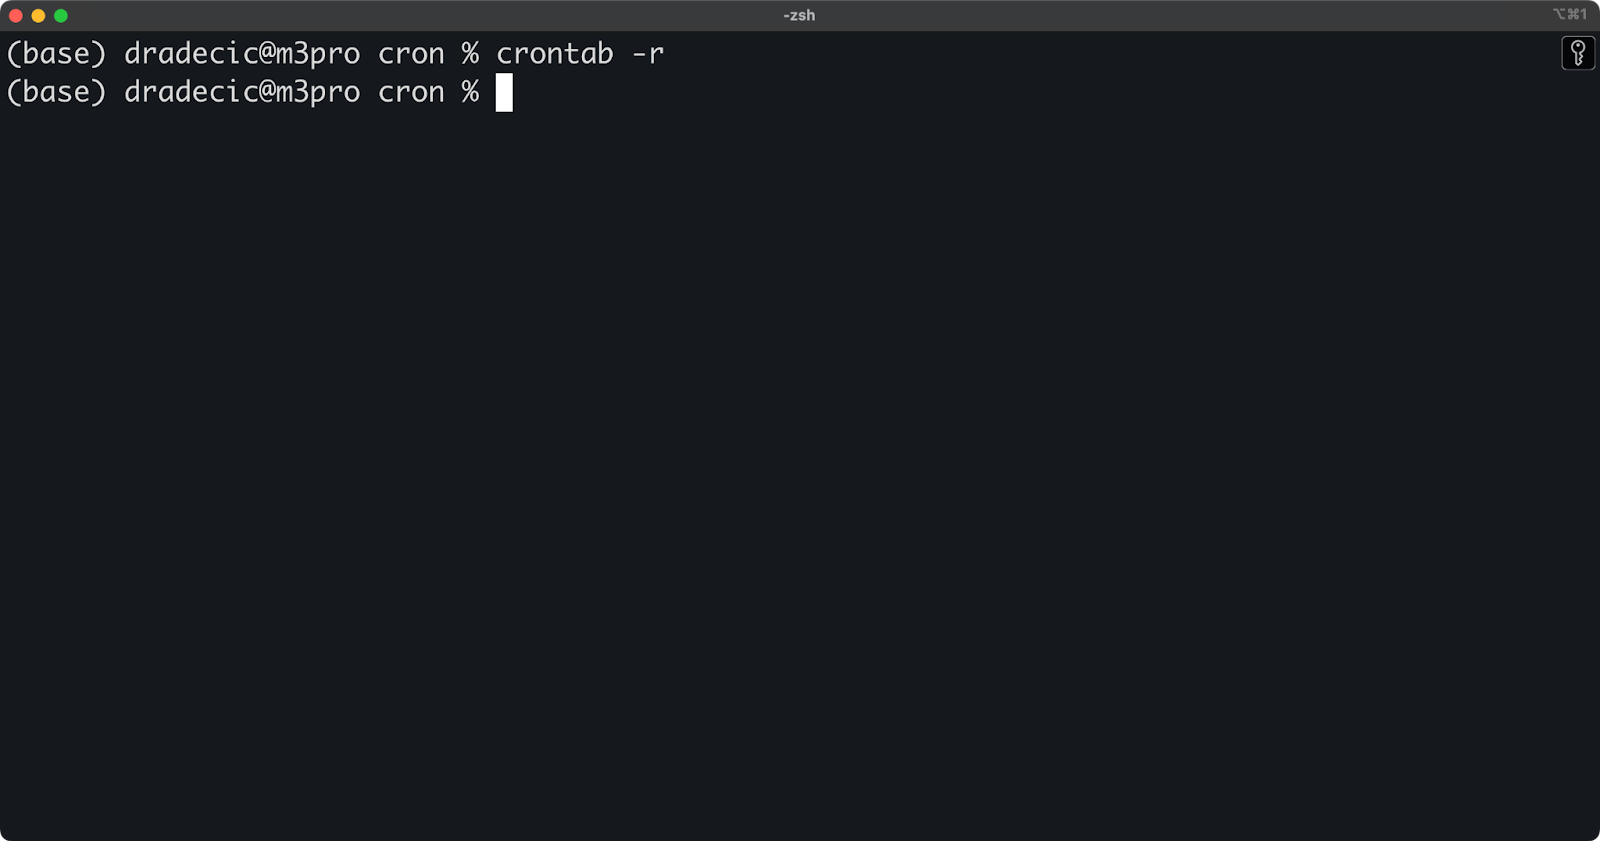
Image 6 - Suppression de toute la crontab
Attention : cette commande supprime tous vos jobs sans confirmation. Pour éviter toute suppression accidentelle, sauvegardez d’abord votre crontab :
crontab -l > my_crontab_backupCette commande enregistre votre crontab actuelle dans un fichier, que vous pourrez restaurer si besoin :
crontab my_crontab_backup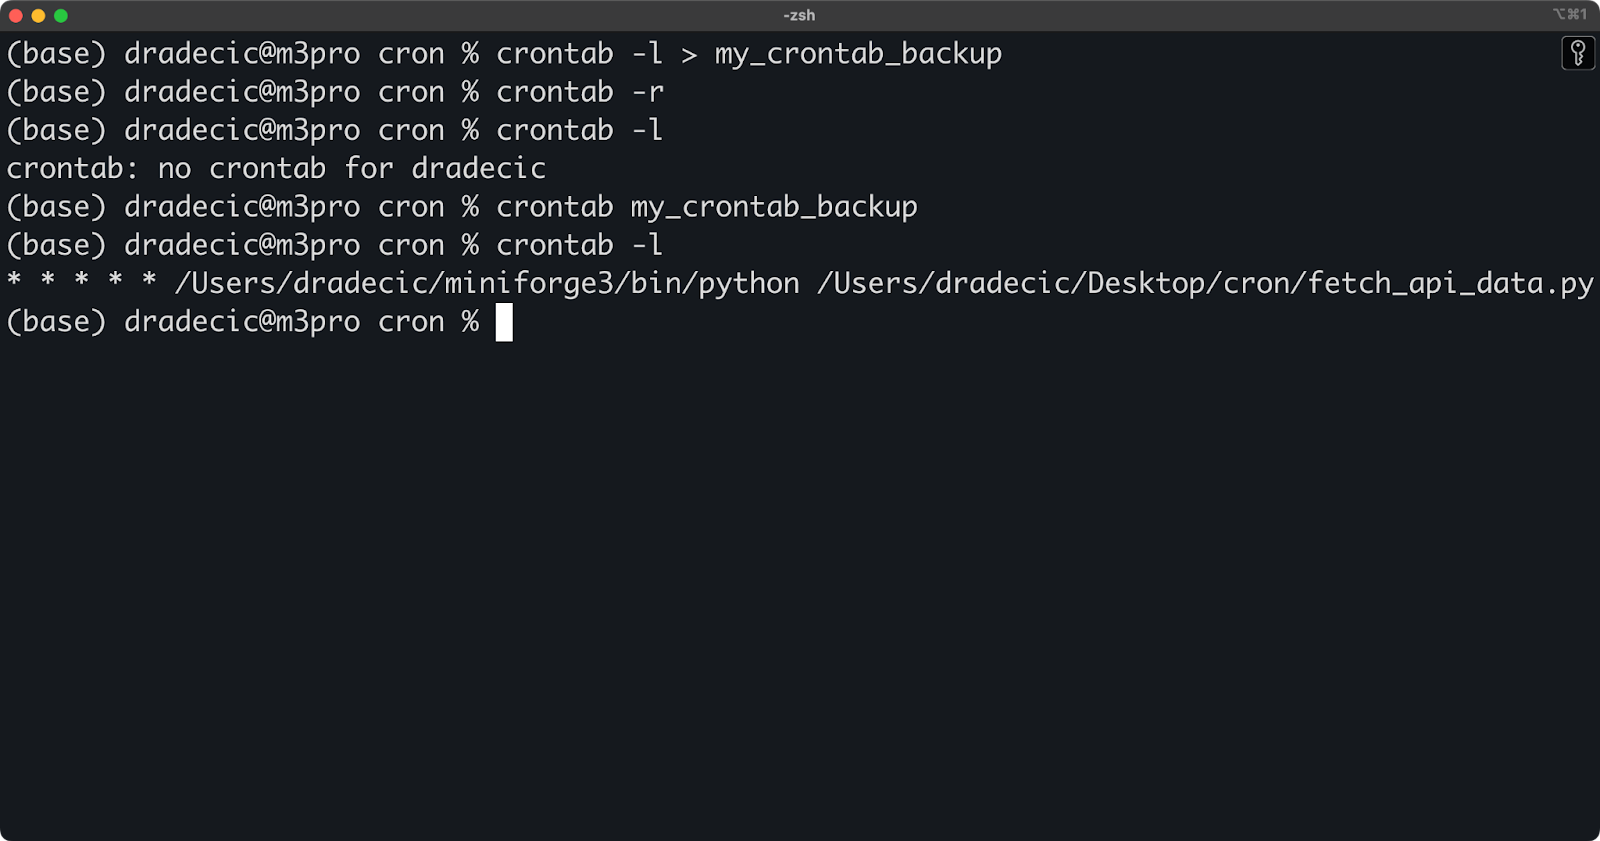
Image 7 - Restauration d’une crontab depuis une sauvegarde
Par défaut, cron tente d’envoyer par e-mail la sortie des jobs à l’utilisateur propriétaire de la crontab. Cela suppose un système de messagerie correctement configuré, ce qui n’est pas toujours le cas. À la place, redirigez la sortie vers des fichiers de log pour un suivi et un débogage plus simples.
Pour capturer à la fois la sortie standard et les erreurs, utilisez cette redirection :
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1Cette syntaxe peut sembler intimidante au début, voici l’explication :
>> ajoute la sortie à la fin du fichier spécifié.2>&1 redirige stderr (messages d’erreur) vers le même emplacement que stdout (sortie standard).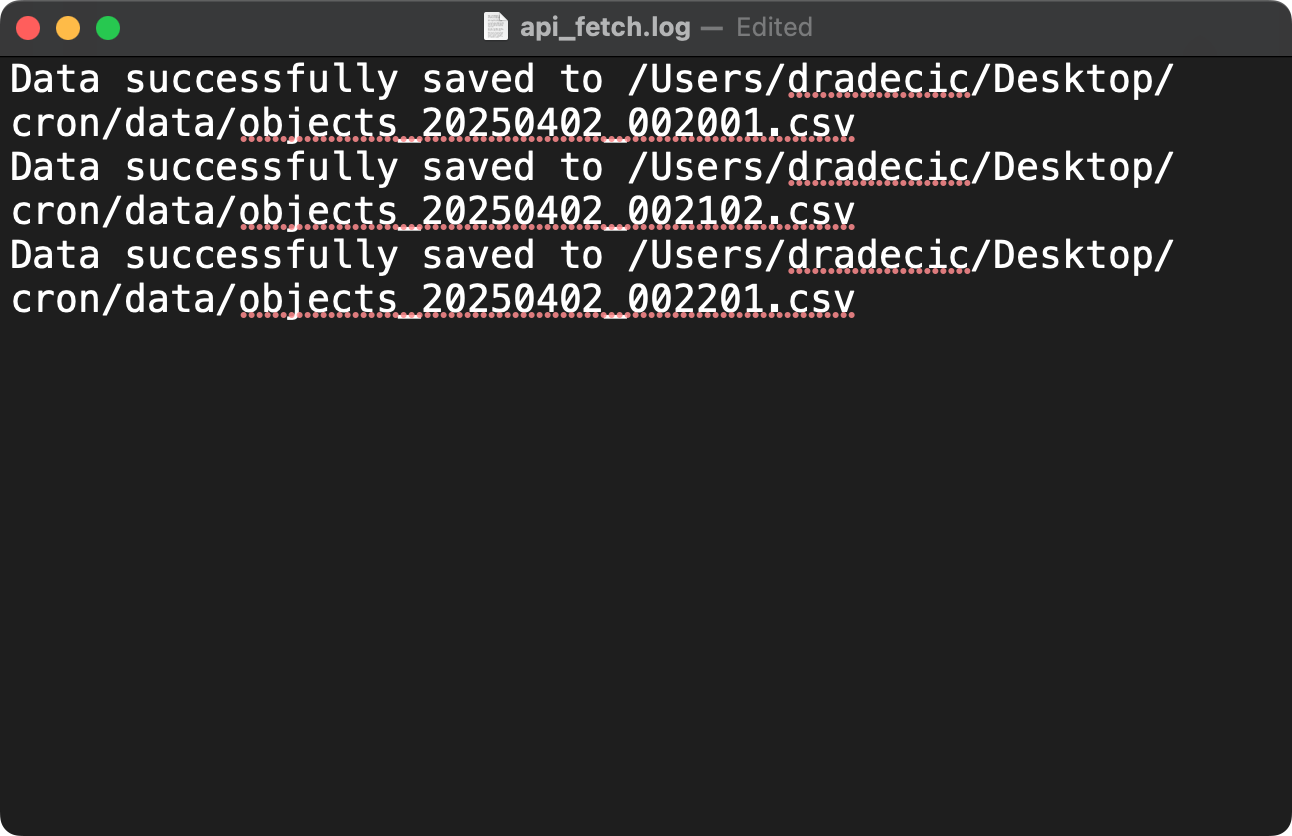
Image 8 - Capture des logs d’un cron job
Pour une meilleure gestion des logs, vous pouvez ajouter des horodatages à vos entrées :
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1 && echo "Job completed at $(date)" >> /Users/dradecic/Desktop/cron/logs/api_fetch.log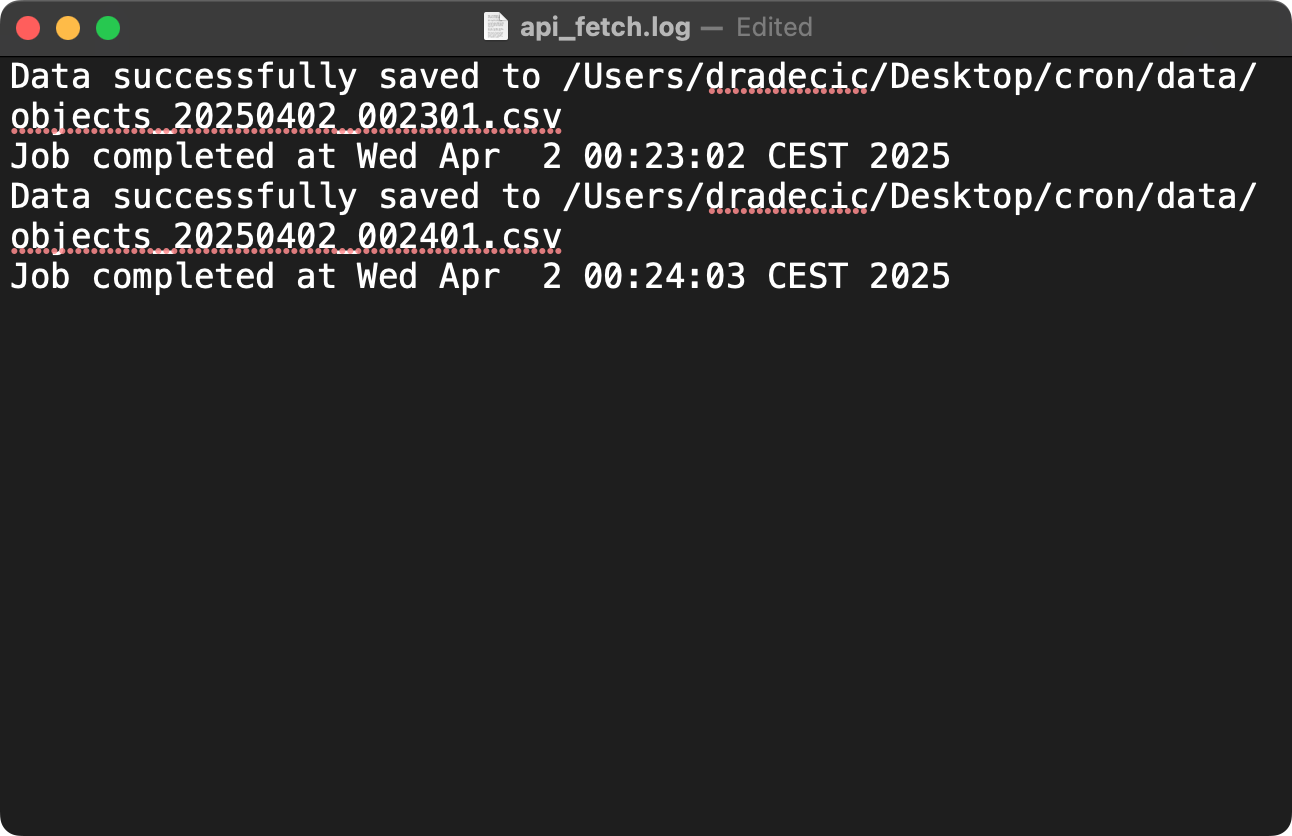
Image 9 - Logs de cron jobs avec horodatage
Si vous souhaitez des fichiers de log séparés pour la sortie normale et les erreurs, utilisez :
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>> /Users/dradecic/Desktop/cron/logs/api_fetch_errors.log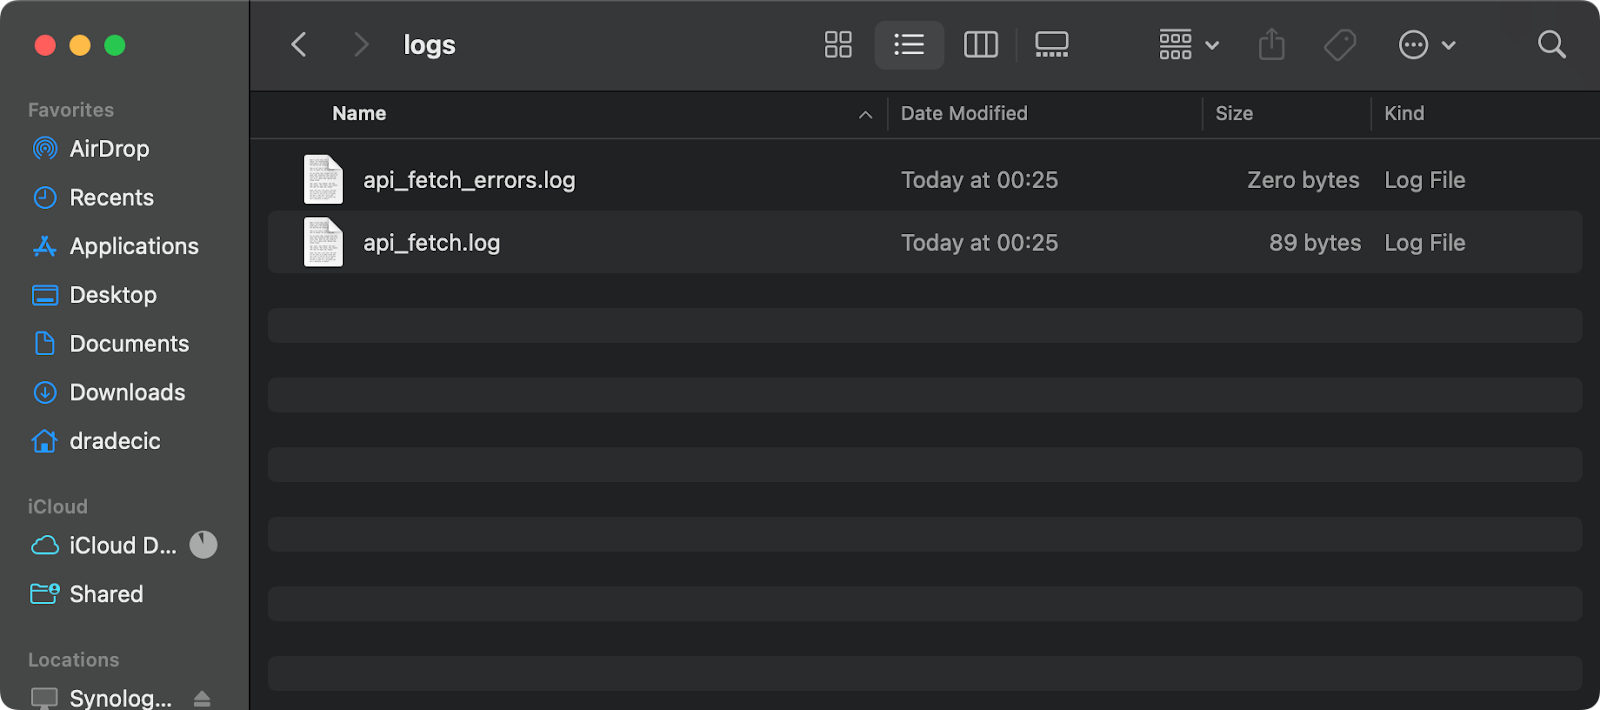
Image 10 - Fichiers de log et d’erreurs d’un cron job
Pour les jobs critiques nécessitant des notifications en cas d’échec, vous pouvez mettre en place des alertes e-mail. En supposant qu’un agent de transfert de courrier (postfix ou sendmail) soit installé, vous pouvez modifier votre cron job pour envoyer un e-mail uniquement en cas d’échec :
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1 || echo "API fetch failed on $(date)" | mail -s "Cron Job Failed" your-email@example.comIci, l’opérateur || signifie « n’exécuter la commande mail que si la commande précédente échoue ».
Pour un e-mail de « succès », utilisez :
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1 && echo "API fetch completed successfully on $(date)" | mail -s "Cron Job Succeeded" your-email@example.comVous pouvez aussi utiliser des outils de supervision plus avancéss comme Prometheus avec Node Exporter ou des services dédiés de monitoring de cron, mais ces techniques simples de logging et d’e-mail couvrent la plupart des besoins en data engineering.
Jusqu’ici, vous avez vu les commandes de base et les schémas pour capturer logs et erreurs. C’est idéal pour démarrer, mais pour la production, vous voudrez aller plus loin et intégrer les conteneurs.
Dans cette section, découvrez comment faire monter en puissance vos cron jobs pour des workflows plus sophistiqués.
Vous pouvez chaîner plusieurs commandes dans un seul cron job pour créer des workflows complexes, sans script shell séparé.
Plusieurs méthodes existent pour combiner des commandes.
Vous pouvez utiliser des points-virgules pour exécuter les commandes à la suite, même si la précédente échoue :
* * * * * cd /path/to/data && python3 extract.py; python3 transform.py; python3 load.pyOu utiliser && pour n’exécuter une commande que si la précédente réussit (arrêt au premier échec) :
* * * * * cd /path/to/data && python3 extract.py && python3 transform.py && python3 load.py >> /path/to/logs/etl.log 2>&1Autre option : || pour n’exécuter une commande que si la précédente échoue (gestion d’erreur) :
* * * * * python3 /path/to/critical_job.py || python3 /path/to/send_alert.py "Critical job failed"Pour des enchaînements plus complexes, regroupez des commandes entre parenthèses :
* * * * * (cd /path/to/data && python3 extract.py && echo "Extraction complete") && (python3 transform.py && echo "Transform complete") >> /path/to/logs/etl.log 2>&1Cette approche convient aux workflows multi‑étapes simples. Pour des pipelines très complexes avec nombreuses étapes, logique conditionnelle ou gestion d’erreurs, un script shell dédié reste préférable.
Les conteneurs Docker sont devenus essentiels dans les stacks modernes de data engineering. Vous pouvez intégrer cron à Docker de plusieurs façons puissantes pour garantir des exécutions planifiées dans des environnements isolés et cohérents.
Pour la démonstration, je modifie légèrement le script fetch_api_data.py afin d’avoir des répertoires dédiés aux données et aux logs, avec des chemins adaptés à un conteneur :
# fetch_api_data.py

import requests
import pandas as pd
import os
import uuid
from datetime import datetime

# Set file paths
data_dir = "/app/data"
log_dir = "/app/logs"
output_file = f"{data_dir}/objects_{str(uuid.uuid4())}.csv"

# Make sure the data directory exists
os.makedirs(data_dir, exist_ok=True)
os.makedirs(log_dir, exist_ok=True)


def log_message(message):
    print(f"{datetime.now().isoformat()}: {message}")


# Fetch data from the API
try:
    log_message("Starting API data fetch")
    response = requests.get("https://jsonplaceholder.typicode.com/posts")
    if response.status_code == 200:
        data = response.json()

        # Check if we have data
        if data:
            df = pd.DataFrame(
                [
                    {
                        "id": row.get("id", ""),
                        "user_id": row.get("userId", ""),
                        "title": row.get("title", ""),
                        "body": row.get("body", ""),
                    }
                    for row in data
                ]
            )

            df.to_csv(output_file, index=False)

            log_message(f"Data successfully saved to {output_file}")
        else:
            log_message("API returned empty data")
    else:
        log_message(f"API request failed with status code: {response.status_code}")
except Exception as e:
    log_message(f"Error occurred: {str(e)}")
Ainsi, les données récupérées et les logs seront sauvegardés dans le dossier /app/runs.
Créez ensuite un Dockerfile — un fichier unique qui indique à Docker comment construire et exécuter le conteneur :
FROM python:3.12-slim

# Install cron and required packages
RUN apt-get update && apt-get -y install cron \
    && pip install requests pandas \
    && rm -rf /var/lib/apt/lists/*

# Set up directories
WORKDIR /app
RUN mkdir -p /app/runs/data /app/runs/logs

# Copy our script
COPY fetch_api_data.py /app/

# Make the script executable
RUN chmod +x /app/fetch_api_data.py

# Create the crontab file
RUN echo "* * * * * root /usr/local/bin/python /app/fetch_api_data.py >> /app/runs/logs/api_fetch.log 2>&1" | tee /etc/cron.d/api-cron
RUN chmod 0644 /etc/cron.d/api-cron

# Create a startup script
RUN echo '#!/bin/sh' > /app/start.sh && \
    echo 'mkdir -p /app/runs/logs' >> /app/start.sh && \
    echo 'touch /app/runs/logs/api_fetch.log' >> /app/start.sh && \
    echo 'tail -f /app/runs/logs/api_fetch.log &' >> /app/start.sh && \
    echo 'cron -f' >> /app/start.sh
RUN chmod +x /app/start.sh

# Set entry point
CMD ["/app/start.sh"]
Presque terminé. Lancez maintenant la construction de l’image et l’exécution du conteneur Docker :
docker build --no-cache -t api-cron-job . && \
docker run --rm --name api-fetcher api-cron-job
En vous connectant au conteneur, vous verrez que le script Python s’exécute chaque minute :
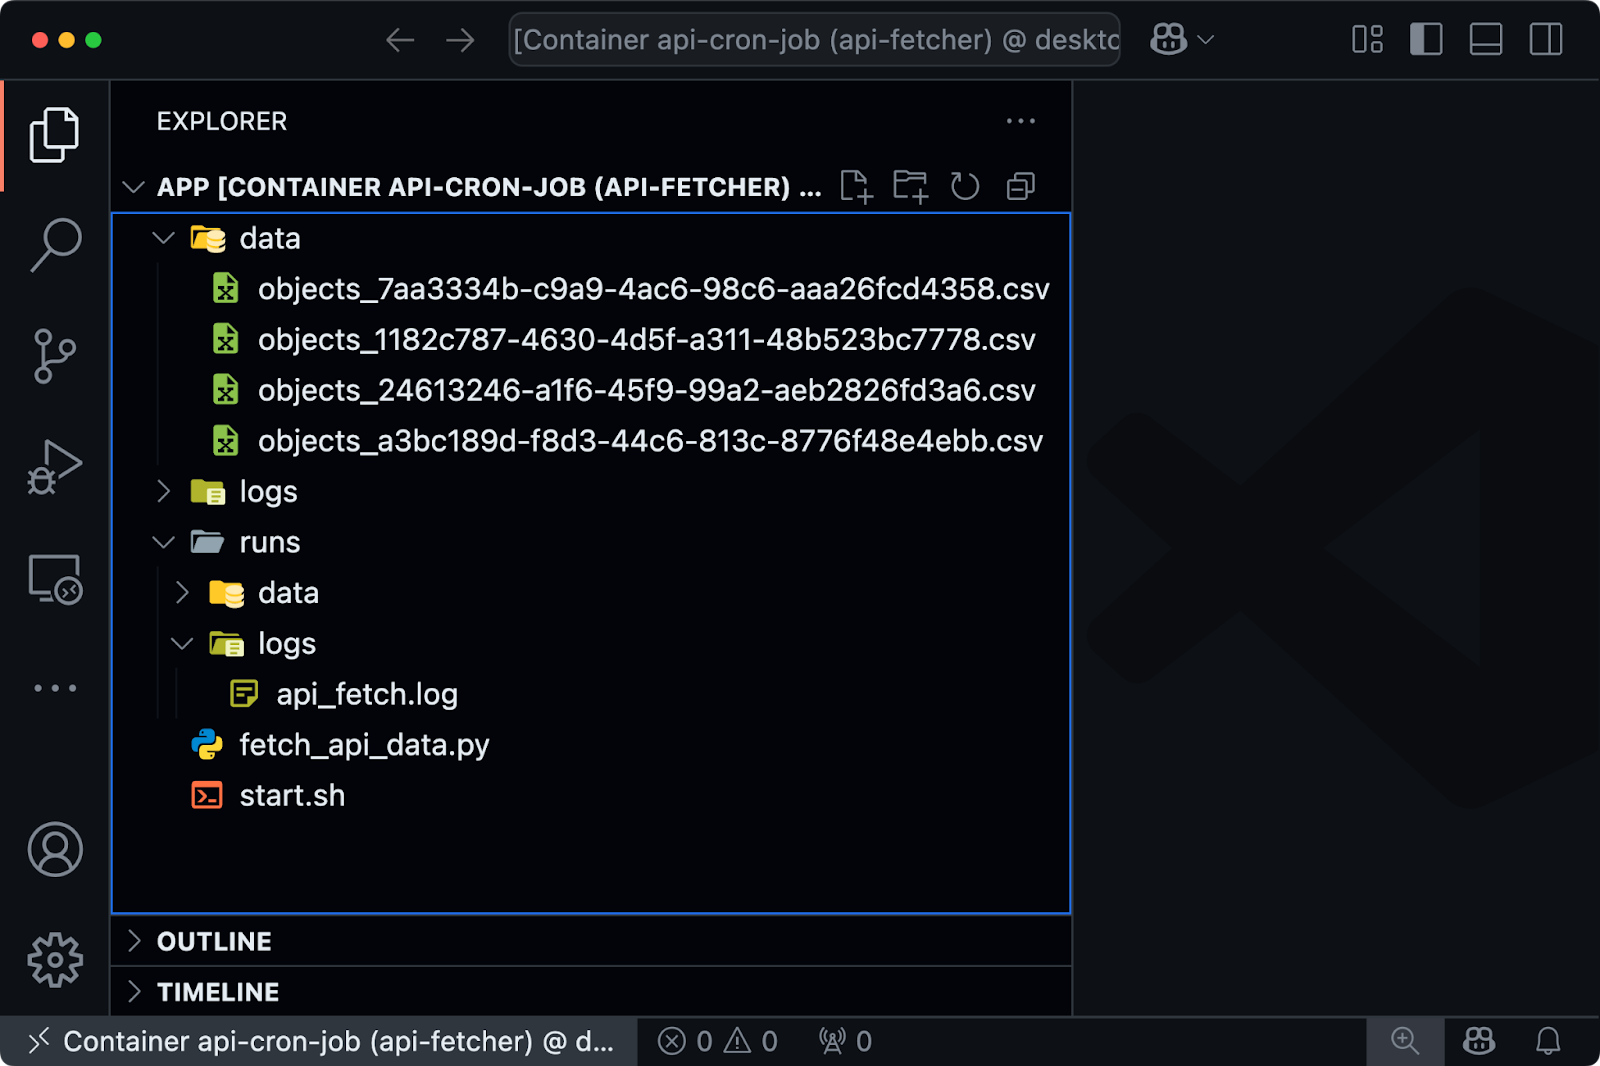
Image 11 - Cron job exécuté dans un conteneur Docker
À l’inverse, si vous souhaitez exécuter un pipeline de data engineering dans un conteneur Docker selon une planification cron, gardez fetch_api_data.py inchangé, mais modifiez le Dockerfile :
# Use Python 3.12 slim as base image
FROM python:3.12-slim

# Install required Python packages
RUN pip install --no-cache-dir requests pandas

# Set working directory
WORKDIR /app

# Copy the script into the container
COPY fetch_api_data.py /app/

# Set execution permissions
RUN chmod +x /app/fetch_api_data.py

# Run the script
CMD ["/usr/local/bin/python", "/app/fetch_api_data.py"]
Ajoutez ensuite ceci à la crontab de votre système :
*/2 * * * * cd /path/to/root/project/folder && docker build --no-cache -t api-cron-job . && docker run --rm --name api-fetcher api-cron-jobCela déclenchera la construction et l’exécution du conteneur toutes les 2 minutes.
Pour des workflows distribués, vous devez souvent exécuter des processus sur des serveurs distants. Les cron jobs peuvent déclencher ces opérations via SSH.
Par exemple, pour exécuter un cron job sur un serveur distant :
0 5 * * * ssh username@remote-server 'python3 /path/to/remote_job.py' >> /path/to/logs/remote_job.log 2>&1Pour que cela fonctionne sans demande de mot de passe, configurez une authentification SSH par clé entre les serveurs.
Pour transférer des données entre serveurs selon une planification, utilisez :
0 6 * * * scp /path/to/local/data.csv username@remote-server:/path/to/destination/ >> /path/to/logs/data_transfer.log 2>&1Pour des opérations distantes plus complexes, combinez SSH et scripts shell :
#!/bin/bash
# remote_etl.sh

# Run extraction on the data source server
ssh username@source-server 'python3 /path/to/extract.py'

# Transfer the extracted data to the processing server
scp username@source-server:/path/to/extracted_data.csv /local/temp/

# Run transformation locally
python3 /path/to/transform.py

# Transfer the transformed data to the warehouse server
scp /local/temp/transformed_data.csv username@warehouse-server:/path/to/data/

# Trigger the load process on the warehouse server
ssh username@warehouse-server 'python3 /path/to/load.py'
Puis planifiez simplement le tout avec cron :
0 7 * * * /path/to/remote_etl.sh >> /path/to/logs/remote_etl.log 2>&1Cette approche vous permet d’orchestrer des pipelines multi‑serveurs directement depuis vos cron jobs. Ça fonctionne, mais pour des workflows distribués très complexes, envisagez des outils d’orchestration dédiés comme Apache Airflow ou Prefect pour des pipelines à grande échelle.
Même les cron jobs les mieux conçus peuvent échouer ou poser problème sans pratiques opérationnelles adaptées.
En tant que data engineer, vous devez garantir des exécutions fiables, des échecs gérés proprement et une visibilité suffisante pour le diagnostic. Voici comment procéder.
Le logging est crucial pour des processus automatisés sans supervision directe. Sans logs, diagnostiquer les problèmes des cron jobs devient presque impossible.
Pour mettre en place un logging basique, redirigez sortie standard et erreurs vers des fichiers de log :
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/script.log 2>&1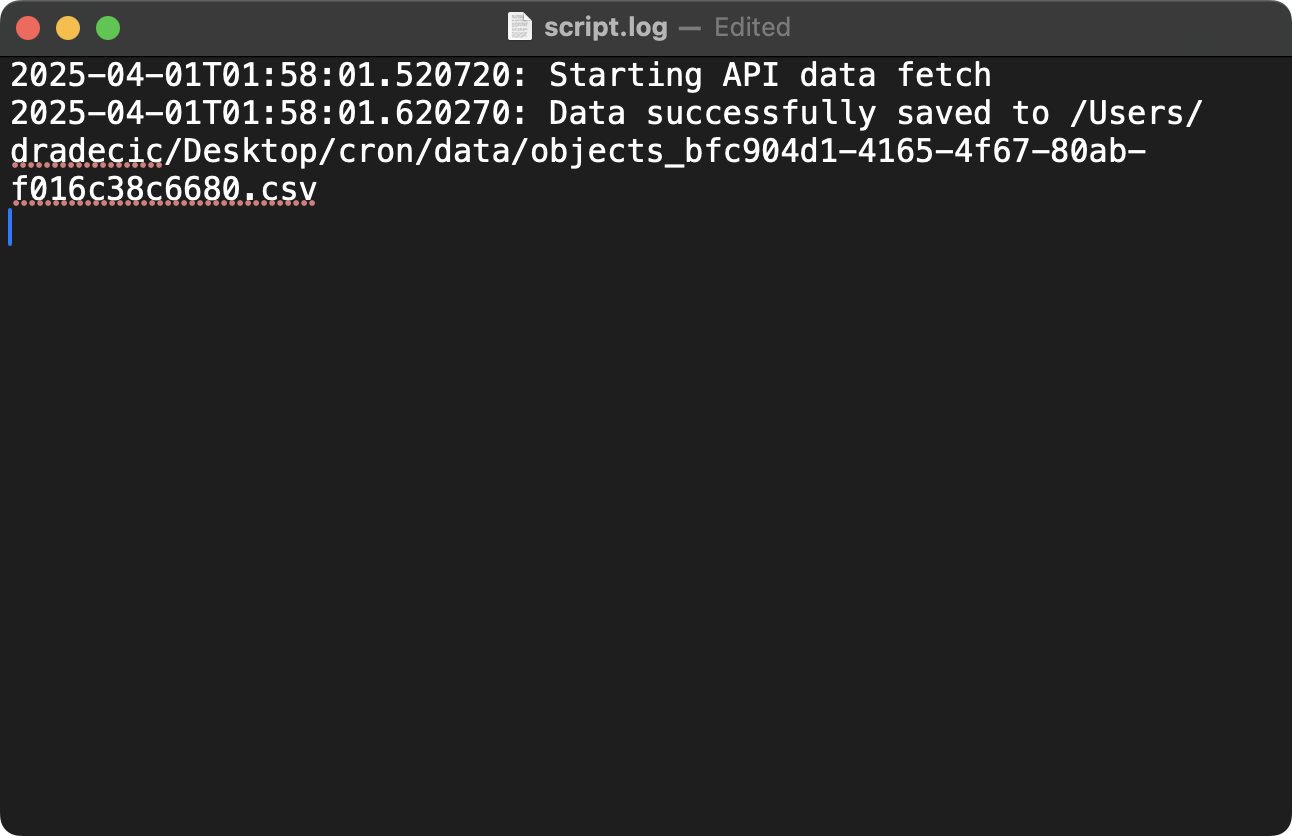
Image 12 - Configuration du logging (1)
Cette commande exécute votre script chaque minute et ajoute toute la sortie à un fichier de log. L’opérateur >> ajoute sans écraser, tandis que 2>&1 redirige erreurs (descripteur 2) et sortie standard (descripteur 1) vers le même fichier.
Pour des logs plus structurés, ajoutez des horodatages et des identifiants de job :
* * * * * (echo "=== Job started at $(date) ==="; /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py; echo "=== Job finished at $(date) with exit code $? ===") >> /Users/dradecic/Desktop/cron/logs/script.log 2>&1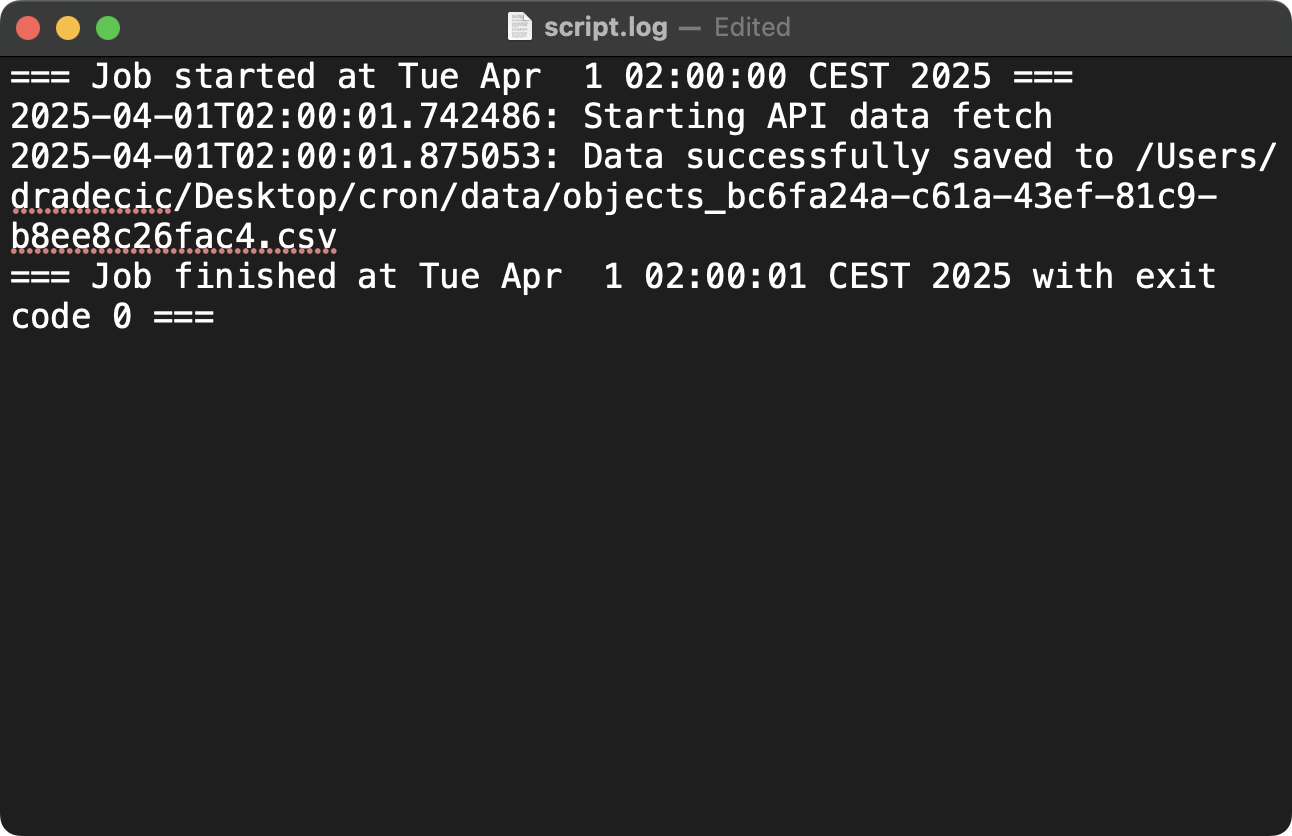
Image 13 - Configuration du logging (2)
Cette variante ajoute un marqueur de début avec horodatage, puis un marqueur de fin avec horodatage et code de sortie. Les parenthèses regroupent les commandes pour rediriger toute la sortie vers le log. La variable $? contient le code de sortie de la dernière commande (0 = succès, non‑zéro = échec).
Pour éviter que les logs n’occupent trop d’espace disque, mettez en place une rotation des journaux avec logrotate (présent sur la plupart des distributions Linux) :
Créez un fichier de configuration dans /etc/logrotate.d/cron-jobs :
/path/to/logs/*.log {
    daily
    missingok
    rotate 14
    compress
    delaycompress
    notifempty
    create 0640 username groupname
}
Cette configuration demande de :
daily)missingok)rotate 14)compress)delaycompress)notifempty)create 0640 username groupname)Le service logrotate applique ces règles (généralement une fois par jour) : il renomme le log courant (avec suffixe de date), compresse les plus anciens, supprime ceux de plus de 14 jours, et crée un nouveau fichier pour les prochaines écritures.
Des workflows robustes nécessitent des stratégies de gestion des échecs. Vous pouvez intégrer une logique de relance dans vos scripts ou vos cron jobs, ou encore relier vos cron jobs à des systèmes de monitoring.
Je vous montre ces options ci-dessous.
Logique de relance intégrée directement dans vos scripts Python, par exemple :
import time
import random

def fetch_data_with_retry(max_attempts=3, backoff_factor=1.5):
    attempt = 1
    while attempt <= max_attempts:
        try:
            # Try to fetch data
            return fetch_data()
        except Exception as e:
            print(f"Attempt {attempt} failed: {str(e)}")
            # Calculate backoff time with jitter
            backoff_time = backoff_factor ** (attempt - 1) * (random.uniform(0.8, 1.2))
            if attempt < max_attempts:
                print(f"Retrying in {backoff_time:.2f} seconds...")
                time.sleep(backoff_time)
            else:
                print("Max retry attempts reached. Giving up.")
                raise
        attempt += 1
Cette fonction met en œuvre un backoff exponentiel avec jitter :
max_attempts tentatives (3 par défaut).backoff_factor).Ce modèle est idéal pour les pannes transitoires comme les problèmes réseau ou les limites de taux d’API. L’augmentation du délai laisse le temps au système externe de se rétablir, tandis que le jitter évite l’« effet troupeau ».
Relances via cron : vous pouvez replanifier plus fréquemment qu’exigé pour retenter les jobs échoués.
Exemple avec deux cron jobs :
success_flag est créé pour empêcher une nouvelle exécution dans l’intervalle.*/10 * * * * [ ! -f /path/to/success_flag ] && python /path/to/script.py && touch /path/to/success_flag
0 0 * * * rm -f /path/to/success_flag Pour clarifier le fonctionnement :
[ ! -f /path/to/success_flag ])/path/to/script.py)touch /path/to/success_flag)0 0 * * *) supprime ce fichier pour permettre une nouvelle exécution le jour suivant.Cette technique convient aux tâches à réaliser une fois par jour, susceptibles d’échecs temporaires. Le job réessaie dans la journée jusqu’au premier succès.
Intégration au monitoring : reliez vos cron jobs à des systèmes comme Prometheus. Sujet vaste ; voici une vue d’ensemble.
Le script ci-dessous encapsule votre job réel pour collecter et pousser des métriques vers Prometheus. Étapes :
#!/bin/bash
# monitored_job.sh

# Define pushgateway URL
PUSHGATEWAY="http://prometheus-pushgateway:9091"

# Start time in seconds
START_TIME=$(date +%s)

# Run the actual job
/path/to/actual_job.sh
EXIT_CODE=$?

# End time in seconds
END_TIME=$(date +%s)
DURATION=$((END_TIME - START_TIME))

# Push metrics to Prometheus
cat <<EOF | curl --data-binary @- ${PUSHGATEWAY}/metrics/job/cron_job/instance/$(hostname)
# HELP cron_job_duration_seconds How long the cron job took to execute
# TYPE cron_job_duration_seconds gauge
cron_job_duration_seconds{name="data_extraction"} ${DURATION}

# HELP cron_job_exit_code Exit code of the cron job
# TYPE cron_job_exit_code gauge
cron_job_exit_code{name="data_extraction"} ${EXIT_CODE}

# HELP cron_job_last_run_timestamp Timestamp of last job run
# TYPE cron_job_last_run_timestamp gauge
cron_job_last_run_timestamp{name="data_extraction"} ${END_TIME}
EOF

exit ${EXIT_CODE}
Ces métriques vous permettent de :
Le Pushgateway joue l’intermédiaire : il permet à un job de courte durée de pousser ses métriques vers Prometheus pour stockage, alerting et visualisation.
Les fuseaux horaires sont souvent source de complexité en data engineering, notamment avec des sources mondiales ou des systèmes distribués.
Sans surprise, les cron jobs sont sensibles à la configuration du fuseau.
Par défaut, cron utilise le fuseau horaire local du système. Vérifiez-le avec cette commande Linux :
timedatectlCette commande affiche l’heure et le fuseau actuels du système. Si votre serveur est en America/New_York, toutes les planifications seront interprétées dans ce fuseau.
Pour une planification cohérente quel que soit l’emplacement du serveur ou l’heure d’été, utilisez l’UTC dans vos cron jobs :
# Set the CRON_TZ environment variable at the top of your crontab
CRON_TZ=UTC

# Now all job schedules will use UTC
0 0 * * * /path/to/daily_job.sh
En ajoutant CRON_TZ=UTC en tête de votre crontab, vous demandez à cron d’interpréter toutes les heures en UTC plutôt qu’en heure locale.
Votre job s’exécutera donc chaque jour à minuit UTC, indépendamment du fuseau local du serveur ou des changements d’heure. L’UTC ne varie jamais, ce qui en fait une référence fiable.
Pour un·e data engineer, les cron jobs sont des outils précieux.
Ils automatisent les tâches répétitives et renforcent la fiabilité des pipelines. Ils offrent un moyen simple et puissant de planifier des scripts et d’orchestrer des processus ETL multi‑étapes. La syntaxe demande un petit temps d’adaptation, mais devient vite naturelle.
Au moment d’industrialiser vos cron jobs, gardez en tête les bonnes pratiques de logging, de gestion d’erreurs et de fuseaux horaires. Des logs adaptés améliorent la visibilité et simplifient le diagnostic. Une bonne gestion des erreurs avec relances assure la résilience face aux pannes transitoires. Une gestion soignée des fuseaux garantit des plannings cohérents, surtout avec des sources mondiales ou des équipes distribuées.
>Vous visez un poste de Data Engineer en 2025 ? Voici 5 compétences essentielles à maîtriser.
Bien sûr, des outils spécialisés d’orchestration de workflows comme Apache Airflow ou Prefect offrent des fonctionnalités avancées pour des pipelines complexes, mais cron reste pertinent pour de nombreux besoins du data engineering. Simple, fiable et léger — parfait pour l’automatisation.
Pour en savoir plus sur le data engineering, inscrivez-vous à ces cours DataCamp :
Nos programmes de certification vous aident à vous démarquer et à prouver aux employeurs potentiels que vos compétences sont adaptées à l'emploi.

Approfondissez le data engineering avec ces cours !
Cours
Cours
Cours