
50% off DataCamp Premium. 700+ courses, half price. Start learning today.
Sinds de lancering van ChatGPT lijkt er elke paar dagen een nieuw Large Language Model (LLM) te verschijnen, samen met nieuwe bedrijven die zich in deze technologie specialiseren. Elk nieuw LLM is getraind om zijn voorganger op verschillende manieren te overtreffen. Zo zien we steeds vaker LLM’s die zijn afgestemd op een specifieke usecase: chatmodellen, code-assistenten en begrip van lange context, om er maar een paar te noemen.
Het kiezen van het juiste model voor een nieuwe LLM-gebaseerde applicatie of project kan een flinke uitdaging zijn, om nog maar te zwijgen van het bijhouden van de nieuwste modellen en hun functies.
In mijn geval leidt dit er vaak toe dat ik standaard ChatGPT of GPT-modellen via API-calls gebruik.
Hier wil ik ingaan op het brede scala aan beschikbare modellen en de belangrijkste mogelijkheden uitlichten waar je op moet letten bij het kiezen van het juiste model voor de kenmerken van je project.
We focussen vooral op de verschillende manieren om met deze modellen te interageren, als een van de sleutelfuncties om rekening mee te houden bij de keuze tussen alle beschikbare modellen.
Het doel is dat deze uitgebreide gids dient als een spiekbrief die je helpt te navigeren door de enorme keuze aan LLM’s voor jouw specifieke taken.
Als je nieuw bent in de LLM-wereld, raad ik je aan de cursus AI Fundamentals en Large Language Models Concepts te volgen om vertrouwd te raken met de basisbegrippen en modellen.
Toegang krijgen tot LLM’s en ermee interfacen in een LLM-gestuurde applicatie of project kan op verschillende manieren, afhankelijk van de technische behoeften.
De meest gebruiksvriendelijke manier om met LLM’s te interfacen is via conversatie-interfaces in de browser. Dit is het geval bij ChatGPT, waar de gebruikersinterface simpelweg een chat is waarmee je met het model kunt communiceren.
Over het algemeen bieden deze interfaces weinig tot geen controle of modelaanpassing door de gebruiker, maar het is een makkelijke manier om modellen voor eenvoudige taken te proberen. ChatGPT van OpenAI en Google’s Gemini bieden dit soort interfaces:
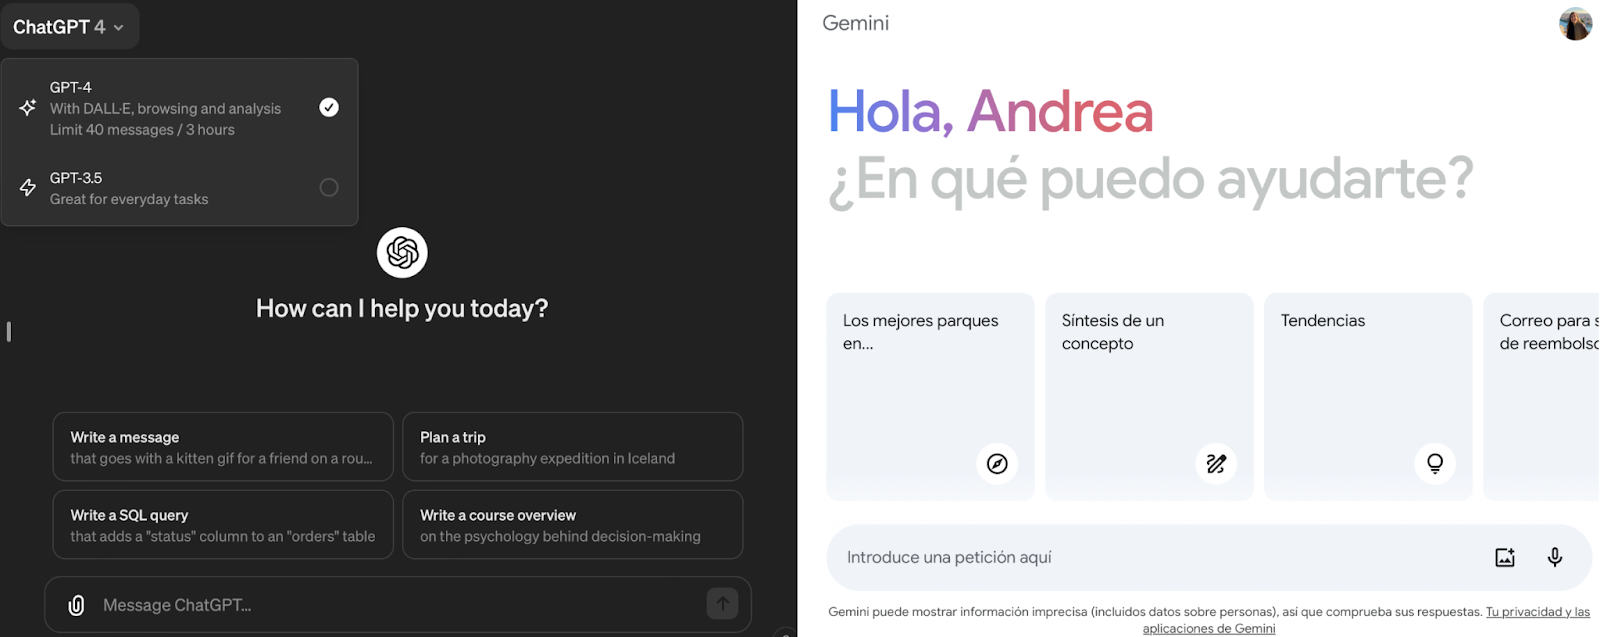
Schermafbeelding van de chatinterfaces van OpenAI’s ChatGPT (links) en Google’s Gemini (rechts).
Soms bieden providers ook een zekere mate van aanpassing via vergelijkbare, gebruiksvriendelijke chatinterfaces. In het geval van OpenAI heet het platform “Playground”.
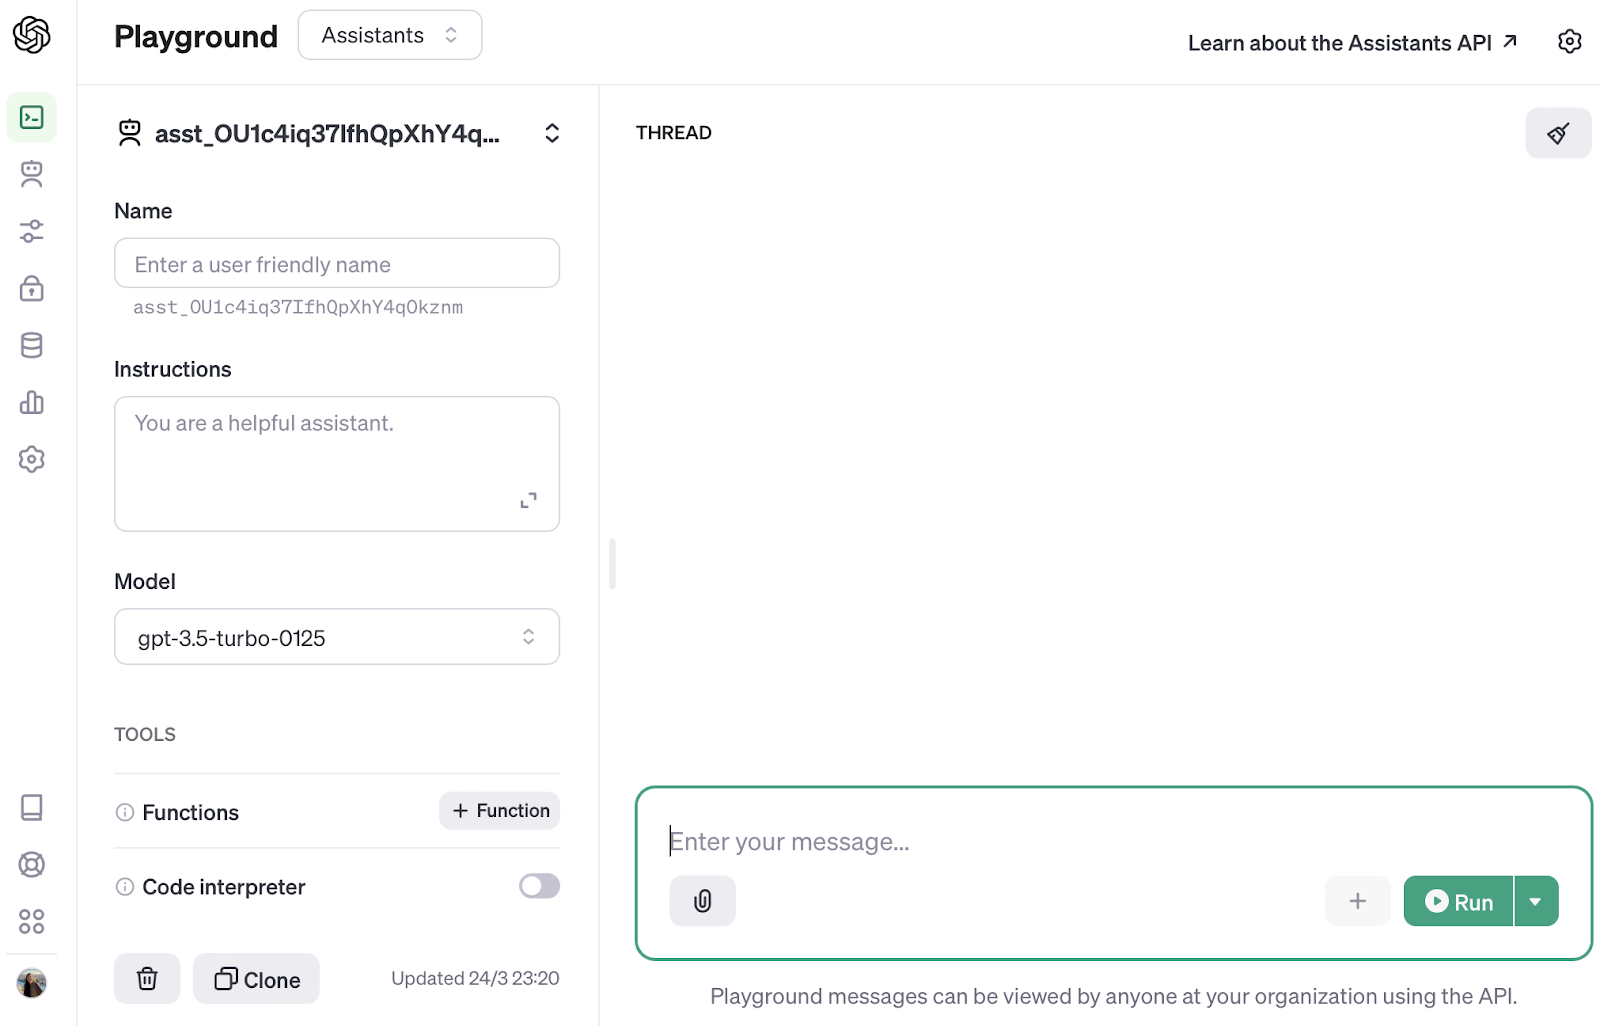
Schermafbeelding van de OpenAI Playground-interface.
Met playground-interfaces kunnen we verschillende modellen uitproberen met beperkte controle over de instellingen. Zo kunnen we verkennen welke parameters geschikt zijn voor jouw taak. Maar zoals je waarschijnlijk al gemerkt hebt, maken playground- of chatinterfaces het niet mogelijk om de interactie met de LLM in een applicatie of project in te bedden.
Een van de populairste interfaces om LLM’s te bevragen is via API-toegang. Deze aanpak is vooral handig wanneer we geen verdere modelaanpassing nodig hebben.
API-calls kun je naadloos in je scripts integreren, zonder dat je zelf infrastructuur hoeft op te zetten en te onderhouden.
Het gemak heeft echter een prijs, en ondanks de afhankelijkheid van externe services — een afhankelijkheid die je altijd zult hebben als je het model niet zelf host en de benodigde infrastructuur niet beheert — zullen de kosten onvermijdelijk met het gebruik meegroeien.
Bij API-calls is het een goede gewoonte om een eenvoudige wrapper rond de API-call te implementeren om op een modulaire manier met het model te interfacen. Voor de OpenAI API, die ik tot nu toe het meest heb gebruikt, gebruik ik altijd de wrapper in de volgende sectie, zodat de modelkeuze transparant is voor de gebruiker.
Een gestandaardiseerde maar flexibele methode schrijven om GPT-modellen via de OpenAI API te bevragen is erg nuttig als je soepel en minder foutgevoelig met het model wilt interfacen. Daarom zet ik de GPT-call meestal op in een wrapperfunctie aan het begin van het programma, zodat het gebruik van het model transparant is voor de applicatie.
De bibliotheek openai (pip install openai) biedt al een ChatCompletion-endpoint dat ons in staat stelt elk GPT-model aan te roepen met de methode .create.
De methode .create heeft twee verplichte parameters:
gpt-4.Met deze twee parameters kunnen we de GPT-call als volgt schrijven:
prompt = "Hello world"
chat_completion = openai.ChatCompletion.create(model="gpt-3.5-turbo", messages=[{"role": "user", "content": prompt}])
Bij het aanroepen van het model krijgen we de completion terug in JSON-indeling:
{
 "choices": [
   {
     "finish_reason": "stop",
     "index": 0,
     "message": {
       "content": "Hello! How can I assist you today?",
       "role": "assistant"
     }
   }
 ],
 "created": 1692042919,
 "id": "chatcmpl-7nXwl0tywcTb91xeEuhpQbpRD6XLM",
 "model": "gpt-3.5-turbo-0613",
 "object": "chat.completion",
 "usage": {
   "completion_tokens": 9,
   "prompt_tokens": 9,
   "total_tokens": 18
 }
}
Daarom is het handig om alleen de modelcompletion als returnwaarde te krijgen. Als we alle onderdelen bij elkaar zetten, kan onze wrapper-implementatie er zo uitzien:
def chatgpt_call(prompt, model="gpt-3.5-turbo"):
   response = openai.ChatCompletion.create(
       model=model,
       messages=[{"role": "user", "content": prompt}]
   )
   return response.choices[0].message["content"]
Als je meer wilt weten over deze implementatie, gaat het artikel ChatGPT API Calls: A Gentle Introduction dieper op de details in!
Tot slot is het ook goed om te weten dat de meeste API-providers, waaronder OpenAI, een aantal gratis calls aanbieden wanneer je je account aanmaakt. De credits zijn echter beperkt (meestal minder dan $20) en doorgaans geldig binnen een tijdsvenster (meestal een maand).
Het is in ieder geval altijd een goede gewoonte om de LLM-calls in een functie — of een verzameling functies — te wikkelen, zodat het model transparant is voor de applicatie, ongeacht de provider.
Het model zelf hosten houdt in dat je de modelgewichten downloadt en het draait op lokale machines of privéservers.
Deze aanpak is aantrekkelijk omdat je volledige controle hebt over de modelinfrastructuur, maar het betekent ook dat de technische inspanning aanzienlijk toeneemt.
Ben je benieuwd naar de stappen die komen kijken bij het draaien van de infrastructuur voor een LLM? Bekijk dan het artikel LLMOps Essentials!
Het model lokaal draaien maakt verdere aanpassing mogelijk naar onze behoeften. In deze context is een van de populairste keuzes voor self-hosting de bekende LLaMa-modellen van Meta AI. Zij hebben lichte modellen uitgebracht die je op een laptop met slechts 8GB RAM kunt draaien.
Het LLaMa-model op onze laptop draaien is vrij eenvoudig dankzij platforms zoals Ollama.
Ollama biedt een platform voor het lokaal draaien van LLM’s zoals LLaMa 2 en Code LLaMa op onze apparaten. Het ondersteunt macOS, Linux en Windows, en maakt aanpassing en het creëren van eigen modellen mogelijk. Meer details vind je op de website van Ollama.
Het downloaden van het Ollama-platform kan via de officiële pagina, terwijl de modelgewichten rechtstreeks via de terminalinterface kunnen worden opgehaald.
Laten we eerst Ollama installeren door naar de hoofdpagina te gaan!
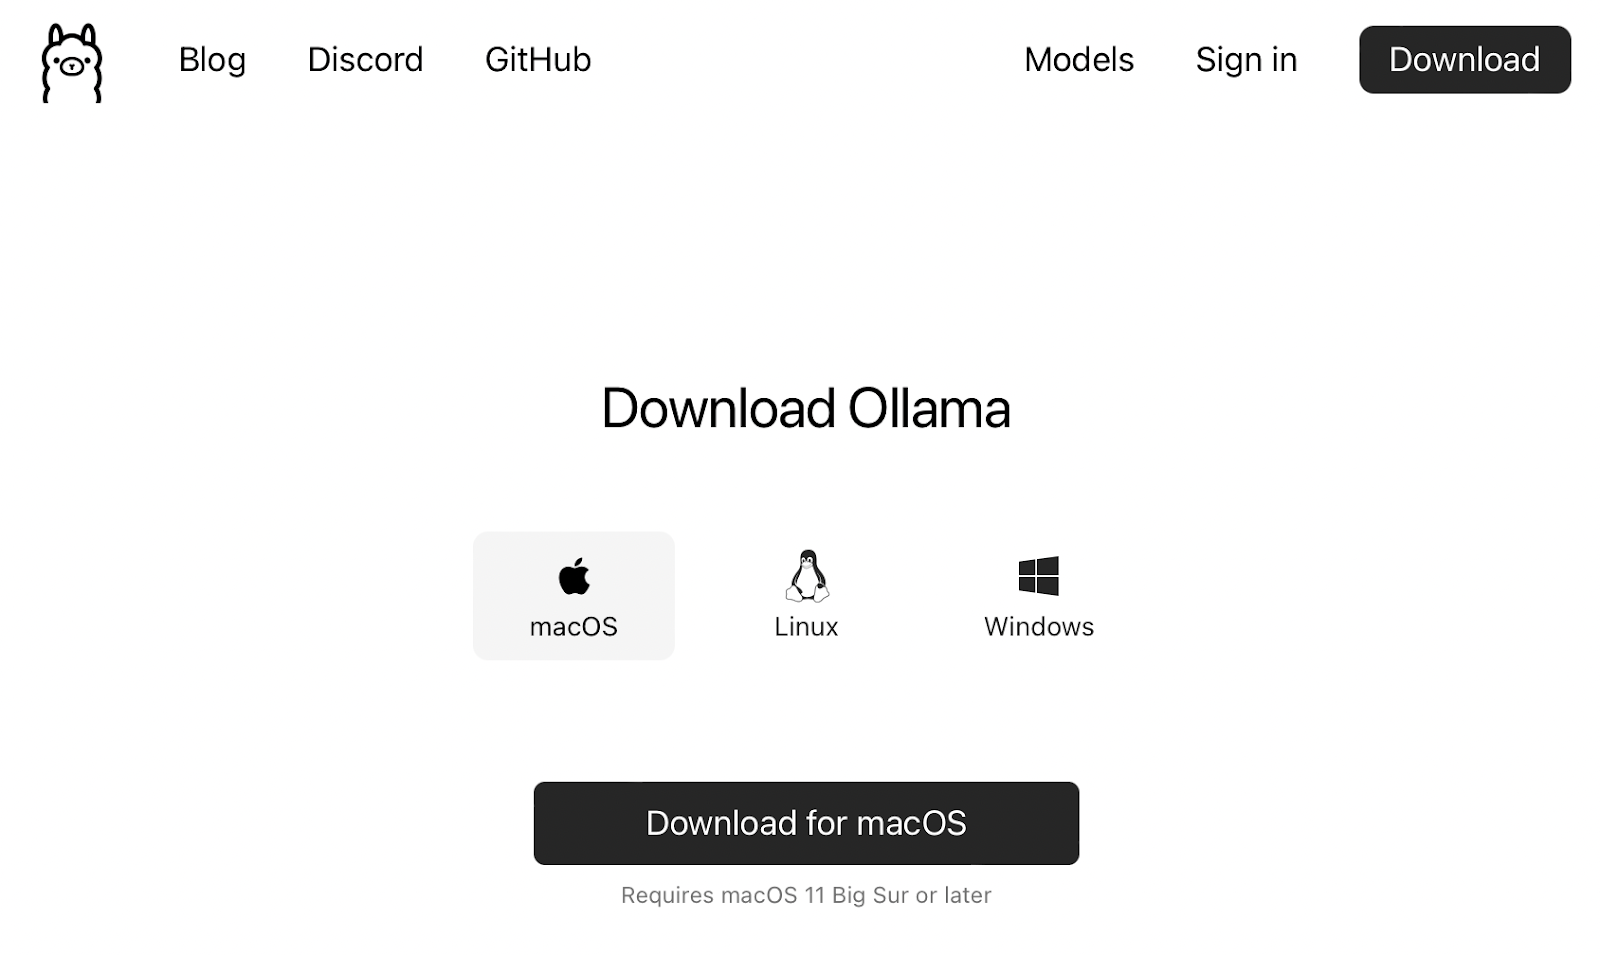 Schermafbeelding van de hoofdpagina van de website van Ollama.
In dit geval is Ollama een commandline-hulpprogramma:
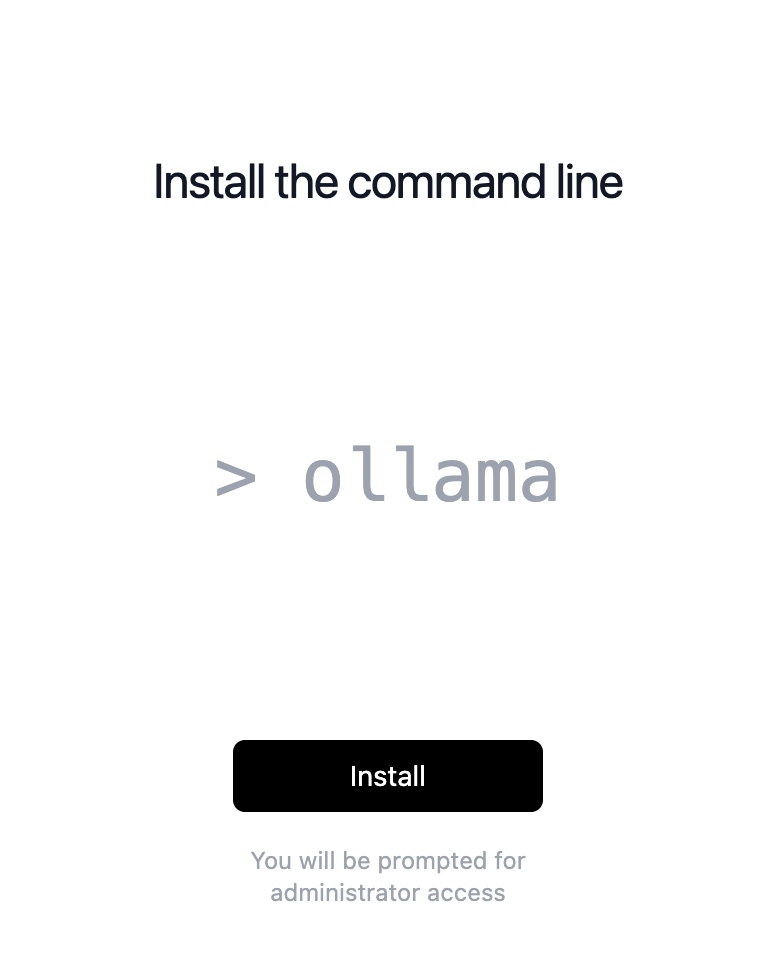
Schermafbeelding van de installatie van de commandline-tool van Ollama.
Zodra de commandline-tool is geïnstalleerd, kunnen we het model starten met het commando ollama run <model name>. Als het de eerste keer is dat we het model op ons apparaat draaien, zal Ollama het voor ons ophalen:
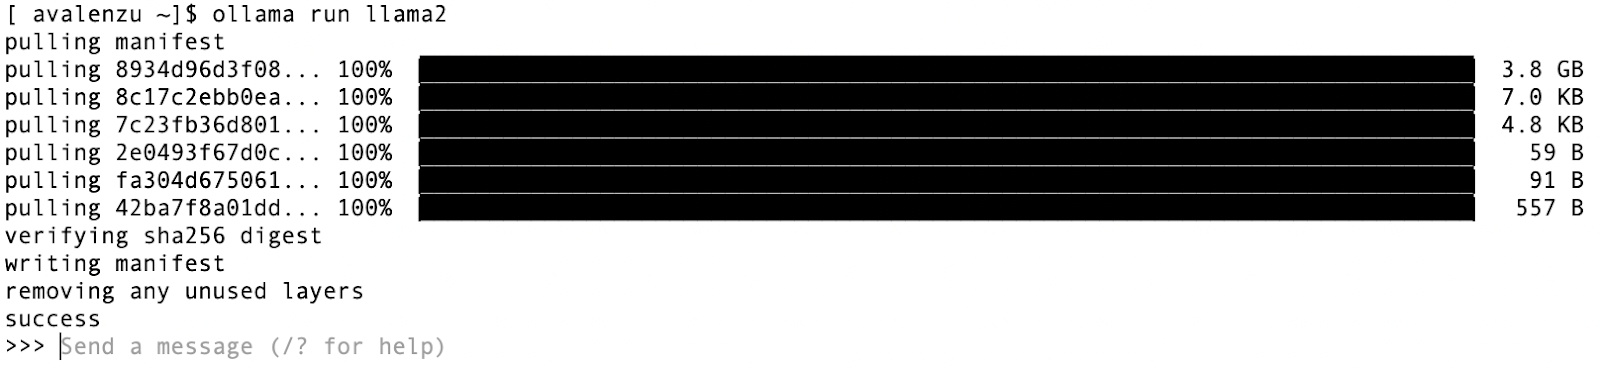
Schermafbeelding van de eerste run van het LLaMa 2-model met de commandline-tool van Ollama. Het model wordt automatisch opgehaald bij eerste gebruik.
Vanaf dat moment is het aansturen en afsluiten van het model via de commandline heel eenvoudig:
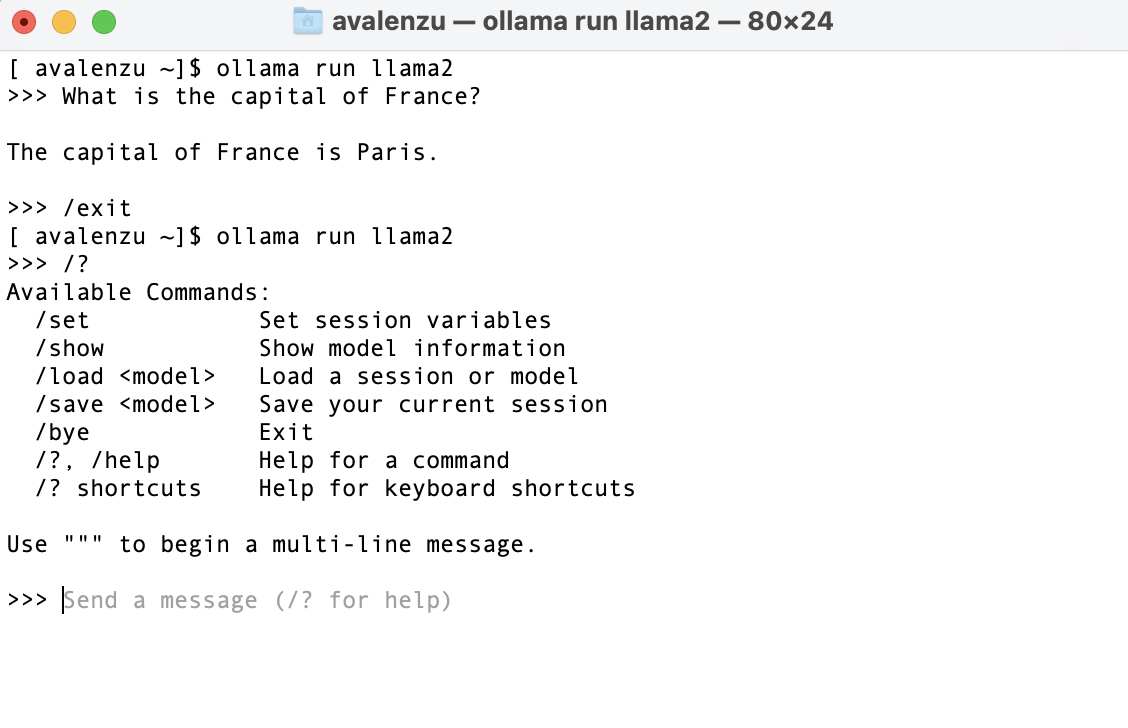
Schermafbeelding van de gebruikersinteractie met het model via de commandline-tool van Ollama.
Zoals we in de afbeelding hierboven zien, heeft het model ook een kleine set extra commando’s beschikbaar.
Ollama ondersteunt ook andere modellen, zoals de nieuwe Mistral:
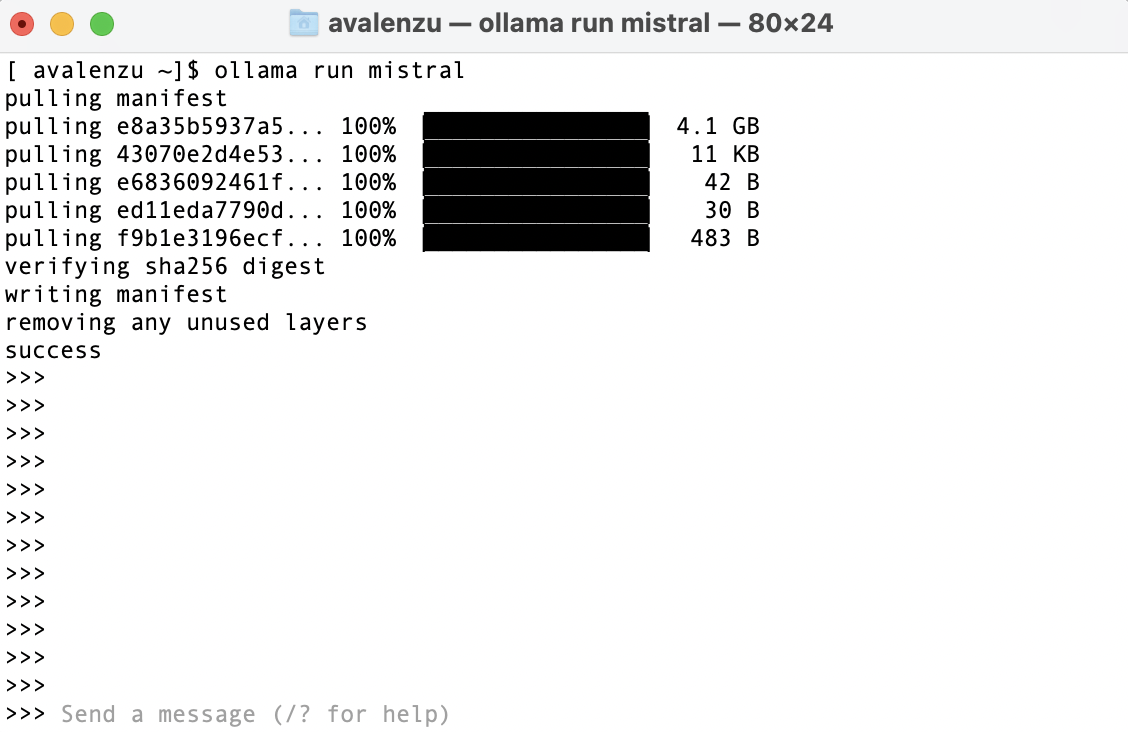
Schermafbeelding van de eerste run van het Mistral-model met de commandline-tool van Ollama. Het model wordt automatisch opgehaald bij eerste gebruik.
Het model is opnieuw out-of-the-box klaar voor gebruik met één enkel commando!
Deze aanpak is voordelig omdat het alleen middelen van ons eigen apparaat verbruikt. Het is echter belangrijk om te onthouden dat de modelprestaties over het algemeen toenemen met het aantal parameters.
Daarom geldt: hoe meer parameters een model heeft, hoe meer resources het zal vereisen. Grotere modellen zullen dus waarschijnlijk op privéservers moeten draaien voor self-hosted LLM-applicaties.
Als we een grootschalige applicatie willen bouwen, is het goed om te weten dat Ollama ook met Docker Desktop op Mac kan draaien en binnen Docker-containers met GPU-versnelling op Linux.
Misschien vraag je je nu af: kan ik OLLAMA in mijn scripts inbedden?
Jazeker, het model zelf hosten betekent niet dat je het niet in je Python-scripts kunt integreren! Ollama biedt ook de mogelijkheid om via Python met je self-hosted model te interfacen.
De Python- en JavaScript-bibliotheken van Ollama stellen ons in staat de modelinference in onze scripts op te nemen.
Ollama is niet onze enige optie als we het model zelf willen hosten. In het algemeen zijn LLM’s vaak te downloaden op meerdere open-sourceplatforms die ook community-ondersteuning bieden.
Open-source LLM’s zijn doorgaans kosteloos beschikbaar voor academische en onderzoeksdoeleinden. Voor commercieel gebruik kunnen de voorwaarden echter verschillen, afhankelijk van de specifieke licentie waaronder een model is vrijgegeven. Wees je er altijd van bewust of je met LLM’s experimenteert of LLM-gebaseerde applicaties voor commerciële doeleinden bouwt.
Wil je vandaag nog aan de slag met het ontwikkelen van LLM’s? Dan is de cursus Developing Large Language Models iets voor jou!
Het lokaal hosten van krachtige modellen kan zeer resource-intensief zijn, daarom kunnen clouddiensten een haalbaar alternatief zijn: schaalbare resources on demand en ondersteuning van cloudproviders.
Het is noemenswaardig dat traditionele clouddiensten zoals Azure nu aangepaste pipelines bieden om LLM’s, zoals Mistral, te hosten, zodat we geen gespecialiseerde hosting hoeven te implementeren.
Dit is een groot voordeel voor het uitrollen van applicaties binnen je organisatie, aangezien veel bedrijven al contracten met deze providers hebben voor diensten zoals e-mail en algemene cloudoplossingen.
Kiezen voor third-party providers kan een balans bieden tussen het niet beheren van de hostinfrastructuur en toch enige controle over het model, vergeleken met het simpelweg gebruiken van een native API-service.
Deze providers bieden doorgaans API-toegang, maar het is belangrijk te beseffen dat de kosten bij intensief gebruik aanzienlijk kunnen oplopen, vergelijkbaar met het gebruik van de native OpenAI API.
Het belangrijkste verschil zit in wie er host. Third-party providers, en niet de native LLM-services, hosten het model op hun infrastructuur en stellen het API-endpoint bloot, vaak met een verscheidenheid aan modellen uit verschillende bronnen voor flexibele integratie.
Een populaire third-party API-provider is de LLAMA API.
Schermafbeelding van de hoofdpagina op de LLAMA API-website.
De API is niet gratis, maar je kunt hem wel gratis uitproberen, want er wordt $5 aan gratis tegoed toegekend aan elk nieuw account. Houd er wel rekening mee dat die credits slechts één maand geldig zijn nadat ze zijn uitgegeven.
De LLAMA API gebruiken is heel eenvoudig. Zodra deze is geïnstalleerd (pip install llamaapi), kunnen we een eerste proefcall doen als volgt:
from llamaapi import LlamaAPI
import json

llama = LlamaAPI('<Insert API key here>')
prompt = "Which is the capital of France?"

api_request_json = {
  "model": "llama-13b-chat",
  "messages": [
    {"role": "system", "content": "You are a friendly chatbot."},
    {"role": "user", "content": prompt},
  ]
}

response = llama.run(api_request_json)
print(json.dumps(response.json(), indent=2))
Maar net als bij de OpenAI API is het een goede gewoonte om de API-call in een wrapperfunctie in te bedden. Volgens dezelfde aanpak als hiervoor:
def llm_call(prompt, model="llama-13b-chat"):
    api_request_json = {
        "model": model,
        "messages": [
            {"role": "system", "content": "You are a friendly chatbot."},
            {"role": "user", "content": prompt},
        ]
    }
    response = llama.run(api_request_json)
    return response.json()["choices"][0]["message"]["content"]
Met deze implementatie krijgen we de stringresponse terug van de LLM door simpelweg llm_call() aan te roepen:
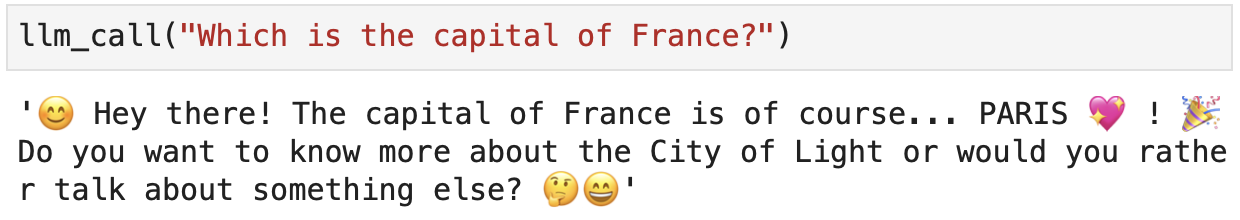
LLAMA API ondersteunt een verscheidenheid aan state-of-the-art modellen, niet alleen LLaMa van Meta. In de volgende sectie ontdekken we welke modellen worden ondersteund!
Tot slot: bij LLAMA API hangen de API-kosten af van het aantal parameters van het model, en de prijs lijkt constant over alle modellen heen:
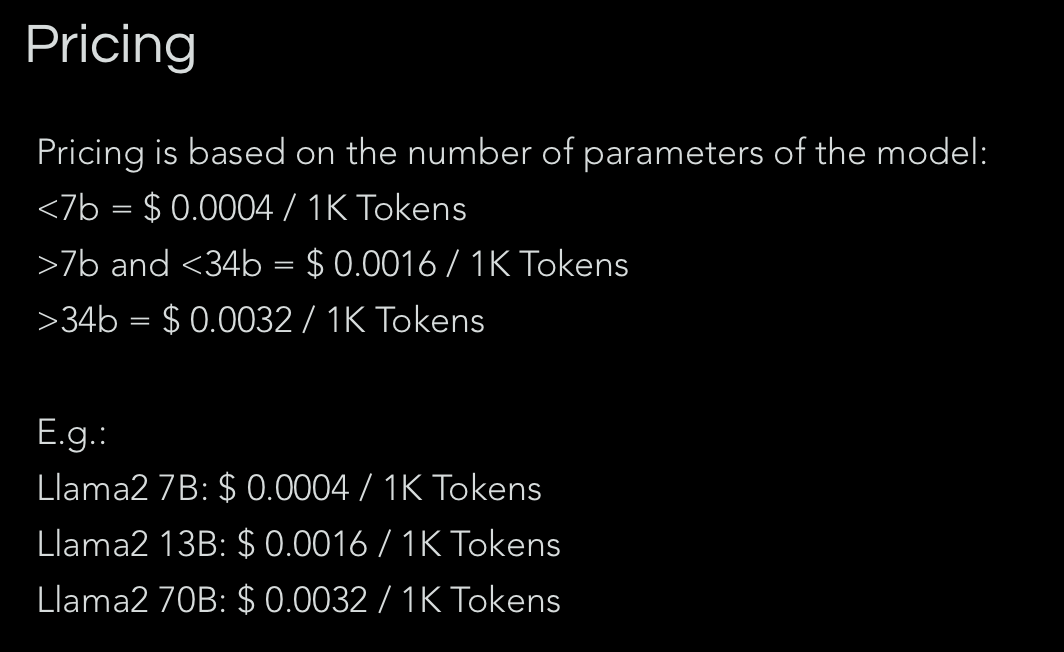
Schermafbeelding van de LLAMA API-prijzen. Deze informatie is pas beschikbaar nadat je een account hebt aangemaakt.
De populairste third-party provider voor LLM’s is Hugging Face. Hugging Face staat vooral bekend om zijn transformers-bibliotheek, de populairste Python-bibliotheek voor Natural Language Processing.
Hugging Face biedt meerdere interfaces om toegang te krijgen tot LLM’s. Het heeft een gebruiksvriendelijke playground-interface genaamd “Spaces”:

Schermafbeelding van de “Spaces”-playground in Hugging Face.
Het maakt ook modelhosting en endpoint-deployment mogelijk, evenals directe download en lokaal gebruik van de modellen.
Houd er rekening mee dat Hugging Face een soort “ontwikkelaarsite” is. Hoewel je er tutorials vindt om te starten, vereist het opschalen van een applicatie met hun modellen technische kennis.
Wil je meer leren over Hugging Face? Dan raad ik het artikel What is Hugging Face? The AI Community's Open-Source Oasis sterk aan.
Een aanvullende tool die ik vaak gebruik om LLM-gestuurde applicaties from scratch te bouwen, samen met Hugging Face, is LangChain. De tutorial How to Build LLM Applications with LangChain biedt een fijne, praktijkgerichte introductie.
We hebben de verschillende methoden besproken om toegang te krijgen tot en LLM’s te draaien, zoals GPT-, LLaMa- en Mistral-modellen. Er zijn echter nog veel meer modellen beschikbaar, inclusief diverse varianten van de genoemde. In deze sectie classificeren we de belangrijkste modellen die vandaag bestaan, met hun kenmerken, prijzen en usecases.
OpenAI-modellen zijn erg populair geworden sinds de lancering van ChatGPT, dat nu wordt aangedreven door GPT-3.5 of GPT-4, afhankelijk van je abonnement. Voor veel basistaken is het verschil tussen GPT-3.5 en GPT-4 niet groot.
GPT-4 toont echter veel meer capaciteit in complexere redeneerscenario’s dan eerdere modellen.
Daarnaast is GPT-4 een multimodaal model dat tekst- of beeldinvoer accepteert en tekst uitvoert. Het biedt ook de mogelijkheid om plug-ins te gebruiken om met externe bronnen te interfacen. Browsen op internet is hier een voorbeeld van, zoals met Bing-zoekopdrachten.
Er zijn drie hoofdvarianten van GPT-4 toegankelijk via de OpenAI API voor betalende klanten:
|
Model |
Kenmerken |
Contextvenster |
API |
Lokaal |
Tokenprijs |
Trainingsdata |
|
GPT-4 |
Momentopname van gpt-4 van 13 juni 2023. Dit endpoint ontvangt constante updates. Geoptimaliseerd voor chat. |
8.192 tokens |
Nee |
$0,03 / 1K tokens (input) $0,06 / 1K tokens (output) |
dec 2023 |
|
|
GPT-4 Turbo |
API-naam is gpt-4-turbo-preview. Blinkt uit in taken zoals codegeneratie en is bedoeld om gevallen van “laziness” te verminderen. |
128k tokens |
Nee |
$0,01 / 1K tokens (input) $0,03 / 1K tokens (output) |
dec 2023 |
|
|
GPT-4 Vision |
API-naam is gpt-4-vision-preview. GPT-4 met het vermogen om beelden te begrijpen, naast alle andere GPT-4 Turbo-mogelijkheden. |
128k tokens |
Nee |
$0,01 / 1K tokens (input) $0,03 / 1k tokens (output) |
apr 2023 |
In het algemeen is het interessant om op te merken dat GPT-modellen, in tegenstelling tot LLaMa-modellen, closed source zijn. Dat betekent dat we ze niet lokaal kunnen draaien of een eigen endpoint kunnen uitrollen.
Er is echter wel de mogelijkheid tot maatwerk via de OpenAI Fine-tuning API. Bovendien zijn ze niet toegankelijk via third-party providers zoals Ollama, LLAMA API of Hugging Face.
Wat de OpenAI Playground betreft, de informatie over het onderliggende model wordt niet duidelijk weergegeven, maar het lijkt gebaseerd op het GPT-4-model met DALL·E-, browse- en analysemogelijkheden.
Laten we ook kijken naar de beschikbare GPT-3-modellen!
|
Model |
Kenmerken |
Contextvenster |
API |
Lokaal |
Tokenprijs |
Trainingsdata |
|
GPT-3.5 Turbo |
API-naam is gpt-3.5-turbo. Het vlaggenschipmodel van deze familie. Geoptimaliseerd voor dialoog en nauwkeuriger in het beantwoorden in gevraagde formats. |
16.385 tokens |
Nee |
$0,0005 / 1K tokens (input) $0,0015 / 1K tokens (output) |
sep 2021 |
|
|
GPT-3.5 Turbo Instruct |
API-naam is gpt-3.5-turbo-instruct. Focust op nauwkeurigheid en relevantie in de antwoorden, in nauwe afstemming met de behoeften van de gebruiker. |
4.096 tokens |
Nee |
$0,0015 / 1K tokens (input) $0,0020 / 1K tokens (output) |
sep 2021 |
Het in de tabel gepresenteerde GPT-3.5 Turbo Instruct-model is fijngestemd om de intenties van de gebruiker beter te volgen via Reinforcement Learning from Human Feedback (RLHF).
RLHF is een techniek waarbij menselijke feedback in het reinforcement learning-proces wordt geïntegreerd om de leerresultaten van AI-agenten te sturen en te verbeteren. Deze aanpak maakt het mogelijk om modellen te ontwikkelen die beter aansluiten bij menselijke waarden en voorkeuren, door menselijke oordelen, correcties of voorkeuren direct in de trainingscyclus op te nemen.
Tot slot is het, zoals we in de tabel zien, vermeldenswaard dat het gebruik van een van de twee GPT-3.5-modellen aanzienlijk goedkoper is dan GPT-4.
In dit opzicht raad ik meestal aan de prestaties van elk model te vergelijken op een set goed gedefinieerde voorbeelden om te zien of GPT-3.5 voldoende is voor mijn taak, en zo op inferentiekosten te besparen.
Zoals we in de vorige secties hebben besproken, zijn LLaMa-modellen gratis te downloaden en lokaal te draaien of beschikbaar als basis om maatwerk op te bouwen.
De LLaMa-modellen vormen eigenlijk een grote familie van open modellen qua grootte en varianten, aangeboden door Meta AI:
|
Model |
Kenmerken |
Contextvenster |
API |
Lokaal |
Variant |
Trainingsdata |
|
LLaMa 2 |
Basismodel zonder chat voor completion-taken. |
4.096 tokens |
Ja |
Ja* |
7B 13B 70B |
sep 2022 |
|
LLaMa 2 Chat |
Basis LLaMa 2 met instruction tuning om eenvoudige completions om te zetten in een chatmodel dat de gebruikersintentie volgt. |
4.096 tokens |
Ja |
Ja* |
7B 13B 70B |
sep 2022 |
|
LLaMa 2 Guard |
Input-output-beveiligingsmodel, getraind om toxische en schadelijke content te detecteren. |
4.096 tokens |
Ja** |
Nee |
7B |
sep 2022* |
*Hugging Face biedt ook enkele varianten van LLaMa, zoals de basis- en chat-modellen. **Voorlopig is LLaMa 2 Guard toegankelijk in de cloudomgeving van Amazon SageMaker.
In tegenstelling tot GPT-modellen, die geïntegreerde codeercapaciteiten hebben, heeft LLaMa toegewijde modellen voor coderen met grotere contextvensters van 16k tokens, bereikt via een long-context fine-tuningproces.
|
Model |
Kenmerken |
Contextvenster |
API |
Lokaal |
Variant |
Trainingsdata |
|
Code LLaMa |
Basismodel zonder chat voor codecompletion-taken, zoals GitHub Copilot. Bestaat uit een LLaMa 2-model met extra training op code en long-context- fine-tuning. |
16k |
Nee |
Ja |
7B 13B 34B |
sep 2022* |
|
Code LLaMa - Instruct |
Afgeleid van Instruct-modellen. Blinkt uit in codecompletions en uitleg bij codefragmenten. |
16k |
Ja |
Ja |
7B 13B 34B |
sep 2022* |
|
Code LLaMa - Python |
Fijngestemd voor de programmeertaal Python. |
16k |
Nee |
Ja |
34B |
sep 2022* |
* De officiële cutoff-datum van LLaMa-modellen is sep 2022. De tuningdata is echter recenter, uit 2023, vooral voor nieuwere varianten.
Google heeft een lange geschiedenis in het ontwikkelen van Large Language Models. Met de introductie van het Gemini-model begon Google aan zijn generatie multimodale LLM’s.
In de context van Google’s aanbod is Gemini het vlaggenschipmodel en closed source, net als ChatGPT. Onlangs hebben ze echter Gemma gelanceerd, een reeks open-sourcemodellen afgeleid van Gemini, bedoeld om toegankelijke AI-ontwikkeling te faciliteren.
In dit artikel focussen we op zowel Gemini als Gemma:
|
Model |
Kenmerken |
API |
Lokaal |
Varianten |
|
Gemini |
Closed-sourcemodel voor generieke taken (tekstgeneratie, vertaling, vraag–antwoord, code, enz.) |
Ja* |
Nee |
Ultra - Oplossen van complexe taken. Pro - Brede waaier aan taken. Schaalbaar. Nano - Efficiënt voor gebruik op het apparaat. |
|
Gemma |
Vergelijkbare taken als Gemini, maar gericht op integratie in maatwerkapplicaties en onderzoek. Het is een lichtgewicht model. |
Ja**LLAMA API |
JaOllama |
2B 7B |
*Er is een API voor Gemini voor commerciële doeleinden (niet open voor deployments). We kunnen het model wel uitproberen via de Playground-interface.
**Er is geen native Google-endpoint, maar het model is toegankelijk via Kaggle en Google Colab. Meer informatie is beschikbaar in de officiële Google-documentatie.
Wat de Gemini-varianten betreft: Gemini Ultra is een multimodaal model dat uitblinkt in complexe analysetaken. Gemini Pro balanceert prestaties en schaalbaarheid en blinkt uit in taken zoals code- en tekstgeneratie. Tot slot focust Gemini Nano op efficiëntie voor gebruik op het apparaat, draaiend op mobiele en edge-apparaten zonder zware resource-eisen.
Over de modellen van Google is niet veel publieke informatie beschikbaar over de contextvensters en de cutoff-datum van de trainingsdata ten tijde van schrijven.
Mistral AI is een Frans AI-bedrijf, opgericht in april 2023 door voormalige medewerkers van Meta Platforms en Google DeepMind. Het richt zich op het ontwikkelen van open-source LLM’s en benadrukt het belang van open-source software als antwoord op propriëtaire modellen. Het bedrijf biedt modellen zoals Mistral 7B en Mixtral 8x7B met geavanceerde taalverwerkingsmogelijkheden.
|
Model |
Kenmerken |
Context venster |
API |
Lokaal |
Tokenprijs |
Trainingsdata |
|
Mistral |
Algemeen model met 7B parameters. Geoptimaliseerd voor de Engelse taal en taken voor codegeneratie. |
32k |
Ja* |
Ja |
$0,25 / 1M tokens (input en output) |
sep 2023 |
|
Mixtral |
Meest krachtige algemene model. Vloeiend in Engels, Frans, Italiaans, Duits, Spaans, en sterk in coderingstaken. Gebaseerd op een spars Mixture-of-Expert-architectuur met 7B parameters. |
32k |
Ja* |
Ja |
$0,7 / 1M tokens (input en output) |
dec 2023 |
*We kunnen met modellen van Mistral AI interageren via hun Playground-interface “La Plataforme”.
** Hugging Face biedt ook een proeftuin voor realtime-inferentie via zijn API voor sommige modellen. Het is ook een third-party provider die je toelaat betaalde endpoints te deployen naar de beschikbare modellen.
Wat betreft het Mixtral-model: de “Mixture-of-Experts”-architectuur laat het model zijn totale capaciteiten verdelen over verschillende gespecialiseerde groepen of “experts”. Elke expert is geoptimaliseerd voor specifieke typen taken of data.
Bij het verwerken van input schakelt Mixtral dynamisch alleen de relevante experts in, zodat het complexe taken efficiënt kan afhandelen door voor elk token slechts een fractie van de totale parameters te gebruiken. Deze methode verbetert de prestaties van Mixtral, waardoor het bedreven is in verschillende talen en taken terwijl het rekenmiddelen optimaliseert. De naam van het Mixtral-model is inderdaad "Mixtral 8x7B" en verwijst naar het feit dat het 8 verschillende groepen “experts” benut.
Tot slot biedt Mistral AI ook drie commerciële modellen: Mistral Small, Mistral Medium en Mistral Large. Als je geïnteresseerd bent, vind je meer informatie over de modellen en prijzen in de officiële documentatie.
Tot nu toe hebben we meerdere modellen en varianten gezien van de bekendste bedrijven in het vak. Er valt echter nog veel meer te ontdekken!
Ik wil de Falcon-modellen van het Technology Innovation Institute uitlichten, beschikbaar in zowel Ollama als LLAMA API. Er is ook het Orca2-model van Microsoft Research, dat vooral uitblinkt in redeneren, en ook beschikbaar is in Ollama en Hugging Face.
Je kunt lezen over andere open-source, beschikbare modellen in 8 Top Open-Source LLMs for 2024 and Their Uses.
In dit artikel hebben we verschillende aspecten besproken om te overwegen bij het selecteren van het beste Large Language Model voor onze doelapplicatie. Hoewel het doel van deze gids was om als spiekbrief te dienen, bestaat er geen gouden regel om meteen het beste model te kiezen.
Op basis van mijn persoonlijke ervaring denk ik dat het definiëren van hoe we met de LLM willen interfacen een goed uitgangspunt is, omdat dit het aantal beschikbare modellen — en varianten — al verkleint.
Het tweede aspect is de doeltaak die het model zal uitvoeren: generieke chatbot, samenvattingsexpert, code-assistent, enzovoort.
Hoewel we een model altijd kunnen fine-tunen voor onze gewenste taak, hebben we gezien dat er al varianten bestaan die zijn fijngestemd voor bepaalde usecases. Die besparen ons tijd, rekenmiddelen en technische expertise. Het benodigde contextvenster voor de applicatie is ook cruciaal om het beste model te selecteren.
Tot slot is prijs altijd een goede indicator voor welk model te gebruiken. Helaas wordt het project vaak begrensd door de initiële investering en de kosten om het project in de tijd te onderhouden. Wat de prijs betreft, is het belangrijk om in gedachten te houden dat trainen en fine-tunen niet-gratis diensten zijn om tijdens de projectontwikkeling in te calculeren en bovendien behoorlijk tijdrovend.
Zet vandaag nog je AI-reis voort!
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min


