Centrale limietstelling: een sleutelconcept in de statistiek uitgelegd
De centrale limietstelling stelt dat, bij een voldoende grote steekproef, de steekproefverdeling van het gemiddelde normaal verdeeld zal zijn, ongeacht de verdeling van de populatie. Leer de formule, belangrijkste voorwaarden en toepassingen in statistiek en machine learning.
Als we veel willekeurige steekproeven nemen uit vrijwel elk type dataverdeling, gebeurt er iets verrassends. Het gemiddelde van die steekproeven begint op een normale verdeling te lijken – die bekende klokvormige curve. Dat is de centrale limietstelling (CLT) in een notendop.
Het is een groot ding in kansrekening en statistiek, omdat het betekent dat we nauwkeurige voorspellingen kunnen doen en conclusies kunnen trekken over hele populaties, zelfs wanneer we alleen naar kleine steekproeven kijken.
Wat de CLT extra handig maakt, is dat ze werkt zelfs als de oorspronkelijke data niet normaal verdeeld is. Laten we dit in detail verkennen en kijken hoe we het kunnen uitrekenen.
Wat is de centrale limietstelling?
De centrale limietstelling, of CLT, is een idee in de statistiek dat zegt dat als we een heleboel willekeurige steekproeven uit een populatie nemen en naar de gemiddelden van die steekproeven kijken, die gemiddelden een normale, klokvormige curve gaan vormen, zelfs als de oorspronkelijke populatie er helemaal niet normaal uitziet.
Dit hangt samen met de wet van de grote aantallen, die ons vertelt dat naarmate we meer data verzamelen, ons steekproefgemiddelde steeds dichter bij het ware gemiddelde van de hele populatie komt. De CLT gaat nog een stap verder — ze vertelt ons dat het steekproefgemiddelde nauwkeuriger wordt en dat het patroon van die gemiddelden voorspelbaar wordt. Onze Intro to Statistics-cursus heeft oefenopgaven om je vertrouwd te maken met de relatie en de verschillen tussen de CLT en de wet van de grote aantallen, als je dit verder wilt verkennen.
Een goede manier om dit in actie te zien, is door met een dobbelsteen te gooien. Als we maar één keer gooien, krijgen we een willekeurig getal tussen 1 en 6. Maar na genoeg worpen zal het gemiddelde uitkomen rond 3,5 (de werkelijke gemiddelde waarde van een eerlijke dobbelsteen). Doe dit herhaaldelijk, en de verdeling van die gemiddelden begint op een normale curve te lijken.
Formule van de centrale limietstelling
Hier is de basisformule voor de centrale limietstelling:
In deze formule:
X is de steekproefverdeling van het steekproefgemiddelde, die een normale verdeling volgt.
N is de normale verdeling.
𝜇 is het populatiegemiddelde.
σ is de populatiestandaardafwijking.
n is de steekproefgrootte.
Naarmate de steekproef groter wordt, wordt de standaardafwijking van de steekproefverdeling kleiner. Hoe meer data we verzamelen, hoe dichter onze steekproefgemiddelden rond het werkelijke populatiegemiddelde clusteren.
Voorwaarden voor de centrale limietstelling
Opdat de centrale limietstelling werkt zoals we verwachten, zijn er een paar voorwaarden om rekening mee te houden:
Voldoende grote steekproefgrootte: De steekproef moet groot genoeg zijn. Een steekproef van 30 of meer wordt meestal als goed beschouwd. Maar als de populatie waaruit we steekproeven trekken scheef is of veel uitschieters heeft, hebben we mogelijk een grotere steekproef nodig om die mooie, klokvormige curve te zien verschijnen.
Onafhankelijke en identiek verdeelde (i.i.d.) steekproeven: De steekproeven die we nemen, moeten onafhankelijk en identiek verdeeld (i.i.d.) zijn. Dit betekent dat elke steekproef willekeurig is gekozen en uit dezelfde populatie komt. Als dat niet zo is, zijn de resultaten mogelijk niet betrouwbaar.
Eindige populatievariantie: De populatie waaruit we steekproeven trekken, moet een eindige variantie hebben. Als de data uit een verdeling met oneindige variantie komt, zoals de Cauchy-verdeling, dan is de CLT daar niet op van toepassing.
Voorbeelden van de centrale limietstelling
Stel dat we willen weten hoeveel koppen koffie er per dag worden verkocht in een lokale koffiezaak. Door de jaren heen kan het aantal verkochte koppen per dag een verdeling volgen zoals die ik hier opneem. Op de meeste dagen verkopen ze tussen de 80 en 120 koppen. Maar op drukke dagen, zoals feestdagen of speciale evenementen, verkopen ze 150 of zelfs 180 koppen. De data is in dit geval wat scheef (onevenwichtig).
Oneven grafiek. Afbeelding door de auteur.
Stel dat we een kleine steekproef nemen. We kiezen willekeurig 5 dagen uit het jaar en kijken hoeveel koppen op die dagen zijn verkocht.
Dat geeft ons één schatting van het populatiegemiddelde, maar omdat de steekproef klein is, is die mogelijk niet exact. Als we dit proces 10 keer herhalen, telkens willekeurig 5 dagen kiezen, het gemiddelde berekenen en de resultaten noteren, dan zijn de 10 steekproefgemiddelden:
97.6, 105.8, 93.4, 110.2, 99.0, 102.4, 101.2, 107.5, 96.3, 94.1Mogelijk gemaakt door
Als we deze waarden in een histogram uitzetten, zien we een ruwe klokvorm, maar hij kan nog steeds oneffen lijken. En de spreiding van deze gemiddelden is kleiner dan de spreiding in de populatie.
Grafiek van 10 koppen. Afbeelding door de auteur.
Laten we nu een grotere steekproef nemen. Deze keer selecteren we willekeurig 50 dagen en berekenen we het gemiddelde aantal verkochte koppen:
Deze schatting ligt veel dichter bij het populatiegemiddelde van 100 en omdat onze steekproef groter is, is het een nauwkeurigere schatting.
Als we dit proces vaak herhalen, waarbij we telkens willekeurig 50 dagen selecteren, het gemiddelde berekenen en die gemiddelden in een histogram uitzetten, zien we, hoewel de oorspronkelijke data scheef was, een duidelijke, vloeiende klokvormige curve. Dat is dus de kracht van de centrale limietstelling.
Egale grafiek. Afbeelding door de auteur.
We kunnen die spreiding zelfs berekenen met deze formule:
Hier:
µ (populatiegemiddelde) = 100
σ (populatiestandaardafwijking) = 15
n (steekproefgrootte) = 50
Dus, de standaardafwijking van onze steekproefgemiddelden is:
Dit vertelt ons dat de steekproefgemiddelden heel dicht bij 100 koppen zullen liggen, met slechts een kleine variatie (rond 2,12 koppen).
Waarom de centrale limietstelling belangrijk is
We weten inmiddels dat data in de echte wereld vreemd en onvoorspelbaar kan zijn. Maar de centrale limietstelling geeft ons een betrouwbare manier om te begrijpen wat er gebeurt en betere keuzes te maken op basis daarvan. Laten we het belang ervan iets verder uitdiepen.
Statistische inferentie
In de statistiek is de centrale limietstelling de reden dat parametrische toetsen zoals t-toetsen, ANOVA en regressie werken zoals ze doen. Deze toetsen zijn gebaseerd op het idee dat steekproefdata afkomstig is uit een populatie met vaste kenmerken.
Zonder de centrale limietstelling zouden we niet op die toetsen kunnen vertrouwen. En dankzij deze stelling zijn parametrische toetsen vaak krachtiger dan niet-parametrische, die geen aannames doen over de verdeling van de data.
Toepassingen in de praktijk
Ze duikt ook op in veel situaties in de echte wereld. In de financiële wereld gebruiken analisten haar om gemiddelde aandelenrendementen te schatten op basis van historische prestaties. Bij peilingen en enquêtes maakt ze voorspellingen over de hele populatie door een steekproef van antwoorden te verzamelen. In machine learning en big data gebruiken we haar waar modellen op steekproeven worden getraind. Een film-app kan bijvoorbeeld een steekproef van gebruikersactiviteit gebruiken om het aanbevelingssysteem te bouwen.
Rekenhulp voor de centrale limietstelling
De standaardafwijking is een getal dat aangeeft hoe ver de waarden van het gemiddelde afliggen. Als we naar steekproefgemiddelden kijken (de gemiddelden van verschillende steekproeven), willen we weten hoeveel die gemiddelden variëren. Daarvoor kunnen we deze formule gebruiken:
Dit vertelt ons dat wanneer we de populatiestandaardafwijking delen door de wortel uit de steekproefgrootte, we de standaardafwijking van de steekproefverdeling krijgen. Naarmate de steekproef groter wordt, wordt de totale waarde kleiner.
Kijken we naar een snel voorbeeld:
Steekproefgrootte (n)
Steekproefgemiddelde (μₓ̄)
Standaardafw. (σₓ̄)
5
17
1.788854
10
17
1.264911
25
17
0.800000
50
17
0.565685
100
17
0.400000
Je ziet dat het gemiddelde hetzelfde blijft, maar de standaardafwijking blijft krimpen. Dit laat zien dat hoe groter de steekproef, hoe nauwkeuriger en consistenter die is.
De centrale limietstelling in data science
In data science werken we meestal met steekproeven, niet met hele populaties. De CLT helpt ons te begrijpen hoe die steekproefresultaten zich gedragen en vertelt ons dat als we genoeg steekproeven nemen, hun gemiddelden op een normale verdeling gaan lijken, zelfs als de oorspronkelijke data dat niet is.
Dit heeft ook flinke voordelen in de praktijk. In machine learning gebruiken we vaak technieken zoals bootstrapping om waarden te schatten. Dankzij de CLT kunnen we erop vertrouwen dat die schattingen accuraat zijn.
Ze speelt ook een sleutelrol in A/B-testen. Wanneer een bedrijf twee versies van een webpagina of functie uitprobeert, helpt de CLT ons te bepalen of de resultaten betekenisvol zijn of slechts ruis.
Zelfs in reinforcement learning, waar systemen leren door trial-and-error, strijkt de CLT de chaos glad. Naarmate er meer data binnenkomt, worden de gemiddelden stabieler, wat het systeem helpt sneller en beter te leren.
Tot slot kom je de CLT ook tegen bij toetsen van hypothesen en tijdreeksanalyse. Ze helpt data scientists ideeën te toetsen en trends met meer vertrouwen te volgen.
Tot slot
De centrale limietstelling klinkt misschien technisch als je nieuw bent met statistiek, maar ze is een grote reden waarom we slimme dingen met data kunnen doen. Ze maakt van willekeurigheid iets dat we kunnen begrijpen en vertrouwen. Sterker nog, ze is een van de bouwstenen van statistische modellering en onmisbaar voor iedereen die met data werkt.
Wil je meer verkennen, lees dan over de wet van de grote aantallen en kansverdelingen — ze hangen allemaal met elkaar samen.
Ik ben een contentstrateeg die graag complexe onderwerpen eenvoudig maakt. Ik heb bedrijven als Splunk, Hackernoon en Tiiny Host geholpen om boeiende en informatieve content te maken voor hun doelgroep.
Veelgestelde vragen over de centrale limietstelling
Kan de centrale limietstelling worden gebruikt met niet-numerieke data?⌄
Ja, maar niet rechtstreeks. De CLT is van toepassing op numerieke data, met name op gemiddelden en sommen. Voor categorische of ordinale data kun je echter vergelijkbare principes gebruiken door de data om te zetten naar numerieke vorm of andere statistische technieken te gebruiken.
Wat is het verschil tussen steekproefverdeling en populatieverdeling?⌄
De populatieverdeling beschrijft de volledige dataset, terwijl de steekproefverdeling verwijst naar de verdeling van steekproefstatistieken (zoals gemiddelden) uit herhaalde steekproeven.
Hoe beïnvloeden uitschieters de centrale limietstelling?⌄
Uitschieters vergroten de scheefheid en variantie, wat betekent dat we mogelijk een grotere steekproefgrootte nodig hebben voor de steekproefverdeling om de normaliteit te benaderen.




Als we veel willekeurige steekproeven nemen uit vrijwel elk type dataverdeling, gebeurt er iets verrassends. Het gemiddelde van die steekproeven begint op een normale verdeling te lijken – die bekende klokvormige curve. Dat is de centrale limietstelling (CLT) in een notendop.
Het is een groot ding in kansrekening en statistiek, omdat het betekent dat we nauwkeurige voorspellingen kunnen doen en conclusies kunnen trekken over hele populaties, zelfs wanneer we alleen naar kleine steekproeven kijken.
Wat de CLT extra handig maakt, is dat ze werkt zelfs als de oorspronkelijke data niet normaal verdeeld is. Laten we dit in detail verkennen en kijken hoe we het kunnen uitrekenen.
Wat is de centrale limietstelling?
De centrale limietstelling, of CLT, is een idee in de statistiek dat zegt dat als we een heleboel willekeurige steekproeven uit een populatie nemen en naar de gemiddelden van die steekproeven kijken, die gemiddelden een normale, klokvormige curve gaan vormen, zelfs als de oorspronkelijke populatie er helemaal niet normaal uitziet.
Dit hangt samen met de wet van de grote aantallen, die ons vertelt dat naarmate we meer data verzamelen, ons steekproefgemiddelde steeds dichter bij het ware gemiddelde van de hele populatie komt. De CLT gaat nog een stap verder — ze vertelt ons dat het steekproefgemiddelde nauwkeuriger wordt en dat het patroon van die gemiddelden voorspelbaar wordt. Onze Intro to Statistics-cursus heeft oefenopgaven om je vertrouwd te maken met de relatie en de verschillen tussen de CLT en de wet van de grote aantallen, als je dit verder wilt verkennen.
Een goede manier om dit in actie te zien, is door met een dobbelsteen te gooien. Als we maar één keer gooien, krijgen we een willekeurig getal tussen 1 en 6. Maar na genoeg worpen zal het gemiddelde uitkomen rond 3,5 (de werkelijke gemiddelde waarde van een eerlijke dobbelsteen). Doe dit herhaaldelijk, en de verdeling van die gemiddelden begint op een normale curve te lijken.
Formule van de centrale limietstelling
Hier is de basisformule voor de centrale limietstelling:
In deze formule:
Xis de steekproefverdeling van het steekproefgemiddelde, die een normale verdeling volgt.Nis de normale verdeling.𝜇is het populatiegemiddelde.σis de populatiestandaardafwijking.nis de steekproefgrootte.Naarmate de steekproef groter wordt, wordt de standaardafwijking van de steekproefverdeling kleiner. Hoe meer data we verzamelen, hoe dichter onze steekproefgemiddelden rond het werkelijke populatiegemiddelde clusteren.
Voorwaarden voor de centrale limietstelling
Opdat de centrale limietstelling werkt zoals we verwachten, zijn er een paar voorwaarden om rekening mee te houden:
Voorbeelden van de centrale limietstelling
Stel dat we willen weten hoeveel koppen koffie er per dag worden verkocht in een lokale koffiezaak. Door de jaren heen kan het aantal verkochte koppen per dag een verdeling volgen zoals die ik hier opneem. Op de meeste dagen verkopen ze tussen de 80 en 120 koppen. Maar op drukke dagen, zoals feestdagen of speciale evenementen, verkopen ze 150 of zelfs 180 koppen. De data is in dit geval wat scheef (onevenwichtig).
Oneven grafiek. Afbeelding door de auteur.
Stel dat we een kleine steekproef nemen. We kiezen willekeurig 5 dagen uit het jaar en kijken hoeveel koppen op die dagen zijn verkocht.
Het gemiddelde dat we uit deze steekproef krijgen, is:
Grafiek van 5 koppen. Afbeelding door de auteur.
Dat geeft ons één schatting van het populatiegemiddelde, maar omdat de steekproef klein is, is die mogelijk niet exact. Als we dit proces 10 keer herhalen, telkens willekeurig 5 dagen kiezen, het gemiddelde berekenen en de resultaten noteren, dan zijn de 10 steekproefgemiddelden:
Als we deze waarden in een histogram uitzetten, zien we een ruwe klokvorm, maar hij kan nog steeds oneffen lijken. En de spreiding van deze gemiddelden is kleiner dan de spreiding in de populatie.
Grafiek van 10 koppen. Afbeelding door de auteur.
Laten we nu een grotere steekproef nemen. Deze keer selecteren we willekeurig 50 dagen en berekenen we het gemiddelde aantal verkochte koppen:
Als we het gemiddelde van deze steekproef berekenen, krijgen we:
Deze schatting ligt veel dichter bij het populatiegemiddelde van 100 en omdat onze steekproef groter is, is het een nauwkeurigere schatting.
Als we dit proces vaak herhalen, waarbij we telkens willekeurig 50 dagen selecteren, het gemiddelde berekenen en die gemiddelden in een histogram uitzetten, zien we, hoewel de oorspronkelijke data scheef was, een duidelijke, vloeiende klokvormige curve. Dat is dus de kracht van de centrale limietstelling.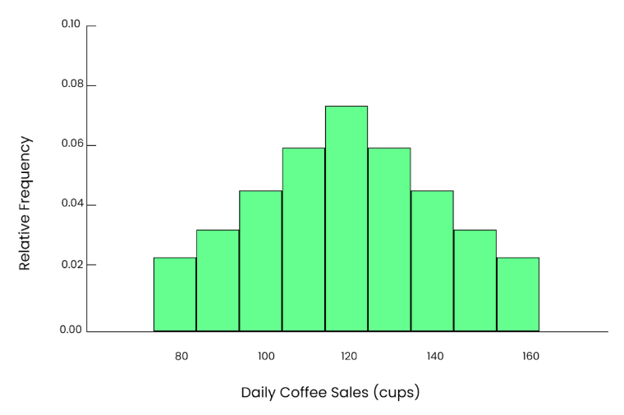
Egale grafiek. Afbeelding door de auteur.
We kunnen die spreiding zelfs berekenen met deze formule:
µ(populatiegemiddelde) = 100σ(populatiestandaardafwijking) = 15n(steekproefgrootte) = 50Dus, de standaardafwijking van onze steekproefgemiddelden is:
Dit vertelt ons dat de steekproefgemiddelden heel dicht bij 100 koppen zullen liggen, met slechts een kleine variatie (rond 2,12 koppen).
Waarom de centrale limietstelling belangrijk is
We weten inmiddels dat data in de echte wereld vreemd en onvoorspelbaar kan zijn. Maar de centrale limietstelling geeft ons een betrouwbare manier om te begrijpen wat er gebeurt en betere keuzes te maken op basis daarvan. Laten we het belang ervan iets verder uitdiepen.
Statistische inferentie
In de statistiek is de centrale limietstelling de reden dat parametrische toetsen zoals t-toetsen, ANOVA en regressie werken zoals ze doen. Deze toetsen zijn gebaseerd op het idee dat steekproefdata afkomstig is uit een populatie met vaste kenmerken.
Zonder de centrale limietstelling zouden we niet op die toetsen kunnen vertrouwen. En dankzij deze stelling zijn parametrische toetsen vaak krachtiger dan niet-parametrische, die geen aannames doen over de verdeling van de data.
Toepassingen in de praktijk
Ze duikt ook op in veel situaties in de echte wereld. In de financiële wereld gebruiken analisten haar om gemiddelde aandelenrendementen te schatten op basis van historische prestaties. Bij peilingen en enquêtes maakt ze voorspellingen over de hele populatie door een steekproef van antwoorden te verzamelen. In machine learning en big data gebruiken we haar waar modellen op steekproeven worden getraind. Een film-app kan bijvoorbeeld een steekproef van gebruikersactiviteit gebruiken om het aanbevelingssysteem te bouwen.
Rekenhulp voor de centrale limietstelling
De standaardafwijking is een getal dat aangeeft hoe ver de waarden van het gemiddelde afliggen. Als we naar steekproefgemiddelden kijken (de gemiddelden van verschillende steekproeven), willen we weten hoeveel die gemiddelden variëren. Daarvoor kunnen we deze formule gebruiken:
Dit vertelt ons dat wanneer we de populatiestandaardafwijking delen door de wortel uit de steekproefgrootte, we de standaardafwijking van de steekproefverdeling krijgen. Naarmate de steekproef groter wordt, wordt de totale waarde kleiner.
Kijken we naar een snel voorbeeld:
Je ziet dat het gemiddelde hetzelfde blijft, maar de standaardafwijking blijft krimpen. Dit laat zien dat hoe groter de steekproef, hoe nauwkeuriger en consistenter die is.
De centrale limietstelling in data science
In data science werken we meestal met steekproeven, niet met hele populaties. De CLT helpt ons te begrijpen hoe die steekproefresultaten zich gedragen en vertelt ons dat als we genoeg steekproeven nemen, hun gemiddelden op een normale verdeling gaan lijken, zelfs als de oorspronkelijke data dat niet is.
Dit heeft ook flinke voordelen in de praktijk. In machine learning gebruiken we vaak technieken zoals bootstrapping om waarden te schatten. Dankzij de CLT kunnen we erop vertrouwen dat die schattingen accuraat zijn.
Ze speelt ook een sleutelrol in A/B-testen. Wanneer een bedrijf twee versies van een webpagina of functie uitprobeert, helpt de CLT ons te bepalen of de resultaten betekenisvol zijn of slechts ruis.
Zelfs in reinforcement learning, waar systemen leren door trial-and-error, strijkt de CLT de chaos glad. Naarmate er meer data binnenkomt, worden de gemiddelden stabieler, wat het systeem helpt sneller en beter te leren.
Tot slot kom je de CLT ook tegen bij toetsen van hypothesen en tijdreeksanalyse. Ze helpt data scientists ideeën te toetsen en trends met meer vertrouwen te volgen.
Tot slot
De centrale limietstelling klinkt misschien technisch als je nieuw bent met statistiek, maar ze is een grote reden waarom we slimme dingen met data kunnen doen. Ze maakt van willekeurigheid iets dat we kunnen begrijpen en vertrouwen. Sterker nog, ze is een van de bouwstenen van statistische modellering en onmisbaar voor iedereen die met data werkt.
Wil je meer verkennen, lees dan over de wet van de grote aantallen en kansverdelingen — ze hangen allemaal met elkaar samen.