Gemini 3.8 Live vs. GPT-Live-1 pe scurt
Ce nu poate arăta tabelul de mai jos este că, în ambele cazuri, aplicația ta face în continuare munca propriu-zisă, cum ar fi rularea funcțiilor tale și urmărirea a ceea ce a cerut utilizatorul.
|
Punct de comparație |
Gemini 3.8 Live |
GPT-Live-1 |
|
Rol |
Un singur model care ascultă, vede, raționează și cere aplicației tale să acționeze |
Model vocal care vorbește și pasează munca mai grea unui backend |
|
ID-uri de model |
|
|
|
Inputuri native |
Text, audio, imagini, cadre video |
Doar text și audio |
|
Unde rulează raționamentul profund |
În interiorul modelului, mai mult în varianta Extended Thinking |
Într-un backend ales de tine |
|
Cine rulează funcțiile tale |
Aplicația ta (Search grounding rulează la Google) |
Aplicația ta; instrumente găzduite precum căutarea web rulează cu backendul |
|
Unitate de facturare |
Tokeni, inclusiv tokeni de gândire |
Minute de sesiune conectată, plus consumul backendului |
|
Plan gratuit |
Da |
Nu |
Ce sunt Gemini 3.8 Live și GPT-Live-1?
Ambele sunt modele speech-to-speech, deci intră audio și iese audio fără un pas separat de transcriere.
Ce este Gemini 3.8 Live?
Gemini 3.8 Live este modelul Google de dialog live cu latență redusă. Acceptă text, imagini, audio și video, raționează între ture și apelează funcții asincron. Ambele variante Gemini listează o limită de input de 131.072 tokeni pe paginile modelului.
Gemini 3.8 Live Extended Thinking este un model separat, nu o setare. Adaugă raționament în fundal la un nivel scăzut, mediu sau înalt, în timp ce narrează progresul.
Notele de lansare ale Google listează ambele ID-uri de model ca fiind disponibile general, în timp ce ghidul de capabilități Live API încă etichetează API-ul ca preview.
Ce este GPT-Live-1?
GPT-Live-1 este modelul vocal full-duplex al OpenAI. Full duplex este denumirea tehnică pentru comportamentul de a asculta în timp ce vorbește, descris în introducere.
OpenAI numește pasarea către backend delegare. Vocea poate continua să vorbească în timp ce acea muncă rulează.
GPT-Live-1 nu este același produs ca linia GPT-Realtime-2 a OpenAI sau modelul de backend către care deleagă. GPT-Realtime-2.1 păstrează raționamentul și instrumentele într-un singur model în timp real, deci tot ce spun despre delegare se aplică doar la GPT-Live-1.
Care este principala diferență între Gemini 3.8 Live și GPT-Live-1?
TL;DR a dat versiunea scurtă, deci aceasta e cea completă. Gemini 3.8 Live alege apelurile de funcții în interiorul sesiunii live, în timp ce GPT-Live-1 pasează raționamentul unui backend separat. În ambele concepte, aplicația ta rulează propriile funcții.
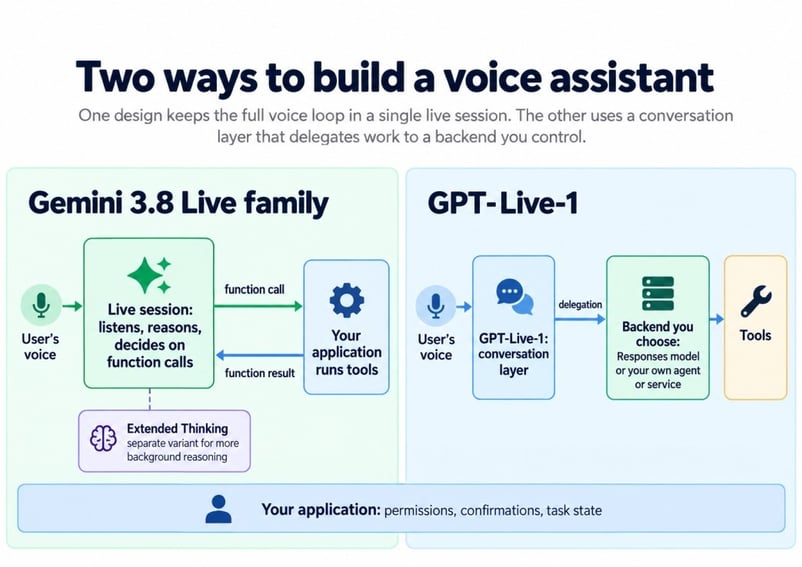
Unde își plasează fiecare model „gândirea”. Imagine de autor.
Majoritatea lucrurilor de mai jos se leagă de această separare, așa că întâi, fiecare parte.
Cum planifică Gemini 3.8 Live într-o singură sesiune
Cu Gemini, nu există un al doilea model de configurat. Modelul live emite un apel de funcție când are nevoie de date, iar clientul tău returnează rezultatul, după cum descrie ghidul de gândire al Google.
Trecerea la Extended Thinking păstrează același endpoint WebSocket și nu necesită un model backend, deși codul client se schimbă.
Cum funcționează delegarea în GPT-Live-1
GPT-Live-1 gestionează vorbirea și decide când să ceară ajutor; backendul gestionează raționamentul, instrumentele și regulile de business. Ghidul de promptare al OpenAI pune procedura completă a sarcinii în instrucțiunile backendului.
Cu delegarea Responses, OpenAI rulează un model pe care îl configurezi tu. Cu delegarea din client, munca ajunge la orice model sau serviciu pe care îl rulează aplicația ta. În ambele cazuri, ghidul de delegare spune că aplicația ta deține permisiunile, înregistrările și starea sarcinilor.
De ce contează diferența de arhitectură
Prețul separării este mai multe componente: o sesiune vocală, un backend și stare partajată între ele. În schimb, poți schimba modelul de raționament fără să atingi vocea.
Compromisul arată mai rău dacă încă nu ai un backend, dar mai bine dacă trebuie să upgradezi un agent existent fără să-i schimbi vocea.
Cum gestionează Gemini 3.8 Live și GPT-Live-1 întreruperile?
Ambele gestionează întreruperile, dar GPT-Live-1 este construit în jurul lor, împreună cu pauze și backchannel-uri (acel „mm-hmm” al unui ascultător). Gemini 3.8 Live suportă barge-in, iar audio proactiv este mereu pornit, dar documentația Google nu îl numește full duplex.
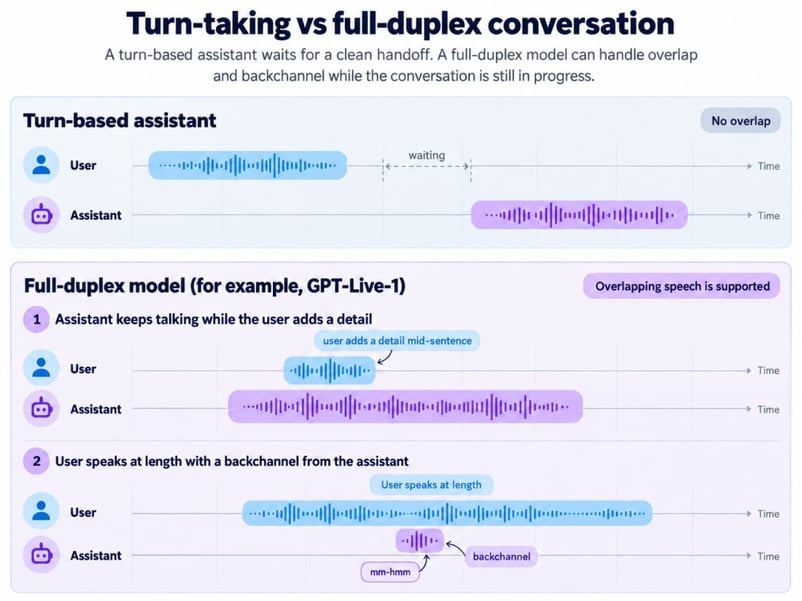
Pe rând versus în același timp. Imagine de autor.
Postarea de lansare a OpenAI citează aplicația de limbi Speak, spunând că GPT-Live-1 a redus întreruperile cu aproape 80% față de sistemele pe rânduri — o afirmație a unui client, nu un test independent.
Pe Gemini, audio proactiv permite modelului să sară peste vorbirea care nu îi este adresată. Tutorialul nostru Gemini a observat că sunetul din difuzoarele laptopului care intră în microfon e interpretat ca utilizatorul care întrerupe, așa că testează cu și fără căști.
Cum gestionează Gemini 3.8 Live și GPT-Live-1 raționamentul și apelurile de instrumente?
Gemini scalează raționamentul trecând de la Live de bază la Extended Thinking. GPT-Live-1 îl scalează schimbând backendul, deci compară Extended Thinking cu un setup complet GPT-Live-1, nu doar cu modelul vocal.
Gemini 3.8 Live vs. Gemini 3.8 Live Extended Thinking
Gemini 3.8 Live de bază nu are setarea thinking_level și acceptă funcții BLOCKING pentru codul mai vechi. Extended Thinking schimbă patru comportamente ale clientului:
-
Instrumente: funcționează doar funcțiile
NON_BLOCKING, iar una blocantă întoarce o eroare dură. -
Nivele de gândire: nu există opțiune minimă, doar cele trei niveluri de mai sus.
-
Sfârșitul unei ture:
turnComplete: truenu mai înseamnă că modelul a terminat, așa că clientul tău urmăreșteinteraction_statuspână când devineIDLE. -
Programare: programarea funcțiilor nu este suportată.
Google recomandă Extended Thinking pentru sarcini în mai mulți pași și instrumente lente. Costă mai multă latență și tokeni de ieșire.
Un lucru m-a deranjat în documentația Google. Postarea de lansare spune că Gemini 3.8 Live poate „continua conversația în timp ce sarcinile se termină în fundal”, dar ghidul de gândire spune că modelul de bază „așteaptă execuția instrumentelor înainte să vorbească”. Tutorialul nostru Gemini a văzut al doilea comportament în timpul unei interogări meteo, așa că aș planifica după ghid până când Google clarifică.
Ce modele backend funcționează cu GPT-Live-1?
GPT-Live-1 poate sta în fața oricărui backend pe care îl configurezi. Documentația OpenAI indică trei backenduri GPT-6:
-
GPT-6 Luna (
gpt-6-luna), punctul de pornire sugerat de ghidul de delegare -
GPT-6 Sol (
gpt-6-sol), sugestia ghidului pentru sarcini mai grele -
GPT-6 Astra, pe care postarea de lansare îl recomandă pentru probleme complexe ale clienților
Rândurile Artificial Analysis „GPT-Live-1 (Astra, medium)” și „GPT-Live-1 (Sol, low)” sunt configurații de sistem, nu versiuni de model vocal. Artificial Analysis nu numește generația Sol, iar OpenAI a lansat GPT-6.1 Sol după ce au rulat acele teste.
Ce se întâmplă când apelantul își schimbă cererea în mijlocul sarcinii
Să presupunem că cineva cere mutarea unei rezervări pe vineri, apoi spune „de fapt, joi” în timp ce rulează căutarea. Doar a doua cerere mai contează.
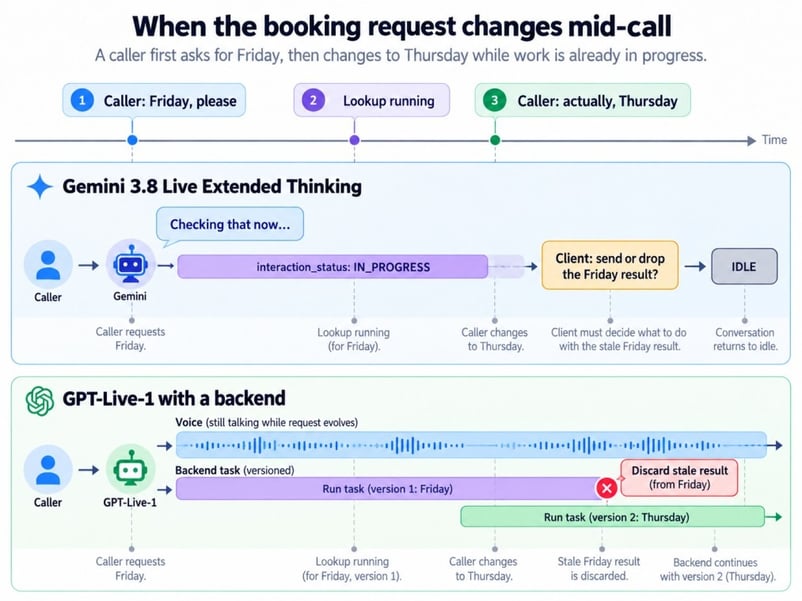
O cerere schimbată în timpul unei lucrări lente. Imagine de autor.
În GPT-Live-1, întreruperea vocii nu anulează munca backendului. Delegarea Responses poate încă întoarce vechiul rezultat către voce, în timp ce delegarea din client îți permite să-l arunci înainte.
În Gemini, clientul tău poate arunca rezultatul învechit al instrumentului. În ambele cazuri, aplicația ta decide care este sarcina curentă.
Suportă Gemini 3.8 Live și GPT-Live-1 imagini și video?
Gemini 3.8 Live acceptă nativ imagini și video; GPT-Live-1 listează ambele ca nesuportate. O aplicație GPT-Live-1 poate totuși trimite o fotografie către un backend de viziune separat, dar nu poate urmări singur o cameră live.
Pentru Gemini, cadrele intră în aceeași sesiune ca audio, astfel încât modelul poate răspunde „este acesta cablul potrivit?” în timp ce utilizatorul îl ține în față. Asta are două costuri. Cadrele video sunt trimise implicit, iar ghidul de sesiune al Google limitează sesiunile cu audio și video la 2 minute, față de 15 pentru doar audio, cu excepția cazului în care activezi compresia ferestrei de context.
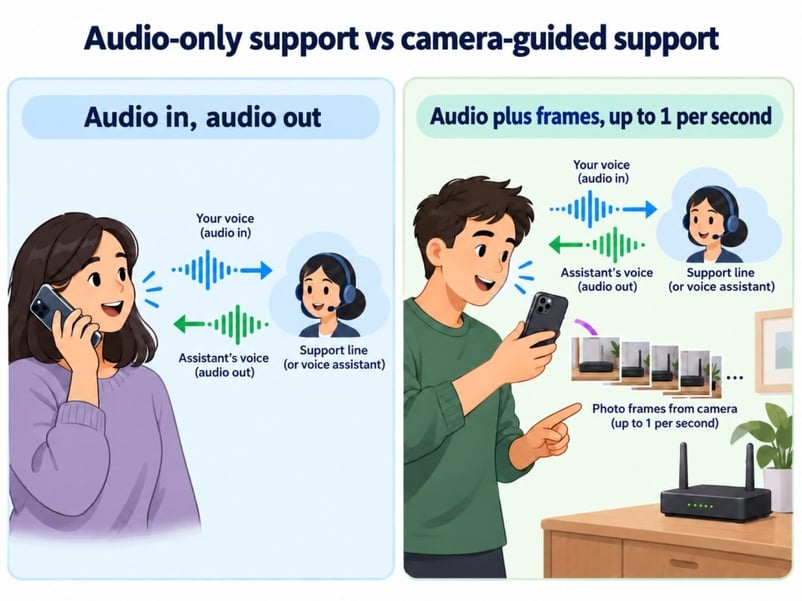
Apeluri telefonice versus sesiuni de depanare cu cameră. Imagine de autor.
O linie de rezervări nu vede niciodată un cadru, iar clasamentele vocale de mai jos nu măsoară viziunea.
Benchmarkuri: Gemini 3.8 Live vs. GPT-Live-1
Niciun benchmark singular nu tranșează această comparație. Dintre cele patru configurații ale celor două modele, Astra conduce indexul principal, Sol conduce dinamica conversațională, iar Gemini de bază are cel mai mare Arena Elo dintre cele patru configurații.
Mai întâi, cum funcționează indexul principal, pentru că asta explică majoritatea diferențelor.
Cum funcționează Artificial Analysis Speech to Speech Index
Indexul dă pondere egală la patru abilități diferite:
- Big Bench Audio: întrebări de raționament puse cu voce tare
- τ-Voice: sarcini de suport clienți în mai mulți pași, cum ar fi schimbarea unui zbor
- Scorul Arena: voturi umane oarbe despre ce agent au preferat oamenii
- Rata de succes a sarcinilor: cât de des s-a încheiat o conversație cu apelul corect al instrumentului final
Dinamica conversațională este raportată separat în metodologia v2.0.
Aici sunt cele patru configurații care contează aici.
|
Configurație |
Index |
Big Bench Audio |
τ-Voice |
Dinamică conversațională |
Arena Elo |
Succes sarcină |
TTFA |
|
GPT-Live-1 (Astra, medium) |
83.2 |
90.1% |
74.5% |
94.9% |
1027 |
87.4% |
1.34 s |
|
Gemini 3.8 Live Extended Thinking (High) |
82.6 |
97.7% |
68.6% |
91.9% |
966 |
89.1% |
1.35 s |
|
GPT-Live-1 (Sol, low) |
80.1 |
89.0% |
59.3% |
97.3% |
1037 |
90.9% |
1.24 s |
|
Gemini 3.8 Live |
74.5 |
91.7% |
30.1% |
96.1% |
1074 |
93.2% |
1.18 s |
Ambele scoruri τ-Voice pentru GPT-Live-1 provin dintr-un singur test, deci tratează-le cu precauție.
Sarcini de agent vs. scoruri de preferință umană
La τ-Voice, Astra are 74,5%, Extended Thinking 68,6%, iar Gemini de bază 30,1%. Raționamentul suplimentar contează când instrumentele sunt înlănțuite.
Conversația spune altă poveste: Sol obține cel mai mare scor, iar intervalele de încredere Arena pentru Gemini de bază și Sol se suprapun.
Diferența de 0,6 puncte în index între Astra și Extended Thinking nu are interval de încredere publicat. S-au inversat deja o dată, așa că tot aș numi-o egalitate.
Care model răspunde mai repede?
Gemini 3.8 Live de bază are cel mai rapid timp până la primul audio (TTFA) din tabel, dar diferența între toate patru e sub 0,2 secunde. TTFA este cât îi ia modelului să producă primul token audio.
TTFA nu surprinde reacția la întreruperi și nici timpul necesar pentru a termina o rezervare sau o căutare. Ultimul depinde mai mult de backendul și instrumentele tale.
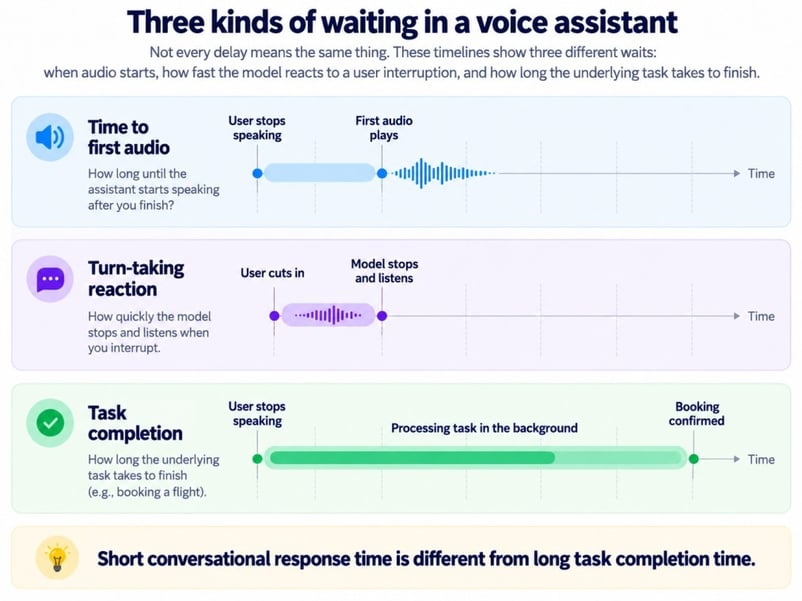
Trei feluri de așteptare în voce. Imagine de autor.
Atât Extended Thinking, cât și GPT-Live-1 pot continua să vorbească în timpul unei căutări lente. Apelantul tot așteaptă rezervarea.
Ce nu măsoară benchmarkurile de voce
Pentru o linie de suport, clasamentele nu îți pot spune:
- dacă furnizorul tău de telefonie și codecul o redau curat
- dacă agentul încă îți urmează scriptul după zece minute
- cum aude un apelant cu accent puternic pe o stradă zgomotoasă
- cât a costat apelul odată ce numeri backendul și instrumentele
Un pilot cu propriile înregistrări răspunde mai bine la aceste întrebări.
Prețuri: Gemini 3.8 Live vs. GPT-Live-1 — care e mai ieftin?
Gemini de bază e cel mai ieftin în testul Artificial Analysis, dar modelele taxează pentru lucruri diferite. Costul pe sarcină reușită contează mai mult decât eticheta de preț.
Tarifele de mai jos sunt prețurile de listă de pe pagina de prețuri Google și de pe pagina modelului GPT-Live-1 la momentul scrierii, iar cifrele pe minut ale lui Gemini sunt conversiile proprii ale Google din prețurile pe token.
|
Element de cost |
Gemini 3.8 Live și Extended Thinking (plan plătit) |
GPT-Live-1 |
|
Input audio |
3,00 $ per 1M tokeni (aprox. 0,005 $/min) |
Inclus în 0,05 $ pe minut, facturat pe secundă |
|
Output audio |
12,00 $ per 1M tokeni (aprox. 0,018 $/min) |
Inclus în aceeași taxă de sesiune |
|
Input imagine sau video |
1,00 $ per 1M tokeni (aprox. 0,002 $/min) |
Nu este suportat |
|
Raționament |
Tokenii de gândire facturați la tarifele de output |
Tokenii modelului backend, la prețul acelui model |
|
Căutare și instrumente |
5.000 de cereri Search gratuite pe lună, apoi 14 $ per 1.000 |
Facturate de modelul backend și instrumentele pe care le folosești |
Tokenii de gândire fac ca Extended Thinking să coste mai mult decât Gemini de bază. Artificial Analysis estimează 0,84 $ pe oră de input audio pentru Gemini de bază, 3,50 $ pentru Extended Thinking, 4,47 $ pentru Sol și 5,83 $ pentru Astra, excluzând instrumente și reduceri de cache. Gemini Live nu suportă cache-ul; un backend GPT-Live-1 poate.
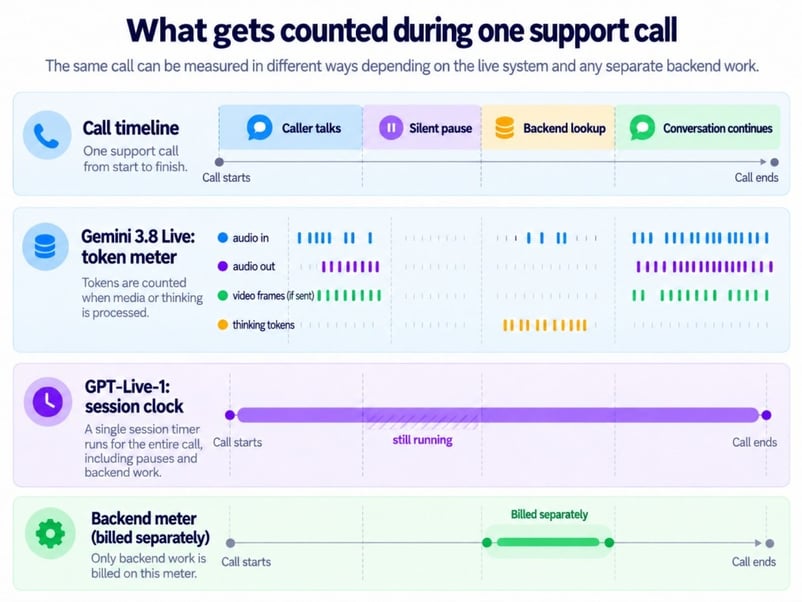
Ce contorizează fiecare în timpul apelurilor. Imagine de autor.
Ceasul GPT-Live-1 rulează și prin tăcere, iar mutarea nu îl oprește. Adună taxele din tabel și costurile telefonice, apoi împarte la sarcinile finalizate.
Suport în browser, server și telefon în Gemini 3.8 Live și GPT-Live-1
Aplicațiile de browser și server se pot conecta la oricare model, dar implementarea pe telefon le separă. Diagrama arată opțiunile de conexiune; diferențele operaționale sunt durata conexiunii și cine stă în calea apelului.
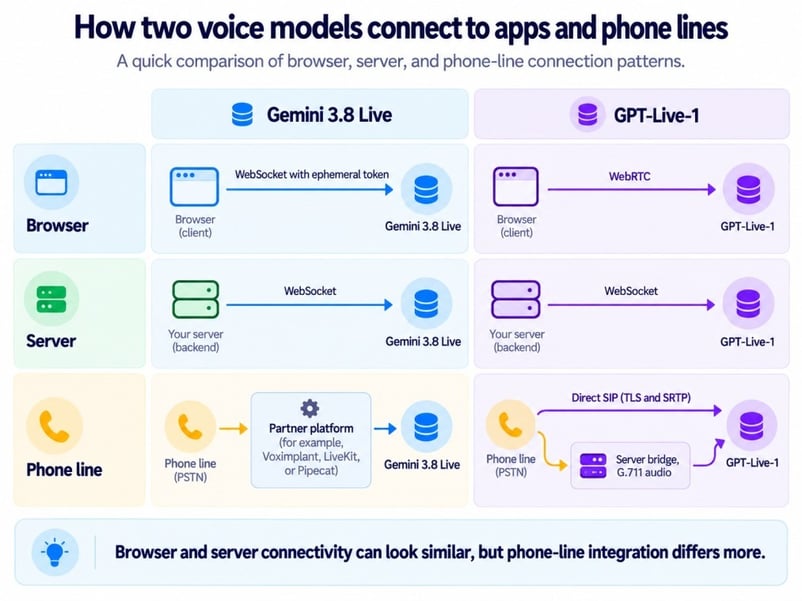
Căi de conexiune pentru browser, server și telefon. Imagine de autor.
Conexiunile Gemini se resetează după aproximativ 10 minute, deci apelurile mai lungi au nevoie de reluarea sesiunii. Cu GPT-Live-1, loghează separat conexiunea vocală și munca delegată în backend.
Apeluri telefonice și suport SIP
SIP direct înseamnă cu un furnizor mai puțin în calea apelului GPT-Live-1. Ruta prin partener a lui Gemini adaugă încă un serviciu de configurat, monitorizat și depanat.
Câțiva dezvoltatori pe forumurile OpenAI raportează că GPT-Live-1 promite o acțiune fără a crea o delegare. Suportul OpenAI nu a numit-o bug; a indicat ghidul de promptare, care notează că o confirmare vorbită nu confirmă că munca backend a început. Aș loga evenimentele de delegare separat de vorbire.
Din 2 noiembrie, OpenAI acceptă și apelarea SIP outbound pentru toate organizațiile, astfel încât GPT-Live-1 poate iniția apeluri, nu doar să le răspundă.
Gemini 3.8 Live vs. GPT-Live-1: pe care ar trebui să-l folosești?
Alegerea se reduce la două întrebări: are nevoie asistentul să vadă și ai deja un backend? Un „da” la prima indică spre Gemini; un „da” la a doua indică spre GPT-Live-1.
Sari la scenariul de mai jos care se potrivește produsului tău.
Suport telefonic și rezervări
O linie telefonică are nevoie de gestionarea întreruperilor și confirmări înainte de orice ireversibil. GPT-Live-1 se potrivește bine, cu suportul SIP de mai sus și logica de rezervare păstrată în backend.
Depanare cu cameră și ecran
Când un utilizator îndreaptă telefonul spre un router, modelul trebuie să raționeze despre ceea ce vede acum. Gemini 3.8 Live face asta într-o singură sesiune, fără un component separat de viziune, atâta timp cât planifici pentru limita de 2 minute la video din secțiunea de imagini.
Muncă în mai mulți pași în fundal
Pentru sarcini care înlănțuie instrumente, compară Extended Thinking cu GPT-Live-1 plus Astra. Astra conduce τ-Voice într-un singur test, deci alegerea tot se reduce la unde ar trebui să „locuiască” raționamentul.
Adăugarea vocii la un agent pe care îl rulezi deja
Delegarea din client poate adăuga GPT-Live-1 la un agent existent fără să-i rescrii bucla de raționament. Cu Gemini, modelul live devine planificatorul.
Volum mare de apeluri cu buget restrâns
Apelurile scurte și simple indică spre Gemini de bază, cel mai ieftin setup în testul Artificial Analysis. Instrumentele în mai mulți pași schimbă calculele.
Gânduri finale
Cea mai clară formulare a comparației este că Gemini 3.8 Live combină vederea, raționamentul și vorbirea într-un singur model, în timp ce GPT-Live-1 separă vocea de inteligența din spatele ei. Niciunul nu domină, iar cele două sunt suficient de apropiate la naturalețea vocii și viteza răspunsului încât arhitectura va decide majoritatea cazurilor reale.
Ce mi se pare interesant este cât de repede s-a mutat avantajul la sarcini de agent spre GPT-Live-1 cu Astra. Acel scor aparține întregului sistem, nu doar modelului vocal, deci este argumentul pentru delegare în acțiune, deși o singură rulare de test este un semnal, nu un verdict.
Ce mai merită urmărit este linia de backenduri a OpenAI, din moment ce GPT-6.1 Sol a apărut la sfârșit de septembrie 2026. Fiecare backend nou poate muta scorurile GPT-Live-1 fără să atingă vocea, în timp ce schimbarea comparabilă la Google ar însemna schimbarea modelului live.
Deocamdată, Gemini 3.8 Live e alegerea mai ușoară pentru orice cu cameră, iar GPT-Live-1 e alegerea mai ușoară pentru produse de telefonie cu un backend deja existent. Oricum ar fi, codul tău tot trebuie să gestioneze problema rezervării din vineri mutată pe joi.
Pentru conceptele de agent din spatele ambelor căi, cursul nostru Introduction to AI Agents acoperă instrumentele, memoria și planificarea.
Întrebări frecvente
Poate GPT-Live-1 să folosească un model Gemini ca backend?
Da. Delegarea din client poate trimite munca către un model text Gemini în spatele propriului tău backend. Ai plăti OpenAI pentru minutele de voce și Google pentru tokenii backendului.
Cât timp poate rămâne o conversație GPT-Live-1 în context?
GPT-Live-1 are o fereastră de context de 128.000 de tokeni care numără tokenii audio, nu doar transcrierea. După ce utilizarea trece de 90%, pornește un motor vocal de înlocuire care poartă până la 8.192 tokeni de istoric recent și rezumate, deci păstrează acțiunile confirmate și starea sarcinii în propria aplicație.
Ce limite de rată se aplică la Gemini 3.8 Live și GPT-Live-1?
GPT-Live-1 permite 50 de sesiuni concomitente pe Build, 300 pe Launch și 500 pe Grow, fără acces în planul gratuit. Google nu publică limite doar pentru Live și te direcționează către Google AI Studio pentru limitele curente ale proiectului tău.
Pot refolosi codul aplicației mele vocale existente?
Mai ales pe Gemini, mai puțin pe OpenAI. Codul scris pentru Gemini 3.1 Flash Live are nevoie în principal de noul string al modelului, minus orice setare thinking_level, pe care gemini-3.8-live nu o acceptă. De asemenea, elimină enable_affective_dialog și proactive_audio: false dacă le cari din modelele mai vechi. GPT-Live-1 folosește propriul endpoint v1/live/sessions în loc de v1/realtime, deci o aplicație Realtime API are nevoie de rework, iar OpenAI publică un ghid de migrare pentru asta.
Este audio-ul Gemini 3.8 Live marcat cu watermark?
Da. Google spune că tot audio-ul generat de produsele sale AI, inclusiv ambele modele Gemini 3.8 Live, poartă un watermark SynthID pe care ascultătorii nu îl aud, lucru util dacă va trebui vreodată să demonstrezi că un apelant a auzit vorbire sintetică.
Asistenții vocali mai vechi funcționează mai ales pe rând: vorbești, aștepți, apoi ei răspund. Gemini 3.8 Live de la Google și GPT-Live-1 de la OpenAI sunt agenți vocali în timp real care pot gestiona întreruperile și schimbările din mijlocul propozițiilor. Niciunul nu e mai bun peste tot.
Diferența e unde are loc „gândirea”. Gemini 3.8 Live te aude, poate inspecta inputul camerei, raționează și decide când să ceară aplicației tale să acționeze. GPT-Live-1 se concentrează pe conversație și poate asculta în timp ce vorbește. Când GPT-Live-1 are nevoie de un raționament mai dificil sau de o acțiune, pasează munca unui al doilea model sau serviciu numit backend.
OpenAI a adus GPT-Live-1 în API în septembrie, iar Google a lansat Gemini 3.8 Live la mai puțin de o săptămână după. Prezentarea noastră despre Gemini 3.8 Live acoperă lansarea Google. Dacă vrei să construiești cu oricare dintre ele, tutorialul Gemini 3.8 Live și tutorialul API-ului GPT-Live-1 acoperă configurarea.
TL;DR
Te grăbești? Iată comparația în șase puncte:
O cerință de cameră sau un backend existent pot tranșa alegerea înainte să o facă clasamentul. Tabelul de mai jos arată de ce.