Gemini 3.8 Live vs. GPT-Live-1 i korthet
Det tabellen nedan inte kan visa är att din egen app i båda fallen fortfarande gör det faktiska arbetet, som att köra dina funktioner och hålla reda på vad användaren har bett om.
|
Jämförelsepunkt |
Gemini 3.8 Live |
GPT-Live-1 |
|
Roll |
En modell som lyssnar, ser, resonerar och ber din app att agera |
Röstmodell som pratar och lämnar över tyngre arbete till en backend |
|
Modell-ID:n |
|
|
|
Inbyggda indata |
Text, ljud, bilder, videorutor |
Endast text och ljud |
|
Var djupare resonemang körs |
Inne i modellen, med mer av det på Extended Thinking |
I en backend du väljer |
|
Vem som kör dina funktioner |
Din applikation (Search-grundning körs på Googles sida) |
Din applikation; hostade verktyg som webbsök körs med backend |
|
Debiteringsenhet |
Tokens, inklusive "thinking tokens" |
Anslutna sessionsminuter, plus backend-användning |
|
Gratisnivå |
Ja |
Nej |
Vad är Gemini 3.8 Live och GPT-Live-1?
Båda är tal-till-tal-modeller, så ljud går in och ljud kommer ut utan separat transkriberingssteg.
Vad är Gemini 3.8 Live?
Gemini 3.8 Live är Googles låglatensmodell för live-dialog. Den tar emot text, bilder, ljud och video, resonerar mellan turerna och anropar funktioner asynkront. Båda Gemini-varianterna listar en 131 072-tokens inmatningsgräns på sina modellsidor.
Gemini 3.8 Live Extended Thinking är en separat modell, inte en inställning. Den lägger till bakgrundsresonemang på låg, medel eller hög nivå medan den berättar om framstegen.
Googles releasenoter listar båda modell-ID:n som allmänt tillgängliga, medan Live API-funktionsguiden fortfarande märker API:et som förhandsversion.
Vad är GPT-Live-1?
GPT-Live-1 är OpenAI:s full-duplex-röstmodell. Full duplex är den tekniska termen för beteendet att lyssna medan man pratar som jag beskrev i inledningen.
OpenAI kallar överlämningen till backend för delegering. Rösten kan fortsätta prata medan det arbetet körs.
GPT-Live-1 är inte heller samma produkt som OpenAI:s GPT-Realtime-2-serie eller backendmodellen den delegerar till. GPT-Realtime-2.1 behåller resonemang och verktyg i en realtidsmodell, så allt jag säger om delegering gäller bara GPT-Live-1.
Vad är den största skillnaden mellan Gemini 3.8 Live och GPT-Live-1?
TL;DR gav den korta versionen, så här är den fullständiga. Gemini 3.8 Live väljer funktionsanrop inne i livesessionen, medan GPT-Live-1 överlämnar resonemanget till en separat backend. I båda designerna kör din applikation dina egna funktioner.
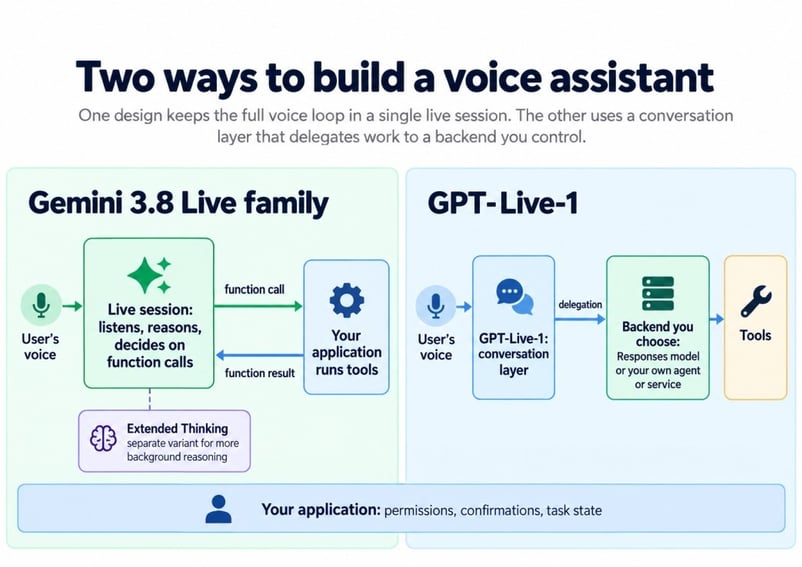
Var varje modell placerar tänkandet. Bild av författaren.
Det mesta som följer kan spåras tillbaka till den uppdelningen, så här är respektive sida först.
Hur Gemini 3.8 Live planerar i en och samma session
Med Gemini finns det ingen andra modell att konfigurera. Livemodellen avger ett funktionsanrop när den behöver data, och din klient returnerar resultatet, som Googles "thinking"-guide beskriver.
Att gå över till Extended Thinking behåller samma WebSocket-endpoint och kräver ingen backendmodell, även om klientkoden ändras.
Hur delegering i GPT-Live-1 fungerar
GPT-Live-1 hanterar talet och avgör när den ska be om hjälp; backend hanterar resonemang, verktyg och affärsregler. OpenAI:s prompting-guide lägger hela uppgiftsproceduren i backendens instruktioner.
Med Responses-delegering kör OpenAI en modell du konfigurerar. Med klientdelegering går arbetet till valfri modell eller tjänst som din applikation kör. Oavsett vilket säger delegeringsguiden att din applikation äger behörigheter, loggar och uppgiftsstatus.
Varför arkitekturskillnaden spelar roll
Priset för uppdelningen är fler delar: en röstsesson, en backend och delat tillstånd mellan dem. I gengäld kan du byta resonemangsmodell utan att röra rösten.
Det bytet ser sämre ut om du inte har någon backend än, men bättre om du behöver uppgradera en befintlig agent utan att ändra dess röst.
Hur hanterar Gemini 3.8 Live och GPT-Live-1 avbrott?
Båda hanterar avbrott, men GPT-Live-1 är byggd kring dem, tillsammans med pauser och "backchannels" (det där "mm-hmm" en lyssnare gör). Gemini 3.8 Live stöder barge-in, och dess proaktiva ljud är alltid på, men Googles dokument kallar det inte full duplex.
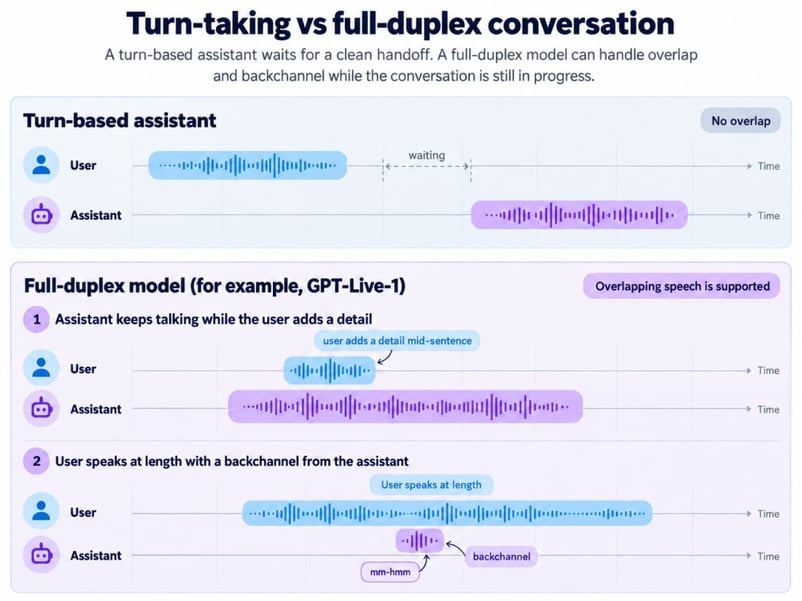
Turas om kontra prata samtidigt. Bild av författaren.
OpenAI:s lanseringsinlägg citerar språkappar Speak som säger att GPT-Live-1 minskade avbrotten med nästan 80% jämfört med turbaserade system, ett kundpåstående snarare än ett oberoende test.
På Gemini gör proaktivt ljud att modellen kan hoppa över tal som inte är avsett för den. Vår Gemini-guide fann att ljud från bärbara datorns högtalare som läcker in i mikrofonen räknas som att användaren avbryter, så testa med och utan hörlurar.
Hur hanterar Gemini 3.8 Live och GPT-Live-1 resonemang och verktygsanrop?
Gemini skalar resonemang genom att byta från basmodellen Live till Extended Thinking. GPT-Live-1 skalar det genom att byta backend, så jämför Extended Thinking med en komplett GPT-Live-1-uppsättning, inte bara röstmodellen.
Gemini 3.8 Live vs. Gemini 3.8 Live Extended Thinking
Basen Gemini 3.8 Live har ingen thinking_level-inställning och accepterar BLOCKING-funktioner för äldre kod. Extended Thinking ändrar fyra klientbeteenden:
-
Verktyg: endast
NON_BLOCKING-funktioner fungerar, och en blockerande returnerar ett hårt fel. -
Resoneringsnivåer: det finns inget minimalt alternativ, bara de tre nivåerna ovan.
-
Slutet på en tur:
turnComplete: truebetyder inte längre att modellen är klar, så din klient bevakarinteraction_statustills den visarIDLE. -
Schemaläggning: funktionsschemaläggning stöds inte.
Google rekommenderar Extended Thinking för flerstegsuppgifter och långsamma verktyg. Det kostar mer latens och utdata-tokens.
En sak störde mig i Googles dokument. Lanseringsinlägget säger att Gemini 3.8 Live kan ”fortsätta chatta medan uppgifter avslutas i bakgrunden”, men thinking-guiden säger att basmodellen ”väntar på verktygskörning innan den talar”. Vår Gemini-guide såg det senare beteendet under en väderuppslagning, så jag skulle planera efter guiden tills Google förtydligar.
Vilka backendmodeller fungerar med GPT-Live-1?
GPT-Live-1 kan stå framför vilken backend du än konfigurerar. OpenAI:s dokument pekar på tre GPT-6-backends:
-
GPT-6 Luna (
gpt-6-luna), delegeringsguidens föreslagna startpunkt -
GPT-6 Sol (
gpt-6-sol), guidens förslag för svårare uppgifter -
GPT-6 Astra, som lanseringsinlägget rekommenderar för komplexa kundärenden
Raderna Artificial Analysis ”GPT-Live-1 (Astra, medium)” och ”GPT-Live-1 (Sol, low)” är systemkonfigurationer, inte versioner av röstmodellen. Artificial Analysis namnger inte Sol-generationen, och OpenAI släppte GPT-6.1 Sol efter dessa tester kördes.
Vad som händer när en uppringare ändrar begäran mitt i en uppgift
Anta att en uppringare ber att flytta en bokning till fredag och sedan säger ”nej, torsdag” medan uppslagningen körs. Det är bara den andra begäran som fortfarande gäller.
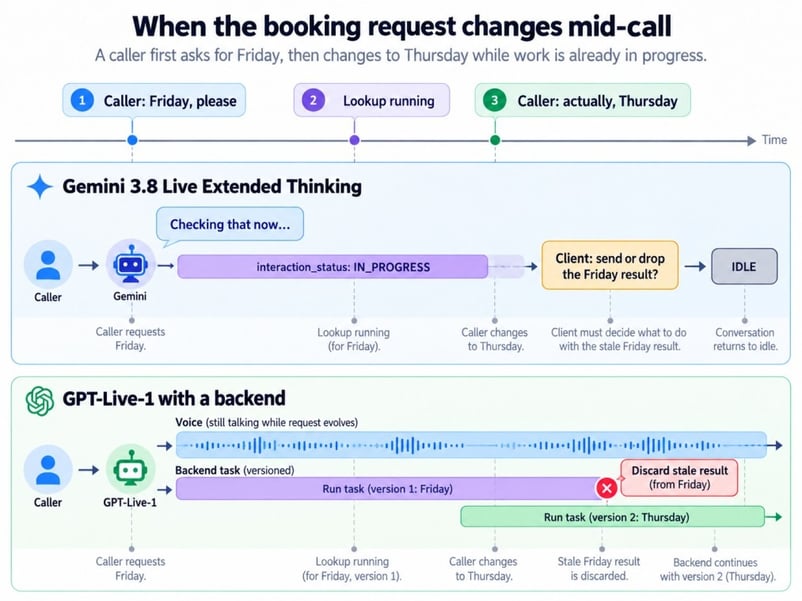
En ändrad begäran under långsamt arbete. Bild av författaren.
På GPT-Live-1 avbryter inte ett avbrott i rösten backend-arbetet. Responses-delegering kan fortfarande returnera det gamla resultatet till rösten, medan klientdelegering låter din kod släppa det först.
På Gemini kan din klient släppa det inaktuella verktygsresultatet. Oavsett vilket avgör din applikation vad som är den nuvarande uppgiften.
Stöder Gemini 3.8 Live och GPT-Live-1 bilder och video?
Gemini 3.8 Live tar emot bilder och video inbyggt; GPT-Live-1 listar båda som ej stödda. En GPT-Live-1-app kan fortfarande skicka ett foto till en separat visions-backend, men den kan inte själv titta på en livekamera.
För Gemini hamnar ramarna i samma session som ljudet, så modellen kan svara ”är det här rätt kabel?” medan användaren håller upp den. Det har två kostnader. Videorutor skickas som standard, och Googles sessionsguide begränsar sessioner med ljud och video till 2 minuter, jämfört med 15 för endast ljud, om du inte slår på komprimering av kontextfönster.
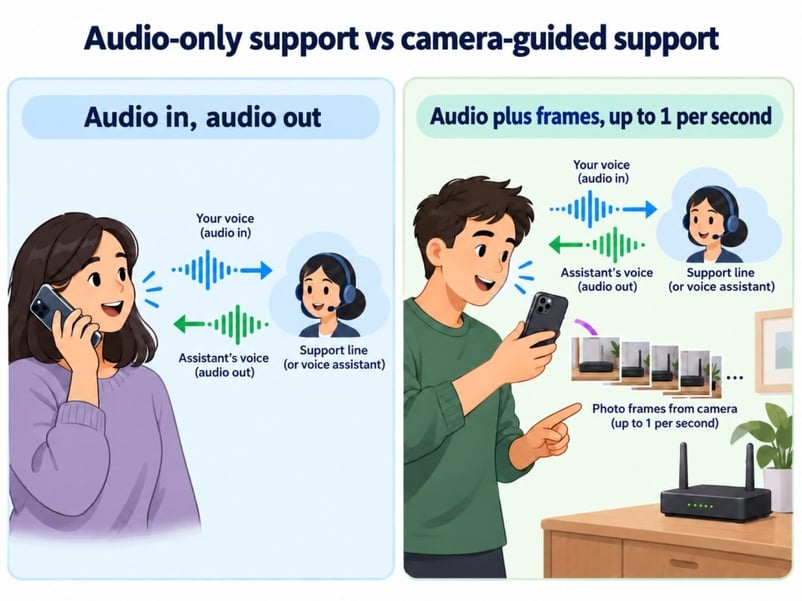
Telefonsamtal kontra kameraplansessioner. Bild av författaren.
En bokningslinje ser aldrig en ruta, och tal-topplistorna nedan mäter inte vision.
Benchmarktester: Gemini 3.8 Live vs. GPT-Live-1
Inget enskilt benchmarktest avgör den här jämförelsen. Bland de fyra konfigurationerna av de två modellerna leder Astra huvudindexet, Sol leder konversationsdynamik och bas-Gemini har högst Arena Elo av de fyra konfigurationerna.
Först hur huvudindexet fungerar, eftersom det förklarar de flesta gapen.
Hur Artificial Analysis Speech to Speech Index fungerar
Indexet ger lika vikt åt fyra olika färdigheter:
- Big Bench Audio: resonemangsfrågor som ställs högt
- τ-Voice: flerstegsuppgifter i kundtjänst, såsom att ändra en flygning
- Arena-poäng: blinda mänskliga röster om vilken agent man föredrog
- Uppgiftsframgång: hur ofta en konversation slutade med rätt slutgiltiga verktygsanrop
Konversationsdynamik rapporteras separat enligt metodik v2.0.
Här är de fyra konfigurationerna som är relevanta här.
|
Konfiguration |
Index |
Big Bench Audio |
τ-Voice |
Konversationsdynamik |
Arena Elo |
Uppgiftsframgång |
TTFA |
|
GPT-Live-1 (Astra, medium) |
83.2 |
90,1% |
74,5% |
94,9% |
1027 |
87,4% |
1,34 s |
|
Gemini 3.8 Live Extended Thinking (Hög) |
82.6 |
97,7% |
68,6% |
91,9% |
966 |
89,1% |
1,35 s |
|
GPT-Live-1 (Sol, low) |
80.1 |
89,0% |
59,3% |
97,3% |
1037 |
90,9% |
1,24 s |
|
Gemini 3.8 Live |
74.5 |
91,7% |
30,1% |
96,1% |
1074 |
93,2% |
1,18 s |
Boda GPT-Live-1:s τ-Voice-poäng kommer från en körning, så behandla dem med försiktighet.
Agentuppgifter vs. mänskliga preferenspoäng
På τ-Voice får Astra 74,5%, Extended Thinking 68,6% och bas-Gemini 30,1%. Extra resonemang spelar roll när verktyg kedjas.
Konversation berättar en annan historia: Sol har högst poäng, och Arenas konfidensintervall för bas-Gemini och Sol överlappar.
Det 0,6-poängs gap i index mellan Astra och Extended Thinking har inget publicerat konfidensintervall. De har redan bytt plats en gång, så jag skulle fortfarande kalla det oavgjort.
Vilken modell svarar snabbare?
Basen Gemini 3.8 Live har kortast tid till första ljud (TTFA) i tabellen, men spridningen över alla fyra är under 0,2 sekunder. TTFA är hur lång tid en modell tar att producera sin första ljudtoken.
TTFA fångar inte avbrottssvar och tiden som krävs för att slutföra en bokning eller uppslagning. Det senare beror mer på din backend och dina verktyg.
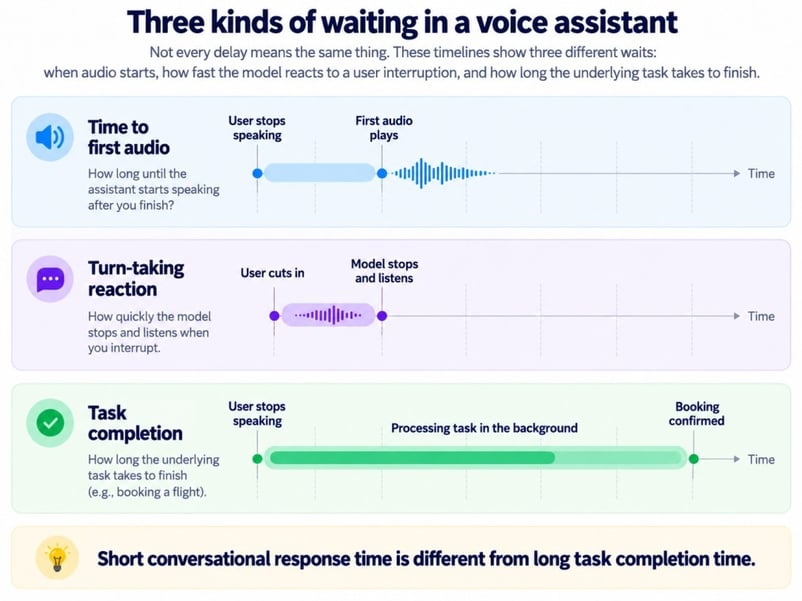
Tre sorters väntan i röst. Bild av författaren.
Både Extended Thinking och GPT-Live-1 kan fortsätta prata genom ett långsamt uppslag. Uppringaren väntar fortfarande på bokningen.
Vad röst-benchmarks inte mäter
För en supportlinje kan topplistorna inte berätta:
- om din telefonileverantör och codec levererar det rent
- om agenten fortfarande följer ditt manus efter tio minuter
- hur den hör en uppringare med stark accent på en bullrig gata
- vad samtalet kostade när backend och verktyg räknas in
En pilot med dina egna inspelningar besvarar de frågorna bättre.
Priser: Vad är billigast – Gemini 3.8 Live eller GPT-Live-1?
Basen Gemini är billigast i Artificial Analysis test, men modellerna tar betalt för olika saker. Kostnad per lyckad uppgift spelar större roll än prislappen i sig.
Nedanstående priser är listpriser på Googles prissida och GPT-Live-1:s modellsida när jag skriver detta, och Geminis per-minut-siffror är Googles egna omräkningar från tokenpriser.
|
Kostnadspost |
Gemini 3.8 Live och Extended Thinking (betald nivå) |
GPT-Live-1 |
|
Ljudinmatning |
$3,00 per 1M tokens (cirka $0,005/min) |
Täcks av $0,05 per minut, debiteras per sekund |
|
Ljudutmatning |
$12,00 per 1M tokens (cirka $0,018/min) |
Täcks av samma sessionsavgift |
|
Bild- eller videoinmatning |
$1,00 per 1M tokens (cirka $0,002/min) |
Stöds inte |
|
Resonemang |
"Thinking tokens" debiteras till utdata-priser |
Backendmodellens tokens till den modellens pris |
|
Sök och verktyg |
5 000 kostnadsfria sökförfrågningar per månad, därefter $14 per 1 000 |
Debiteras av backend-modellen och verktygen du använder |
"Thinking tokens" gör att Extended Thinking kostar mer än bas-Gemini. Artificial Analysis uppskattar $0,84 per timme inmatat ljud för bas-Gemini, $3,50 för Extended Thinking, $4,47 för Sol och $5,83 för Astra, exklusive verktyg och cache-rabatter. Gemini Live stöder inte cachning; en GPT-Live-1-backend kan göra det.
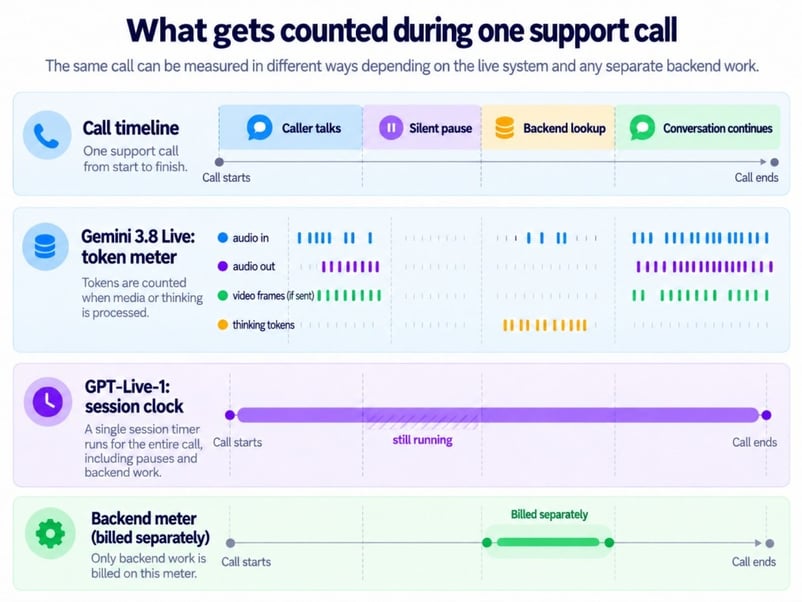
Vad varje mätare räknar under samtal. Bild av författaren.
GPT-Live-1:s klocka går genom tystnad, och muting stoppar den inte. Addera tabellens avgifter och telefonkostnader och dividera sedan med slutförda uppgifter.
Stöd i webbläsare, på server och telefon för Gemini 3.8 Live och GPT-Live-1
Webbläsar- och serverappar kan ansluta till båda modellerna, men telefonutrullning särskiljer dem. Diagrammet visar anslutningsalternativen; de operativa skillnaderna är anslutningens livslängd och vem som sitter i samtalsvägen.
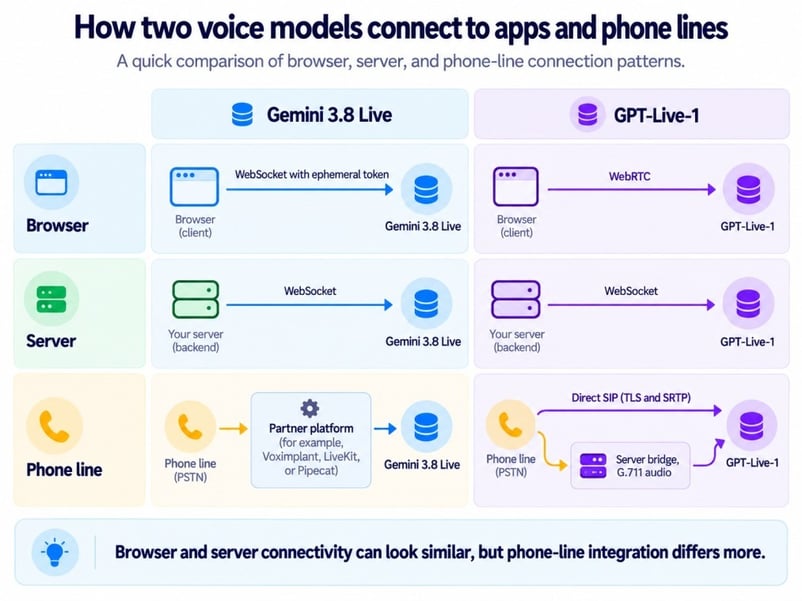
Anslutningsvägar för webbläsare, server och telefon. Bild av författaren.
Gemini-anslutningar återställs efter cirka 10 minuter, så längre samtal behöver sessionsåterupptagning. Med GPT-Live-1 bör du logga röstanslutningen och delegerat backend-arbete separat.
Telefonsamtal och SIP-stöd
Direkt SIP lämnar en leverantör mindre i GPT-Live-1:s samtalsväg. Geminis partnerväg lägger till ytterligare en tjänst att konfigurera, övervaka och felsöka.
Några utvecklare på OpenAI:s forum rapporterar att GPT-Live-1 lovar en åtgärd utan att skapa en delegering. OpenAI:s support har inte kallat det en bugg; de pekade på sin prompting-guide, som noterar att ett muntligt bekräftande inte bevisar att backend-arbetet startat. Jag skulle logga delegeringshändelser separat från talet.
Sedan 2 november stöder OpenAI även utgående SIP-samtal för alla organisationer, så GPT-Live-1 kan ringa samtal såväl som besvara dem.
Gemini 3.8 Live vs. GPT-Live-1: Vilken ska du använda?
Valet kokar ner till två frågor: behöver assistenten se, och har du redan en backend? Ja på den första pekar mot Gemini; ja på den andra pekar mot GPT-Live-1.
Hoppa till scenariot nedan som matchar din produkt.
Telefonsupport och bokningar
En telefonlinje behöver hantera avbrott och bekräftelser innan något oåterkalleligt sker. GPT-Live-1 passar väl, med SIP-stödet ovan och bokningslogik som hålls i backend.
Felsökning med kamera och skärm
När en användare riktar en telefon mot en router måste modellen resonera om vad den ser just nu. Gemini 3.8 Live gör det i en och samma session, utan separat visionskomponent, så länge du planerar för 2-minutersgränsen för video från avsnittet om bilder.
Flerstegsarbete i bakgrunden
För uppgifter som kedjar verktyg, jämför Extended Thinking med GPT-Live-1 plus Astra. Astra leder τ-Voice i en körning, så valet handlar fortfarande om var resonemanget ska bo.
Lägga till röst i en agent du redan kör
Klientdelegering kan lägga till GPT-Live-1 i en befintlig agent utan att skriva om dess resonemangsloop. Med Gemini blir livemodellen planeraren.
Hög samtalsvolym med tajt budget
Korta, enkla samtal pekar mot bas-Gemini, den billigaste uppsättningen i Artificial Analysis test. Flerstegsverktyg ändrar den kalkylen.
Avslutande tankar
Det tydligaste sättet att rama in den här jämförelsen är att Gemini 3.8 Live kombinerar seende, resonemang och tal i en modell, medan GPT-Live-1 separerar rösten från intelligensen bakom. Ingen dominerar, och de två ligger tillräckligt nära varandra i hur mänskliga de låter och hur snabbt de svarar för att arkitekturen ska avgöra de flesta verkliga beslut.
Det jag tycker är mest intressant är hur snabbt agentuppgiftsledningen rörde sig mot GPT-Live-1 med Astra. Den poängen tillhör hela systemet, inte bara röstmodellen, så det är delegeringsargumentet i praktiken, även om en testrunda är en signal och inte en dom.
Det andra värt att bevaka är OpenAI:s backendutbud, eftersom GPT-6.1 Sol kom i slutet av september 2026. Varje ny backend kan flytta GPT-Live-1:s poäng utan att röra rösten, medan en jämförbar förändring hos Google skulle kräva att byta livemodell.
Just nu är Gemini 3.8 Live det enklare valet för allt med kamera, och GPT-Live-1 är det enklare valet för telefonprodukter med en backend på plats. Oavsett vilket måste din kod fortfarande hantera problemet med att ändra bokning från fredag till torsdag.
För agentkoncepten bakom respektive väg täcker vår Introduktion till AI-agenter verktyg, minne och planering.
FAQs
Kan GPT-Live-1 använda en Gemini-modell som sin backend?
Ja. Klientdelegering kan skicka arbetet till en Gemini-textmodell bakom din egen backend. Du skulle betala OpenAI för röstminuter och Google för backend-tokens.
Hur länge kan ett GPT-Live-1-samtal ligga kvar i kontext?
GPT-Live-1 har ett kontextfönster på 128 000 tokens som räknar ljudtokens, inte bara transkriptionen. När användningen passerar 90% startar den en ersättande röstmotor som bär upp till 8 192 tokens av senaste historik och sammanfattningar, så behåll bekräftade åtgärder och uppgiftsstatus i din egen applikation.
Vilka hastighetsgränser gäller för Gemini 3.8 Live och GPT-Live-1?
GPT-Live-1 tillåter 50 samtidiga sessioner på Build, 300 på Launch och 500 på Grow, utan gratisnivå. Google publicerar inga gränser enbart för Live och hänvisar dig till Google AI Studio för ditt projekts aktuella gränser.
Kan jag återanvända min befintliga röstappskod?
Mest på Gemini, mindre på OpenAI. Kod skriven för Gemini 3.1 Flash Live behöver främst den nya modellsträngen, minus eventuell thinking_level-inställning, som gemini-3.8-live inte accepterar. Ta också bort enable_affective_dialog och proactive_audio: false om din kod bär med dem från äldre modeller. GPT-Live-1 använder sin egen v1/live/sessions-endpoint i stället för v1/realtime, så en Realtime API-app behöver göras om, och OpenAI publicerar en migreringsguide för det.
Är ljudet från Gemini 3.8 Live vattenmärkt?
Ja. Google säger att allt ljud som genereras av dess AI-produkter, inklusive båda Gemini 3.8 Live-modellerna, bär en SynthID-vattenstämpel som lyssnare inte hör, vilket hjälper om du någon gång behöver visa att en uppringare hörde syntetiskt tal.
Äldre röstassistenter turas mest om: du pratar, du väntar och sedan svarar de. Googles Gemini 3.8 Live och OpenAI:s GPT-Live-1 är röstagenter i realtid som klarar avbrott och ändringar mitt i en mening. Ingen av dem är generellt bäst på allt.
Skillnaden ligger i var tänkandet sker. Gemini 3.8 Live lyssnar på dig, kan granska kamerainmatning, resonerar och avgör när din app ska agera. GPT-Live-1 fokuserar på konversationen och kan lyssna medan den pratar. När GPT-Live-1 behöver mer avancerat resonemang eller en åtgärd överlämnar den arbetet till en andra modell eller tjänst som kallas backend.
OpenAI lanserade GPT-Live-1 i sitt API i september, och Google släppte Gemini 3.8 Live mindre än en vecka senare. Vår översikt av Gemini 3.8 Live täcker Googles lansering. Om du vill bygga med någon av dem går vår Gemini 3.8 Live-guide och GPT-Live-1 API-guide igenom uppsättningen.
TL;DR
Ont om tid? Här är jämförelsen i sex punkter:
Ett kamerakrav eller en befintlig backend kan avgöra valet redan innan topplistorna gör det. Tabellen nedan visar varför.