
Gemini 3.8 Live vs. GPT-Live-1 im Überblick
Was die Tabelle nicht zeigt: In beiden Fällen erledigt deine eigene App weiterhin die eigentliche Arbeit, etwa das Ausführen deiner Funktionen und das Nachhalten der Nutzerwünsche.
|
Vergleichspunkt |
Gemini 3.8 Live |
GPT-Live-1 |
|
Rolle |
Ein Modell, das zuhört, sieht, schlussfolgert und deine App um Aktionen bittet |
Sprachmodell, das spricht und harte Arbeit an ein Backend übergibt |
|
Modell-IDs |
|
|
|
Native Eingaben |
Text, Audio, Bilder, Videoframes |
Nur Text und Audio |
|
Wo tiefere Schlüsse laufen |
Im Modell, mit mehr davon bei Extended Thinking |
In einem Backend deiner Wahl |
|
Wer deine Funktionen ausführt |
Deine Anwendung (Search Grounding läuft bei Google) |
Deine Anwendung; gehostete Tools wie Websuche laufen mit dem Backend |
|
Abrechnungseinheit |
Tokens, inklusive Thinking-Tokens |
Verbundene Sitzungsminuten, plus Backend-Nutzung |
|
Free Tier |
Ja |
Nein |
Was sind Gemini 3.8 Live und GPT-Live-1?
Beide sind Speech-to-Speech-Modelle: Audio rein, Audio raus – ohne separaten Transkriptionsschritt.
Was ist Gemini 3.8 Live?
Gemini 3.8 Live ist Googles Live-Dialogmodell mit niedriger Latenz. Es nimmt Text, Bilder, Audio und Video an, denkt zwischen den Turns und ruft Funktionen asynchron auf. Beide Gemini-Varianten nennen ein Eingabelimit von 131.072 Tokens auf ihren Modellseiten.
Gemini 3.8 Live Extended Thinking ist ein eigenes Modell, keine Einstellung. Es fügt Hintergrund-Reasoning auf niedrigem, mittlerem oder hohem Niveau hinzu und kommentiert den Fortschritt.
Googles Release Notes listen beide Modell-IDs als allgemein verfügbar, während der Live API Fähigkeitsleitfaden die API noch als Vorschau markiert.
Was ist GPT-Live-1?
GPT-Live-1 ist OpenAIs Vollduplex-Sprachmodell. Vollduplex ist der technische Begriff für das „Zuhören während des Sprechens“ aus der Einleitung.
OpenAI nennt die Übergabe ans Backend Delegation. Die Stimme kann weitersprechen, während diese Arbeit läuft.
GPT-Live-1 ist auch nicht dasselbe Produkt wie OpenAIs GPT-Realtime-2-Linie oder das Backend-Modell, an das es delegiert. GPT-Realtime-2.1 behält Reasoning und Tools in einem Realtime-Modell, daher gilt alles zur Delegation nur für GPT-Live-1.
Was ist der Hauptunterschied zwischen Gemini 3.8 Live und GPT-Live-1?
Die TL;DR gab die Kurzfassung, hier die ausführliche: Gemini 3.8 Live entscheidet über Funktionsaufrufe innerhalb der Live-Session, während GPT-Live-1 das Reasoning an ein separates Backend übergibt. In beiden Designs führt deine Anwendung die eigenen Funktionen aus.
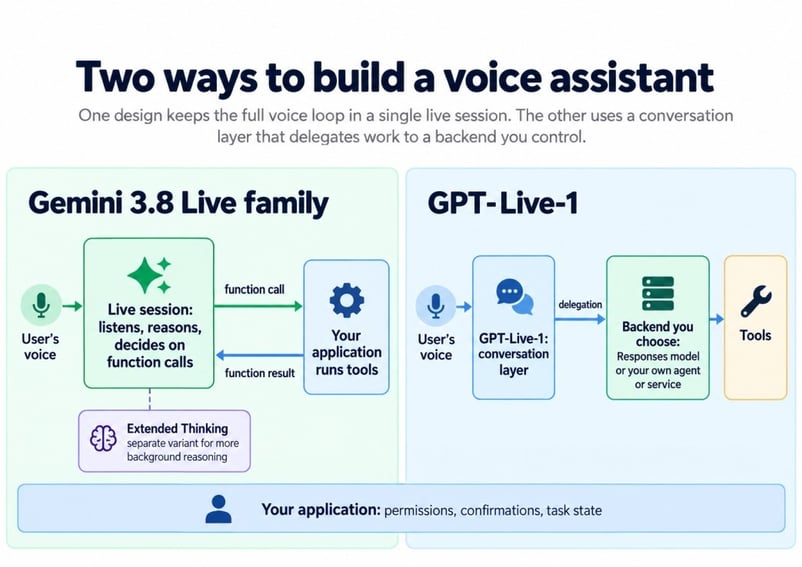
Wo jedes Modell das Denken verortet. Bild: Autor.
Das meiste im Folgenden führt auf diese Aufteilung zurück. Hier zuerst beide Seiten.
Wie Gemini 3.8 Live innerhalb einer Session plant
Bei Gemini gibt es kein zweites Modell zum Konfigurieren. Das Live-Modell gibt einen Funktionsaufruf aus, wenn es Daten braucht, und dein Client liefert das Ergebnis zurück, wie es der Thinking-Leitfaden von Google beschreibt.
Der Wechsel zu Extended Thinking nutzt denselben WebSocket-Endpunkt und benötigt kein Backend-Modell, auch wenn sich der Client-Code ändert.
Wie die Delegation in GPT-Live-1 funktioniert
GPT-Live-1 übernimmt Sprache und entscheidet, wann Hilfe nötig ist; das Backend übernimmt Reasoning, Tools und Geschäftsregeln. OpenAIs Prompting-Guide verankert den gesamten Aufgabenablauf in den Instruktionen des Backends.
Bei Responses-Delegation betreibt OpenAI ein von dir konfiguriertes Modell. Bei Client-Delegation geht die Arbeit an jedes Modell oder jeden Service, den deine Anwendung betreibt. So oder so hält laut Delegationsleitfaden deine Anwendung Berechtigungen, Aufzeichnungen und Aufgabenstatus.
Warum der Architekturunterschied wichtig ist
Der Preis der Aufteilung sind mehr Bausteine: eine Sprachsession, ein Backend und geteilter Zustand dazwischen. Im Gegenzug kannst du das Reasoning-Modell tauschen, ohne die Stimme zu ändern.
Das wirkt schlechter, wenn du noch kein Backend hast, aber besser, wenn du einen bestehenden Agenten aufrüsten willst, ohne dessen Stimme zu ändern.
Wie gehen Gemini 3.8 Live und GPT-Live-1 mit Unterbrechungen um?
Beide beherrschen Unterbrechungen, aber GPT-Live-1 ist darum herum gebaut – inklusive Pausen und Backchannels (das „hm-hm“ eines Zuhörers). Gemini 3.8 Live unterstützt Barge-In, und sein proaktives Audio ist immer an, aber Googles Doku nennt es nicht Vollduplex.
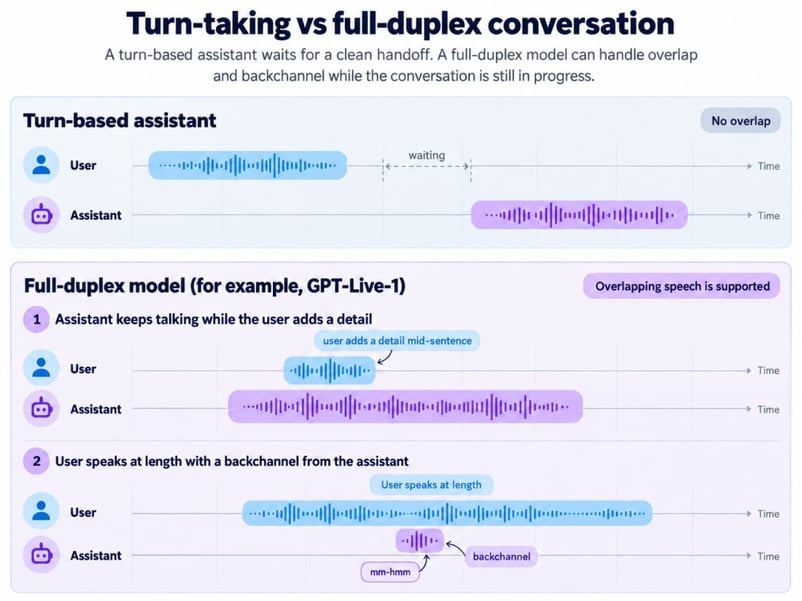
Abwechselnd reden versus gleichzeitig sprechen. Bild: Autor.
OpenAIs Launch-Post zitiert die Sprachlern-App Speak, wonach GPT-Live-1 Unterbrechungen gegenüber Turn-basierten Systemen um fast 80% senkte – eine Kundenangabe, kein unabhängiger Test.
Bei Gemini lässt proaktives Audio das Modell Redeanteile überspringen, die nicht an es gerichtet sind. Unser Gemini-Tutorial zeigte: Laptop-Lautsprecherton, der ins Mikro leckt, zählt als Nutzereinwurf – also mit und ohne Kopfhörer testen.
Wie handhaben Gemini 3.8 Live und GPT-Live-1 Reasoning und Tool-Aufrufe?
Gemini skaliert Reasoning durch den Wechsel vom Basis-Live zum Extended Thinking. GPT-Live-1 skaliert über das Backend – vergleiche daher Extended Thinking mit einem vollständigen GPT-Live-1-Setup, nicht mit dem Sprachmodell allein.
Gemini 3.8 Live vs. Gemini 3.8 Live Extended Thinking
Das Basis-Gemini 3.8 Live hat keine thinking_level-Einstellung und akzeptiert BLOCKING-Funktionen für älteren Code. Extended Thinking ändert vier Client-Verhaltensweisen:
-
Tools: Es funktionieren nur
NON_BLOCKING-Funktionen; eine blocking-Funktion liefert einen harten Fehler. -
Thinking Levels: Es gibt keine Minimaloption, nur die drei oben genannten Stufen.
-
Turn-Ende:
turnComplete: truebedeutet nicht mehr, dass das Modell fertig ist; dein Client beobachtetinteraction_statusbisIDLE. -
Scheduling: Funktionsplanung wird nicht unterstützt.
Google empfiehlt Extended Thinking für mehrstufige Aufgaben und langsame Tools. Das kostet mehr Latenz und Ausgabetokens.
Eines hat mich in Googles Doku gestört: Der Launch-Post sagt, Gemini 3.8 Live könne „weiterplaudern, während Aufgaben im Hintergrund fertig werden“, doch der Thinking-Guide sagt, das Basismodell „wartet vor dem Sprechen auf die Tool-Ausführung“. Unser Tutorial sah Letzteres bei einer Wetterabfrage. Ich würde mich bis zur Klarstellung an den Guide halten.
Welche Backend-Modelle funktionieren mit GPT-Live-1?
GPT-Live-1 kann vor jedem von dir konfigurierten Backend sitzen. OpenAIs Doku verweist auf drei GPT-6-Backends:
-
GPT-6 Luna (
gpt-6-luna), der empfohlene Einstieg des Delegations-Guides -
GPT-6 Sol (
gpt-6-sol), die Empfehlung für schwierigere Aufgaben -
GPT-6 Astra, das der Launch-Post für komplexe Kundenanliegen empfiehlt
Die Artificial Analysis-Zeilen „GPT-Live-1 (Astra, medium)“ und „GPT-Live-1 (Sol, low)“ sind Systemkonfigurationen, keine Varianten des Sprachmodells. Artificial Analysis nennt die Sol-Generation nicht, und OpenAI veröffentlichte GPT-6.1 Sol nach diesen Tests.
Was passiert, wenn Anrufende mitten in der Aufgabe umschwenken
Beispiel: Eine Anruferin will eine Buchung auf Freitag verschieben und sagt dann während der Suche „eigentlich Donnerstag“. Nur die zweite Anfrage zählt weiter.
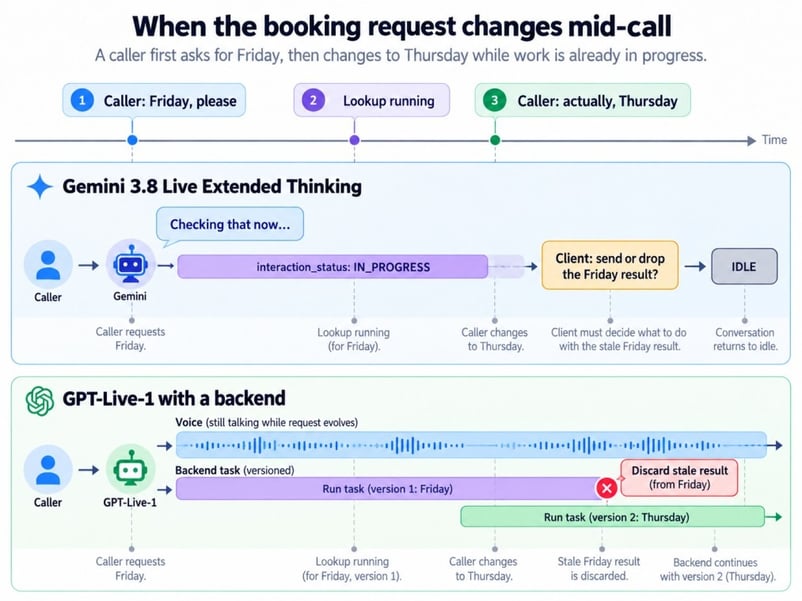
Geänderte Anfrage während langsamer Arbeit. Bild: Autor.
Bei GPT-Live-1 bricht eine Sprachunterbrechung die Backend-Arbeit nicht ab. Responses-Delegation kann das alte Ergebnis dennoch an die Stimme zurückgeben, während Client-Delegation es zuerst verwerfen lässt.
Bei Gemini kann dein Client das veraltete Tool-Ergebnis verwerfen. In beiden Fällen bestimmt deine Anwendung, was die aktuelle Aufgabe ist.
Unterstützen Gemini 3.8 Live und GPT-Live-1 Bilder und Video?
Gemini 3.8 Live nimmt Bilder und Video nativ an; GPT-Live-1 führt beide als nicht unterstützt. Eine GPT-Live-1-App kann ein Foto an ein separates Vision-Backend senden, aber nicht selbst eine Live-Kamera verfolgen.
Bei Gemini laufen Frames in dieselbe Session wie das Audio, sodass das Modell etwa „Ist das das richtige Kabel?“ beantworten kann, während der Nutzer es hochhält. Das hat zwei Kosten: Videoframes werden standardmäßig gesendet, und Googles Session-Guide begrenzt Sessions mit Audio und Video auf 2 Minuten (gegenüber 15 bei nur Audio), außer du aktivierst Context-Window-Kompression.
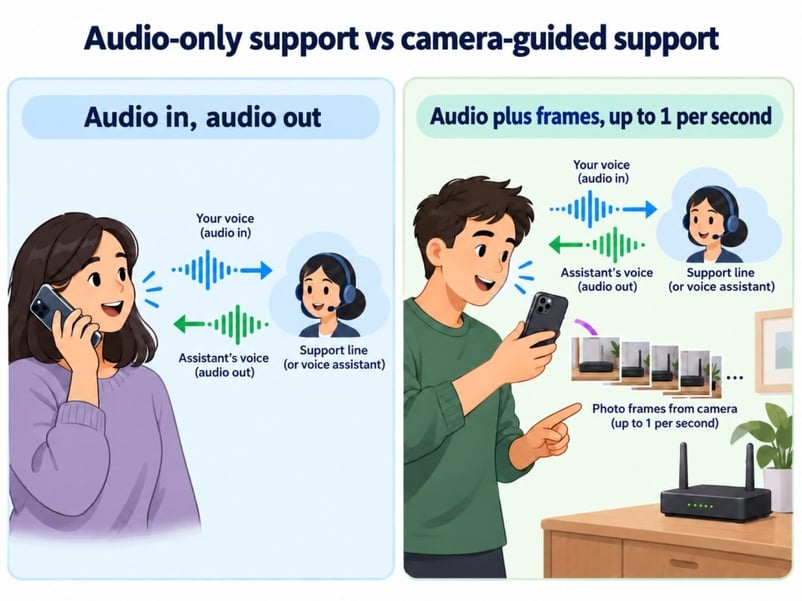
Telefonate versus Kamera-Reparatursessions. Bild: Autor.
Eine Reservierungs-Hotline sieht nie ein Frame, und die Sprachranglisten unten messen keine Vision.
Gemini 3.8 Live vs. GPT-Live-1 Benchmarks
Kein einzelner Benchmark entscheidet diesen Vergleich. Unter den vier Konfigurationen führt Astra den Hauptindex an, Sol führt die Konversationsdynamik, und das Basis-Gemini hat die höchste Arena-Elo der vier.
Zuerst kurz, wie der Hauptindex funktioniert – das erklärt die meisten Abstände.
So funktioniert der Artificial Analysis Speech-to-Speech Index
Der Index gewichtet vier unterschiedliche Fähigkeiten gleich:
- Big Bench Audio: Reasoning-Fragen, laut gestellt
- τ-Voice: mehrstufige Kundenserviceaufgaben, z. B. Flug umbuchen
- Arena-Score: Blinde menschliche Abstimmungen, welcher Agent bevorzugt wurde
- Task Success Rate: Wie oft ein Gespräch mit dem richtigen finalen Tool-Call endete
Konversationsdynamik wird separat nach der v2.0-Methodik berichtet.
Hier sind die vier relevanten Konfigurationen.
|
Konfiguration |
Index |
Big Bench Audio |
τ-Voice |
Konversationsdynamik |
Arena Elo |
Task Success |
TTFA |
|
GPT-Live-1 (Astra, medium) |
83.2 |
90,1% |
74,5% |
94,9% |
1027 |
87,4% |
1,34 s |
|
Gemini 3.8 Live Extended Thinking (High) |
82.6 |
97,7% |
68,6% |
91,9% |
966 |
89,1% |
1,35 s |
|
GPT-Live-1 (Sol, low) |
80.1 |
89,0% |
59,3% |
97,3% |
1037 |
90,9% |
1,24 s |
|
Gemini 3.8 Live |
74.5 |
91,7% |
30,1% |
96,1% |
1074 |
93,2% |
1,18 s |
Beide τ-Voice-Werte für GPT-Live-1 stammen aus einem Lauf – mit Vorsicht genießen.
Agentenaufgaben vs. menschliche Präferenzwerte
Bei τ-Voice erzielt Astra 74,5%, Extended Thinking 68,6% und das Basis-Gemini 30,1%. Mehr Reasoning zahlt sich aus, sobald Tools verkettet werden.
Das Gespräch erzählt eine andere Geschichte: Sol liegt vorn, und die Arena-Konfidenzintervalle von Basis-Gemini und Sol überlappen.
Die Indexdifferenz von 0,6 Punkten zwischen Astra und Extended Thinking hat kein veröffentlichtes Konfidenzintervall. Beide haben schon Plätze getauscht – ich würde es weiter als Kopf-an-Kopf werten.
Welches Modell reagiert schneller?
Das Basis-Gemini 3.8 Live hat die schnellste Time to First Audio (TTFA) in der Tabelle, aber die Spanne über alle vier liegt unter 0,2 Sekunden. TTFA misst die Zeit bis zum ersten Audiotoken.
TTFA erfasst weder Reaktionen auf Unterbrechungen noch die Zeit bis zum Abschluss einer Buchung oder Abfrage. Letzteres hängt stärker von deinem Backend und den Tools ab.
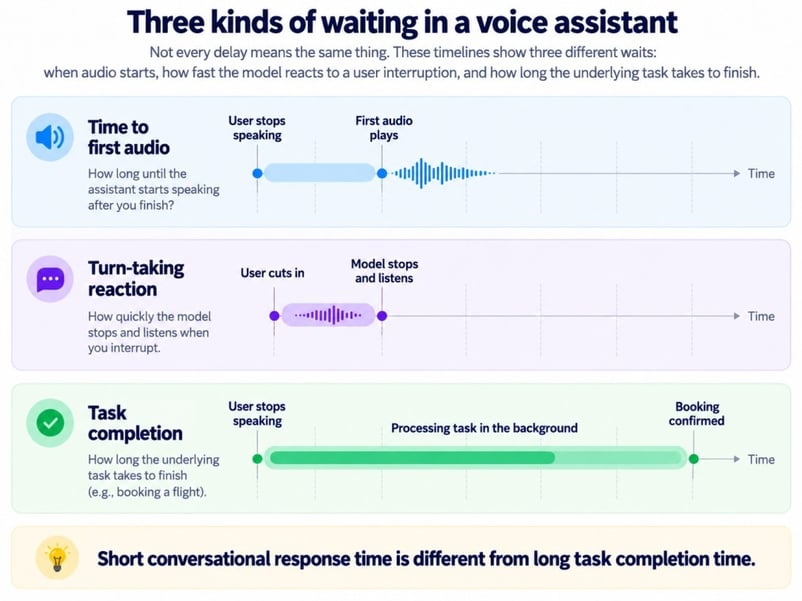
Drei Arten des Wartens in Sprachinteraktionen. Bild: Autor.
Sowohl Extended Thinking als auch GPT-Live-1 können während einer langsamen Suche weitersprechen. Warten auf die Buchung bleibt trotzdem.
Was Sprachbenchmarks nicht messen
Für eine Support-Hotline sagen dir Ranglisten nicht:
- ob Provider und Codec den Ton sauber übertragen
- ob der Agent deinem Skript nach zehn Minuten noch folgt
- wie er starke Akzente in lauter Umgebung versteht
- was der Anruf kostet, wenn Backend und Tools eingerechnet sind
Ein Pilot mit deinen eigenen Aufnahmen liefert hier die besseren Antworten.
Gemini 3.8 Live vs. GPT-Live-1 Preise: Was ist günstiger?
Basis-Gemini ist im Test von Artificial Analysis am günstigsten, aber die Modelle rechnen unterschiedliche Dinge ab. Kosten pro erfolgreicher Aufgabe zählen mehr als der Etikettenpreis.
Die folgenden Sätze sind Listenpreise auf Googles Preisseite und der GPT-Live-1-Modellseite zum Zeitpunkt des Schreibens; Geminis Minutenwerte sind Googles eigene Umrechnungen aus Tokenpreisen.
|
Kostenpunkt |
Gemini 3.8 Live und Extended Thinking (Paid Tier) |
GPT-Live-1 |
|
Audioeingabe |
$3,00 pro 1 Mio. Tokens (ca. $0,005/Min) |
Abgedeckt durch $0,05 pro Minute, sekundengenau |
|
Audioausgabe |
$12,00 pro 1 Mio. Tokens (ca. $0,018/Min) |
Durch dieselbe Sitzungsgebühr abgedeckt |
|
Bild- oder Videoeingabe |
$1,00 pro 1 Mio. Tokens (ca. $0,002/Min) |
Nicht unterstützt |
|
Reasoning |
Thinking-Tokens zum Ausgaberate-Tarif |
Backend-Model-Token zum jeweiligen Modellpreis |
|
Suche und Tools |
5.000 kostenlose Search-Anfragen/Monat, danach $14 pro 1.000 |
Abrechnung über das Backend-Modell und die genutzten Tools |
Thinking-Tokens machen Extended Thinking teurer als Basis-Gemini. Artificial Analysis schätzt $0,84 pro Eingabe-Audiostunde für Basis-Gemini, $3,50 für Extended Thinking, $4,47 für Sol und $5,83 für Astra – exklusive Tools und Cache-Rabatte. Gemini Live unterstützt kein Caching; ein GPT-Live-1-Backend kann es.
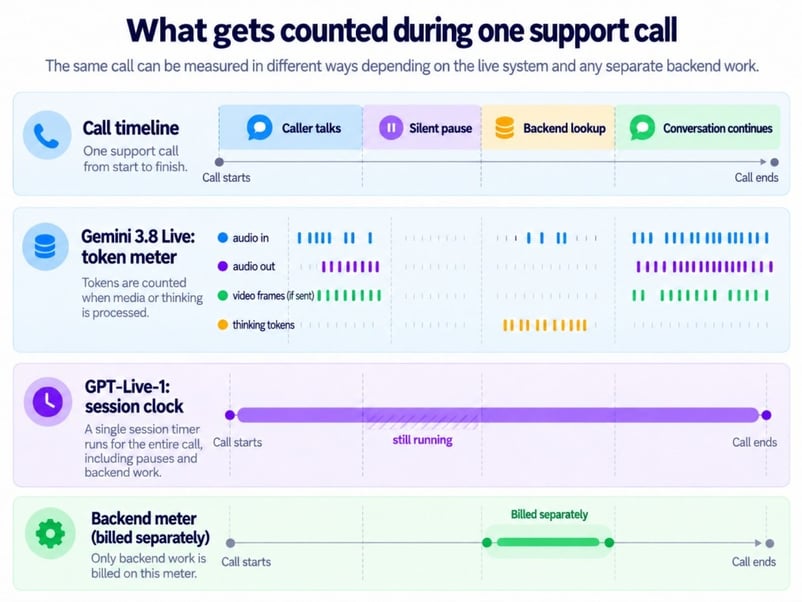
Was jede Uhr während Anrufen zählt. Bild: Autor.
Die Uhr von GPT-Live-1 läuft durch stille Phasen; Stummschalten stoppt sie nicht. Addiere die Tabellengebühren und Telefonkosten und teile sie durch abgeschlossene Aufgaben.
Browser-, Server- und Telefonsupport in Gemini 3.8 Live und GPT-Live-1
Browser- und Server-Apps können sich mit beiden Modellen verbinden, aber die Telefonie trennt sie. Die Grafik zeigt die Verbindungswege; operativ unterscheiden sie sich in Verbindungsdauer und wer im Call-Path sitzt.
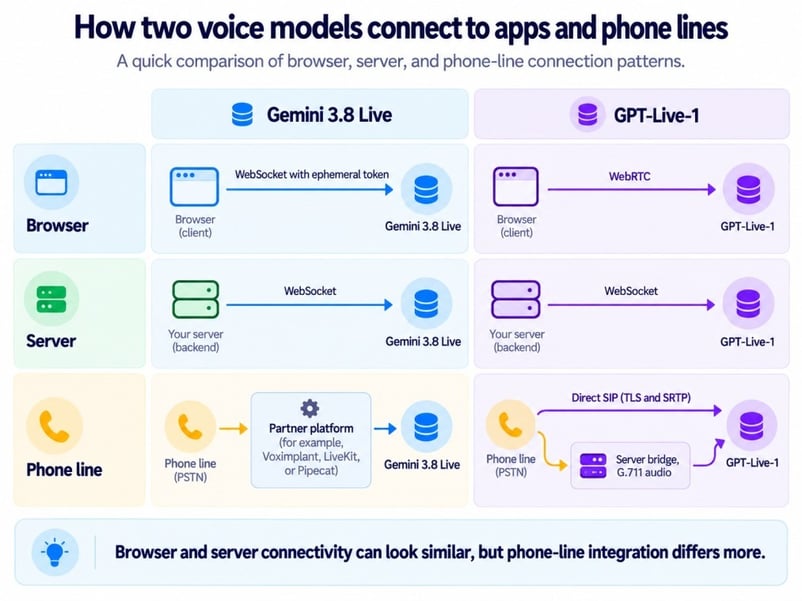
Browser-, Server- und Telefon-Verbindungspfade. Bild: Autor.
Gemini-Verbindungen setzen sich nach ca. 10 Minuten zurück, längere Anrufe brauchen Session-Fortsetzung. Bei GPT-Live-1 solltest du Sprachverbindung und delegierte Backend-Arbeit getrennt loggen.
Telefonate und SIP-Support
Direktes SIP lässt bei GPT-Live-1 einen Anbieter weniger im Call-Path. Geminis Partnerroute fügt einen weiteren Dienst hinzu, den du konfigurieren, überwachen und debuggen musst.
Einige Entwickler im OpenAI-Forum berichten, GPT-Live-1 verspreche eine Aktion, ohne eine Delegation zu erstellen. OpenAI-Support nannte es keinen Bug; verwies auf den Prompting-Guide, der festhält, dass eine mündliche Bestätigung nicht belegt, dass Backend-Arbeit gestartet wurde. Ich würde Delegations-Events separat vom Gesprochenen loggen.
Seit dem 2. November unterstützt OpenAI zudem ausgehende SIP-Anrufe für alle Organisationen – GPT-Live-1 kann also Anrufe tätigen und annehmen.
Gemini 3.8 Live vs. GPT-Live-1: Was solltest du nutzen?
Die Entscheidung hängt an zwei Fragen: Muss der Assistent sehen, und hast du bereits ein Backend? Ein Ja zur ersten spricht für Gemini; ein Ja zur zweiten für GPT-Live-1.
Springe zum Szenario, das zu deinem Produkt passt.
Telefon-Support und Reservierungen
Eine Hotline braucht Unterbrechungs-Handling und Bestätigungen vor irreversiblen Schritten. GPT-Live-1 passt gut: SIP-Support wie oben und Buchungslogik im Backend.
Troubleshooting mit Kamera und Bildschirm
Zeigt ein Nutzer das Handy auf einen Router, muss das Modell live sehen und schlussfolgern. Gemini 3.8 Live kann das in einer Session – ohne separates Vision-Teil –, solange du die 2-Minuten-Video-Grenze aus dem Abschnitt zu Bildern einplanst.
Mehrschritt-Aufgaben im Hintergrund
Für verkettete Tools vergleiche Extended Thinking mit GPT-Live-1 plus Astra. Astra führt τ-Voice in einem Testrun; am Ende entscheidet dennoch, wo das Reasoning leben soll.
Voice zu einem vorhandenen Agenten hinzufügen
Client-Delegation kann GPT-Live-1 vor einen bestehenden Agenten setzen, ohne dessen Reasoning-Loop umzuschreiben. Bei Gemini wird das Livemodell zum Planer.
Hohe Anrufvolumina bei knappem Budget
Kurze, einfache Anrufe sprechen für Basis-Gemini – das günstigste Setup im Artificial-Analysis-Test. Mehrschritt-Tools ändern die Rechnung.
Fazit
Am klarsten: Gemini 3.8 Live vereint Sehen, Denken und Sprechen in einem Modell, während GPT-Live-1 die Stimme von der Intelligenz dahinter trennt. Keines dominiert, und beide klingen menschlich genug und reagieren schnell genug, dass die Architektur die meisten Entscheidungen bestimmt.
Spannend ist, wie schnell der Vorsprung bei Agentenaufgaben mit Astra zu GPT-Live-1 wanderte. Dieser Score gehört dem Gesamtsystem, nicht nur dem Sprachmodell – Delegation in Aktion, auch wenn ein Testrun eher Signal als Urteil ist.
Beobachtenswert ist auch OpenAIs Backend-Lineup, seit GPT-6.1 Sol Ende September 2026 erschien. Jedes neue Backend kann GPT-Live-1s Werte bewegen, ohne die Stimme anzutasten, während Googles vergleichbare Änderung den Wechsel des Live-Modells bedeuten würde.
Aktuell ist Gemini 3.8 Live die einfachere Wahl für alles mit Kamera, und GPT-Live-1 die einfachere Wahl für Telefonprodukte mit vorhandenem Backend. So oder so muss dein Code noch das Freitag-zu-Donnerstag-Buchungsproblem sauber lösen.
Für die Agenten-Konzepte hinter beiden Wegen deckt unser Introduction to AI Agents Kurs Tools, Memory und Planung ab.
FAQs
Kann GPT-Live-1 ein Gemini-Modell als Backend nutzen?
Ja. Client-Delegation kann die Arbeit an ein Gemini-Textmodell hinter deinem eigenen Backend senden. Du würdest OpenAI für Sprachminuten und Google für Backend-Tokens zahlen.
Wie lange bleibt ein GPT-Live-1-Gespräch im Kontext?
GPT-Live-1 hat ein Kontextfenster von 128.000 Tokens, das Audiotokens zählt – nicht nur das Transkript. Sobald die Auslastung 90% überschreitet, startet es eine Ersatz-Sprachengine, die bis zu 8.192 Tokens jüngster Historie und Zusammenfassungen trägt. Halte daher bestätigte Aktionen und Aufgabenstatus in deiner eigenen Anwendung fest.
Welche Ratenlimits gelten für Gemini 3.8 Live und GPT-Live-1?
GPT-Live-1 erlaubt 50 parallele Sessions auf Build, 300 auf Launch und 500 auf Grow, ohne Free-Tier-Zugang. Google veröffentlicht keine separaten Limits nur für Live und verweist für die aktuellen Projektlimits auf Google AI Studio.
Kann ich bestehenden Voice-App-Code wiederverwenden?
Größtenteils bei Gemini, weniger bei OpenAI. Code für Gemini 3.1 Flash Live braucht vor allem den neuen Model-String, ohne ein thinking_level, das gemini-3.8-live nicht akzeptiert. Entferne außerdem enable_affective_dialog und proactive_audio: false, falls deine Basis sie von älteren Modellen mitschleppt. GPT-Live-1 nutzt seinen eigenen v1/live/sessions-Endpunkt statt v1/realtime – eine Realtime-API-App braucht also Anpassungen, wofür OpenAI einen Migrationsleitfaden veröffentlicht.
Ist Audio von Gemini 3.8 Live wasserzeichenmarkiert?
Ja. Google sagt, dass sämtliches Audio seiner KI-Produkte, inklusive beider Gemini 3.8 Live-Modelle, ein SynthID-Wasserzeichen trägt, das Hörer nicht wahrnehmen – hilfreich, falls du je nachweisen musst, dass Anrufende synthetische Sprache gehört haben.

Ich bin Dateningenieur und Community-Builder und arbeite mit Datenpipelines, Cloud- und KI-Tools. Außerdem schreibe ich praktische, super nützliche Tutorials für DataCamp und angehende Entwickler.


Ältere Sprachassistenten sprechen meist abwechselnd: Du redest, wartest, dann kommt die Antwort. Googles Gemini 3.8 Live und OpenAIs GPT-Live-1 sind Echtzeit-Sprachagenten, die Unterbrechungen und Kurswechsel mitten im Satz verkraften. Keines der beiden ist pauschal besser.
Der Unterschied liegt darin, wo gedacht wird. Gemini 3.8 Live hört zu, kann die Kamera einspeisen, schließt Schlüsse und entscheidet, wann es deine App um Aktionen bittet. GPT-Live-1 fokussiert das Gespräch und kann zuhören, während es spricht. Braucht GPT-Live-1 mehr Denkleistung oder eine Aktion, übergibt es an ein zweites Modell oder einen Service, das sogenannte Backend.
OpenAI hat GPT-Live-1 im September in seine API gebracht, und Google veröffentlichte kurz darauf Gemini 3.8 Live. Unsere Übersicht zu Gemini 3.8 Live deckt den Google-Launch ab. Wenn du mit einem der beiden bauen willst, zeigen unser Gemini 3.8 Live Tutorial und das GPT-Live-1 API Tutorial die Einrichtung.
TL;DR
Keine Zeit? Hier ist der Vergleich in sechs Punkten:
Ob eine Kamera nötig ist oder bereits ein Backend existiert, entscheidet oft früher als jede Rangliste. Die Tabelle unten zeigt, warum.