Gemini 3.8 Live vs. GPT-Live-1 w skrócie
Czego poniższa tabela nie pokaże, to że w obu przypadkach to twoja aplikacja wciąż wykonuje właściwą pracę, jak uruchamianie twoich funkcji i śledzenie, o co prosił użytkownik.
|
Punkt porównania |
Gemini 3.8 Live |
GPT-Live-1 |
|
Rola |
Jeden model, który słucha, widzi, rozumuje i prosi twoją aplikację o działanie |
Model głosowy, który mówi i przekazuje trudniejsze zadania do backendu |
|
Identyfikatory modeli |
|
|
|
Natywne wejścia |
Tekst, audio, obrazy, klatki wideo |
Tylko tekst i audio |
|
Gdzie działa głębsze rozumowanie |
Wewnątrz modelu, więcej w Extended Thinking |
W wybranym przez ciebie backendzie |
|
Kto uruchamia twoje funkcje |
Twoja aplikacja (Search grounding działa po stronie Google) |
Twoja aplikacja; hostowane narzędzia, takie jak wyszukiwanie w sieci, działają z backendem |
|
Jednostka rozliczeniowa |
Tokeny, w tym tokeny "thinking" |
Minuty połączonej sesji, plus użycie backendu |
|
Darmowy limit |
Tak |
Nie |
Czym są Gemini 3.8 Live i GPT-Live-1?
Oba to modele speech-to-speech, więc wchodzi audio, a wychodzi audio — bez osobnego etapu transkrypcji.
Czym jest Gemini 3.8 Live?
Gemini 3.8 Live to niskolatencyjny model do rozmów na żywo od Google. Przyjmuje tekst, obrazy, audio i wideo, rozumuje między turami i asynchronicznie wywołuje funkcje. Obie wersje Gemini mają limit wejścia 131 072 tokenów na swoich stronach modeli.
Gemini 3.8 Live Extended Thinking to osobny model, nie ustawienie. Dodaje rozumowanie w tle na poziomie niskim, średnim lub wysokim, jednocześnie relacjonując postępy.
W informacjach o wydaniu Google listuje oba identyfikatory modeli jako ogólnie dostępne, podczas gdy przewodnik po możliwościach Live API nadal oznacza API jako wersję preview.
Czym jest GPT-Live-1?
GPT-Live-1 to pełnodupleksowy model głosowy od OpenAI. Full duplex to techniczna nazwa zachowania „słuchania podczas mówienia”, które opisałem we wstępie.
OpenAI nazywa przekazanie pracy do backendu delegowaniem. Głos może mówić dalej, gdy ta praca się wykonuje.
GPT-Live-1 to także inny produkt niż linia GPT-Realtime-2 OpenAI lub model backendowy, do którego deleguje. GPT-Realtime-2.1 utrzymuje rozumowanie i narzędzia w jednym modelu realtime, więc wszystko, co mówię o delegowaniu, dotyczy tylko GPT-Live-1.
Jaka jest główna różnica między Gemini 3.8 Live a GPT-Live-1?
TL;DR dało krótką wersję, tu pełna. Gemini 3.8 Live wybiera wywołania funkcji w ramach sesji live, a GPT-Live-1 przekazuje rozumowanie do osobnego backendu. W obu projektach twoja aplikacja uruchamia twoje funkcje.
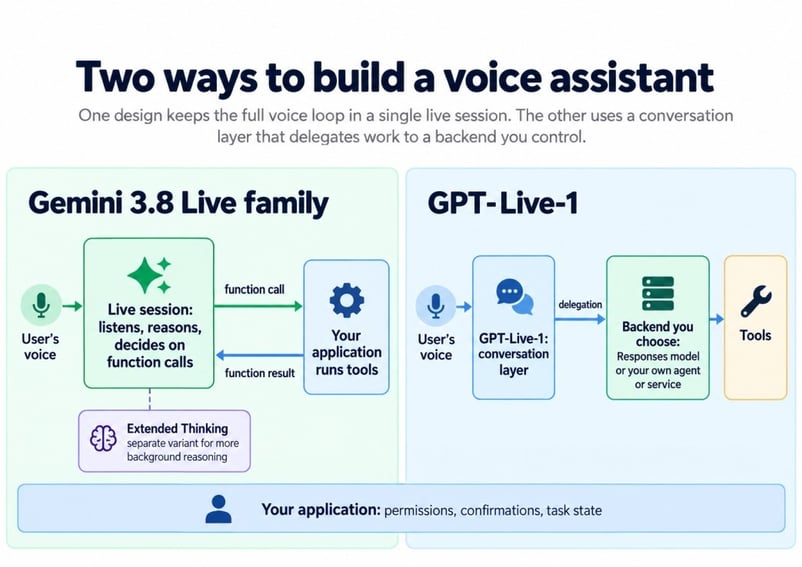
Gdzie każdy model umieszcza „myślenie”. Ilustracja: autor.
Większość tego, co dalej, wynika z tego podziału, więc najpierw każda strona.
Jak Gemini 3.8 Live planuje w jednej sesji
W Gemini nie ma drugiego modelu do konfigurowania. Model live emituje wywołanie funkcji, gdy potrzebuje danych, a twój klient zwraca wynik, jak opisuje przewodnik po myśleniu Google.
Przejście na Extended Thinking zachowuje ten sam endpoint WebSocket i nie wymaga modelu backendowego, choć kod klienta się zmienia.
Jak działa delegowanie w GPT-Live-1
GPT-Live-1 obsługuje mowę i decyduje, kiedy poprosić o pomoc; backend obsługuje rozumowanie, narzędzia i reguły biznesowe. Przewodnik po promptowaniu OpenAI umieszcza pełną procedurę zadania w instrukcjach backendu.
Przy delegowaniu Responses OpenAI uruchamia model, który skonfigurujesz. Przy delegowaniu po stronie klienta praca trafia do dowolnego modelu lub usługi uruchamianej przez twoją aplikację. W obu przypadkach przewodnik po delegowaniu mówi, że twoja aplikacja zarządza uprawnieniami, zapisami i stanem zadań.
Dlaczego różnica w architekturze ma znaczenie
Cena rozdzielenia to więcej elementów: sesja głosowa, backend i współdzielony między nimi stan. W zamian możesz zmieniać model rozumowania bez dotykania warstwy głosowej.
Ten kompromis wygląda gorzej, jeśli nie masz jeszcze backendu, ale lepiej, jeśli musisz ulepszyć istniejącego agenta bez zmiany jego głosu.
Jak Gemini 3.8 Live i GPT-Live-1 radzą sobie z przerwami?
Oba radzą sobie z przerwami, ale GPT-Live-1 jest wokół nich zbudowany, wraz z pauzami i backchannelami (to „mhm”, które wydaje słuchacz). Gemini 3.8 Live obsługuje barge-in, a proaktywne audio jest zawsze włączone, ale dokumentacja Google nie nazywa tego pełnym dupleksem.
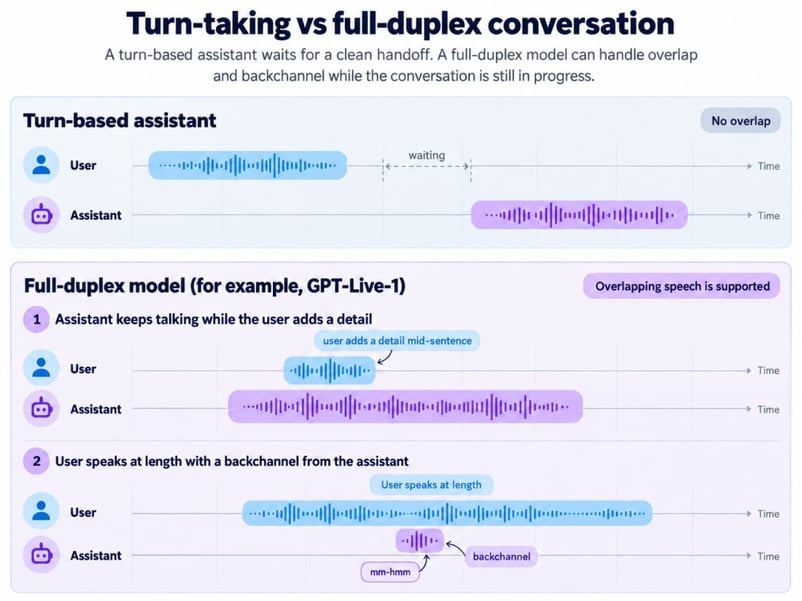
Zmiany versus mówienie jednocześnie. Ilustracja: autor.
W poście premierowym OpenAI cytuje aplikację językową Speak, która twierdzi, że GPT-Live-1 ograniczył przerwy o prawie 80% w porównaniu z systemami na zmiany — to deklaracja klienta, a nie niezależny test.
W Gemini proaktywne audio pozwala modelowi pomijać wypowiedzi, które nie są do niego kierowane. Nasz tutorial Gemini wykazał, że dźwięk z głośników laptopa wyciekający do mikrofonu liczy się jako wtrącenie użytkownika, więc testuj w słuchawkach i bez nich.
Jak Gemini 3.8 Live i GPT-Live-1 radzą sobie z rozumowaniem i wywołaniami narzędzi?
Gemini skaluję rozumowanie, przełączając się z podstawowego Live na Extended Thinking. GPT-Live-1 skaluję je, zmieniając backend, więc porównuj Extended Thinking z kompletną konfiguracją GPT-Live-1, a nie samym modelem głosowym.
Gemini 3.8 Live vs. Gemini 3.8 Live Extended Thinking
Podstawowe Gemini 3.8 Live nie ma ustawienia thinking_level i akceptuje funkcje BLOCKING dla starszego kodu. Extended Thinking zmienia cztery zachowania klienta:
-
Narzędzia: działają tylko funkcje
NON_BLOCKING, a blokująca zwróci twardy błąd. -
Poziomy „thinking”: nie ma opcji minimalnej, tylko trzy poziomy wymienione wyżej.
-
Koniec tury:
turnComplete: truenie oznacza już, że model skończył, więc twój klient obserwujeinteraction_status, aż pojawi sięIDLE. -
Harmonogram: planowanie wywołań funkcji nie jest obsługiwane.
Google zaleca Extended Thinking dla zadań wieloetapowych i wolnych narzędzi. Kosztuje to więcej opóźnień i tokenów wyjściowych.
Jedna rzecz w dokumentacji Google mnie zirytowała. Post premierowy mówi, że Gemini 3.8 Live może „kontynuować rozmowę, gdy zadania kończą się w tle”, ale przewodnik po myśleniu twierdzi, że podstawowy model „czeka na wykonanie narzędzia przed mówieniem”. Nasz tutorial Gemini zaobserwował to drugie zachowanie podczas sprawdzania pogody, więc planowałbym według przewodnika, dopóki Google nie wyjaśni.
Jakie modele backendowe działają z GPT-Live-1?
GPT-Live-1 może działać przed dowolnym backendem, który skonfigurujesz. Dokumentacja OpenAI wskazuje trzy backendy GPT-6:
-
GPT-6 Luna (
gpt-6-luna), sugerowany punkt wyjścia w przewodniku po delegowaniu -
GPT-6 Sol (
gpt-6-sol), sugestia przewodnika do trudniejszych zadań -
GPT-6 Astra, które post premierowy poleca do złożonych spraw klienta
Wiersze Artificial Analysis „GPT-Live-1 (Astra, medium)” i „GPT-Live-1 (Sol, low)” to konfiguracje systemowe, a nie wersje modelu głosowego. Artificial Analysis nie podaje generacji Sol, a OpenAI wypuściło GPT-6.1 Sol po tamtych testach.
Co się dzieje, gdy dzwoniący zmienia prośbę w trakcie zadania
Załóżmy, że dzwoniący prosi o przeniesienie rezerwacji na piątek, a potem mówi „jednak w czwartek”, gdy trwa wyszukiwanie. Liczy się tylko ta druga prośba.
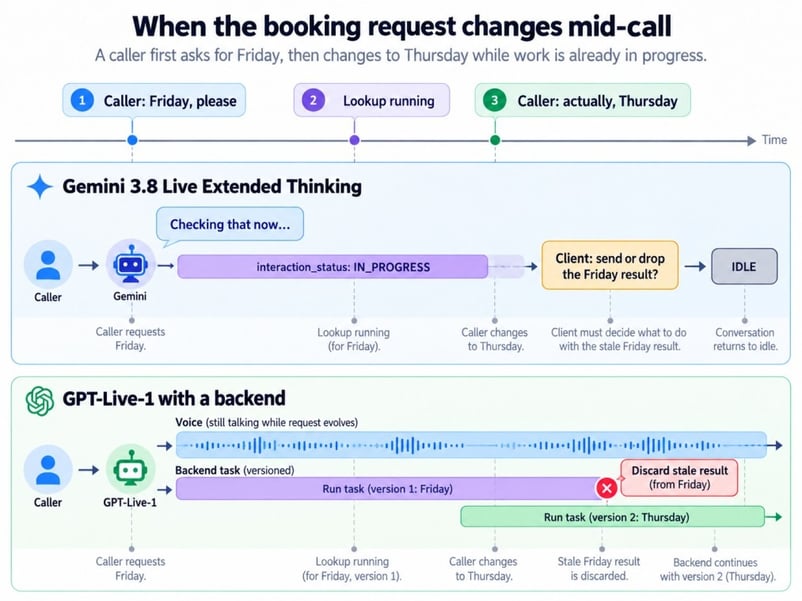
Zmiana prośby podczas wolnej pracy. Ilustracja: autor.
W GPT-Live-1 przerwanie głosu nie anuluje pracy backendu. Delegowanie Responses może wciąż zwrócić stary wynik do warstwy głosowej, podczas gdy delegowanie po stronie klienta pozwala twojemu kodowi od razu go porzucić.
W Gemini twój klient może odrzucić nieaktualny wynik narzędzia. Tak czy inaczej, twoja aplikacja decyduje, jakie zadanie jest bieżące.
Czy Gemini 3.8 Live i GPT-Live-1 obsługują obrazy i wideo?
Gemini 3.8 Live natywnie przyjmuje obrazy i wideo; GPT-Live-1 wymienia oba jako nieobsługiwane. Aplikacja GPT-Live-1 może wciąż wysłać zdjęcie do osobnego backendu wizji, ale sama nie obejrzy obrazu z kamery na żywo.
W Gemini klatki trafiają do tej samej sesji co audio, więc model może odpowiedzieć „czy to właściwy kabel?”, gdy użytkownik trzyma go przed kamerą. Ma to dwa koszty. Klatki wideo są wysyłane domyślnie, a przewodnik sesji Google ogranicza sesje z audio i wideo do 2 minut (wobec 15 dla samego audio), chyba że włączysz kompresję okna kontekstu.
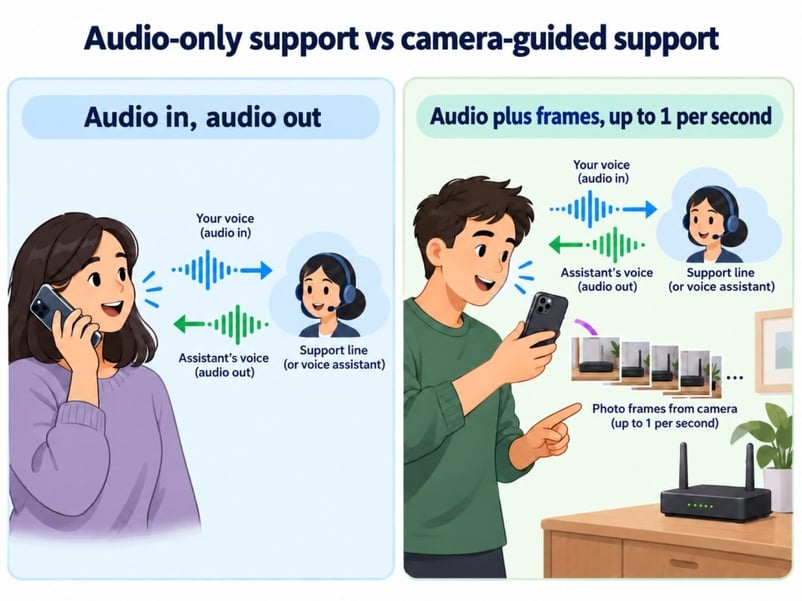
Połączenia telefoniczne vs. sesje naprawy z kamerą. Ilustracja: autor.
Linia rezerwacji nigdy nie zobaczy klatki wideo, a poniższe rankingi mowy nie mierzą wizji.
Benchmarki: Gemini 3.8 Live vs. GPT-Live-1
Żaden pojedyńczy benchmark nie rozstrzyga tego porównania. Spośród czterech konfiguracji dwóch modeli Astra prowadzi w głównym indeksie, Sol prowadzi w dynamice rozmowy, a podstawowe Gemini ma najwyższe Arena Elo z tej czwórki.
Najpierw, jak działa główny indeks, bo to wyjaśnia większość różnic.
Jak działa Artificial Analysis Speech to Speech Index
Indeks przyznaje równą wagę czterem różnym umiejętnościom:
- Big Bench Audio: pytania wymagające rozumowania zadane na głos
- τ-Voice: wieloetapowe zadania obsługi klienta, np. zmiana lotu
- Wynik Arena: ślepe głosy ludzi, który agent był preferowany
- Wskaźnik sukcesu zadań: jak często rozmowa kończyła się właściwym końcowym wywołaniem narzędzia
Dynamika rozmowy jest raportowana osobno w metodologii v2.0.
Tutaj są cztery konfiguracje, które mają tu znaczenie.
|
Konfiguracja |
Indeks |
Big Bench Audio |
τ-Voice |
Dynamika rozmowy |
Arena Elo |
Sukces zadania |
TTFA |
|
GPT-Live-1 (Astra, medium) |
83.2 |
90,1% |
74,5% |
94,9% |
1027 |
87,4% |
1,34 s |
|
Gemini 3.8 Live Extended Thinking (High) |
82.6 |
97,7% |
68,6% |
91,9% |
966 |
89,1% |
1,35 s |
|
GPT-Live-1 (Sol, low) |
80.1 |
89,0% |
59,3% |
97,3% |
1037 |
90,9% |
1,24 s |
|
Gemini 3.8 Live |
74.5 |
91,7% |
30,1% |
96,1% |
1074 |
93,2% |
1,18 s |
Obie wyniki τ-Voice GPT-Live-1 pochodzą z jednego przebiegu, więc traktuj je ostrożnie.
Zadania agenta vs. oceny preferencji ludzi
W τ-Voice Astra ma 74,5%, Extended Thinking 68,6%, a podstawowe Gemini 30,1%. Dodatkowe rozumowanie ma znaczenie, gdy narzędzia są łączone w łańcuch.
Rozmowa opowiada inną historię: Sol ma najwyższy wynik, a przedziały ufności Arena dla podstawowego Gemini i Sol nachodzą na siebie.
Różnica 0,6 punktu w indeksie między Astra a Extended Thinking nie ma opublikowanego przedziału ufności. Już raz zamieniły się miejscami, więc nadal nazwałbym to remisem.
Który model odpowiada szybciej?
Podstawowe Gemini 3.8 Live ma najszybszy czas do pierwszego audio (TTFA) w tabeli, ale rozrzut w całej czwórce to poniżej 0,2 sekundy. TTFA to czas potrzebny modelowi na wygenerowanie pierwszego tokena audio.
TTFA nie obejmuje reakcji na przerwanie i czasu potrzebnego do dokończenia rezerwacji czy wyszukiwania. To drugie bardziej zależy od twojego backendu i narzędzi.
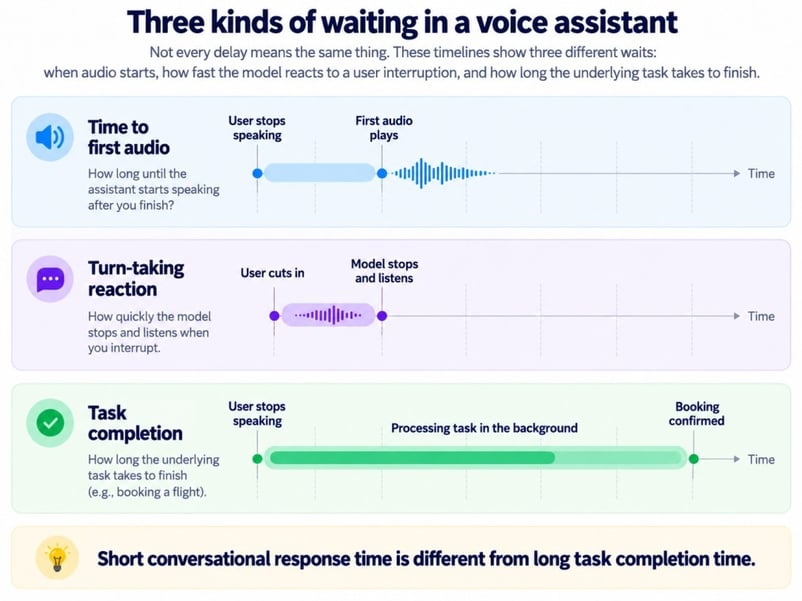
Trzy rodzaje czekania w rozmowie głosowej. Ilustracja: autor.
Zarówno Extended Thinking, jak i GPT-Live-1 mogą mówić dalej podczas wolnego wyszukiwania. Dzwoniący i tak czeka na rezerwację.
Czego nie mierzą benchmarki głosowe
Dla linii wsparcia rankingi nie powiedzą ci:
- czy twój operator telefoniczny i kodek przenoszą dźwięk czysto
- czy agent nadal trzyma się skryptu po dziesięciu minutach
- jak słyszy rozmówcę z silnym akcentem na głośnej ulicy
- ile kosztowała rozmowa po doliczeniu backendu i narzędzi
Pilotaż z twoimi nagraniami odpowie na te pytania lepiej.
Ceny: Gemini 3.8 Live vs. GPT-Live-1 — co tańsze?
Podstawowe Gemini jest najtańsze w teście Artificial Analysis, ale modele liczą za różne rzeczy. Ważniejszy jest koszt na udane zadanie niż cena katalogowa.
Poniższe stawki to ceny katalogowe na stronie cen Google i stronie modelu GPT-Live-1 w momencie pisania, a przeliczenia na minuty dla Gemini to konwersje Google z cen za tokeny.
|
Pozycja kosztowa |
Gemini 3.8 Live i Extended Thinking (płatny plan) |
GPT-Live-1 |
|
Wejście audio |
$3,00 za 1 mln tokenów (ok. $0,005/min) |
Wliczone w $0,05 za minutę, rozliczane co sekundę |
|
Wyjście audio |
$12,00 za 1 mln tokenów (ok. $0,018/min) |
Wliczone w tę samą opłatę sesyjną |
|
Wejście obrazu lub wideo |
$1,00 za 1 mln tokenów (ok. $0,002/min) |
Nieobsługiwane |
|
Rozumowanie |
Tokeny „thinking” rozliczane jak wyjście |
Tokeny modelu backendowego wg jego cen |
|
Wyszukiwanie i narzędzia |
5 000 darmowych zapytań Search miesięcznie, potem $14 za 1 000 |
Rozliczane przez model backendu i użyte narzędzia |
Tokeny „thinking” sprawiają, że Extended Thinking kosztuje więcej niż podstawowe Gemini. Artificial Analysis szacuje $0,84 za godzinę wejścia audio dla podstawowego Gemini, $3,50 dla Extended Thinking, $4,47 dla Sol i $5,83 dla Astra, bez narzędzi i rabatów cache. Gemini Live nie obsługuje cache’owania; backend GPT-Live-1 może.
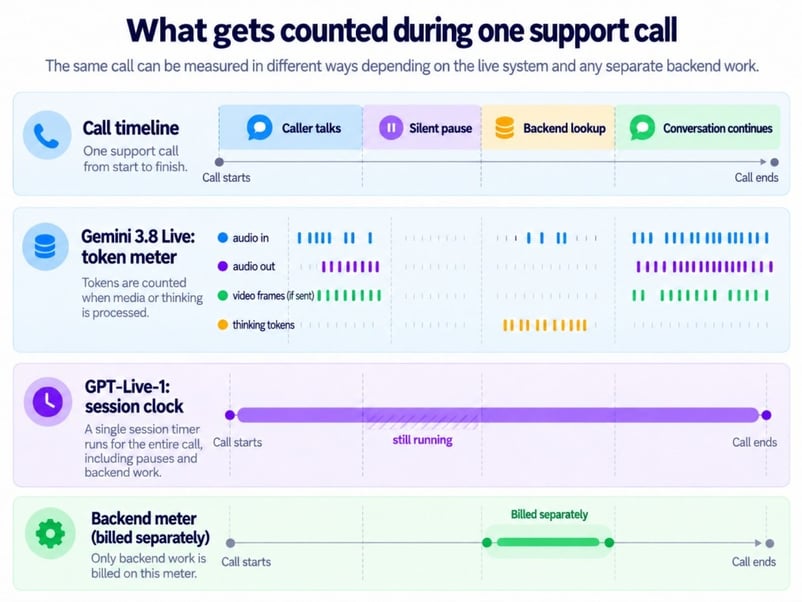
Co zlicza każdy licznik podczas rozmów. Ilustracja: autor.
Zegar GPT-Live-1 biegnie także w ciszy i wyciszenie go nie zatrzymuje. Zsumuj opłaty z tabeli i koszty telefonu, a potem podziel przez liczbę ukończonych zadań.
Wsparcie przeglądarki, serwera i telefonu w Gemini 3.8 Live i GPT-Live-1
Aplikacje przeglądarkowe i serwerowe mogą łączyć się z oboma modelami, ale wdrożenie telefoniczne je rozdziela. Diagram pokazuje opcje połączeń; operacyjnie różnią je czas trwania połączenia i to, kto siedzi na ścieżce połączenia.
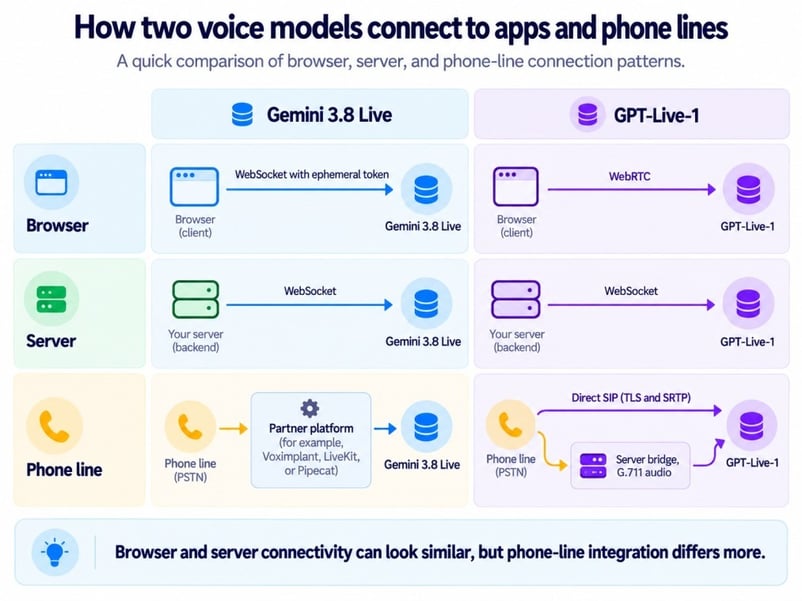
Ścieżki połączeń: przeglądarka, serwer i telefon. Ilustracja: autor.
Połączenia Gemini resetują się po ok. 10 minutach, więc dłuższe rozmowy wymagają wznowienia sesji. W GPT-Live-1 loguj oddzielnie połączenie głosowe i delegowaną pracę backendu.
Połączenia telefoniczne i wsparcie SIP
Bezpośredni SIP to o jednego dostawcę mniej na ścieżce połączenia GPT-Live-1. Trasa partnerska Gemini dodaje kolejną usługę do konfiguracji, monitorowania i debugowania.
Kilku deweloperów na forum OpenAI zgłasza, że GPT-Live-1 obiecuje działanie bez tworzenia delegacji. Wsparcie OpenAI nie nazwało tego błędem; wskazało swój przewodnik po promptowaniu, który zauważa, że ustne potwierdzenie nie oznacza, że praca backendowa się rozpoczęła. Logowałbym zdarzenia delegowania osobno od mowy.
Od 2 listopada OpenAI wspiera też wychodzące połączenia SIP dla wszystkich organizacji, więc GPT-Live-1 może wykonywać połączenia, a nie tylko je odbierać.
Gemini 3.8 Live vs. GPT-Live-1: którego użyć?
Wybór sprowadza się do dwóch pytań: czy asystent musi widzieć i czy masz już backend? „Tak” na pierwsze wskazuje na Gemini; „tak” na drugie wskazuje na GPT-Live-1.
Przejdź do scenariusza poniżej, który pasuje do twojego produktu.
Obsługa telefoniczna i rezerwacje
Linia telefoniczna wymaga obsługi przerwań i potwierdzeń przed czymkolwiek nieodwracalnym. GPT-Live-1 dobrze się tu wpisuje, z omówionym wyżej wsparciem SIP i logiką rezerwacji utrzymaną w backendzie.
Diagnostyka z kamerą i ekranem
Gdy użytkownik kieruje telefon na router, model musi rozumować o tym, co widzi teraz. Gemini 3.8 Live robi to w jednej sesji, bez osobnego komponentu wizji, pod warunkiem, że zaplanujesz 2‑minutowy limit wideo z sekcji o obrazach.
Wieloetapowa praca w tle
Dla zadań łańcuchujących narzędzia porównuj Extended Thinking z GPT-Live-1 plus Astra. Astra prowadzi w τ-Voice w jednym teście, więc wybór nadal sprowadza się do tego, gdzie ma mieszkać rozumowanie.
Dodanie głosu do agenta, którego już prowadzisz
Delegowanie po stronie klienta może dodać GPT-Live-1 do istniejącego agenta bez przepisywania jego pętli rozumowania. W Gemini model live staje się planerem.
Wysokie wolumeny połączeń przy napiętym budżecie
Krótkie, proste rozmowy wskazują na podstawowe Gemini, najtańsze w teście Artificial Analysis. Narzędzia wieloetapowe zmieniają to wyliczenie.
Na zakończenie
Najczytelniejsza ramka porównania to: Gemini 3.8 Live łączy widzenie, rozumowanie i mówienie w jednym modelu, a GPT-Live-1 oddziela głos od inteligencji za nim. Żaden nie dominuje, a oba są na tyle zbliżone w brzmieniu i szybkości odpowiedzi, że o większości realnych decyzji zadecyduje architektura.
Najciekawsze jest dla mnie, jak szybko prowadzenie w zadaniach agenta przesunęło się w stronę GPT-Live-1 z Astrą. Ten wynik należy do całego systemu, nie tylko do modelu głosowego, więc to argument za delegowaniem w praktyce — choć jeden przebieg testu to sygnał, a nie wyrok.
Warto też obserwować lineup backendów OpenAI, bo GPT-6.1 Sol pojawił się pod koniec września 2026. Każdy nowy backend może przesunąć wyniki GPT-Live-1 bez dotykania warstwy głosowej, podczas gdy porównywalna zmiana u Google oznaczałaby przełączenie modelu live.
Na teraz Gemini 3.8 Live to łatwiejszy wybór do wszystkiego z kamerą, a GPT-Live-1 to łatwiejszy wybór dla produktów telefonicznych z już istniejącym backendem. Tak czy inaczej twój kod nadal musi obsłużyć problem rezerwacji z piątku na czwartek.
Koncepcje agentów stojące za obiema ścieżkami omawia nasz kurs Introduction to AI Agents, w tym narzędzia, pamięć i planowanie.
FAQ
Czy GPT-Live-1 może używać modelu Gemini jako backendu?
Tak. Delegowanie po stronie klienta może wysłać pracę do tekstowego modelu Gemini za twoim własnym backendem. Płacisz OpenAI za minuty głosu i Google za tokeny backendu.
Jak długo rozmowa GPT-Live-1 może pozostać w kontekście?
GPT-Live-1 ma okno kontekstu 128 000 tokenów, które liczy tokeny audio, a nie tylko transkrypt. Po przekroczeniu 90% uruchamia zastępczy silnik głosu, który przenosi do 8 192 tokenów ostatniej historii i podsumowań, więc trzymaj potwierdzone działania i stan zadań w swojej aplikacji.
Czy mogę ponownie użyć mojego istniejącego kodu aplikacji głosowej?
W głównej mierze w Gemini, mniej w OpenAI. Kod napisany dla Gemini 3.1 Flash Live głównie wymaga nowego stringu modelu, minus jakiekolwiek ustawienie thinking_level, którego gemini-3.8-live nie akceptuje. Usuń też enable_affective_dialog oraz proactive_audio: false, jeśli twój kod je przenosi ze starszych modeli. GPT-Live-1 używa własnego endpointu v1/live/sessions zamiast v1/realtime, więc aplikacja Realtime API wymaga przeróbek, a OpenAI publikuje do tego przewodnik migracyjny.
Czy audio Gemini 3.8 Live jest znakowane wodnym znakiem?
Tak. Google podaje, że całe audio generowane przez jego produkty AI, w tym oba modele Gemini 3.8 Live, ma znak wodny SynthID niesłyszalny dla odbiorców, co pomaga, jeśli kiedykolwiek będziesz musieć wykazać, że rozmówca słyszał syntetyczną mowę.
Is Gemini 3.8 Live audio watermarked?
Yes. Google says all audio generated by its AI products, including both Gemini 3.8 Live models, carries a SynthID watermark that listeners can't hear, which helps if you ever need to show a caller heard synthetic speech.
Starsze asystenty głosowe zwykle mówią na zmiany: mówisz, czekasz, a potem one odpowiadają. Gemini 3.8 Live od Google i GPT-Live-1 od OpenAI to agenci głosowi czasu rzeczywistego, którzy potrafią reagować na przerwy i zmiany w połowie zdania. Żaden nie jest bezwzględnie lepszy we wszystkim.
Różnica tkwi w tym, gdzie odbywa się myślenie. Gemini 3.8 Live słyszy cię, może analizować obraz z kamery, rozumuje i decyduje, kiedy poprosić twoją aplikację o działanie. GPT-Live-1 koncentruje się na rozmowie i potrafi słuchać, kiedy mówi. Gdy GPT-Live-1 potrzebuje trudniejszego rozumowania lub działania, przekazuje pracę do drugiego modelu lub usługi, zwanej backendem.
OpenAI wprowadziło GPT-Live-1 do swojego API we wrześniu, a Google udostępniło Gemini 3.8 Live niespełna tydzień później. Nasz przegląd Gemini 3.8 Live omawia premierę Google. Jeśli chcesz budować na bazie któregoś z nich, nasze tutorial Gemini 3.8 Live i tutorial API GPT-Live-1 pokazują konfigurację.
TL;DR
Nie masz czasu? Oto porównanie w sześciu punktach:
Wymóg kamery lub istniejący backend mogą rozstrzygnąć wybór, zanim zrobi to ranking. Poniższa tabela pokazuje dlaczego.