
Gemini 3.8 Live vs. GPT-Live-1 in breve
Quello che la tabella non può mostrare è che in entrambi i casi la tua app fa comunque il lavoro, ad esempio eseguire le tue funzioni e tenere traccia delle richieste dell'utente.
|
Punto di confronto |
Gemini 3.8 Live |
GPT-Live-1 |
|
Ruolo |
Un modello che ascolta, vede, ragiona e chiede alla tua app di agire |
Modello vocale che parla e delega il lavoro più complesso a un backend |
|
ID modello |
|
|
|
Input nativi |
Testo, audio, immagini, fotogrammi video |
Solo testo e audio |
|
Dove gira il ragionamento più profondo |
Dentro il modello, con più capacità in Extended Thinking |
In un backend a tua scelta |
|
Chi esegue le tue funzioni |
La tua applicazione (il Search grounding gira lato Google) |
La tua applicazione; strumenti ospitati come la ricerca web girano con il backend |
|
Unità di fatturazione |
Token, inclusi i token di ragionamento |
Minuti di sessione connessi, più uso del backend |
|
Piano gratuito |
Sì |
No |
Cosa sono Gemini 3.8 Live e GPT-Live-1?
Entrambi sono modelli speech-to-speech: l'audio entra e l'audio esce senza uno step di trascrizione separato.
Cos'è Gemini 3.8 Live?
Gemini 3.8 Live è il modello di dialogo live a bassa latenza di Google. Accetta testo, immagini, audio e video, ragiona tra i turni e chiama funzioni in modo asincrono. Entrambe le varianti di Gemini indicano un limite di input di 131.072 token sulle loro pagine del modello.
Gemini 3.8 Live Extended Thinking è un modello separato, non un'impostazione. Aggiunge ragionamento in background a livello basso, medio o alto mentre narra i progressi.
Le note di rilascio di Google elencano entrambi gli ID modello come generalmente disponibili, mentre la guida alle funzionalità della Live API etichetta ancora l'API come in anteprima.
Cos'è GPT-Live-1?
GPT-Live-1 è il modello vocale full duplex di OpenAI. Full duplex è il nome tecnico del comportamento di ascolto-mentre-parla descritto nell'introduzione.
OpenAI chiama il passaggio al backend delegazione. La voce può continuare a parlare mentre quel lavoro gira.
GPT-Live-1 non è nemmeno lo stesso prodotto della linea GPT-Realtime-2 di OpenAI o del modello backend a cui delega. GPT-Realtime-2.1 tiene ragionamento e strumenti dentro un unico modello realtime, quindi tutto ciò che dico sulla delega vale solo per GPT-Live-1.
Qual è la differenza principale tra Gemini 3.8 Live e GPT-Live-1?
Il TL;DR dava la versione breve; questa è quella completa. Gemini 3.8 Live sceglie le chiamate di funzione dentro la sessione live, mentre GPT-Live-1 passa il ragionamento a un backend separato. In entrambi i design, la tua applicazione esegue le tue funzioni.
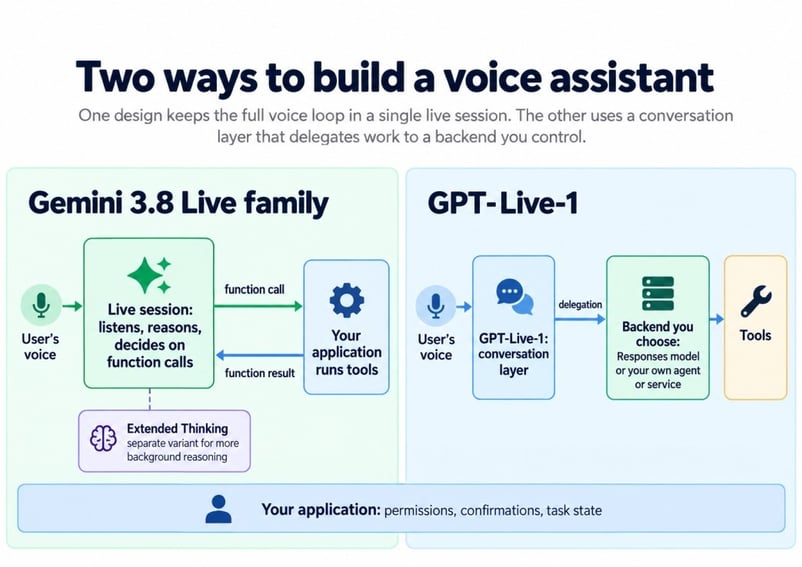
Dove ciascun modello mette il ragionamento. Immagine dell'autore.
Gran parte di ciò che segue risale a questa separazione, quindi ecco prima i due approcci.
Come Gemini 3.8 Live pianifica dentro un'unica sessione
Con Gemini, non c'è un secondo modello da configurare. Il modello live emette una chiamata di funzione quando ha bisogno di dati e il tuo client restituisce il risultato, come descritto nella guida al ragionamento di Google.
Passare a Extended Thinking mantiene lo stesso endpoint WebSocket e non richiede un modello backend, anche se cambia il codice del client.
Come funziona la delega in GPT-Live-1
GPT-Live-1 gestisce la parte vocale e decide quando chiedere aiuto; il backend gestisce ragionamento, strumenti e regole di business. La guida al prompting di OpenAI mette la procedura completa del task nelle istruzioni del backend.
Con la delega Responses, OpenAI esegue un modello che configuri. Con la delega client, il lavoro va a qualsiasi modello o servizio esegua la tua applicazione. In entrambi i casi, la guida alla delega indica che la tua applicazione gestisce permessi, registri e stato dei task.
Perché l'architettura fa la differenza
Il prezzo della separazione sono più componenti: una sessione vocale, un backend e uno stato condiviso tra i due. In cambio, puoi cambiare il modello di ragionamento senza toccare la voce.
Lo scambio sembra peggiore se non hai ancora un backend, ma migliore se devi aggiornare un agente esistente senza cambiare la sua voce.
Come gestiscono le interruzioni Gemini 3.8 Live e GPT-Live-1?
Entrambi gestiscono le interruzioni, ma GPT-Live-1 è costruito attorno a esse, insieme a pause e backchannel (i "mm-hmm" di un ascoltatore). Gemini 3.8 Live supporta il barge-in, e il suo audio proattivo è sempre attivo, ma la documentazione di Google non lo definisce full duplex.
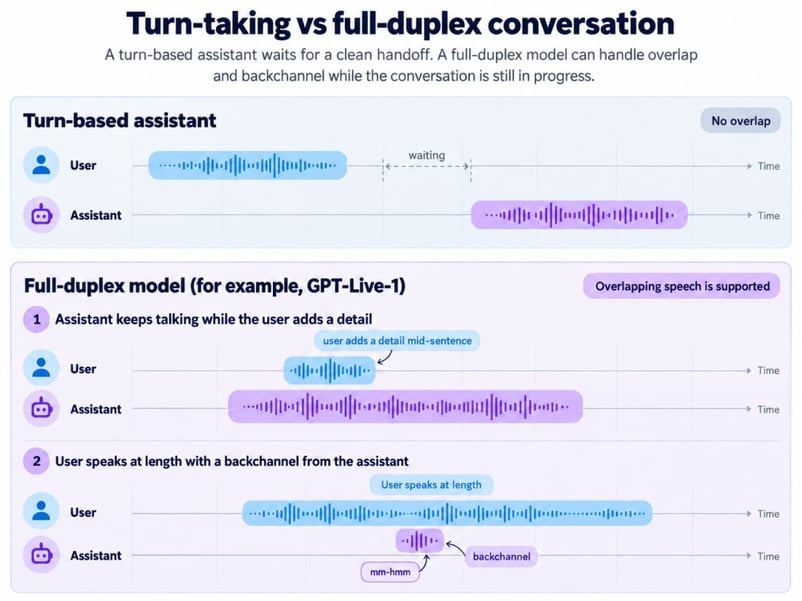
Prendersi il turno contro parlare in contemporanea. Immagine dell'autore.
Il post di lancio di OpenAI cita l'app di lingue Speak, secondo cui GPT-Live-1 ha ridotto le interruzioni di quasi l'80% rispetto ai sistemi a turni; è un'affermazione di un cliente, non un test indipendente.
Su Gemini, l'audio proattivo permette al modello di ignorare il parlato che non è rivolto a lui. Nel nostro tutorial su Gemini, l'audio delle casse del portatile che finiva nel microfono contava come interruzione da parte dell'utente, quindi testa sia con che senza cuffie.
Come gestiscono ragionamento e chiamate agli strumenti Gemini 3.8 Live e GPT-Live-1?
Gemini scala il ragionamento passando da Live di base a Extended Thinking. GPT-Live-1 lo scala cambiando il backend, quindi confronta Extended Thinking con un setup completo di GPT-Live-1, non solo con il modello vocale.
Gemini 3.8 Live vs. Gemini 3.8 Live Extended Thinking
Il Gemini 3.8 Live base non ha l'impostazione thinking_level e accetta funzioni BLOCKING per il codice più vecchio. Extended Thinking cambia quattro comportamenti del client:
-
Strumenti: funzionano solo le funzioni
NON_BLOCKING, e una bloccante restituisce un errore irreversibile. -
Livelli di ragionamento: non c'è un'opzione minima, solo i tre livelli indicati sopra.
-
Fine di un turno:
turnComplete: truenon indica più che il modello ha finito, quindi il tuo client osservainteraction_statusfinché non leggeIDLE. -
Pianificazione: la schedulazione delle funzioni non è supportata.
Google raccomanda Extended Thinking per task multi-step e strumenti lenti. Costa più latenza e più token di output.
Una cosa mi ha infastidito nella documentazione di Google. Il post di lancio dice che Gemini 3.8 Live può "continuare a chattare mentre i task finiscono in background", ma la guida al ragionamento dice che il modello base "attende l'esecuzione dello strumento prima di parlare". Nel nostro tutorial su Gemini abbiamo visto il secondo comportamento durante un controllo meteo, quindi punterei sulla guida finché Google non chiarisce.
Quali modelli backend funzionano con GPT-Live-1?
GPT-Live-1 può stare davanti a qualsiasi backend tu configuri. La documentazione di OpenAI indica tre backend GPT-6:
-
GPT-6 Luna (
gpt-6-luna), il punto di partenza suggerito dalla guida alla delega -
GPT-6 Sol (
gpt-6-sol), il suggerimento della guida per task più difficili -
GPT-6 Astra, che il post di lancio raccomanda per problemi complessi dei clienti
Le righe Artificial Analysis "GPT-Live-1 (Astra, medium)" e "GPT-Live-1 (Sol, low)" sono configurazioni di sistema, non versioni del modello vocale. Artificial Analysis non indica la generazione di Sol, e OpenAI ha rilasciato GPT-6.1 Sol dopo quei test.
Cosa succede quando chi chiama cambia richiesta a metà task
Supponi che chi chiama chieda di spostare una prenotazione a venerdì, poi dica "anzi, giovedì" mentre gira la ricerca. Conta solo la seconda richiesta.
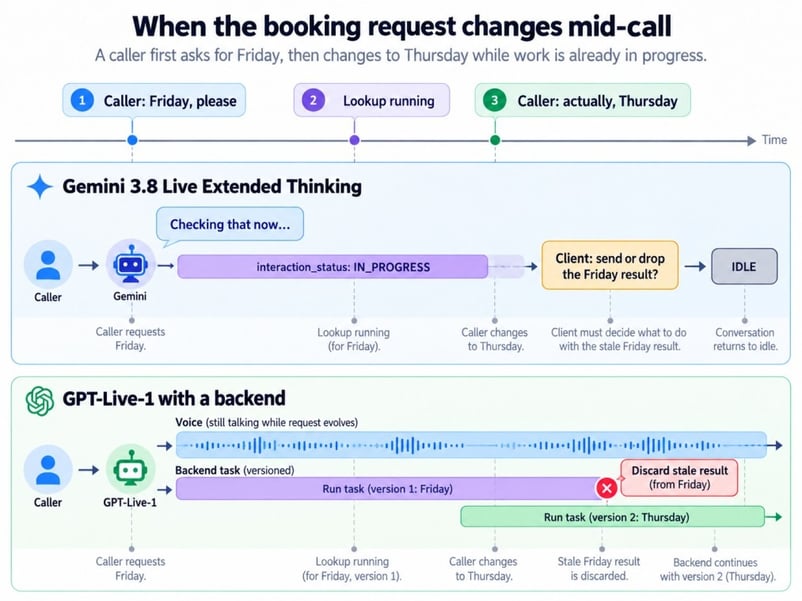
Una richiesta cambiata durante un lavoro lento. Immagine dell'autore.
Su GPT-Live-1, interrompere la voce non annulla il lavoro del backend. La delega Responses può ancora restituire il vecchio risultato alla voce, mentre la delega client permette al tuo codice di scartarlo prima.
Su Gemini, il tuo client può scartare il risultato dello strumento ormai obsoleto. In ogni caso, la tua applicazione decide qual è il task corrente.
Gemini 3.8 Live e GPT-Live-1 supportano immagini e video?
Gemini 3.8 Live accetta nativamente immagini e video; GPT-Live-1 li indica come non supportati. Un'app GPT-Live-1 può comunque inviare una foto a un backend di visione separato, ma non può osservare direttamente una fotocamera live.
Per Gemini, i fotogrammi entrano nella stessa sessione dell'audio, così il modello può rispondere "è il cavo giusto?" mentre l'utente lo mostra. Ha due costi. I fotogrammi video sono inviati per impostazione predefinita, e la guida alle sessioni di Google limita a 2 minuti le sessioni con audio e video, contro i 15 solo audio, a meno che tu non attivi la compressione della finestra di contesto.
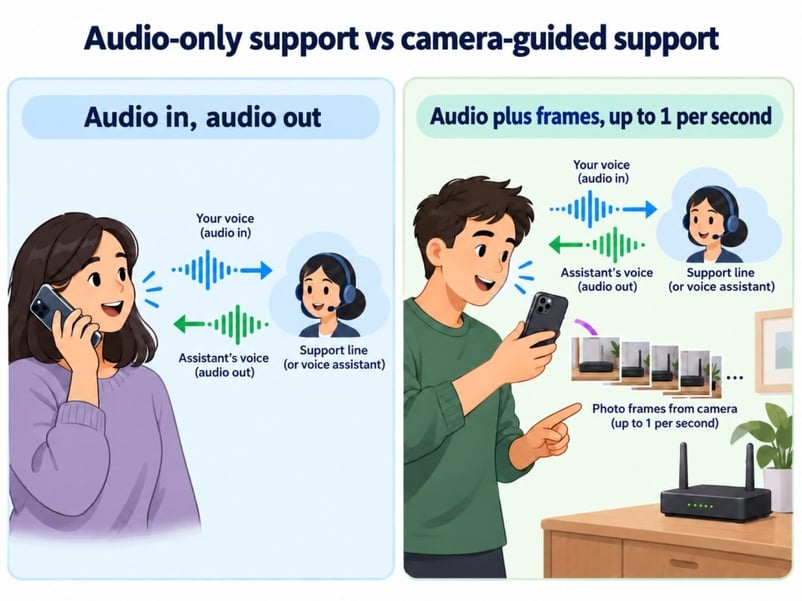
Telefonate contro sessioni di riparazione via fotocamera. Immagine dell'autore.
Una linea prenotazioni non vede mai un fotogramma, e le classifiche vocali qui sotto non misurano la visione.
Benchmark: Gemini 3.8 Live vs. GPT-Live-1
Nessun benchmark singolo chiude il confronto. Tra le quattro configurazioni dei due modelli, Astra guida l'indice principale, Sol guida la dinamica conversazionale e il Gemini base ha l'Arena Elo più alto tra le quattro configurazioni.
Prima, come funziona l'indice principale, perché spiega gran parte degli scarti.
Come funziona l'Artificial Analysis Speech to Speech Index
L'indice dà pari peso a quattro abilità diverse:
- Big Bench Audio: domande di ragionamento fatte a voce
- τ-Voice: task di assistenza clienti multi-step, ad esempio cambiare un volo
- Punteggio Arena: voti umani alla cieca su quale agente è stato preferito
- Tasso di successo del task: quanto spesso una conversazione termina con la giusta chiamata finale allo strumento
La dinamica conversazionale è riportata separatamente secondo la metodologia v2.0.
Ecco le quattro configurazioni rilevanti qui.
|
Configurazione |
Indice |
Big Bench Audio |
τ-Voice |
Dinamica conversazionale |
Arena Elo |
Successo task |
TTFA |
|
GPT-Live-1 (Astra, medium) |
83.2 |
90.1% |
74.5% |
94.9% |
1027 |
87.4% |
1.34 s |
|
Gemini 3.8 Live Extended Thinking (High) |
82.6 |
97.7% |
68.6% |
91.9% |
966 |
89.1% |
1.35 s |
|
GPT-Live-1 (Sol, low) |
80.1 |
89.0% |
59.3% |
97.3% |
1037 |
90.9% |
1.24 s |
|
Gemini 3.8 Live |
74.5 |
91.7% |
30.1% |
96.1% |
1074 |
93.2% |
1.18 s |
Entrambi i punteggi τ-Voice di GPT-Live-1 derivano da una sola prova, quindi trattali con cautela.
Task da agente vs. preferenze umane
Su τ-Voice, Astra segna 74,5%, Extended Thinking 68,6% e il Gemini base 30,1%. Un ragionamento extra conta quando si concatenano strumenti.
La conversazione racconta un'altra storia: Sol è il più alto, e gli intervalli di confidenza Arena per Gemini base e Sol si sovrappongono.
Il divario di 0,6 punti nell'indice tra Astra ed Extended Thinking non ha intervalli di confidenza pubblicati. Si sono già scambiati di posto una volta, quindi la chiamerei ancora una parità.
Quale modello risponde più in fretta?
Il Gemini 3.8 Live base ha il tempo al primo audio (TTFA) più rapido in tabella, ma lo scarto tra tutti e quattro è sotto i 0,2 secondi. Il TTFA è quanto impiega un modello a produrre il suo primo token audio.
Il TTFA non misura la risposta alle interruzioni né il tempo per completare una prenotazione o una ricerca. Quest'ultimo dipende più dal tuo backend e dagli strumenti.
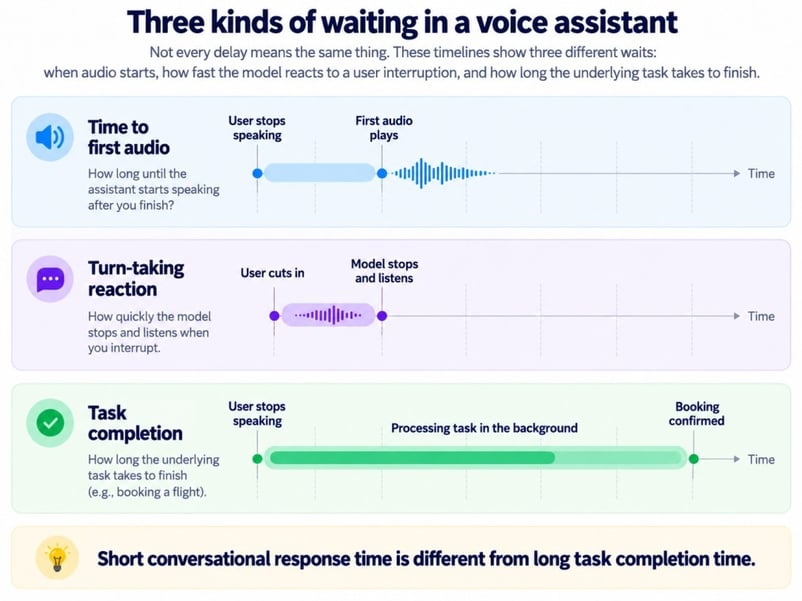
Tre tipi di attesa nella voce. Immagine dell'autore.
Sia Extended Thinking che GPT-Live-1 possono continuare a parlare durante una ricerca lenta. Chi chiama sta comunque aspettando la prenotazione.
Cosa non misurano i benchmark vocali
Per una linea di supporto, le classifiche non possono dirti:
- se il tuo provider telefonico e il codec trasportano l'audio in modo pulito
- se l'agente segue ancora lo script dopo dieci minuti
- come sente un chiamante con un forte accento in strada rumorosa
- quanto costa la chiamata una volta conteggiati backend e strumenti
Un pilot con le tue registrazioni risponde meglio a queste domande.
Prezzi: Gemini 3.8 Live vs. GPT-Live-1 — Qual è più economico?
Il Gemini base è il più economico nel test di Artificial Analysis, ma i modelli fanno pagare cose diverse. Il costo per task completato conta più del prezzo di listino.
Le tariffe sotto sono i prezzi di listino sulle pagine dei prezzi di Google e sulla pagina modello di GPT-Live-1 mentre scrivo, e le cifre al minuto di Gemini sono conversioni di Google dai prezzi a token.
|
Voce di costo |
Gemini 3.8 Live e Extended Thinking (tier a pagamento) |
GPT-Live-1 |
|
Input audio |
$3,00 per 1M token (circa $0,005/min) |
Incluso in $0,05 al minuto, fatturato al secondo |
|
Output audio |
$12,00 per 1M token (circa $0,018/min) |
Coperto dallo stesso costo di sessione |
|
Input immagine o video |
$1,00 per 1M token (circa $0,002/min) |
Non supportato |
|
Ragionamento |
Token di ragionamento fatturati alle tariffe di output |
Token del modello backend al prezzo di quel modello |
|
Ricerca e strumenti |
5.000 richieste Search gratuite al mese, poi $14 per 1.000 |
Fatturati dal modello backend e dagli strumenti che usi |
I token di ragionamento rendono Extended Thinking più costoso del Gemini base. Artificial Analysis stima $0,84 per ora di audio in input per il Gemini base, $3,50 per Extended Thinking, $4,47 per Sol e $5,83 per Astra, esclusi strumenti e sconti cache. Gemini Live non supporta la cache; un backend GPT-Live-1 può farlo.
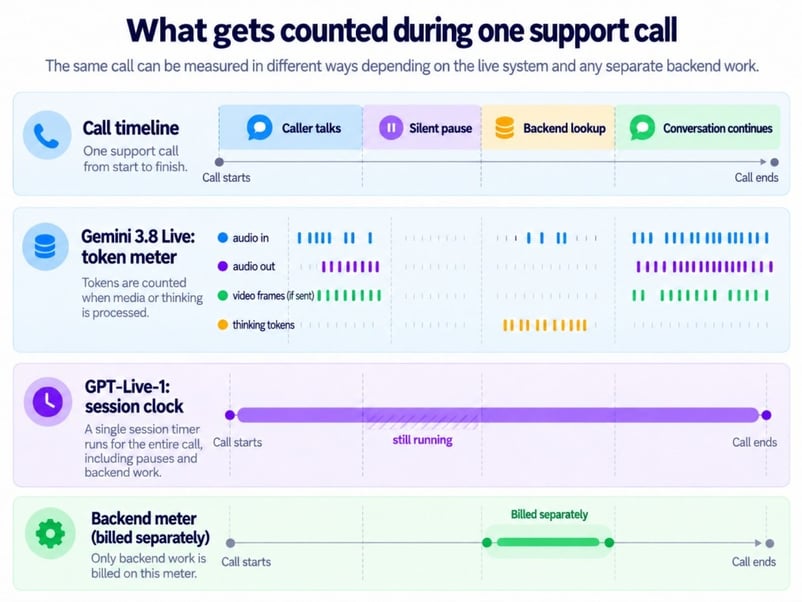
Cosa conta ciascun contatore durante le chiamate. Immagine dell'autore.
L'orologio di GPT-Live-1 scorre anche nel silenzio, e il mute non lo ferma. Somma i costi della tabella e del telefono, poi dividi per i task completati.
Supporto browser, server e telefono in Gemini 3.8 Live e GPT-Live-1
Le app browser e server possono connettersi a entrambi i modelli, ma la distribuzione su telefono li separa. Il diagramma mostra le opzioni di connessione; le differenze operative sono la durata della connessione e chi sta nel percorso della chiamata.
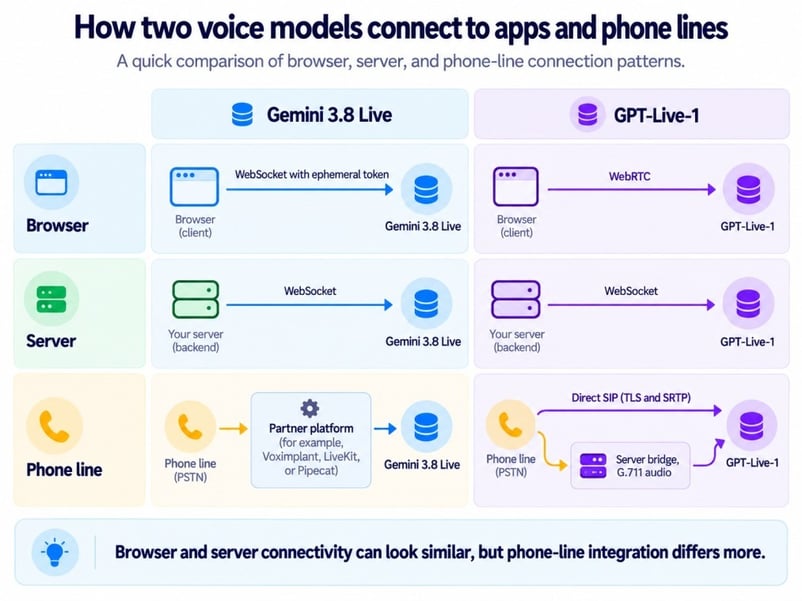
Percorsi di connessione per browser, server e telefono. Immagine dell'autore.
Le connessioni Gemini si resettano dopo circa 10 minuti, quindi le chiamate più lunghe richiedono la ripresa di sessione. Con GPT-Live-1, registra separatamente la connessione vocale e il lavoro delegato al backend.
Telefonate e supporto SIP
Il SIP diretto lascia un fornitore in meno nel percorso di chiamata di GPT-Live-1. Il percorso tramite partner di Gemini aggiunge un altro servizio da configurare, monitorare e fare debug.
Alcuni sviluppatori sul forum di OpenAI riportano che GPT-Live-1 promette un'azione senza creare una delega. L'assistenza OpenAI non l'ha definito un bug; ha rimandato alla guida al prompting, che nota come un riscontro verbale non confermi l'avvio del lavoro backend. Io registrerei gli eventi di delega separatamente dal parlato.
Dal 2 novembre, OpenAI supporta anche le chiamate SIP in uscita per tutte le organizzazioni, quindi GPT-Live-1 può fare chiamate oltre a rispondere.
Gemini 3.8 Live vs. GPT-Live-1: quale dovresti usare?
La scelta si riduce a due domande: l'assistente deve vedere? Hai già un backend? Un sì alla prima porta verso Gemini; un sì alla seconda porta verso GPT-Live-1.
Passa allo scenario qui sotto che corrisponde al tuo prodotto.
Supporto telefonico e prenotazioni
Una linea telefonica ha bisogno di gestione delle interruzioni e conferme prima di azioni irreversibili. GPT-Live-1 è in linea con queste esigenze, con il supporto SIP visto sopra e la logica di prenotazione mantenuta nel backend.
Troubleshooting con fotocamera e schermo
Quando un utente punta il telefono su un router, il modello deve ragionare su ciò che vede in quel momento. Gemini 3.8 Live lo fa in un'unica sessione, senza un componente di visione separato, a patto di pianificare il limite di 2 minuti per il video dalla sezione immagini.
Lavori multi-step in background
Per i task che concatenano strumenti, confronta Extended Thinking con GPT-Live-1 più Astra. Astra guida τ-Voice in una prova, quindi la scelta torna comunque a dove deve vivere il ragionamento.
Aggiungere la voce a un agente che già gestisci
La delega client può aggiungere GPT-Live-1 a un agente esistente senza riscriverne il ciclo di ragionamento. Con Gemini, il modello live diventa il pianificatore.
Alto volume di chiamate con budget ridotto
Chiamate brevi e semplici puntano al Gemini base, la configurazione più economica nel test di Artificial Analysis. Strumenti multi-step cambiano il calcolo.
Considerazioni finali
Il modo più chiaro per inquadrare il confronto è che Gemini 3.8 Live combina vista, ragionamento e parlato in un unico modello, mentre GPT-Live-1 separa la voce dall'intelligenza dietro. Nessuno domina, e i due sono abbastanza vicini nel suonare umani e nel rispondere rapidamente che sarà l'architettura a determinare la maggior parte delle decisioni reali.
Trovo interessante quanto velocemente il vantaggio nei task da agente si sia spostato verso GPT-Live-1 con Astra. Quel punteggio appartiene all'intero sistema, non solo al modello vocale, quindi è l'argomento della delega in azione, anche se una singola esecuzione di test è un segnale e non una sentenza.
Un'altra cosa da osservare è la lineup backend di OpenAI, dato che GPT-6.1 Sol è arrivato a fine settembre 2026. Ogni nuovo backend può spostare i punteggi di GPT-Live-1 senza toccare la voce, mentre una modifica comparabile di Google implicherebbe cambiare il modello live.
Per ora, Gemini 3.8 Live è la scelta più semplice per tutto ciò che usa la fotocamera, e GPT-Live-1 è la scelta più semplice per prodotti telefonici con un backend già in essere. In entrambi i casi, il tuo codice deve comunque gestire il problema della prenotazione da venerdì a giovedì.
Per i concetti di agenti alla base di entrambi i percorsi, il nostro corso Introduzione agli agenti AI copre strumenti, memoria e pianificazione.
FAQ
GPT-Live-1 può usare un modello Gemini come backend?
Sì. La delega client può inviare il lavoro a un modello di testo Gemini dietro il tuo backend. Pagheresti OpenAI per i minuti voce e Google per i token del backend.
Per quanto tempo una conversazione GPT-Live-1 resta nel contesto?
GPT-Live-1 ha una finestra di contesto da 128.000 token che conta i token audio, non solo la trascrizione. Una volta superato il 90% d'uso, avvia un motore vocale sostitutivo che porta fino a 8.192 token di cronologia recente e riepiloghi, quindi mantieni azioni confermate e stato dei task nella tua applicazione.
Posso riutilizzare il codice della mia app vocale esistente?
Limiti più espliciti su OpenAI che su Gemini. Il codice scritto per Gemini 3.1 Flash Live richiede principalmente la nuova stringa del modello, senza alcuna impostazione thinking_level, che gemini-3.8-live non accetta. Rimuovi anche enable_affective_dialog e proactive_audio: false se il tuo codice li ha ereditati da modelli più vecchi. GPT-Live-1 usa il proprio endpoint v1/live/sessions invece di v1/realtime, quindi un'app Realtime API richiede un refactoring, e OpenAI pubblica una guida alla migrazione.
L'audio di Gemini 3.8 Live è filigranato?
Sì. Google afferma che tutto l'audio generato dai suoi prodotti di AI, inclusi entrambi i modelli Gemini 3.8 Live, porta una filigrana SynthID che gli ascoltatori non possono sentire, utile se mai dovessi dimostrare che un chiamante ha ascoltato parlato sintetico.
Is Gemini 3.8 Live audio watermarked?
Yes. Google says all audio generated by its AI products, including both Gemini 3.8 Live models, carries a SynthID watermark that listeners can't hear, which helps if you ever need to show a caller heard synthetic speech.

Sono un data engineer e community builder: lavoro su pipeline dati, cloud e strumenti di AI, e scrivo tutorial pratici e ad alto impatto per DataCamp e per sviluppatori alle prime armi.





I vecchi assistenti vocali funzionavano a turni: parli, aspetti e poi rispondono. Gemini 3.8 Live di Google e GPT-Live-1 di OpenAI sono agenti vocali in tempo reale che gestiscono interruzioni e cambi a metà frase. Nessuno dei due è nettamente superiore in tutto.
La differenza sta in dove avviene il ragionamento. Gemini 3.8 Live ti ascolta, può ispezionare l'input della fotocamera, ragiona e decide quando chiedere alla tua app di agire. GPT-Live-1 si concentra sulla conversazione e può ascoltare mentre parla. Quando GPT-Live-1 ha bisogno di ragionamenti più complessi o di un'azione, passa il lavoro a un secondo modello o servizio chiamato backend.
OpenAI ha portato GPT-Live-1 nella sua API a settembre, e Google ha rilasciato Gemini 3.8 Live meno di una settimana dopo. La nostra panoramica su Gemini 3.8 Live copre il lancio di Google. Se vuoi costruire con uno dei due, il nostro tutorial su Gemini 3.8 Live e il tutorial sull'API GPT-Live-1 spiegano la configurazione.
TL;DR
Poco tempo? Ecco il confronto in sei punti:
Un requisito di fotocamera o un backend già esistente può chiudere la scelta prima dei benchmark. La tabella sotto mostra perché.