
Sekilas: Gemini 3.8 Live vs. GPT-Live-1
Hal yang tidak terlihat di tabel di bawah adalah bahwa pada kedua kasus, aplikasi Anda sendiri tetap melakukan pekerjaan sebenarnya, seperti menjalankan fungsi Anda dan mencatat apa yang diminta pengguna.
|
Poin perbandingan |
Gemini 3.8 Live |
GPT-Live-1 |
|
Peran |
Satu model yang mendengarkan, melihat, bernalar, dan meminta aplikasi Anda bertindak |
Model suara yang berbicara dan menyerahkan pekerjaan lebih berat ke backend |
|
ID model |
|
|
|
Input native |
Teks, audio, gambar, frame video |
Hanya teks dan audio |
|
Lokasi penalaran lebih dalam berjalan |
Di dalam model, dengan porsi lebih besar pada Extended Thinking |
Di backend pilihan Anda |
|
Siapa yang menjalankan fungsi Anda |
Aplikasi Anda (Search grounding berjalan di sisi Google) |
Aplikasi Anda; alat yang dihosting seperti penelusuran web berjalan bersama backend |
|
Satuan penagihan |
Token, termasuk token penalaran |
Menit sesi tersambung, plus penggunaan backend |
|
Paket gratis |
Ya |
Tidak |
Apa Itu Gemini 3.8 Live dan GPT-Live-1?
Keduanya adalah model speech-to-speech, jadi audio masuk dan audio keluar tanpa langkah transkripsi terpisah.
Apa itu Gemini 3.8 Live?
Gemini 3.8 Live adalah model dialog langsung berlatensi rendah dari Google. Ia menerima teks, gambar, audio, dan video, melakukan penalaran di antara giliran bicara, dan memanggil fungsi secara asinkron. Kedua varian Gemini mencantumkan batas input 131.072 token pada halaman model mereka.
Gemini 3.8 Live Extended Thinking adalah model terpisah, bukan pengaturan. Ia menambahkan penalaran latar belakang pada level rendah, sedang, atau tinggi sambil menarasikan progres.
Catatan rilis Google mencantumkan kedua ID model sebagai tersedia umum, sementara panduan kapabilitas Live API masih memberi label pratinjau untuk API-nya.
Apa itu GPT-Live-1?
GPT-Live-1 adalah model suara full-duplex dari OpenAI. Full duplex adalah istilah teknis untuk perilaku mendengarkan sambil berbicara yang saya jelaskan di bagian pengantar.
OpenAI menyebut penyerahan ke backend sebagai delegation. Suara dapat terus berbicara saat pekerjaan itu berjalan.
GPT-Live-1 juga bukan produk yang sama dengan lini GPT-Realtime-2 dari OpenAI atau model backend yang menjadi tujuan delegasi. GPT-Realtime-2.1 menjaga penalaran dan alat di dalam satu model realtime, jadi semua yang saya katakan tentang delegation hanya berlaku untuk GPT-Live-1.
Apa Perbedaan Utama Antara Gemini 3.8 Live dan GPT-Live-1?
Ringkasan singkat sudah ada di atas; berikut versi lengkapnya. Gemini 3.8 Live memilih pemanggilan fungsi di dalam sesi live, sementara GPT-Live-1 menyerahkan penalaran ke backend terpisah. Pada kedua desain, aplikasi Anda menjalankan fungsi Anda sendiri.
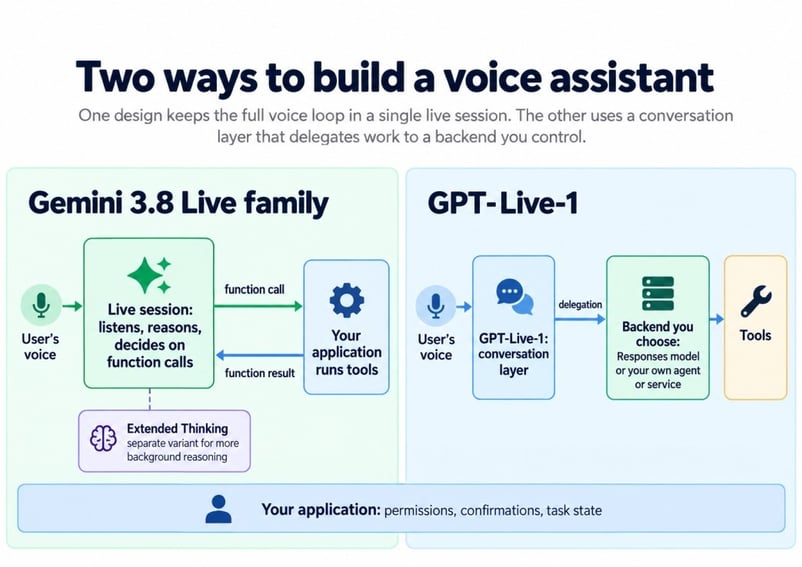
Di mana masing-masing model menempatkan proses berpikir. Gambar oleh Penulis.
Sebagian besar poin berikut ini berawal dari perbedaan itu, jadi berikut dahulu masing-masing pendekatan.
Bagaimana Gemini 3.8 Live merencanakan di dalam satu sesi
Dengan Gemini, tidak ada model kedua untuk dikonfigurasi. Model live mengeluarkan panggilan fungsi saat membutuhkan data, dan klien Anda mengembalikan hasilnya, seperti yang dijelaskan dalam panduan thinking Google.
Berpindah ke Extended Thinking tetap menggunakan endpoint WebSocket yang sama dan tidak memerlukan model backend, meski kode klien berubah.
Cara kerja delegation pada GPT-Live-1
GPT-Live-1 menangani ucapan dan memutuskan kapan meminta bantuan; backend menangani penalaran, alat, dan aturan bisnis. Panduan prompting OpenAI menaruh prosedur tugas lengkap di instruksi backend.
Dengan Responses delegation, OpenAI menjalankan model yang Anda konfigurasikan. Dengan client delegation, pekerjaan diarahkan ke model atau layanan apa pun yang dijalankan aplikasi Anda. Apa pun pilihannya, panduan delegation menyatakan bahwa aplikasi Anda yang memiliki izin, pencatatan, dan status tugas.
Mengapa perbedaan arsitektur penting
Konsekuensi dari pemisahan adalah lebih banyak komponen: sesi suara, backend, dan status yang dibagi di antara keduanya. Sebagai imbalannya, Anda bisa mengganti model penalaran tanpa menyentuh komponen suara.
Kompromi itu terasa kurang menarik jika Anda belum memiliki backend, tetapi lebih baik jika Anda perlu meningkatkan agen yang sudah ada tanpa mengubah suaranya.
Bagaimana Gemini 3.8 Live dan GPT-Live-1 Menangani Interupsi?
Keduanya menangani interupsi, tetapi GPT-Live-1 dibangun dengan fondasi itu, bersama jeda dan backchannel ("mm-hmm" yang diucapkan pendengar). Gemini 3.8 Live mendukung barge-in, dan audio proaktifnya selalu aktif, tetapi dokumen Google tidak menyebutnya full duplex.
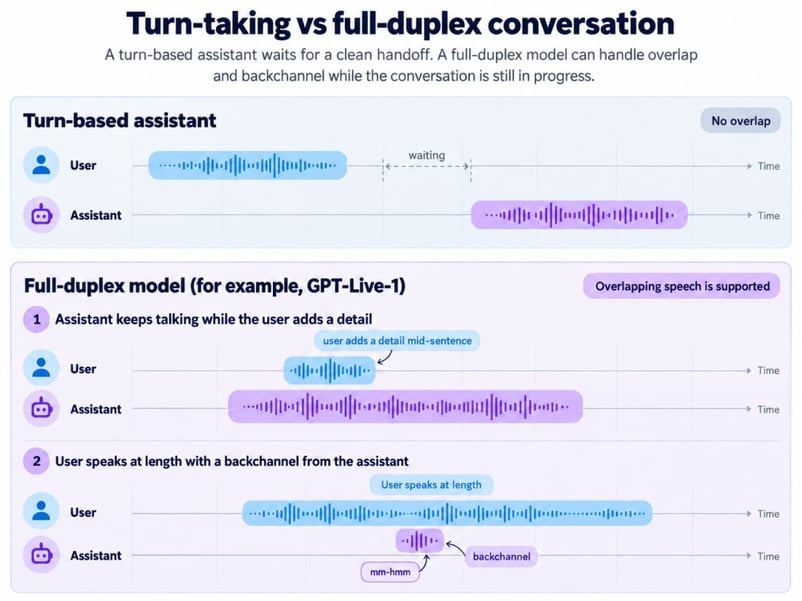
Bergiliran versus berbicara bersamaan. Gambar oleh Penulis.
Posting peluncuran OpenAI mengutip aplikasi bahasa Speak yang mengatakan GPT-Live-1 memangkas interupsi hampir 80% dibanding sistem berbasis giliran, klaim pelanggan alih-alih uji independen.
Pada Gemini, audio proaktif memungkinkan model melewati ucapan yang tidak ditujukan untuknya. Tutorial Gemini kami menemukan bahwa audio dari speaker laptop yang bocor ke mikrofon dihitung sebagai pengguna memotong pembicaraan, jadi uji dengan dan tanpa headphone.
Bagaimana Gemini 3.8 Live dan GPT-Live-1 Menangani Penalaran dan Pemanggilan Alat?
Gemini meningkatkan penalaran dengan beralih dari Live dasar ke Extended Thinking. GPT-Live-1 meningkatkannya dengan mengganti backend, jadi bandingkan Extended Thinking dengan setelan GPT-Live-1 yang lengkap, bukan hanya model suaranya.
Gemini 3.8 Live vs. Gemini 3.8 Live Extended Thinking
Gemini 3.8 Live dasar tidak memiliki thinking_level dan menerima fungsi BLOCKING untuk kode lama. Extended Thinking mengubah empat perilaku klien:
-
Alat: hanya fungsi
NON_BLOCKINGyang bekerja, dan fungsi blocking mengembalikan error fatal. -
Level thinking: tidak ada opsi minimal, hanya tiga level yang disebutkan di atas.
-
Akhir giliran:
turnComplete: truetidak lagi berarti model selesai, jadi klien Anda memantauinteraction_statushingga terbacaIDLE. -
Penjadwalan: penjadwalan fungsi tidak didukung.
Google merekomendasikan Extended Thinking untuk tugas multi-langkah dan alat yang lambat. Konsekuensinya adalah latensi dan token output yang lebih besar.
Satu hal yang mengganggu saya di dokumen Google. Posting peluncuran mengatakan Gemini 3.8 Live dapat "terus mengobrol saat tugas selesai di latar belakang," tetapi panduan thinking mengatakan model dasar "menunggu eksekusi alat sebelum berbicara." Tutorial Gemini kami melihat perilaku kedua saat pencarian cuaca, jadi saya akan berpatokan pada panduan hingga Google memperjelas.
Model backend mana yang bekerja dengan GPT-Live-1?
GPT-Live-1 dapat berada di depan backend apa pun yang Anda konfigurasikan. Dokumen OpenAI menyoroti tiga backend GPT-6:
-
GPT-6 Luna (
gpt-6-luna), titik awal yang disarankan panduan delegation -
GPT-6 Sol (
gpt-6-sol), saran panduan untuk tugas yang lebih berat -
GPT-6 Astra, yang direkomendasikan posting peluncuran untuk isu pelanggan yang kompleks
Baris Artificial Analysis "GPT-Live-1 (Astra, medium)" dan "GPT-Live-1 (Sol, low)" adalah konfigurasi sistem, bukan versi model suara. Artificial Analysis tidak menyebut generasi Sol, dan OpenAI merilis GPT-6.1 Sol setelah uji tersebut dilakukan.
Apa yang terjadi saat penelepon mengubah permintaan di tengah tugas
Misalkan penelepon meminta memindahkan pemesanan ke Jumat, lalu berkata "sebenarnya, Kamis" saat pencarian berjalan. Hanya permintaan kedua yang tetap berlaku.
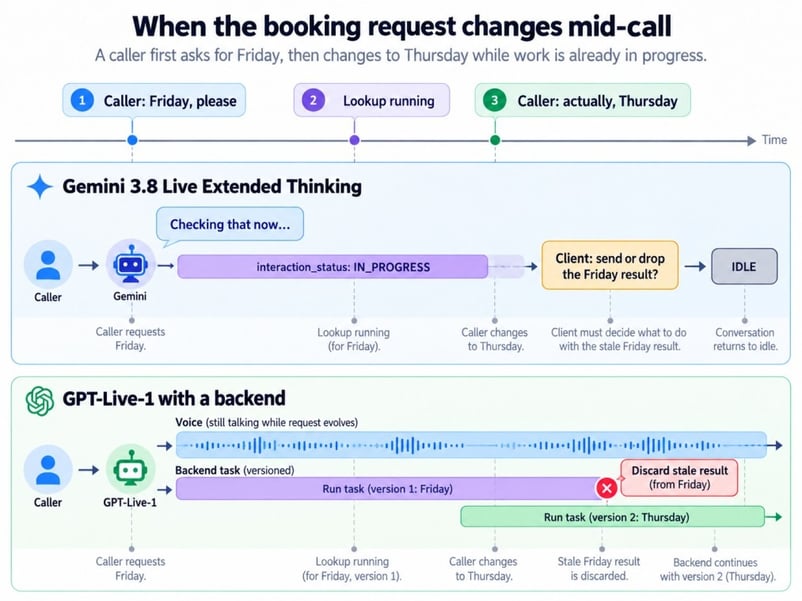
Permintaan berubah saat pekerjaan lambat. Gambar oleh Penulis.
Pada GPT-Live-1, menginterupsi suara tidak membatalkan pekerjaan backend. Responses delegation masih bisa mengembalikan hasil lama ke suara, sementara client delegation memungkinkan kode Anda membuangnya terlebih dahulu.
Pada Gemini, klien Anda dapat membuang hasil alat yang basi. Apa pun jalurnya, aplikasi Anda yang memutuskan tugas saat ini.
Apakah Gemini 3.8 Live dan GPT-Live-1 Mendukung Gambar dan Video?
Gemini 3.8 Live menerima gambar dan video secara native; GPT-Live-1 mencantumkan keduanya sebagai tidak didukung. Aplikasi GPT-Live-1 masih bisa mengirim foto ke backend visi terpisah, tetapi tidak bisa menonton kamera secara langsung.
Untuk Gemini, frame masuk ke sesi yang sama dengan audio, sehingga model dapat menjawab "apakah ini kabel yang benar?" saat pengguna menyorotkannya. Ada dua konsekuensi. Frame video dikirim secara default, dan panduan sesi Google membatasi sesi dengan audio dan video hingga 2 menit, dibanding 15 menit untuk audio saja, kecuali Anda menyalakan kompresi context window.
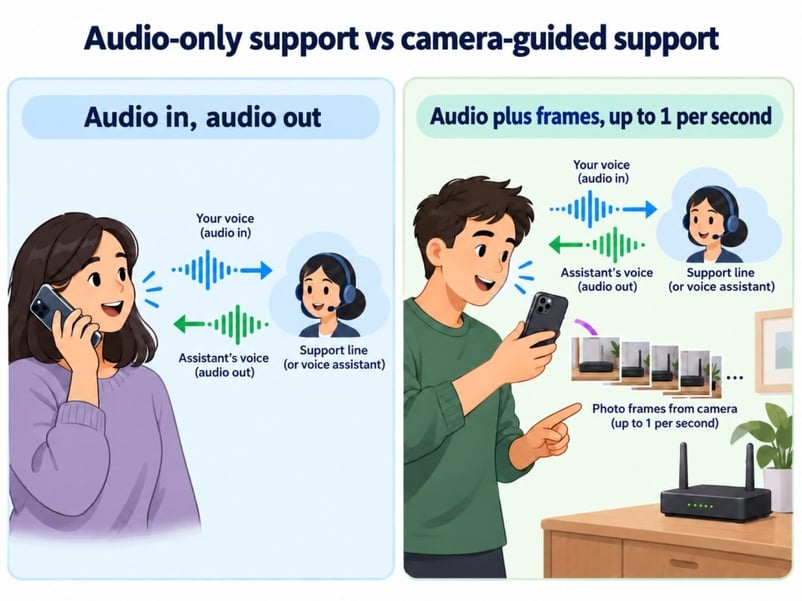
Panggilan telepon versus sesi perbaikan berbasis kamera. Gambar oleh Penulis.
Layanan reservasi tidak pernah melihat frame, dan leaderboard suara di bawah tidak mengukur visi.
Tolok Ukur Gemini 3.8 Live vs. GPT-Live-1
Tidak ada satu pun tolok ukur yang memastikan perbandingan ini. Di antara empat konfigurasi dari dua model tersebut, Astra memimpin indeks utama, Sol memimpin dinamika percakapan, dan Gemini dasar memiliki Arena Elo tertinggi dari empat konfigurasi.
Pertama, cara kerja indeks utama, karena itu menjelaskan sebagian besar selisih.
Cara kerja Artificial Analysis Speech to Speech Index
Indeks memberikan bobot yang sama pada empat keterampilan berbeda:
- Big Bench Audio: pertanyaan penalaran yang dibacakan
- τ-Voice: tugas layanan pelanggan multi-langkah, seperti mengganti jadwal penerbangan
- Skor Arena: pemungutan suara buta oleh manusia atas agen mana yang lebih disukai
- Tingkat keberhasilan tugas: seberapa sering percakapan diakhiri dengan pemanggilan alat akhir yang benar
Dinamika percakapan dilaporkan terpisah berdasarkan metodologi v2.0.
Berikut empat konfigurasi yang relevan di sini.
|
Konfigurasi |
Indeks |
Big Bench Audio |
τ-Voice |
Dinamika percakapan |
Arena Elo |
Keberhasilan tugas |
TTFA |
|
GPT-Live-1 (Astra, medium) |
83.2 |
90.1% |
74.5% |
94.9% |
1027 |
87.4% |
1.34 s |
|
Gemini 3.8 Live Extended Thinking (High) |
82.6 |
97.7% |
68.6% |
91.9% |
966 |
89.1% |
1.35 s |
|
GPT-Live-1 (Sol, low) |
80.1 |
89.0% |
59.3% |
97.3% |
1037 |
90.9% |
1.24 s |
|
Gemini 3.8 Live |
74.5 |
91.7% |
30.1% |
96.1% |
1074 |
93.2% |
1.18 s |
Kedua skor τ-Voice GPT-Live-1 berasal dari satu kali percobaan, jadi perlakukan dengan kehati-hatian.
Tugas agen vs. skor preferensi manusia
Pada τ-Voice, Astra meraih 74,5%, Extended Thinking 68,6%, dan Gemini dasar 30,1%. Penalaran ekstra berpengaruh ketika alat dirangkai.
Percakapan menunjukkan cerita berbeda: Sol meraih skor tertinggi, dan interval kepercayaan Arena untuk Gemini dasar dan Sol saling tumpang tindih.
Selisih indeks 0,6 poin antara Astra dan Extended Thinking tidak memiliki interval kepercayaan yang dipublikasikan. Keduanya sudah pernah bertukar posisi, jadi saya masih menyebutnya imbang.
Model mana yang merespons lebih cepat?
Gemini 3.8 Live dasar memiliki time to first audio (TTFA) paling cepat di tabel, tetapi rentang di keempatnya kurang dari 0,2 detik. TTFA adalah waktu yang dibutuhkan model untuk menghasilkan token audio pertama.
TTFA tidak mengukur respons terhadap interupsi dan waktu untuk menyelesaikan pemesanan atau pencarian. Yang terakhir lebih dipengaruhi oleh backend dan alat Anda.
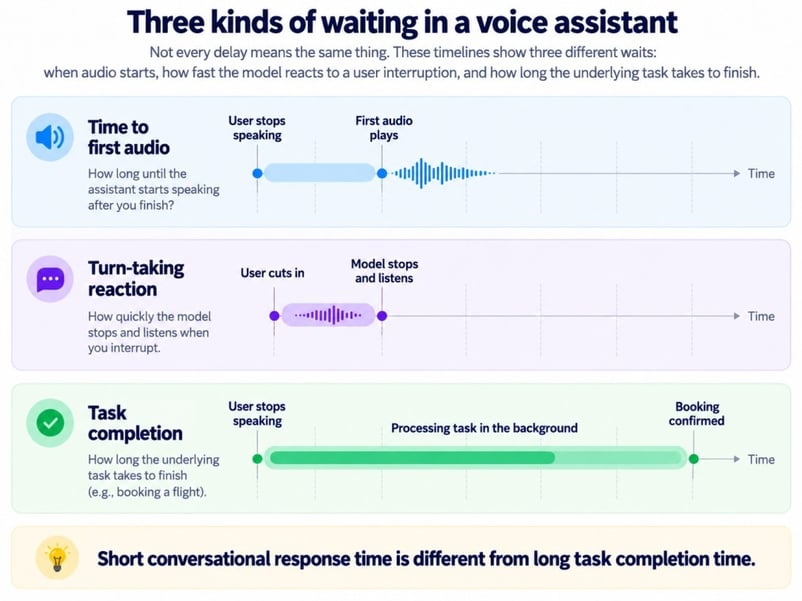
Tiga jenis waktu tunggu dalam suara. Gambar oleh Penulis.
Baik Extended Thinking maupun GPT-Live-1 dapat terus berbicara selama pencarian lambat. Penelepon tetap menunggu pemesanan selesai.
Hal yang tidak diukur tolok ukur suara
Untuk jalur dukungan, leaderboard tidak dapat memberi tahu Anda:
- apakah penyedia telepon dan codec Anda mengalirkannya dengan jernih
- apakah agen tetap mengikuti skrip Anda setelah sepuluh menit
- bagaimana model mendengar penelepon dengan aksen kuat di jalan yang bising
- berapa biaya panggilan setelah backend dan alat dihitung
Uji coba dengan rekaman Anda sendiri menjawab pertanyaan-pertanyaan itu dengan lebih baik.
Harga Gemini 3.8 Live vs. GPT-Live-1: Mana yang Lebih Murah?
Gemini dasar termurah dalam uji Artificial Analysis, tetapi model menagih hal yang berbeda. Biaya per tugas yang berhasil lebih penting daripada harga tertera.
Tarif di bawah ini adalah harga resmi di halaman harga Google dan halaman model GPT-Live-1 saat saya menulis ini, dan angka per menit Gemini adalah konversi Google sendiri dari harga token.
|
Komponen biaya |
Gemini 3.8 Live dan Extended Thinking (tingkat berbayar) |
GPT-Live-1 |
|
Input audio |
$3,00 per 1M token (sekitar $0,005/menit) |
Termasuk dalam $0,05 per menit, ditagih per detik |
|
Output audio |
$12,00 per 1M token (sekitar $0,018/menit) |
Termasuk dalam biaya sesi yang sama |
|
Input gambar atau video |
$1,00 per 1M token (sekitar $0,002/menit) |
Tidak didukung |
|
Penalaran |
Token thinking ditagih pada tarif output |
Token model backend sesuai harga model tersebut |
|
Pencarian dan alat |
5.000 permintaan Search gratis per bulan, lalu $14 per 1.000 |
Ditagih oleh model backend dan alat yang Anda gunakan |
Token thinking membuat Extended Thinking lebih mahal daripada Gemini dasar. Artificial Analysis memperkirakan $0,84 per jam audio input untuk Gemini dasar, $3,50 untuk Extended Thinking, $4,47 untuk Sol, dan $5,83 untuk Astra, tidak termasuk alat dan diskon cache. Gemini Live tidak mendukung caching; backend GPT-Live-1 bisa.
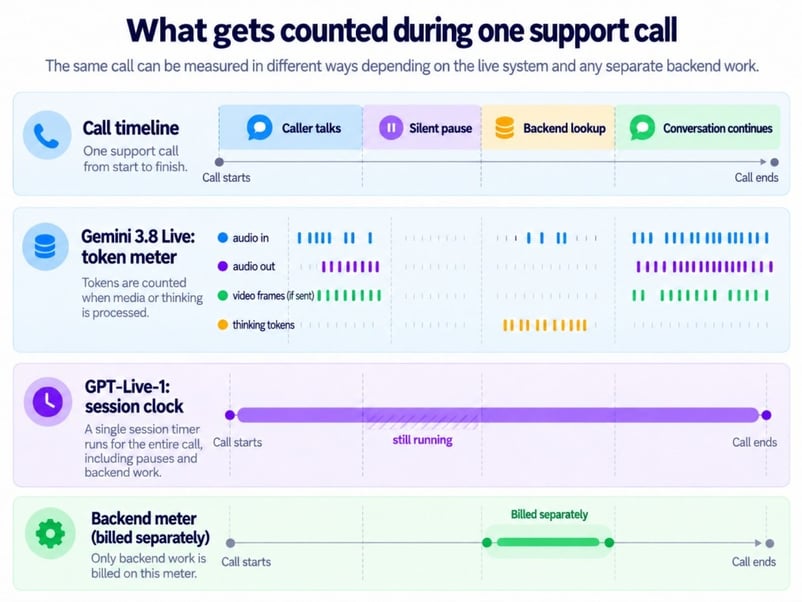
Apa yang dihitung masing-masing meter selama panggilan. Gambar oleh Penulis.
Jam GPT-Live-1 terus berjalan saat hening, dan mute tidak menghentikannya. Tambahkan biaya di tabel dan biaya telepon, lalu bagi dengan jumlah tugas yang selesai.
Dukungan Browser, Server, dan Telepon pada Gemini 3.8 Live dan GPT-Live-1
Aplikasi browser dan server dapat terhubung ke kedua model, tetapi penerapan telepon membedakan keduanya. Diagram menunjukkan opsi koneksi; perbedaannya secara operasional adalah lamanya koneksi dan siapa yang berada di jalur panggilan.
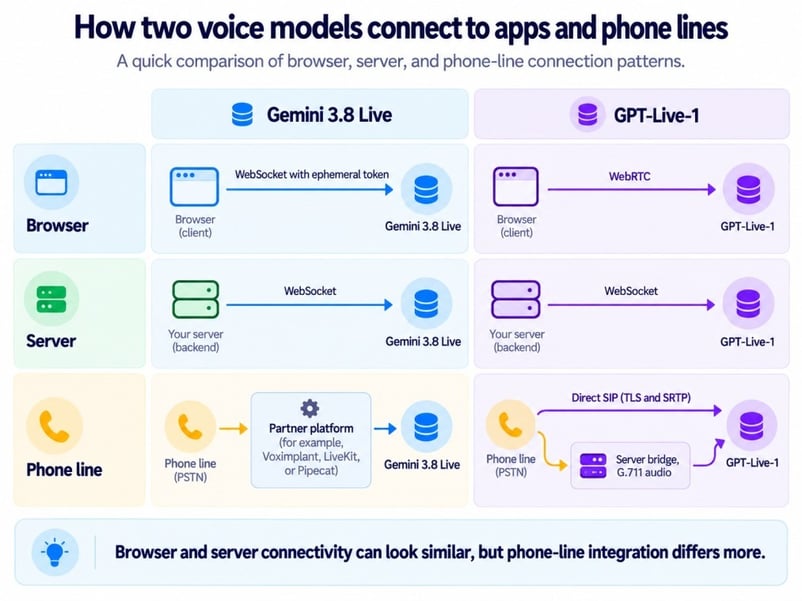
Jalur koneksi browser, server, dan telepon. Gambar oleh Penulis.
Koneksi Gemini direset sekitar setiap 10 menit, jadi panggilan yang lebih lama memerlukan kelanjutan sesi. Dengan GPT-Live-1, catat koneksi suara dan pekerjaan backend yang didelegasikan secara terpisah.
Panggilan telepon dan dukungan SIP
SIP langsung mengurangi satu vendor pada jalur panggilan GPT-Live-1. Rute mitra Gemini menambah satu layanan lagi untuk dikonfigurasi, dipantau, dan di-debug.
Beberapa pengembang di forum OpenAI melaporkan GPT-Live-1 menjanjikan sebuah aksi tanpa membuat delegation. Dukungan OpenAI tidak menyebutnya bug; mereka menunjuk ke panduan prompting, yang mencatat bahwa pengakuan lisan tidak mengonfirmasi pekerjaan backend sudah dimulai. Saya akan mencatat event delegation terpisah dari ucapan.
Sejak 2 November, OpenAI juga mendukung panggilan keluar SIP untuk semua organisasi, sehingga GPT-Live-1 dapat melakukan panggilan selain menjawabnya.
Gemini 3.8 Live vs. GPT-Live-1: Mana yang Harus Anda Gunakan?
Pilihan bermuara pada dua pertanyaan: apakah asisten perlu melihat, dan apakah Anda sudah memiliki backend? Jawaban ya untuk yang pertama mengarah ke Gemini; jawaban ya untuk yang kedua mengarah ke GPT-Live-1.
Lewati ke skenario di bawah yang paling cocok dengan produk Anda.
Dukungan telepon dan reservasi
Saluran telepon membutuhkan penanganan interupsi dan konfirmasi sebelum sesuatu yang tidak dapat diurungkan. GPT-Live-1 cocok, dengan dukungan SIP seperti dibahas di atas dan logika pemesanan tetap di backend.
Pemecahan masalah kamera dan layar
Saat pengguna mengarahkan ponsel ke router, model harus bernalar tentang apa yang dilihatnya saat itu juga. Gemini 3.8 Live melakukannya dalam satu sesi, tanpa komponen visi terpisah, selama Anda mengantisipasi batas 2 menit video dari bagian gambar.
Pekerjaan multi-langkah di latar belakang
Untuk tugas yang merangkai alat, bandingkan Extended Thinking dengan GPT-Live-1 plus Astra. Astra memimpin τ-Voice pada satu uji, jadi pilihan tetap kembali ke lokasi penalaran sebaiknya ditempatkan.
Menambahkan suara ke agen yang sudah Anda jalankan
Client delegation dapat menambahkan GPT-Live-1 ke agen yang sudah ada tanpa menulis ulang loop penalarannya. Dengan Gemini, model live menjadi perencana.
Volume panggilan tinggi dengan anggaran ketat
Panggilan singkat dan sederhana mengarah ke Gemini dasar, setelan termurah dalam uji Artificial Analysis. Alat multi-langkah mengubah perhitungannya.
Penutup
Cara paling jelas untuk membingkai perbandingan ini adalah Gemini 3.8 Live menggabungkan penglihatan, penalaran, dan tutur dalam satu model, sementara GPT-Live-1 memisahkan suara dari kecerdasan di belakangnya. Tidak ada yang dominan, dan keduanya cukup berdekatan dalam hal terdengar alami dan merespons cepat sehingga arsitektur akan menentukan sebagian besar keputusan nyata.
Hal yang menurut saya paling menarik adalah seberapa cepat keunggulan tugas agen bergeser ke GPT-Live-1 dengan Astra. Skor itu milik keseluruhan sistem, bukan hanya model suara, jadi ini adalah argumen delegation yang bekerja, meskipun satu kali uji adalah sinyal, bukan vonis.
Hal lain yang layak diperhatikan adalah jajaran backend OpenAI, karena GPT-6.1 Sol hadir pada akhir September 2026. Setiap backend baru dapat mengubah skor GPT-Live-1 tanpa menyentuh komponen suara, sementara perubahan sebanding di Google berarti mengganti model live.
Untuk saat ini, Gemini 3.8 Live lebih mudah dipilih untuk apa pun yang melibatkan kamera, dan GPT-Live-1 lebih mudah untuk produk telepon dengan backend yang sudah ada. Apa pun pilihannya, kode Anda tetap harus menangani masalah pemesanan dari Jumat ke Kamis.
Untuk konsep agen di balik kedua jalur tersebut, kursus Introduction to AI Agents kami membahas alat, memori, dan perencanaan.
FAQs
Bisakah GPT-Live-1 menggunakan model Gemini sebagai backend-nya?
Ya. Client delegation dapat mengirim pekerjaan ke model teks Gemini di balik backend Anda sendiri. Anda akan membayar OpenAI untuk menit suara dan Google untuk token backend.
Seberapa lama percakapan GPT-Live-1 bisa tetap dalam konteks?
GPT-Live-1 memiliki context window 128.000 token yang menghitung token audio, bukan hanya transkrip. Setelah penggunaan melewati 90%, ia memulai mesin suara pengganti yang membawa hingga 8.192 token riwayat terbaru dan ringkasan, jadi simpan tindakan yang sudah dikonfirmasi dan status tugas di aplikasi Anda sendiri.
Batas laju apa yang berlaku untuk Gemini 3.8 Live dan GPT-Live-1?
GPT-Live-1 mengizinkan 50 sesi bersamaan pada Build, 300 pada Launch, dan 500 pada Grow, tanpa akses tingkat gratis. Google tidak memublikasikan batas khusus untuk Live dan mengarahkan Anda ke Google AI Studio untuk batas proyek Anda saat ini.
Bisakah saya menggunakan ulang kode aplikasi suara yang sudah ada?
Kebanyakan pada Gemini, lebih sedikit pada OpenAI. Kode yang ditulis untuk Gemini 3.1 Flash Live umumnya hanya perlu string model baru, tanpa pengaturan thinking_level, yang tidak diterima oleh gemini-3.8-live. Hapus juga enable_affective_dialog dan proactive_audio: false jika kode Anda masih membawanya dari model lama. GPT-Live-1 menggunakan endpoint v1/live/sessions sendiri alih-alih v1/realtime, jadi aplikasi Realtime API memerlukan pengerjaan ulang, dan OpenAI menerbitkan panduan migrasinya.
Apakah audio Gemini 3.8 Live diberi watermark?
Ya. Google mengatakan semua audio yang dihasilkan oleh produk AI-nya, termasuk kedua model Gemini 3.8 Live, membawa watermark SynthID yang tidak dapat didengar pendengar, yang membantu jika Anda perlu menunjukkan bahwa penelepon mendengar suara sintetis.

Saya seorang data engineer dan pembangun komunitas yang bekerja lintas pipeline data, cloud, dan perkakas AI sambil menulis tutorial praktis dan berdampak tinggi untuk DataCamp dan pengembang yang sedang berkembang.


Asisten suara lama umumnya bergiliran: Anda berbicara, menunggu, lalu mereka menjawab. Gemini 3.8 Live dari Google dan GPT-Live-1 dari OpenAI adalah agen suara real-time yang bisa menangani interupsi dan perubahan di tengah kalimat. Tidak ada yang mutlak lebih baik dalam semua hal.
Perbedaannya ada pada tempat proses berpikirnya. Gemini 3.8 Live mendengar Anda, dapat memeriksa input kamera, melakukan penalaran, dan memutuskan kapan meminta aplikasi Anda bertindak. GPT-Live-1 berfokus pada percakapan dan dapat mendengarkan sambil berbicara. Saat GPT-Live-1 membutuhkan penalaran yang lebih berat atau sebuah aksi, ia menyerahkan pekerjaan itu ke model atau layanan kedua yang disebut backend.
OpenAI membawa GPT-Live-1 ke API-nya pada September ini, dan Google merilis Gemini 3.8 Live kurang dari seminggu kemudian. Ulasan Gemini 3.8 Live kami membahas peluncuran Google. Jika Anda ingin membangun dengan salah satunya, tutorial Gemini 3.8 Live dan tutorial API GPT-Live-1 kami membahas langkah penyiapan.
Ringkasnya
Tidak banyak waktu? Berikut perbandingan dalam enam poin:
Kebutuhan kamera atau backend yang sudah tersedia bisa menentukan pilihan bahkan sebelum melihat leaderboard. Tabel di bawah menunjukkan alasannya.