
Gemini 3.8 Live vs GPT-Live-1 en un coup d’œil
Ce que le tableau ne montre pas, c’est que dans les deux cas, votre application exécute toujours le travail, comme lancer vos fonctions et suivre les demandes de l’utilisateur.
|
Point de comparaison |
Gemini 3.8 Live |
GPT-Live-1 |
|
Rôle |
Un modèle qui écoute, voit, raisonne et demande à votre app d’agir |
Modèle vocal qui parle et confie le travail complexe à un backend |
|
Identifiants de modèle |
|
|
|
Entrées natives |
Texte, audio, images, trames vidéo |
Texte et audio uniquement |
|
Où s’exécute le raisonnement approfondi |
Dans le modèle, avec davantage en Extended Thinking |
Dans un backend de votre choix |
|
Qui exécute vos fonctions |
Votre application (le Search grounding s’exécute côté Google) |
Votre application ; des outils hébergés comme la recherche web tournent via le backend |
|
Unité de facturation |
Tokens, y compris les tokens de raisonnement |
Minutes de session connectée, plus l’usage du backend |
|
Offre gratuite |
Oui |
Non |
Qu’est-ce que Gemini 3.8 Live et GPT-Live-1 ?
Ce sont deux modèles speech-to-speech : l’audio entre, l’audio sort, sans étape de transcription séparée.
Qu’est-ce que Gemini 3.8 Live ?
Gemini 3.8 Live est le modèle de dialogue live à faible latence de Google. Il accepte texte, images, audio et vidéo, raisonne entre les tours et appelle des fonctions de manière asynchrone. Les deux variantes de Gemini affichent une limite d’entrée de 131 72 tokens sur leurs pages modèle.
Gemini 3.8 Live Extended Thinking est un modèle distinct, pas un simple réglage. Il ajoute du raisonnement en arrière-plan à un niveau faible, moyen ou élevé tout en décrivant l’avancement.
Les notes de version de Google indiquent que les deux IDs de modèle sont en disponibilité générale, tandis que le guide des capacités Live API qualifie encore l’API de préversion.
Qu’est-ce que GPT-Live-1 ?
GPT-Live-1 est le modèle vocal full duplex d’OpenAI. Full duplex est le terme technique pour désigner l’écoute pendant la parole décrite en introduction.
OpenAI appelle cette passation au backend la délégation. La voix peut continuer à parler pendant l’exécution du travail.
GPT-Live-1 n’est pas non plus le même produit que la ligne GPT-Realtime-2 d’OpenAI ni que le modèle backend auquel il délègue. GPT-Realtime-2.1 conserve raisonnement et outils dans un seul modèle temps réel, donc tout ce que nous disons sur la délégation s’applique uniquement à GPT-Live-1.
Quelle est la principale différence entre Gemini 3.8 Live et GPT-Live-1 ?
Nous avons donné la version courte plus haut ; voici la complète. Gemini 3.8 Live choisit les appels de fonction dans la session live, tandis que GPT-Live-1 délègue le raisonnement à un backend séparé. Dans les deux architectures, votre application exécute vos fonctions.
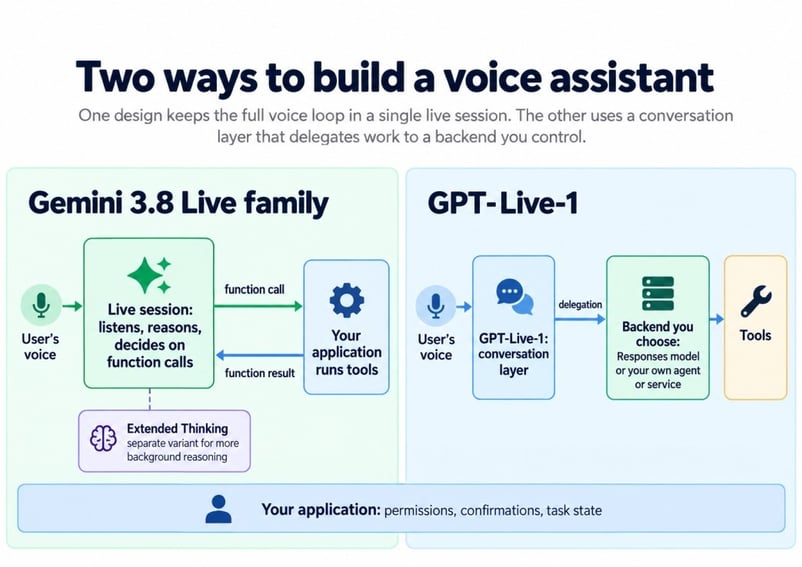
Où chaque modèle place le raisonnement. Image par l’auteur.
La suite découle de cette séparation, donc commençons par chaque approche.
Comment Gemini 3.8 Live planifie dans une seule session
Avec Gemini, il n’y a pas de second modèle à configurer. Le modèle live émet un appel de fonction quand il a besoin de données, et votre client renvoie le résultat, comme l’explique le guide de raisonnement de Google.
Passer à Extended Thinking conserve le même endpoint WebSocket et ne requiert pas de modèle backend, même si le code client change.
Comment fonctionne la délégation avec GPT-Live-1
GPT-Live-1 gère la parole et décide quand demander de l’aide ; le backend gère le raisonnement, les outils et les règles métier. Le guide de prompting d’OpenAI place toute la procédure de tâche dans les instructions du backend.
Avec la délégation Responses, OpenAI exécute un modèle que vous configurez. Avec la délégation côté client, le travail part vers n’importe quel modèle ou service exécuté par votre application. Dans les deux cas, le guide de délégation précise que votre application détient les autorisations, les enregistrements et l’état des tâches.
Pourquoi l’architecture fait la différence
La séparation ajoute des pièces : une session vocale, un backend et un état partagé entre les deux. En retour, vous pouvez changer le modèle de raisonnement sans toucher à la voix.
Ce compromis semble moins intéressant si vous n’avez pas encore de backend, mais plus avantageux si vous devez mettre à niveau un agent existant sans changer sa voix.
Comment Gemini 3.8 Live et GPT-Live-1 gèrent-ils les interruptions ?
Les deux gèrent les interruptions, mais GPT-Live-1 est conçu autour d’elles, ainsi que des pauses et des backchannels (les « mm-hmm » d’un auditeur). Gemini 3.8 Live prend en charge le barge-in, et son audio proactif est toujours actif, mais la documentation de Google ne le qualifie pas de full duplex.
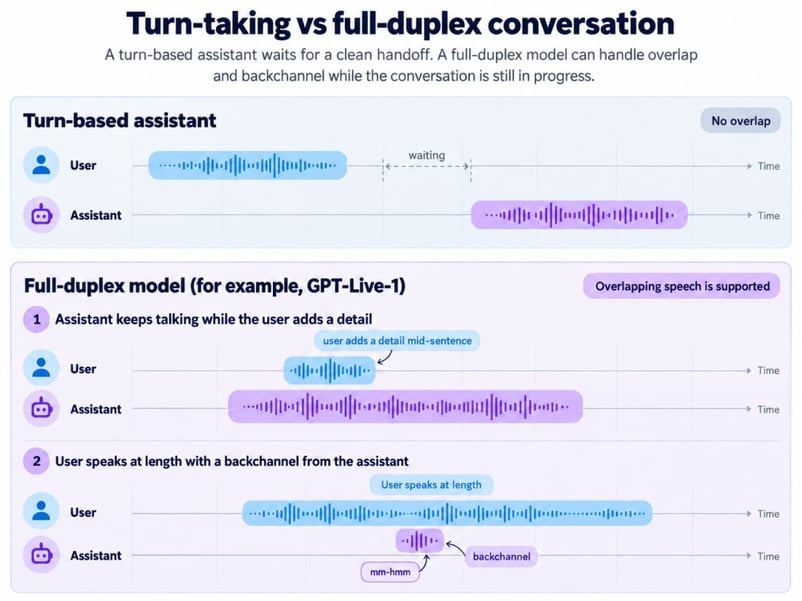
Prendre la parole à tour de rôle versus parler en même temps. Image par l’auteur.
Le billet d’OpenAI cite l’app Speak, qui affirme que GPT-Live-1 a réduit les interruptions de près de 80 % par rapport aux systèmes en tours de parole — un retour client, pas un test indépendant.
Sur Gemini, l’audio proactif permet au modèle d’ignorer les énoncés qui ne lui sont pas destinés. Notre tutoriel Gemini a constaté que le son des haut-parleurs d’un ordinateur portable capté par le micro est interprété comme une coupure de l’utilisateur, donc testez avec et sans casque.
Comment Gemini 3.8 Live et GPT-Live-1 gèrent-ils le raisonnement et les appels d’outils ?
Gemini fait évoluer le raisonnement en passant de la version Live de base à Extended Thinking. GPT-Live-1 l’augmente en changeant de backend ; comparez donc Extended Thinking avec une configuration GPT-Live-1 complète, pas avec le seul modèle vocal.
Gemini 3.8 Live vs Gemini 3.8 Live Extended Thinking
Le Gemini 3.8 Live de base n’a pas de paramètre thinking_level et accepte les fonctions BLOCKING pour l’ancien code. Extended Thinking modifie quatre comportements côté client :
-
Outils : seules les fonctions
NON_BLOCKINGfonctionnent ; un appel bloquant renvoie une erreur ferme. -
Niveaux de raisonnement : pas d’option minimale, uniquement les trois niveaux cités plus haut.
-
Fin de tour :
turnComplete: truene signifie plus que le modèle a terminé ; votre client surveilleinteraction_statusjusqu’àIDLE. -
Planification : la planification de fonctions n’est pas prise en charge.
Google recommande Extended Thinking pour les tâches multi-étapes et les outils lents. Le coût est une latence et un volume de sortie plus élevés.
Un point m’a agacé dans la doc de Google. Le billet de lancement dit que Gemini 3.8 Live peut « continuer à discuter pendant que les tâches se terminent en arrière-plan », mais le guide de raisonnement indique que le modèle de base « attend l’exécution de l’outil avant de parler ». Notre tutoriel a observé ce second comportement lors d’une requête météo, donc je vous conseille de suivre le guide jusqu’à clarification.
Quels modèles backend fonctionnent avec GPT-Live-1 ?
GPT-Live-1 peut se placer devant n’importe quel backend que vous configurez. La doc d’OpenAI cite trois backends GPT-6 :
-
GPT-6 Luna (
gpt-6-luna), point de départ recommandé par le guide de délégation -
GPT-6 Sol (
gpt-6-sol), suggestion du guide pour des tâches plus ardues -
GPT-6 Astra, recommandé dans le billet de lancement pour des cas clients complexes
Les lignes Artificial Analysis « GPT-Live-1 (Astra, medium) » et « GPT-Live-1 (Sol, low) » décrivent des configurations système, pas des versions du modèle vocal. Artificial Analysis ne précise pas la génération de Sol, et OpenAI a publié GPT-6.1 Sol après ces tests.
Que se passe-t-il si l’appelant change de demande en cours de tâche
Imaginons qu’un appelant demande de déplacer une réservation au vendredi, puis corrige en disant « finalement, jeudi » pendant la recherche. Seule la seconde demande fait foi.
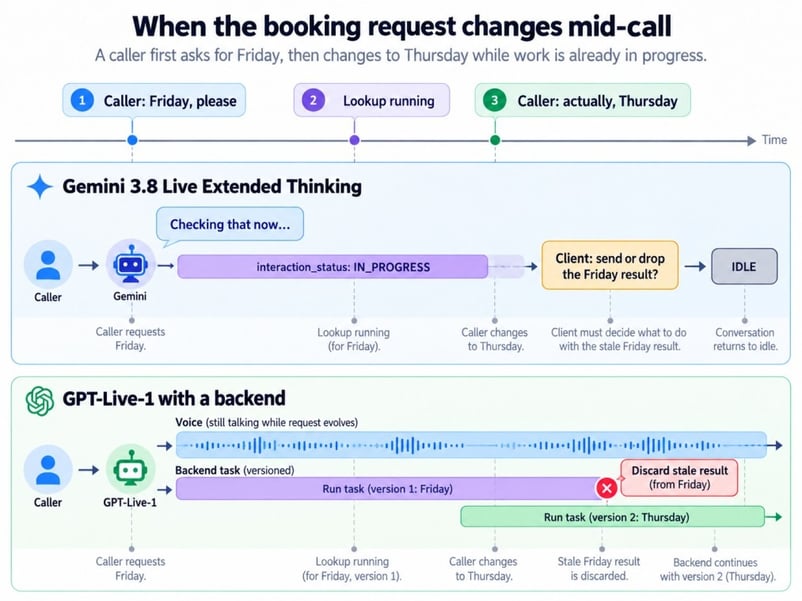
Une demande modifiée pendant un traitement lent. Image par l’auteur.
Avec GPT-Live-1, interrompre la voix n’annule pas le travail backend. La délégation Responses peut encore renvoyer l’ancien résultat à la voix, tandis que la délégation client permet à votre code de l’écarter au préalable.
Avec Gemini, votre client peut ignorer le résultat d’outil périmé. Dans tous les cas, c’est votre application qui décide de la tâche courante.
Les modèles prennent-ils en charge images et vidéo ?
Gemini 3.8 Live accepte nativement images et vidéo ; GPT-Live-1 indique que les deux ne sont pas pris en charge. Une app GPT-Live-1 peut tout de même envoyer une photo à un backend vision séparé, mais elle ne peut pas regarder un flux caméra en direct.
Avec Gemini, les trames entrent dans la même session que l’audio, donc le modèle peut répondre « est-ce le bon câble ? » pendant que l’utilisateur le montre. Deux contreparties : l’envoi de trames vidéo est actif par défaut, et le guide des sessions de Google limite à 2 minutes les sessions audio+vidéo, contre 15 minutes en audio seul, sauf si vous activez la compression de la fenêtre de contexte.
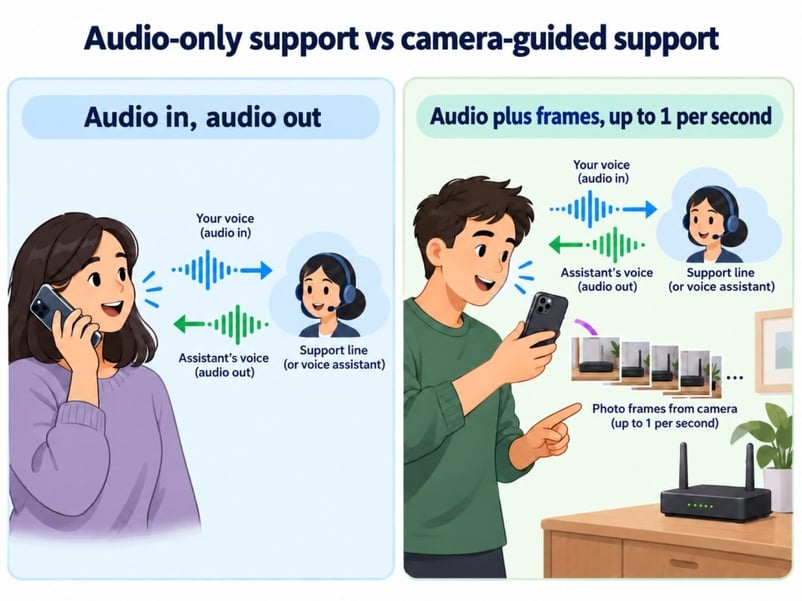
Appels téléphoniques versus sessions d’assistance par caméra. Image par l’auteur.
Une ligne de réservation ne voit jamais d’image, et les classements vocaux ci-dessous ne mesurent pas la vision.
Benchmarks : Gemini 3.8 Live vs GPT-Live-1
Aucun benchmark unique ne tranche la comparaison. Parmi les quatre configurations testées, Astra mène l’indice principal, Sol domine la dynamique conversationnelle et le Gemini de base a l’Elo Arena le plus élevé des quatre.
D’abord, comment fonctionne l’indice principal, car cela explique l’essentiel des écarts.
Comment fonctionne l’index Speech to Speech d’Artificial Analysis
L’indice pondère à parts égales quatre compétences :
- Big Bench Audio : questions de raisonnement posées à l’oral
- τ-Voice : tâches de service client multi-étapes, comme modifier un vol
- Score Arena : votes humains à l’aveugle sur l’agent préféré
- Taux de réussite : fréquence à laquelle la conversation aboutit au bon appel d’outil final
La dynamique conversationnelle est rapportée séparément selon la méthodologie v2.0.
Voici les quatre configurations pertinentes ici.
|
Configuration |
Indice |
Big Bench Audio |
τ-Voice |
Dynamique conversationnelle |
Arena Elo |
Réussite des tâches |
TTFA |
|
GPT-Live-1 (Astra, medium) |
83.2 |
90.1% |
74.5% |
94.9% |
1027 |
87.4% |
1.34 s |
|
Gemini 3.8 Live Extended Thinking (High) |
82.6 |
97.7% |
68.6% |
91.9% |
966 |
89.1% |
1.35 s |
|
GPT-Live-1 (Sol, low) |
80.1 |
89.0% |
59.3% |
97.3% |
1037 |
90.9% |
1.24 s |
|
Gemini 3.8 Live |
74.5 |
91.7% |
30.1% |
96.1% |
1074 |
93.2% |
1.18 s |
Les scores τ-Voice de GPT-Live-1 proviennent d’un seul essai ; manipulez-les avec prudence.
Tâches d’agent vs préférence humaine
Sur τ-Voice, Astra atteint 74,5 %, Extended Thinking 68,6 % et le Gemini de base 30,1 %. Le raisonnement supplémentaire pèse dès que les outils s’enchaînent.
Côté conversation, l’histoire est différente : Sol obtient le meilleur score, et les intervalles de confiance Arena de Gemini base et Sol se recouvrent.
L’écart de 0,6 point entre Astra et Extended Thinking n’a pas d’intervalle de confiance publié. Ils ont déjà échangé leurs places, donc nous parlerions encore d’égalité.
Quel modèle répond le plus vite ?
Le Gemini 3.8 Live de base a le meilleur temps jusqu’au premier audio (TTFA) du tableau, mais l’écart entre les quatre reste sous 0,2 seconde. Le TTFA mesure le temps nécessaire pour produire le premier token audio.
Le TTFA ne mesure ni la réponse à une interruption, ni le temps pour terminer une réservation ou une recherche — qui dépendent surtout de votre backend et de vos outils.
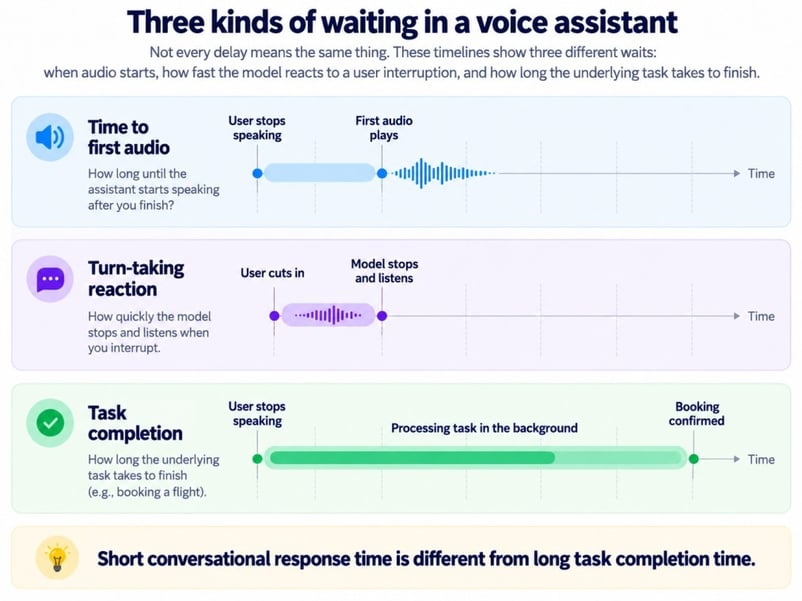
Trois types d’attente dans la voix. Image par l’auteur.
Extended Thinking comme GPT-Live-1 peuvent continuer à parler durant une recherche lente. L’appelant attend toujours la réservation.
Ce que les benchmarks vocaux ne mesurent pas
Pour une ligne support, les classements ne vous diront pas :
- si votre opérateur téléphonique et votre codec transportent proprement la voix
- si l’agent suit encore votre script au bout de dix minutes
- comment il comprend un fort accent dans une rue bruyante
- combien coûte l’appel une fois le backend et les outils inclus
Un pilote avec vos propres enregistrements répondra mieux à ces questions.
Tarifs : lequel est le moins cher, Gemini 3.8 Live ou GPT-Live-1 ?
Gemini de base est le moins cher d’après les tests d’Artificial Analysis, mais les modèles ne facturent pas les mêmes éléments. Le coût par tâche réussie compte plus que le prix affiché.
Les tarifs ci-dessous sont les prix catalogue sur la page de tarification de Google et la page modèle GPT-Live-1 au moment d’écrire ces lignes, et les valeurs par minute de Gemini sont les conversions de Google à partir des prix par token.
|
Élément de coût |
Gemini 3.8 Live et Extended Thinking (offre payante) |
GPT-Live-1 |
|
Entrée audio |
3,00 $ par 1 M de tokens (env. 0,005 $/min) |
Inclus dans 0,05 $ par minute, facturé à la seconde |
|
Sortie audio |
12,00 $ par 1 M de tokens (env. 0,018 $/min) |
Inclus dans les frais de session |
|
Entrée image ou vidéo |
1,00 $ par 1 M de tokens (env. 0,002 $/min) |
Non pris en charge |
|
Raisonnement |
Tokens de raisonnement facturés au tarif de sortie |
Tokens du modèle backend au prix de ce modèle |
|
Recherche et outils |
5 000 requêtes Search gratuites par mois, puis 14 $ par 1 000 |
Facturés par le modèle backend et les outils utilisés |
Les tokens de raisonnement rendent Extended Thinking plus cher que Gemini de base. Artificial Analysis estime 0,84 $ par heure d’audio entrant pour Gemini base, 3,50 $ pour Extended Thinking, 4,47 $ pour Sol et 5,83 $ pour Astra, hors outils et remises de cache. Gemini Live ne prend pas en charge la mise en cache ; un backend GPT-Live-1 le peut.
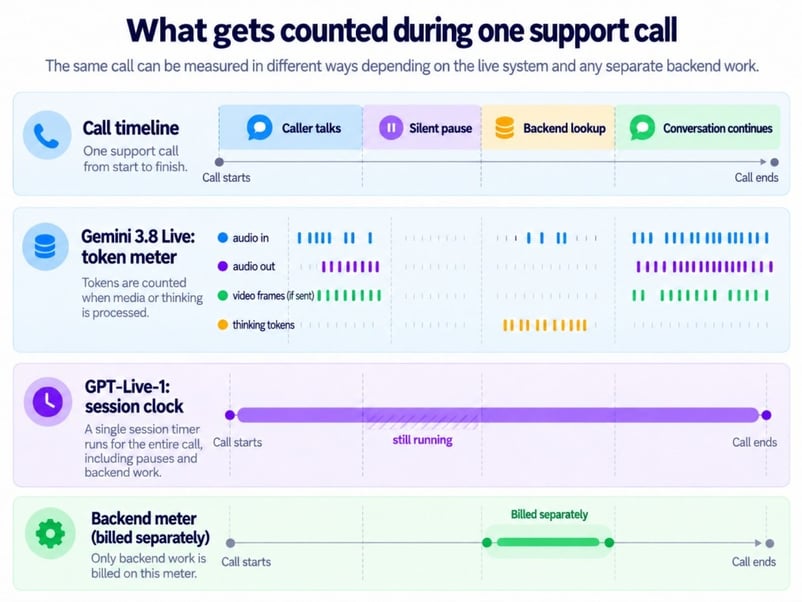
Ce que chaque compteur additionne pendant les appels. Image par l’auteur.
L’horloge de GPT-Live-1 tourne pendant le silence, et couper le micro ne l’arrête pas. Additionnez les lignes du tableau et les coûts télécom, puis divisez par les tâches menées à terme.
Navigateurs, serveurs et téléphonie : prise en charge dans Gemini 3.8 Live et GPT-Live-1
Les apps web et serveur peuvent se connecter à l’un ou l’autre modèle, mais le déploiement téléphonique les distingue. Le schéma montre les options de connexion ; les différences opérationnelles portent sur la durée des connexions et l’acteur présent dans le chemin d’appel.
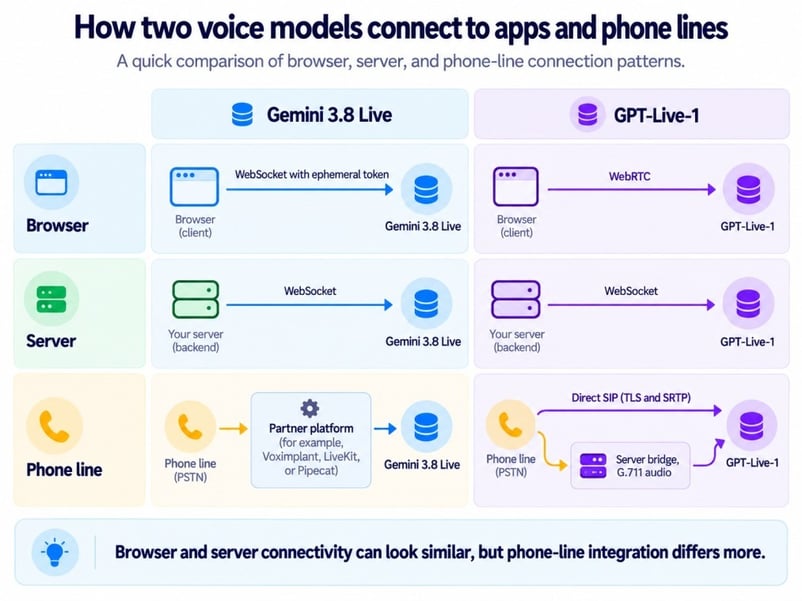
Chemins de connexion navigateur, serveur et téléphone. Image par l’auteur.
Les connexions Gemini se réinitialisent au bout d’environ 10 minutes, donc les appels plus longs nécessitent une reprise de session. Avec GPT-Live-1, journalisez séparément la connexion vocale et le travail délégué au backend.
Appels téléphoniques et support SIP
Le SIP direct retire un fournisseur du chemin d’appel GPT-Live-1. La route via partenaires de Gemini ajoute un service à configurer, superviser et déboguer.
Quelques développeurs sur le forum d’OpenAI signalent que GPT-Live-1 promet une action sans créer de délégation. Le support d’OpenAI n’a pas parlé de bug ; il renvoie au guide de prompting, qui précise qu’un acquittement oral ne confirme pas le démarrage d’un travail backend. Je vous recommande de journaliser distinctement les événements de délégation et la parole.
Depuis le 2 novembre, OpenAI prend aussi en charge les appels sortants SIP pour toutes les organisations, de sorte que GPT-Live-1 peut émettre et recevoir des appels.
Gemini 3.8 Live vs GPT-Live-1 : lequel choisir ?
Le choix tient à deux questions : l’assistant doit-il voir, et avez-vous déjà un backend ? Un oui à la première oriente vers Gemini ; un oui à la seconde oriente vers GPT-Live-1.
Passez directement au scénario correspondant à votre produit.
Support téléphonique et réservations
Une ligne téléphonique a besoin de gérer l’interruption et de confirmer avant toute action irréversible. GPT-Live-1 s’y prête bien, avec le SIP vu plus haut et une logique de réservation conservée dans le backend.
Dépannage via caméra et écran
Quand un utilisateur pointe un routeur à la caméra, le modèle doit raisonner sur ce qu’il voit à l’instant T. Gemini 3.8 Live le fait dans une seule session, sans composant vision séparé, à condition d’anticiper la limite de 2 minutes évoquée plus haut.
Travail multi-étapes en arrière-plan
Pour les tâches qui enchaînent des outils, comparez Extended Thinking à GPT-Live-1 + Astra. Astra mène τ-Voice sur un essai, donc le choix revient encore à décider où vivra le raisonnement.
Ajouter la voix à un agent que vous exploitez déjà
La délégation côté client permet d’ajouter GPT-Live-1 à un agent existant sans réécrire sa boucle de raisonnement. Avec Gemini, le modèle live devient le planificateur.
Fort volume d’appels avec budget serré
Des appels courts et simples orientent vers Gemini de base, la configuration la plus économique dans le test Artificial Analysis. Des outils multi-étapes changent l’équation.
Conclusion
La meilleure façon de cadrer cette comparaison : Gemini 3.8 Live réunit vision, raisonnement et parole dans un seul modèle, tandis que GPT-Live-1 sépare la voix de l’intelligence qui la pilote. Aucun ne domine, et leurs performances en naturel de la voix et en réactivité sont assez proches pour que l’architecture dicte la plupart des décisions réelles.
Ce qui m’intéresse le plus est la rapidité avec laquelle l’avantage sur les tâches d’agent a penché vers GPT-Live-1 avec Astra. Ce score appartient à tout le système, pas seulement au modèle vocal — un argument en faveur de la délégation, même si un seul essai reste un signal, pas un verdict.
Autre point à suivre : la gamme backend d’OpenAI, puisque GPT-6.1 Sol est arrivé fin septembre 2026. Chaque nouveau backend peut faire évoluer les scores de GPT-Live-1 sans toucher la voix, tandis que l’équivalent chez Google impliquerait de changer de modèle live.
À ce stade, Gemini 3.8 Live est le choix le plus simple pour tout ce qui implique une caméra, et GPT-Live-1 le plus simple pour les produits téléphoniques avec backend en place. Dans tous les cas, votre code devra gérer le problème de la réservation du vendredi passée au jeudi.
Pour les concepts d’agent derrière ces deux voies, notre cours Introduction to AI Agents couvre les outils, la mémoire et la planification.
FAQ
GPT-Live-1 peut-il utiliser un modèle Gemini comme backend ?
Oui. La délégation côté client peut envoyer le travail à un modèle texte Gemini derrière votre propre backend. Vous paierez OpenAI pour les minutes de voix et Google pour les tokens backend.
Combien de temps une conversation GPT-Live-1 reste-t-elle dans le contexte ?
GPT-Live-1 dispose d’une fenêtre de contexte de 128 000 tokens qui comptabilise les tokens audio, pas seulement la transcription. Au-delà de 90 % d’usage, il lance un moteur vocal de remplacement qui transporte jusqu’à 8 192 tokens d’historique récent et des résumés ; conservez donc actions confirmées et état des tâches dans votre propre application.
Quelles limites de débit s’appliquent à Gemini 3.8 Live et GPT-Live-1 ?
GPT-Live-1 autorise 50 sessions simultanées sur Build, 300 sur Launch et 500 sur Grow, sans palier gratuit. Google ne publie pas de limites spécifiques à Live et vous renvoie à Google AI Studio pour connaître les limites actuelles de votre projet.
Puis-je réutiliser le code de mon application vocale existante ?
Surtout côté Gemini, moins côté OpenAI. Le code écrit pour Gemini 3.1 Flash Live nécessite principalement la nouvelle chaîne de modèle, en retirant tout paramètre thinking_level que gemini-3.8-live n’accepte pas. Supprimez aussi enable_affective_dialog et proactive_audio: false si votre code les a conservés d’anciens modèles. GPT-Live-1 utilise son propre endpoint v1/live/sessions au lieu de v1/realtime, donc une app Realtime API nécessite une refonte, et OpenAI publie un guide de migration.
L’audio de Gemini 3.8 Live est-il filigrané ?
Oui. Google indique que tout audio généré par ses produits IA, y compris les deux modèles Gemini 3.8 Live, porte un filigrane SynthID inaudible pour l’auditeur, utile si vous devez prouver qu’un appelant a entendu une voix de synthèse.

Je suis ingénieur de données et créateur de communautés. Je travaille sur les pipelines de données, le cloud et les outils d'IA, tout en rédigeant des tutoriels pratiques et percutants pour DataCamp et les développeurs émergents.







Les anciens assistants vocaux fonctionnaient en tours de parole : vous parlez, vous attendez, puis ils répondent. Gemini 3.8 Live de Google et GPT-Live-1 d’OpenAI sont des agents vocaux en temps réel capables de gérer les interruptions et les changements en cours de phrase. Aucun ne surpasse l’autre sur tous les critères.
La différence tient à l’endroit où se fait le raisonnement. Gemini 3.8 Live vous écoute, peut analyser le flux caméra, raisonne et décide quand demander à votre application d’agir. GPT-Live-1 se concentre sur la conversation et peut écouter tout en parlant. Lorsqu’il a besoin d’un raisonnement plus poussé ou d’une action, GPT-Live-1 délègue le travail à un second modèle ou service appelé le backend.
OpenAI a ajouté GPT-Live-1 à son API en septembre, et Google a lancé Gemini 3.8 Live moins d’une semaine plus tard. Notre aperçu de Gemini 3.8 Live couvre l’annonce de Google. Si vous souhaitez développer avec l’un ou l’autre, notre tutoriel Gemini 3.8 Live et notre tutoriel API GPT-Live-1 détaillent la mise en route.
En bref
Peu de temps devant vous ? Voici la comparaison en six points :
Un besoin caméra ou un backend déjà en place peut trancher avant même de regarder le classement. Le tableau ci-dessous explique pourquoi.