
Gemini 3.8 Live vs. GPT-Live-1 em um relance
O que a tabela abaixo não mostra é que, nos dois casos, seu próprio app ainda faz o trabalho de fato, como rodar suas funções e manter o histórico do que o usuário pediu.
|
Ponto de comparação |
Gemini 3.8 Live |
GPT-Live-1 |
|
Papel |
Um único modelo que ouve, vê, raciocina e pede ações ao seu app |
Modelo de voz que conversa e repassa o trabalho mais pesado a um backend |
|
IDs de modelo |
|
|
|
Entradas nativas |
Texto, áudio, imagens, frames de vídeo |
Apenas texto e áudio |
|
Onde roda o raciocínio mais profundo |
Dentro do modelo, com mais intensidade no Extended Thinking |
Em um backend à sua escolha |
|
Quem executa suas funções |
Sua aplicação (Search grounding roda no lado do Google) |
Sua aplicação; ferramentas hospedadas como busca na web rodam no backend |
|
Unidade de cobrança |
Tokens, incluindo tokens de raciocínio |
Minutos de sessão conectada, mais uso do backend |
|
Camada gratuita |
Sim |
Não |
O que são o Gemini 3.8 Live e o GPT-Live-1?
Ambos são modelos de fala para fala: o áudio entra e o áudio sai, sem etapa separada de transcrição.
O que é o Gemini 3.8 Live?
O Gemini 3.8 Live é o modelo de diálogo ao vivo e baixa latência do Google. Ele aceita texto, imagens, áudio e vídeo, raciocina entre turnos e chama funções de forma assíncrona. As duas variantes do Gemini listam um limite de entrada de 131.072 tokens em suas páginas de modelo.
O Gemini 3.8 Live Extended Thinking é um modelo separado, não uma configuração. Ele adiciona raciocínio em segundo plano em nível baixo, médio ou alto, enquanto narra o andamento.
As notas de versão do Google listam ambos os IDs como disponíveis de forma geral, enquanto o guia de capacidades da Live API ainda marca a API como prévia.
O que é o GPT-Live-1?
O GPT-Live-1 é o modelo de voz full duplex da OpenAI. Full duplex é o termo técnico para o comportamento de “ouvir enquanto fala” descrito na introdução.
A OpenAI chama o repasse ao backend de delegation. A voz consegue continuar falando enquanto esse trabalho roda.
O GPT-Live-1 também não é o mesmo produto da linha GPT-Realtime-2 da OpenAI nem do modelo de backend para o qual delega. O GPT-Realtime-2.1 mantém raciocínio e ferramentas dentro de um único modelo em tempo real, então tudo que eu digo sobre delegation vale apenas para o GPT-Live-1.
Qual é a principal diferença entre o Gemini 3.8 Live e o GPT-Live-1?
O TL;DR deu a versão curta; aqui vai a completa. O Gemini 3.8 Live escolhe chamadas de função dentro da sessão ao vivo, enquanto o GPT-Live-1 repassa o raciocínio a um backend separado. Em ambos os designs, sua aplicação executa suas próprias funções.
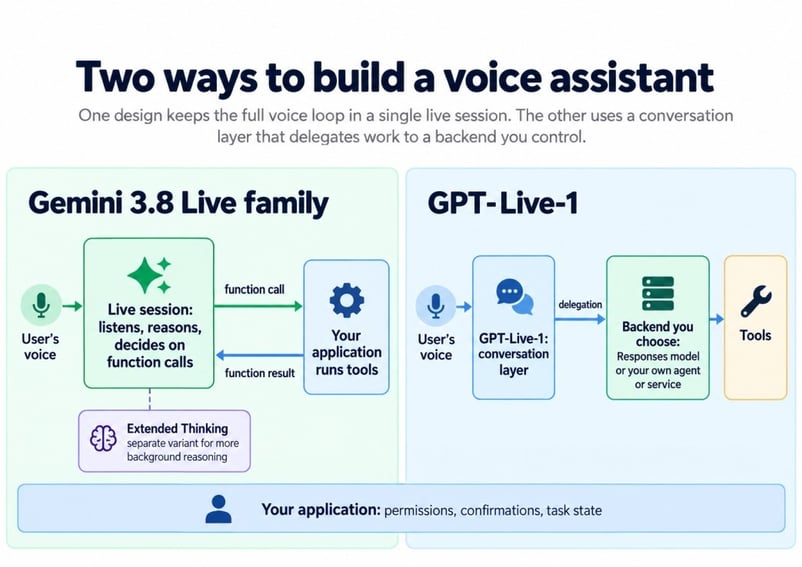
Onde cada modelo coloca o raciocínio. Imagem do autor.
A maior parte do que vem a seguir se explica por essa divisão, então vamos a cada lado primeiro.
Como o Gemini 3.8 Live planeja dentro de uma única sessão
Com o Gemini, não há um segundo modelo para configurar. O modelo ao vivo emite uma chamada de função quando precisa de dados, e seu cliente retorna o resultado, como descreve o guia de thinking do Google.
Migrar para o Extended Thinking mantém o mesmo endpoint WebSocket e não exige modelo de backend, embora o código do cliente mude.
Como funciona a delegação no GPT-Live-1
O GPT-Live-1 cuida da fala e decide quando pedir ajuda; o backend cuida do raciocínio, das ferramentas e das regras de negócio. O guia de prompting da OpenAI coloca todo o procedimento da tarefa nas instruções do backend.
Com Responses delegation, a OpenAI roda um modelo que você configura. Com client delegation, o trabalho vai para qualquer modelo ou serviço que sua aplicação execute. Em ambos os casos, o guia de delegation diz que sua aplicação mantém permissões, registros e estado da tarefa.
Por que a diferença de arquitetura importa
O preço da divisão são mais peças: uma sessão de voz, um backend e um estado compartilhado entre eles. Em troca, você pode trocar o modelo de raciocínio sem mexer na voz.
Essa troca parece pior se você ainda não tem backend, mas melhor se precisa atualizar um agente existente sem mudar a voz.
Como o Gemini 3.8 Live e o GPT-Live-1 lidam com interrupções?
Ambos lidam com interrupções, mas o GPT-Live-1 é construído em torno delas, junto com pausas e backchannels (o “hum-hum” de quem está ouvindo). O Gemini 3.8 Live suporta barge-in, e o áudio proativo fica sempre ligado, mas a documentação do Google não chama isso de full duplex.
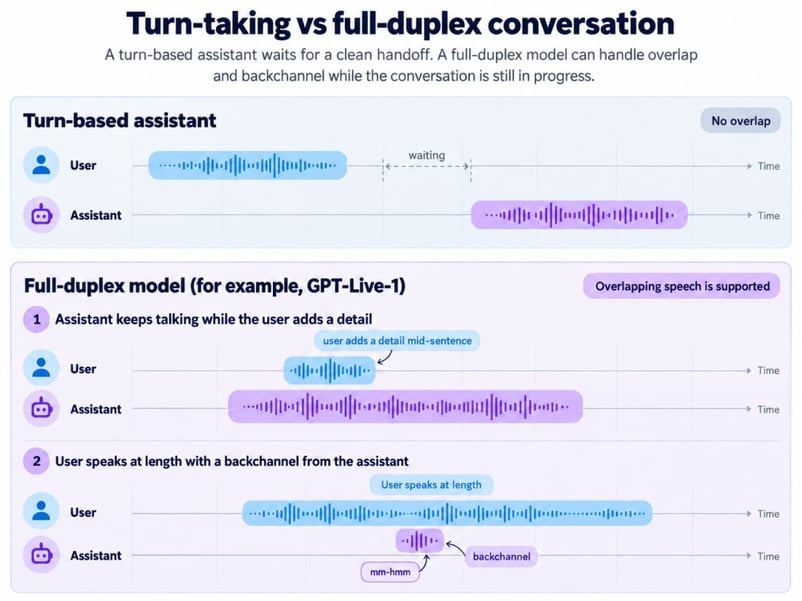
Revezar turnos versus falar ao mesmo tempo. Imagem do autor.
O post de lançamento da OpenAI cita o app de idiomas Speak dizendo que o GPT-Live-1 reduziu interrupções em quase 80% em relação a sistemas por turnos — um relato de cliente, não um teste independente.
No Gemini, o áudio proativo permite que o modelo ignore fala que não é para ele. Nosso tutorial do Gemini notou que o áudio do alto-falante do laptop vazando no microfone conta como interrupção do usuário — então teste com e sem fones.
Como o Gemini 3.8 Live e o GPT-Live-1 tratam raciocínio e chamadas de ferramentas?
O Gemini escala o raciocínio alternando do Live base para o Extended Thinking. O GPT-Live-1 escala mudando o backend, então compare o Extended Thinking com um setup completo do GPT-Live-1, não só o modelo de voz.
Gemini 3.8 Live vs. Gemini 3.8 Live Extended Thinking
O Gemini 3.8 Live base não tem a configuração thinking_level e aceita funções BLOCKING para código mais antigo. O Extended Thinking muda quatro comportamentos do cliente:
-
Ferramentas: só funções
NON_BLOCKINGfuncionam; uma função blocking retorna erro fatal. -
Níveis de thinking: não há opção mínima, apenas os três níveis acima.
-
Fim do turno:
turnComplete: truenão significa mais que o modelo terminou; seu cliente monitorainteraction_statusaté lerIDLE. -
Agendamento: agendamento de funções não é suportado.
O Google recomenda Extended Thinking para tarefas em múltiplas etapas e ferramentas lentas. Isso custa mais latência e mais tokens de saída.
Uma coisa me incomodou na documentação do Google. O post de lançamento diz que o Gemini 3.8 Live pode “continuar conversando enquanto tarefas terminam em segundo plano”, mas o guia de thinking diz que o modelo base “espera a execução da ferramenta antes de falar”. Nosso tutorial do Gemini viu o segundo comportamento durante uma consulta de clima, então eu planejava com base no guia até o Google esclarecer.
Quais modelos de backend funcionam com o GPT-Live-1?
O GPT-Live-1 pode ficar na frente de qualquer backend que você configurar. A documentação da OpenAI aponta três backends GPT-6:
-
GPT-6 Luna (
gpt-6-luna), ponto de partida sugerido pelo guia de delegation -
GPT-6 Sol (
gpt-6-sol), sugestão do guia para tarefas mais difíceis -
GPT-6 Astra, recomendado no post de lançamento para casos complexos de atendimento
As linhas do Artificial Analysis “GPT-Live-1 (Astra, medium)” e “GPT-Live-1 (Sol, low)” são configurações de sistema, não versões do modelo de voz. O Artificial Analysis não informa a geração do Sol, e a OpenAI lançou o GPT-6.1 Sol depois que esses testes rodaram.
O que acontece quando o usuário muda o pedido no meio da tarefa
Suponha que a pessoa peça para mover uma reserva para sexta e, enquanto a consulta roda, diga “na verdade, quinta”. Só o segundo pedido vale.
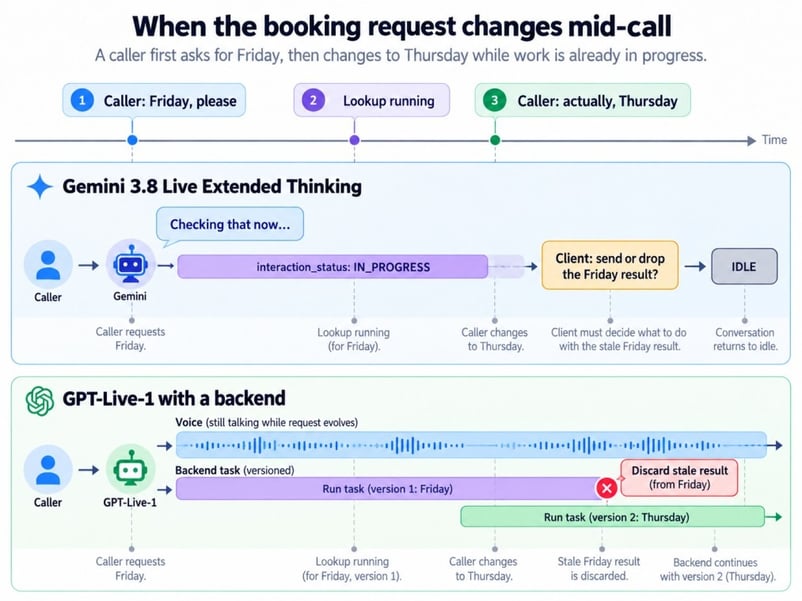
Um pedido alterado durante um processo lento. Imagem do autor.
No GPT-Live-1, interromper a voz não cancela o trabalho do backend. A Responses delegation ainda pode retornar o resultado antigo para a voz, enquanto a client delegation deixa seu código descartá-lo antes.
No Gemini, seu cliente pode descartar o resultado de ferramenta obsoleto. De todo modo, sua aplicação decide qual é a tarefa atual.
Gemini 3.8 Live e GPT-Live-1 suportam imagens e vídeo?
O Gemini 3.8 Live aceita imagens e vídeo de forma nativa; o GPT-Live-1 lista ambos como não suportados. Um app com GPT-Live-1 ainda pode enviar uma foto a um backend de visão separado, mas ele não consegue assistir a uma câmera ao vivo.
No Gemini, os frames entram na mesma sessão do áudio, então o modelo pode responder “esse é o cabo certo?” enquanto o usuário o mostra. Isso tem dois custos. Frames de vídeo são enviados por padrão, e o guia de sessão do Google limita sessões com áudio e vídeo a 2 minutos (contra 15 só com áudio), a menos que você ative compressão de janela de contexto.
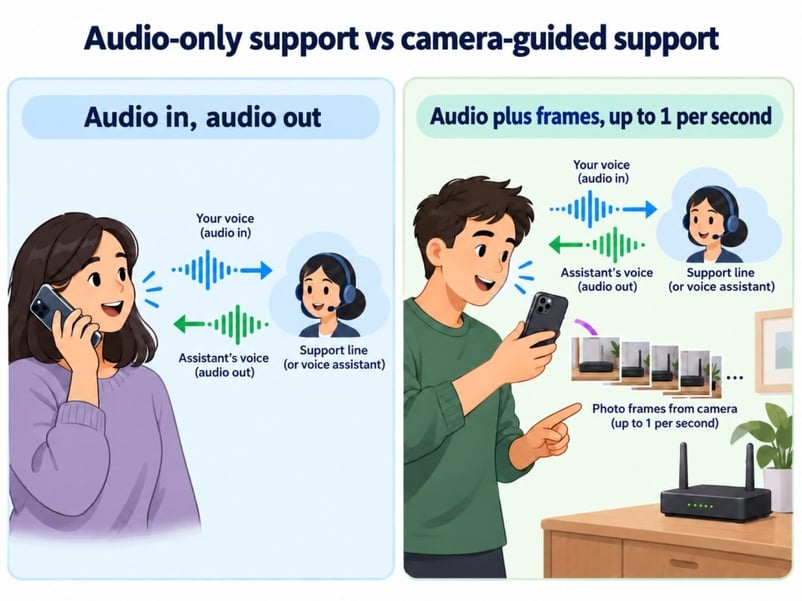
Atendimento por telefone versus sessão de reparo com câmera. Imagem do autor.
Uma central de reservas nunca vê um frame, e os rankings de fala abaixo não medem visão.
Benchmarks: Gemini 3.8 Live vs. GPT-Live-1
Não há um único benchmark que encerre a comparação. Entre as quatro configurações dos dois modelos, o Astra lidera o índice principal, o Sol lidera dinâmica conversacional, e o Gemini base tem o maior Arena Elo entre as quatro.
Antes, como funciona o índice principal — isso explica a maioria das diferenças.
Como funciona o Artificial Analysis Speech to Speech Index
O índice dá peso igual a quatro habilidades diferentes:
- Big Bench Audio: perguntas de raciocínio feitas em voz alta
- τ-Voice: tarefas de atendimento em múltiplas etapas, como mudar um voo
- Pontuação Arena: votos humanos cegos sobre qual agente as pessoas preferiram
- Taxa de sucesso de tarefas: com que frequência a conversa terminou com a chamada de ferramenta correta
A dinâmica conversacional é reportada separadamente sob a metodologia v2.0.
Aqui estão as quatro configurações que importam aqui.
|
Configuração |
Índice |
Big Bench Audio |
τ-Voice |
Dinâmica conversacional |
Arena Elo |
Sucesso de tarefa |
TTFA |
|
GPT-Live-1 (Astra, medium) |
83.2 |
90,1% |
74,5% |
94,9% |
1027 |
87,4% |
1,34 s |
|
Gemini 3.8 Live Extended Thinking (High) |
82.6 |
97,7% |
68,6% |
91,9% |
966 |
89,1% |
1,35 s |
|
GPT-Live-1 (Sol, low) |
80.1 |
89,0% |
59,3% |
97,3% |
1037 |
90,9% |
1,24 s |
|
Gemini 3.8 Live |
74.5 |
91,7% |
30,1% |
96,1% |
1074 |
93,2% |
1,18 s |
Ambas as pontuações τ-Voice do GPT-Live-1 vêm de um único ensaio, então encare com cautela.
Tarefas de agente vs. preferência humana
No τ-Voice, o Astra marca 74,5%, o Extended Thinking 68,6% e o Gemini base 30,1%. Raciocínio extra faz diferença quando há encadeamento de ferramentas.
Na conversa, a história muda: o Sol pontua mais alto, e os intervalos de confiança do Arena para o Gemini base e o Sol se sobrepõem.
A diferença de 0,6 ponto no índice entre Astra e Extended Thinking não tem intervalo de confiança publicado. Eles já trocaram de posição uma vez; eu ainda chamaria de empate técnico.
Qual modelo responde mais rápido?
O Gemini 3.8 Live base tem o menor tempo até o primeiro áudio (TTFA) da tabela, mas a diferença entre os quatro fica abaixo de 0,2 segundo. TTFA é quanto tempo o modelo leva para gerar seu primeiro token de áudio.
O TTFA não mede resposta a interrupções nem o tempo para concluir uma reserva ou consulta. Isso depende mais do seu backend e das ferramentas.
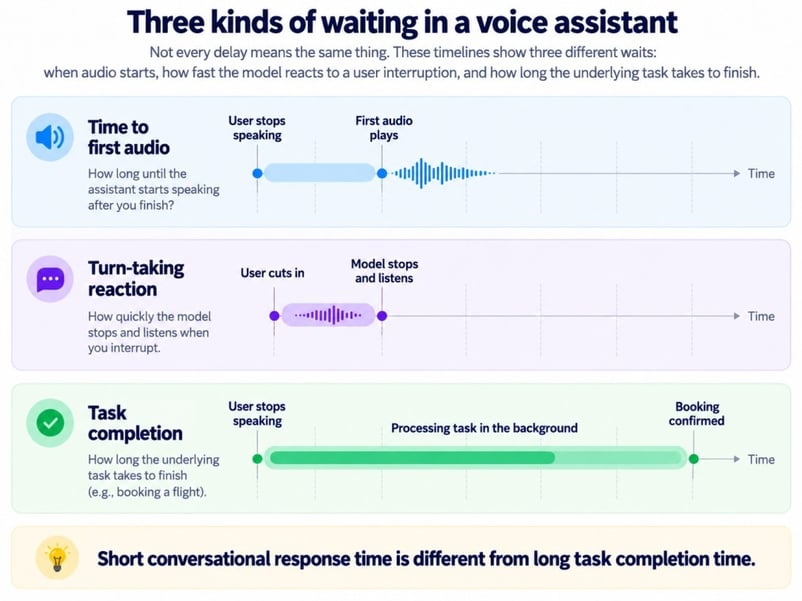
Três tipos de espera na voz. Imagem do autor.
Tanto o Extended Thinking quanto o GPT-Live-1 conseguem continuar falando durante uma consulta lenta. A pessoa ainda está esperando a reserva.
O que os benchmarks de voz não medem
Para uma central de suporte, os rankings não dirão:
- se seu provedor de telefonia e codec entregam áudio limpo
- se o agente segue seu script após dez minutos de chamada
- como ele entende um sotaque forte em uma rua barulhenta
- quanto a chamada custou depois de somar backend e ferramentas
Um piloto com suas próprias gravações responde melhor a essas questões.
Preços: Gemini 3.8 Live vs. GPT-Live-1 — qual é mais barato?
O Gemini base é o mais barato no teste do Artificial Analysis, mas os modelos cobram por coisas diferentes. Custo por tarefa concluída importa mais do que o preço de tabela.
As tarifas abaixo são os preços de lista nas páginas de preços do Google e do modelo GPT-Live-1 no momento em que escrevo; os valores por minuto do Gemini são as conversões do Google a partir de tokens.
|
Item de custo |
Gemini 3.8 Live e Extended Thinking (camada paga) |
GPT-Live-1 |
|
Áudio de entrada |
US$ 3,00 por 1M tokens (cerca de US$ 0,005/min) |
Coberto por US$ 0,05 por minuto, com cobrança por segundo |
|
Áudio de saída |
US$ 12,00 por 1M tokens (cerca de US$ 0,018/min) |
Coberto pela mesma taxa de sessão |
|
Entrada de imagem ou vídeo |
US$ 1,00 por 1M tokens (cerca de US$ 0,002/min) |
Não suportado |
|
Raciocínio |
Tokens de thinking cobrados como saída |
Tokens do modelo de backend ao preço do modelo |
|
Busca e ferramentas |
5.000 solicitações de Search grátis por mês; depois, US$ 14 por 1.000 |
Cobrados pelo modelo de backend e ferramentas que você usar |
Tokens de thinking deixam o Extended Thinking mais caro que o Gemini base. O Artificial Analysis estima US$ 0,84 por hora de áudio de entrada para o Gemini base, US$ 3,50 para o Extended Thinking, US$ 4,47 para o Sol e US$ 5,83 para o Astra, excluindo ferramentas e descontos de cache. O Gemini Live não suporta caching; um backend do GPT-Live-1 pode suportar.
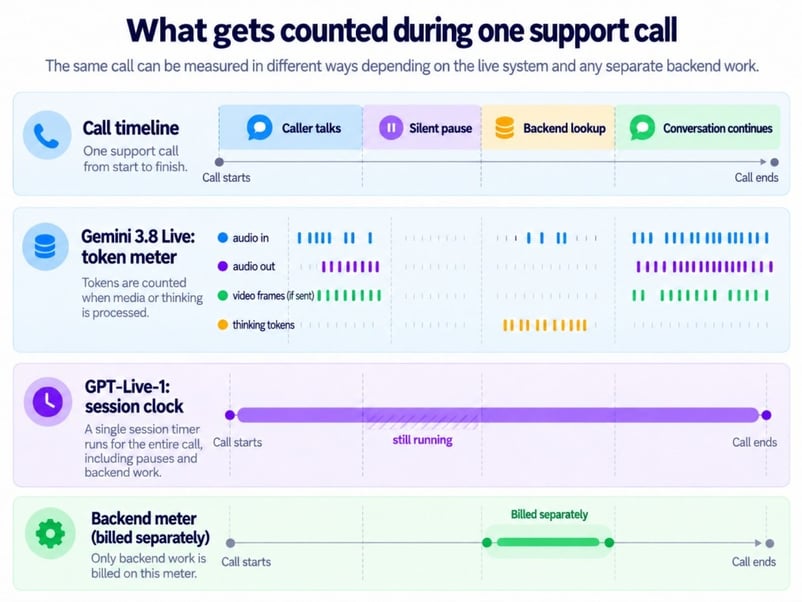
O que cada medidor contabiliza nas chamadas. Imagem do autor.
O relógio do GPT-Live-1 corre até no silêncio, e mutar não para a contagem. Some as cobranças da tabela e os custos telefônicos, depois divida por tarefas concluídas.
Navegador, servidor e telefone: suporte no Gemini 3.8 Live e no GPT-Live-1
Apps de navegador e servidor podem conectar a ambos, mas a implantação por telefone os separa. O diagrama mostra as opções de conexão; as diferenças operacionais são o tempo de vida da conexão e quem fica no caminho da chamada.
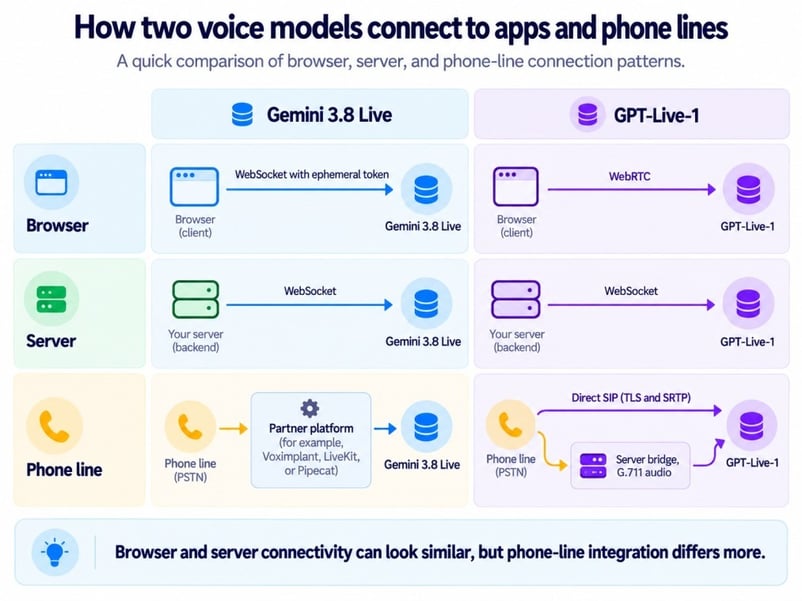
Caminhos de conexão no navegador, servidor e telefone. Imagem do autor.
Conexões do Gemini se reiniciam após cerca de 10 minutos; chamadas mais longas precisam de retomada de sessão. No GPT-Live-1, registre a conexão de voz e o trabalho delegado do backend separadamente.
Ligações e suporte a SIP
SIP direto remove um fornecedor do caminho da chamada no GPT-Live-1. A rota por parceiros do Gemini adiciona outro serviço para configurar, monitorar e depurar.
Alguns desenvolvedores no fórum da OpenAI relatam que o GPT-Live-1 promete uma ação sem criar a delegação. O suporte da OpenAI não chamou de bug; apontou o guia de prompting, que observa que um reconhecimento falado não confirma que o trabalho do backend começou. Eu registraria eventos de delegação separadamente da fala.
Desde 2 de novembro, a OpenAI também suporta chamadas SIP de saída para todas as organizações, então o GPT-Live-1 pode fazer ligações além de atendê-las.
Gemini 3.8 Live vs. GPT-Live-1: qual usar?
A escolha se resume a duas perguntas: o assistente precisa ver? E você já tem um backend? Um “sim” para a primeira aponta para o Gemini; um “sim” para a segunda aponta para o GPT-Live-1.
Vá direto ao cenário abaixo que combina com o seu produto.
Suporte telefônico e reservas
Uma linha telefônica precisa lidar com interrupções e confirmações antes de algo irreversível. O GPT-Live-1 se encaixa bem, com o SIP coberto acima e a lógica de reserva mantida no backend.
Troubleshooting por câmera e tela
Quando o usuário aponta o celular para um roteador, o modelo precisa raciocinar sobre o que está vendo naquele momento. O Gemini 3.8 Live faz isso em uma sessão, sem componente de visão separado — planeje considerando o limite de 2 minutos de vídeo da seção de imagens.
Trabalho em múltiplas etapas em segundo plano
Para tarefas que encadeiam ferramentas, compare o Extended Thinking com o GPT-Live-1 mais Astra. O Astra lidera o τ-Voice em um ensaio; então, a decisão ainda recai sobre onde o raciocínio deve ficar.
Adicionar voz a um agente que você já opera
A client delegation pode adicionar o GPT-Live-1 a um agente existente sem reescrever o loop de raciocínio. Com o Gemini, o modelo ao vivo vira o planejador.
Alto volume de chamadas com orçamento apertado
Chamadas curtas e simples apontam para o Gemini base, o setup mais barato no teste do Artificial Analysis. Ferramentas em múltiplas etapas mudam essa conta.
Considerações finais
A forma mais clara de enquadrar a comparação: o Gemini 3.8 Live combina visão, raciocínio e fala em um único modelo, enquanto o GPT-Live-1 separa a voz da inteligência por trás dela. Nenhum domina, e os dois estão próximos o suficiente em naturalidade e velocidade de resposta para que a arquitetura decida a maioria dos casos reais.
O que acho mais interessante é a rapidez com que a liderança em tarefas de agente migrou para o GPT-Live-1 com Astra. Essa pontuação pertence ao sistema inteiro, não só ao modelo de voz — é o argumento da delegação em prática, embora um único ensaio seja um sinal, não um veredito.
Outra coisa a observar é a linha de backends da OpenAI, já que o GPT-6.1 Sol chegou no fim de setembro de 2026. Cada novo backend pode mover as pontuações do GPT-Live-1 sem tocar na voz, enquanto a mudança comparável do Google exigiria trocar o modelo ao vivo.
Por ora, o Gemini 3.8 Live é a escolha mais simples para qualquer coisa com câmera, e o GPT-Live-1 é a escolha mais simples para produtos telefônicos com backend já pronto. De qualquer forma, seu código ainda precisa lidar com o problema de mudar a reserva de sexta para quinta.
Para os conceitos de agente por trás de ambos os caminhos, nosso curso Introduction to AI Agents cobre ferramentas, memória e planejamento.
FAQs
O GPT-Live-1 pode usar um modelo Gemini como backend?
Sim. A client delegation pode enviar o trabalho para um modelo de texto do Gemini no seu próprio backend. Você pagaria à OpenAI pelos minutos de voz e ao Google pelos tokens do backend.
Por quanto tempo uma conversa do GPT-Live-1 permanece em contexto?
O GPT-Live-1 tem uma janela de contexto de 128.000 tokens que contabiliza tokens de áudio, não só a transcrição. Ao passar de 90% de uso, ele inicia um mecanismo de voz de substituição que carrega até 8.192 tokens de histórico recente e resumos — portanto, mantenha ações confirmadas e estado da tarefa na sua própria aplicação.
Quais limites de taxa se aplicam ao Gemini 3.8 Live e ao GPT-Live-1?
Limites mais claros na OpenAI do que no Google. O GPT-Live-1 permite 50 sessões simultâneas no Build, 300 no Launch e 500 no Grow, sem acesso gratuito. O Google não publica limites específicos do Live e indica o Google AI Studio para ver os limites atuais do seu projeto.
Posso reaproveitar meu código atual de app de voz?
Na maior parte, sim no Gemini; menos na OpenAI. Código escrito para o Gemini 3.1 Flash Live basicamente precisa do novo string de modelo, sem qualquer configuração thinking_level, que o gemini-3.8-live não aceita. Remova também enable_affective_dialog e proactive_audio: false se o seu código os herdou de modelos antigos. O GPT-Live-1 usa seu próprio endpoint v1/live/sessions em vez de v1/realtime, então um app da Realtime API precisa de retrabalho; a OpenAI publica um guia de migração.
O áudio do Gemini 3.8 Live tem marca d'água?
Sim. O Google diz que todo áudio gerado pelos seus produtos de IA, incluindo os dois modelos do Gemini 3.8 Live, carrega uma marca d'água SynthID inaudível para ouvintes, o que ajuda se você precisar comprovar que um(a) cliente ouviu fala sintética.

Sou engenheiro de dados e criador de comunidades que trabalha com pipelines de dados, nuvem e ferramentas de IA, além de escrever tutoriais práticos e de alto impacto para o DataCamp e desenvolvedores iniciantes.





Assistentes de voz antigos funcionavam por turnos: você fala, espera e só então eles respondem. O Gemini 3.8 Live, do Google, e o GPT-Live-1, da OpenAI, são agentes de voz em tempo real, capazes de lidar com interrupções e mudanças no meio da frase. Nenhum deles vence em todos os quesitos.
A diferença está em onde o “pensar” acontece. O Gemini 3.8 Live ouve você, pode inspecionar a entrada da câmera, raciocina e decide quando pedir para o seu app agir. O GPT-Live-1 foca na conversa e consegue ouvir enquanto fala. Quando o GPT-Live-1 precisa de um raciocínio mais pesado ou executar uma ação, ele repassa o trabalho para um segundo modelo ou serviço chamado backend.
A OpenAI lançou o GPT-Live-1 na sua API em setembro, e o Google liberou o Gemini 3.8 Live menos de uma semana depois. Nosso overview do Gemini 3.8 Live cobre o lançamento do Google. Se você quer construir com qualquer um deles, nosso tutorial do Gemini 3.8 Live e o tutorial da API do GPT-Live-1 mostram a configuração.
TL;DR
Sem tempo? Aqui vai o comparativo em seis pontos:
A necessidade de câmera ou um backend já pronto pode decidir antes dos rankings. A tabela abaixo mostra por quê.