
Gemini 3.8 Live vs. GPT-Live-1 in één oogopslag
Wat de onderstaande tabel niet laat zien, is dat in beide gevallen je eigen app nog steeds het echte werk doet, zoals je functies aanroepen en bijhouden wat de gebruiker heeft gevraagd.
|
Vergelijkingspunt |
Gemini 3.8 Live |
GPT-Live-1 |
|
Rol |
Eén model dat luistert, ziet, redeneert en je app vraagt om te handelen |
Spraakmodel dat praat en zwaarder werk overdraagt aan een backend |
|
Model-ID's |
|
|
|
Native invoer |
Tekst, audio, afbeeldingen, videoframes |
Alleen tekst en audio |
|
Waar dieper redeneren draait |
Binnen het model, met meer ervan op Extended Thinking |
In een backend die jij kiest |
|
Wie jouw functies draait |
Je applicatie (Search grounding draait aan Google's kant) |
Je applicatie; gehoste tools zoals websearch draaien met de backend |
|
Afrekeneenheid |
Tokens, inclusief denktokens |
Verbonden sessieminuten, plus backend-gebruik |
|
Gratis laag |
Ja |
Nee |
Wat zijn Gemini 3.8 Live en GPT-Live-1?
Beide zijn spraak-naar-spraak-modellen, dus audio gaat erin en audio komt eruit zonder aparte transcriptiestap.
Wat is Gemini 3.8 Live?
Gemini 3.8 Live is Google's live dialoogmodel met lage latentie. Het accepteert tekst, afbeeldingen, audio en video, redeneert tussen beurten en roept functies asynchroon aan. Beide Gemini-varianten vermelden een invoerlimiet van 131.072 tokens op hun modelpagina's.
Gemini 3.8 Live Extended Thinking is een apart model, geen instelling. Het voegt achtergrondredeneren toe op een laag, medium of hoog niveau terwijl het voortgang vertelt.
Google's releasenotes vermelden beide model-ID's als algemeen beschikbaar, terwijl de Live API-capabilitiesgids de API nog als preview labelt.
Wat is GPT-Live-1?
GPT-Live-1 is OpenAI's full-duplex spraakmodel. Full duplex is de technische naam voor het luister-terwijl-je-praat-gedrag dat ik in de intro beschreef.
OpenAI noemt de overdracht naar de backend delegatie. De stem kan blijven praten terwijl dat werk draait.
GPT-Live-1 is ook niet hetzelfde product als OpenAI's GPT-Realtime-2-lijn of het backendmodel waarnaar het delegeert. GPT-Realtime-2.1 houdt redeneren en tools in één realtime model, dus alles wat ik over delegatie zeg, geldt alleen voor GPT-Live-1.
Wat is het belangrijkste verschil tussen Gemini 3.8 Live en GPT-Live-1?
De TL;DR gaf de korte versie, dit is de volledige. Gemini 3.8 Live kiest functieaanroepen binnen de live sessie, terwijl GPT-Live-1 het redeneren overdraagt aan een aparte backend. In beide ontwerpen draait je applicatie je eigen functies.
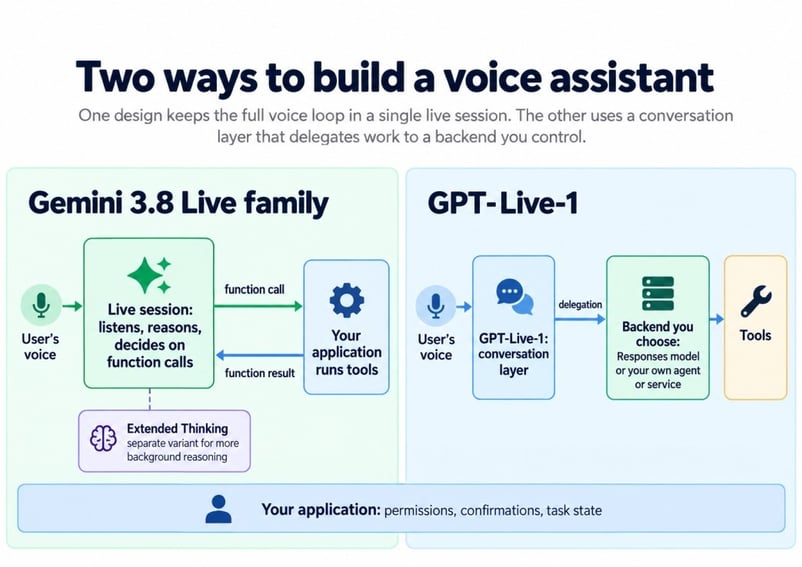
Waar elk model het denkwerk plaatst. Afbeelding door de auteur.
Het meeste hieronder is terug te voeren op die splitsing, dus hier eerst beide kanten.
Hoe Gemini 3.8 Live binnen één sessie plant
Met Gemini is er geen tweede model om te configureren. Het livemodel geeft een functieaanroep wanneer het data nodig heeft, en je client retourneert het resultaat, zoals Google's thinking-gids beschrijft.
Overschakelen naar Extended Thinking houdt dezelfde WebSocket-endpoint en vereist geen backendmodel, al verandert de clientcode wel.
Hoe GPT-Live-1-delegatie werkt
GPT-Live-1 verwerkt spraak en beslist wanneer om hulp te vragen; de backend verwerkt redeneren, tools en bedrijfsregels. OpenAI's prompting-gids zet de volledige taakprocedure in de instructies van de backend.
Met Responses-delegatie draait OpenAI een model dat jij configureert. Met clientdelegatie gaat het werk naar elk model of elke service die je applicatie draait. In beide gevallen zegt de delegatiegids dat je applicatie permissies, registraties en taakstatus beheert.
Waarom het architectuurverschil telt
De prijs van de splitsing is meer onderdelen: een stemsessie, een backend en gedeelde status ertussen. In ruil daarvoor kun je het redeneermodel veranderen zonder de stem aan te raken.
Die trade-off lijkt slechter als je nog geen backend hebt, maar beter als je een bestaande agent moet upgraden zonder de stem te wijzigen.
Hoe gaan Gemini 3.8 Live en GPT-Live-1 om met onderbrekingen?
Beide kunnen onderbrekingen aan, maar GPT-Live-1 is eromheen gebouwd, samen met pauzes en backchannels (het "hmm-hmm" dat een luisteraar maakt). Gemini 3.8 Live ondersteunt barge-in, en zijn proactieve audio staat altijd aan, maar Google's documentatie noemt het geen full duplex.
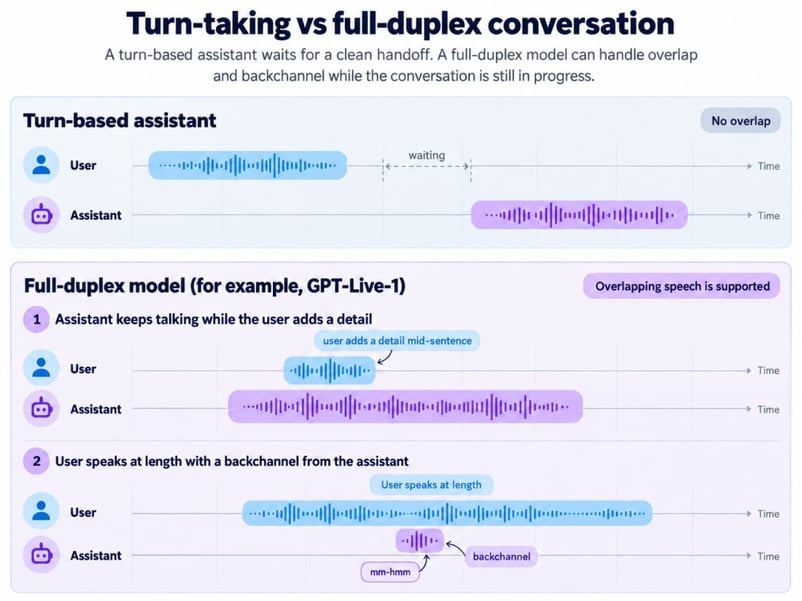
Om de beurt praten versus tegelijk praten. Afbeelding door de auteur.
OpenAI's lanceringpost citeert taalapp Speak die zegt dat GPT-Live-1 onderbrekingen met bijna 80% verminderde ten opzichte van beurtgebaseerde systemen, een klantclaim en geen onafhankelijke test.
Bij Gemini stelt proactieve audio het model in staat spraak over te slaan die niet voor hem bedoeld is. Onze Gemini-tutorial merkte dat laptopspeakergeluid dat in de microfoon lekt telt als de gebruiker die inbreekt, dus test met en zonder koptelefoon.
Hoe gaan Gemini 3.8 Live en GPT-Live-1 om met redeneren en tool-calls?
Gemini schaalt redeneren door te schakelen van basis Live naar Extended Thinking. GPT-Live-1 schaalt het door de backend te veranderen, dus vergelijk Extended Thinking met een complete GPT-Live-1-setup, niet met alleen het spraakmodel.
Gemini 3.8 Live vs. Gemini 3.8 Live Extended Thinking
Basis Gemini 3.8 Live heeft geen thinking_level-instelling en accepteert BLOCKING-functies voor oudere code. Extended Thinking wijzigt vier clientgedragingen:
-
Tools: alleen
NON_BLOCKING-functies werken, en een blocking-functie geeft een harde fout. -
Denk-niveaus: er is geen minimale optie, alleen de drie niveaus hierboven.
-
Einde van een beurt:
turnComplete: truebetekent niet langer dat het model klaar is, dus je client kijkt naarinteraction_statustotdat daarIDLEstaat. -
Planning: het inplannen van functies wordt niet ondersteund.
Google raadt Extended Thinking aan voor meerstapstaken en trage tools. Het kost meer latentie en outputtokens.
Eén ding irriteerde me in Google's docs. De lanceringpost zegt dat Gemini 3.8 Live kan "blijven praten terwijl taken op de achtergrond afronden", maar de thinking-gids zegt dat het basismodel "wacht op toolexecutie voordat het spreekt." Onze Gemini-tutorial zag het tweede gedrag tijdens een weeropvraag, dus ik zou op de gids plannen totdat Google verduidelijkt.
Welke backendmodellen werken met GPT-Live-1?
GPT-Live-1 kan voor elke backend staan die jij configureert. OpenAI's documentatie wijst op drie GPT-6-backends:
-
GPT-6 Luna (
gpt-6-luna), het aanbevolen startpunt in de delegatiegids -
GPT-6 Sol (
gpt-6-sol), de suggestie van de gids voor zwaardere taken -
GPT-6 Astra, dat in de lanceringpost wordt aanbevolen voor complexe klantkwesties
De Artificial Analysis-rijen "GPT-Live-1 (Astra, medium)" en "GPT-Live-1 (Sol, low)" zijn systeemconfiguraties, geen spraakmodelversies. Artificial Analysis noemt de Sol-generatie niet, en OpenAI bracht GPT-6.1 Sol uit nadat die tests draaiden.
Wat er gebeurt als een beller halverwege de taak van verzoek wisselt
Stel dat een beller vraagt een boeking naar vrijdag te verplaatsen en vervolgens zegt "eigenlijk donderdag" terwijl de opvraag draait. Alleen het tweede verzoek telt nog.
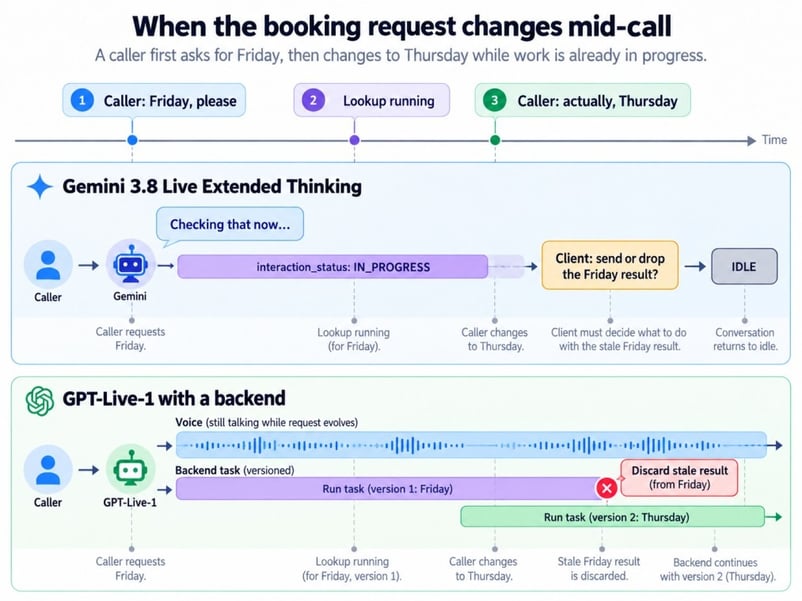
Een gewijzigd verzoek tijdens traag werk. Afbeelding door de auteur.
Bij GPT-Live-1 annuleert het onderbreken van de stem het backendwerk niet. Responses-delegatie kan het oude resultaat nog aan de stem teruggeven, terwijl clientdelegatie je code het eerst kan laten droppen.
Bij Gemini kan je client het verouderde toolresultaat droppen. In beide gevallen beslist je applicatie wat de huidige taak is.
Ondersteunen Gemini 3.8 Live en GPT-Live-1 afbeeldingen en video?
Gemini 3.8 Live accepteert afbeeldingen en video native; GPT-Live-1 vermeldt beide als niet ondersteund. Een GPT-Live-1-app kan nog steeds een foto naar een aparte vision-backend sturen, maar kan niet zelf een live camera bekijken.
Bij Gemini komen frames binnen in dezelfde sessie als de audio, zodat het model kan antwoorden "is dit de juiste kabel?" terwijl de gebruiker die omhoog houdt. Dat heeft twee kosten. Videoframes worden standaard verzonden, en Google's sessiegids beperkt sessies met audio en video tot 2 minuten, tegenover 15 voor alleen audio, tenzij je contextvenster-compressie inschakelt.
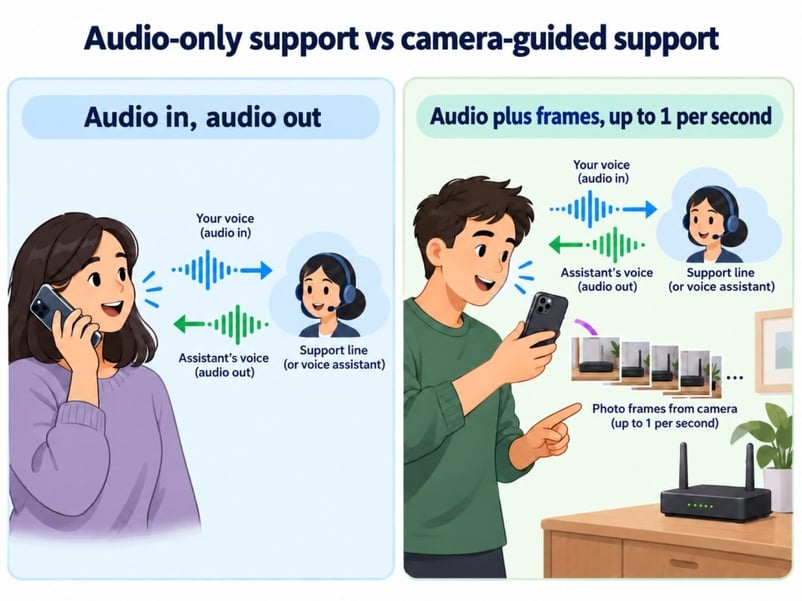
Telefoongesprekken versus camera-reparatiesessies. Afbeelding door de auteur.
Een reserveringslijn ziet nooit een frame, en de spraakranglijsten hieronder meten geen visie.
Gemini 3.8 Live vs. GPT-Live-1-benchmarks
Geen enkele benchmark beslist deze vergelijking. Onder de vier configuraties van de twee modellen leidt Astra de hoofdindex, Sol leidt conversatiedynamiek en basis Gemini heeft de hoogste Arena Elo van de vier configuraties.
Eerst: hoe de hoofdindex werkt, want dat verklaart de meeste verschillen.
Hoe de Artificial Analysis Speech to Speech Index werkt
De index geeft vier verschillende vaardigheden evenveel gewicht:
- Big Bench Audio: redeneervragen die hardop gesteld worden
- τ-Voice: meerstapsklantenservice-taken, zoals een vlucht wijzigen
- Arena-score: blinde menselijke stemmen over welke agent mensen prefereerden
- Taaksuccesratio: hoe vaak een gesprek eindigde met de juiste laatste tool-call
Conversatiedynamiek wordt apart gerapporteerd onder de v2.0-methodologie.
Hier zijn de vier configuraties die hier ter zake doen.
|
Configuratie |
Index |
Big Bench Audio |
τ-Voice |
Conversatiedynamiek |
Arena Elo |
Taaksucces |
TTFA |
|
GPT-Live-1 (Astra, medium) |
83.2 |
90.1% |
74.5% |
94.9% |
1027 |
87.4% |
1,34 s |
|
Gemini 3.8 Live Extended Thinking (Hoog) |
82.6 |
97,7% |
68,6% |
91,9% |
966 |
89,1% |
1,35 s |
|
GPT-Live-1 (Sol, laag) |
80.1 |
89,0% |
59,3% |
97,3% |
1037 |
90,9% |
1,24 s |
|
Gemini 3.8 Live |
74.5 |
91,7% |
30,1% |
96,1% |
1074 |
93,2% |
1,18 s |
Beide GPT-Live-1 τ-Voice-scores komen uit één proef, dus behandel ze met voorzichtigheid.
Agenttaken vs. menselijke voorkeursscores
Op τ-Voice scoort Astra 74,5%, Extended Thinking 68,6% en basis Gemini 30,1%. Extra redeneren telt zodra tools worden geschakeld.
Het gesprek vertelt een ander verhaal: Sol scoort het hoogst, en de betrouwbaarheidsintervallen voor Arena van basis Gemini en Sol overlappen.
Het indexverschil van 0,6 punt tussen Astra en Extended Thinking heeft geen gepubliceerd betrouwbaarheidsinterval. Ze hebben al eens van plaats gewisseld, dus ik noem het nog steeds gelijkspel.
Welk model reageert sneller?
Basis Gemini 3.8 Live heeft de snelste time to first audio (TTFA) in de tabel, maar de spreiding over alle vier is minder dan 0,2 seconden. TTFA is hoe lang een model erover doet om zijn eerste audiotoken te produceren.
TTFA mist de reactie op onderbrekingen en de tijd die nodig is om een boeking of opzoeking af te ronden. Dat laatste hangt meer af van je backend en tools.
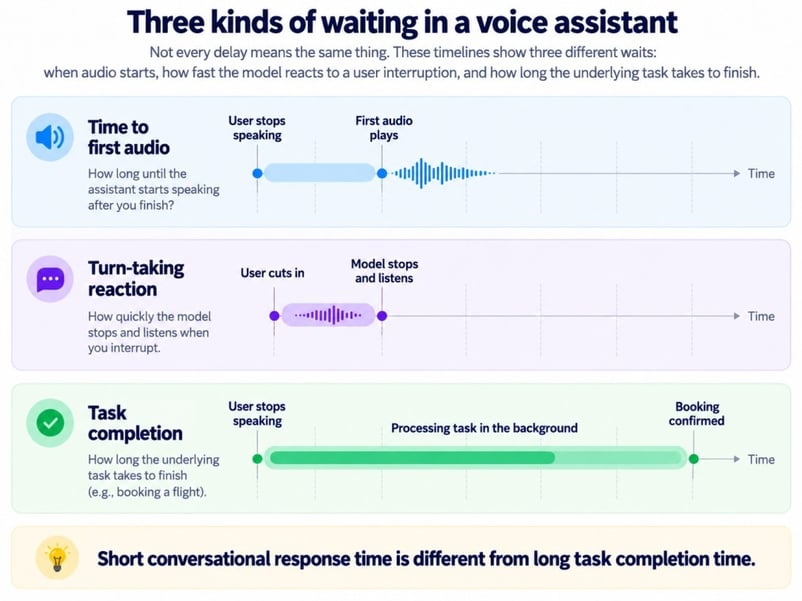
Drie soorten wachten bij voice. Afbeelding door de auteur.
Zowel Extended Thinking als GPT-Live-1 kunnen blijven praten tijdens een trage opzoeking. De beller wacht nog steeds op de boeking.
Wat voice-benchmarks niet meten
Voor een supportlijn vertellen de ranglijsten je niet:
- of je telefonieprovider en codec het schoon transporteren
- of de agent jouw script nog volgt na tien minuten
- hoe een beller met een sterk accent op een rumoerige straat wordt gehoord
- wat het gesprek kostte zodra backend en tools zijn meegerekend
Een pilot met je eigen opnames beantwoordt die vragen beter.
Gemini 3.8 Live vs. GPT-Live-1-prijzen: wat is goedkoper?
Basis Gemini is het goedkoopst in de test van Artificial Analysis, maar de modellen rekenen verschillende dingen af. Kosten per succesvolle taak tellen meer dan de stickerprijs.
De onderstaande tarieven zijn de lijstprijsen op Google's prijspagina en de GPT-Live-1-modelpagina terwijl ik dit schrijf, en Gemini's per-minuut-cijfers zijn Google's eigen conversies vanuit tokenprijzen.
|
Kostenpost |
Gemini 3.8 Live en Extended Thinking (betaalde laag) |
GPT-Live-1 |
|
Audio-invoer |
$3,00 per 1M tokens (ongeveer $0,005/min) |
Gedekt door $0,05 per minuut, per seconde gefactureerd |
|
Audio-uitvoer |
$12,00 per 1M tokens (ongeveer $0,018/min) |
Gedekt door dezelfde sessievergoeding |
|
Afbeelding- of video-invoer |
$1,00 per 1M tokens (ongeveer $0,002/min) |
Niet ondersteund |
|
Redeneren |
Denktokens gefactureerd tegen outputtarieven |
Backendmodel-tokens tegen de prijs van dat model |
|
Zoeken en tools |
5.000 gratis Search-verzoeken per maand, daarna $14 per 1.000 |
Gefactureerd door het backendmodel en de tools die je gebruikt |
Denktokens maken Extended Thinking duurder dan basis Gemini. Artificial Analysis schat $0,84 per input-audiouur voor basis Gemini, $3,50 voor Extended Thinking, $4,47 voor Sol en $5,83 voor Astra, exclusief tools en cachekortingen. Gemini Live ondersteunt geen caching; een GPT-Live-1-backend kan dat wel.
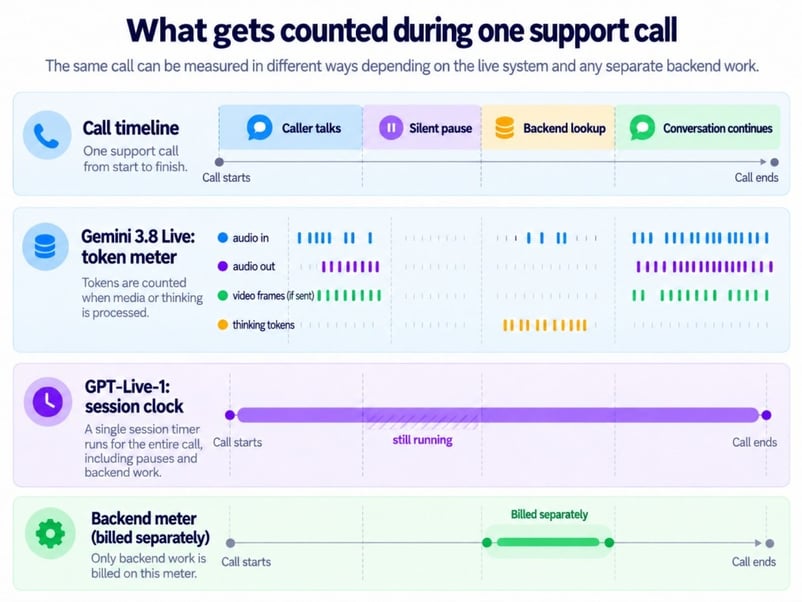
Wat elke meter telt tijdens gesprekken. Afbeelding door de auteur.
De klok van GPT-Live-1 loopt door tijdens stilte, en dempen stopt hem niet. Tel de kosten uit de tabel bij elkaar op plus telefoniekosten en deel dan door afgeronde taken.
Browser-, server- en telefonie-ondersteuning in Gemini 3.8 Live en GPT-Live-1
Browser- en serverapps kunnen met beide modellen verbinden, maar telefonie scheidt ze. Het diagram toont de verbindingsopties; de operationele verschillen zijn de levensduur van de verbinding en wie er in het belpad zit.
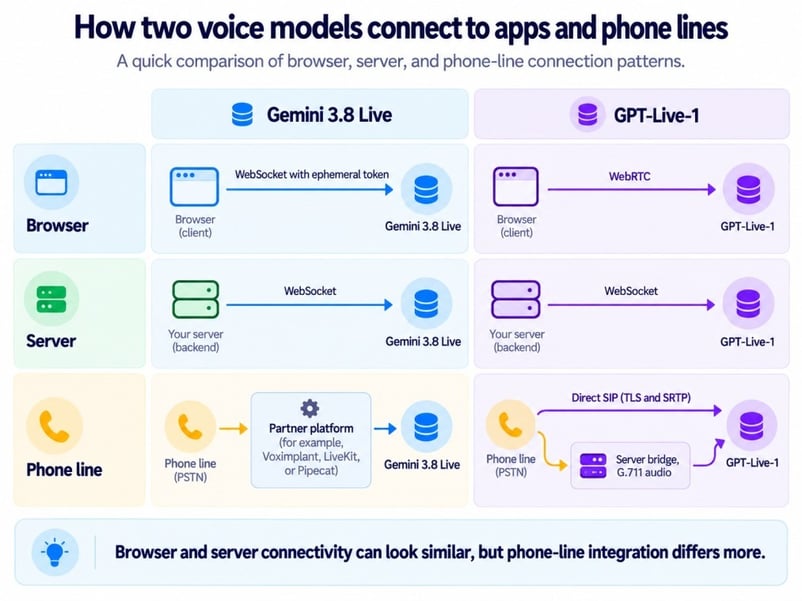
Browser-, server- en telefoonverbindingspaden. Afbeelding door de auteur.
Gemini-verbindingen worden na ongeveer 10 minuten gereset, dus langere gesprekken hebben sessiehervatting nodig. Bij GPT-Live-1 log je de stemverbinding en het gedelegeerde backendwerk apart.
Telefoongesprekken en SIP-ondersteuning
Directe SIP laat één leverancier minder in het belpad van GPT-Live-1. De partnerroute van Gemini voegt een extra service toe om te configureren, te monitoren en te debuggen.
Een paar ontwikkelaars op OpenAI's forum melden dat GPT-Live-1 een actie belooft zonder een delegatie te creëren. OpenAI-support noemde het geen bug; het wees op de prompting-gids, die opmerkt dat een mondelinge bevestiging niet garandeert dat backendwerk is gestart. Ik zou delegatie-events los van spraak loggen.
Sinds 2 november ondersteunt OpenAI ook uitgaande SIP-bellen voor alle organisaties, zodat GPT-Live-1 zowel kan bellen als opnemen.
Gemini 3.8 Live vs. GPT-Live-1: welke moet je gebruiken?
De keuze komt neer op twee vragen: moet de assistent kunnen zien, en heb je al een backend? Een ja op de eerste wijst naar Gemini; een ja op de tweede wijst naar GPT-Live-1.
Spring naar het scenario hieronder dat bij je product past.
Telefoonondersteuning en reserveringen
Een telefoonlijn heeft onderbrekingsafhandeling nodig en bevestigingen voordat iets onomkeerbaars gebeurt. GPT-Live-1 sluit daar goed op aan, met de hierboven besproken SIP-ondersteuning en boekingslogica in de backend.
Camera- en schermproblemen oplossen
Wanneer een gebruiker een telefoon op een router richt, moet het model redeneren over wat het nu ziet. Gemini 3.8 Live doet dat in één sessie, zonder aparte visioncomponent, zolang je rekening houdt met de videolimiet van 2 minuten uit de sectie over afbeeldingen.
Meerstapswerk op de achtergrond
Voor taken die tools aan elkaar rijgen, vergelijk Extended Thinking met GPT-Live-1 plus Astra. Astra leidt τ-Voice in één proef, dus de keuze komt nog steeds neer op waar het redeneren moet plaatsvinden.
Voice toevoegen aan een agent die je al runt
Clientdelegatie kan GPT-Live-1 toevoegen aan een bestaande agent zonder zijn redeneerloop te herschrijven. Met Gemini wordt het livemodel de planner.
Hoge belvolumes met krap budget
Korte, eenvoudige gesprekken wijzen naar basis Gemini, de goedkoopste setup in de test van Artificial Analysis. Meerstapstools veranderen die rekensom.
Slotgedachten
De duidelijkste manier om deze vergelijking te kaderen is dat Gemini 3.8 Live zien, redeneren en spreken in één model combineert, terwijl GPT-Live-1 de stem scheidt van de intelligentie erachter. Geen van beide domineert, en ze liggen dicht genoeg bij elkaar in menselijk klinken en snel antwoorden dat architectuur de meeste echte beslissingen zal bepalen.
Wat ik het meest interessant vind, is hoe snel de voorsprong op agenttaken richting GPT-Live-1 met Astra verschoof. Die score hoort bij het hele systeem, niet alleen het spraakmodel, dus het is het delegatie-argument in actie, al is één testrun een signaal en geen uitspraak.
Het andere om in de gaten te houden is OpenAI's backendportfolio, aangezien GPT-6.1 Sol eind september 2026 arriveerde. Elk nieuw backend kan de scores van GPT-Live-1 verschuiven zonder de stem aan te raken, terwijl een vergelijkbare wijziging bij Google zou betekenen dat je het livemodel wisselt.
Voor nu is Gemini 3.8 Live de makkelijkere keuze voor alles met een camera, en GPT-Live-1 de makkelijkere keuze voor telefoonproducten met een bestaande backend. Hoe dan ook, je code moet nog steeds het vrijdag-naar-donderdag-boekingsprobleem afhandelen.
Voor de agentconcepten achter beide paden behandelt onze cursus Introductie tot AI-agents tools, geheugen en planning.
FAQs
Kan GPT-Live-1 een Gemini-model als backend gebruiken?
Ja. Clientdelegatie kan het werk sturen naar een Gemini-tekstmodel achter je eigen backend. Je betaalt OpenAI voor stemminuten en Google voor backendtokens.
Hoe lang kan een GPT-Live-1-gesprek in context blijven?
GPT-Live-1 heeft een contextvenster van 128.000 tokens dat audiotokens meetelt, niet alleen het transcript. Zodra het gebruik 90% passeert, start het een vervangende stemengine die tot 8.192 tokens aan recente geschiedenis en samenvattingen meedraagt, dus bewaar bevestigde acties en taakstatus in je eigen applicatie.
Welke ratelimieten gelden voor Gemini 3.8 Live en GPT-Live-1?
GPT-Live-1 staat 50 gelijktijdige sessies toe op Build, 300 op Launch en 500 op Grow, zonder gratis laag. Google publiceert geen limieten alleen voor Live en verwijst je naar Google AI Studio voor de huidige limieten van je project.
Kan ik mijn bestaande voice-appcode hergebruiken?
Voornamelijk bij Gemini, minder bij OpenAI. Code geschreven voor Gemini 3.1 Flash Live heeft vooral de nieuwe modelstring nodig, minus elke thinking_level-instelling, die gemini-3.8-live niet accepteert. Verwijder ook enable_affective_dialog en proactive_audio: false als je code ze van oudere modellen meeneemt. GPT-Live-1 gebruikt zijn eigen v1/live/sessions-endpoint in plaats van v1/realtime, dus een Realtime API-app heeft herwerk nodig, en OpenAI publiceert er een migratiegids voor.
Is Gemini 3.8 Live-audio voorzien van een watermerk?
Ja. Google zegt dat alle audio die door zijn AI-producten wordt gegenereerd, inclusief beide Gemini 3.8 Live-modellen, een SynthID-watermerk draagt dat luisteraars niet horen, wat helpt als je ooit moet aantonen dat een beller synthetische spraak hoorde.

Ik ben een data-engineer en communitybouwer die werkt aan datapijplijnen, cloud en AI-tools, en tegelijkertijd praktische, impactvolle tutorials schrijft voor DataCamp en beginnende developers.


Oudere spraakassistenten werken vooral om de beurt: jij praat, je wacht, en dan geven zij antwoord. Google's Gemini 3.8 Live en OpenAI's GPT-Live-1 zijn realtime voice-agents die onderbrekingen en wijzigingen midden in een zin aankunnen. Geen van beide is overal beter.
Het verschil zit in waar het denkwerk gebeurt. Gemini 3.8 Live luistert naar je, kan camerabeelden bekijken, redeneert en beslist wanneer je app iets moet doen. GPT-Live-1 focust op het gesprek en kan luisteren terwijl het praat. Wanneer GPT-Live-1 zwaarder denkwerk of een actie nodig heeft, draagt het dat over aan een tweede model of service: de backend.
OpenAI bracht GPT-Live-1 naar zijn API in september, en Google lanceerde Gemini 3.8 Live minder dan een week later. Onze overzichtspagina van Gemini 3.8 Live behandelt Google's lancering. Wil je met een van beide bouwen, dan leggen onze Gemini 3.8 Live-tutorial en GPT-Live-1 API-tutorial de setup uit.
TL;DR
Geen tijd? Hier is de vergelijking in zes punten:
Een cameravereiste of bestaande backend kan de keuze al bepalen voordat de ranglijst dat doet. De onderstaande tabel laat zien waarom.