
Gemini 3.8 Live và GPT-Live-1 trong nháy mắt
Điều bảng dưới không thể hiện là ở cả hai trường hợp, ứng dụng của bạn vẫn thực hiện công việc thực, như chạy các hàm của bạn và theo dõi những gì người dùng yêu cầu.
|
Điểm so sánh |
Gemini 3.8 Live |
GPT-Live-1 |
|
Vai trò |
Một mô hình có thể lắng nghe, quan sát, suy luận và yêu cầu ứng dụng của bạn hành động |
Mô hình giọng nói có thể nói và chuyển phần việc khó hơn cho backend |
|
ID mô hình |
|
|
|
Đầu vào gốc |
Văn bản, âm thanh, hình ảnh, khung hình video |
Chỉ văn bản và âm thanh |
|
Nơi chạy suy luận sâu hơn |
Bên trong mô hình, nhiều hơn ở Extended Thinking |
Trong một backend do bạn chọn |
|
Ai chạy các hàm của bạn |
Ứng dụng của bạn (Search grounding chạy phía Google) |
Ứng dụng của bạn; các công cụ được lưu trữ như tìm kiếm web chạy cùng backend |
|
Đơn vị tính phí |
Token, bao gồm token suy nghĩ |
Phút phiên kết nối, cộng mức dùng backend |
|
Miễn phí |
Có |
Không |
Gemini 3.8 Live và GPT-Live-1 là gì?
Cả hai đều là mô hình chuyển giọng nói thành giọng nói, nên âm thanh vào và âm thanh ra mà không cần bước chuyển âm riêng.
Gemini 3.8 Live là gì?
Gemini 3.8 Live là mô hình đối thoại trực tiếp độ trễ thấp của Google. Nó nhận văn bản, hình ảnh, âm thanh và video, suy luận giữa các lượt nói và gọi hàm bất đồng bộ. Cả hai biến thể Gemini đều liệt kê giới hạn đầu vào 131.072 token trên trang mô hình của chúng.
Gemini 3.8 Live Extended Thinking là một mô hình riêng, không phải thiết lập. Nó bổ sung suy luận nền ở mức thấp, trung bình hoặc cao trong khi tường thuật tiến độ.
Ghi chú phát hành của Google liệt kê cả hai ID mô hình là khả dụng rộng rãi, trong khi hướng dẫn khả năng Live API vẫn gắn nhãn API là bản xem trước.
GPT-Live-1 là gì?
GPT-Live-1 là mô hình giọng nói full-duplex của OpenAI. Full duplex là tên kỹ thuật cho hành vi vừa nói vừa nghe mà tôi mô tả ở phần mở đầu.
OpenAI gọi việc chuyển giao cho backend là ủy quyền (delegation). Giọng nói có thể tiếp tục nói trong khi phần việc đó đang chạy.
GPT-Live-1 cũng không phải là cùng sản phẩm với dòng GPT-Realtime-2 của OpenAI hay mô hình backend mà nó ủy quyền. GPT-Realtime-2.1 giữ suy luận và công cụ trong một mô hình realtime, nên mọi điều tôi nói về ủy quyền chỉ áp dụng cho GPT-Live-1.
Khác biệt chính giữa Gemini 3.8 Live và GPT-Live-1 là gì?
TL;DR đã tóm tắt ngắn gọn, dưới đây là phiên bản đầy đủ. Gemini 3.8 Live chọn gọi hàm bên trong phiên trực tiếp, trong khi GPT-Live-1 chuyển suy luận sang backend riêng. Ở cả hai thiết kế, ứng dụng của bạn chạy chính các hàm của bạn.
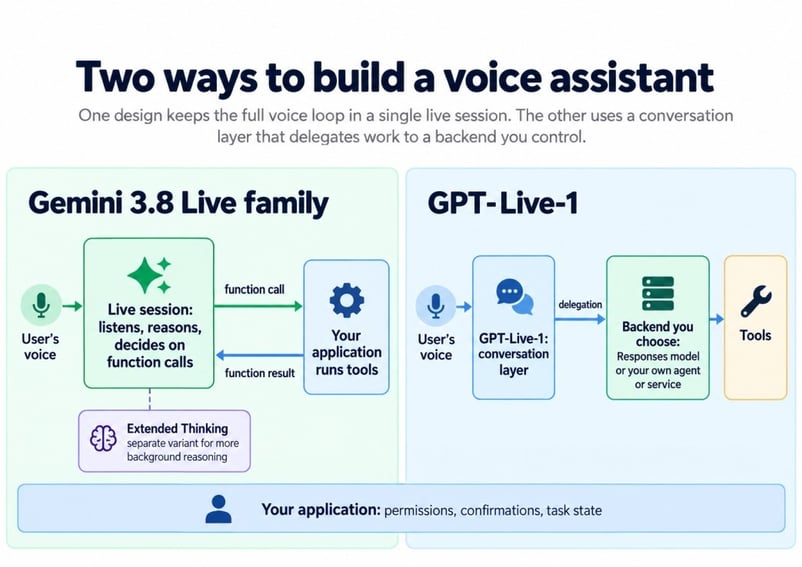
Mỗi mô hình đặt phần “suy nghĩ” ở đâu. Hình: Tác giả.
Hầu hết những gì theo sau đều bắt nguồn từ tách biệt đó, nên trước tiên là từng phía.
Cách Gemini 3.8 Live lập kế hoạch trong một phiên
Với Gemini, không có mô hình thứ hai để cấu hình. Mô hình live phát ra lời gọi hàm khi cần dữ liệu, và client của bạn trả về kết quả, như hướng dẫn thinking của Google mô tả.
Chuyển sang Extended Thinking vẫn giữ cùng endpoint WebSocket và không cần mô hình backend, dù mã phía client có thay đổi.
Cách ủy quyền của GPT-Live-1 hoạt động
GPT-Live-1 xử lý giọng nói và quyết định khi nào cần trợ giúp; backend xử lý suy luận, công cụ và quy tắc nghiệp vụ. Hướng dẫn nhắc (prompt) của OpenAI đưa toàn bộ quy trình tác vụ vào phần hướng dẫn của backend.
Với ủy quyền Responses, OpenAI chạy một mô hình bạn cấu hình. Với ủy quyền client, công việc chuyển đến bất kỳ mô hình hay dịch vụ nào ứng dụng của bạn chạy. Dù thế nào, hướng dẫn ủy quyền cho biết ứng dụng của bạn sở hữu quyền hạn, bản ghi và trạng thái tác vụ.
Vì sao khác biệt kiến trúc lại quan trọng
Cái giá của việc tách là nhiều thành phần hơn: một phiên giọng nói, một backend và trạng thái được chia sẻ giữa chúng. Đổi lại, bạn có thể thay đổi mô hình suy luận mà không đụng đến giọng nói.
Sự đánh đổi này có vẻ tệ nếu bạn chưa có backend, nhưng lại tốt nếu bạn cần nâng cấp một tác nhân hiện có mà không thay đổi giọng nói của nó.
Gemini 3.8 Live và GPT-Live-1 xử lý ngắt lời như thế nào?
Cả hai đều xử lý ngắt lời, nhưng GPT-Live-1 được xây dựng xoay quanh điều đó, cùng với các khoảng dừng và backchannel (tiếng “ừ-hừ” của người nghe). Gemini 3.8 Live hỗ trợ barge-in, và âm thanh chủ động luôn bật, nhưng tài liệu của Google không gọi nó là full duplex.
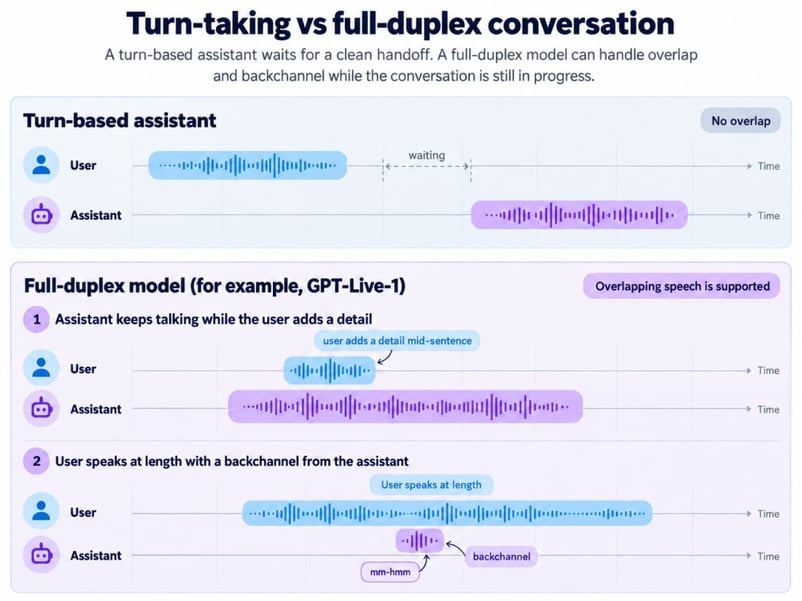
Luân phiên nói so với nói đồng thời. Hình: Tác giả.
Bài ra mắt của OpenAI trích dẫn ứng dụng ngôn ngữ Speak nói rằng GPT-Live-1 giảm ngắt lời gần 80% so với hệ thống theo lượt, đây là tuyên bố của khách hàng chứ không phải kiểm thử độc lập.
Trên Gemini, âm thanh chủ động cho phép mô hình bỏ qua lời nói không dành cho nó. Hướng dẫn Gemini của chúng tôi cho thấy âm thanh từ loa laptop lọt vào mic cũng bị tính là người dùng chen ngang, nên hãy thử cả khi có và không có tai nghe.
Gemini 3.8 Live và GPT-Live-1 xử lý suy luận và gọi công cụ ra sao?
Gemini mở rộng suy luận bằng cách chuyển từ Live cơ bản sang Extended Thinking. GPT-Live-1 mở rộng bằng cách thay backend, nên hãy so sánh Extended Thinking với một thiết lập GPT-Live-1 hoàn chỉnh, không chỉ riêng mô hình giọng nói.
Gemini 3.8 Live vs. Gemini 3.8 Live Extended Thinking
Gemini 3.8 Live cơ bản không có thiết lập thinking_level và chấp nhận các hàm BLOCKING cho mã cũ. Extended Thinking thay đổi bốn hành vi phía client:
-
Công cụ: chỉ các hàm
NON_BLOCKINGhoạt động, và hàm blocking sẽ trả về lỗi cứng. -
Mức độ suy nghĩ: không có tùy chọn tối thiểu, chỉ có ba mức nêu trên.
-
Kết thúc một lượt:
turnComplete: truekhông còn nghĩa là mô hình đã xong, nên client của bạn theo dõiinteraction_statuscho đến khi làIDLE. -
Lập lịch: không hỗ trợ lập lịch hàm.
Google khuyến nghị Extended Thinking cho tác vụ nhiều bước và công cụ chậm. Đổi lại là nhiều độ trễ và token đầu ra hơn.
Một điều khiến tôi khó chịu trong tài liệu của Google. Bài ra mắt nói Gemini 3.8 Live có thể “tiếp tục trò chuyện khi tác vụ hoàn tất ở nền”, nhưng hướng dẫn thinking nói mô hình cơ bản “chờ công cụ chạy xong trước khi nói”. Hướng dẫn Gemini của chúng tôi thấy hành vi thứ hai khi tra thời tiết, nên tôi sẽ lên kế hoạch theo hướng dẫn cho đến khi Google làm rõ.
Những mô hình backend nào hoạt động với GPT-Live-1?
GPT-Live-1 có thể đặt trước bất kỳ backend nào bạn cấu hình. Tài liệu OpenAI trỏ tới ba backend GPT-6:
-
GPT-6 Luna (
gpt-6-luna), điểm khởi đầu gợi ý của hướng dẫn ủy quyền -
GPT-6 Sol (
gpt-6-sol), gợi ý cho tác vụ khó hơn -
GPT-6 Astra, bài ra mắt khuyến nghị cho các vấn đề khách hàng phức tạp
Artificial Analysis có các hàng “GPT-Live-1 (Astra, medium)” và “GPT-Live-1 (Sol, low)” là cấu hình hệ thống, không phải phiên bản mô hình giọng nói. Artificial Analysis không nêu thế hệ Sol, và OpenAI phát hành GPT-6.1 Sol sau khi các bài test đó chạy.
Khi người gọi đổi yêu cầu giữa chừng tác vụ
Giả sử người gọi yêu cầu dời đặt chỗ sang thứ Sáu, rồi nói “thực ra, thứ Năm” khi tra cứu đang chạy. Chỉ yêu cầu thứ hai còn hiệu lực.
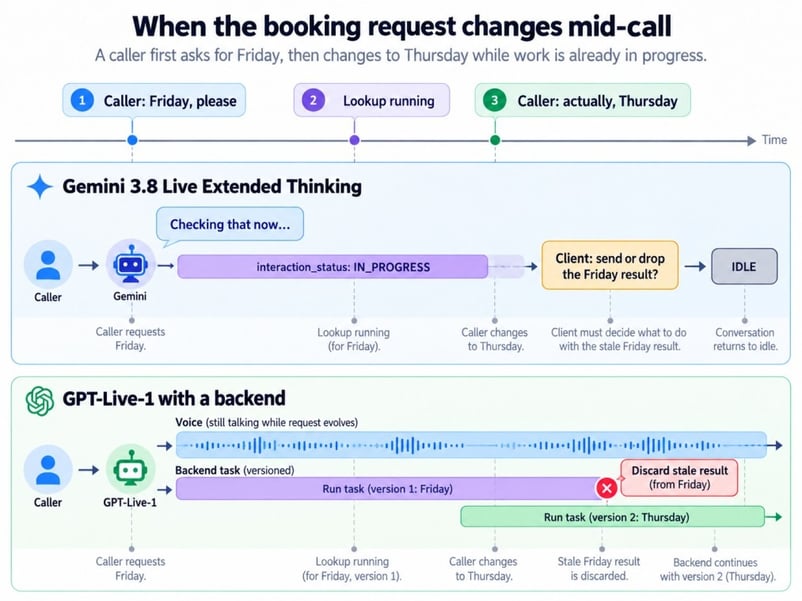
Thay đổi yêu cầu trong khi công việc chậm. Hình: Tác giả.
Với GPT-Live-1, ngắt lời giọng nói không hủy công việc backend. Ủy quyền Responses vẫn có thể trả về kết quả cũ cho giọng nói, trong khi ủy quyền client cho phép mã của bạn loại bỏ nó trước.
Trên Gemini, client của bạn có thể loại bỏ kết quả công cụ đã cũ. Dù thế nào, ứng dụng của bạn quyết định tác vụ hiện tại là gì.
Gemini 3.8 Live và GPT-Live-1 có hỗ trợ hình ảnh và video không?
Gemini 3.8 Live hỗ trợ hình ảnh và video gốc; GPT-Live-1 liệt kê cả hai là không hỗ trợ. Ứng dụng GPT-Live-1 vẫn có thể gửi ảnh đến một backend thị giác riêng, nhưng bản thân nó không thể xem camera trực tiếp.
Với Gemini, các khung hình đi vào cùng phiên với âm thanh, nên mô hình có thể trả lời “đây có phải sợi cáp đúng không?” khi người dùng giơ lên. Điều đó có hai cái giá. Khung hình video được gửi theo mặc định, và Guide về phiên của Google giới hạn phiên có âm thanh và video ở 2 phút, so với 15 phút cho chỉ âm thanh, trừ khi bạn bật nén cửa sổ ngữ cảnh.
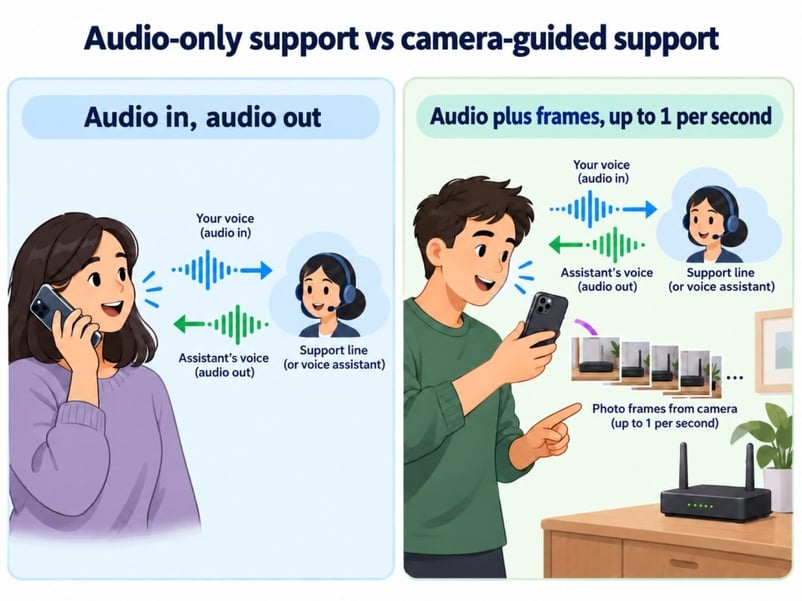
Cuộc gọi điện thoại so với phiên sửa chữa qua camera. Hình: Tác giả.
Đường dây đặt chỗ sẽ không bao giờ thấy khung hình, và các bảng xếp hạng giọng nói dưới đây không đo lường thị giác.
Điểm chuẩn Gemini 3.8 Live vs. GPT-Live-1
Không có bài điểm chuẩn đơn lẻ nào phân thắng bại. Giữa bốn cấu hình của hai mô hình, Astra dẫn đầu chỉ số chính, Sol dẫn đầu về động lực hội thoại, và Gemini cơ bản có Arena Elo cao nhất trong bốn cấu hình.
Đầu tiên, cách chỉ số chính hoạt động, vì điều đó giải thích hầu hết các khoảng cách.
Cách hoạt động của Artificial Analysis Speech to Speech Index
Chỉ số cho trọng số bằng nhau cho bốn kỹ năng khác nhau:
- Big Bench Audio: câu hỏi suy luận được đọc to
- τ-Voice: tác vụ dịch vụ khách hàng nhiều bước, như đổi chuyến bay
- Điểm Arena: bình chọn mù của con người về tác nhân họ ưa thích
- Tỷ lệ thành công tác vụ: mức độ thường xuyên cuộc trò chuyện kết thúc bằng lời gọi công cụ đúng
Động lực hội thoại được báo cáo riêng theo phương pháp v2.0.
Dưới đây là bốn cấu hình quan trọng ở đây.
|
Cấu hình |
Chỉ số |
Big Bench Audio |
τ-Voice |
Động lực hội thoại |
Arena Elo |
Thành công tác vụ |
TTFA |
|
GPT-Live-1 (Astra, medium) |
83.2 |
90,1% |
74,5% |
94,9% |
1027 |
87,4% |
1,34 s |
|
Gemini 3.8 Live Extended Thinking (Cao) |
82,6 |
97,7% |
68,6% |
91,9% |
966 |
89,1% |
1,35 s |
|
GPT-Live-1 (Sol, thấp) |
80,1 |
89,0% |
59,3% |
97,3% |
1037 |
90,9% |
1,24 s |
|
Gemini 3.8 Live |
74,5 |
91,7% |
30,1% |
96,1% |
1074 |
93,2% |
1,18 s |
Cả hai điểm τ-Voice của GPT-Live-1 đều từ một lần thử, nên hãy thận trọng.
Tác vụ tác nhân so với điểm ưu thích của con người
Trên τ-Voice, Astra đạt 74,5%, Extended Thinking 68,6% và Gemini cơ bản 30,1%. Bổ sung suy luận trở nên quan trọng khi xâu chuỗi công cụ.
Câu chuyện hội thoại lại khác: Sol đạt cao nhất, và khoảng tin cậy Arena của Gemini cơ bản và Sol chồng lấp.
Khoảng cách chỉ số 0,6 điểm giữa Astra và Extended Thinking không có khoảng tin cậy công bố. Chúng đã từng đổi chỗ một lần, nên tôi vẫn gọi là hòa.
Mô hình nào phản hồi nhanh hơn?
Gemini 3.8 Live cơ bản có thời gian đến âm thanh đầu tiên (TTFA) nhanh nhất trong bảng, nhưng độ chênh giữa cả bốn dưới 0,2 giây. TTFA là thời gian mô hình cần để phát ra token âm thanh đầu tiên.
TTFA bỏ qua phản ứng khi bị ngắt lời và thời gian cần để hoàn tất đặt chỗ hay tra cứu. Yếu tố sau phụ thuộc nhiều hơn vào backend và công cụ của bạn.
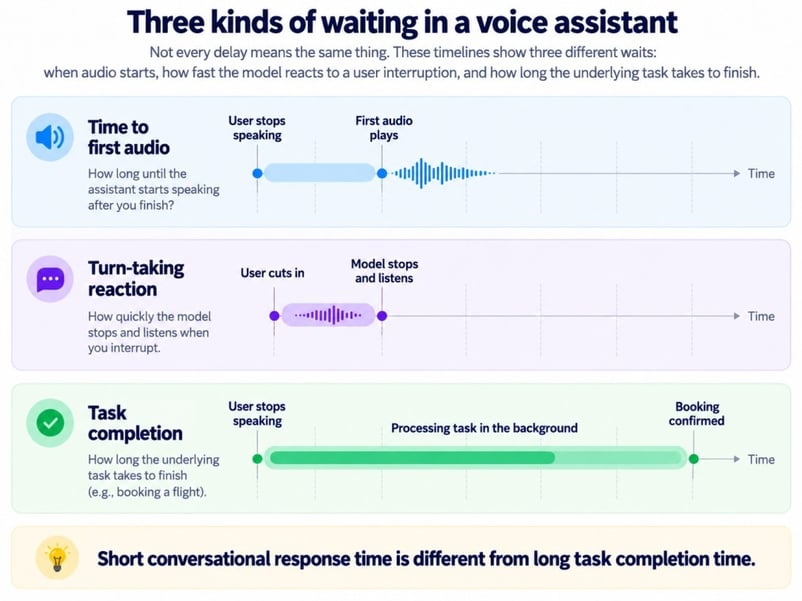
Ba kiểu chờ trong tương tác giọng nói. Hình: Tác giả.
Cả Extended Thinking và GPT-Live-1 đều có thể tiếp tục nói trong khi tra cứu chậm. Người gọi vẫn phải chờ việc đặt chỗ.
Những gì điểm chuẩn giọng nói không đo
Với đường dây hỗ trợ, bảng xếp hạng không thể cho bạn biết:
- nhà cung cấp điện thoại và codec của bạn truyền âm có sạch không
- tác nhân còn theo kịch bản của bạn sau mười phút không
- mô hình nghe người gọi có giọng nặng giữa phố ồn như thế nào
- chi phí cuộc gọi là bao nhiêu khi cộng backend và công cụ
Một thử nghiệm pilot với bản ghi của chính bạn trả lời tốt hơn.
Giá: Gemini 3.8 Live và GPT-Live-1—mô hình nào rẻ hơn?
Gemini cơ bản rẻ nhất trong bài thử của Artificial Analysis, nhưng các mô hình tính phí cho những thứ khác nhau. Chi phí trên mỗi tác vụ thành công quan trọng hơn giá niêm yết.
Các mức dưới đây là giá niêm yết trên trang giá của Google và trang mô hình GPT-Live-1 tại thời điểm tôi viết, và các con số trên phút của Gemini là chuyển đổi do chính Google thực hiện từ giá token.
|
Mục chi phí |
Gemini 3.8 Live và Extended Thinking (gói trả phí) |
GPT-Live-1 |
|
Âm thanh đầu vào |
$3,00 mỗi 1M token (khoảng $0,005/phút) |
Bao gồm trong $0,05 mỗi phút, tính theo giây |
|
Âm thanh đầu ra |
$12,00 mỗi 1M token (khoảng $0,018/phút) |
Bao gồm trong cùng phí phiên |
|
Đầu vào hình ảnh hoặc video |
$1,00 mỗi 1M token (khoảng $0,002/phút) |
Không hỗ trợ |
|
Suy luận |
Token suy nghĩ tính theo mức giá đầu ra |
Token của mô hình backend theo giá của mô hình đó |
|
Tìm kiếm và công cụ |
5.000 yêu cầu Search miễn phí mỗi tháng, sau đó $14 mỗi 1.000 |
Tính phí theo mô hình backend và công cụ bạn dùng |
Token suy nghĩ khiến Extended Thinking đắt hơn Gemini cơ bản. Artificial Analysis ước tính $0,84 mỗi giờ âm thanh đầu vào cho Gemini cơ bản, $3,50 cho Extended Thinking, $4,47 cho Sol và $5,83 cho Astra, chưa tính công cụ và chiết khấu bộ nhớ đệm. Gemini Live không hỗ trợ caching; backend của GPT-Live-1 có thể.
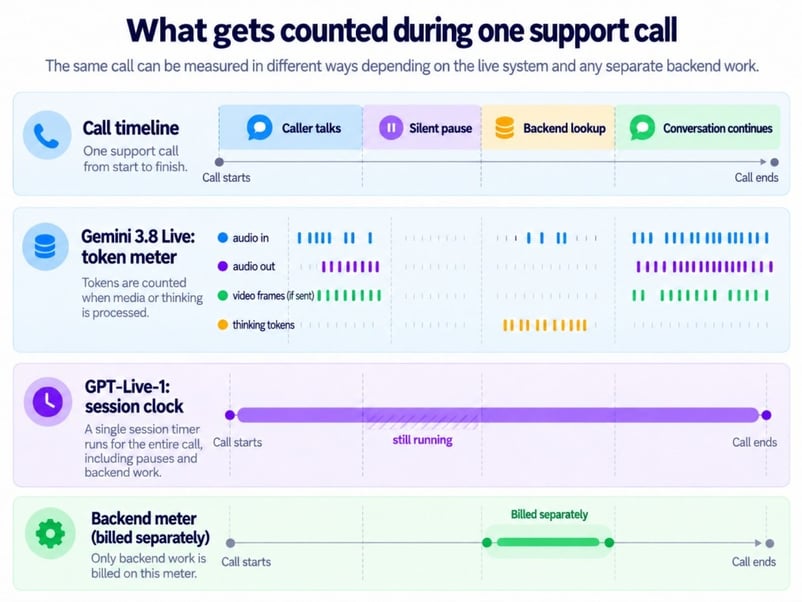
Mỗi đồng hồ đếm gì trong cuộc gọi. Hình: Tác giả.
Đồng hồ của GPT-Live-1 chạy cả khi im lặng, và tắt tiếng không dừng nó. Cộng các khoản phí trong bảng và chi phí điện thoại, rồi chia cho số tác vụ hoàn tất.
Hỗ trợ trình duyệt, máy chủ và điện thoại trong Gemini 3.8 Live và GPT-Live-1
Ứng dụng trình duyệt và máy chủ đều có thể kết nối tới cả hai mô hình, nhưng triển khai qua điện thoại thì tách biệt. Sơ đồ cho thấy các tùy chọn kết nối; khác biệt vận hành là thời lượng kết nối và ai nằm trên đường truyền cuộc gọi.
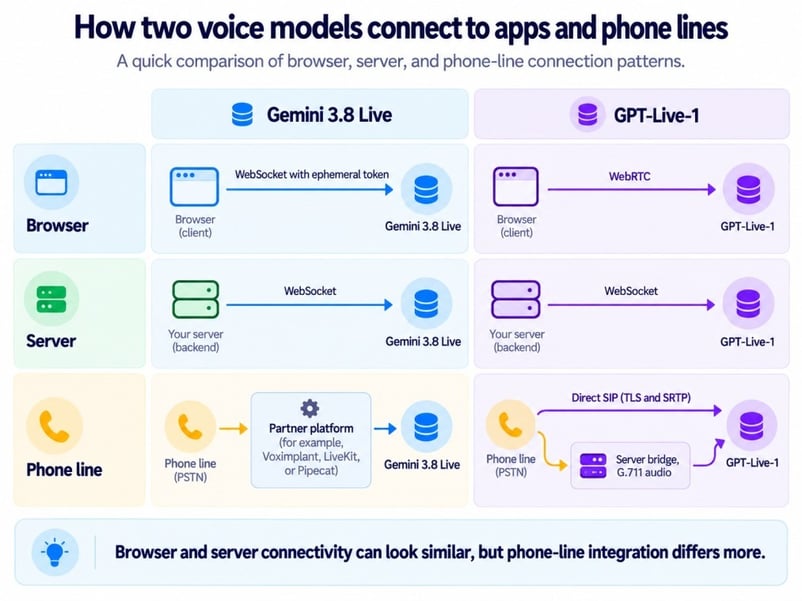
Đường kết nối trình duyệt, máy chủ và điện thoại. Hình: Tác giả.
Kết nối Gemini đặt lại sau khoảng 10 phút, nên cuộc gọi dài hơn cần nối lại phiên. Với GPT-Live-1, hãy ghi log kết nối giọng nói và công việc backend được ủy quyền riêng biệt.
Cuộc gọi điện thoại và hỗ trợ SIP
SIP trực tiếp loại bớt một nhà cung cấp trong đường truyền cuộc gọi của GPT-Live-1. Tuyến đối tác của Gemini thêm một dịch vụ nữa để cấu hình, giám sát và gỡ lỗi.
Một số nhà phát triển trên diễn đàn OpenAI báo cáo GPT-Live-1 hứa thực hiện hành động mà không tạo ủy quyền. Hỗ trợ OpenAI không gọi đó là lỗi; họ chỉ đến hướng dẫn nhắc, trong đó lưu ý rằng một lời xác nhận bằng lời nói không khẳng định công việc backend đã bắt đầu. Tôi sẽ ghi log sự kiện ủy quyền tách biệt khỏi lời nói.
Từ ngày 2 tháng 11, OpenAI cũng hỗ trợ gọi đi SIP cho mọi tổ chức, nên GPT-Live-1 có thể thực hiện cuộc gọi cũng như nhận cuộc gọi.
Gemini 3.8 Live vs. GPT-Live-1: Bạn nên dùng mô hình nào?
Quyết định xoay quanh hai câu hỏi: trợ lý có cần nhìn thấy không, và bạn đã có backend chưa? Có cho câu đầu hướng về Gemini; có cho câu thứ hai hướng về GPT-Live-1.
Chuyển tới kịch bản bên dưới phù hợp với sản phẩm của bạn.
Hỗ trợ qua điện thoại và đặt chỗ
Đường dây điện thoại cần xử lý ngắt lời và xác nhận trước điều gì đó không thể đảo ngược. GPT-Live-1 phù hợp, với hỗ trợ SIP như trên và logic đặt chỗ giữ ở backend.
Khắc phục sự cố bằng camera và màn hình
Khi người dùng chĩa điện thoại vào router, mô hình phải suy luận về những gì nó thấy ngay lúc đó. Gemini 3.8 Live làm điều đó trong một phiên, không cần thành phần thị giác riêng, miễn là bạn tính đến giới hạn video 2 phút như phần hình ảnh nêu.
Công việc nhiều bước ở nền
Với tác vụ xâu chuỗi công cụ, hãy so sánh Extended Thinking với GPT-Live-1 cộng Astra. Astra dẫn đầu τ-Voice trong một lần thử, nên lựa chọn vẫn quay về việc suy luận nên đặt ở đâu.
Thêm giọng nói cho tác nhân bạn đã vận hành
Ủy quyền client có thể thêm GPT-Live-1 vào một tác nhân hiện hữu mà không phải viết lại vòng suy luận. Với Gemini, mô hình live trở thành bộ lập kế hoạch.
Lượng cuộc gọi lớn với ngân sách eo hẹp
Cuộc gọi ngắn, đơn giản nghiêng về Gemini cơ bản, thiết lập rẻ nhất trong bài thử của Artificial Analysis. Công cụ nhiều bước sẽ thay đổi phép tính đó.
Kết luận
Cách rõ ràng nhất để đóng khung so sánh này là Gemini 3.8 Live kết hợp khả năng nhìn, suy luận và nói trong một mô hình, trong khi GPT-Live-1 tách giọng nói khỏi trí tuệ phía sau. Không mô hình nào áp đảo, và cả hai đủ gần nhau về độ tự nhiên và tốc độ phản hồi để kiến trúc sẽ quyết định đa số lựa chọn thực tế.
Điều tôi thấy thú vị là khoảng cách dẫn đầu ở tác vụ tác nhân nhanh chóng nghiêng về GPT-Live-1 với Astra. Điểm số đó thuộc về cả hệ thống, không chỉ mô hình giọng nói, nên đó là lập luận cho ủy quyền, dù một lần chạy thử là tín hiệu chứ không phải phán quyết.
Điều khác đáng theo dõi là danh mục backend của OpenAI, vì GPT-6.1 Sol xuất hiện cuối tháng 9 năm 2026. Mỗi backend mới có thể dịch chuyển điểm GPT-Live-1 mà không chạm vào giọng nói, trong khi thay đổi tương ứng của Google sẽ là đổi mô hình live.
Hiện tại, Gemini 3.8 Live dễ chọn hơn cho mọi thứ có camera, còn GPT-Live-1 dễ chọn hơn cho sản phẩm điện thoại đã có backend. Dù theo hướng nào, mã của bạn vẫn phải xử lý bài toán đặt chỗ từ thứ Sáu sang thứ Năm.
Với các khái niệm tác nhân đằng sau mỗi con đường, khóa Giới thiệu về Tác nhân AI của chúng tôi bao quát công cụ, bộ nhớ và lập kế hoạch.
Câu hỏi thường gặp
GPT-Live-1 có thể dùng mô hình Gemini làm backend không?
Có. Ủy quyền client có thể gửi công việc đến một mô hình văn bản Gemini phía sau backend của bạn. Bạn sẽ trả phí cho OpenAI theo phút giọng nói và cho Google theo token backend.
Cuộc hội thoại GPT-Live-1 có thể được giữ trong ngữ cảnh bao lâu?
GPT-Live-1 có cửa sổ ngữ cảnh 128.000 token tính cả token âm thanh, không chỉ bản chép lời. Khi mức dùng vượt 90%, nó khởi động một động cơ giọng nói thay thế mang tối đa 8.192 token lịch sử gần đây và tóm tắt, vì vậy hãy giữ các hành động đã xác nhận và trạng thái tác vụ trong chính ứng dụng của bạn.
Các giới hạn tốc độ áp dụng cho Gemini 3.8 Live và GPT-Live-1 là gì?
GPT-Live-1 cho phép 50 phiên đồng thời trên Build, 300 trên Launch và 500 trên Grow, không có gói miễn phí. Google không công bố giới hạn riêng cho Live và hướng bạn đến Google AI Studio để xem giới hạn hiện tại của dự án.
Tôi có thể tái sử dụng mã ứng dụng giọng nói hiện có không?
Chủ yếu là trên Gemini, ít hơn trên OpenAI. Mã viết cho Gemini 3.1 Flash Live chủ yếu cần chuỗi mô hình mới, bỏ mọi thiết lập thinking_level mà gemini-3.8-live không chấp nhận. Cũng bỏ enable_affective_dialog và proactive_audio: false nếu mã của bạn mang từ mô hình cũ. GPT-Live-1 dùng endpoint riêng v1/live/sessions thay vì v1/realtime, nên ứng dụng Realtime API cần chỉnh sửa, và OpenAI có công bố hướng dẫn di trú.
Âm thanh của Gemini 3.8 Live có watermark không?
Có. Google cho biết mọi âm thanh do các sản phẩm AI của họ tạo, bao gồm cả hai mô hình Gemini 3.8 Live, đều mang watermark SynthID mà người nghe không nghe thấy, điều này hữu ích nếu bạn cần chứng minh người gọi đã nghe giọng tổng hợp.

Tôi là một kỹ sư dữ liệu và người xây dựng cộng đồng, làm việc với pipeline dữ liệu, đám mây và công cụ AI, đồng thời viết các hướng dẫn thực hành, tác động cao cho DataCamp và các nhà phát triển mới nổi.


Các trợ lý giọng nói cũ chủ yếu nói theo lượt: bạn nói, bạn chờ, rồi chúng mới trả lời. Gemini 3.8 Live của Google và GPT-Live-1 của OpenAI là các tác nhân giọng nói thời gian thực có thể xử lý việc ngắt lời và thay đổi giữa chừng câu nói. Không có mô hình nào vượt trội trên mọi mặt.
Khác biệt nằm ở chỗ quá trình suy nghĩ diễn ra ở đâu. Gemini 3.8 Live nghe bạn, có thể quan sát đầu vào từ camera, suy luận và quyết định khi nào yêu cầu ứng dụng của bạn hành động. GPT-Live-1 tập trung vào cuộc hội thoại và có thể lắng nghe khi đang nói. Khi GPT-Live-1 cần suy luận khó hơn hoặc cần hành động, nó chuyển phần việc đó cho một mô hình hay dịch vụ thứ hai gọi là backend.
OpenAI đã đưa GPT-Live-1 lên API vào tháng 9 này, và Google phát hành Gemini 3.8 Live chưa đầy một tuần sau đó. Bài tổng quan về Gemini 3.8 Live của chúng tôi đề cập đến lễ ra mắt của Google. Nếu bạn muốn xây dựng với một trong hai mô hình, hướng dẫn Gemini 3.8 Live và hướng dẫn API GPT-Live-1 của chúng tôi sẽ giúp bạn thiết lập.
TL;DR
Ít thời gian? Đây là so sánh trong sáu điểm:
Yêu cầu camera hoặc backend sẵn có có thể quyết định lựa chọn trước cả khi nhìn bảng xếp hạng. Bảng dưới sẽ cho thấy lý do.