
Gemini 3.8 Live vs. GPT-Live-1 de un vistazo
Lo que no se ve en la tabla es que, en ambos casos, tu propia app sigue haciendo el trabajo real, como ejecutar tus funciones y llevar el control de lo que pide la persona usuaria.
|
Punto de comparación |
Gemini 3.8 Live |
GPT-Live-1 |
|
Papel |
Un solo modelo que escucha, ve, razona y pide a tu app que actúe |
Modelo de voz que conversa y deriva el trabajo más complejo a un backend |
|
IDs de modelo |
|
|
|
Entradas nativas |
Texto, audio, imágenes, fotogramas de vídeo |
Solo texto y audio |
|
Dónde se ejecuta el razonamiento profundo |
Dentro del modelo, con más capacidad en Extended Thinking |
En un backend que tú eliges |
|
Quién ejecuta tus funciones |
Tu aplicación (Search grounding se ejecuta en el lado de Google) |
Tu aplicación; las herramientas alojadas como la búsqueda web funcionan con el backend |
|
Unidad de facturación |
Tokens, incluidos tokens de razonamiento |
Minutos de sesión conectada, más uso del backend |
|
Nivel gratuito |
Sí |
No |
¿Qué son Gemini 3.8 Live y GPT-Live-1?
Ambos son modelos speech-to-speech: entra audio y sale audio, sin un paso de transcripción separado.
¿Qué es Gemini 3.8 Live?
Gemini 3.8 Live es el modelo de diálogo en vivo y baja latencia de Google. Acepta texto, imágenes, audio y vídeo, razona entre turnos y llama a funciones de forma asíncrona. Ambas variantes de Gemini indican un límite de entrada de 131.072 tokens en sus páginas de modelo.
Gemini 3.8 Live Extended Thinking es un modelo aparte, no un ajuste. Añade razonamiento en segundo plano en nivel bajo, medio o alto, mientras narra el progreso.
Las notas de publicación de Google listan ambos IDs como disponibles de forma general, aunque la guía de capacidades de la Live API sigue marcando la API como vista previa.
¿Qué es GPT-Live-1?
GPT-Live-1 es el modelo de voz full dúplex de OpenAI. Full dúplex es el término técnico para el comportamiento de escuchar mientras habla que describí en la introducción.
OpenAI llama a la derivación al backend delegation. La voz puede seguir hablando mientras ese trabajo se ejecuta.
GPT-Live-1 tampoco es el mismo producto que la línea GPT-Realtime-2 de OpenAI ni que el modelo de backend al que delega. GPT-Realtime-2.1 mantiene razonamiento y herramientas en un único modelo en tiempo real, así que todo lo que digo sobre delegation aplica solo a GPT-Live-1.
¿Cuál es la principal diferencia entre Gemini 3.8 Live y GPT-Live-1?
El TL;DR te dio la versión corta; aquí va la completa. Gemini 3.8 Live elige las llamadas a funciones dentro de la sesión en vivo, mientras que GPT-Live-1 deriva el razonamiento a un backend separado. En ambos diseños, tu aplicación ejecuta tus propias funciones.
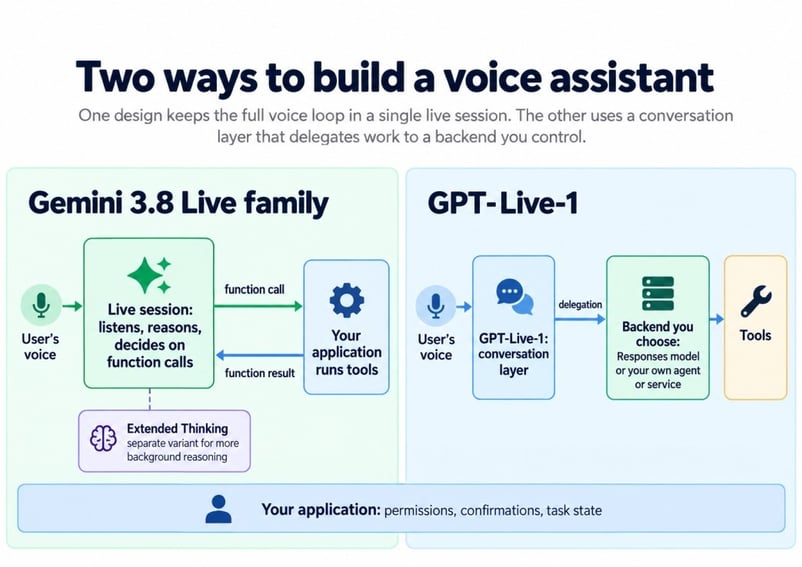
Dónde pone cada modelo el razonamiento. Imagen del autor.
Casi todo lo que sigue se explica por esta separación, así que veamos cada lado primero.
Cómo planifica Gemini 3.8 Live dentro de una sola sesión
Con Gemini, no hay un segundo modelo que configurar. El modelo en vivo emite una llamada a función cuando necesita datos, y tu cliente devuelve el resultado, tal y como describe la guía de razonamiento de Google.
Pasar a Extended Thinking mantiene el mismo endpoint WebSocket y no requiere un modelo de backend, aunque sí cambia el código del cliente.
Cómo funciona la delegación en GPT-Live-1
GPT-Live-1 gestiona el habla y decide cuándo pedir ayuda; el backend gestiona el razonamiento, las herramientas y las reglas de negocio. La guía de prompting de OpenAI coloca el procedimiento completo de la tarea en las instrucciones del backend.
Con Responses delegation, OpenAI ejecuta un modelo que tú configuras. Con client delegation, el trabajo va a cualquier modelo o servicio que ejecute tu aplicación. En ambos casos, la guía de delegación indica que tu aplicación es la dueña de permisos, registros y estado de las tareas.
Por qué importa la diferencia de arquitectura
El precio de la separación son más piezas: una sesión de voz, un backend y estado compartido entre ambos. A cambio, puedes cambiar el modelo de razonamiento sin tocar la voz.
Ese intercambio parece peor si aún no tienes backend, pero mejor si necesitas actualizar un agente existente sin cambiar su voz.
¿Cómo gestionan Gemini 3.8 Live y GPT-Live-1 las interrupciones?
Ambos gestionan interrupciones, pero GPT-Live-1 está construido en torno a ellas, junto con pausas y backchannels (el «mm-hmm» de quien escucha). Gemini 3.8 Live admite barge-in, y su audio proactivo está siempre activo, pero la documentación de Google no lo denomina full dúplex.
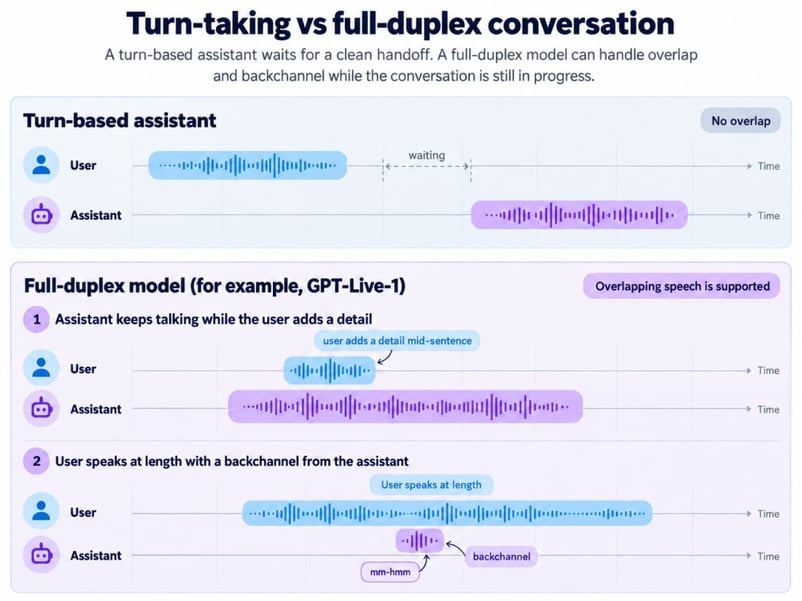
Turnarse frente a hablar a la vez. Imagen del autor.
La nota de lanzamiento de OpenAI cita a la app de idiomas Speak diciendo que GPT-Live-1 redujo las interrupciones casi un 80% frente a sistemas por turnos; es una afirmación de cliente, no una prueba independiente.
En Gemini, el audio proactivo permite al modelo ignorar habla que no va dirigida a él. En nuestro tutorial de Gemini, el audio de los altavoces del portátil que se cuela en el micrófono contó como interrupción del usuario, así que haz pruebas con y sin auriculares.
¿Cómo gestionan Gemini 3.8 Live y GPT-Live-1 el razonamiento y las llamadas a herramientas?
Gemini escala el razonamiento pasando del Live base a Extended Thinking. GPT-Live-1 lo escala cambiando el backend, así que compara Extended Thinking con una configuración completa de GPT-Live-1, no solo con el modelo de voz.
Gemini 3.8 Live vs. Gemini 3.8 Live Extended Thinking
El Gemini 3.8 Live base no tiene el ajuste thinking_level y acepta funciones BLOCKING para código antiguo. Extended Thinking cambia cuatro comportamientos del cliente:
-
Herramientas: solo funcionan funciones
NON_BLOCKING, y una bloqueante devuelve un error irrecuperable. -
Niveles de razonamiento: no hay opción mínima, solo los tres niveles indicados.
-
Fin de turno:
turnComplete: trueya no significa que el modelo haya terminado, así que tu cliente vigilainteraction_statushasta que marqueIDLE. -
Planificación: no se admite la programación de funciones.
Google recomienda Extended Thinking para tareas de varios pasos y herramientas lentas. Supone más latencia y más tokens de salida.
Hay algo de la documentación de Google que me chirría. La nota de lanzamiento dice que Gemini 3.8 Live puede «seguir conversando mientras las tareas terminan en segundo plano», pero la guía de razonamiento dice que el modelo base «espera a que la herramienta termine antes de hablar». Nuestro tutorial de Gemini observó este segundo comportamiento en una consulta del tiempo, así que yo planificaría según la guía hasta que Google lo aclare.
¿Qué modelos de backend funcionan con GPT-Live-1?
GPT-Live-1 puede situarse delante de cualquier backend que configures. La documentación de OpenAI señala tres backends GPT-6:
-
GPT-6 Luna (
gpt-6-luna), el punto de partida sugerido en la guía de delegación -
GPT-6 Sol (
gpt-6-sol), la sugerencia para tareas más complejas -
GPT-6 Astra, que la nota de lanzamiento recomienda para incidencias complejas de clientes
Las filas de Artificial Analysis «GPT-Live-1 (Astra, medium)» y «GPT-Live-1 (Sol, low)» son configuraciones de sistema, no versiones del modelo de voz. Artificial Analysis no indica la generación de Sol, y OpenAI publicó GPT-6.1 Sol después de esas pruebas.
Qué pasa si la persona cambia la petición a mitad de tarea
Imagina que alguien pide mover una reserva al viernes y, mientras se hace la búsqueda, dice «mejor, al jueves». Solo la segunda petición sigue vigente.
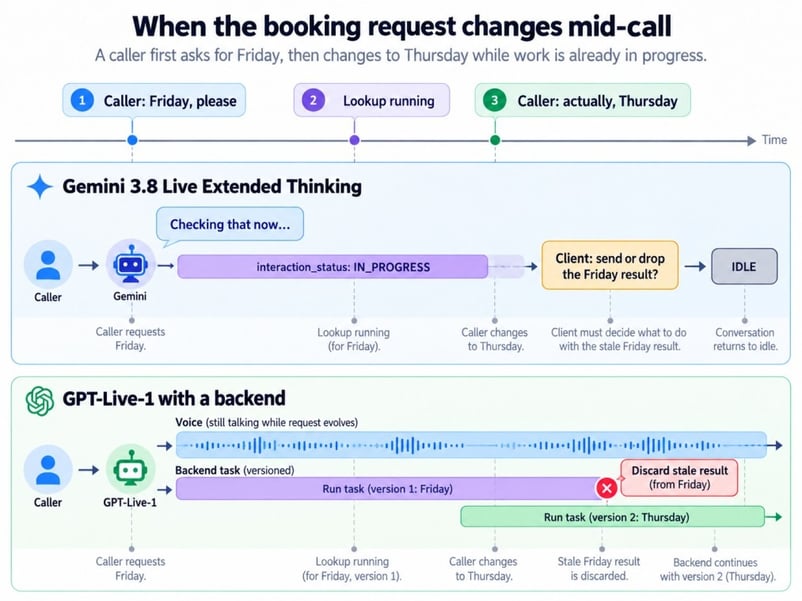
Una petición cambiada durante un trabajo lento. Imagen del autor.
En GPT-Live-1, interrumpir la voz no cancela el trabajo del backend. Con Responses delegation aún puede devolverse el resultado antiguo a la voz, mientras que con client delegation tu código puede descartarlo antes.
En Gemini, tu cliente también puede descartar el resultado obsoleto de la herramienta. En cualquier caso, tu aplicación decide cuál es la tarea actual.
¿Admiten imágenes y vídeo Gemini 3.8 Live y GPT-Live-1?
Gemini 3.8 Live acepta imágenes y vídeo de forma nativa; GPT-Live-1 indica que ambos no están admitidos. Una app con GPT-Live-1 puede enviar una foto a un backend de visión separado, pero no puede ver una cámara en vivo por sí misma.
En Gemini, los fotogramas entran en la misma sesión que el audio, así que el modelo puede responder «¿es este el cable correcto?» mientras la persona lo sostiene ante la cámara. Eso tiene dos costes. Los fotogramas de vídeo se envían por defecto, y la guía de sesiones de Google limita a 2 minutos las sesiones con audio y vídeo, frente a 15 solo con audio, a menos que actives la compresión de la ventana de contexto.
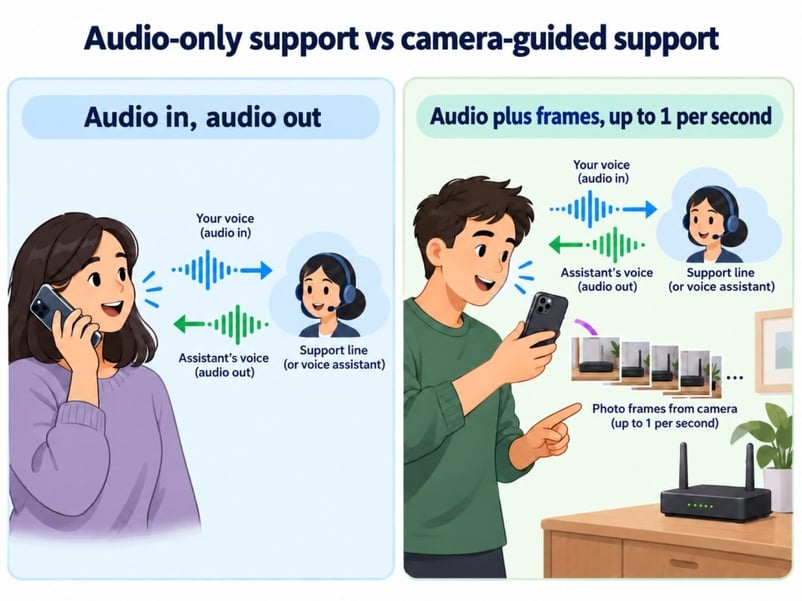
Llamadas telefónicas frente a sesiones de reparación con cámara. Imagen del autor.
Una línea de reservas nunca verá un fotograma, y los rankings de voz de abajo no miden visión.
Benchmarks de Gemini 3.8 Live vs. GPT-Live-1
No hay un único benchmark que sentencie esta comparativa. Entre las cuatro configuraciones de los dos modelos, Astra lidera el índice principal, Sol lidera en dinámica conversacional y el Gemini base tiene el Elo de Arena más alto de las cuatro configuraciones.
Primero, cómo funciona el índice principal, porque explica la mayoría de las diferencias.
Cómo funciona el Speech to Speech Index de Artificial Analysis
El índice pondera por igual cuatro habilidades distintas:
- Big Bench Audio: preguntas de razonamiento formuladas en voz alta
- τ-Voice: tareas de atención al cliente en varios pasos, como cambiar un vuelo
- Puntuación de Arena: votos ciegos de personas sobre qué agente prefirieron
- Tasa de éxito en tareas: con qué frecuencia la conversación termina con la llamada a herramienta correcta
La dinámica conversacional se informa por separado según la metodología v2.0.
Aquí están las cuatro configuraciones que importan en este análisis.
|
Configuración |
Índice |
Big Bench Audio |
τ-Voice |
Dinámica conversacional |
Arena Elo |
Éxito en tareas |
TTFA |
|
GPT-Live-1 (Astra, medium) |
83.2 |
90.1% |
74.5% |
94.9% |
1027 |
87.4% |
1.34 s |
|
Gemini 3.8 Live Extended Thinking (High) |
82.6 |
97.7% |
68.6% |
91.9% |
966 |
89.1% |
1.35 s |
|
GPT-Live-1 (Sol, low) |
80.1 |
89.0% |
59.3% |
97.3% |
1037 |
90.9% |
1.24 s |
|
Gemini 3.8 Live |
74.5 |
91.7% |
30.1% |
96.1% |
1074 |
93.2% |
1.18 s |
Los dos τ-Voice de GPT-Live-1 proceden de una sola ejecución, así que tómalos con cautela.
Tareas de agente vs. puntuaciones de preferencia humana
En τ-Voice, Astra obtiene 74,5%, Extended Thinking 68,6% y el Gemini base 30,1%. El razonamiento extra importa cuando se encadenan herramientas.
La conversación cuenta otra historia: Sol puntúa más alto, y los intervalos de confianza de Arena para el Gemini base y Sol se solapan.
La diferencia de 0,6 puntos en el índice entre Astra y Extended Thinking no tiene intervalo de confianza publicado. Ya se han intercambiado posiciones una vez, así que yo aún lo llamaría empate.
¿Qué modelo responde más rápido?
El Gemini 3.8 Live base tiene el menor tiempo hasta el primer audio (TTFA) de la tabla, pero la diferencia entre los cuatro es menor de 0,2 segundos. TTFA es lo que tarda el modelo en producir su primer token de audio.
El TTFA no mide la respuesta a interrupciones ni el tiempo en completar una reserva o búsqueda. Esto último depende más de tu backend y tus herramientas.
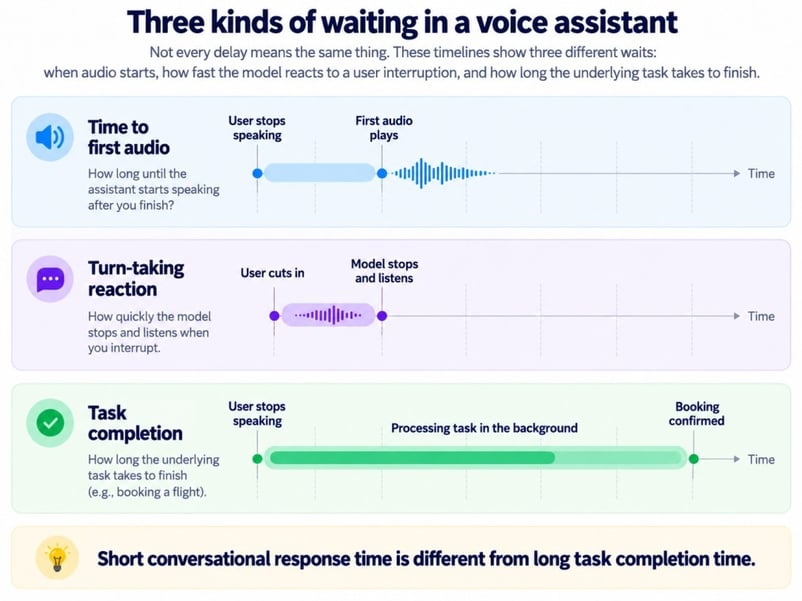
Tres tipos de espera en voz. Imagen del autor.
Tanto Extended Thinking como GPT-Live-1 pueden seguir hablando durante una búsqueda lenta. La persona sigue esperando la reserva.
Lo que no miden los benchmarks de voz
Para una línea de soporte, los rankings no te dirán:
- si tu proveedor telefónico y códec lo transmiten con calidad
- si el agente sigue tu guion a los diez minutos
- cómo oye a alguien con acento marcado en una calle ruidosa
- cuánto costó la llamada una vez sumados backend y herramientas
Un piloto con tus propias grabaciones responde mejor a esas preguntas.
Precios de Gemini 3.8 Live vs. GPT-Live-1: ¿cuál es más barato?
El Gemini base es el más barato en la prueba de Artificial Analysis, pero los modelos cobran por cosas distintas. Importa más el coste por tarea completada que la tarifa de lista.
Las tarifas siguientes son los precios de lista en la página de precios de Google y en la página del modelo GPT-Live-1 en el momento de escribir esto, y las cifras por minuto de Gemini son conversiones de Google a partir de precios por token.
|
Concepto de coste |
Gemini 3.8 Live y Extended Thinking (plan de pago) |
GPT-Live-1 |
|
Entrada de audio |
3,00 $ por 1M tokens (unos 0,005 $/min) |
Incluida en 0,05 $ por minuto, con facturación por segundo |
|
Salida de audio |
12,00 $ por 1M tokens (unos 0,018 $/min) |
Incluida en la misma tarifa de sesión |
|
Entrada de imagen o vídeo |
1,00 $ por 1M tokens (unos 0,002 $/min) |
No admitido |
|
Razonamiento |
Tokens de razonamiento facturados a tarifas de salida |
Tokens del modelo de backend al precio de ese modelo |
|
Búsqueda y herramientas |
5.000 búsquedas gratuitas al mes, luego 14 $ por 1.000 |
Facturado por el modelo de backend y herramientas que uses |
Los tokens de razonamiento hacen que Extended Thinking cueste más que el Gemini base. Artificial Analysis estima 0,84 $ por hora de audio de entrada para el Gemini base, 3,50 $ para Extended Thinking, 4,47 $ para Sol y 5,83 $ para Astra, sin contar herramientas ni descuentos por caché. Gemini Live no admite caché; un backend de GPT-Live-1 sí puede.
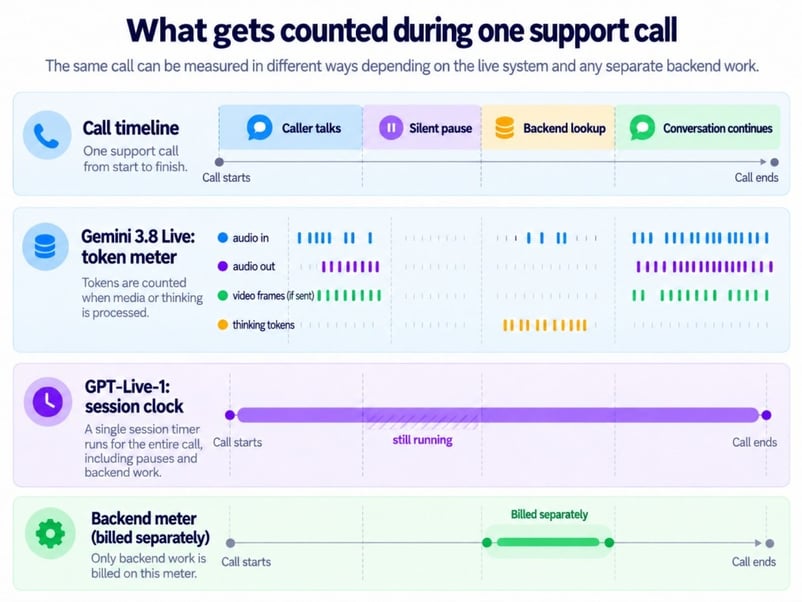
Qué cuenta cada medidor durante las llamadas. Imagen del autor.
El contador de GPT-Live-1 sigue durante el silencio, y silenciar no lo detiene. Suma los cargos de la tabla y los costes telefónicos, y divide entre tareas completadas.
Soporte en navegador, servidor y teléfono en Gemini 3.8 Live y GPT-Live-1
Las apps en navegador y servidor pueden conectarse a ambos modelos, pero el despliegue en teléfono los separa. El diagrama muestra las opciones de conexión; las diferencias operativas son la duración de la conexión y quién se sienta en la ruta de la llamada.
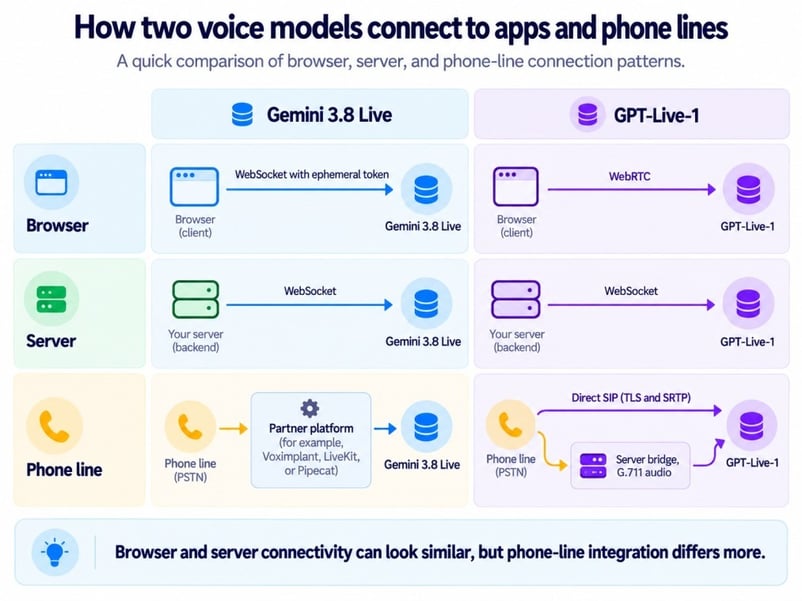
Rutas de conexión para navegador, servidor y teléfono. Imagen del autor.
Las conexiones de Gemini se reinician a los 10 minutos aprox., así que las llamadas más largas requieren reanudación de sesión. Con GPT-Live-1, registra por separado la conexión de voz y el trabajo delegado en el backend.
Llamadas telefónicas y soporte SIP
El SIP directo elimina un proveedor en la ruta de llamada de GPT-Live-1. La ruta con socios de Gemini añade otro servicio que configurar, monitorizar y depurar.
Algunos desarrolladores en el foro de OpenAI informan de que GPT-Live-1 promete una acción sin crear una delegación. Soporte de OpenAI no lo ha señalado como bug; remitió a su guía de prompting, que indica que un acuse hablado no confirma que el backend haya empezado. Yo registraría eventos de delegación por separado del habla.
Desde el 2 de noviembre, OpenAI también admite llamadas SIP salientes para todas las organizaciones, así que GPT-Live-1 puede realizar llamadas además de recibirlas.
Gemini 3.8 Live vs. GPT-Live-1: ¿cuál deberías usar?
La decisión se reduce a dos preguntas: ¿el asistente necesita ver? y ¿ya tienes backend? Un sí a la primera apunta a Gemini; un sí a la segunda, a GPT-Live-1.
Salta al escenario que más se parezca a tu producto.
Soporte telefónico y reservas
Una línea telefónica necesita gestionar interrupciones y confirmaciones antes de cualquier acción irreversible. GPT-Live-1 encaja bien, con el soporte SIP de arriba y la lógica de reservas en el backend.
Solución de problemas con cámara o pantalla
Si una persona apunta el móvil a un router, el modelo debe razonar sobre lo que ve en ese momento. Gemini 3.8 Live lo hace en una sola sesión, sin un componente de visión aparte, siempre que planifiques el límite de 2 minutos de vídeo del apartado de imágenes.
Trabajo en segundo plano con varios pasos
Para tareas que encadenan herramientas, compara Extended Thinking con GPT-Live-1 más Astra. Astra lidera τ-Voice en una ejecución, así que la decisión sigue siendo dónde debe vivir el razonamiento.
Añadir voz a un agente que ya ejecutas
Client delegation puede añadir GPT-Live-1 a un agente existente sin reescribir su bucle de razonamiento. Con Gemini, el modelo en vivo pasa a ser el planificador.
Alto volumen de llamadas con presupuesto ajustado
Llamadas breves y sencillas apuntan al Gemini base, la opción más barata en la prueba de Artificial Analysis. Las tareas con múltiples herramientas cambian ese cálculo.
Conclusiones
La forma más clara de enmarcar esta comparativa es que Gemini 3.8 Live combina visión, razonamiento y habla en un solo modelo, mientras que GPT-Live-1 separa la voz de la inteligencia que hay detrás. Ninguno domina, y están lo bastante cerca en naturalidad y rapidez como para que la arquitectura decida la mayoría de casos reales.
Lo más interesante es lo rápido que la ventaja en tareas de agente se ha movido hacia GPT-Live-1 con Astra. Esa puntuación pertenece al sistema completo, no solo al modelo de voz, así que es el argumento de la delegación en acción, aunque una ejecución es una señal, no un veredicto.
También conviene vigilar la gama de backends de OpenAI, ya que GPT-6.1 Sol llegó a finales de septiembre de 2026. Cada backend nuevo puede mover las puntuaciones de GPT-Live-1 sin tocar la voz, mientras que el cambio comparable en Google implicaría cambiar el modelo en vivo.
Por ahora, Gemini 3.8 Live es la opción más sencilla para todo lo que use cámara, y GPT-Live-1 lo es para productos telefónicos con backend ya implantado. En cualquier caso, tu código seguirá teniendo que gestionar el problema de pasar la reserva de viernes a jueves.
Para los conceptos de agentes detrás de ambos caminos, nuestro curso Introduction to AI Agents cubre herramientas, memoria y planificación.
FAQs
¿Puede GPT-Live-1 usar un modelo de Gemini como backend?
Sí. Con client delegation puedes enviar el trabajo a un modelo de texto de Gemini detrás de tu propio backend. Pagarías a OpenAI por los minutos de voz y a Google por los tokens del backend.
¿Cuánto puede mantenerse en contexto una conversación con GPT-Live-1?
GPT-Live-1 tiene una ventana de contexto de 128.000 tokens que cuenta tokens de audio, no solo la transcripción. Cuando el uso supera el 90%, inicia un motor de voz de reemplazo que mantiene hasta 8.192 tokens de historial reciente y resúmenes, así que conserva acciones confirmadas y estado de tareas en tu propia aplicación.
¿Qué límites de tasa se aplican a Gemini 3.8 Live y GPT-Live-1?
GPT-Live-1 permite 50 sesiones concurrentes en Build, 300 en Launch y 500 en Grow, sin acceso al nivel gratuito. Google no publica límites específicos para Live y te remite a Google AI Studio para ver los límites actuales de tu proyecto.
¿Puedo reutilizar el código de mi app de voz existente?
En su mayor parte, sí en Gemini y menos en OpenAI. El código escrito para Gemini 3.1 Flash Live básicamente necesita la nueva cadena de modelo, sin el ajuste thinking_level, que gemini-3.8-live no acepta. También elimina enable_affective_dialog y proactive_audio: false si tu código los arrastra de modelos antiguos. GPT-Live-1 usa su propio endpoint v1/live/sessions en lugar de v1/realtime, así que una app del Realtime API necesita rework, y OpenAI publica una guía de migración.
¿El audio de Gemini 3.8 Live lleva marca de agua?
Sí. Google afirma que todo el audio generado por sus productos de IA, incluidos ambos modelos de Gemini 3.8 Live, lleva una marca de agua SynthID inaudible para quien escucha, lo que ayuda si alguna vez necesitas demostrar que una persona oyó voz sintética.

Soy ingeniero de datos y creador de comunidades. Trabajo con canalizaciones de datos, nube y herramientas de IA, al tiempo que escribo tutoriales prácticos y de gran impacto para DataCamp y programadores emergentes.






Los asistentes de voz tradicionales funcionan por turnos: hablas, esperas y luego responden. Gemini 3.8 Live de Google y GPT-Live-1 de OpenAI son agentes de voz en tiempo real capaces de gestionar interrupciones y cambios a mitad de frase. Ninguno es claramente superior en todo.
La diferencia clave es dónde ocurre el razonamiento. Gemini 3.8 Live te oye, puede inspeccionar la cámara, razona y decide cuándo pedir a tu app que actúe. GPT-Live-1 se centra en la conversación y puede escuchar mientras habla. Cuando GPT-Live-1 necesita un razonamiento más profundo o realizar una acción, deriva el trabajo a un segundo modelo o servicio llamado backend.
OpenAI llevó GPT-Live-1 a su API en septiembre, y Google lanzó Gemini 3.8 Live menos de una semana después. Nuestro resumen de Gemini 3.8 Live cubre el lanzamiento de Google. Si quieres crear con cualquiera de los dos, nuestro tutorial de Gemini 3.8 Live y el tutorial del API de GPT-Live-1 te guían en la configuración.
TL;DR
¿Vas justo de tiempo? Aquí va la comparativa en seis puntos:
Una necesidad de cámara o un backend existente pueden decidir antes de mirar el ranking. La tabla de abajo muestra por qué.